HyperLogLog en OxiMem: los mismos números que Redis, uniones 3 veces más rápidas
OxiMem, el motor en memoria de OxiDB, ya entiende PFADD, PFCOUNT y PFMERGE. Cómo funciona HyperLogLog en detalle, la codificación ASCII de OxiMem y lo que cuesta, las optimizaciones y mediciones frente a Redis 8.6.1: estimaciones idénticas, conteos de varias claves entre 3 y 5 veces más rápidos, y Redis igualado o por delante con una sola clave.
OxiMem, el motor en memoria de OxiDB, habla el protocolo de Redis. Desde hoy también conoce los comandos HyperLogLog de Redis: PFADD, PFCOUNT y PFMERGE. Las matemáticas son exactamente las de Redis, así que para los mismos elementos devuelve el mismo número que Redis. La codificación es distinta, y eso tiene un coste. Este artículo explica cómo funciona HyperLogLog, cómo está escrito en OxiMem y cómo se compara con Redis 8.6, uno al lado del otro. OxiDB es de código abierto y el código está en GitHub: github.com/parisxmas/OxiDB.
El problema: ¿cuántos distintos?
El número de "lectores" que aparece en el lateral de este blog muestra cuántas personas distintas han leído el sitio. La forma obvia de hacerlo es un conjunto: añadir cada lector y preguntar el tamaño del conjunto. Así contaba el sitio al principio: cada lector se guardaba como un resumen de 16 caracteres, lo que supone unos pocos megabytes con 100.000 lectores.
Un conjunto cuenta con exactitud, pero guarda todo lo que ha visto y crece con ello. Los usuarios únicos diarios de una red publicitaria, las IP distintas que llegan a una API o las consultas distintas de un buscador se cuentan por millones y miles de millones. Guardar cada elemento ahí sale caro. Y la mayoría de las veces no hace falta un número exacto: "unos 3,2 millones" basta.
HyperLogLog existe precisamente para esto. Estima cuántos elementos distintos ha visto sin guardarlos, con memoria fija y un error pequeño. La versión de Redis ocupa 12 KB y tiene un error estándar del 0,81 %.
Cómo funciona HyperLogLog
La intuición de la moneda
Un amigo lanza una moneda y solo te dice una cosa: la racha más larga de cruces seguidas. Si la respuesta es "como mucho 2", probablemente la lanzó pocas veces. Si es "20 seguidas", eso pasa una vez entre un millón, así que debe de haberla lanzado muchísimas veces.
Las funciones hash se comportan como lanzamientos de moneda. Los bits de un buen hash parecen aleatorios, y ver exactamente k bits a cero al final de un hash ocurre una vez de cada 2^(k+1). Así que, cuanto más larga es la racha de ceros más larga entre los hashes que has visto, más elementos distintos has visto. El mismo elemento da siempre el mismo hash, así que las repeticiones no cambian el número. De ahí viene lo de "distintos".
Una sola medida no basta: cubetas
Una única racha más larga es muy ruidosa. Un solo hash afortunado duplica la estimación. Por eso HyperLogLog reparte los hashes en cubetas (registros) y guarda una racha más larga por separado en cada una:
hash = MurmurHash64A(elemento)                     64 bits

  ┌──────────── 50 bits ───────────┬── 14 bits ─┐
  │  el resto                      │  registro  │
  └────────────────────────────────┴────────────┘
                                         │
     número de ceros finales + 1 ────────┼──► rango
                                         ▼
               registro[r] = max(registro[r], rango)
Redis y OxiMem usan 2^14 = 16.384 registros. Los 14 bits bajos del hash eligen el registro. Uno más que el número de ceros finales en los 50 bits restantes es el "rango" del elemento. Un bit centinela en la posición 50 limita el rango a 51. El registro se actualiza si contiene un rango menor.
Eso es todo lo que supone añadir un elemento: un hash, una máscara, un recuento de ceros y como mucho una escritura.
La estimación
El rango de cada registro es, a grandes rasgos, el logaritmo de cuántos elementos han caído en él. Para volver a un recuento, se promedian esas conjeturas. No con la media aritmética, sino con la media armónica, que evita que un solo registro afortunado desvíe todo el resultado. La fórmula del artículo original de 2007:
E = α · m² / Σ 2^(−registro[j])m es el número de registros y α una constante de corrección. La fórmula se desvía con recuentos muy pequeños y muy grandes, así que el algoritmo original pasa a "contar los registros vacíos" para números pequeños y usa tablas empíricas de sesgo en la zona intermedia.
Desde la 4.0, Redis usa el estimador mejorado de Otmar Ertl de 2017, y OxiMem también. No mira los registros, sino el histograma de rangos: cuántos registros contienen cada rango. Dos series (sigma y tau en el código) tratan correctamente los extremos. El resultado es una única fórmula: sin tablas de sesgo, sin cambios de método, el mismo cálculo desde cero hasta miles de millones.
El error depende del número de registros: el error estándar es 1.04 / √m, que con 16.384 registros es del 0,81 %. Para 10.000 elementos distintos, la respuesta caerá casi siempre entre 9.920 y 10.080.
Fusión
La propiedad más bonita de HyperLogLog es que se puede fusionar. La unión de dos contadores se obtiene comparándolos registro a registro y quedándose con el mayor: register[j] = max(a[j], b[j]). El resultado es el mismo que si hubieras contado la unión desde cero. Así, los contadores diarios dan los usuarios únicos semanales, y los contadores por servidor dan el total. PFMERGE y PFCOUNT con varias claves hacen exactamente esto.
La implementación en OxiMem
El código está en oxidb-server/src/hll.rs y llegó en dos commits: primero los comandos (c4502f2b) y después las optimizaciones (0cd23297).
Mismas matemáticas, mismos números
El objetivo era devolver el número de Redis para los mismos elementos, así que cada detalle coincide con Redis:
- MurmurHash64A con la semilla de Redis (
0xadc83b19), leído en little-endian en cualquier máquina. Su salida está fijada por vectores de prueba generados a partir de la referencia en C. - 2^14 registros. El registro son los 14 bits bajos; el rango son los ceros finales del resto más uno.
- El estimador de Ertl, redondeado como lo redondea Redis.
Lo medí yo mismo, añadiendo los mismos elementos user:0, user:1 ... a ambos:
| Recuento real | Redis 8.6.1 | OxiMem 0.45.1 | Error | Igual |
|---|---|---|---|---|
| 10 | 10 | 10 | 0,00 % | sí |
| 100 | 100 | 100 | 0,00 % | sí |
| 1.000 | 1.007 | 1.007 | +0,70 % | sí |
| 10.000 | 10.089 | 10.089 | +0,89 % | sí |
| 100.000 | 99.471 | 99.471 | -0,53 % | sí |
| 1.000.000 | 999.674 | 999.674 | -0,03 % | sí |
| unión de 3 claves (450.000) | 447.209 | 447.209 | -0,62 % | sí |
En todas las filas ambos servidores dan el mismo número, y el error se mantiene en torno al error estándar del 0,81 %.
Una codificación distinta: ASCII
Redis guarda un HyperLogLog como un blob binario: en forma densa, cada uno de los 16.384 registros ocupa 6 bits, 12 KB en total. OxiMem no puede hacer eso. Sus valores son String de Rust, así que deben ser UTF-8 válido, y se escriben como texto en la instantánea JSON y en el espejo SQL opcional. Un blob de bytes arbitrarios rompería todo eso.
Así que hay dos codificaciones ASCII:
- Dispersa (
HYLLs): solo los registros distintos de cero, ordenados por índice. Cada uno esindex << 6 | rank, 20 bits, escritos como 4 caracteres base64url. Un HyperLogLog vacío es solo la cabecera de 5 bytes. - Densa (
HYLLd): un carácter por registro,'0' + rank, 16.389 bytes en total.
La dispersa pasa a densa a partir de 750 registros (3.000 bytes, el valor por defecto de hll-sparse-max-bytes en Redis). El valor es una cadena normal: TYPE dice "string", GET, SET, RENAME, COPY y la instantánea lo tratan como cualquier cadena, y el TTL sobrevive a un PFADD. Un PFADD sobre una cadena que no es un HyperLogLog responde WRONGTYPE, como hace Redis, y deja el valor intacto. Como fusionar un valor corrupto corrompería los recuentos, se rechazan los índices desordenados, los rangos fuera de límites o una longitud incorrecta.
También medí el coste. Tamaño en bytes de las mismas claves:
| Elementos | Redis | OxiMem |
|---|---|---|
| 10 | 46 | 45 |
| 100 | 283 | 405 |
| 200 | 506 | 797 |
| 1.000 | 1.910 | 16.389 |
| 10.000 o más | 12.304 | 16.389 |
Para claves pequeñas apenas hay diferencia. Hacia los 1.000 elementos, OxiMem pasa a densa antes que Redis, porque su forma dispersa gasta 4 bytes por registro, mientras que la de Redis salta las rachas de registros vacíos con un único código de operación. Una clave llena ocupa 12 KB en Redis y 16 KB en OxiMem, así que OxiMem en forma densa usa alrededor de un 33 % más de memoria. El texto no puede empaquetarse más: los 6 bits de un registro son exactamente un carácter base64, así que el mejor caso sigue siendo un carácter por registro. La diferencia solo se cerrará si OxiMem incorpora un tipo de valor binario. La disposición más grande también devuelve algo a cambio, como muestran las mediciones.
Optimizaciones
La primera versión era correcta, pero más lenta que Redis; según el mensaje del commit, PFMERGE iba a una cuarta parte de la velocidad de Redis. El segundo commit cambió esto:
- Contar directamente desde la codificación: el estimador solo necesita el histograma de rangos, así que
PFCOUNTcon una sola clave ya no construye un array de registros de 16 KB; lee el histograma directamente de la codificación. Una clave dispersa solo cuesta lo que sus entradas. - Plegar en un único array:
PFMERGEyPFCOUNTcon varias claves pliegan todas las fuentes en un único array de registros (merge_into) en lugar de decodificar cada una en el suyo propio y fusionarlas después. - Bucles sin ramas: una comprobación de salida anticipada por byte impedía que el bucle denso se vectorizara, con un coste de unos 6 µs por fuente. Ahora la comprobación va a un indicador que se consulta después de la pasada; una prueba garantiza que los bytes corruptos se siguen rechazando.
- Construir bytes: construir la codificación densa como un vector de bytes en lugar de carácter a carácter la llevó de 10 µs a 2,5 µs.
- Cuatro subhistogramas: la mayoría de los registros se concentran en uno o dos valores de rango, así que un único histograma incrementa una y otra vez el mismo contador, y cada incremento espera al anterior. Escribir en cuatro histogramas por turnos y sumarlos al final llevó el recuento denso de 9,8 µs a 6,8 µs.
Medido frente a Redis
Corrección (3 de noviembre de 2026): los números de la primera versión de esta sección procedían de una ejecución en la que Redis se arrancó con
--daemonize. macOS ejecuta los procesos demonizados con menor prioridad, lo que hacía que Redis pareciera más lento y OxiMem mejor de lo que son. Las pruebas se repitieron con ambos servidores arrancados de la misma forma; los números de abajo son los corregidos.
Configuración:
- Apple M4 (10 núcleos), macOS 26.3.
- Redis 8.6.1 y oxidb-server 0.45.1 (
master,0cd23297) en la misma máquina, ambos arrancados de la misma forma desde la misma shell (en primer plano, bajonohup), con la persistencia desactivada. - Cinco escenarios con
redis-benchmark, cada uno de 5 rondas, alternando Redis y OxiMem. Las tablas muestran la mediana. Las rondas difieren, en general, menos de un 5 %. - La clave densa contiene 1 millón de elementos y la dispersa, 200. La unión y
PFMERGEusan tres claves densas que se solapan.
50 clientes, sin pipelining
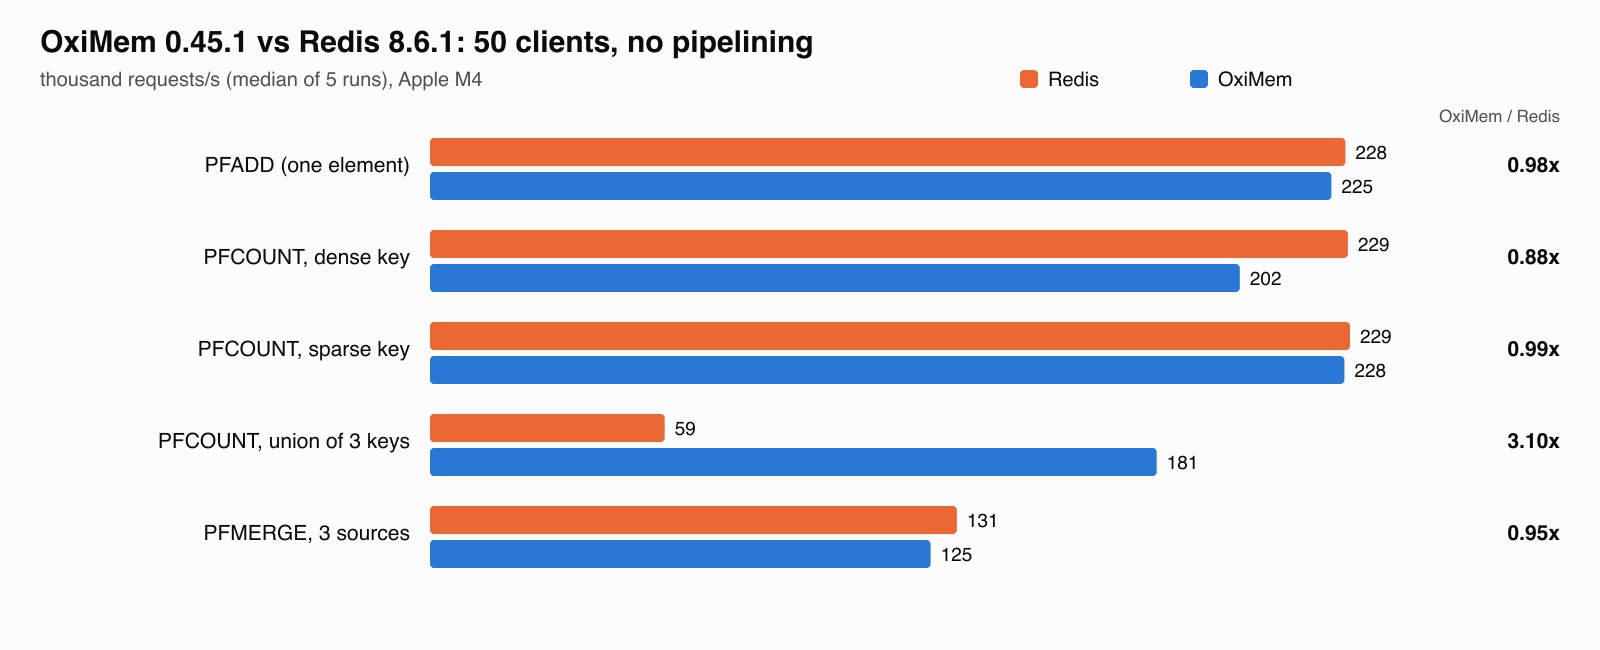
| Escenario | Redis (pet/s) | OxiMem (pet/s) | OxiMem / Redis | p50 Redis / OxiMem (ms) | p99 Redis / OxiMem (ms) |
|---|---|---|---|---|---|
PFADD un elemento | 228.206 | 224.719 | 0,98 | 0,119 / 0,119 | 0,143 / 0,159 |
PFCOUNT clave densa | 228.833 | 201.884 | 0,88 | 0,119 / 0,143 | 0,143 / 0,191 |
PFCOUNT clave dispersa | 229.358 | 227.964 | 0,99 | 0,119 / 0,119 | 0,135 / 0,159 |
PFCOUNT unión de 3 claves | 58.502 | 181.159 | 3,10 | 0,807 / 0,159 | 0,911 / 0,263 |
PFMERGE 3 fuentes | 131.349 | 124.792 | 0,95 | 0,335 / 0,383 | 0,431 / 1,959 |
En esta ronda, los comandos de una sola clave se agrupan en torno a las 230.000 peticiones/s en ambos lados. Ese es, sobre todo, el techo de redis-benchmark, que usa un solo hilo, en esta máquina, no el de los servidores. PFADD y PFCOUNT sobre una clave dispersa van a la par. OxiMem queda un 12 % por detrás al contar una clave densa y un 5 % por detrás en PFMERGE.
La diferencia real está en la unión: OxiMem es 3,1 veces más rápido. Ambos pliegan las fuentes en un único array de registros, pero la codificación densa de Redis empaqueta los registros en 6 bits, así que al fusionar extrae cada uno con desplazamientos de bits. En OxiMem cada registro es un byte, así que el mismo bucle no tiene ramas y se vectoriza. Aquí es donde se recupera el 33 % pagado en memoria.
50 clientes, pipeline de 16, 4 hilos
Con pipelining, cada cliente envía 16 comandos sin esperar las respuestas, lo que traslada el cuello de botella del cliente al servidor. Aquí es donde se ven las diferencias reales.
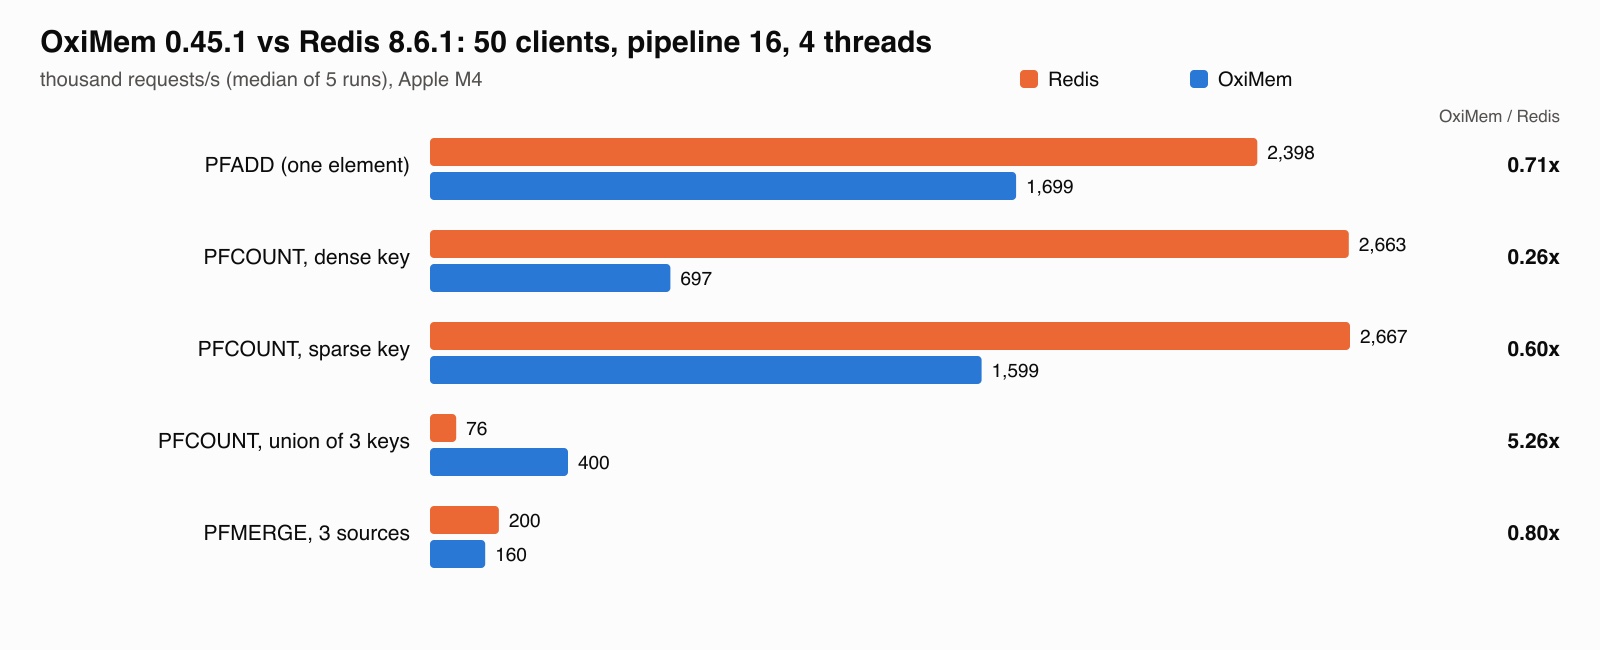
| Escenario | Redis (pet/s) | OxiMem (pet/s) | OxiMem / Redis | p50 Redis / OxiMem (ms) | p99 Redis / OxiMem (ms) |
|---|---|---|---|---|---|
PFADD un elemento | 2.398.082 | 1.698.754 | 0,71 | 0,295 / 0,167 | 0,407 / 3,655 |
PFCOUNT clave densa | 2.663.116 | 696.864 | 0,26 | 0,263 / 0,271 | 0,383 / 3,983 |
PFCOUNT clave dispersa | 2.666.667 | 1.598.721 | 0,60 | 0,263 / 0,167 | 0,375 / 1,727 |
PFCOUNT unión de 3 claves | 76.060 | 400.000 | 5,26 | 10,239 / 1,303 | 10,479 / 5,791 |
PFMERGE 3 fuentes | 199.800 | 159.936 | 0,80 | 3,847 / 3,191 | 4,063 / 24,415 |
Destacan cuatro cosas:
- OxiMem tiene un techo. En los comandos baratos (
PFADD,PFCOUNTdisperso) OxiMem se detiene en 1,6 a 1,7 millones de peticiones/s, mientras que Redis llega a 2,4 a 2,7 millones. Que se detenga en el mismo punto sea cual sea el comando sugiere que la diferencia no viene del código de HyperLogLog, sino del coste fijo por petición de OxiMem (protocolo y despacho de comandos). Todavía no lo he investigado. - La diferencia en la unión se amplía hasta 5,3 veces. Con el servidor a plena carga, desempaquetar los registros de 6 bits uno a uno cuesta de forma más visible.
- Redis cuenta una sola clave densa 3,8 veces más rápido. Además del techo anterior hay un segundo motivo: Redis guarda la última estimación en una caché de 8 bytes en la cabecera de la clave y no la recalcula hasta que la clave cambia. En esta prueba la clave nunca cambia, así que Redis responde desde la caché cada vez, mientras que OxiMem reconstruye el histograma de 16.384 registros en cada ocasión (unos 6,8 µs). En una clave dispersa ese trabajo es mínimo, así que ahí solo queda la diferencia del techo. La solución está clara: un campo de caché en la cabecera del valor. Ese es el siguiente paso.
- La latencia de cola de OxiMem es mayor. Su latencia mediana es igual o inferior a la de Redis en la mayoría de los escenarios, pero con pipelining su p99 sube a entre 1,7 y 24 ms, mientras que Redis se queda entre 0,4 y 10,5 ms. Tampoco he investigado todavía por qué.
En resumen: en el trabajo con una sola clave, OxiMem está por ahora a la par o algo por detrás de Redis, y claramente por detrás bajo carga. En los recuentos con varias claves va de 3 a 5 veces por delante.
Cómo usarlo
Los comandos son los mismos que en Redis y funcionan con redis-cli o con cualquier cliente de Redis:
$ redis-cli -p 6380 PFADD lectores:2026-11-03 ip:203.0.113.7 ip:198.51.100.9
(integer) 1
$ redis-cli -p 6380 PFADD lectores:2026-11-04 ip:203.0.113.7 ip:192.0.2.44
(integer) 1
$ redis-cli -p 6380 PFCOUNT lectores:2026-11-03 lectores:2026-11-04
(integer) 3
$ redis-cli -p 6380 PFMERGE lectores:semana lectores:2026-11-03 lectores:2026-11-04
OK
$ redis-cli -p 6380 TYPE lectores:semana
string
El recuento de lectores de este blog ya funciona así: un resumen con sal de la dirección IP de cada lector se añade a una sola clave PFADD y el número se lee con PFCOUNT. No se guarda nada por lector, la clave ocupa como mucho 16 KB haya los lectores que haya y, a cambio, el número no es exacto sino una estimación con un 0,81 % de error.
Comentarios
Sé el primero en comentar.
Inicia sesión con tu cuenta de Google para comentar. Tu nombre y tu comentario son públicos. Tu correo y tu dirección IP se guardan para combatir el abuso, pero nunca se muestran.