Consultas geoespaciales y de grafos en OxiDB: índice geohash, $near, $graphLookup y $shortestPath
Cómo incorporé consultas geoespaciales y etapas de grafos al motor de documentos de OxiDB, con lugares reales de Estambul y una pequeña red de vuelos: un índice geohash generoso pero nunca equivocado, BFS y Dijkstra perezoso.
El motor de documentos de OxiDB hace algo más que "dame los documentos en los que este campo sea igual a aquel valor". Hay dos tipos de preguntas que suelen enviarse a un sistema aparte: "¿qué es lo que tengo más cerca?" y "¿cómo llego de aquí hasta allí?". Para la primera se suele recurrir a PostGIS o a Redis GEO; para la segunda, a una base de datos de grafos como Neo4j. Puse ambas dentro de OxiDB, como parte natural del lenguaje de consultas y del pipeline de agregación. Este artículo trata la parte geoespacial ($geoWithin, $near, $geoNear, el índice geohash) y la parte de grafos ($graphLookup, $shortestPath). Todos los ejemplos usan lugares reales de Estambul y aeropuertos reales de Turquía, y todas las respuestas que aparecen aquí salieron de un servidor local de OxiDB 0.44.2 que ejecuté mientras lo escribía.
El primer artículo de esta serie trataba el motor de documentos. Todo lo de aquí funciona sobre él: las mismas colecciones, los mismos índices, el mismo protocolo de red. Sin servicio aparte, sin plugin.
¿Por qué dentro de la base de datos?
Pensemos en una aplicación de reparto. Las posiciones de los repartidores viven en una colección. "Repartidores libres a menos de 2 km del cliente" combina un filtro de ubicación con un filtro de campo normal (status: "idle"). Si las posiciones están en Redis y el estado en la base de datos principal, se acaba cruzando en el código de la aplicación resultados de dos sistemas, y la consistencia pasa a ser problema de uno mismo. Con los grafos ocurre lo mismo: copiar los datos a una segunda base de datos solo para preguntar por "amigos de amigos" implica un pipeline que hay que mantener sincronizado para siempre.
En OxiDB una ubicación no es más que un campo de un documento, y un grafo no es más que referencias entre documentos. El lenguaje de consultas entiende ambas cosas y los índices sirven a ambas. El precio es que no se obtiene todo lo que ofrece un GIS o una base de datos de grafos dedicados. Más abajo enumero lo que hace y, con la misma intención, lo que no hace.
Cómo activarlo: no hay nada que hacer
Las consultas geoespaciales y de grafos forman parte del motor de documentos, y el motor de documentos está activado por defecto. No hay ninguna variable de entorno adicional. Para estas pruebas arranqué el servidor en mi propio puerto y con su propio directorio de datos:
OXIDB_ADDR=127.0.0.1:15300 OXIDB_DATA=./data ./oxidb-serverEl protocolo de red es JSON con prefijo de longitud: una longitud de 4 bytes en little-endian seguida de un documento JSON de la forma {"cmd": ...}. Todas las peticiones siguientes se enviaron así, y las respuestas se muestran tal como las devolvió el servidor (en algunos sitios recorté campos o los reduje con $project para que se lean mejor). Los nombres de colecciones y campos están en turco, porque son los datos que ejecuté de verdad: yerler significa "lugares", konum es "ubicación", ad es "nombre" y tur es "tipo".
El modelo de datos geoespacial: puntos
El soporte geográfico de OxiDB se construye deliberadamente en torno a puntos. Un campo de ubicación puede tener cualquiera de estas tres formas:
| Forma | Ejemplo |
|---|---|
| GeoJSON Point | {"type": "Point", "coordinates": [28.9802, 41.0086]} |
Array [lon, lat] | [28.9741, 41.0256] |
Objeto {lat, lon} | {"lat": 41.0370, "lon": 28.9850} (o lng) |
El orden es siempre el de GeoJSON: primero la longitud, después la latitud. En la forma de objeto las claves tienen nombre, así que el orden no importa. La longitud debe estar entre -180..180 y la latitud entre -90..90; lo que quede fuera de eso, o lo que no sea un número, simplemente no es un punto. Un documento sin ubicación o con una ubicación no válida nunca cumple un predicado geográfico, pero tampoco provoca un error. Eso es lo deseable en una colección sin esquema: una cafetería sin coordenadas puede estar en la colección, solo que nunca aparece en "cerca de mí".
Para mostrarlo inserté 14 lugares de Estambul más una cafetería sin ubicación, mezclando a propósito las tres formas:
{"cmd": "insert_many", "collection": "yerler", "docs": [
  {"ad": "Ayasofya", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9802, 41.0086]}},
  {"ad": "Topkapı Sarayı", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9834, 41.0115]}},
  {"ad": "Kapalıçarşı", "tur": "carsi", "konum": [28.968, 41.0107]},
  {"ad": "Galata Kulesi", "tur": "kule", "konum": [28.9741, 41.0256]},
  {"ad": "Taksim Meydanı", "tur": "meydan", "konum": {"lat": 41.037, "lon": 28.985}},
  {"ad": "Dolmabahçe Sarayı", "tur": "muze", "konum": {"lat": 41.0392, "lon": 29.0005}},
  {"ad": "Kız Kulesi", "tur": "kule", "konum": [29.0041, 41.0211]},
  {"ad": "Kadıköy İskelesi", "tur": "iskele", "konum": {"lat": 40.9926, "lng": 29.0221}},
  {"ad": "Çamlıca Kulesi", "tur": "kule", "konum": [29.0697, 41.027]},
  {"ad": "Rumeli Hisarı", "tur": "muze", "konum": [29.0561, 41.0848]},
  {"ad": "Anadolu Hisarı", "tur": "muze", "konum": [29.0669, 41.0822]},
  {"ad": "Büyükada", "tur": "ada", "konum": [29.12, 40.858]},
  {"ad": "Sabiha Gökçen Havalimanı", "tur": "havalimani", "konum": [29.3092, 40.8986]},
  {"ad": "İstanbul Havalimanı", "tur": "havalimani", "konum": [28.7519, 41.2753]},
  {"ad": "Konumsuz Kafe", "tur": "kafe"}
]}
{"ok": true, "data": [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]}(Ayasofya es Santa Sofía, Topkapı Sarayı es el Palacio de Topkapı, Kapalıçarşı es el Gran Bazar, Kız Kulesi es la Torre de la Doncella y Kadıköy İskelesi es el muelle de ferris de Kadıköy.)
Crear el índice geográfico es un solo comando:
{"cmd": "create_geo_index", "collection": "yerler", "field": "konum"}
{"ok": true, "data": "geo index created"}

{"cmd": "list_indexes", "collection": "yerler"}
{"ok": true, "data": [{"name": "_geo_konum", "index_type": "geo", "fields": ["konum"], "unique": false}]}
Todas las consultas geográficas funcionan también sin el índice (con un escaneo completo). El índice solo acelera las cosas, nunca cambia la respuesta. Esa frase es el núcleo de este artículo; explicaré el porqué en breve.
$geoWithin: qué hay dentro de una región
$centerSphere: un círculo esférico
$centerSphere recibe un centro y un radio en radianes. Es la definición de MongoDB; para pasar de metros a radianes se divide por el radio de la Tierra. OxiDB usa el mismo radio medio terrestre que documenta MongoDB: 6.371.008,8 metros. Para 2 km alrededor de Santa Sofía, eso da 2000 / 6371008.8 = 0.000313922... radianes:
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoWithin": {"$centerSphere": [[28.9802, 41.0086], 0.00031392202754452326]}}}}
{"ok": true, "data": [
{"ad": "Ayasofya", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9802, 41.0086]}, "_id": 1, "_version": 1},
{"ad": "Topkapı Sarayı", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9834, 41.0115]}, "_id": 2, "_version": 1},
{"ad": "Kapalıçarşı", "tur": "carsi", "konum": [28.968, 41.0107], "_id": 3, "_version": 1},
{"ad": "Galata Kulesi", "tur": "kule", "konum": [28.9741, 41.0256], "_id": 4, "_version": 1}
]}La Torre de Gálata está a 1958 metros de Santa Sofía (veremos ese número con $geoNear en un momento), justo dentro del círculo de 2 km. Las distancias son siempre distancias de círculo máximo (haversine); no hay Pitágoras sobre el plano.
$box: un rectángulo lon/lat
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoWithin": {"$box": [[28.96, 41.0], [29.01, 41.03]]}}}}
Esta caja devolvió Santa Sofía, Topkapı, el Gran Bazar, la Torre de Gálata y la Torre de la Doncella (5 documentos). Las esquinas deben ser [min, max]. Una caja no da la vuelta por el antimeridiano (longitud 180); si lo hiciera, la intención sería ambigua, así que unas esquinas invertidas son un error (ver la sección de errores más abajo).
$geometry Polygon y $geoIntersects
Después de la primera versión llegó también el soporte de GeoJSON Polygon: un anillo exterior más huecos opcionales. La pertenencia se comprueba mediante ray casting sobre el plano lon/lat. Con un polígono aproximado alrededor de la península histórica:
{"cmd": "find", "collection": "yerler", "query": {"konum": {"$geoWithin": {"$geometry":
  {"type": "Polygon", "coordinates": [[[28.92, 40.993], [28.985, 41.0], [28.99, 41.015],
     [28.97, 41.02], [28.94, 41.03], [28.923, 41.025], [28.92, 40.993]]]}}}}}
El resultado contiene Santa Sofía, el Palacio de Topkapı y el Gran Bazar, pero no la Torre de Gálata, al otro lado del Cuerno de Oro. Evaluar los polígonos sobre el plano es una decisión consciente: para regiones del tamaño de una geocerca (un barrio, una obra, un puerto) la diferencia entre plano y esfera es demasiado pequeña para medirla, y las matemáticas son mucho más simples y rápidas.
También existe $geoIntersects. Como la colección solo almacena puntos, "un punto interseca una región" y "un punto está dentro de una región" son lo mismo, así que ambos comparten un único evaluador. Una geometría Point degenera en un círculo de radio cero:
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoIntersects": {"$geometry": {"type": "Point", "coordinates": [29.0041, 41.0211]}}}}}
{"ok": true, "data": [{"ad": "Kız Kulesi", "tur": "kule", "konum": [29.0041, 41.0211], "_id": 7, "_version": 1}]}$near y $nearSphere: primero lo más cercano
$near hace dos cosas a la vez: filtra por límites de distancia opcionales y ordena los resultados del más cercano al más lejano. Las distancias se expresan en metros. A menos de 3 km de la Torre de Gálata:
{"cmd": "find", "collection": "yerler", "query": {"konum": {"$near": {
  "$geometry": {"type": "Point", "coordinates": [28.9741, 41.0256]}, "$maxDistance": 3000}}}}
El orden devuelto: Torre de Gálata, plaza de Taksim, Gran Bazar, Palacio de Topkapı, Santa Sofía, Torre de la Doncella, Palacio de Dolmabahçe. Siete documentos, del más cercano al más lejano.
$nearSphere es un alias exacto de $near. La forma heredada también funciona: se pasa el punto directamente y se ponen $maxDistance y $minDistance junto al operador. Lugares entre 1 y 6 km del muelle de Kadıköy:
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$nearSphere": [29.0221, 40.9926], "$maxDistance": 6000, "$minDistance": 1000}}}
Resultado: Torre de la Doncella, Palacio de Topkapı, Santa Sofía, Gran Bazar, Torre de Gálata, Palacio de Dolmabahçe, Torre de Çamlıca, plaza de Taksim. El propio muelle (0 m) queda excluido por $minDistance.
Aquí me separo deliberadamente de MongoDB. En MongoDB, la forma heredada de $near es plana y lee $maxDistance en grados. La misma consulta significa dos cosas distintas en dos unidades distintas, lo cual es la receta perfecta para medir mal sin darse cuenta. En OxiDB ambas formas usan metros y ambas son esféricas. Si se porta código de MongoDB, es una diferencia, pero no una silenciosa: si se escribe 0.01 pensando que son grados, se obtiene un círculo de un centímetro, algo que se nota de inmediato.
$near también funciona sin límite de distancia y se combina con otros filtros. Las torres más cercanas a Santa Sofía:
{"cmd": "find", "collection": "yerler", "query": {"tur": "kule",
  "konum": {"$near": {"$geometry": {"type": "Point", "coordinates": [28.9802, 41.0086]}}}}}
Orden: Torre de Gálata, Torre de la Doncella, Torre de Çamlıca.
La regla de ordenación coincide con la de MongoDB: $near solo ordena cuando quien llama no ha indicado un sort explícito. Si se indica, gana el suyo. Añadir "sort": {"ad": 1}, "limit": 3 devolvió Anadolu Hisarı, Ayasofya, Büyükada: orden alfabético.
$geoNear: dame también la distancia
$near ordena, pero no devuelve la distancia. Si la aplicación quiere mostrar "a 1,2 km", o se recalculan las distancias en el cliente con un haversine propio, o se usa la etapa $geoNear:
{"cmd": "aggregate", "collection": "yerler", "pipeline": [
  {"$geoNear": {"near": {"type": "Point", "coordinates": [28.9802, 41.0086]},
                "key": "konum", "distanceField": "mesafe_m", "maxDistance": 5000}},
  {"$project": {"_id": 0, "ad": 1, "mesafe_m": 1}}
]}
{"ok": true, "data": [
{"ad": "Ayasofya", "mesafe_m": 0.0},
{"ad": "Topkapı Sarayı", "mesafe_m": 419.6165187010312},
{"ad": "Kapalıçarşı", "mesafe_m": 1049.969147589969},
{"ad": "Galata Kulesi", "mesafe_m": 1958.3701941280722},
{"ad": "Kız Kulesi", "mesafe_m": 2439.8565175620315},
{"ad": "Taksim Meydanı", "mesafe_m": 3183.509891312274},
{"ad": "Dolmabahçe Sarayı", "mesafe_m": 3804.936857196773},
{"ad": "Kadıköy İskelesi", "mesafe_m": 3940.690888137602}
]}key y distanceField son obligatorios; no adivino qué campo contiene el punto. query añade un filtro y distanceMultiplier convierte unidades. La distancia desde Santa Sofía a los dos aeropuertos, en kilómetros:
{"cmd": "aggregate", "collection": "yerler", "pipeline": [
  {"$geoNear": {"near": [28.9802, 41.0086], "key": "konum", "distanceField": "km",
                "distanceMultiplier": 0.001, "query": {"tur": "havalimani"}}},
  {"$project": {"_id": 0, "ad": 1, "km": 1}}
]}
{"ok": true, "data": [
{"ad": "Sabiha Gökçen Havalimanı", "km": 30.215465616237612},
{"ad": "İstanbul Havalimanı", "km": 35.28374942949766}
]}Internamente, $geoNear se divide en dos etapas: un $match inicial sintetizado (el predicado $near equivalente más el query indicado) y una etapa que escribe la distancia y ordena. Así, el índice geográfico, la intersección de candidatos y el pushdown sirven a $geoNear gratis, sin tener que escribirlos dos veces. spherical se acepta y se ignora: este motor siempre es esférico.
También ejecuté el mismo tipo de consulta con el cliente oficial de Python. El cliente todavía no tiene un helper create_geo_index, así que envié el comando en bruto:
from oxidb import OxiDbClient

with OxiDbClient("127.0.0.1", 15300) as db:
    # The Python client has no create_geo_index helper yet; send the raw command
    db._checked({"cmd": "create_geo_index", "collection": "yerler", "field": "konum"})
    yakin = db.aggregate("yerler", [
        {"$geoNear": {"near": [29.0221, 40.9926], "key": "konum",
                      "distanceField": "m", "maxDistance": 4000}},
        {"$project": {"_id": 0, "ad": 1, "m": 1}},
    ])
    for d in yakin:
        print(f'{d["ad"]:<20} {d["m"]:>7.0f} m')
Kadıköy İskelesi 0 m
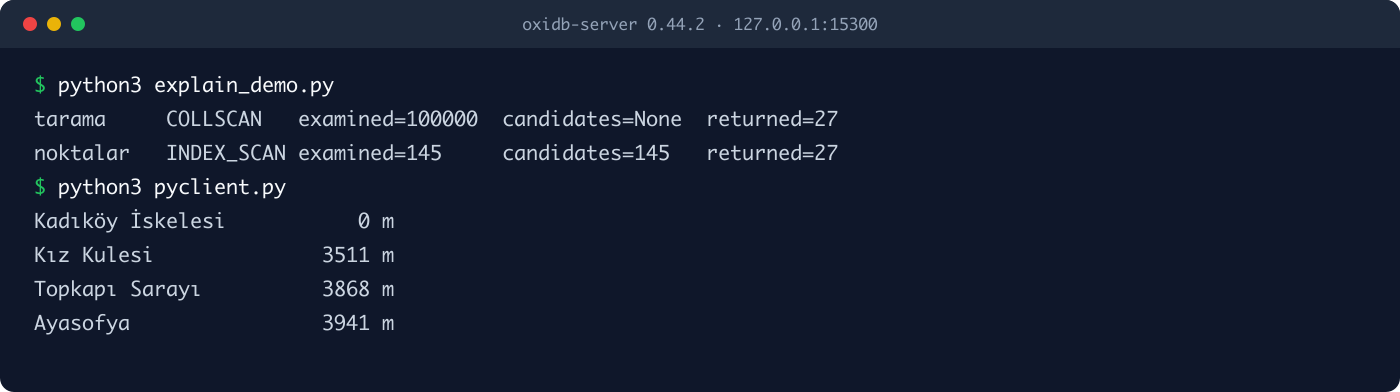
Kız Kulesi 3511 m
Topkapı Sarayı 3868 m
Ayasofya 3941 mRechazar las formas que no puede responder correctamente
El error más fácil en el código geográfico es responder a una forma "aproximadamente" sin decírselo a nadie. La regla de OxiDB es sencilla: una consulta que no puedo responder correctamente se rechaza indicando el motivo. Una lista de resultados incorrecta sale mucho más cara que un mensaje de error, porque nadie se da cuenta.
{"konum": {"$geoWithin": {"$center": [[28.98, 41.0], 0.02]}}}invalid query: $geoWithin $center is not supported - use $centerSphere (spherical), $box, or $geometry PolygonEl $center de MongoDB es un círculo plano con un radio en grados. A latitud 41, un grado de longitud mide unos 84 km y un grado de latitud unos 111 km, así que el "círculo" es en realidad una elipse. Tratarlo en silencio como $centerSphere, o calcularlo sobre el plano, crearía en ambos casos expectativas equivocadas. El $polygon heredado se rechaza por la misma razón:
invalid query: $geoWithin $polygon is not supported - use $centerSphere (spherical), $box, or $geometry PolygonTambién se rechaza un polígono que abarque más de 180 grados de longitud. Cuando un anillo rodea medio globo, qué lado es "dentro" se vuelve ambiguo sobre el plano:
{"konum": {"$geoWithin": {"$geometry": {"type": "Polygon",
  "coordinates": [[[-100, 0], [100, 0], [100, 10], [-100, 10], [-100, 0]]]}}}}
invalid query: Polygon spanning more than 180° of longitude is ambiguous - split it at the antimeridianAlgunos rechazos más, todos respuestas reales del servidor:
swapped $box corners:  invalid query: $box corners must be [min, max] (no antimeridian wrap)
3-element point:       invalid query: expected a point ([lon, lat], GeoJSON Point, or {lon, lat}), got [41.0,28.9,1]
negative distance:     invalid query: $maxDistance must be a non-negative number of meters
LineString region:     invalid query: $geoWithin $geometry supports Polygon, got Some("LineString") - use $centerSphere for circles
(Aquí escribí el guion largo de los mensajes de error del servidor como un guion normal; el resto del texto es exactamente lo que devolvió el servidor.)
Hay que fijarse en la asimetría: un punto roto en un documento es una no coincidencia, un punto roto en una consulta es un error. Los documentos no tienen esquema y pueden estar desordenados; pero la consulta la escribió uno mismo, y un fallo en ella es muy probablemente un bug.
El índice geohash: generoso, nunca equivocado
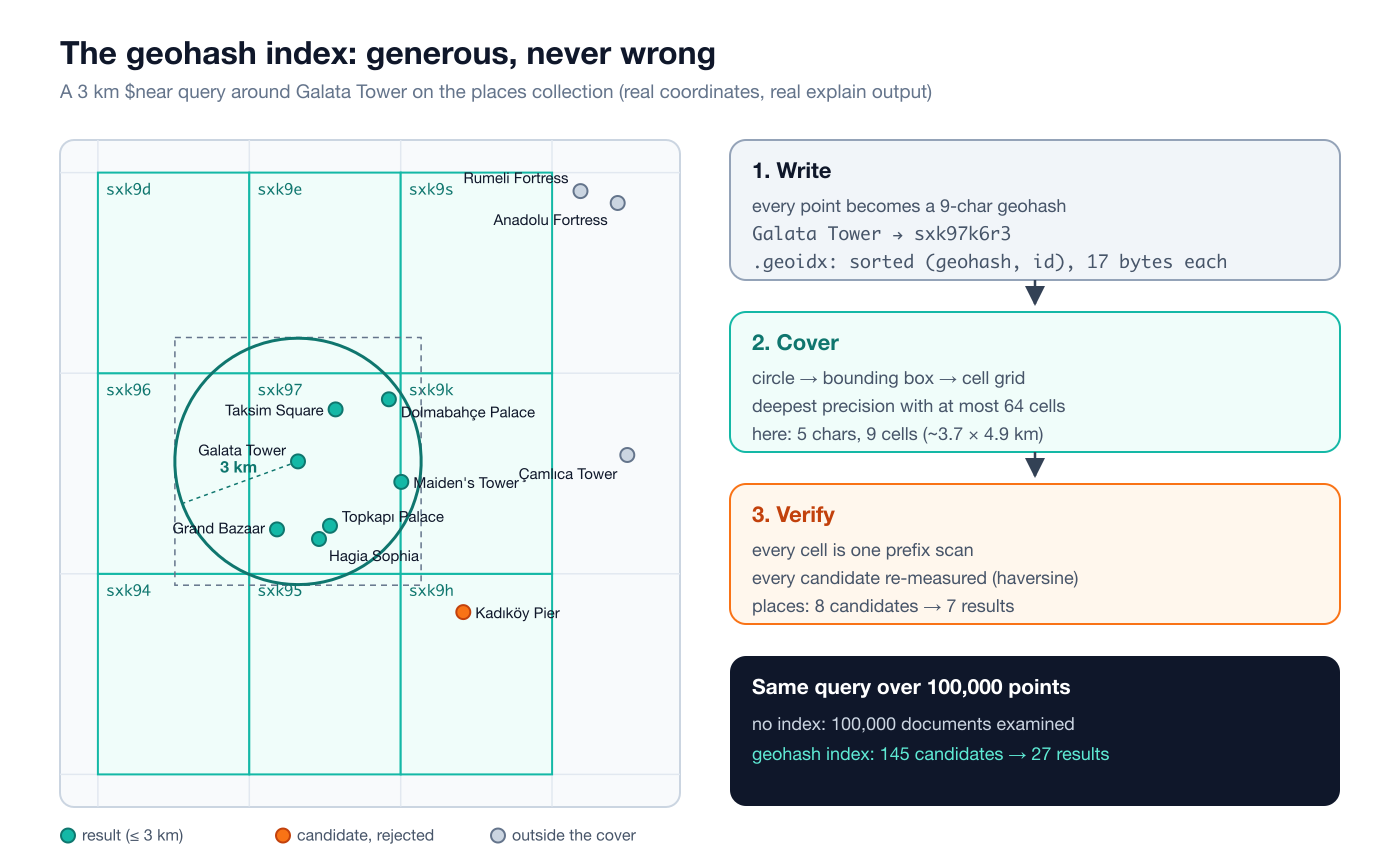
Pasemos al interior. Un geohash es una codificación clásica que convierte un punto en una cadena corta dividiendo el mundo por la mitad una y otra vez. Los bits de longitud y latitud se intercalan (bit 0 longitud, bit 1 latitud, ...) y cada 5 bits se convierten en un carácter base32. La propiedad que importa: los geohashes que comparten un prefijo están en la misma celda rectangular. Todo punto que empieza por sxk97 está dentro de la celda sxk97.
El lado de la escritura
Cada punto indexado se convierte en un geohash de precisión fija de 9 caracteres. Nueve caracteres equivalen a celdas de aproximadamente 4,8 m × 4,8 m. La Torre de Gálata es sxk97k6r3 y Santa Sofía sxk973qsr. El índice es una tabla ordenada de pares (geohash, id de documento): un BTreeMap<String, BTreeSet<DocumentId>> en memoria y un archivo .geoidx en disco.
El formato .geoidx es deliberadamente simple: los bytes mágicos OXGE, una versión de 4 bytes, un recuento de entradas de 8 bytes y después entradas de ancho fijo. Cada entrada es un geohash ASCII de 9 bytes y un id de documento de 8 bytes en little-endian: 17 bytes. El ancho fijo se debe a que todo geohash tiene exactamente 9 caracteres, y hace que un escaneo por prefijo sea tan simple como "buscar por bisección el límite inferior y avanzar mientras coincida el prefijo". En mi servidor de pruebas, el archivo de una colección de 100.000 puntos ocupaba exactamente 1.700.016 bytes: una cabecera de 16 bytes más 100.000 × 17. El archivo de la colección de lugares tiene 14 entradas, porque la cafetería sin ubicación no está en el índice:
00000000: 4f58 4745 0100 0000 0e00 0000 0000 0000  OXGE............
00000010: 7378 6b36 7933 6271 700e 0000 0000 0000  sxk6y3bqp.......
00000020: 0073 786b 3871 7475 7831 0c00 0000 0000  .sxk8qtux1......
El lado de la consulta: la cobertura
Cuando llega una consulta, primero convierto su forma (círculo, caja o polígono) en una caja delimitadora. Los círculos requieren algo de cuidado: los metros por grado de longitud disminuyen con la latitud, así que uso la latitud más ancha que alcanza el círculo, lo que garantiza que la caja nunca se quede corta. Después pruebo precisiones de 9 hacia abajo y elijo la más profunda cuya rejilla de celdas cubra la caja con 64 celdas como máximo. Para encontrar las celdas no hago aritmética con tablas de vecinos; coloco sobre la caja una rejilla de puntos de muestra del tamaño de una celda y calculo el geohash de cada uno. Eso esquiva por completo las conocidas trampas del cálculo de vecinos en geohash.
Para 3 km alrededor de la Torre de Gálata, el resultado son 9 celdas con precisión 5: sxk94, sxk95, sxk96, sxk97, sxk9d, sxk9e, sxk9h, sxk9k, sxk9s. La precisión 6 habría necesitado 88 celdas, por encima del límite de 64. Cada celda es un escaneo por prefijo del índice.
Verificación: el índice solo propone
Esta es la parte más importante del diseño. El índice solo propone candidatos. Cada candidato procedente de las celdas se comprueba de nuevo contra el predicado real sobre el propio documento (distancia haversine, prueba de caja o prueba de polígono). La cobertura puede ser generosa y traer candidatos de más; nunca puede equivocarse, porque la última palabra la tiene el documento, no el índice.
Se puede ver con explain:
{"cmd": "explain", "inner": {"cmd": "find", "collection": "yerler", "query": {"konum": {"$near": {
  "$geometry": {"type": "Point", "coordinates": [28.9741, 41.0256]}, "$maxDistance": 3000}}}}}
{"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": "(range/in conditions)", "collection_docs": 15,
"candidates": 8, "examined": 8, "returned": 7, "post_filter": true, "post_filter_ops": [], "sort": "none",
"duration_ms": 0.005}}8 candidatos, 7 resultados. El candidato rechazado es el muelle de Kadıköy: está en la celda sxk9h, dentro de la cobertura, pero a más de 3 km de la Torre de Gálata. El índice lo propuso y la verificación lo descartó.
Este contrato de "el índice es una pista, no la verdad" importa todavía más en el modo disco. En las colecciones disk-first, el modo por defecto desde la 0.38, el índice tiene dos capas: una base .geoidx ordenada abierta con mmap y una pequeña capa superpuesta en memoria con las escrituras desde la última persistencia. Cuando un documento se mueve o se borra, su antigua entrada de la base pasa a un conjunto dead; las consultas la saltan y, en el siguiente ciclo de persistencia, la base y la capa superpuesta se fusionan en un archivo nuevo que sustituye atómicamente al anterior. Supongamos que una entrada obsoleta se colara de algún modo: el documento no pasaría la verificación, así que el resultado seguiría siendo correcto. Tras un apagado limpio, la apertura es instantánea: sin escanear documentos, solo un mmap. El archivo también se comprueba al abrirlo: un número mágico incorrecto, una versión incorrecta o un archivo truncado se rechazan y el índice se reconstruye a partir de los documentos. Tras una recuperación de un fallo también se reconstruye. Las colecciones en RAM (arrancadas con OXIDB_DISK_FIRST=0) solo persisten la definición del índice, y el índice se reconstruye con un escaneo de documentos al abrir.
Reinicié el servidor y comprobé que el índice seguía ahí y producía el mismo plan (los mismos 145 candidatos, los mismos 27 resultados). También comprobé que el índice sigue las actualizaciones: mover el Palacio de Topkapı a las coordenadas de Ankara con $set lo sacó de la consulta de 1,5 km alrededor de Santa Sofía, y devolverlo a su sitio lo hizo volver.
¿Cuánto importa?
Inserté 100.000 puntos aleatorios sobre la región de Mármara (longitud de 26 a 31, latitud de 39,5 a 42) y ejecuté las mismas consultas sobre los mismos datos con y sin el índice. Medido en un Mac con Apple M4 contra el servidor local:
| Consulta (100.000 puntos) | Sin índice | Índice geohash |
|---|---|---|
$near de 3 km alrededor de Gálata: documentos examinados | 100.000 | 145 candidatos |
| Resultados | 27 | 27 |
| Tiempo mediano medido desde el cliente (20 ejecuciones) | 40,9 ms | 0,084 ms |
$geoWithin de 10 km alrededor de Santa Sofía: documentos examinados | 100.000 | 527 candidatos |
| Resultados | 270 | 270 |
| Tiempo mediano medido desde el cliente (20 ejecuciones) | 34,0 ms | 0,224 ms |
Los tiempos se midieron desde Python sobre TCP, incluida la decodificación del JSON. Las filas que realmente importan son las de "Resultados": la respuesta es la misma con y sin el índice. Eso es exactamente lo que comprueban las pruebas del proyecto (tests/geo_queries.rs): una consulta indexada debe devolver el mismo resultado que el escaneo sin índice a lo largo de inserciones, actualizaciones, borrados y una reapertura.
La cobertura también tiene un límite inferior. Si una forma es tan grande que ni siquiera la precisión más gruesa puede cubrirla con 64 celdas (medio planeta, por ejemplo), la cobertura devuelve "sin restricción" y la consulta recurre a un escaneo completo. Lo mismo ocurre con $near sin límite de distancia: todos los documentos son candidatos y después se ordenan todos. Lento, pero un plan honesto.
Consultas de grafos
La parte geográfica responde a "¿dónde?" y la parte de grafos a "¿conectado con qué?". En OxiDB no hay un modelo de datos de grafos aparte: los nodos son documentos normales y las aristas son o bien un campo de referencia dentro de un documento (un array de ids, por ejemplo) o bien documentos en una colección de aristas separada. Dos etapas lo cubren: $graphLookup (alcanzabilidad, BFS) y $shortestPath (camino más corto, Dijkstra).
Para los ejemplos construí una pequeña red de vuelos: 11 aeropuertos de Turquía y 22 rutas. Las coordenadas de los aeropuertos son reales, y los pesos de las aristas son las distancias de círculo máximo calculadas a partir de esas coordenadas (km). Las rutas en sí no son horarios reales, sino una red de ejemplo que elegí yo.
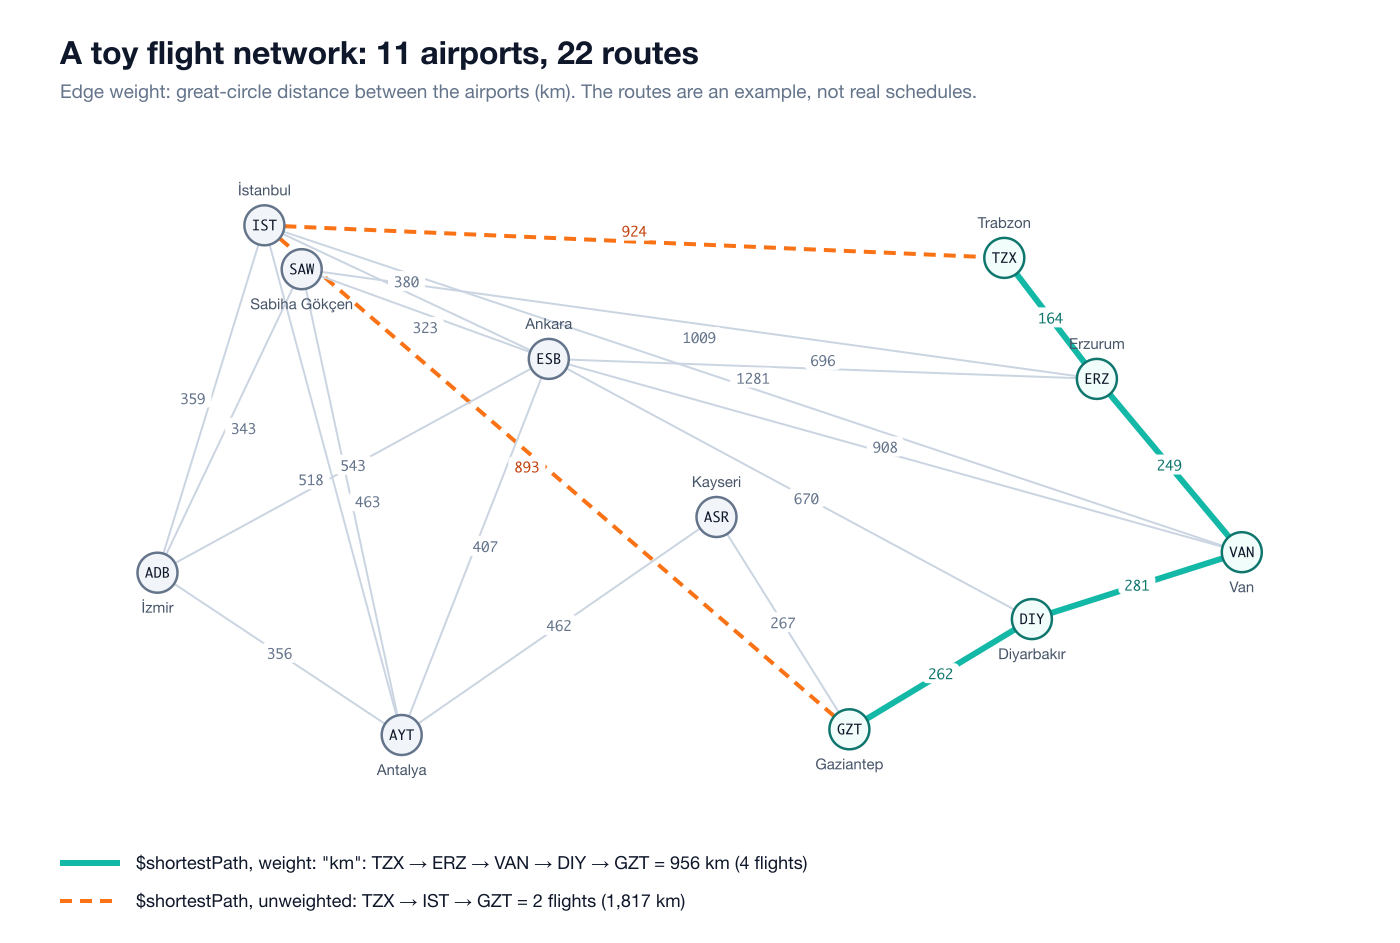
Hay dos colecciones. havalimanlari ("aeropuertos") contiene los nodos, cada uno con los códigos de sus vecinos en un array (baglanti, "conexiones"); ucuslar ("vuelos") es la colección de aristas:
{"cmd": "find_one", "collection": "havalimanlari", "query": {"kod": "VAN"}}
{"ok": true, "data": {"kod": "VAN", "ad": "Van Ferit Melen", "konum": [43.3323, 38.4682],
  "baglanti": ["DIY", "ERZ", "ESB", "IST"], "_id": 8, "_version": 1}}
{"from": "TZX", "to": "ERZ", "km": 164}
{"from": "ERZ", "to": "VAN", "km": 249}
{"from": "IST", "to": "TZX", "km": 924}Puse índices normales en los campos de conexión: havalimanlari.kod, ucuslar.from y ucuslar.to. Enseguida quedará claro por qué importa.
$graphLookup: búsqueda en anchura
$graphLookup es la misma etapa que en MongoDB: se parte de los valores de startWith, se buscan los documentos cuyo connectToField sea igual a ellos y después se continúa desde sus valores de connectFromField. "¿A dónde puedo volar desde Van con una escala como máximo?" (aktarma significa "escala"):
{"cmd": "aggregate", "collection": "havalimanlari", "pipeline": [
  {"$match": {"kod": "VAN"}},
  {"$graphLookup": {"from": "havalimanlari", "startWith": "$baglanti",
     "connectFromField": "baglanti", "connectToField": "kod",
     "as": "erisilen", "depthField": "aktarma", "maxDepth": 1}},
  {"$unwind": "$erisilen"},
  {"$project": {"_id": 0, "kod": "$erisilen.kod", "aktarma": "$erisilen.aktarma"}},
  {"$sort": {"aktarma": 1, "kod": 1}}
]}
{"ok": true, "data": [
{"kod": "DIY", "aktarma": 0}, {"kod": "ERZ", "aktarma": 0}, {"kod": "ESB", "aktarma": 0}, {"kod": "IST", "aktarma": 0},
{"kod": "ADB", "aktarma": 1}, {"kod": "AYT", "aktarma": 1}, {"kod": "GZT", "aktarma": 1},
{"kod": "SAW", "aktarma": 1}, {"kod": "TZX", "aktarma": 1}, {"kod": "VAN", "aktarma": 1}
]}maxDepth: 0 devuelve solo los vuelos directos (DIY, ERZ, ESB, IST). Sin maxDepth, la búsqueda continúa hasta que no aparece nada nuevo y devuelve 11 documentos; Kayseri (ASR) llega en la ronda 2. Hay que fijarse en que el propio VAN aparece en la ronda 1: se puede volar de Van a Ankara y volver, así que VAN es realmente alcanzable. MongoDB se comporta igual; si no se quiere el documento de partida, hay que filtrarlo después.
Por dentro: un $in por ronda
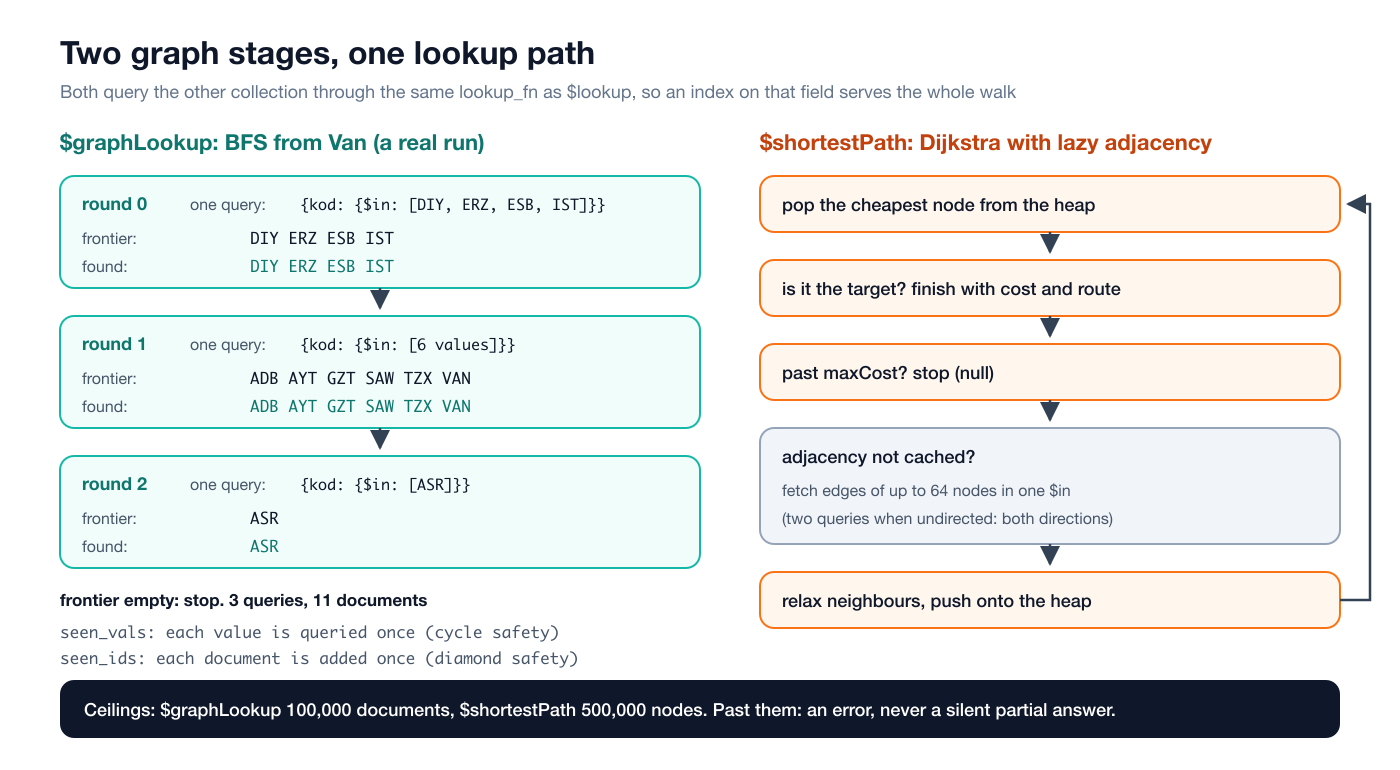
La propiedad más importante de $graphLookup es que cada ronda de BFS es una sola consulta. Todos los valores de la frontera de una ronda van a una única consulta {connectToField: {$in: [...]}} (envuelta en un $and con restrictSearchWithMatch cuando se indica). Esa consulta pasa por el mismo lookup_fn que usa $lookup, así que un índice normal sobre connectToField sirve a todo el recorrido. En el ejemplo de Van, la búsqueda entera son 3 consultas: 4 valores en la ronda 0, 6 en la ronda 1 y 1 en la ronda 2. En la ronda 3 la frontera está vacía y la búsqueda se detiene. Una implementación ingenua que lanzara una consulta por nodo habría enviado 11 consultas para el mismo trabajo; en grafos grandes la diferencia se mide en miles.
La protección frente a ciclos se basa en dos conjuntos separados, y cada uno tiene su propia función:
seen_vals: los valores de conexión ya consultados. Un valor se consulta como máximo una vez. Sin este conjunto, un ciclo (A sigue a B, B sigue a C, C sigue a A) se volvería a consultar indefinidamente.seen_ids: los ids de documento ya recogidos. Un documento aparece en el resultado como máximo una vez. Sin este conjunto, un rombo (A→B→D y A→C→D) devolvería D dos veces.
Lo probé con un grafo de seguidores diminuto: ayşe sigue a mehmet, mehmet sigue a zeynep, zeynep sigue tanto a ayşe como a can. Hay un ciclo:
{"cmd": "aggregate", "collection": "takip", "pipeline": [
  {"$match": {"kisi": "ayse"}},
  {"$graphLookup": {"from": "takip", "startWith": "$takip", "connectFromField": "takip",
     "connectToField": "kisi", "as": "ag", "depthField": "d"}},
  {"$unwind": "$ag"},
  {"$project": {"_id": 0, "kisi": "$ag.kisi", "d": "$ag.d"}}
]}
{"ok": true, "data": [{"kisi": "mehmet", "d": 0}, {"kisi": "zeynep", "d": 1}, {"kisi": "can", "d": 2}, {"kisi": "ayse", "d": 2}]}La búsqueda termina y cada persona aparece una vez.
Poda: restrictSearchWithMatch
restrictSearchWithMatch se aplica durante el recorrido, no al final. Un documento que no supera el filtro se elimina del resultado y además deja de ser una puerta por la que la búsqueda pueda continuar. "¿A dónde puedo llegar desde Trabzon sin hacer escala en Estambul ni en Ankara?":
{"$graphLookup": {"from": "havalimanlari", "startWith": "$baglanti",
   "connectFromField": "baglanti", "connectToField": "kod", "as": "erisilen", "depthField": "aktarma",
   "restrictSearchWithMatch": {"kod": {"$nin": ["IST", "SAW", "ESB"]}}}}
{"ok": true, "data": [
{"kod": "ERZ", "aktarma": 0}, {"kod": "TZX", "aktarma": 1}, {"kod": "VAN", "aktarma": 1},
{"kod": "DIY", "aktarma": 2}, {"kod": "GZT", "aktarma": 3}, {"kod": "ASR", "aktarma": 4},
{"kod": "AYT", "aktarma": 5}, {"kod": "ADB", "aktarma": 6}
]}Solo a través de Erzurum, hacia el este y luego hacia el sur, llegando a Esmirna tras 6 escalas. El filtro, además, se parsea una sola vez al construir la etapa, así que un filtro roto falla al construir el pipeline, no en la primera ronda del recorrido. Lo mismo con maxDepth: pasar -1 produce de inmediato invalid pipeline: $graphLookup maxDepth must be a non-negative integer.
Una nota práctica: startWith y connectFromField pueden ser arrays (cada elemento entra en la frontera como un valor propio), pero la coincidencia sobre connectToField es por igualdad. En los documentos de destino, connectToField debería contener un escalar. Por eso guardé la lista de vecinos en el array baglanti y el campo con el que se compara en el escalar kod.
Límites que fallan de forma ruidosa
Un grafo puede resultar mucho más grande de lo esperado. En una red social, "seguidores de seguidores" puede llegar a millones en dos saltos. $graphLookup tiene un límite de 100.000 documentos por documento de entrada. Si se supera, no devuelve un resultado parcial en silencio, devuelve un error. Una respuesta parcial es una respuesta incorrecta que parece correcta.
Para probarlo creé una única cuenta con 100.001 seguidores:
{"cmd": "aggregate", "collection": "yildiz", "pipeline": [
  {"$match": {"kullanici": "merkez"}},
  {"$graphLookup": {"from": "yildiz", "startWith": "$kullanici", "connectFromField": "kullanici",
     "connectToField": "takip", "as": "takipciler"}},
  {"$project": {"_id": 0, "n": {"$size": "$takipciler"}}}
]}
invalid pipeline: $graphLookup found more than 100000 documents for one input document - narrow the traversal with maxDepth or restrictSearchWithMatch(El mensaje real tiene algunos espacios de más, restos de una continuación de línea en el código fuente; aquí los reduje a espacios simples. Un pequeño defecto estético.) El error volvió en unos 156 ms; el límite actúa mucho antes de que se llegara a agotar la memoria. Añadir restrictSearchWithMatch: {"kullanici": {"$in": ["u1", "u2", "u3"]}} a la misma consulta devolvió {"n": 3}.
$shortestPath: Dijkstra sobre una colección de aristas
$shortestPath no es una etapa de MongoDB; es un añadido que entra deliberadamente en el terreno de las bases de datos de grafos. Para cada documento de entrada evalúa las expresiones source y target y ejecuta Dijkstra sobre las aristas de la colección from. Cada arista es un documento de la forma {edgeFrom: node, edgeTo: node, weight: number}.
Primero, sin pesos, lo que minimiza el número de vuelos: de Trabzon a Gaziantep (rota es "ruta" y maliyet es "coste").
{"$shortestPath": {"from": "ucuslar", "source": "$kod", "target": "GZT",
   "edgeFrom": "from", "edgeTo": "to", "undirected": true, "as": "rota", "costField": "maliyet"}}
{"ok": true, "data": [{"kod": "TZX", "maliyet": 2.0, "rota": [
{"from": "IST", "to": "TZX", "km": 924}, {"from": "IST", "to": "GZT", "km": 893}]}]}Dos vuelos, pero 1817 km pasando por Estambul. Ahora se añade weight: "km":
{"$shortestPath": {"from": "ucuslar", "source": "$kod", "target": "GZT",
   "edgeFrom": "from", "edgeTo": "to", "undirected": true, "as": "rota", "costField": "maliyet",
   "weight": "km"}}
{"ok": true, "data": [{"kod": "TZX", "maliyet": 956.0, "rota": [
{"from": "TZX", "to": "ERZ", "km": 164}, {"from": "ERZ", "to": "VAN", "km": 249},
{"from": "DIY", "to": "VAN", "km": 281}, {"from": "GZT", "to": "DIY", "km": 262}]}]}Cuatro vuelos, pero solo 956 km: Trabzon, Erzurum, Van, Diyarbakır, Gaziantep. El array rota enumera en orden los documentos de arista desde el origen hasta el destino. Con undirected: true las aristas se pueden usar en cualquier sentido, pero los documentos se devuelven tal como están almacenados; por eso la arista {"from": "DIY", "to": "VAN"} aparece así aunque la ruta la recorriera de VAN a DIY. El sentido se deduce de la secuencia.
Los demás parámetros:
restrictSearchWithMatch: un filtro que se aplica a las aristas. La ruta más corta de Esmirna a Van pasa por Ankara, 1451 km (ADB, ESB, VAN). Excluir las aristas de Ankara con{"from": {"$nin": ["ESB"]}, "to": {"$nin": ["ESB"]}}la convierte en 1601 km pasando por Sabiha Gökçen y Erzurum.maxCost: la búsqueda se detiene en cuanto el coste supera este valor. La misma consulta de Esmirna a Van conmaxCost: 1200devolvió{"maliyet": null, "rota": []}. Como el heap siempre entrega el nodo más barato, una vez que la cima del heap supera el límite, todo lo demás también lo supera; detenerse es seguro.- Sin
undirected(por defecto esfalse), las aristas solo se pueden usar en el sentido en que están almacenadas. Mi red no tiene un camino dirigido de Trabzon a Gaziantep, así que la respuesta esmaliyet: null. - Que el origen sea igual al destino no es "inalcanzable", sino un camino de longitud cero: de
ISTaISTdamaliyet: 0.0,rota: [].
Por dentro: adyacencia perezosa
El Dijkstra en sí es de manual y el orden de asentamiento nunca se compromete: el heap siempre entrega el nodo no asentado más barato. Lo que se agrupa por lotes es la obtención de datos. Cuando la adyacencia del nodo más barato todavía no está en caché, se agrupa con hasta otros 63 nodos del heap cuya adyacencia no se ha obtenido, y todas sus aristas llegan en una sola consulta $in (dos cuando es undirected, una por sentido). Esa consulta pasa también por el mismo lookup_fn que $lookup y $graphLookup, así que los índices sobre edgeFrom y edgeTo sirven a la búsqueda. Una vez obtenida, la adyacencia se queda en caché.
"Perezosa" es la palabra clave: la colección de aristas nunca se carga entera en memoria. Solo se obtiene la adyacencia de los nodos que la búsqueda toca realmente. Si el destino está cerca, incluso una colección con millones de aristas cuesta solo unas pocas consultas.
La corrección de Dijkstra depende de que los pesos no sean negativos, y en lugar de suponerlo en silencio, lo compruebo:
invalid pipeline: $shortestPath: negative or non-finite weight -2 - Dijkstra requires non-negative weightsUna arista sin peso numérico también es un error:
invalid pipeline: $shortestPath: edge has no numeric 'ucret' weight: {"from":"TZX","to":"ERZ","km":164,"_id":21,"_version":1}Igual que un maxCost negativo ($shortestPath maxCost must be a non-negative number). Y, como $graphLookup, tiene un límite: 500.000 nodos asentados. Si se supera, de nuevo un error, con un mensaje que indica qué hacer: acotar la búsqueda con maxCost o restrictSearchWithMatch. No construí un grafo de 500.000 nodos para provocar este caso por separado; el valor está en el código fuente (MAX_SETTLED).
Límites y compromisos honestos
- Solo puntos. No se pueden almacenar líneas (LineString) ni polígonos en los documentos y preguntar "¿cruza esta carretera esta región?". Los polígonos existen en el lado de la consulta, no en el de los datos. Es un alcance consciente para la v1: la mayoría de los datos de ubicación son puntos (usuarios, vehículos, tiendas, sensores).
- Los polígonos son planos. Correctos a escala de geocerca, no a escala continental. Los polígonos de más de 180 grados de longitud se rechazan;
$boxno da la vuelta por el antimeridiano. - Solo un predicado geográfico por consulta usa el índice. Si una consulta tiene varios predicados geográficos, el primero produce los candidatos y el resto se comprueba durante la verificación. Combinarlo con un índice normal funciona bien, eso sí: después de indexar también
tur, el explain de{"tur": "kule", "konum": {"$near": ... 3 km}}mostró 2 candidatos; se intersecaron los conjuntos de candidatos de los dos índices. - Un
$nearsin límites implica un escaneo completo. Sin$maxDistanceel índice no puede calcular una cobertura; todos los documentos pasan a ser candidatos y después se ordenan. En colecciones grandes conviene dar siempre un límite de distancia o usarlo con unlimit. $nearordena en memoria. La ordenación se hace en memoria después de verificar el conjunto de candidatos. Es despreciable cuando la cobertura es pequeña, no en una consulta sin límites.- Las etapas de grafos se ejecutan por documento de entrada. Un
$graphLookupdespués de un$matchque devuelve 1000 documentos supone 1000 ejecuciones de BFS independientes. Primero hay que acotar. $shortestPathnecesita pesos no negativos. No hay Bellman-Ford para aristas negativas; se obtiene un error.- Un único camino más corto. Si varios caminos empatan, se devuelve uno; no hay k caminos más cortos ni todos los caminos.
Cómo encaja con el resto de OxiDB
Las consultas geográficas y de grafos no son un motor aparte, sino parte del lenguaje de consultas del motor de documentos. Por eso se combinan con naturalidad con todo lo demás: $group después de $geoNear, $lookup después de $graphLookup, en el mismo pipeline. Al fin y al cabo, una ubicación es un campo normal; las actualizaciones, los borrados y el mantenimiento de índices siguen el mismo camino que el resto del motor de documentos.
El mismo motor también se compila a WebAssembly. La demo del globo geográfico es eso, en directo: las localidades pobladas de GeoNames se cargan en OxiDB dentro de una pestaña del navegador, hacer clic en el globo ejecuta un $near real, arrastrar el control deslizante ejecuta $geoWithin con $centerSphere, y el modo de rutas ajusta dos clics al grafo de carreteras con $near y ejecuta $shortestPath (Dijkstra) como una sola agregación dentro de la pestaña. Sin servidor.
Para quien prefiera hablar Redis, la parte de OxiMem tiene comandos GEO de RESP como GEOADD, GEOSEARCH y GEODIST; allí seguí el propio diseño de Redis (una clave GEO es un sorted set cuya puntuación es un geohash de 52 bits). Para datos con marca de tiempo está el motor de series temporales, y si se prefiere escribir las consultas en SQL, el motor SQL. Los grafos de similitud y similares son tema del artículo sobre el motor de recomendaciones.
Pruébalo
OxiDB es un único binario. Lo más fácil es descargar la compilación para la plataforma correspondiente desde la página de releases de GitHub, o usar la imagen Docker. Se arranca el servidor, se indexa un campo de ubicación con create_geo_index y se prueban las consultas anteriores. Los grafos no necesitan ninguna configuración: los documentos ya son nodos y las referencias ya son aristas. Solo hay que acordarse de indexar los campos de conexión; la velocidad de $graphLookup y $shortestPath depende casi por completo de ello.
De aquí en adelante mantendré la regla de este artículo: cuando no pueda responder correctamente a una consulta, se obtendrá un error claro en lugar de una respuesta aproximada.