El motor de recomendación de OxiDB: contadores de coocurrencia en tiempo real y LLR
oxidb-rec, el cuarto motor de OxiDB: convierte las cestas en contadores a medida que llegan y puntúa "los clientes que compraron esto también compraron" con la LLR de Dunning. Buckets de tiempo, LLR a mano, la estructura en disco y pruebas con 12k pedidos en un servidor real.
"Los clientes que compraron esto también compraron" es una de las preguntas más habituales que una tienda le hace a su base de datos y, hasta ahora, casi todas las bases de datos la respondían de la misma manera: no la respondían. La aplicación hace un self-join de sus líneas de pedido, puntúa los pares y escribe el resultado en algún sitio, normalmente desde un proceso batch nocturno, así que la lista está desactualizada en cuanto existe. El cuarto motor de OxiDB, oxidb-rec, existe precisamente para cubrir ese hueco. Es un motor de recomendación item a item en tiempo real que convierte las cestas en contadores a medida que llegan, calcula las recomendaciones en el momento de la petición y las puntúa con la razón de verosimilitud logarítmica (LLR) de Dunning. En este artículo recorro el motor por dentro: el modelo de datos, los buckets de tiempo, por qué LLR es la opción por defecto (con un ejemplo calculado a mano), la estructura en disco, el protocolo de red y los límites. Todos los ejemplos provienen de un conjunto de datos sintético de una librería con 12,003 pedidos que cargué en un servidor OxiDB real; todos los números que aparecen son de esas sesiones.
¿Por qué un motor aparte?
El razonamiento está recogido en el ADR-0025, y su núcleo cabe en una frase: este trabajo no tiene forma de consulta, tiene forma de índice.
- La unidad es una cesta. No un documento ni una fila, sino un conjunto, cuyo significado reside por completo en qué otros artículos acompañan a cada miembro.
- La actualización es un incremento de contadores de pares. Aproximadamente |B|²/2 incrementos para una cesta de |B| artículos, con independencia del tamaño del catálogo. Nada en ella pide un planificador.
- La lectura es una ordenación parcial sobre una fila dispersa. El motor de documentos solo puede expresar eso como un recorrido completo de la colección.
- La puntuación es matemática del dominio. Tiene una respuesta correcta y muchas incorrectas, y si se deja en manos de quien llama, todos se equivocan de la misma manera (más abajo muestro cómo).
Meter esto a la fuerza en el motor de documentos significa almacenar una matriz N×N como documentos: 100 millones de celdas, casi todas a cero, con 10k artículos. Meterlo en el motor SQL significa volver al proceso batch nocturno del que intentamos escapar.
Dos aclaraciones de entrada. Esto no es búsqueda vectorial: OxiDB ya tiene un índice vectorial HNSW (artículo sobre búsqueda de texto completo y vectorial), que responde a "qué se parece a esto" a partir de un embedding que ha calculado otro. oxidb-rec responde a "qué se compra realmente junto a esto" a partir del comportamiento observado. Sin modelo, sin embedding, sin entrenamiento, y acierta desde el primer pedido. Tampoco es una consulta de grafos: con (customer)-[bought]->(item), dos saltos desde un superventas son millones de caminos (artículo sobre consultas geoespaciales y de grafos; los grafos brillan en vecindarios dispersos). Esto es una agregación sobre un vecindario denso, y la estructura adecuada para ello es un contador de adyacencia.
El algoritmo no es nuevo: es el filtrado colaborativo item a item de Amazon (Linden, Smith y York, 2003) más la LLR de Dunning (1993), la combinación que usa el ItemSimilarityJob de Apache Mahout. En producción suele ser un pipeline de Spark, una matriz de indicadores y Elasticsearch. Lo que todos ellos tienen en común es un ciclo de actualización entre el pedido y la recomendación. Lo construí como motor para eliminar ese ciclo, no para escribir las matemáticas una vez más.
Activación y configuración
El motor está desactivado por defecto y sigue el mismo patrón que los motores TSDB y SQL: una variable de entorno lo activa, tiene sus propios archivos, su propio WAL y su propia recuperación, y solo comparte con los demás motores el proceso, el puerto, la autenticación y el RBAC.
| Variable | Valor por defecto | Significado |
|---|---|---|
OXIDB_REC | desactivado | 1/true/yes/on activa el motor |
OXIDB_REC_DATA | ${OXIDB_DATA}/rec | Directorio de la base de datos por defecto (las demás bases de datos viven en ${OXIDB_DATA}/<db>/rec) |
OXIDB_REC_BUCKET_SECS | 2592000 (30 días) | Anchura de un bucket de tiempo; la ventana es de 8 buckets |
OXIDB_REC_MAX_BASKET | 50 | Las cestas más grandes no se cuentan y se notifican como baskets_skipped |
OXIDB_REC_CHECKPOINT_BYTES | 8 MiB | Checkpoint automático cuando el WAL supera este tamaño (0 = solo manual) |
Así arranqué el servidor para este artículo. Mi conjunto de datos es semanal, así que fijé la anchura del bucket en una semana (604800 segundos) y bajé el umbral de checkpoint a 256 KiB para que de verdad se produjeran checkpoints:
OXIDB_ADDR=127.0.0.1:16100 \
OXIDB_DATA=./data \
OXIDB_REC=1 OXIDB_SQL=1 \
OXIDB_REC_BUCKET_SECS=604800 \
OXIDB_REC_CHECKPOINT_BYTES=262144 \
./oxidb-server
El motor se abre de forma perezosa: el directorio se crea con la primera petición rec, y el log muestra:
[oxidb] recommendation engine enabled (default db at ./data/rec)Sin OXIDB_REC, la respuesta es explícita:
{"ok": false, "error": "recommendation engine is not enabled (set OXIDB_REC=1)"}El protocolo de red: un comando, cinco operaciones
El protocolo nativo de OxiDB es JSON con prefijo de longitud sobre TCP: una longitud de 4 bytes en little-endian seguida del cuerpo JSON. Las peticiones al motor de recomendación llevan "engine": "rec" (o el reservado "cmd": "rec"), y un campo op selecciona la acción. El enrutamiento está en el mismo punto del handler que SQL y TSDB; las peticiones sin campo engine siguen tomando la ruta de documentos byte a byte igual que antes.
| op | Qué hace | Permiso |
|---|---|---|
track | Ingiere una cesta en un modelo (idempotente por id de cesta) | escritura |
related | Los artículos más asociados con un artículo | lectura |
for_basket | Los artículos más asociados con un conjunto (la página del carrito) | lectura |
stats | Modelos, artículos, pares, cestas, cestas omitidas, estimación de memoria | lectura |
checkpoint | Incorpora el WAL a una nueva generación de snapshot | escritura |
Parámetros de consulta: scoring (llr por defecto; cosine, jaccard, lift, count), half_life (en buckets, 2 por defecto, 0 = sin decaimiento), min_support (1 por defecto), limit (10 por defecto). ts es opcional en todas las peticiones, en segundos epoch; sin él se usa el reloj del servidor. El motor en sí no tiene reloj: el "ahora" entra en el puente, lo que mantiene deterministas los tests y la reproducción del WAL.
Para los ejemplos basta con un cliente de Python mínimo de 15 líneas:
import json, socket, struct

class Oxi:
    def __init__(self, port=16100):
        self.s = socket.create_connection(("127.0.0.1", port))
    def call(self, req):
        b = json.dumps(req).encode()
        self.s.sendall(struct.pack("<I", len(b)) + b)
        n = struct.unpack("<I", self._read(4))[0]
        return json.loads(self._read(n))
    def _read(self, n):
        buf = b""
        while len(buf) < n:
            buf += self.s.recv(n - len(buf))
        return buf
    def rec(self, **kw):
        return self.call({"engine": "rec", "cmd": "rec", **kw})
El conjunto de datos: ocho semanas de una librería
Para una prueba realista generé ocho semanas de una librería online sintética con 1,500 pedidos por semana (semilla fija, script reproducible) y planté algunas asociaciones a propósito:
- Sagas: aproximadamente la mitad de quienes compran
dunetambién comprandune-messiah, y algunos compranchildren-of-dune. Está la cadenathe-hobbit→lotr-fellowship→two-towers→return-of-the-king,rust-book→rust-atomics/zero-to-production,sapiens→homo-deus→21-lessons, etc. - Temas: ciencia ficción, fantasía, programación, historia, cocina, libros infantiles. Los libros del mismo tema tienen una asociación débil pero real.
- Superventas independientes del contenido:
bookmark-setse añade a más de un tercio de todos los pedidos, ygift-wrapyreading-lighten proporciones menores. Junto a qué se añaden no importa en absoluto. - Una asociación que cambia con el tiempo:
the-martianse compra conartemisdurante las seis primeras semanas y con el recién publicadoproject-hail-maryen las dos últimas. - Coincidencias:
haiku-anthologyyknitting-patterns, que no aparecen en ningún otro lugar del catálogo, se compraron juntos en un único pedido.dune-tarot-deckse compró dos veces, ambas condune. - Una cola larga: 400 títulos con distribución de Zipf (
title-001...title-400).
El resultado: 12,003 pedidos, 448 artículos distintos, 3.2 artículos por cesta de media. Los envié en orden temporal, por una sola conexión, como llamadas track secuenciales:
for r in rows:
    o.rec(op="track", model="purchase", basket_id=r["basket_id"],
          items=r["items"], ts=r["ts"])
12003 track calls, 12003 counted, 0.35 s, 34173 baskets/sEso se midió en un Mac con Apple M4, por una conexión local, en un momento tranquilo. Cuando repetí la misma carga mientras otros procesos de la máquina hacían mucho trabajo de fsync, tardó entre 9 y 15 segundos, y sample mostró casi todo el tiempo dentro de la llamada al sistema write(). Cada track escribe una línea del WAL y la vuelca al sistema operativo, así que la velocidad de ingesta es sensible a la contención de disco; el trabajo propio del motor es barato.
stats después:
{
 "catalogue_items": 448,
 "bucket_secs": 604800,
 "buckets": 8,
 "generation": 5,
 "wal_bytes": 73966,
 "models": {
  "purchase": {
   "items": 448,
   "pairs": 19362,
   "baskets": 12003,
   "baskets_skipped": 0,
   "saturated_counters": 0,
   "approx_bytes": 1776848
  }
 }
}
generation: 5 significa que el umbral de 256 KiB disparó cinco checkpoints automáticos durante la carga. pairs: 19362 cuenta las filas de pares en ambas direcciones (9,681 pares distintos), y approx_bytes es una estimación aproximada de la memoria de los mapas de contadores, unos 1.8 MB.
Primeras recomendaciones: conteos brutos frente a LLR
Ahora la pregunta de verdad: ¿qué deberíamos recomendar a alguien que compra dune? Primero por conteo bruto de coocurrencias (scoring: "count") y después con la LLR por defecto. Para que la comparación sea limpia desactivé el decaimiento con half_life: 0:
{"engine": "rec", "cmd": "rec", "op": "related", "model": "purchase",
 "item": "dune", "scoring": "count", "half_life": 0, "limit": 6, "ts": 1771459199}
{"ok": true, "data": {"recommendations": [
{"item": "dune-messiah", "score": 440.0},
{"item": "children-of-dune", "score": 396.0},
{"item": "bookmark-set", "score": 250.0},
{"item": "foundation", "score": 144.0},
{"item": "snow-crash", "score": 143.0},
{"item": "hyperion", "score": 136.0}]}}La misma petición con "scoring": "llr":
{"ok": true, "data": {"recommendations": [
  {"item": "dune-messiah", "score": 2835.72581039503},
  {"item": "children-of-dune", "score": 2510.829224631947},
  {"item": "snow-crash", "score": 209.64968031286844},
  {"item": "foundation", "score": 202.3380715753883},
  {"item": "hyperion", "score": 173.2231380022422},
  {"item": "neuromancer", "score": 164.29420415742788}]}}
Por conteo bruto, bookmark-set es tercero: aparece con dune en 250 pedidos. En la lista LLR no aparece en absoluto; su lugar lo ocupa ciencia ficción del mismo tema. El juego de marcapáginas está en 4,491 pedidos, uno de cada tres. Estar también en un tercio de los pedidos de dune no es una asociación, es la tasa base. Los conteos brutos no pueden notar la diferencia, así que ponen el superventas en todas las listas. El mismo patrón se repite con otros libros:
the-hobbit  count: lotr-fellowship 472, bookmark-set 290, two-towers 283, ...
the-hobbit  llr:   lotr-fellowship 2808.7, two-towers 1597.1, return-of-the-king 1025.1, ...
rust-book   count: rust-atomics 238, zero-to-production 188, bookmark-set 154, ...
rust-book   llr:   rust-atomics 1704.7, zero-to-production 1316.8, ddia 338.5, database-internals 312.6, ...
Para the-hobbit, LLR alinea la trilogía completa mientras que el conteo bruto cuela el juego de marcapáginas en medio. Para ir más allá de un par de ejemplos, comprobé en qué posición queda bookmark-set para cada uno de 27 libros:
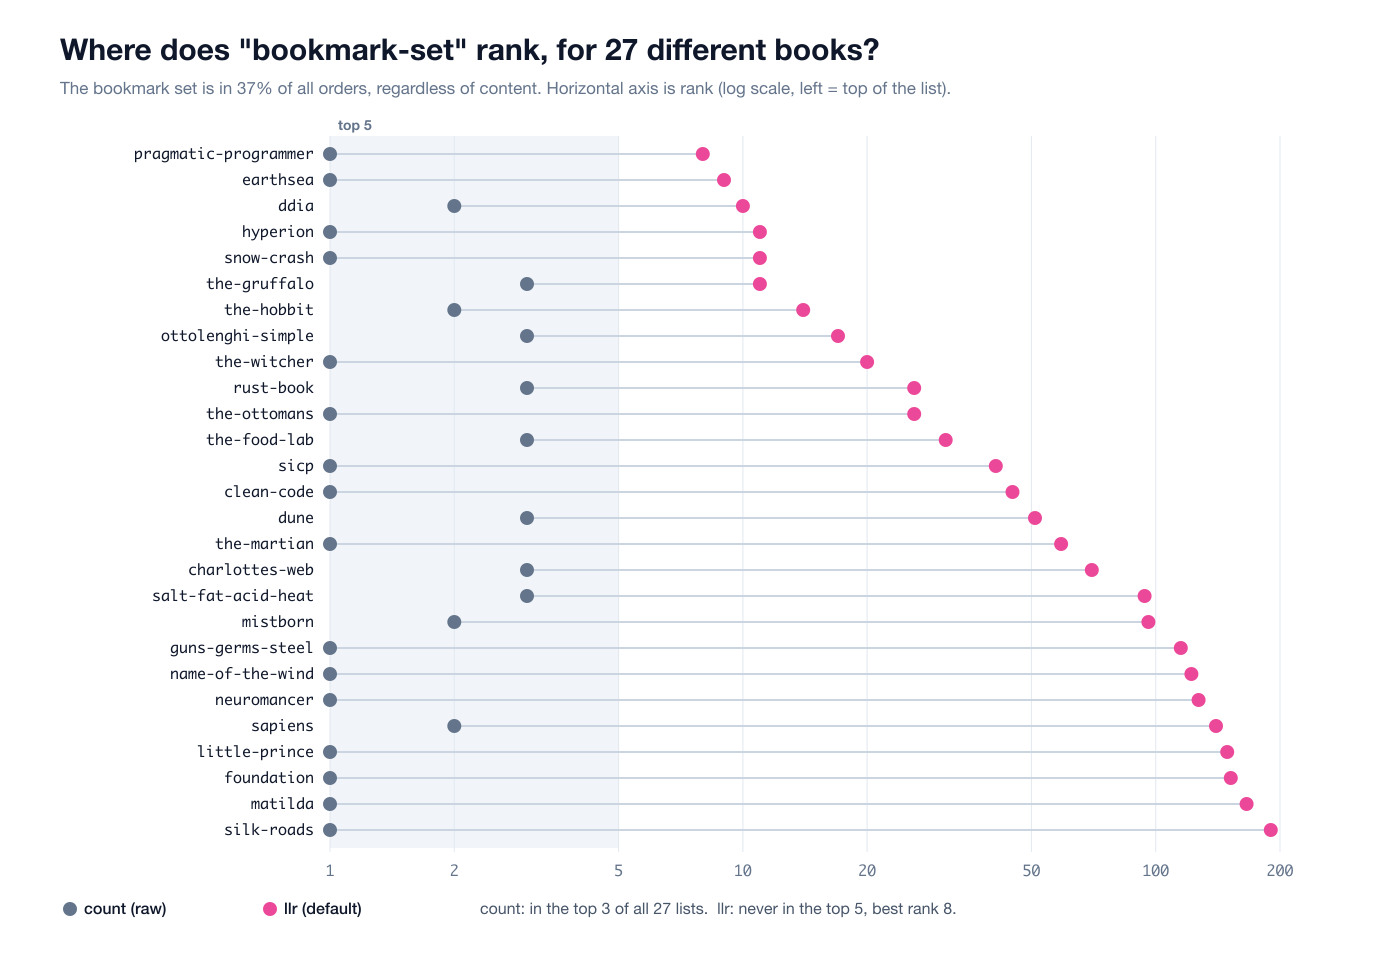
Con el conteo bruto, el juego de marcapáginas es primero en 16 de las 27 listas y está entre los tres primeros en todas. Con LLR nunca está entre los cinco primeros; su mejor posición es la 8, y en ocho listas está más allá del puesto 100. Una tienda que escribe "quienes compraron esto también compraron un marcapáginas" en cada página de producto tiene técnicamente razón y es completamente inútil.
Cómo funciona LLR: la tabla 2×2 y un cálculo a mano
La pregunta que se hace LLR es: dadas las tasas base, ¿cuánto debería sorprendernos esta coocurrencia? Para cada par candidato (x, y) construye una tabla de contingencia 2×2:
| y presente | y ausente | |
|---|---|---|
| x presente | k11 = co(x,y) | k12 = n(x) - co |
| x ausente | k21 = n(y) - co | k22 = N - n(x) - n(y) + co |
N es el número total de cestas, n(x) las cestas que contienen x, co(x,y) las que contienen ambos. El estadístico G² de Dunning compara la tabla observada con la que cabría esperar si x e y fueran independientes. Una celda esperada es el total de su fila por el total de su columna dividido entre N, y:
G² = 2 · Σ O · ln(O / E) (over the four cells, a term is 0 when O = 0)El motor calcula lo mismo en la forma equivalente basada en entropía:
fn xlogx(x: f64) -> f64 { if x <= 0.0 { 0.0 } else { x * x.ln() } }
fn entropy2(a: f64, b: f64) -> f64 { xlogx(a + b) - xlogx(a) - xlogx(b) }

pub fn llr(co: f64, n_x: f64, n_y: f64, total: f64) -> f64 {
    let k11 = co;
    let k12 = (n_x - co).max(0.0);
    let k21 = (n_y - co).max(0.0);
    let k22 = (total - n_x - n_y + co).max(0.0);
    let row_e = entropy2(k11 + k12, k21 + k22);
    let col_e = entropy2(k11 + k21, k12 + k22);
    let cell_e = entropy4(k11, k12, k21, k22);
    (2.0 * (row_e + col_e - cell_e)).max(0.0)
}
Todo se hace en f64, porque los conteos pasan a ser fraccionarios en cuanto se aplica el decaimiento, y el resultado se acota en cero, ya que el error de coma flotante cerca de la independencia puede volverlo ligeramente negativo.
Calculemos a mano dos pares del conjunto de datos. Conté los números brutos por separado a partir del archivo de datos en Python: N = 12,003, dune está en 707 cestas, dune-messiah en 440 (todas ellas contienen también dune), y bookmark-set en 4,491, de las cuales 250 contienen dune.
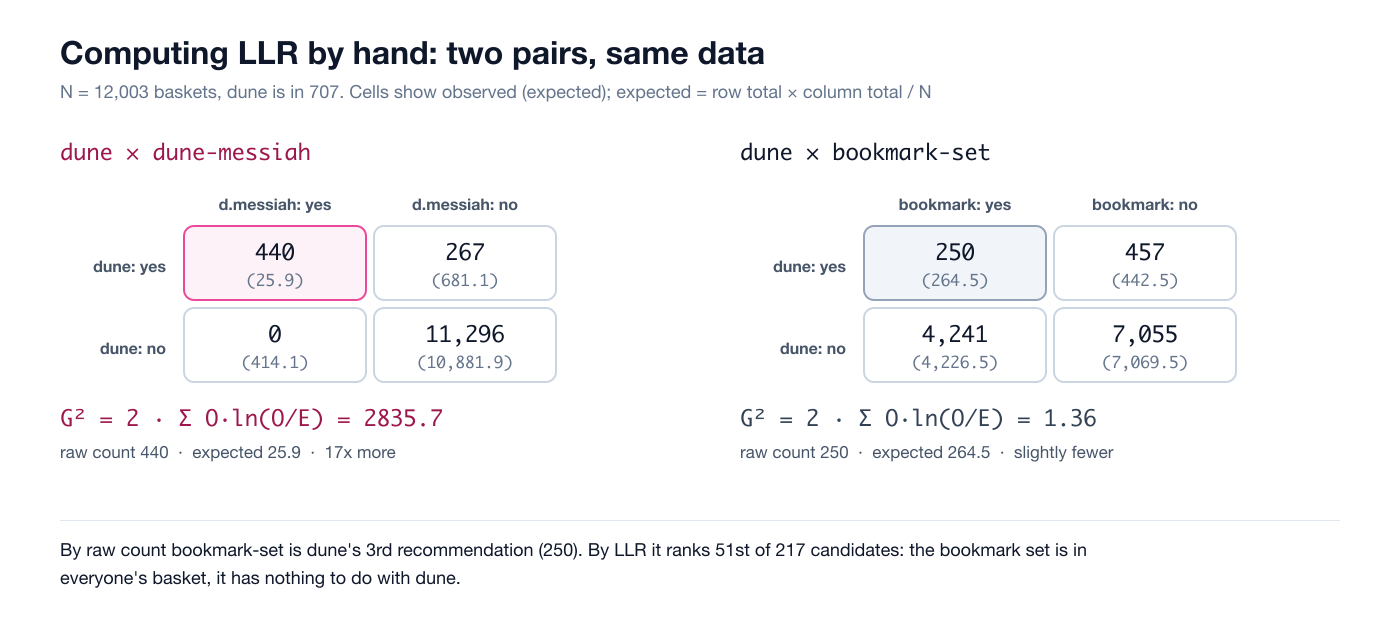
dune × dune-messiah. Si fueran independientes, la coocurrencia esperada sería 707 × 440 / 12,003 = 25.9; el valor observado es 440, diecisiete veces más. Los cuatro términos: 440·ln(440/25.9) = 1246.03; 267·ln(267/681.1) = -250.03; k21 = 0, así que ese término es 0; 11,296·ln(11,296/10,881.9) = 421.86. La suma es 1417.86, y el doble es 2835.7.
dune × bookmark-set. Coocurrencia esperada 707 × 4,491 / 12,003 = 264.5; observada 250, ligeramente menos de lo esperado. Los términos son -14.12, 14.76, 14.55 y -14.51; la suma es 0.68, y el doble es 1.36.
Comparé estos valores con lo que devolvió el servidor: 2835.72581039503 para dune-messiah y 1.3646498105954379 para bookmark-set. Mi cálculo independiente en Python coincidió exactamente. Por conteo bruto son 440 frente a 250, la misma liga; por LLR son 2835 frente a 1.4, ninguna relación en absoluto. bookmark-set queda en el puesto 51 de 217 candidatos en la lista LLR.
Las trampas de cosine y lift
El motor admite los cinco modos de puntuación y, como los contadores se almacenan en bruto, cambiar de modo es un parámetro y no una reconstrucción. Eso facilita ver dónde fallan los otros modos, sobre los mismos datos.
Cosine es co / sqrt(n(x)·n(y)). Tomemos la coincidencia plantada: haiku-anthology y knitting-patterns aparecen cada uno una sola vez en todo el catálogo, en el mismo pedido.
{"op": "related", "model": "purchase", "item": "haiku-anthology", "scoring": "cosine", "half_life": 0}
{"ok": true, "data": {"recommendations": [
  {"item": "knitting-patterns", "score": 1.0},
  {"item": "bookmark-set", "score": 0.014922049367861507}]}}
1.0 es la puntuación más alta que puede dar cosine. Como comparación, la asociación real más fuerte de la tienda, dune → dune-messiah, obtiene 0.789 con cosine. Así que cosine considera una única coincidencia más "relacionada" que una relación de saga respaldada por 440 pedidos, simplemente porque el denominador es tan pequeño como el numerador. LLR le da a esa misma coincidencia 20.8, dos órdenes de magnitud por debajo del 2835 de dune-messiah. No es exactamente cero, porque una observación frente a una expectativa de 0.00008 es estadísticamente algo. min_support existe para eliminarla por completo:
{"op": "related", "model": "purchase", "item": "haiku-anthology", "half_life": 0, "min_support": 2}
{"ok": true, "data": {"recommendations": []}}
Lift es co·N / (n(x)·n(y)). Los tres primeros de la lista lift para dune:
{"item": "children-of-dune", "score": 16.97736916548798},
{"item": "dune-messiah", "score": 16.97736916548798},
{"item": "dune-tarot-deck", "score": 16.97736916548798}
Los tres empatan, porque los tres se compraron siempre con dune. A lift le da igual que eso ocurriera 440 veces o dos, así que dune-tarot-deck (dos ventas en total) aterriza junto a las secuelas. Con LLR, dune-tarot-deck es décimo con 11.3: hay evidencia, pero poca. Jaccard produjo ordenaciones cercanas a LLR en este conjunto de datos. En la validación del ADR con datos reales, cosine también coincidía en gran medida con LLR en los artículos de cabeza y divergía en los de poco volumen. La diferencia aparece justo donde la evidencia es escasa, que es donde viven la mayoría de las listas de recomendación.
La página del carrito: for_basket
Recomendar a partir de un solo artículo es la forma útil más débil. La conversión ocurre en la página del carrito, y por eso for_basket forma parte de la v1. La puntuación de cada candidato se suma a lo largo de los miembros de la cesta; los artículos de la propia cesta y la lista exclude nunca aparecen:
{"op": "for_basket", "model": "purchase", "items": ["dune", "rust-book"],
 "exclude": ["dune-messiah"], "limit": 6, "ts": 1771459199}
{"ok": true, "data": {"recommendations": [
{"item": "children-of-dune", "score": 1006.2434574795043},
{"item": "rust-atomics", "score": 719.6690210232482},
{"item": "zero-to-production", "score": 509.19681360899995},
{"item": "ddia", "score": 129.83592528033478},
{"item": "database-internals", "score": 107.594666573641},
{"item": "clean-code", "score": 102.12004133801383}]}}Excluí dune-messiah (supongamos que el cliente ya lo tiene), y la lista atiende a ambos intereses. Aquí no pasé half_life, así que se aplica el decaimiento por defecto de 2 buckets, y por eso las puntuaciones son más bajas que en el ejemplo de related.
Si se pregunta por un artículo desconocido, el motor devuelve una lista vacía:
{"op": "related", "model": "purchase", "item": "no-such-book"}
{"ok": true, "data": {"recommendations": []}}
Es deliberado: un motor sin evidencia no debería disfrazar "no tengo evidencia" de "aquí tienes una recomendación". Si se quiere una alternativa, como los superventas, la elige la aplicación.
Dentro del motor: rutas de escritura y de lectura
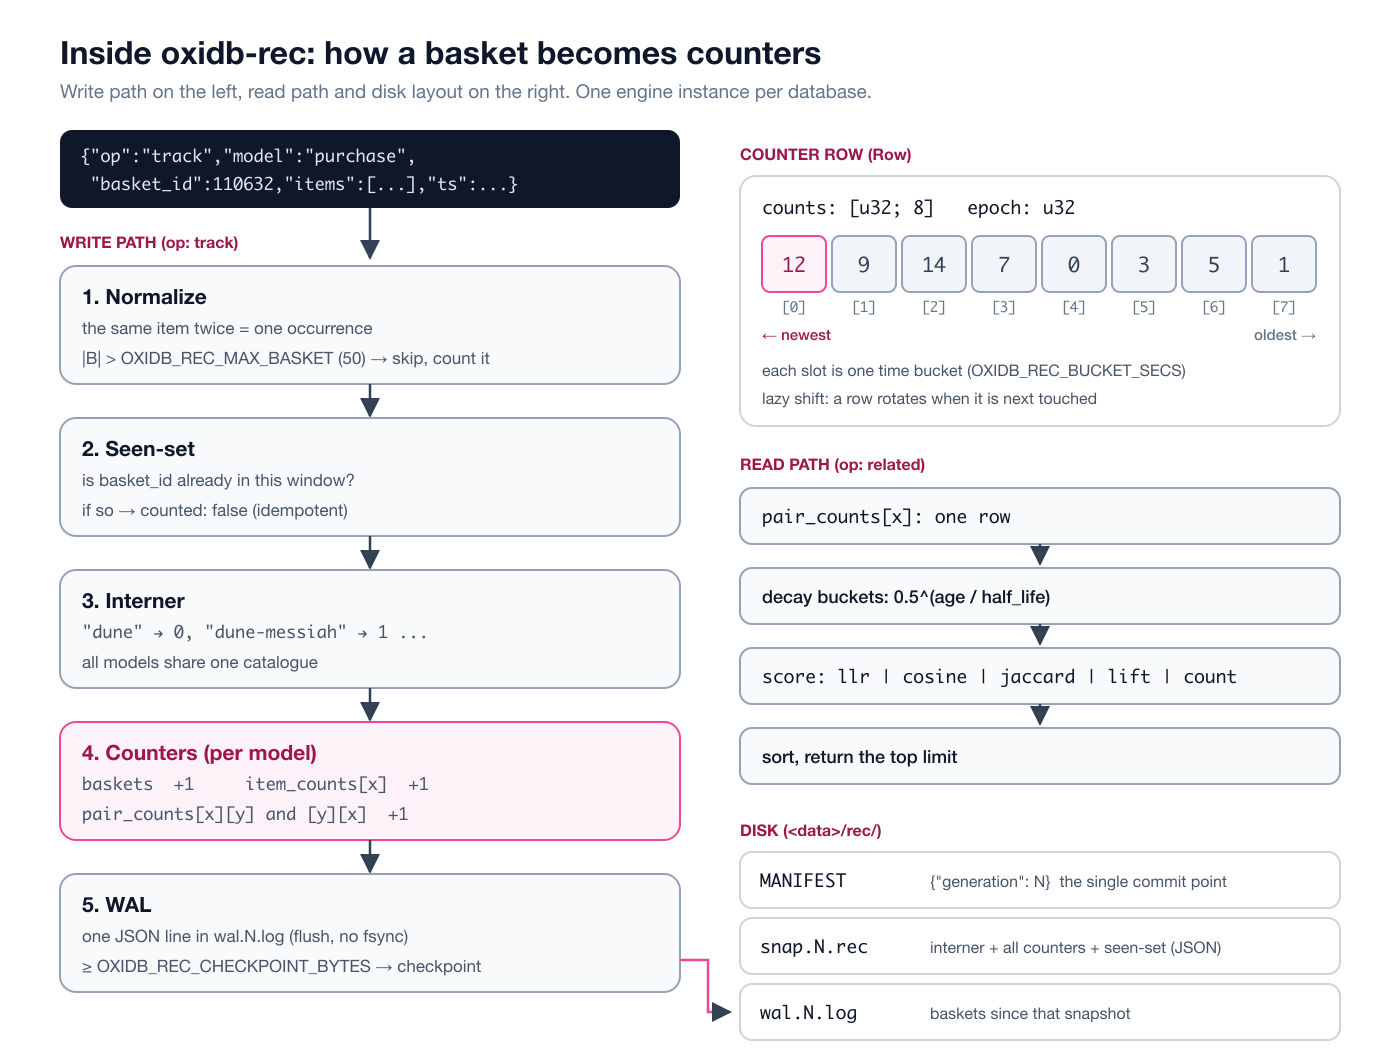
Hasta ahora hemos usado el motor desde fuera. Las secciones siguientes tratan de sus entrañas; el diagrama de abajo muestra de un vistazo cómo una petición track se convierte en contadores, cómo una petición related se convierte en una lista puntuada y qué vive en disco:
El tiempo: ocho buckets, desplazamiento perezoso y half_life
Los contadores no son números sueltos; están divididos en buckets de tiempo. Cada fila es un array de tamaño fijo:
pub struct Row {
    pub counts: [u32; BUCKETS],   // BUCKETS = 8
    pub epoch: u32,               // the period counts[0] belongs to
}
El periodo es simplemente ts / bucket_secs. Con el bucket por defecto de 30 días la ventana es de 240 días; en mi configuración semanal, de ocho semanas. Usar [u32; 8] en lugar de un Vec es deliberado: con unos pocos millones de pares, solo la cabecera de 24 bytes de un Vec pesaría más que los conteos a los que apunta. Una fila ocupa 36 bytes.
La decisión de diseño más interesante es que el desplazamiento es perezoso. En lugar de recorrer todo el mapa y mover cada contador una posición cuando empieza un periodo nuevo, cada fila lleva su propio epoch y se desplaza en su siguiente acceso (una escritura o una lectura) tantos periodos como lleve de retraso: una rotación de array O(8) por fila. En el primer borrador del ADR el desplazamiento se hacía de forma inmediata en la frontera del periodo, lo que supone un recorrido completo bajo el bloqueo de escritura. Una vez al mes con la anchura por defecto, pero con millones de pares una petición cualquiera habría cargado con una parada de varios segundos. El desplazamiento perezoso elimina esa pausa por completo; el coste es una comparación de u32 por cada acceso a una fila. Las filas que nadie toca se quedan desactualizadas, pero el checkpoint las recorre de todas formas y no escribe las filas que han decaído a todo ceros. El checkpoint hace también de recolector de basura.
Para ver la ventana en acción, hice la misma consulta con valores de ts en el futuro: ahora, cuatro semanas después y ocho semanas después:
ts = now          → dune-messiah 440, children-of-dune 396
ts = +4 weeks     → dune-messiah 228, children-of-dune 201
ts = +8 weeks     → []
Cuatro semanas después, los buckets de las cuatro primeras semanas han salido de la ventana; ocho semanas después, no queda nada. Sin borrados, sin barridos, solo aritmética de periodos.
En el lado de la lectura, los buckets se ponderan con una semivida exponencial: un bucket con una antigüedad de age periodos se multiplica por 0.5^(age / half_life). half_life es un parámetro de consulta, así que "lo que sube junto ahora mismo" es una consulta, no un pipeline aparte. Así se ve con the-martian del conjunto de datos:
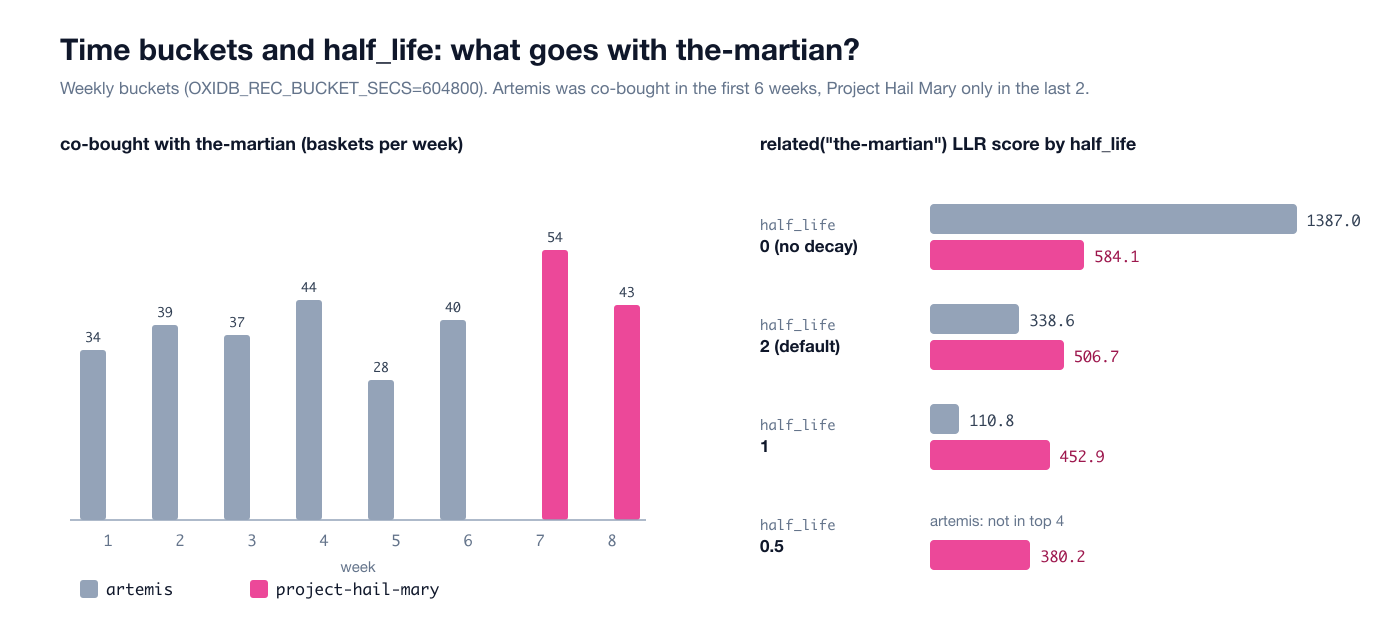
half_life 0   → artemis 1387.0, project-hail-mary 584.1, snow-crash 207.7, hyperion 168.1
half_life 2   → project-hail-mary 506.7, artemis 338.6, snow-crash 84.4
half_life 1   → project-hail-mary 452.9, artemis 110.8, snow-crash 54.8, hyperion 44.5
half_life 0.5 → project-hail-mary 380.2, snow-crash 39.8, children-of-dune 33.6, hyperion 29.4
Sin decaimiento, ganan las seis semanas de historial de artemis. Con el half_life: 2 por defecto, el libro nuevo de las dos últimas semanas pasa por delante, pero artemis sigue en la lista. Con medio bucket, artemis desaparece por completo de los cuatro primeros, y el precio es el ruido (children-of-dune aparece para the-martian), porque la muestra efectiva se reduce a las últimas semanas. El half_life adecuado depende del dominio: corto para moda, largo para B2B. En ningún caso hace falta una reconstrucción.
Contadores y estructura en memoria
Cada modelo (un espacio de eventos con nombre, como purchase, view, cart) contiene:
pub struct Model {
    baskets: Row,                                  // total baskets per period
    item_counts: HashMap<u32, Row>,                // baskets containing x
    pair_counts: HashMap<u32, HashMap<u32, Row>>,  // baskets containing x and y
    seen: [HashSet<u64>; BUCKETS],                 // basket ids seen per period
    seen_epoch: u32,
    baskets_total: u64, baskets_skipped: u64, saturated: u64,
}
Los artículos llegan como cadenas y se internan como u32. Hay un interner por base de datos, compartido por todos los modelos, porque el catálogo es el mismo catálogo. Las visualizaciones y las compras son señales distintas con tasas base distintas, así que se cuentan en modelos separados y nunca se mezclan.
Las filas de pares se almacenan en ambas direcciones. Eso duplica la memoria de los contadores, pero convierte related(x) en una única búsqueda de fila, que es la ruta crítica. La alternativa (solo el orden x < y) reduce la memoria a la mitad y convierte cada consulta en un recorrido. El ADR presupuesta aproximadamente distinct_pairs × 2 × 36 bytes más la sobrecarga del mapa, unos 72 MB con un millón de pares distintos. La memoria crece con la diversidad del catálogo, no con el número de pedidos, y por eso stats la informa de antemano como approx_bytes.
Los contadores se saturan ante un desbordamiento de u32 en lugar de dar la vuelta, y stats informa de cualquier saturación como saturated_counters. Un conteo clavado en el techo sesga una puntuación; uno que da la vuelta la invierte.
Dos salvaguardas de ingesta e idempotencia
Límite de tamaño de cesta (50 por defecto). Un pedido de 500 líneas son 125,000 incrementos y casi siempre es una importación masiva o un fixture de test: no aporta señal de preferencia, pero dominaría los contadores. Una cesta que supera el límite no se descarta en silencio, se contabiliza:
{"op": "track", "model": "purchase", "basket_id": 900001, "items": ["title-001", "...60 items..."]}
{"ok": true, "data": {"counted": false}}
Después, stats muestra "baskets_skipped": 1.
Los duplicados dentro de una cesta cuentan como una sola aparición. La deduplicación se ejecuta antes de la comprobación de tamaño, así que un pedido de 60 líneas con 40 artículos distintos está dentro del límite:
{"op": "track", "model": "view", "basket_id": 1, "items": ["dune", "dune", "dune-messiah"]}
{"ok": true, "data": {"counted": true}}
{"op": "related", "model": "view", "item": "dune", "scoring": "count"}
{"ok": true, "data": {"recommendations": [{"item": "dune-messiah", "score": 1.0}]}}
Idempotencia. track es idempotente por id de cesta: el mismo pedido enviado dos veces cuenta una vez. Volví a enviar el último pedido del conjunto de datos:
{"op": "track", "model": "purchase", "basket_id": 111237, "items": ["title-007"], "ts": 1771458725}
{"ok": true, "data": {"counted": false}}
El conjunto de ids vistos que hay detrás también está dividido en buckets, como todo lo demás: los ids de cesta se guardan por periodo y, cuando un periodo sale de la ventana, sus ids salen con él. Por tanto, la ventana de idempotencia es igual a la ventana de conteo, y el conjunto está acotado por una ventana de cestas en lugar de crecer durante toda la vida del modelo. Un conjunto de vistos sin límite habría sido el equivalente, en este motor, del error del índice residente.
En disco: MANIFEST, snapshot y WAL
El directorio rec/ de cada base de datos contiene tres tipos de archivos, con la misma disciplina que el motor TSDB (artículo sobre series temporales):
MANIFEST        {"generation": N}: the authoritative generation
snap.N.rec      interner + all model counters + seen-set
wal.N.log       baskets ingested since that snapshot, one JSON per line
El directorio después de la carga:
-rw-r--r--  16       MANIFEST
-rw-r--r--  1008926  snap.5.rec
-rw-r--r--  73966    wal.5.log
Un registro del WAL es exactamente la cesta que envió el cliente:
{"model":"purchase","basket_id":110632,"items":["21-lessons","bookmark-set","homo-deus","sapiens","silk-roads","the-ottomans","title-007","title-041"],"ts_secs":1771203773}Un checkpoint escribe snap.N+1 en un archivo temporal, hace fsync y lo renombra, abre el WAL nuevo y después renombra atómicamente el MANIFEST. Ese rename es el único punto de commit. Un fallo antes de él se recupera desde N; después de él, la generación antigua se elimina. Al abrir, se barren los archivos snap.* y wal.* que el MANIFEST no nombra; de lo contrario, cada fallo dejaría atrás una pareja huérfana.
La recuperación es la carga del snapshot más la reproducción del WAL, y aquí la idempotencia vuelve a rendir frutos: como el conjunto de vistos está dentro del snapshot, reproducir registros que el snapshot ya contiene no tiene ningún efecto. El WAL no necesita registros de commit ni disciplina de truncado. Una última línea cortada (un fallo a mitad de una escritura) se omite en lugar de tratarse como error; ese registro nunca se confirmó como duradero. Cuando detuve y reinicié el servidor, stats volvió idéntico y related("dune") devolvió las mismas puntuaciones.
Un checkpoint manual y el uso de disco:
{"engine": "rec", "cmd": "rec", "op": "checkpoint", "ts": 1771459199}
{"ok": true, "data": {"ok": true}}
{"cmd": "disk_usage"}
{"ok": true, "data": {"path": ".../data", "total_bytes": 1075232, "engines": {"documents": 260, "documents_mmap": 260, "sql": 0, "tsdb": 0, "rec": 1074972, "blobs": 0, "oximem": 0, "messaging": 0, "fts": 0, "pitr_archive": 0, "system": 0}}}
Una salvaguarda más: la anchura del bucket se guarda en el snapshot y se comprueba al abrir. Los periodos son ts / bucket_secs, así que abrir con una anchura distinta reinterpretaría en silencio el periodo de cada contador. Cuando intenté abrir un directorio escrito con buckets semanales usando OXIDB_REC_BUCKET_SECS=86400, el motor se negó (acorté el final del mensaje):
failed to open rec engine for database "oxidb": bucket_secs mismatch: snapshot has 604800, config wants 86400 ...Para dejar clara la durabilidad: el WAL se vuelca al sistema operativo después de cada registro, pero no se hace fsync. Eso es seguro frente a la caída del proceso; ante un corte de corriente se pueden perder las cestas desde el último checkpoint. El checkpoint automático (OXIDB_REC_CHECKPOINT_BYTES) acota el tiempo de reproducción. Para contadores de recomendación, este es un compromiso deliberado de la v1: unos segundos de pedidos que faltan son invisibles en cualquier lista.
Rendimiento
De nuevo un Mac con Apple M4, conexión local, cliente de Python con una sola conexión, 2,000 repeticiones de cada:
related x2000: 36 us per call (round trip)
for_basket x2000: 48 us per call (round trip)
ping x2000: 13 us per call
Un ping vacío tarda 13 µs, así que el coste en el servidor de una consulta related de un solo artículo ronda los 20 µs: puntuar una fila de 217 candidatos, ordenarla y serializar el JSON. Un for_basket de tres artículos tarda 48 µs. Son números de mi pequeño conjunto de datos; la longitud de la fila crece linealmente con el número de candidatos. La validación con datos reales del ADR del proyecto (UCI Online Retail, 541k líneas de pedido) compara la calidad de las listas entre modos de puntuación, no la velocidad.
Acceso desde SQL y procedimientos almacenados
El motor tiene una segunda puerta de entrada: los métodos db.rec_* dentro de los procedimientos almacenados LANGUAGE COBRA (artículo sobre el motor SQL). Pasan por la misma función de despacho que el protocolo de red, así que un procedimiento y un cliente reciben la misma validación y la misma respuesta. Envolví la recomendación de la página del carrito en un procedimiento:
# CREATE PROCEDURE cart_recs(a TEXT, b TEXT) LANGUAGE COBRA
def run(db, a, b)
    let out = db.rec_for_basket({"model": "purchase", "items": [a, b], "limit": 3, "ts": 1771459199})
    return out["recommendations"]
end
Después de compilarlo con cobra build --portable y cargarlo como base64 con CREATE PROCEDURE ... LANGUAGE COBRA AS '...':
{"engine": "sql", "cmd": "sql", "sql": "CALL cart_recs('the-hobbit', 'sapiens')"}
{"ok": true, "data": [{"columns": ["item", "score"], "types": [null, null],
  "rows": [["lotr-fellowship", 1130.2998390605499], ["homo-deus", 742.2844136386848], ["two-towers", 664.9649628103361]]}]}
Las recomendaciones vuelven como filas SQL. El mismo procedimiento que escribe en una tabla de pedidos podría también pasar la cesta al motor de recomendación con db.rec_track.
Límites y notas honestas
No se replica en un clúster. En un clúster Raft, track es una escritura, pero no se replica a través de Raft; comparte esa carencia con TSDB. Cada nodo acumula solo las cestas que ha recibido, y las respuestas de related pueden diferir de un nodo a otro. El ADR lo recoge como una decisión, no como un descubrimiento. Las dos propiedades que abaratan la solución ya están ahí: track es idempotente (basta con una entrega at-least-once) y el estado es un contador conmutativo (las réplicas convergen con cualquier intercalado).
No es personalización. La coocurrencia responde a "qué va con esto", no a "qué debería ver esta persona a continuación".
LLR es bilateral. G² no distingue entre "más de lo esperado" y "menos de lo esperado", y la implementación del motor no comprueba el signo. En mi conjunto de datos, bookmark-set salió octavo para pragmatic-programmer: coocurrencia 139, expectativa bajo independencia 164.3. La asociación es en realidad negativa, pero la puntuación es positiva, aunque pequeña (6.59). Como la puntuación se mantiene baja, no aparece en las listas cortas; puede aparecer en la cola de las largas.
Diferencias entre el ADR y la v1. El ADR describe el snapshot como un formato binario; en la v1, snap.N.rec es JSON (mi snapshot de 1 MB era un archivo JSON legible). El parámetro fallback: "popular" y las operaciones backup/restore/retention que menciona el ADR no están en la superficie del protocolo de esta versión; el puente conoce track, related, for_basket, stats y checkpoint. Una operación desconocida se rechaza con un error claro:
{"engine": "rec", "cmd": "rec", "op": "retention"}
{"ok": false, "error": "unknown rec op: \"retention\" (track, related, for_basket, stats, checkpoint)"}
Un bug que encontré mientras escribía este artículo: cestas tardías. Ejecuté por accidente mi script de carga dos veces y, en la segunda pasada, las 12,003 cestas volvieron a responder counted: true. La causa: Row::roll_to y el desplazamiento del conjunto de vistos suponen que el nuevo periodo es mayor o igual que el epoch actual. Eso solo lo protege un debug_assert!; en una compilación release, la resta now - epoch sufre un underflow como u32 y da un número enorme, que se interpreta como "toda la ventana está atrasada". Así, una sola cesta cuyo ts sea anterior al periodo actual del modelo vacía todo el conjunto de vistos, pone a cero las filas que toca (incluida la fila del total de cestas) y mueve sus epochs hacia atrás. Una pequeña reproducción en un servidor limpio:
before: {"recommendations": [{"item": "coffee", "score": 30.431653267886233}]}
late basket: {'counted': True}
after:  {"recommendations": []}
Aquí había 40 cestas en la semana actual y llegó una sola cesta con un ts de la semana anterior; después, la lista LLR de milk quedó vacía, porque N había caído en la práctica a 1. En la misma sesión, volver a enviar un id de cesta que ya se había contado devolvió counted: true. Con datos que llegan en orden temporal (por ejemplo, una tienda en vivo que omite ts y confía en el reloj del servidor) esto nunca se dispara, y todos los resultados anteriores provienen de datos cargados en orden temporal. Pero importar pedidos históricos desordenados, o escribir desde varias fuentes con relojes distintos, hoy no es seguro. La solución correcta es añadir un evento tardío a la posición correcta (counts[epoch - now]) si sigue dentro de la ventana, descartarlo en caso contrario y no mover nunca un epoch hacia atrás. Es lo primero para la próxima versión; mientras tanto, mi consejo es cargar los datos históricos ordenados por ts.
Cómo encaja con el resto de OxiDB
oxidb-rec es el cuarto motor de OxiDB y sigue, sin desviarse, el patrón que el ADR-0010 fijó para el segundo: su propio crate (sin dependencia del crate de documentos oxidb ni de oxidb-sql, para poder embeberlo de forma independiente), sus propios archivos, su propio WAL y un discriminador engine aditivo. El soporte multibase de datos funciona como en los otros motores: cada base de datos tiene su propia instancia del motor, y drop_database la elimina también. En el RBAC, el rol de lectura puede ejecutar related, for_basket y stats; track y checkpoint requieren acceso de escritura. No participa en transacciones entre motores: un contador de recomendación que va unos segundos por detrás de un pedido no es una inconsistencia que nadie pueda observar, y pagar por la atomicidad entre motores aquí no compraría nada.
En la práctica, la configuración es así: el código que escribe el pedido en el motor de documentos o en el motor SQL envía un track por la misma conexión. La siguiente petición de una página de producto ya ve el pedido nuevo. No hay nada que refrescar, ningún proceso programado que se pueda perder, ningún retraso que explicar. Esa es toda la razón por la que lo construí como motor y no como un proceso nocturno.
Pruébalo
Las versiones precompiladas de OxiDB están en la página de releases de GitHub, junto con la imagen de Docker y el binario del servidor en un solo archivo. Para el motor de recomendación solo hace falta OXIDB_REC=1. Envía tu propio historial de pedidos con track en orden temporal y luego pon una junto a otra las listas scoring: "count" y scoring: "llr" de unos cuantos productos. La diferencia suele verse ya en la primera página de producto.