OxiDB'de öneri motoru: gerçek zamanlı birlikte görülme sayaçları ve LLR
OxiDB'nin dördüncü motoru oxidb-rec: sepetleri anında sayaçlara çeviren, "bunu alanlar şunu da aldı" listesini Dunning LLR ile skorlayan gerçek zamanlı öneri motoru. Zaman kovaları, elle LLR hesabı, disk düzeni ve gerçek bir sunucuda 12 bin siparişle denemeler.
"Bunu alanlar şunları da aldı" kutusu, bir e-ticaret sitesinin veritabanına sorduğu en yaygın sorulardan biri. Ve bugüne kadar neredeyse her veritabanı bu soruya aynı cevabı veriyordu: hiç. Uygulama sipariş satırlarını kendi kendine join eder, çiftleri skorlar, sonucu bir yere yazar; genellikle gece çalışan bir batch işiyle. Yani öneri listesi daha doğduğu anda bayattır. OxiDB'nin dördüncü motoru oxidb-rec tam bu boşluk için var: sepetleri geldikleri anda sayaçlara dönüştüren, öneriyi istek anında hesaplayan, skoru da Dunning'in log-likelihood ratio (LLR) testiyle veren gerçek zamanlı bir item-to-item öneri motoru. Bu yazıda motoru içinden anlatıyorum: veri modeli, zaman kovaları, LLR'nin neden varsayılan olduğu (elle hesaplanmış bir örnekle), diskteki düzen, wire protokolü ve sınırları. Bütün örnekleri 12.003 siparişlik sentetik bir kitapçı veri setini gerçek bir OxiDB sunucusuna yükleyip çalıştırdım; gösterdiğim her sayı o oturumlardan.
Neden ayrı bir motor?
Kararın gerekçesi ADR-0025'te yazılı ve özü tek cümle: bu iş bir sorgu şeklinde değil, bir index şeklinde.
- Birim bir sepet. Doküman ya da satır değil, bir küme. Anlamı tamamen yanında hangi ürünlerin olduğunda.
- Güncelleme bir çift sayacı artırmak. |B| ürünlü bir sepet için yaklaşık |B|²/2 artış; katalog büyüklüğünden bağımsız. Planner'a ihtiyacı yok.
- Okuma tek bir seyrek satır üzerinde kısmi sıralama. Doküman motoru bunu ancak tam koleksiyon taramasıyla ifade edebilir.
- Skorlama alan matematiği. Doğru cevabı olan, yanlış cevabı ise çok olan bir hesap. Çağırana bırakılırsa herkes aynı şekilde yanlış yapar (aşağıda göstereceğim).
Bunu doküman motoruna zorlamak, 10 bin üründe 100 milyon hücrelik, neredeyse tamamı sıfır bir N×N matrisi doküman olarak saklamak demek. SQL motoruna zorlamak ise kaçmaya çalıştığımız gece batch işinin ta kendisi.
İki şeyi de baştan ayırmak istiyorum. Bu vektör arama değil: OxiDB'de HNSW tabanlı vektör index zaten var (tam metin ve vektör arama yazısı), o "hangi ürün buna benziyor" sorusunu başkasının hesapladığı bir embedding üzerinden cevaplar. oxidb-rec ise "hangi ürün gerçekten bunun yanında alınıyor" sorusunu gözlenen davranıştan cevaplar; model, embedding, eğitim gerektirmez, ilk siparişte çalışır. Bu bir graf sorgusu da değil: (müşteri)-[aldı]->(ürün) modelinde çok satan bir üründen iki atlama milyonlarca yol demek (coğrafi ve graf sorguları yazısı seyrek komşuluklarda parlar). Buradaki iş yoğun bir komşuluk üzerinde toplama yapmak ve doğru yapı bir komşuluk sayacı.
Algoritmanın kendisi yeni değil: Amazon'un item-to-item collaborative filtering'i (Linden, Smith ve York, 2003) ve Dunning'in LLR'si (1993), Apache Mahout'un ItemSimilarityJob'unda kullanılan ikili. Üretimde bu genellikle Spark, bir gösterge matrisi ve Elasticsearch ile kurulan bir boru hattı olur. Hepsinin ortak noktası sipariş ile öneri arasında bir yenileme döngüsü olması. Bunu motor olarak yazmamın sebebi o döngüyü silmek; matematiği bir kez daha yazmak değil.
Etkinleştirme ve yapılandırma
Motor varsayılan olarak kapalı. TSDB ve SQL motorlarıyla aynı kalıp: bir ortam değişkeniyle açılıyor, kendi dosyalarını, kendi WAL'ını, kendi kurtarma mantığını kullanıyor; diğer motorlarla yalnızca süreci, portu, kimlik doğrulamayı ve RBAC'yi paylaşıyor.
| Değişken | Varsayılan | Açıklama |
|---|---|---|
OXIDB_REC | kapalı | 1/true/yes/on ile motoru açar |
OXIDB_REC_DATA | ${OXIDB_DATA}/rec | Varsayılan veritabanının rec dizini (diğer veritabanları ${OXIDB_DATA}/<db>/rec altında) |
OXIDB_REC_BUCKET_SECS | 2592000 (30 gün) | Bir zaman kovasının genişliği; pencere bunun 8 katı |
OXIDB_REC_MAX_BASKET | 50 | Bundan büyük sepetler sayılmaz, baskets_skipped olarak raporlanır |
OXIDB_REC_CHECKPOINT_BYTES | 8 MiB | WAL bu boyutu geçince otomatik checkpoint (0 = yalnızca elle) |
Bu yazıdaki sunucuyu şöyle başlattım. Veri seti haftalık olduğu için kova genişliğini bir haftaya (604800 saniye) çektim, checkpoint'leri görebilmek için de eşiği 256 KiB'a indirdim:
OXIDB_ADDR=127.0.0.1:16100 \
OXIDB_DATA=./data \
OXIDB_REC=1 OXIDB_SQL=1 \
OXIDB_REC_BUCKET_SECS=604800 \
OXIDB_REC_CHECKPOINT_BYTES=262144 \
./oxidb-server
Motor tembel açılıyor: ilk rec isteği geldiğinde dizin oluşturuluyor ve log'a şu satır düşüyor:
[oxidb] recommendation engine enabled (default db at ./data/rec)OXIDB_REC olmadan bir istek gönderirseniz cevap net:
{"ok": false, "error": "recommendation engine is not enabled (set OXIDB_REC=1)"}Wire protokolü: tek komut, beş işlem
OxiDB'nin yerel protokolü TCP üzerinde uzunluk önekli JSON: 4 baytlık little-endian uzunluk, ardından JSON gövdesi. Öneri motoruna giden istekler "engine": "rec" (ya da ayrılmış "cmd": "rec") taşıyor ve op alanı işlemi seçiyor. Handler'daki yönlendirme SQL ve TSDB'nin yanında, aynı kavşakta; engine alanı olmayan istekler doküman yoluna byte byte aynı şekilde gitmeye devam ediyor.
| op | Ne yapar | Yetki |
|---|---|---|
track | Bir sepeti bir modele işler (basket id üzerinde idempotent) | yazma |
related | Bir ürünle en çok ilişkili ürünler | okuma |
for_basket | Bir kümeyle en çok ilişkili ürünler (sepet sayfası) | okuma |
stats | Modeller, ürün, çift, sepet, atlanan sepet, bellek tahmini | okuma |
checkpoint | WAL'ı yeni bir snapshot nesline katlar | yazma |
Sorgu parametreleri: scoring (llr varsayılan; cosine, jaccard, lift, count), half_life (kova cinsinden, varsayılan 2, 0 = sönüm yok), min_support (varsayılan 1), limit (varsayılan 10). ts her istekte isteğe bağlı, epoch saniyesi; yoksa sunucunun duvar saati kullanılıyor. Motorun kendi saati yok, "şimdi" köprüde giriyor; bu da testleri ve WAL replay'ini deterministik yapıyor.
Örnekler için 15 satırlık çıplak bir Python istemcisi yeterli:
import json, socket, struct

class Oxi:
    def __init__(self, port=16100):
        self.s = socket.create_connection(("127.0.0.1", port))
    def call(self, req):
        b = json.dumps(req).encode()
        self.s.sendall(struct.pack("<I", len(b)) + b)
        n = struct.unpack("<I", self._read(4))[0]
        return json.loads(self._read(n))
    def _read(self, n):
        buf = b""
        while len(buf) < n:
            buf += self.s.recv(n - len(buf))
        return buf
    def rec(self, **kw):
        return self.call({"engine": "rec", "cmd": "rec", **kw})
Veri seti: sekiz haftalık bir kitapçı
Gerçekçi bir deneme için sekiz haftalık, haftada 1.500 siparişli sentetik bir online kitapçı ürettim (seed sabit, betik tekrar üretilebilir). İçine bilerek ilişkiler gömdüm:
- Seriler:
dunealanların yaklaşık yarısıdune-messiah, bir kısmıchildren-of-dunealıyor.the-hobbit→lotr-fellowship→two-towers→return-of-the-kingzinciri,rust-book→rust-atomics/zero-to-production,sapiens→homo-deus→21-lessonsgibi. - Temalar: bilim kurgu, fantastik, programlama, tarih, yemek, çocuk kitapları. Aynı temadan kitaplar zayıf ama gerçek bir ilişki taşıyor.
- İçerikten bağımsız çok satanlar:
bookmark-set(ayraç seti) siparişlerin üçte birinden fazlasına ekleniyor,gift-wrapvereading-lightda daha düşük oranlarla. Neyin yanına eklendiklerinin hiçbir önemi yok. - Zaman içinde değişen bir ilişki:
the-martianilk altı haftaartemisile, son iki hafta ise yeni çıkanproject-hail-maryile birlikte alınıyor. - Tesadüfler: kataloğun başka hiçbir yerinde geçmeyen
haiku-anthologyveknitting-patternstek bir siparişte birlikte;dune-tarot-deckiki kez alınmış, ikisinde deduneile. - Uzun kuyruk: Zipf dağılımlı 400 başlık (
title-001...title-400).
Sonuç 12.003 sipariş, 448 farklı ürün, ortalama 3,2 ürünlük sepetler. Siparişleri zaman sırasıyla, tek bağlantıdan, ardışık track çağrılarıyla gönderdim:
for r in rows:
    o.rec(op="track", model="purchase", basket_id=r["basket_id"],
          items=r["items"], ts=r["ts"])
12003 track calls, 12003 counted, 0.35 s, 34173 baskets/sBu ölçüm Apple M4 bir Mac'te, yerel bağlantıyla, sakin bir anda alındı. Aynı yüklemeyi makinede başka süreçler diske yoğun fsync yaparken tekrarladığımda 9 ile 15 saniye arası sürdü; sample ile baktığımda zamanın neredeyse tamamı write() sistem çağrısındaydı. Her track WAL'a bir satır yazıp işletim sistemine flush ettiği için yazma hızı disk çekişmesine duyarlı; motorun kendi hesabı ucuz.
stats sonrası tablo:
{
 "catalogue_items": 448,
 "bucket_secs": 604800,
 "buckets": 8,
 "generation": 5,
 "wal_bytes": 73966,
 "models": {
  "purchase": {
   "items": 448,
   "pairs": 19362,
   "baskets": 12003,
   "baskets_skipped": 0,
   "saturated_counters": 0,
   "approx_bytes": 1776848
  }
 }
}
generation: 5: 256 KiB eşiği yükleme sırasında beş otomatik checkpoint tetikledi. pairs: 19362 her iki yöndeki çift satırı sayısı (yani 9.681 farklı çift), approx_bytes da sayaç haritalarının kaba bir bellek tahmini, yaklaşık 1,8 MB.
İlk öneriler: ham sayı ile LLR yan yana
Şimdi asıl soruyu soralım: dune alana ne önerelim? Önce ham birlikte görülme sayısıyla (scoring: "count"), sonra varsayılan LLR ile. Karşılaştırma temiz olsun diye half_life: 0 ile sönümü kapattım:
{"engine": "rec", "cmd": "rec", "op": "related", "model": "purchase",
 "item": "dune", "scoring": "count", "half_life": 0, "limit": 6, "ts": 1771459199}
{"ok": true, "data": {"recommendations": [
{"item": "dune-messiah", "score": 440.0},
{"item": "children-of-dune", "score": 396.0},
{"item": "bookmark-set", "score": 250.0},
{"item": "foundation", "score": 144.0},
{"item": "snow-crash", "score": 143.0},
{"item": "hyperion", "score": 136.0}]}}Aynı istek "scoring": "llr" ile:
{"ok": true, "data": {"recommendations": [
  {"item": "dune-messiah", "score": 2835.72581039503},
  {"item": "children-of-dune", "score": 2510.829224631947},
  {"item": "snow-crash", "score": 209.64968031286844},
  {"item": "foundation", "score": 202.3380715753883},
  {"item": "hyperion", "score": 173.2231380022422},
  {"item": "neuromancer", "score": 164.29420415742788}]}}
Ham sayıda üçüncü sırada bookmark-set var: 250 siparişte dune ile birlikte. LLR listesinde ise yok; yerine aynı temadan bilim kurgu kitapları geliyor. Ayraç seti 4.491 siparişte, yani her üç siparişten birinde. dune alanlarda da üçte bir oranında olması bir ilişki değil, taban oranı. Ham sayı bunu ayırt edemez: her listeye çok satanı koyar. Aynı tablo diğer kitaplarda da tekrar ediyor:
the-hobbit  count: lotr-fellowship 472, bookmark-set 290, two-towers 283, ...
the-hobbit  llr:   lotr-fellowship 2808.7, two-towers 1597.1, return-of-the-king 1025.1, ...
rust-book   count: rust-atomics 238, zero-to-production 188, bookmark-set 154, ...
rust-book   llr:   rust-atomics 1704.7, zero-to-production 1316.8, ddia 338.5, database-internals 312.6, ...
the-hobbit için LLR üçlemenin tamamını sıraya diziyor, ham sayı ise araya ayraç setini sokuyor. Bunu tek tek kitaplarla sınırlı bırakmamak için 27 kitabın her biri için bookmark-set'in kaçıncı sırada çıktığına baktım:
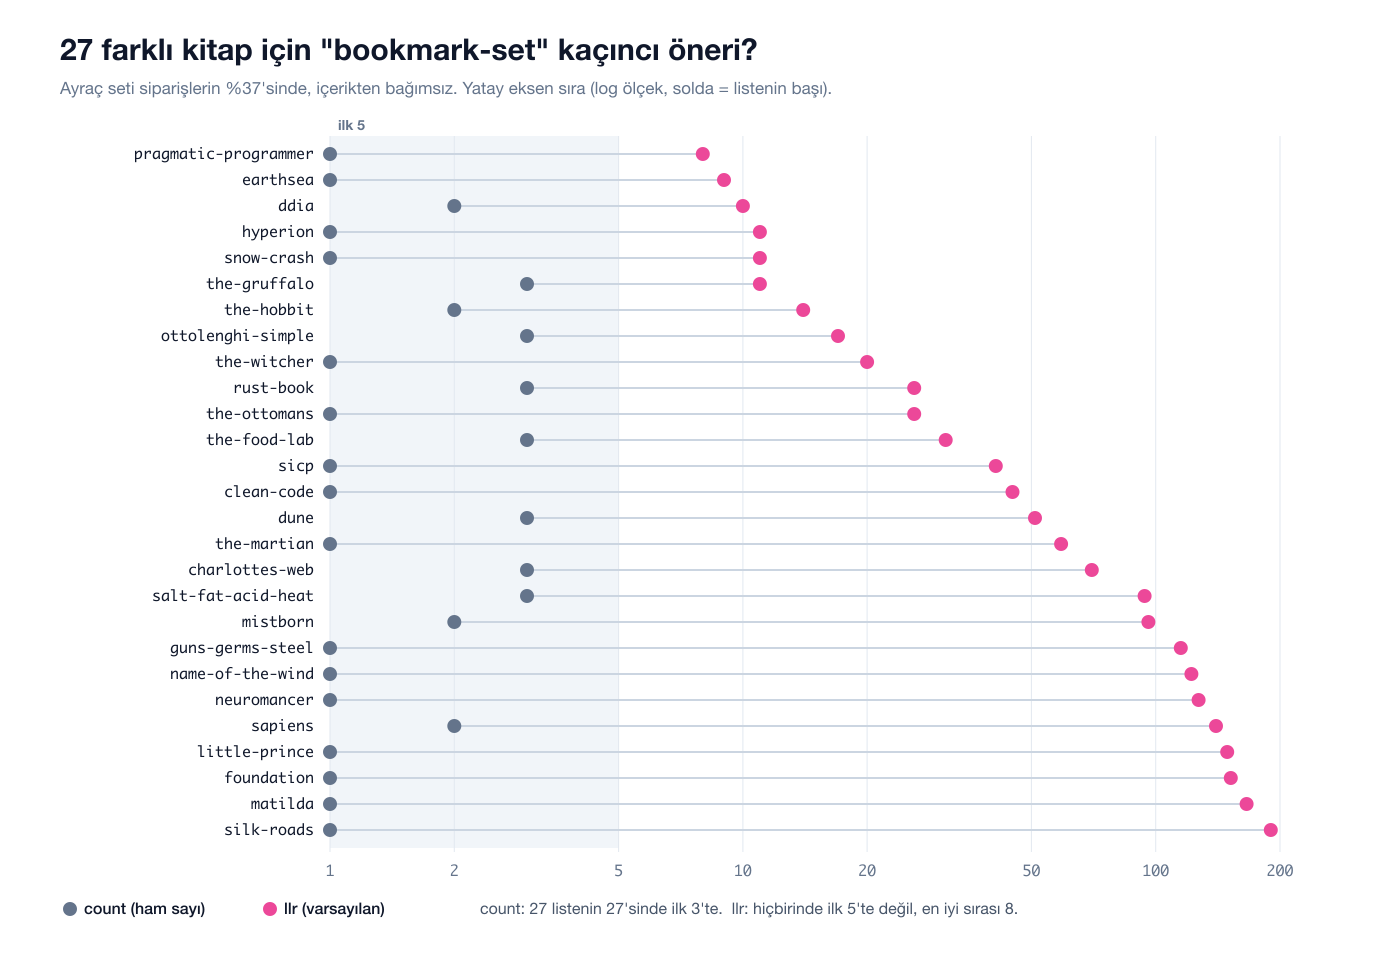
Ham sayıda ayraç seti 27 listenin 16'sında birinci, hepsinde ilk üçte. LLR'de hiçbirinde ilk beşte değil; en iyi sırası 8, sekiz listede 100'ün de ötesinde. Bir mağazanın her ürün sayfasında "bunu alanlar ayraç da aldı" yazması teknik olarak doğru ve tamamen işe yaramaz bir bilgi.
LLR nasıl çalışır: 2×2 tablo ve elle bir hesap
LLR'nin sorduğu soru şu: taban oranlar göz önüne alındığında bu birlikte görülme ne kadar şaşırtıcı? Bunun için her aday çift (x, y) için 2×2'lik bir olasılık tablosu (contingency table) kuruluyor:
| y var | y yok | |
|---|---|---|
| x var | k11 = co(x,y) | k12 = n(x) - co |
| x yok | k21 = n(y) - co | k22 = N - n(x) - n(y) + co |
Burada N toplam sepet sayısı, n(x) x'i içeren sepet sayısı, co(x,y) ikisini birlikte içeren sepet sayısı. Dunning'in G² istatistiği, gözlenen tabloyu "x ile y bağımsız olsaydı" beklenecek tabloyla karşılaştırıyor. Beklenen hücre değeri satır toplamı çarpı sütun toplamı bölü N; G² ise:
G² = 2 · Σ O · ln(O / E) (dört hücre üzerinden, O = 0 ise terim 0)Motor aynı şeyi entropi formuyla hesaplıyor; matematiksel olarak eşdeğer:
fn xlogx(x: f64) -> f64 { if x <= 0.0 { 0.0 } else { x * x.ln() } }
fn entropy2(a: f64, b: f64) -> f64 { xlogx(a + b) - xlogx(a) - xlogx(b) }

pub fn llr(co: f64, n_x: f64, n_y: f64, total: f64) -> f64 {
    let k11 = co;
    let k12 = (n_x - co).max(0.0);
    let k21 = (n_y - co).max(0.0);
    let k22 = (total - n_x - n_y + co).max(0.0);
    let row_e = entropy2(k11 + k12, k21 + k22);
    let col_e = entropy2(k11 + k21, k12 + k22);
    let cell_e = entropy4(k11, k12, k21, k22);
    (2.0 * (row_e + col_e - cell_e)).max(0.0)
}
Hesap baştan sona f64; çünkü sönüm devreye girince sayılar kesirli oluyor. Sonuç sıfırda kırpılıyor, bağımsızlığa çok yakın durumlarda kayan nokta hatası sonucu küçük bir negatife itebiliyor.
Şimdi veri setinden iki çifti elle hesaplayalım. Ham sayıları veri dosyasından ayrıca Python ile saydım: N = 12.003, dune 707 sepette, dune-messiah 440 sepette (ve hepsinde dune da var), bookmark-set 4.491 sepette, bunların 250'sinde dune var.
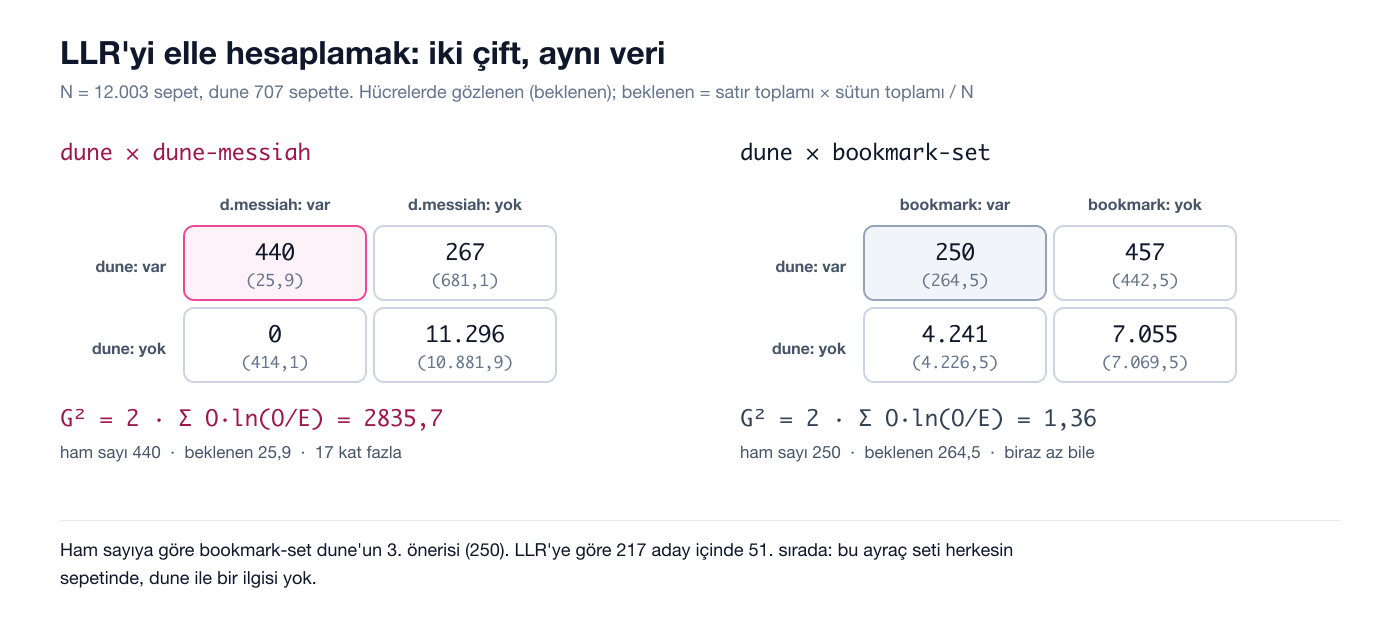
dune × dune-messiah. Bağımsız olsalardı birlikte görülme beklentisi 707 × 440 / 12.003 = 25,9 olurdu; gözlenen 440, yani 17 kat fazla. Dört terim: 440·ln(440/25,9) = 1246,03; 267·ln(267/681,1) = -250,03; k21 = 0 olduğu için ikinci satırın ilk terimi 0; 11.296·ln(11.296/10.881,9) = 421,86. Toplam 1417,86, iki katı 2835,7.
dune × bookmark-set. Beklenen birlikte görülme 707 × 4.491 / 12.003 = 264,5; gözlenen 250, beklenenden biraz az bile. Terimler -14,12, 14,76, 14,55 ve -14,51; toplam 0,68, iki katı 1,36.
Sunucunun döndürdüğü değerlerle karşılaştırdım: dune-messiah için 2835.72581039503, bookmark-set için 1.3646498105954379. Python'daki bağımsız hesap birebir aynı sonucu verdi. Ham sayıda 440'a karşı 250, yani aynı lig; LLR'de 2835'e karşı 1,4, yani hiç ilgisi yok. bookmark-set LLR listesinde 217 aday arasında 51. sırada.
Cosine ve lift'in tuzakları
Motor beş skorlama modunu da destekliyor ve sayaçlar ham saklandığı için mod değiştirmek bir parametre, yeniden inşa değil. Bu sayede diğer modların nerede çöktüğünü aynı veriyle görmek kolay.
Cosine co / sqrt(n(x)·n(y)). Veri setindeki tesadüfe bakalım: haiku-anthology ve knitting-patterns kataloğun tamamında birer kez geçiyor, ikisi de aynı siparişte.
{"op": "related", "model": "purchase", "item": "haiku-anthology", "scoring": "cosine", "half_life": 0}
{"ok": true, "data": {"recommendations": [
  {"item": "knitting-patterns", "score": 1.0},
  {"item": "bookmark-set", "score": 0.014922049367861507}]}}
1,0: cosine'in verebileceği en yüksek skor. Karşılaştırma için mağazanın en güçlü gerçek ilişkisi olan dune → dune-messiah cosine'de 0,789 alıyor. Yani cosine tek bir tesadüfü, 440 siparişle kanıtlanmış bir seri ilişkisinden daha "ilişkili" buluyor. Payda pay kadar küçük olduğu için. LLR aynı tesadüfe 20,8 veriyor; dune-messiah'ın 2835'ine göre iki mertebe aşağıda. Tam sıfır değil, çünkü bir kez bile olsa beklenen 0,00008'e karşı 1 gözlem istatistiksel olarak bir şey. Bunu tamamen elemek için min_support var:
{"op": "related", "model": "purchase", "item": "haiku-anthology", "half_life": 0, "min_support": 2}
{"ok": true, "data": {"recommendations": []}}
Lift co·N / (n(x)·n(y)). dune için lift listesinin ilk üçü:
{"item": "children-of-dune", "score": 16.97736916548798},
{"item": "dune-messiah", "score": 16.97736916548798},
{"item": "dune-tarot-deck", "score": 16.97736916548798}
Üçü de aynı skorda, çünkü üçü de her zaman dune ile birlikte alınmış. Lift bunun 440 siparişle mi yoksa 2 siparişle mi olduğuna bakmıyor; dune-tarot-deck (toplam 2 satış) seri kitaplarıyla aynı yere oturuyor. LLR'de dune-tarot-deck 11,3 ile onuncu sırada: kanıt var ama az. Jaccard bu veri setinde LLR'ye yakın sıralar verdi; ADR'deki gerçek veri doğrulamasında da cosine baş tarafta LLR ile büyük ölçüde örtüşüp küçük hacimli ürünlerde ayrışıyordu. Fark tam da kanıtın az olduğu yerde ortaya çıkıyor ve öneri listelerinin çoğu orada yaşıyor.
Sepet sayfası: for_basket
Tek üründen öneri en zayıf kullanışlı form. Asıl dönüşüm sepet sayfasında oluyor ve for_basket bunun için v1'in parçası. Her adayın skoru sepetteki her ürün için toplanıyor; sepetin kendi ürünleri ve exclude listesi hiç çıkmıyor:
{"op": "for_basket", "model": "purchase", "items": ["dune", "rust-book"],
 "exclude": ["dune-messiah"], "limit": 6, "ts": 1771459199}
{"ok": true, "data": {"recommendations": [
{"item": "children-of-dune", "score": 1006.2434574795043},
{"item": "rust-atomics", "score": 719.6690210232482},
{"item": "zero-to-production", "score": 509.19681360899995},
{"item": "ddia", "score": 129.83592528033478},
{"item": "database-internals", "score": 107.594666573641},
{"item": "clean-code", "score": 102.12004133801383}]}}dune-messiah'ı exclude ile çıkardım (diyelim ki müşteri zaten sahip); liste iki ilgi alanını da karşılıyor. Bu istekte half_life vermediğim için varsayılan sönüm (2 kova) uygulandı; skorların related örneğindekinden küçük olmasının sebebi bu.
Bilinmeyen bir ürün sorulduğunda motor boş liste dönüyor:
{"op": "related", "model": "purchase", "item": "no-such-book"}
{"ok": true, "data": {"recommendations": []}}
Bu bilinçli bir karar: kanıtı olmayan bir motor "kanıtım yok" durumunu "işte bir öneri" diye kamufle etmemeli. Çok satanlara düşmek gibi bir yedek gerekiyorsa onu uygulama seçiyor.
Motorun içi: yazma ve okuma yolları
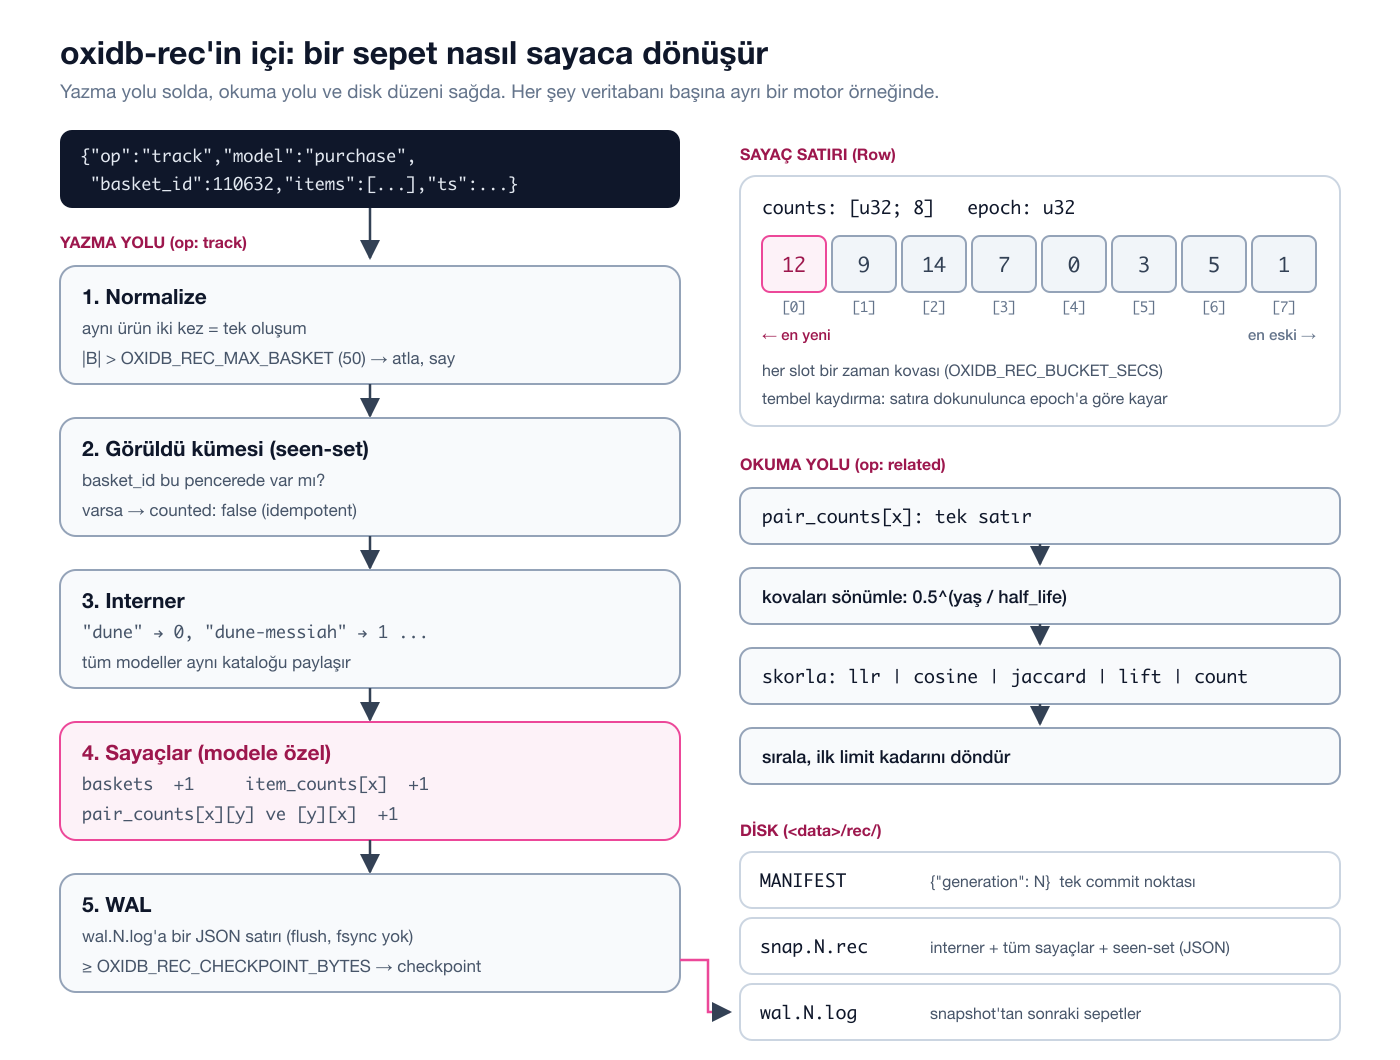
Buraya kadar motoru dışarıdan kullandık. Bundan sonraki bölümler içini anlatıyor; aşağıdaki şema bir track isteğinin sayaçlara, bir related isteğinin de skorlu listeye nasıl dönüştüğünü ve diskte nelerin durduğunu tek bakışta gösteriyor:
Zaman: sekiz kova, tembel kaydırma ve half_life
Sayaçlar tek bir sayı değil, zaman kovalarına bölünmüş. Her satır sabit boyutlu bir dizi:
pub struct Row {
    pub counts: [u32; BUCKETS],   // BUCKETS = 8
    pub epoch: u32,               // counts[0]'ın ait olduğu periyot
}
Periyot basitçe ts / bucket_secs. Varsayılan 30 günlük kovayla pencere 240 gün; benim haftalık kurulumumda sekiz hafta. Vec yerine [u32; 8] seçimi bilinçli: birkaç milyon çiftte Vec'in tek başına 24 baytlık başlığı içindeki sayılardan ağır basardı. Satır 36 bayt.
En ilginç tasarım kararı kaydırmanın tembel olması. Yeni bir periyoda geçildiğinde bütün haritayı tarayıp her sayacı bir slot kaydırmak yerine, her satır kendi epoch'unu taşıyor ve ancak bir dahaki dokunuşta (yazma ya da okuma), kaç periyot gerideyse o kadar kaydırılıyor. Bu, satır başına O(8)'lik bir dizi döndürmesi. ADR'nin ilk taslağında kaydırma periyot sınırında hevesli yapılıyordu: yazma kilidi altında tam bir tarama. Ayda bir olurdu, ama milyonlarca çiftte rastgele bir isteğin birkaç saniyelik bir duraklama taşıması demekti. Tembel kaydırma bu duraklamayı tamamen siliyor; maliyeti satır erişimi başına bir u32 karşılaştırması. Kimsenin dokunmadığı satırlar bayat kalıyor ama checkpoint zaten hepsini yürüyor ve tamamı sıfıra düşmüş satırları snapshot'a hiç yazmıyor. Yani checkpoint aynı zamanda çöp toplayıcı.
Pencerenin işlediğini görmek için aynı sorguyu geleceğe dönük ts değerleriyle sordum. Şimdi, dört hafta sonra ve sekiz hafta sonra:
ts = şimdi        → dune-messiah 440, children-of-dune 396
ts = +4 hafta     → dune-messiah 228, children-of-dune 201
ts = +8 hafta     → []
Dört hafta sonra ilk dört haftanın kovaları pencereden düşmüş, sekiz hafta sonra hiçbir şey kalmamış. Silme işlemi yok, sweep yok; sadece periyot aritmetiği.
Okuma tarafında kovalar üstel bir yarılanma ömrüyle ağırlıklandırılıyor: i periyot yaşındaki bir kova 0.5^(yaş / half_life) ile çarpılıyor. half_life bir sorgu parametresi; yani "son zamanlarda birlikte yükselenler" ayrı bir boru hattı değil, bir sorgu. Bunu veri setindeki the-martian ile gördüm:
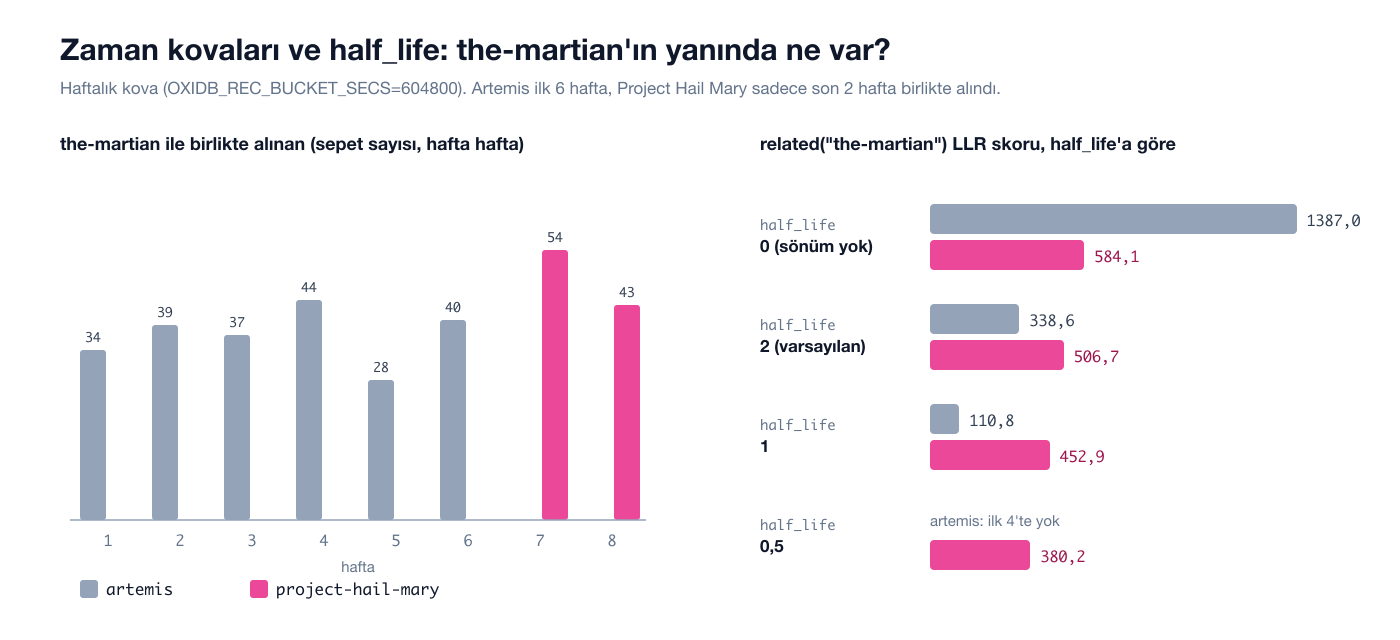
half_life 0   → artemis 1387.0, project-hail-mary 584.1, snow-crash 207.7, hyperion 168.1
half_life 2   → project-hail-mary 506.7, artemis 338.6, snow-crash 84.4
half_life 1   → project-hail-mary 452.9, artemis 110.8, snow-crash 54.8, hyperion 44.5
half_life 0.5 → project-hail-mary 380.2, snow-crash 39.8, children-of-dune 33.6, hyperion 29.4
Sönüm olmadan altı haftalık artemis geçmişi kazanıyor. Varsayılan half_life: 2 ile son iki haftanın yeni kitabı öne geçiyor ama artemis hâlâ listede. Yarım kovada artemis ilk dörtten tamamen çıkıyor; bedeli de listenin gürültülenmesi (children-of-dune'un the-martian listesine girmesi gibi), çünkü etkin örneklem son birkaç haftaya iniyor. Doğru half_life alanınıza bağlı: moda için kısa, B2B için uzun. Hiçbir durumda yeniden inşa gerekmiyor.
Sayaçlar ve bellek düzeni
Her model (purchase, view, cart gibi adlandırılmış bir olay uzayı) şu yapıyı tutuyor:
pub struct Model {
    baskets: Row,                                  // periyot başına toplam sepet
    item_counts: HashMap<u32, Row>,                // x'i içeren sepetler
    pair_counts: HashMap<u32, HashMap<u32, Row>>,  // x ve y'yi birlikte içerenler
    seen: [HashSet<u64>; BUCKETS],                 // periyot başına görülen basket id'leri
    seen_epoch: u32,
    baskets_total: u64, baskets_skipped: u64, saturated: u64,
}
Ürünler string olarak geliyor ve u32'ye intern ediliyor; interner veritabanı başına bir tane ve tüm modeller tarafından paylaşılıyor, çünkü katalog aynı katalog. Görüntüleme ile satın alma farklı taban oranlara sahip farklı sinyaller; ayrı modellerde sayılıyorlar, asla tek havuzda karışmıyorlar.
Çift satırları iki yönde saklanıyor. Bu sayaç belleğini ikiye katlıyor ama related(x)'i tek bir satır aramasına indiriyor; sıcak yol bu. Alternatif (yalnızca x < y sırası) belleği yarıya indirir ama her sorguyu taramaya çevirir. ADR'nin bütçesi kabaca farklı_çift × 2 × 36 bayt artı harita ek yükü; bir milyon farklı çiftte yaklaşık 72 MB. Bellek sipariş sayısıyla değil kataloğun çeşitliliğiyle büyüyor; bu yüzden stats bunu approx_bytes olarak öne koyuyor.
Sayaçlar u32 taşmasında başa dönmek yerine doyuyor (saturating add) ve stats gözlenen doyumu saturated_counters olarak raporluyor. Tavanda takılı bir sayı skoru çarpıtır, başa dönmüş bir sayı ise tersine çevirir.
İki giriş koruması ve idempotence
Sepet boyutu sınırı (varsayılan 50). 500 satırlık bir sipariş 125.000 artış demek ve neredeyse her zaman bir toplu içe aktarma ya da test verisidir; tercih sinyali taşımaz ama sayaçlara hükmeder. Sınırı aşan sepet sessizce düşürülmüyor, sayılıyor:
{"op": "track", "model": "purchase", "basket_id": 900001, "items": ["title-001", "...60 ürün..."]}
{"ok": true, "data": {"counted": false}}
Ardından stats içinde "baskets_skipped": 1 görünüyor.
Sepet içi tekrar tek oluşum sayılıyor. Tekrar ayıklama boyut kontrolünden önce yapılıyor; yani 40 farklı ürünlük 60 satırlık bir sipariş sınırın içinde:
{"op": "track", "model": "view", "basket_id": 1, "items": ["dune", "dune", "dune-messiah"]}
{"ok": true, "data": {"counted": true}}
{"op": "related", "model": "view", "item": "dune", "scoring": "count"}
{"ok": true, "data": {"recommendations": [{"item": "dune-messiah", "score": 1.0}]}}
Idempotence. track basket id üzerinde idempotent: aynı sipariş iki kez gelirse bir kez sayılıyor. Veri setinin son siparişini tekrar gönderdim:
{"op": "track", "model": "purchase", "basket_id": 111237, "items": ["title-007"], "ts": 1771458725}
{"ok": true, "data": {"counted": false}}
Bunu sağlayan görüldü kümesi (seen-set) de diğer her şey gibi kovalara bölünmüş: basket id'ler periyot başına tutuluyor ve bir periyot pencereden düşünce id'leri de onunla düşüyor. Böylece idempotence penceresi sayım penceresine eşit ve kümenin boyutu modelin ömrüyle değil bir pencerelik sepetle sınırlı. Sınırsız bir seen-set bu motorun kendi "bellekte duran index" hatası olurdu.
Diskte: MANIFEST, snapshot ve WAL
Her veritabanının rec/ dizininde üç tür dosya var; TSDB motorunun disiplininin aynısı (zaman serisi yazısı):
MANIFEST        {"generation": N}: yetkili nesil
snap.N.rec      interner + tüm model sayaçları + seen-set
wal.N.log       o snapshot'tan bu yana işlenen sepetler, satır başına bir JSON
Yükleme sonrası dizin:
-rw-r--r--  16       MANIFEST
-rw-r--r--  1008926  snap.5.rec
-rw-r--r--  73966    wal.5.log
WAL kaydı, istemcinin gönderdiği sepetin ta kendisi:
{"model":"purchase","basket_id":110632,"items":["21-lessons","bookmark-set","homo-deus","sapiens","silk-roads","the-ottomans","title-007","title-041"],"ts_secs":1771203773}Checkpoint snap.N+1'i geçici dosyaya yazıp fsync'liyor ve yeniden adlandırıyor, yeni WAL'ı açıyor, ardından MANIFEST'i atomik olarak yeniden adlandırıyor. Tek commit noktası bu rename. Ondan önce çökme olursa kurtarma N'den yapılıyor; sonra eski nesil siliniyor. Açılışta MANIFEST'in göstermediği snap.* ve wal.* dosyaları da süpürülüyor; yoksa her çökme bir çift yetim dosya bırakırdı.
Kurtarma, snapshot yükleme artı WAL replay. Burada idempotence ikinci kez işe yarıyor: seen-set snapshot'ın içinde olduğu için snapshot'ın zaten içerdiği kayıtları yeniden oynatmak etkisiz. WAL'ın commit kaydına da kesme disiplinine de ihtiyacı yok. Yarım kalmış son satır (yazma sırasında çökme) hata değil, atlanıyor; o kayıt zaten kalıcı olarak onaylanmamıştı. Sunucuyu durdurup yeniden başlattığımda stats birebir aynı geldi ve related("dune") aynı skorları verdi.
Elle checkpoint ve disk kullanımı:
{"engine": "rec", "cmd": "rec", "op": "checkpoint", "ts": 1771459199}
{"ok": true, "data": {"ok": true}}
{"cmd": "disk_usage"}
{"ok": true, "data": {"path": ".../data", "total_bytes": 1075232, "engines": {"documents": 260, "documents_mmap": 260, "sql": 0, "tsdb": 0, "rec": 1074972, "blobs": 0, "oximem": 0, "messaging": 0, "fts": 0, "pitr_archive": 0, "system": 0}}}
Bir koruma daha: kova genişliği snapshot'a yazılıyor ve açılışta doğrulanıyor. Periyotlar ts / bucket_secs olduğu için farklı bir genişlikle açmak her sayacın periyodunu sessizce yeniden yorumlamak demek. Haftalık veriyle yazılmış bir dizini OXIDB_REC_BUCKET_SECS=86400 ile açmayı denediğimde motor reddetti (mesajın sonunu kısalttım):
failed to open rec engine for database "oxidb": bucket_secs mismatch: snapshot has 604800, config wants 86400 ...Dayanıklılık konusunda açık olmak istiyorum: WAL her kayıttan sonra işletim sistemine flush ediliyor ama fsync edilmiyor. Süreç çökmesine karşı güvenli; güç kesintisinde son checkpoint'ten sonraki sepetler kaybolabilir. Otomatik checkpoint (OXIDB_REC_CHECKPOINT_BYTES) replay süresini sınırlıyor. Öneri sayaçları için bu bilinçli bir v1 tercihi: birkaç saniyelik bir sipariş eksiği hiçbir listede gözle görülmez.
Performans
Yine Apple M4 Mac, yerel bağlantı, tek bağlantılı Python istemcisi, 2.000'er tekrar:
related x2000: 36 us per call (round trip)
for_basket x2000: 48 us per call (round trip)
ping x2000: 13 us per call
Boş bir ping 13 µs; demek ki tek ürünlük related sorgusunun sunucu tarafındaki maliyeti 20 µs civarında. 217 adaylı bir satırı skorlamak, sıralamak ve JSON'a çevirmek bu kadar. Üç ürünlük for_basket 48 µs. Bunlar benim küçük veri setimdeki rakamlar; satır uzunluğu aday sayısıyla doğrusal büyüyor. Projenin ADR'sindeki gerçek veri doğrulaması (UCI Online Retail, 541 bin sipariş satırı) skorlama modlarının liste kalitesini karşılaştırıyor, hız ölçmüyor.
SQL'den ve stored procedure'lerden erişim
Motorun bir de ikinci kapısı var: LANGUAGE COBRA stored procedure'leri içinden db.rec_* metotları (SQL motoru yazısı). Bunlar wire'ın kullandığı aynı dispatch fonksiyonuna gidiyor; yani bir prosedür ile bir istemci aynı doğrulamayı ve aynı cevabı alıyor. Sepet sayfası önerisini bir prosedüre sardım:
# CREATE PROCEDURE cart_recs(a TEXT, b TEXT) LANGUAGE COBRA
def run(db, a, b)
    let out = db.rec_for_basket({"model": "purchase", "items": [a, b], "limit": 3, "ts": 1771459199})
    return out["recommendations"]
end
cobra build --portable ile derleyip base64 olarak CREATE PROCEDURE ... LANGUAGE COBRA AS '...' ile yükledikten sonra:
{"engine": "sql", "cmd": "sql", "sql": "CALL cart_recs('the-hobbit', 'sapiens')"}
{"ok": true, "data": [{"columns": ["item", "score"], "types": [null, null],
  "rows": [["lotr-fellowship", 1130.2998390605499], ["homo-deus", 742.2844136386848], ["two-towers", 664.9649628103361]]}]}
Öneriler SQL satırları olarak geri geliyor; bir sipariş tablosuna yazan aynı prosedür sepeti db.rec_track ile öneri motoruna da işleyebilir.
Sınırlar ve dürüst notlar
Kümede replike edilmiyor. Raft kümesinde track bir yazma ama Raft üzerinden çoğaltılmıyor; TSDB ile aynı açığı paylaşıyor. Her düğüm yalnızca kendisine gelen sepetleri biriktiriyor ve related cevapları düğümden düğüme farklı olabilir. ADR bunu bir keşif değil bir karar olarak kaydediyor. Düzeltmeyi ucuzlatan iki özellik de hazır: track idempotent (en az bir kez teslim yeterli) ve durum değişmeli (commutative) bir sayaç (replikalar her sıralamada aynı noktaya yakınsar).
Kişiselleştirme değil. Birlikte görülme "bununla ne gider" sorusunu cevaplar, "bu kişi sırada ne görmeli" sorusunu değil.
LLR iki yönlü. G², gözlenenin beklenenden fazla olmasıyla az olmasını ayırt etmiyor ve motordaki uygulama da bir işaret kontrolü yapmıyor. Veri setimde pragmatic-programmer için bookmark-set 8. sırada çıktı: birlikte görülme 139, bağımsızlık beklentisi 164,3. Yani ilişki aslında negatif, ama skor küçük de olsa pozitif (6,59). Skor küçük kaldığı için kısa listelerde fark edilmiyor; uzun listelerin kuyruğunda görülebilir.
ADR ile v1 arasındaki farklar. ADR snapshot'ı ikili bir format olarak tarif ediyor; v1'deki snap.N.rec JSON (1 MB'lık snapshot'ım okunabilir bir JSON dosyasıydı). ADR'de geçen fallback: "popular" parametresi ile backup/restore/retention işlemleri bu sürümün wire yüzeyinde yok; köprünün tanıdığı işlemler track, related, for_basket, stats ve checkpoint. Bilinmeyen bir işlem net bir hatayla reddediliyor:
{"engine": "rec", "cmd": "rec", "op": "retention"}
{"ok": false, "error": "unknown rec op: \"retention\" (track, related, for_basket, stats, checkpoint)"}
Bu yazıyı hazırlarken yakaladığım bir hata: geç gelen sepetler. Yükleme betiğimi bir kez yanlışlıkla iki kez çalıştırdım ve ikinci turda 12.003 sepetin hepsinin yeniden counted: true döndüğünü gördüm. Sebebi şu: Row::roll_to ve seen-set'in kaydırması, yeni periyodun mevcut epoch'tan büyük ya da eşit olduğunu varsayıyor. Bu yalnızca bir debug_assert! ile korunuyor; release derlemede now - epoch çıkarması u32 olarak taşıp çok büyük bir sayıya dönüyor ve "pencerenin tamamı geride kaldı" diye yorumlanıyor. Sonuç olarak modelin mevcut periyodundan daha eski bir ts ile gelen tek bir sepet, seen-set'i tamamen temizliyor ve dokunduğu satırları (toplam sepet satırı dahil) sıfırlayıp epoch'larını geriye alıyor. Temiz bir sunucuda küçük bir tekrar üretimi:
before: {"recommendations": [{"item": "coffee", "score": 30.431653267886233}]}
late basket: {'counted': True}
after:  {"recommendations": []}
Bu sayımda 40 sepet şimdiki haftada, tek bir sepet bir önceki haftanın ts değeriyle geldi; ardından milk için LLR listesi boşaldı, çünkü N fiilen 1'e indi. Aynı oturumda daha önce sayılmış bir basket id'yi tekrar gönderince counted: true döndü. Zaman sırasıyla gelen verilerde (canlı bir mağazada ts göndermeyip sunucu saatine güvenmek gibi) bu hiç tetiklenmiyor; yukarıdaki bütün sonuçlar zaman sırasıyla yüklenmiş veriden. Ama geçmiş siparişleri sırasız içe aktarmak ya da farklı saatlere sahip birden çok kaynaktan yazmak bugün güvenli değil. Doğru düzeltme, geç gelen bir olayı pencerenin içindeyse doğru slota (counts[epoch - now]) eklemek, dışındaysa düşürmek ve epoch'u asla geriye almamak. Bir sonraki sürümün ilk işi bu; o zamana kadar tavsiyem, geçmiş veriyi ts'e göre sıralayarak yüklemek.
OxiDB'nin geri kalanıyla ilişkisi
oxidb-rec OxiDB'nin dördüncü motoru ve ADR-0010'un ikinci motor için koyduğu kalıbı sapmadan izliyor: kendi crate'i (oxidb doküman crate'ine de oxidb-sql'e de bağımlılığı yok, tek başına gömülebilir), kendi dosyaları, kendi WAL'ı, eklemeli bir engine ayrıştırıcısı. Çoklu veritabanı desteği diğer motorlarla aynı: her veritabanının kendi motor örneği var, drop_database onu da kaldırıyor. RBAC'de okuma rolü related, for_basket, stats çalıştırabiliyor; track ve checkpoint yazma yetkisi istiyor. Çapraz motor işlemlerine katılmıyor; bir öneri sayacının siparişin birkaç saniye gerisinde olması kimsenin gözlemleyebileceği bir tutarsızlık değil, onun için çapraz motor atomikliğine para ödemek hiçbir şey satın almaz.
Pratikte kurgu şöyle: siparişi doküman motoruna ya da SQL motoruna yazan kod, aynı bağlantı üzerinden bir track de gönderiyor. Bir sonraki ürün sayfası isteği yeni siparişi zaten görüyor. Yenilenecek bir şey, kaçırılacak bir zamanlanmış iş, açıklanacak bir gecikme yok. Bu motoru bir gece işi yerine bir motor olarak yazmamın bütün sebebi buydu.
Denemek için
OxiDB'nin hazır derlenmiş sürümleri GitHub releases sayfasında; Docker imajı ve tek dosyalık sunucu binary'si de orada. Öneri motorunu açmak için tek gereken OXIDB_REC=1. Kendi sipariş geçmişinizi zaman sırasıyla track ile gönderin, birkaç ürün için scoring: "count" ile scoring: "llr" listelerini yan yana koyun. Farkı görmek genellikle ilk ürün sayfasında oluyor.