OxiDB'de tam metin ve vektör arama
OxiDB'nin arama katmanı: BM25 sıralaması, 18 dilde Snowball kök bulma ve Türkçe örnekler, vurgulu parçalar, PDF/DOCX/XLSX içinde arama, mmap'li inverted index, HNSW ile k-NN ve gerçek recall ölçümleri.
OxiDB'ye bir belge koyduğunuzda onu yalnızca alan eşitliğiyle değil, içindeki kelimelerle ve anlamına yakın başka belgelerle de bulabilmek istersiniz. Bunun için ayrı bir Elasticsearch ya da ayrı bir vektör veritabanı ayağa kaldırmak istemedim. OxiDB'de tam metin aramayı (BM25 sıralaması, Snowball kök bulma, <mark> vurgulu parçalar, PDF/DOCX/XLSX'ten metin çıkarma) ve vektör aramayı (cosine, euclidean, dot product ile k-NN, küçük koleksiyonlarda tam tarama, büyüklerde HNSW) aynı süreç içinde yazdım. Bu yazıda ikisinin de nasıl kullanıldığını, içeride nasıl çalıştığını ve nerede zayıf kaldığını gerçek oturumlarla anlatıyorum. Gösterdiğim her çıktı, bu yazı için kendi makinemde (Apple M4, yerel) çalıştırdığım OxiDB 0.44.2 sunucusundan geliyor.
Serinin ikinci yazısı bu. Belge modelini, sorgu dilini ve index türlerini doküman motoru yazısında anlattım; burada onların üzerine kurulan arama katmanına odaklanıyorum.
İki ayrı arama, bir süreç
OxiDB'de "arama" iki farklı şey demek:
| Tam metin arama | Vektör arama | |
|---|---|---|
| Ne bulur | Sorgudaki kelimeleri (köklerine indirgenmiş hâlde) içeren belgeler | Sorgu vektörüne en yakın k vektör |
| Index | create_text_index (koleksiyon), otomatik (blob/dosya) | create_vector_index |
| Sıralama | BM25 (_score) | Mesafe (_distance) ve 0-1 benzerlik (_similarity) |
| Komut | text_search, search | vector_search |
| Disk | .mtidx (mmap'li inverted index) | 0.44.2'de kalıcı değil (aşağıda) |
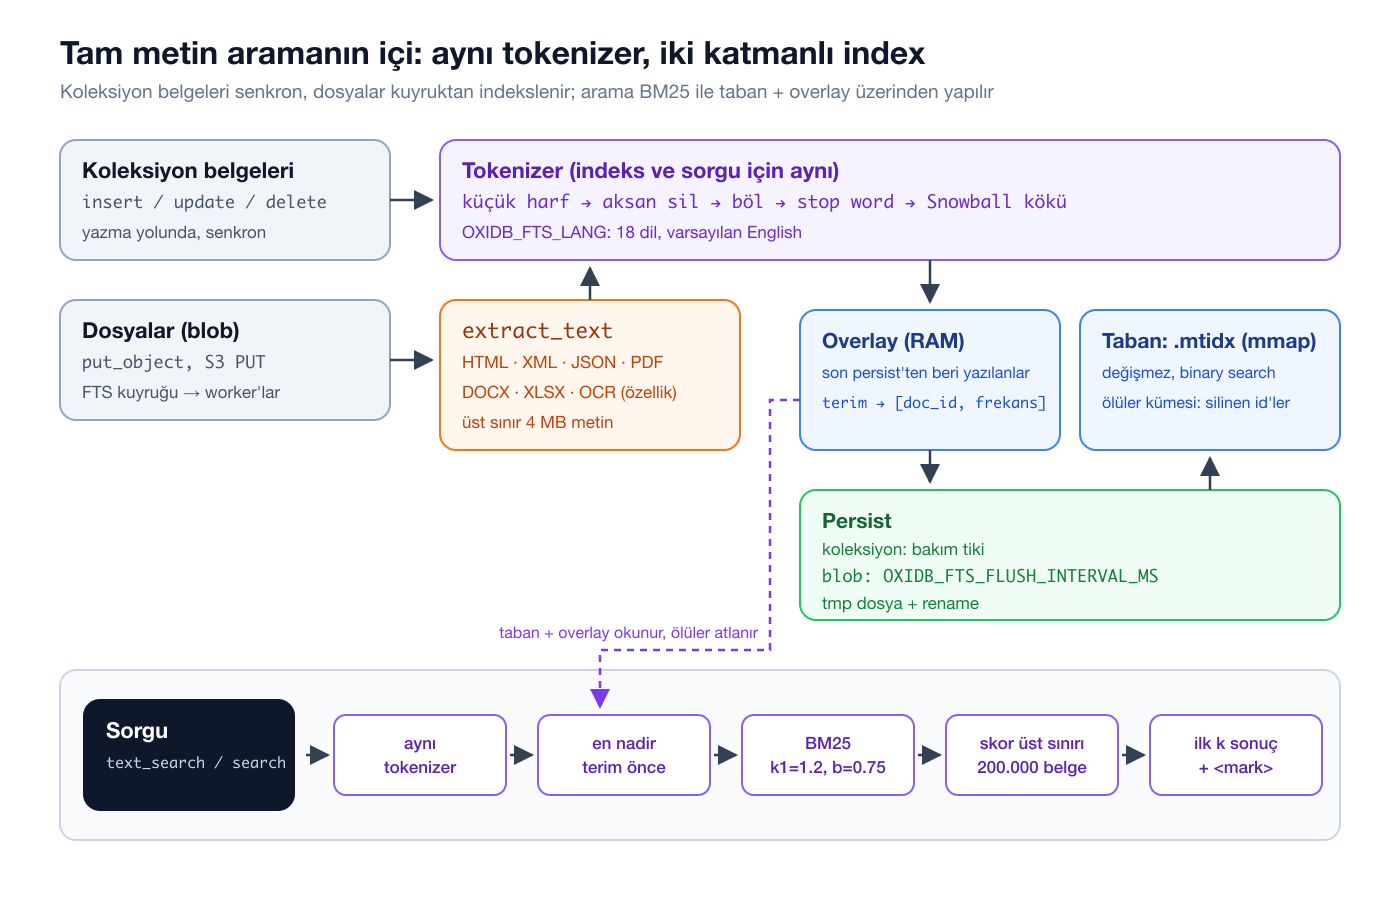
Tam metin aramanın da iki yüzü var. Koleksiyon belgeleri için create_text_index ile seçtiğiniz string alanları indekslenir ve text_search ile aranır. Blob deposuna (S3 uyumlu nesne deposu) koyduğunuz dosyalar ise içerik tipine göre metne çevrilip ayrı bir global index'e girer ve search ile aranır. İkisi aynı tokenizer'ı ve aynı BM25 kodunu kullanır.
Etkinleştirmek için bir bayrak gerekmiyor: doküman motoru açıksa (varsayılan) arama komutları da açık. Dil ve BM25 ayarları ortam değişkenleriyle verilir. Ben bu yazı için iki sunucu çalıştırdım: Türkçe kök bulma için biri, İngilizce için biri.
OXIDB_ADDR=127.0.0.1:15200 OXIDB_DATA=./data-tr OXIDB_FTS_LANG=tr \
OXIDB_S3_PORT=15210 OXIDB_HTTP_PORT=15220 ./oxidb-server
Sunucu açılırken ayarı tek satırda yazıyor:
FTS: lang=turkish k1=1.2 b=0.75 (BM25)Koleksiyonda tam metin arama
Index kurmak
Önce birkaç Türkçe belge ekledim, sonra iki alan üzerinde text index kurdum. Native protokol 4 baytlık uzunluk önekli JSON; aşağıdaki istekler o protokolle gönderildi (yanıtlar birebir sunucudan):
{"cmd": "insert_many", "collection": "yazilar", "docs": [
  {"baslik": "Kütüphanedeki eski kitaplar", "metin": "Kütüphanedeki eski kitaplar yeniden düzenlendi, raflar alfabetik sıraya kondu."},
  {"baslik": "Bir romana dönüş", "metin": "Bu kitabı okumadan önce yazarın ilk romanına bakmanızı öneririm."},
  {"baslik": "Haritada edebiyat", "metin": "Kitaplarda geçen yer adlarını tek tek haritaya döktüm."},
  {"baslik": "Rust ile veritabanı yazmak", "metin": "Kendi veritabanımı yazarken tuttuğum notlar: sayfa yapısı, WAL ve indeksler."},
  {"baslik": "Kahve demlemenin altı yolu", "metin": "French press, V60 ve moka pot ile kahve demlemek üzerine kısa bir rehber."},
  {"baslik": "Çocuklar için masallar", "metin": "Çocuklar için resimli masal kitapları seçerken dikkat ettiğim şeyler."},
  {"baslik": "Veritabanlarında indeks seçimi", "metin": "Veritabanlarında hangi alana indeks koymalı? Seçicilik ve sorgu planı."},
  {"baslik": "Kitapçıda bir öğleden sonra", "metin": "Sahaftan aldığım kitapların listesi ve kısa notlarım."}
]}
{"cmd": "create_text_index", "collection": "yazilar", "fields": ["baslik", "metin"]}
{"cmd": "list_indexes", "collection": "yazilar"}
{"ok": true, "data": [1, 2, 3, 4, 5, 6, 7, 8]}
{"ok": true, "data": "text index created"}
{"ok": true, "data": [{"name": "_text", "index_type": "text", "fields": ["baslik", "metin"], "unique": false}]}Index kurulurken mevcut belgeler geriye dönük indekslenir (backfill). Koleksiyon başına tek bir text index var, adı her zaman _text; birden çok alanı kapsayabilir, alan yolu nokta notasyonu (meta.ozet) da olabilir. String dizileri de okunur, sayılar ve diğer tipler atlanır.
Türkçe kök bulma
Asıl görmek istediğim şey, Türkçe eklerin aramayı bozmaması. kitap diye aradığımda kitaplar, kitabı, kitapları, kitapların geçen belgelerin de gelmesi gerekiyor:
== kitap ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
0.5500  _id=8  Kitapçıda bir öğleden sonra
0.5276  _id=2  Bir romana dönüş
0.5069  _id=3  Haritada edebiyat
0.5069  _id=6  Çocuklar için masallar

== kitaplar ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
...
== kitaplarda ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
...
Üç sorgu da aynı beş belgeyi aynı skorlarla döndürdü, çünkü üçü de aynı köke iniyor. kitabı içindeki b/p yumuşaması da Snowball'un Türkçe kurallarıyla çözülüyor. Aynı denemenin kısa bir dökümü:
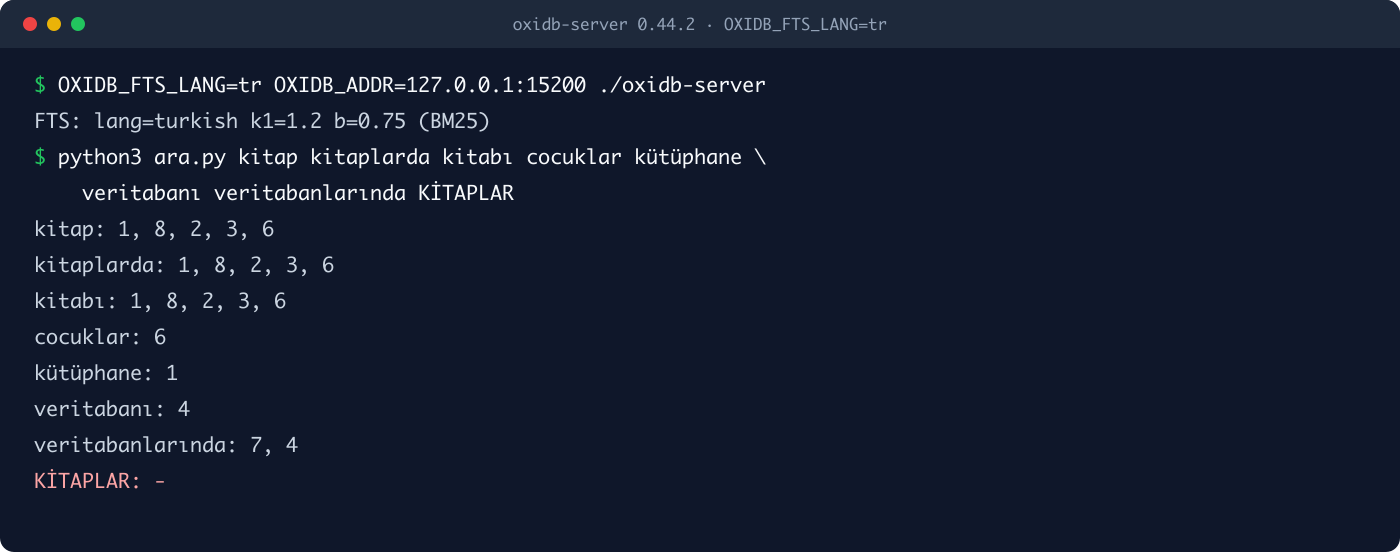
Belge numaraları şunlar: 1 "eski kitaplar", 2 "Bu kitabı", 3 "Kitaplarda geçen", 6 "masal kitapları", 8 "kitapların listesi", 4 "veritabanı, veritabanımı", 7 "Veritabanlarında".
Dikkat çeken iki şey var. cocuklar diye Türkçe karakter kullanmadan yazdığımda da Çocuklar geçen belge geliyor. Bunun sebebi tokenizer'ın kök bulmadan önce aksanları silmesi (ç→c, ş→s, ğ→g, ı→i, ö→o, ü→u). Türkçe klavyesi olmayan bir kullanıcının aramasının çalışması güzel bir yan etki. Ama aynı satırın bedelini de görüyorsunuz; bunlara "sınırlar" bölümünde döneceğim.
Sorgu nasıl yorumlanıyor
text_search sorgudaki terimleri VEYA ile birleştirir: herhangi biri geçen belge sonuca girer, birden çoğu geçen belge daha yüksek skor alır. eski kitaplar araması "eski" geçen tek belgeyi en üste koyuyor, sadece "kitap" geçenleri arkaya diziyor:
== eski kitaplar == 1:3.041; 8:0.550; 2:0.528; 3:0.507; 6:0.507Tırnaklı ifade araması, AND/NOT operatörleri ya da alan bazlı ağırlıklandırma yok. Bunu bilerek basit tuttum: sorgu da belgeyle aynı tokenizer'dan geçiyor ve terimler toplanıyor. Skor eşitse sıralama _id'ye göre yapılıyor; bunu sonradan ekledim, çünkü eşitlerin sırası hash map'in iterasyon sırasına kalınca sayfalama her çağrıda farklı sonuç veriyordu.
Vurgulu parçalar: <mark>
highlight alanı verirseniz her sonuç için, indekslenen her string alandan <mark> etiketli kısa parçalar döner. Aynı tokenizer kullanıldığı için kitaplar sorgusu kitabı kelimesini de işaretliyor. Bu sefer REST arayüzünden, curl ile denedim:
curl -s -X POST http://127.0.0.1:15220/api/yazilar/text_search \
  -H 'Content-Type: application/json' \
  -d '{"query":"çocuk kitapları","limit":2,"highlight":{"snippet_chars":50,"max_snippets":1}}'
[
{
"_id": 6,
"_version": 1,
"baslik": "Çocuklar için masallar",
"metin": "Çocuklar için resimli masal kitapları seçerken dikkat ettiğim şeyler.",
"_score": 3.0199245077882484,
"_highlights": {
"baslik": ["<mark>Çocuklar</mark> için masallar"],
"metin": ["<mark>Çocuklar</mark> için resimli masal <mark>kitapları</mark> seçerken dikkat ettiği"]
}
},
{
"_id": 1,
"_version": 1,
"baslik": "Kütüphanedeki eski kitaplar",
"metin": "Kütüphanedeki eski kitaplar yeniden düzenlendi, raflar alfabetik sıraya kondu.",
"_score": 0.6557111258304198,
"_highlights": {
"baslik": ["Kütüphanedeki eski <mark>kitaplar</mark>"],
"metin": ["Kütüphanedeki eski <mark>kitaplar</mark> yeniden düzenlendi, raf"]
}
}
]highlight: true varsayılanları kullanır (80 karakter, en fazla 3 parça); nesne verirseniz snippet_chars ve max_snippets ile ayarlarsınız. Parçalar eşleşme yoğunluğuna göre sıralanır. Kesme noktaları UTF-8 karakter sınırına oturtuluyor: Rust'ta bir string'i Türkçe bir harfin ortasından kesmek panic demek, o yüzden bunu Türkçe metinle ayrıca test ediyorum. Etiketler kütüphane düzeyinde değiştirilebilir (highlight_with_tags), sunucu <mark> kullanıyor. Vurgulama her sonuç için metni yeniden tokenize ettiğinden ücretsiz değil: sadece istendiğinde yapılır ve alan başına ilk 256 KB ile sınırlıdır (OXIDB_FTS_MAX_HIGHLIGHT_BYTES).
Güncelleme ve silme anında yansır
Koleksiyon text index'i yazma yolunun içinde güncelleniyor, yani bir update döndüğü anda arama yeni metni görüyor:
text_search 'moka' -> 5:1.595
>>> {"cmd": "update", "collection": "yazilar", "query": {"_id": 5}, "update": {"$set": {"metin": "Moka pot ile kahve: bir kitaptan öğrendiğim üç püf noktası."}}}
{"ok": true, "data": {"modified": 1}}
text_search 'moka' -> 5:1.210
text_search 'kitap' -> 1:0.430, 8:0.361, 2:0.346, 3:0.332, 6:0.332, 5:0.307
>>> {"cmd": "delete", "collection": "yazilar", "query": {"_id": 5}}
{"ok": true, "data": {"deleted": 1}}
text_search 'moka' ->
Belge 5'e "kitaptan" kelimesi girince kitap sonuçlarına katıldı, diğer belgelerin skorları da düştü: korpusta "kitap" geçen belge sayısı arttığı için terimin IDF'i azaldı. Silmeden sonra moka boş döndü.
BM25: skorlar nereden geliyor
İlk sürümde TF-IDF kullanıyordum. İki sorunu vardı: uzun belgeler sırf uzun oldukları için öne geçiyordu ve bir kelimeyi on kez tekrar eden belge on kat skor alıyordu. 0.25.9'da BM25'e geçtim ve Lucene/Elasticsearch'ün varsayılanlarını aldım: k1 = 1.2, b = 0.75.
Bir terimin bir belgedeki katkısı:
idf   = ln( (N - df + 0.5) / (df + 0.5) + 1 )
norm  = 1 - b + b * (dl / avgdl)
score = idf * tf * (k1 + 1) / (tf + k1 * norm)
Burada N belge sayısı, df terimi içeren belge sayısı, tf terimin o belgedeki frekansı, dl belgenin token sayısı, avgdl korpustaki ortalama. Çok terimli sorguda katkılar toplanır.
Davranışı görmek için İngilizce sunucuda üç belgeyi özellikle kurdum: "raft" kelimesini iki kez geçiren 8 token'lık kısa bir not, bir kez geçiren 54 token'lık uzun bir metin ve kelimeyi 13 kez tekrar eden 35 token'lık bir belge.
== raft ==
1.8004  _id=3  Raft raft raft
1.5453  _id=1  Raft in five minutes
0.5291  _id=2  Notes from a long week of operations
13 tekrar, 2 tekrara karşı yalnızca %16 fazla skor getiriyor: k1 doygunluğu bu. Skorları Python'da formülle elle hesapladım (N=8, avgdl=18.5, df=3, idf=0.9445) ve dört basamağa kadar aynı çıktı: 1.5453, 0.5291, 1.8004.
Sonra sunucuyu OXIDB_FTS_B=0 ile yeniden başlattım, yani uzunluk normalizasyonunu kapattım:
FTS: lang=english k1=1.2 b=0 (BM25)
== raft (b=0) ==
1.9022  _id=3  Raft raft raft
1.2986  _id=1  Raft in five minutes
0.9445  _id=2  Notes from a long week of operations
Uzun belge 0.53'ten 0.94'e çıktı, kısa not 1.55'ten 1.30'a indi. Index'i yeniden kurmam gerekmedi, çünkü k1 ve b sorgu anında uygulanıyor; index yalnızca tf, dl ve toplam token sayısını saklıyor.
Ayarlar
Tüm FTS ayarları süreç başında bir kez okunup önbelleğe alınıyor (OnceLock), yani değiştirmek için sunucuyu yeniden başlatmak gerekiyor:
| Değişken | Varsayılan | Ne yapar |
|---|---|---|
OXIDB_FTS_LANG | english | Snowball dili: tr, de, fr, es, it, pt, ru, nl, da, fi, hu, no, ro, el, ar, sv, ta, en (18 dil) |
OXIDB_FTS_K1 | 1.2 | Terim frekansı doygunluğu (> 0) |
OXIDB_FTS_B | 0.75 | Uzunluk normalizasyonu (0 ile 1 arası) |
OXIDB_FTS_SCORE_CAP | 200000 | Bir aramanın puanladığı en fazla farklı belge; 0 sınırsız |
OXIDB_FTS_MAX_EXTRACT_BYTES | 4 MB | Bir dosyadan çıkarılacak en fazla metin; 0 sınırsız |
OXIDB_FTS_MAX_HIGHLIGHT_BYTES | 256 KB | Vurgulamanın taradığı en fazla metin |
OXIDB_FTS_WORKERS | 1 | Dosya indeksleme worker sayısı |
OXIDB_FTS_FLUSH_INTERVAL_MS | 1000 | Blob index'inin diske yazılma aralığı |
OXIDB_OCR_LANGS | eng | Tesseract dilleri, örneğin eng+tur (yalnızca ocr özelliğiyle) |
OXIDB_OCR_PREPROCESS | açık | OCR öncesi gri ton, 2x büyütme, Otsu eşikleme |
Dikkat: index kök hâlindeki terimleri saklıyor. OXIDB_FTS_LANG'i mevcut bir veride değiştirirseniz sorgu yeni dilin köklerini, index eski dilinkileri içerir. Dil değiştirince drop_index ile _text'i silip index'i yeniden kurun.
Dosyaların içinde arama
Blob deposuna bir dosya yazıldığında (native put_object ya da S3 PUT), sunucu dosyayı bir FTS kuyruğuna atar. Worker thread dosyayı okur, içerik tipine göre metni çıkarır ve global index'e ekler. Desteklenen tipler:
| İçerik tipi | Nasıl |
|---|---|
text/* | Doğrudan |
text/html, text/xml, application/xml | Etiketler atılır |
application/json | Tüm string değerler özyinelemeli toplanır |
application/pdf | pdf_extract |
| DOCX | word/document.xml içindeki metin |
| XLSX | xl/sharedStrings.xml içindeki hücre metinleri |
image/png, jpeg, tiff, bmp | Tesseract OCR, yalnızca --features ocr ile derlenirse |
Bunu altı dosyayla denedim: bir HTML toplantı notu, bir XML ürün kataloğu, bir JSON ayar dosyası, macOS'un textutil'iyle ürettiğim bir DOCX sözleşme taslağı, bir XLSX stok listesi ve cupsfilter ile ürettiğim bir PDF fatura. Beşini native protokolle, PDF'i ise hiçbir istemci kütüphanesi kullanmadan, düz curl ile S3 arayüzünden yükledim:
curl -s -i -X PUT --data-binary @fatura.pdf -H "Content-Type: application/pdf" \
  http://127.0.0.1:15210/belgeler/fatura.pdf
HTTP/1.1 200 OK
Server: OxiDB-S3
ETag: "a249de4c7ae443472e09ffd73baf6b86"(Burada S3 kimlik doğrulaması kapalıydı, imzasız PUT bu yüzden kabul edildi. S3 tarafını S3 yazısında ayrıntılı anlatıyorum.)
İndeksleme asenkron olduğu için ne olduğunu fts_status ile görebiliyorsunuz. Kuyruk derinliği, her worker'ın o an ne yaptığı ve son işlerin sonucu:
{"cmd": "fts_status"}
queue_depth: 0, workers: [{"id": 0, "current": null}]
toplanti.html  indexed  0 ms
katalog.xml    indexed  0 ms
ayarlar.json   indexed  0 ms
sozlesme.docx  indexed  0 ms
stok.xlsx      skipped  "no extractor for content type"
fatura.pdf     indexed  3 ms
(Yanıt JSON; okunur olsun diye satırlara döktüm.) XLSX atlandı. Sebebi ilginç: dosyayı Python'un openpyxl kütüphanesiyle üretmiştim ve openpyxl hücre metinlerini sharedStrings.xml yerine hücrenin içine (inline string) yazıyor. OxiDB'nin çıkarıcısı yalnızca sharedStrings.xml'i okuyor. Excel'in kendi kaydettiği dosyalar paylaşılan string tablosunu kullandığı için pratikte çoğu dosya sorunsuz, ama "no extractor for content type" mesajı burada yanıltıcı: çıkarıcı var, sadece metin bulamadı. Aynı tabloyu paylaşılan string tablosuyla yeniden paketleyip aynı anahtara S3'ten tekrar yükleyince indekslendi; üzerine yazma eski kaydı index'ten düşürüp yenisini ekliyor.
Aramalar:
== kitap ==      ayarlar.json:0.822; stok.xlsx:0.757; toplanti.html:0.612
== depozito ==   sozlesme.docx:1.426
== kahve ==      katalog.xml:1.221; stok.xlsx:1.124
== tedarikçi ==  stok.xlsx:1.682
== faturası ==   fatura.pdf:1.109
search vurguyu da destekliyor. Burada maliyet daha yüksek: index metni saklamadığı için her sonuçta dosya yeniden okunup metni yeniden çıkarılıyor. Bu yüzden ancak istenirse yapılıyor:
{"cmd": "search", "query": "kitaplar", "bucket": "belgeler", "limit": 5,
 "highlight": {"snippet_chars": 70, "max_snippets": 1}}
{"ok": true, "data": [
{"bucket": "belgeler", "key": "ayarlar.json", "score": 1.0502388364929411,
"highlights": ["OxiDB demo <mark>Kitap</mark> arşivi için arama ayarları tr e"]},
{"bucket": "belgeler", "key": "toplanti.html", "score": 0.7880432878539266,
"highlights": ["in indeksleme kuyruğu konuşuldu. <mark>Kitapların</mark> PDF sürümleri de aranabilir olac"]}
]}Kötü niyetli dosyalara karşı
Metin çıkarma, dışarıdan gelen veriyi ayrıştırmak demek. DOCX ve XLSX zip arşivi: 100 KB'lık bir yükleme gigabaytlara açılabilir. Bu yüzden zip okuyucular 4 MB metin sınırının dört katında okumayı bırakıyor (Read::take), yani bomba hiç tam açılmıyor. PDF için bu mümkün değil, pdf_extract kendi belleğini yönetiyor; çıktıyı sonradan kırpabiliyorum ama kütüphanenin iç belleğini dışarıdan sınırlayamıyorum. Bunu kodda da açıkça yazdım. Çıkarıcılar bozuk girdide panic atabildiği için her iş catch_unwind içinde çalışıyor: tek worker varken bir panic, sürecin geri kalanı boyunca dosya indekslemeyi sessizce durduruyordu.
OCR
Görüntülerden metin çıkarmak ocr özelliğinin arkasında, çünkü Tesseract ve Leptonica sistem kütüphanelerini istiyor. Görüntü önce gri tona çevriliyor, 2 kat büyütülüyor ve Otsu yöntemiyle siyah beyaza indiriliyor; telefonla çekilmiş belge fotoğraflarında bu ciddi fark yaratıyor. Repodaki Dockerfile sunucuyu --features cluster,ocr ile derliyor. Benim kullandığım hazır macOS binary'si ise OCR'sız: bir PNG yüklediğimde fts_status dürüstçe skipped: no extractor for content type dedi.
İçeride: inverted index nasıl saklanıyor
Tokenizer
İndeksleme ve sorgu aynı fonksiyondan geçiyor: küçük harfe çevir, aksanları sil, alfanümerik olmayan karakterlerden böl, tek harfli parçaları ve stop word'leri at, Snowball ile köke indir. Stop word listesi İngilizce ve Türkçe listelerin birleşimi ve dil ayarından bağımsız olarak hep uygulanıyor.
Koleksiyon index'i: overlay ve mmap'li taban
İlk sürümde koleksiyon text index'i tamamen RAM'deydi ve her açılışta koleksiyon taranarak yeniden kuruluyordu. Projenin kendi ölçümüne göre (examples/fts_mem_bench.rs, belge başına yaklaşık 120 bayt metinle 1 milyon belge) bu index 1015 MB yer tutuyordu, belgelerin kendisi ise 38 MB'tı. Önce terimleri Arc<str> ile paylaştırıp 785 MB'a indirdim, sonra index'e bir disk formu verdim.
Şimdiki model, field index'lerinin .mfidx modelinin postings'e uygulanmış hâli:
- Taban (
<koleksiyon>.mtidx): değişmez, mmap ile açılan bir dosya. Başlık (OXTIsihirli baytları, sürüm, alanlar, toplam token sayısı), sabit genişlikli bir belge tablosu (doc_id u64, dl u32), postings (her biri 12 bayt:doc_id u64, freq u32), bayt sırasına göre sıralı bir terim tablosu ve terim stringleri. Hem belge hem terim araması mmap üzerinde doğrudan binary search. - Overlay: son persist'ten beri yazılan belgeler için küçük bir RAM index'i.
- Ölüler kümesi: taban değiştirilemediği için silinen ya da yeniden indekslenen belgelerin id'leri bir kümede tutuluyor ve arama tabandaki postings'lerini atlıyor. Bu, Lucene'in silinmiş belge bitmap'iyle aynı fikir.
Kendi verimdeki dosyanın ilk baytları:
00000000: 4f58 5449 0100 0000 0200 0500 7469 746c  OXTI........titl
00000010: 6504 0062 6f64 7994 0000 0000 0000 0008  e..body.........
Persist, belgelerin snapshot'landığı periyodik bakım tikinde yapılıyor: taban ile overlay birleştirilip ölüler atılarak yeni bir dosya yazılıyor. Yazma terim terim akıyor; postings dosyada terim tablosundan önce durduğu için her terimin postings'i doğrudan dosyaya ekleniyor, yalnızca kelime dağarcığı büyüklüğündeki terim tablosu bellekte bekliyor. Dosya geçici bir isme yazılıp rename ile yerine konuyor, yani çökme anında eski dosya geçerli kalıyor. Açılışta dosya eksik, yarım ya da bozuksa koleksiyon taranıp index yeniden kuruluyor. Çökme kurtarmada WAL'dan kayıt uygulandıysa da aynı yeniden kurma yapılıyor, çünkü disk index'i çökmeden önce yazılmış ve kurtarılan kayıtları bilmiyor.
Proje ölçümlerinde bu değişiklikten sonra 1 milyon belgede yerleşik index 0 MB (mmap), kurulum tepe belleği 200 bin belgede bir persist yapılarak 265 MB, yaygın bir terimde arama tepe belleği 7.3 MB ve süre 35 ms.
Kendi makinemde daha küçük bir deneme yaptım: her biri 12 rastgele kelimeden oluşan 200.000 belge, "coffee" belgelerin yarısında, "curtain" %5'inde, "emerald" binde birinde. (Bu sunucu bir önceki denemeden kalma b=0 ile çalışıyordu; süreleri etkilemiyor.)
N=200000: insert 2.1s, create_text_index 4.06s
'emerald'          hits(top10)=10  p50=0.11 ms  p95=0.20 ms
'curtain'          hits(top10)=10  p50=1.25 ms  p95=2.42 ms
'coffee'           hits(top10)=10  p50=8.80 ms  p95=11.22 ms
'coffee emerald'   hits(top10)=10  p50=8.81 ms  p95=10.73 ms
Süreler Python istemcisinin gidiş dönüşünü de içeriyor. .mtidx dosyası 33 MB oldu (yaklaşık 2.7 milyon posting × 12 bayt).
Neden skor üst sınırı var
Terim terim BM25, sorguyla eşleşen her belge için limit uygulanmadan önce bir skor girdisi tutar. Yarım milyon belgede geçen bir terim, tek bir aramada o kadar girdi demek; projenin ölçümünde 500 bin eşleşmede sorgu başına 25 MB, 1 milyonda 51 MB. Eşzamanlı aramalarla çarpınca bu OOM'a götürüyordu. Şimdi bir arama en fazla 200.000 farklı belge puanlıyor. Önemli olan sıra: terimler en nadirden en yaygına doğru işleniyor. Böylece nadir ve bilgilendirici bir terimle eşleşen belgelerin hepsi bütçe dolmadan puanlanmış oluyor; sınırın kestiği şey en yaygın (en az bilgi taşıyan) terimin listesinin kuyruğu. Sınıra ulaşıldıktan sonra zaten puanlanmış belgeler skor biriktirmeye devam ediyor, yeni belge alınmıyor.
Blob index'i ve toplu yazma
Dosya index'i aynı modeli kullanıyor (_fts/index.mtidx), iki farkla: belgeler (bucket, key) çiftiyle adlandırıldığı için postings 4 baytlık sıra numarası taşıyor (posting başına 8 bayt), ve her belge kova bazlı kota hesabı için çıkarılan metnin bayt sayısını tutuyor. İlk sürümde index tek bir index.json idi ve her belge eklendiğinde dosyanın tamamı yeniden yazılıyordu: toplu yüklemede N² disk yazımı. Şimdi worker'lar index'i yalnızca kirli olarak işaretliyor, arka plandaki bir flusher thread en fazla OXIDB_FTS_FLUSH_INTERVAL_MS (varsayılan 1 saniye) aralıkla diske yazıyor. Eski bir index.json bulunursa ilk açılışta mmap formatına taşınıp siliniyor; bozuksa karantinaya alınıp boş index'le devam ediliyor, çünkü FTS türetilmiş veri ve açılışı kilitlememeli.
Burada bir tutarlılık ödünleşimi var: koleksiyon index'i yazma anında güncel, blob index'i ise kuyruk boşalana kadar birkaç milisaniye geride. put_object'in hemen ardından gelen bir search yeni dosyayı henüz görmeyebilir. fts_status tam da bu yüzden var.
Vektör arama
Vektör arama, embedding'leri belgelerin yanında saklayıp "bu sorguya anlamca en yakın belgeler hangileri" sorusunu sormak için. OxiDB embedding üretmiyor; vektörü siz (bir modelle) hesaplayıp belgenin bir alanına sayı dizisi olarak koyuyorsunuz.
Index ve sorgu
Bu yazıda bir embedding modeli kullanmadım; mekanizmayı göstermek için dört boyutlu, elle yazılmış vektörler kullandım. Boyutlar sırasıyla "veritabanı", "arama", "kahve", "kitap" ağırlığı:
{"cmd": "insert_many", "collection": "articles", "docs": [
  {"title": "B-tree page splits explained",       "emb": [0.9, 0.2, 0.0, 0.1]},
  {"title": "Building an inverted index",         "emb": [0.6, 0.9, 0.0, 0.1]},
  {"title": "BM25 by hand",                       "emb": [0.3, 1.0, 0.0, 0.2]},
  {"title": "HNSW graphs for embeddings",         "emb": [0.5, 0.8, 0.0, 0.0]},
  {"title": "Pour-over coffee ratios",            "emb": [0.0, 0.0, 1.0, 0.1]},
  {"title": "Coffee shops with good bookshelves", "emb": [0.0, 0.1, 0.7, 0.7]},
  {"title": "Second-hand books in Istanbul",      "emb": [0.0, 0.1, 0.1, 1.0]},
  {"title": "Reading list: database internals",   "emb": [0.8, 0.3, 0.0, 0.8]}
]}
{"cmd": "create_vector_index", "collection": "articles", "field": "emb", "dimension": 4, "metric": "cosine"}
{"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": [0.7, 0.7, 0.0, 0.0], "limit": 3}
{"ok": true, "data": [
{"title": "Building an inverted index", "emb": [0.6, 0.9, 0.0, 0.1], "_id": 2, "_version": 1,
"_similarity": 0.9882084, "_distance": 0.023583233},
{"title": "HNSW graphs for embeddings", "emb": [0.5, 0.8, 0.0, 0.0], "_id": 4, "_version": 1,
"_similarity": 0.9871956, "_distance": 0.025608778},
{"title": "BM25 by hand", "emb": [0.3, 1.0, 0.0, 0.2], "_id": 3, "_version": 1,
"_similarity": 0.9323735, "_distance": 0.1352529}
]}"Kahveyle okunacak kitaplar" gibi bir sorgu vektörü ([0, 0, 0.6, 0.8]) ise tamamen başka bir köşeye gidiyor:
sim=0.9925  dist=0.0151  Coffee shops with good bookshelves
sim=0.9258  dist=0.1485  Second-hand books in Istanbul
sim=0.8383  dist=0.3234  Pour-over coffee ratios
sim=0.7734  dist=0.4532  Reading list: database internals
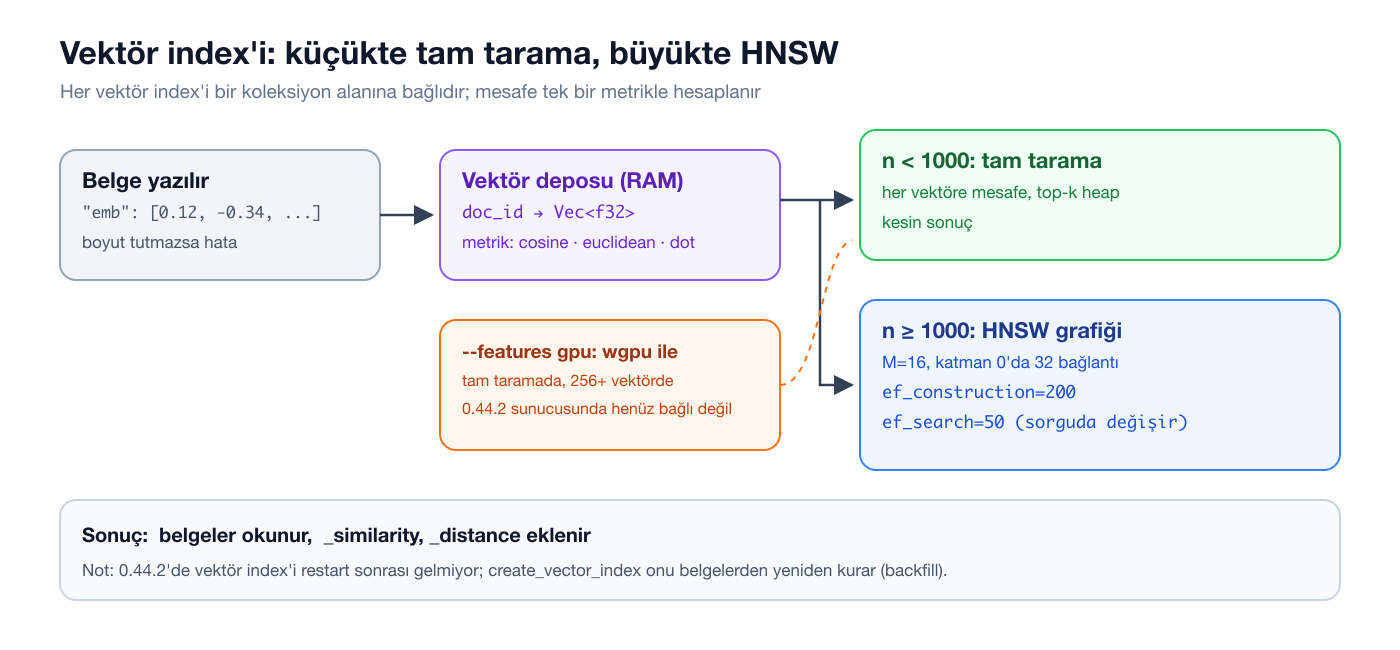
Kurallar basit: her vektör index'i bir alana bağlı (nokta notasyonu desteklenir), bir koleksiyonda farklı alanlarda birden çok vektör index'i olabilir, index kurulunca mevcut belgeler backfill ediliyor. Boyutu tutmayan vektör hata veriyor, alanı olmayan belge sessizce atlanıyor. Sonuçlar tam belge olarak, _distance (düşük iyi) ve _similarity (0 ile 1 arası, yüksek iyi) eklenerek dönüyor.
Üç metrik, üç farklı cevap
Metrik seçimi sonucu gerçekten değiştiriyor. Bunu görmek için aynı dört noktayı üç ayrı alana koyup her birine farklı metrikle index kurdum ve [1, 1] ile sordum. B, A ile aynı yönde ama beş kat uzun:
query = [1.0, 1.0]
-- cosine
   A [1.0, 1.0]   distance=-1.19209e-07 similarity=1.0000
   B [5.0, 5.0]   distance=0           similarity=1.0000
   C [1.2, 0.8]   distance=0.0194193   similarity=0.9903
   D [-1.0, 2.0]  distance=0.683772    similarity=0.6581
-- euclidean
   A [1.0, 1.0]   distance=0           similarity=1.0000
   C [1.2, 0.8]   distance=0.282843    similarity=0.7795
   D [-1.0, 2.0]  distance=2.23607     similarity=0.3090
   B [5.0, 5.0]   distance=5.65685     similarity=0.1502
-- dot_product
   B [5.0, 5.0]   distance=-10         similarity=0.0000
   A [1.0, 1.0]   distance=-2          similarity=0.1192
   C [1.2, 0.8]   distance=-2          similarity=0.1192
D [-1.0, 2.0] distance=-1 similarity=0.2689- cosine (
1 - cos) yalnızca yöne bakıyor: A ile B eşit. Metin embedding'leri için varsayılan ve doğru seçim. A'daki-1.19e-07float yuvarlaması. - euclidean gerçek uzaklığa bakıyor: B en sona düşüyor.
- dot_product (
-a·b) büyüklüğü ödüllendiriyor: B birinci. Normalize vektörlerde cosine ile aynı sırayı verir ve daha ucuzdur.
Bu tabloyu hazırlarken bir hata yakaladım: dot product'ta sıralama doğru, ama _similarity ters. En yakın B'nin benzerliği 0.0000, en uzak D'ninki 0.2689. Kod, yorumunda "sigmoid(dot)" yazmasına rağmen 1 / (1 + e^(-distance)) hesaplıyor, distance zaten -dot olduğu için sonuç sigmoid(-dot) oluyor. docs/vector-search.md de burada başka bir formül ((1 + d) / 2) anlatıyor. Düzeltene kadar dot product ile _distance kullanın. list_indexes de metriği dotproduct olarak gösteriyor; istek tarafında dot_product ve dotproduct ikisi de kabul ediliyor, tanınmayan bir metrik adı ise sessizce cosine'e düşüyor.
Tam tarama mı, HNSW mi
Index 1000 vektörün altındayken her sorguda tüm vektörlere mesafe hesaplanıyor ve bir heap ile en yakın k tutuluyor; sonuç kesin. 1000'e ulaşınca bir HNSW (Hierarchical Navigable Small World) grafiği kuruluyor ve sonraki eklemeler grafiğe artımlı giriyor. Parametreler: M = 16 (katman 0'da 32) bağlantı, ef_construction = 200, sorguda ef_search varsayılan 50 ve istek başına değiştirilebiliyor. Silinen bir düğümün bağlantıları komşularından koparılıyor, silinenler düğümlerin %20'sini geçince grafik baştan kuruluyor; vektör sayısı 500'ün altına inerse grafik bırakılıp tam taramaya dönülüyor.
Belgeler HNSW için ">%95 recall" diyor. Bunu ölçmek istedim. 50 merkez etrafında kümelenmiş sentetik vektörler ürettim (düzgün dağılımlı gürültüden gerçek embedding'lere daha yakın), 200 sorgu için numpy ile kesin cosine sonuçlarını hesapladım ve OxiDB'nin döndürdüğü ilk 10 ile karşılaştırdım:
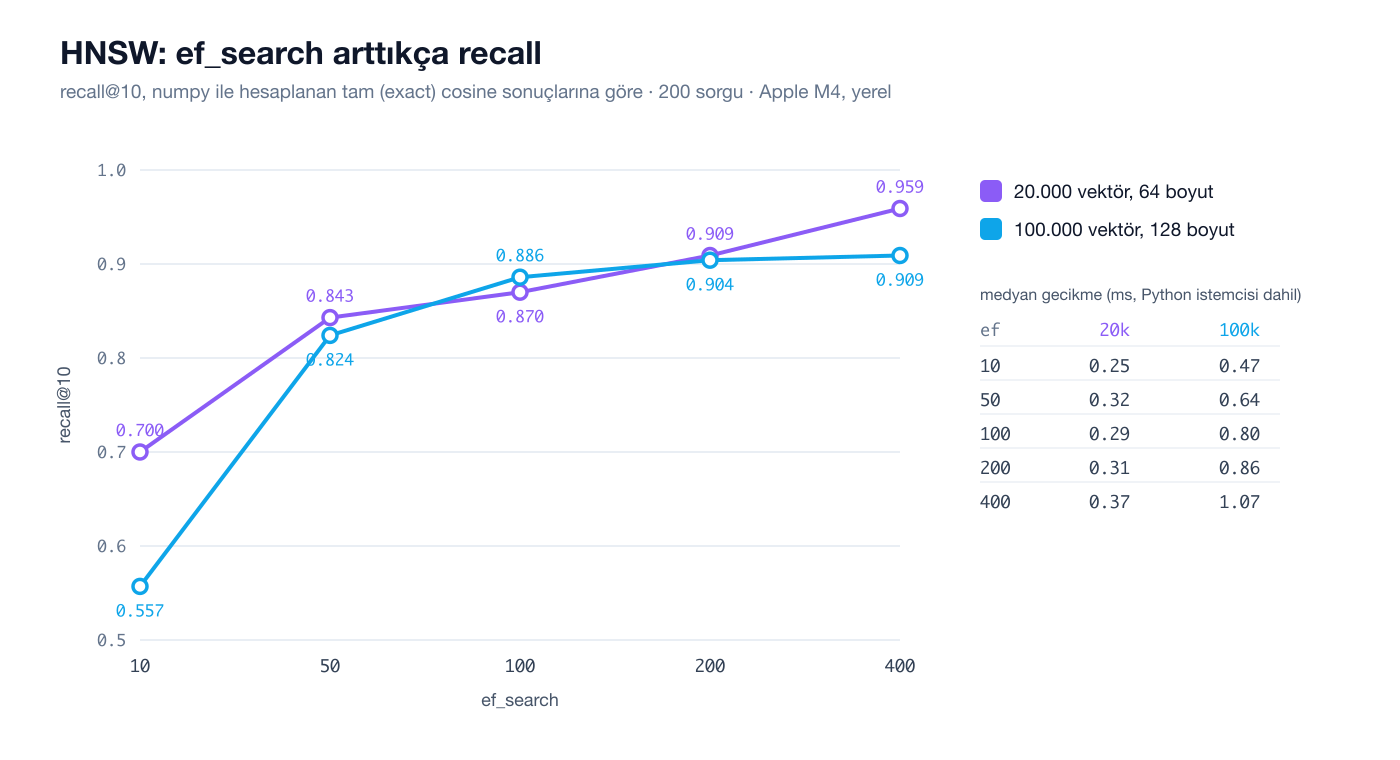
N=20000 D=64: insert 1.03s, create_vector_index 2.28s
ef_search=10   recall@10=0.700  latency p50=0.25 ms  p95=0.35 ms
ef_search=50   recall@10=0.843  latency p50=0.32 ms  p95=0.65 ms
ef_search=100  recall@10=0.870  latency p50=0.29 ms  p95=0.40 ms
ef_search=200  recall@10=0.909  latency p50=0.31 ms  p95=0.39 ms
ef_search=400  recall@10=0.959  latency p50=0.37 ms  p95=0.51 ms

N=100000 D=128: insert 9.92s, create_vector_index 34.45s
ef_search=10   recall@10=0.557  latency p50=0.47 ms  p95=0.54 ms
ef_search=50   recall@10=0.824  latency p50=0.64 ms  p95=0.74 ms
ef_search=100  recall@10=0.886  latency p50=0.80 ms  p95=1.11 ms
ef_search=200  recall@10=0.904  latency p50=0.86 ms  p95=0.97 ms
ef_search=400  recall@10=0.909  latency p50=1.07 ms  p95=1.31 ms
Dürüst sonuç: bu veride varsayılan ef_search=50 ile recall %82-84, %95'e değil. 20 bin vektörde ef_search=400 %96'ya çıkıyor; 100 bin vektörde %91 civarında tıkanıyor, yani orada sınır sorgu genişliği değil grafiğin kalitesi. Gecikme ise her durumda bir milisaniye civarında (Python istemcisiyle gidiş dönüş dahil). Pratik önerim: recall önemliyse ef_search'ü 200-400 verin. Kesin sonuç gerekiyorsa şu an tam taramayı 1000 vektörün üstünde zorlamanın bir yolu yok; o eşik kodda sabit. 900 vektörlük kontrol denemesinde, beklendiği gibi, her ef_search değerinde recall 1.000 çıktı.
GPU
--features gpu ile derlendiğinde src/gpu.rs wgpu üzerinden bir WGSL compute shader çalıştırıyor: cosine, euclidean ve dot için üç giriş noktası, 256'lık iş grupları, her GPU thread'i sorgu ile bir vektör arasındaki mesafeyi hesaplıyor, en yakın k'yı CPU seçiyor. macOS'ta Metal, Linux'ta Vulkan, Windows'ta DX12. Tasarım tam taramayı 256 ve üstü vektörde GPU'ya vermek.
Ama yazıyı hazırlarken kodu okuyunca şunu gördüm: 0.44.2 sunucusu açılışta GPU'yu başlatıp "GPU compute: enabled" yazıyor ve tutamacı motora veriyor, ancak motor bu tutamacı koleksiyonların vektör index'lerine iletmiyor (VectorIndex::set_gpu hiçbir yerden çağrılmıyor). Yani bu sürümde GPU yolu fiilen devrede değil. Benim kullandığım binary zaten GPU'suz derlenmişti, bu yüzden GPU ile ölçüm de yapmadım. Bağlantıyı tamamlamak listemde.
Kalıcılık: vektör index'i restart'ta kayboluyor
docs/vector-search.md index'in .vidx dosyalarına yazılıp açılışta geri yüklendiğini söylüyor. Bu, eski Collection motoru için doğru. Sunucunun bugün kullandığı B-tree koleksiyonlarında vektör index'i ne index metadata'sına ne de diske yazılıyor. Sunucuyu yeniden başlatınca:
>>> {"cmd": "list_indexes", "collection": "articles"}
{"ok": true, "data": []}
>>> {"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": [0.7, 0.7, 0, 0], "limit": 2}
{"ok": false, "error": "invalid query: no vector index on field 'emb'; create one with create_vector_index"}
Aynı restart'tan sonra text index .mtidx'ten anında geri geldi ve aynı skorları verdi. Vektörler belgelerde durduğu için veri kaybı yok: create_vector_index idempotent ve belgelerden yeniden kuruyor. Ama 100 bin × 128 boyutta bu 34 saniye. Uygulamanızın açılışında create_vector_index çağırmak bugünkü pratik çözüm. ADR-0003'te vektör aramayı 1.0 kararlılık sözünün dışında, "API ve disk formatı değişebilir" diye işaretlemiştim; bu boşluk o kararın somut bir yüzü.
Hibrit kullanım
Kelime araması ile anlam araması farklı şeyleri iyi yapar. BM25 nadir özel isimleri, ürün kodlarını, tam kelimeleri kaçırmaz; vektör arama eş anlamlıları ve "buna benzer" sorularını yakalar. OxiDB'de ikisini birleştiren tek bir komut yok, ama ikisi aynı belgeleri aynı _id'lerle döndürdüğü için istemcide birleştirmek kolay. En sağlam yöntem Reciprocal Rank Fusion (RRF): skorların ölçeğine bakmadan sadece sıraları birleştiriyor. Kullandığım kod:
def hybrid(text, vec, k=5, rrf_k=60):
    t = o.req({"cmd": "text_search", "collection": "articles", "query": text, "limit": 20})["data"]
    v = o.req({"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": vec, "limit": 20})["data"]
    fused, title = {}, {}
    for rank, d in enumerate(t, 1):
        fused[d["_id"]] = fused.get(d["_id"], 0) + 1 / (rrf_k + rank); title[d["_id"]] = d["title"]
    for rank, d in enumerate(v, 1):
        fused[d["_id"]] = fused.get(d["_id"], 0) + 1 / (rrf_k + rank); title[d["_id"]] = d["title"]
    ...

hybrid("coffee", [0.0, 0.1, 0.1, 1.0])
Aynı articles koleksiyonuna title üzerinde bir text index ekleyip "coffee" kelimesini ve "kitap" yönündeki bir vektörü birlikte sordum:
text   : [('Pour-over coffee ratios', 1.281), ('Coffee shops with good bookshelves', 1.281)]
vector : [('Second-hand books in Istanbul', 1.0), ('Coffee shops with good bookshelves', 0.888), ('Reading list: database internals', 0.851), ('BM25 by hand', 0.64)]
RRF    :
  1. 0.03226  Coffee shops with good bookshelves
  2. 0.03178  Pour-over coffee ratios
  3. 0.01639  Second-hand books in Istanbul
  4. 0.01587  Reading list: database internals
  5. 0.01562  BM25 by hand
İki listede de geçen "Coffee shops with good bookshelves" ikisinin de birincisi olmadığı hâlde en üste çıktı. Kullandığım diğer kalıplar:
- Aday üret, yeniden sırala:
text_searchile 100 aday al, dönen belgelerdeki embedding'lerle istemcide cosine hesaplayıp yeniden sırala. Vektör index'i bile gerekmiyor. - Filtreli vektör arama:
vector_searchvetext_searchfiltre almıyor. Fazla iste (limit: 100), sonra alan koşulunu istemcide uygula; ya da öncefindile izinli_id'leri al, sonra kesiştir. - Dosya + belge: PDF'leri blob deposuna koyup
searchile bul, her dosyanın meta verisini ve embedding'ini bir koleksiyonda tut.
Vektör arama "hangi ürün buna benziyor" sorusunu bir modelin ürettiği embedding'lerle cevaplar. "Bunu alanlar yanında neyi aldı" sorusu ise başka bir şey: gözlenen davranıştan sayılan, model gerektirmeyen bir yapı. Onun için ayrı bir motor yazdım, öneri motoru yazısında anlatıyorum.
Sınırlar ve ödünleşimler
Snowball kural tabanlı ve Türkçe gibi sondan eklemeli bir dilde mükemmel değil. Bu yazının denemelerinde gördüklerim:
veritabanıileveritabanlarındafarklı köklere iniyor.veritabanıaraması "Veritabanlarında indeks seçimi" belgesini bulmadı;veritabanlarındaiseveritabanımıgeçen belgeyi buldu.faturaaraması, PDF'teki "faturası" kelimesini bulmadı,faturasıbuldu.demlemededemlemekvedemlemenini bulmadı.- Aksanlar kök bulmadan önce siliniyor. ASCII ile yazılan sorgular için iyi, ama Türkçe stemmer
ıveşyerineivesgörüyor; yukarıdaki kaçırmaların bir kısmının sebebi bu olabilir. KİTAPLARhiçbir şey bulmadı. Rust'ınto_lowercasefonksiyonu Türkçe büyükİ'yii+ birleşik nokta (U+0307) yapıyor, birleşik nokta alfanümerik olmadığı için kelime "ki" ve "taplar" diye bölünüyor. Bu bir hata ve düzeltilecek; o zamana kadar sorguyu istemcide Türkçe kurallarla küçük harfe çevirin.- Stop word listesi İngilizce ve Türkçe'nin birleşimi ve hep uygulanıyor: Türkçe bir index'te
notaraması boş dönüyor, çünkü "not" İngilizce stop word.
Bunların dışında: ifade araması, bulanık eşleşme, alan ağırlıklandırma yok; dil süreç geneli, koleksiyon başına değil; blob index'i birkaç milisaniye geride; vektör index'i RAM'de ve restart'ta yeniden kurulmalı; HNSW recall'u varsayılan ayarla %95'in altında; vector_search filtre almıyor ve Python istemcisinin vector_search metodu ef_search parametresini henüz geçirmiyor (ham istekle gönderilebiliyor).
Karşılığında aldığım şey: tek binary, tek kopya veri, belgeyle aynı anda güncellenen bir text index, disk tabanlı ve RAM'i şişirmeyen postings, ve bir PDF'i curl ile S3'e atıp bir saniye içinde içinde arayabilmek. Komutlar native protokolün yanında REST'te (POST /api/{koleksiyon}/text_search, burada satır düzeyi okuma kuralları da uygulanıyor) ve MCP sunucusunda araç olarak da var. Repoda examples/fts-load-tests altında sürükle bırak yüklemeli, belge görüntüleyicili ve vurgulu sonuçlu küçük bir arama arayüzü, examples/fts-demo altında da ayrı bir demo bulunuyor.
Denemek için
OxiDB'nin hazır binary'leri ve sürüm notları GitHub releases sayfasında. Docker imajı OCR desteğiyle derleniyor. Türkçe arama için tek yapmanız gereken:
OXIDB_FTS_LANG=tr ./oxidb-serverSonra bir koleksiyona create_text_index, bir bucket'a birkaç PDF, ve text_search ile search. Embedding'leriniz varsa create_vector_index ile yanlarına koyun, ama restart sonrası o çağrıyı tekrarlamayı unutmayın. Serinin bir sonraki yazısında aynı belgelerin üzerinde coğrafi sorgular ve graf geçişlerini anlatıyorum: coğrafi ve graf sorguları.