OxiDB Ledger Motoru: emir ve fill yevmiyeleri için sabit genişlikli akışlar
Borsa yevmiyeleri için yazdığım oxidb-ledger crate'i: 40 baytlık sabit kayıtlar, motorun atadığı sıra numaraları, mmap'li segmentler, dosya silerek retention ve akış başına fsync. Gerçek ölçümler ve bulduğum iki hata ile.
Bu serinin önceki yazılarındaki motorların hepsi bugün çalışan bir sunucunun içinde, bir port numarasının arkasında duruyor. Bu yazının konusu olan ledger motoru öyle değil. oxidb-ledger, OxiDB deposunda duran, testleri olan, ama henüz workspace'e eklenmemiş ve hiçbir yerden çağrılmayan genç bir crate. 0.44.2 sunucusunda onu açan bir ortam değişkeni ya da wire komutu yok. Yine de seride ona bir yazı ayırdım, çünkü OxiDB'yi bir borsanın arkasına koyma çalışmasının en ilginç tasarım kararları burada ve motorun kendisi küçük: üç dosya, yaklaşık 1650 satır Rust. Bu yazıda neden böyle bir motora ihtiyaç duyduğumu, kaydın bayt bayt nasıl yerleştiğini, segmentleri, retention'ı, fsync'i ve okuma yolunu anlatacağım. Sunucu bu motoru açmadığı için bütün örnekleri, crate'in kaynak dosyalarını hiç değiştirmeden bağlayan küçük bir Rust projesiyle kendi makinemde çalıştırdım; çıktıların hepsi gerçek. Bu sırada iki hata da buldum, onları da yazının sonunda saklamadan anlatıyorum.
Neden ayrı bir motor?
OxiDB'yi bir kripto ya da menkul kıymet borsasının veri katmanı olarak konumlandırırken docs/exchange-readiness.md dosyasında baştan bir sınır çizdim: eşleştirme motoru (matching engine) veritabanının işi değil. Gerçek borsalar eşleştirmeyi tek iş parçacıklı, bellek içi bir olay döngüsünde yapar (LMAX modeli). OxiDB bunun arkasında duran kalıcı ve tutarlı katman: emirlerin, işlemlerin ve yevmiyenin (journal) saklanması, bakiye defteri, piyasa verisi, tekrar denemeye dayanıklı (idempotent) istek işleme.
Bu katmanın bugünkü hali belge motoru ve onun transaction'ları üzerine kurulu. Depodaki tests/live-exchange örneği on trader süreci ve sembol başına bir eşleştirici ile gerçek bir borsa çalıştırıyor: her fill (bir emrin karşı emirle eşleşip gerçekleşen kısmı) tek bir atomik transaction içinde iki kullanıcının USD ve varlık bakiyesini taşıyor, işlemi yazıyor, çift taraflı yevmiye kaydını ekliyor ve sembolün fiyatını son işleme çekiyor. Sonunda bir doğrulama adımı paranın yaratılmadığını, yevmiyenin denk olduğunu ve her bakiyenin yevmiyeden yeniden üretilebildiğini kontrol ediyor. README'ye göre bu kurgu, lazy-sync modunda bir dizüstünde saniyede yaklaşık 150 işlem yapıyor.
Bakiye defteri için bu doğru araç. Bir transfer, birden çok belgeyi birlikte değiştiren ve izolasyon isteyen bir iş. Ama bir borsanın iki kaydı daha var ve bunlar bambaşka bir şekle sahip:
- Emir yevmiyesi (order journal): kabul edilen her emrin değişmez kaydı. Bir onay (acknowledgement) ancak bu kayıt diskteyse bir şey ifade eder.
- Fill yevmiyesi (fill journal): her eşleşmenin kaydı: kim kiminle, hangi fiyattan, ne kadar.
Bu iki kaydın ortak özellikleri şunlar: sadece sona eklenirler (append-only), hiçbir zaman güncellenmezler, şekilleri açık artırma salonlarından beri değişmedi, sıraları kutsaldır ve eski kısımları belli bir süre sonra toptan atılır. Bu iş yüküne genel amaçlı bir yapı (B-tree, belge deposu, SQL tablosu) koyduğunuzda üç maliyet ödersiniz:
- Ekleme maliyeti geçmişle büyür. Bir B-tree'ye ekleme, ağacın tamamını, yani bütün geçmişi temsil eden bir yapıyı güncel tutmak demektir.
- Her kayıt kodlanır. Belge ya da satır kodlaması, alan adları, uzunluk önekleri, kayıt başına bir ayırma (allocation).
- Retention bir tarama ve yeniden yazmadır. "Bir ayı sil" demek, o aydaki her satırı bulmak, silmek ve index'leri güncellemek demektir.
oxidb-ledger bu üç maliyeti tasarım gereği ortadan kaldırmak için yazıldı. Crate açıklaması tek cümlede söylüyor: "append-only fixed-width streams with segment retention, for order and fill journals", yani emir ve fill yevmiyeleri için segment bazlı retention'a sahip, sadece sona eklenen, sabit genişlikli akışlar.
Durum: kodda var, sunucuda yok
Önce dürüst olayım, çünkü serinin geri kalanından farklı bir durum bu:
- Crate, 7 Eylül 2026 tarihli tek bir commit ile depoya girdi. Commit mesajı da açıkça söylüyor: "A new crate, not yet in the workspace and not referenced by anything."
oxidb-ledger/srcaltındaschema.rs,segment.rsvelog.rsvar, ama birlib.rsyok. KökCargo.tomlonu üye olarak listelemiyor,oxidb-serverona bağımlı değil.- 0.44.2 sunucu ikili dosyasında "ledger" kelimesi bir kez bile geçmiyor (
strings oxidb-server | grep -ci ledgersonucu 0). Wire protokolünde, REST'te, PostgreSQL uyumlu portta bu motoru açan bir şey yok.
Kaynak koddaki yorumlar ise nereye gittiğini gösteriyor: alan türlerinin sayısal değerleri "wire encoding" olarak tanımlanmış ve bir şemanın "soketin üzerinden bu baytlar olarak geçtiği" yazıyor; verify için "bir verify komutunun çalıştıracağı şey" deniyor. Yani hedef, istemcinin kayıtları zaten diske yazılacak baytlar halinde soketten gönderdiği bir wire yüzeyi. O yüzey henüz yazılmadı.
Bu yüzden ben de motoru, deponun dosyalarına dokunmadan, ayrı bir Cargo projesinden modül olarak bağladım:
// harness/src/lib.rs
// oxidb-ledger üç modülle geliyor ama henüz lib.rs'i yok. Bu dosya deponun
// dosyalarını değiştirmeden tek bir kütüphanenin modülleri olarak bağlıyor,
// böylece crate::schema ve crate::segment beklendiği gibi çözülüyor.
#[path = "../OxiDB/oxidb-ledger/src/schema.rs"]
pub mod schema;
#[path = "../OxiDB/oxidb-ledger/src/segment.rs"]
pub mod segment;
#[path = "../OxiDB/oxidb-ledger/src/log.rs"]
pub mod log;
Bağımlılıklar crate'in kendi Cargo.toml'u ile aynı: crc32fast, memmap2 ve testler için tempfile. Bu düzenle crate'in kendi birim testleri de çalışıyor; sonuçlarına aşağıda değineceğim.
Veri modeli: akış, kayıt, sıra numarası
Motorun tek kavramı akış (stream). Bir akış, kök dizin altında kendi dizinine sahip, adı olan ve şeması oluşturulduğu anda sabitlenen bir kayıt dizisi. Bir borsada orders ve fills diye iki akış düşünün.
Sabit genişlik, sabit yerleşim
Bu motordaki her kayıt sabit genişlikte ve sabit yerleşimde. Bu, bütün tasarımın temeli: bir ekleme, zaten yeri olan bir tampona copy_from_slice; bir tarama, bilinen bir adımla belleği yürümek. Satır kodlaması yok, alan başına uzunluk öneki yok, kayıt başına ayırma yok, yazma ya da okuma yolunda ayrıştırılacak (parse) hiçbir şey yok.
Bunun bedeli, belge deposunun verdiği esnekliği bırakmak: bir kayıt bir alanı büyütemez, bir alan eksik olamaz. Emir ve fill yevmiyesi için bu bir kayıp değil. Kaynak koddaki yorumu seviyorum: bir fill'in şeklini değiştiren bir borsanın, depolama motoru ne yaparsa yapsın, elinde zaten bir migration vardır.
Alan türleri sekiz tane: I8, U8, I16, U16, I32, U32, I64, U64. Bir akış seq ve ts dışında en fazla 16 alan tanımlayabilir. Bu bir depolama sınırı değil, bir sorgu sınırı: yüklemler (predicate) sabit bir dizide tutulacak, böylece değerlendirilirken hiçbir şey ayırmayacaklar. Kaydın tamamı en fazla 4 KiB olabilir; bu tavan, soketten gelen bir şemanın sınırsız büyüklükte bir segment istemesini engellemek için.
İki zorunlu alan
Her kayıt u64 bir sıra numarası (seq, ofset 0) ve i64 bir zaman damgası (ts, ofset 8) ile başlıyor. Bunlar tanımlanmıyor, motor onlara kendisi yer ayırıyor. İş bölümü şöyle:
- Sıra numarasını motor atar, asla istemci değil. Sıra numarası borsanın düzen hakkındaki kendi beyanı: "bu fill şundan önce oldu." Kendi numarasını seçebilen bir istemci bu beyana bağlı tutulamaz. Numaralar bir akış içinde yoğun (dense) ve monoton artan; bu yüzden bir boşluk kayıp bir kayıt demektir ve tolere edilmek yerine raporlanmaya değer.
- Zaman damgasını istemci verir, çünkü onu sadece istemci bilir. Bir piyasa fill'i eşleştiği mikrosaniyede damgalar; bu an, batch'in motora ulaştığı andan daha erkendir ve teybi analiz eden herkesin istediği sayı odur.
Her şey i64 olarak okunur
Bir alan beyan edilen genişlikte saklanıyor, ama okunurken işaretli ya da işaretsiz genişletilerek i64'e çevriliyor. Bu her iki durumda da tek bir yükleme komutu ve bir yüklemin, bir toplamın, bir projeksiyonun sekiz tür yerine tek türde çalışması demek. Bedeli, i64::MAX'ın üstündeki bir u64 alanın negatif okunması; bir yevmiyede böyle bir alan yok.
Yazarken ise sığmayan bir değer reddediliyor, kırpılmıyor. Bu, SQL motorunun beyan edilen tamsayı genişlikleri için yaptığı seçimle aynı ve gerekçesi de aynı: sessizce taşmış bir hesap numarası, doğru cevap gibi görünen yanlış bir cevaptır.
Yerleşim kuralı ve iki hazır şekil
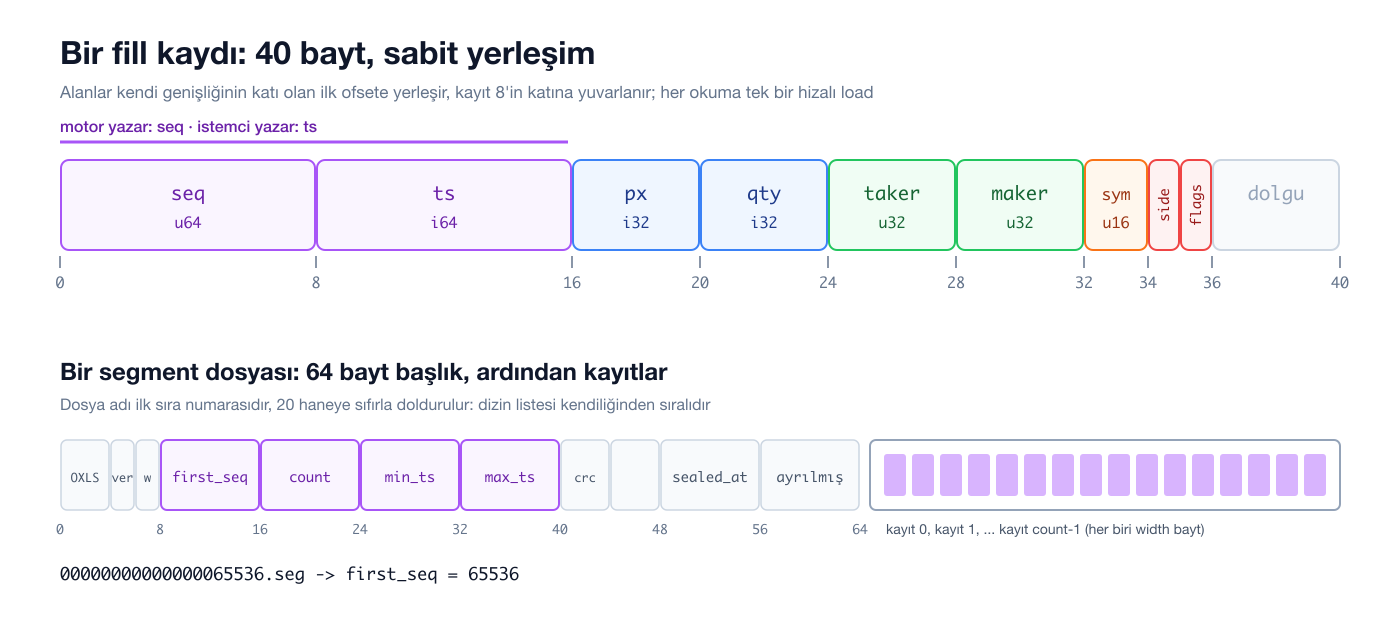
Alanlar, seq ve ts'den sonra, kendi genişliğinin katı olan ilk ofsete yerleşiyor; kayıt 8'in katına yuvarlanıyor. Böylece her okuma tek bir hizalı yükleme ve bir kayıt dizisi hizalı kalıyor. Alanları genişten dara doğru tanımlarsanız hiç dolgu boşa gitmiyor.
Crate iki hazır şekil getiriyor: shapes::fill() ve shapes::order(). Fill şöyle: px (fiyat, i32), qty (miktar, i32), taker ve maker (iki tarafın kimliği, u32), sym (sembol, u16), side (u8), flags (u8).
Kendi çalıştırmamdan, şemanın Debug çıktısı:
== layout
fill  Schema(40 B, px@16:I32, qty@20:I32, taker@24:U32, maker@28:U32, sym@32:U16, side@34:U8, flags@35:U8)
order Schema(40 B, px@16:I32, qty@20:I32, account@24:U32, client@28:U32, order@32:U32, sym@36:U16, kind@38:U8, side@39:U8)
Bir fill 40 bayt: bir milyon fill 40 MB. Emir kaydı da 40 bayt çıkıyor; bunu aşağıda tekrar konuşacağız, çünkü crate'in kendi testi 48 bekliyor.
Fiyatın i32 olması bilinçli: fiyatlar tamsayı "tick" olarak saklanıyor (örneklerimde 1/100 birim, yani 6412350 = 64123,50). Para miktarlarını kayan noktalı sayıyla tutmamak, defter tutan her sistemin ilk kuralı.
Kullanım: Rust API'si
Wire yüzeyi olmadığı için bugün motoru kullanmanın tek yolu Rust API'si. Bir akış oluşturmak:
use ledger_harness::log::{Durability, Stream, DEFAULT_CAPACITY};
use ledger_harness::schema::{Schema, shapes};

let s = shapes::fill();
let mut st = Stream::create(root, "fills", s, DEFAULT_CAPACITY, Durability::Commit)?;
Ekleme, kayıtları istemcinin zaten yerleştirdiği n * width baytlık bir tampon üzerinden yapılıyor. Motor her kaydın ilk sekiz baytına atadığı sıra numarasını yazıyor, gerisine dokunmuyor ve ilk sıra numarasıyla adedi döndürüyor:
let w = s.width();
let mut buf = vec![0u8; 3 * w];
for (i, r) in buf.chunks_exact_mut(w).enumerate() {
    Schema::put_ts(r, t0 + i as i64 * 250);   // zaman damgası istemciden
    s.set(r, 0, 6_412_350)?;                  // px
    s.set(r, 1, 15)?;                         // qty
}
let (first_seq, count) = st.append(&mut buf)?;
Kendi demo programımı segment kapasitesini 4 kayda indirip çalıştırdım ki segment sınırları küçük bir örnekte görünsün:
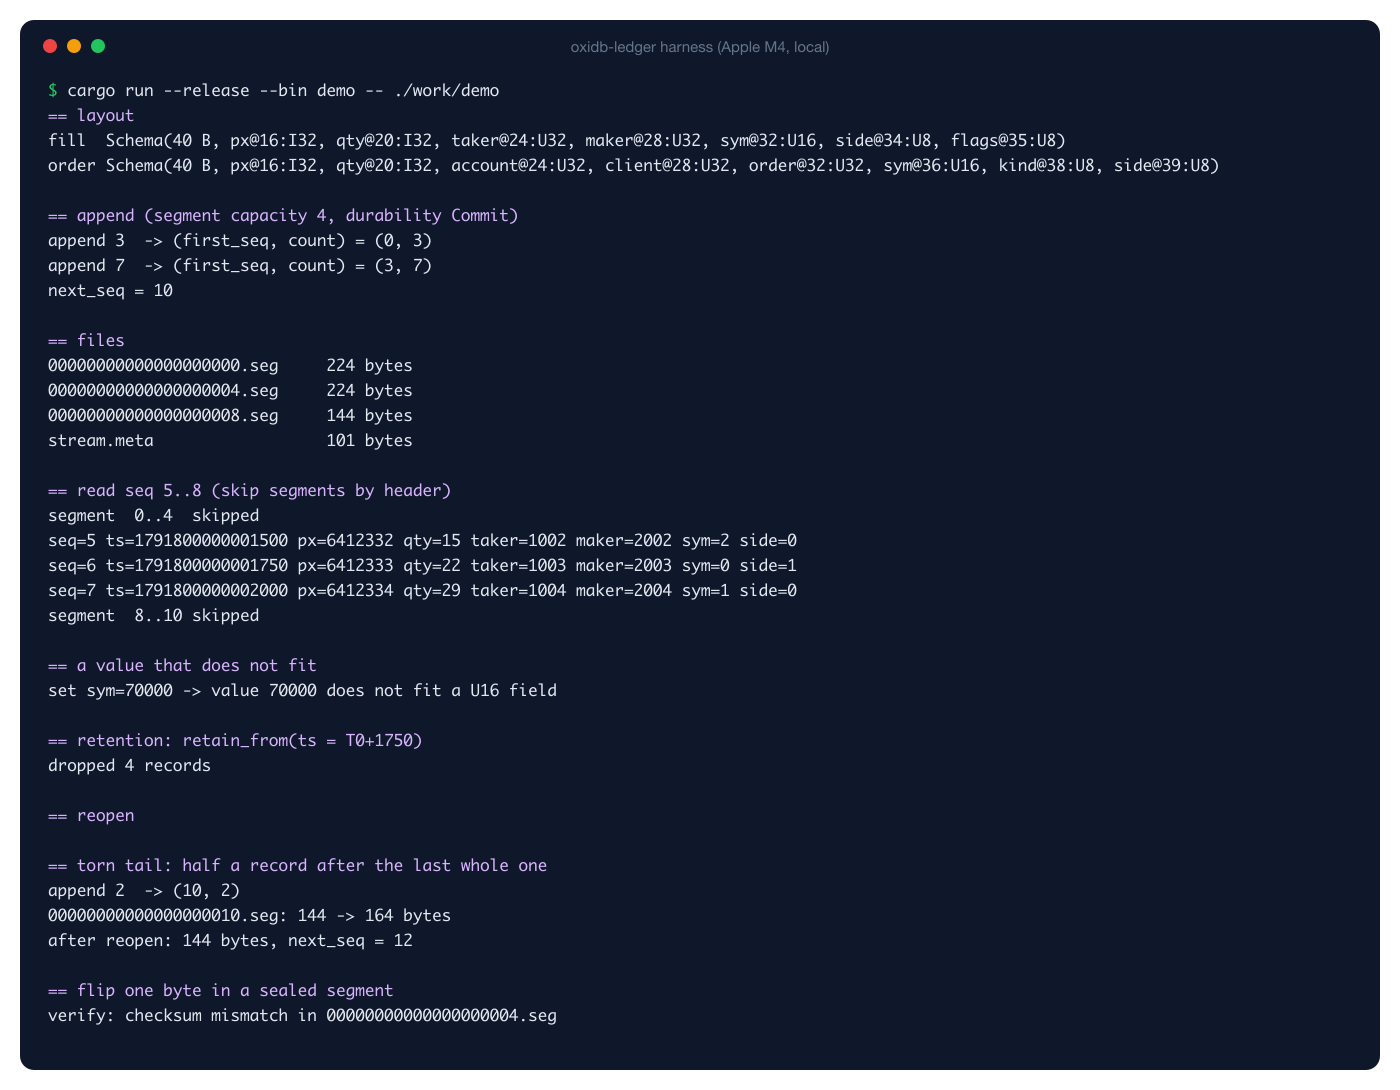
İlk iki ekleme (0, 3) ve (3, 7) döndürüyor: numaraları motor veriyor ve kaldığı yerden devam ediyor. 7 kayıtlık ikinci batch, 4 kayıtlık segment sınırını iki kez geçiyor ve reddedilmek yerine bölünüyor:
== append (segment capacity 4, durability Commit)
append 3  -> (first_seq, count) = (0, 3)
append 7  -> (first_seq, count) = (3, 7)
next_seq = 10
Stats { records: 10, segments: 3, bytes: 592, first_seq: 0, next_seq: 10, min_ts: 1791800000000000, max_ts: 1791800000002500, appended: 10, dropped: 0 }

== files
00000000000000000000.seg     224 bytes
00000000000000000004.seg     224 bytes
00000000000000000008.seg     144 bytes
stream.meta                  101 bytes
Bir kayıt iki segmente bölünemez; bu yüzden append, batch'i segmentlerin aldığı kadar parçaya ayırıyor. Segmentten küçük bir batch için bu tek parça, sınıra denk gelen batch için iki parça.
Sığmayan bir değerin reddi de gerçek:
== a value that does not fit
set sym=70000 -> value 70000 does not fit a U16 field
Segmentler: motorun ucuz yaptığı her şeyin birimi
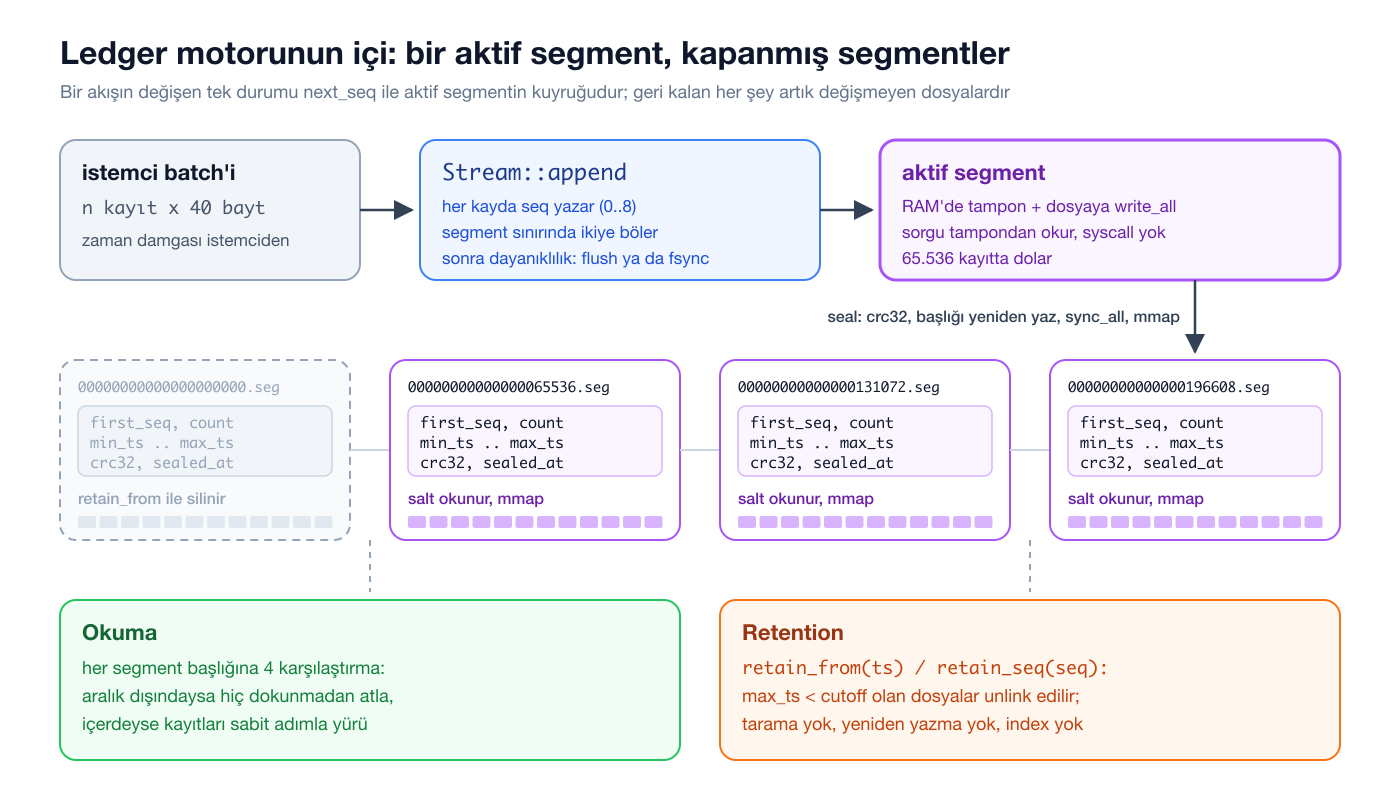
Bir segment, bir başlık ve ardından gelen sabit genişlikli kayıtlardan oluşan bir dosya. Bir kez, baştan sona yazılıyor ve bir daha hiç değiştirilmiyor. Kayıt sayısı kapasiteye ulaştığında kapatılıyor (sealed): başlık tamamlanıyor, dosya diske yazılıyor ve belleğe eşleniyor (mmap). O andan itibaren çekirdeğin motor bilmeden belleğe alıp çıkarabildiği salt okunur baytlar.
Dosya adı ve başlık
Bir segmentin dosya adı, başladığı sıra numarası; 20 haneye sıfırla doldurulmuş. Dizin listesi kimse bir şey ayrıştırmadan sıralı geliyor. Başlık 64 bayt:
| Ofset | Alan | Anlamı |
|---|---|---|
| 0 | magic OXLS | OxiDB ledger segment |
| 4 | version | şu an 1 |
| 6 | width | kayıt genişliği |
| 8 | first_seq | ilk kaydın sıra numarası |
| 16 | count | kayıt sayısı (kapatılana kadar 0) |
| 24 | min_ts | gözlenen en küçük zaman damgası |
| 32 | max_ts | gözlenen en büyük zaman damgası |
| 40 | crc | kayıt baytlarının CRC32'si |
| 48 | sealed_at | kapatma anındaki duvar saati (ms) |
Demo dizinindeki bir segmentin ilk 104 baytı xxd ile şöyle görünüyor:
00000000: 4f58 4c53 0100 2800 0800 0000 0000 0000  OXLS..(.........
00000010: 0200 0000 0000 0000 ca38 82f2 a15d 0600  .........8...]..
00000020: c439 82f2 a15d 0600 a64c ef3c 0000 0000  .9...]...L.<....
00000030: 8a27 eb2c a101 0000 0000 0000 0000 0000  .'.,............
00000040: 0800 0000 0000 0000 ca38 82f2 a15d 0600  .........8...]..
00000050: 2fd8 6100 2400 0000 ed03 0000 d507 0000  /.a.$...........
00000060: 0200 0100 0000 0000 ........OXLS, sürüm 1, genişlik 0x28 = 40, first_seq 8, count 2, ardından min_ts, max_ts, CRC ve sealed_at. 64. bayttan itibaren ilk kayıt başlıyor: seq 8, ts, 0x61d82f = 6412335 fiyat, 0x24 = 36 miktar, taker 1005, maker 2005, sym 2, side 1. Ayrıştırıcı yok, çünkü ayrıştırılacak bir şey yok.
sealed_at alanının ayrı bir gerekçesi var: kaydın yaşına göre retention max_ts'i kullanıyor; sealed_at ise yazmanın yaşına göre retention için. Kayıtların kendi zaman damgalarına güvenilemediğinde bir operatörün sorduğu farklı bir soru bu.
Aktif segment
Yazılmakta olan segment hem dosyaya yazılıyor hem bellekte tutuluyor. İkisi farklı sorulara cevap veriyor: dosya hayatta kalan şey, tampon ise bir sorgunun syscall olmadan okuduğu şey. 65.536 kayıtlık varsayılan kapasitede 40 baytlık kayıtlarla bu tampon 2,6 MB ve motorun akış başına tuttuğu, eşlenmiş dosya olmayan tek bellek bu.
Varsayılan kapasitenin gerekçesi kaynakta yazıyor: 2,6 MB'lık bir dosya, retention'ın ince taneli olmasına yetecek kadar küçük (son dakikayı tutmak isteyen operatör son saati değil son dakikayı alır) ve kapatmanın (bir eklemenin gerçek iş yaptığı tek yer) sürekli değil, saniyede 35 bin kayıtta saniyede iki kez olmasına yetecek kadar büyük.
Neden ekleme maliyeti sabit?
Bir akışın değişen durumunun tamamı next_seq ve aktif segmentin kuyruğu. Geri kalan her şey bir daha değişmeyecek dosyalar. Geçmişi kapsayan, güncel tutulması gereken bir yapı yok. Kodda bir eklemenin yaptığı iş şu: sıra numaralarını damgala, bir extend_from_slice, bir write_all, L1'de hâlâ sıcak olan baytların üzerinden min/max zaman damgası için ikinci bir geçiş, sonra dayanıklılık ayarına göre flush ya da fsync. Bunların hiçbiri öncesinde kaç segment olduğuna bakmıyor.
Bunu ölçmeye de çalıştım ve burada dürüst olmam gerekiyor; sonuçları aşağıdaki performans bölümünde ayrıntılı veriyorum.
Açılış
Bir akışı yeniden açmak, kapanmış segmentlerin tek bir kaydını bile okumuyor. Her birinin 64 baytlık başlığını okuyup gerisini eşliyor ve sadece kapatılmamış son segmenti yeniden oynatıyor. 10 milyon kayıt ve 153 segmentlik bir akış benim makinemde 25 ms civarında açıldı.
Dayanıklılık: akış başına üç ayar
Dayanıklılık akış başına seçiliyor, çünkü iki yevmiye farklı cevaplar istiyor:
| Ayar | Anlamı |
|---|---|
Durability::Os | Baytları işletim sistemine ver ve devam et. Sürecin çökmesi hiçbir şey kaybettirmez; makinenin çökmesi sayfa önbelleğinin henüz yazmadığını kaybettirir. |
Durability::Sealed | Diske sadece segment kapanırken ulaş. Risk penceresi bir segment. |
Durability::Commit | append dönmeden diske ulaş. Bir onayın beklediği şey bu. |
Kaynaktaki gerekçe şu: bir fill yevmiyesi bir elektrik kesintisinde son birkaç milisaniyeyi kaybetmeyi göze alabilir, çünkü fill'ler zaten kablo üzerinde, tarayıcıda ve zaman serisinde de var. Emir yevmiyesi alamaz: varlık sebebi, bir onayın emrin hayatta kaldığı anlamına gelmesi ve bu ancak yazma onaydan önce diske ulaştıysa doğru.
Bunu motorun geri kalanıyla aynı felsefede kurdum: bkz. OxiDB'nin varsayılan olarak her commit'te WAL ve commit log'u fsync etmesi (belge motoru yazısı). Kapatma her durumda sync_all ile bitiyor; yani kapanmış bir segment, ayar ne olursa olsun diskte.
Ölçtüğüm rakamlar (Apple M4 Mac, dahili SSD, macOS, her yapılandırma 3 saniye ya da belirli bir kayıt sayısına kadar):
Os      batch     1:    1443154 records in   3.00 s =      481051 rec/s,       2.1 us/append call
Os      batch    16:    4000000 records in   1.99 s =     2014745 rec/s,       7.9 us/append call
Os      batch   256:    4000000 records in   1.49 s =     2683801 rec/s,      95.4 us/append call
Os      batch  4096:    4001792 records in   0.62 s =     6440016 rec/s,     636.0 us/append call
Sealed  batch     1:    1481627 records in   3.00 s =      493876 rec/s,       2.0 us/append call
Sealed  batch    16:    4000000 records in   1.72 s =     2320832 rec/s,       6.9 us/append call
Sealed  batch   256:    4000000 records in   1.12 s =     3571360 rec/s,      71.7 us/append call
Sealed  batch  4096:    4001792 records in   0.69 s =     5761754 rec/s,     710.9 us/append call
Commit  batch     1:        733 records in   3.00 s =         244 rec/s,    4094.0 us/append call
Commit  batch    16:      11648 records in   3.00 s =        3881 rec/s,    4123.0 us/append call
Commit  batch   256:     161024 records in   3.00 s =       53622 rec/s,    4774.2 us/append call
Commit  batch  4096:     401408 records in   0.52 s =      770586 rec/s,    5315.4 us/append call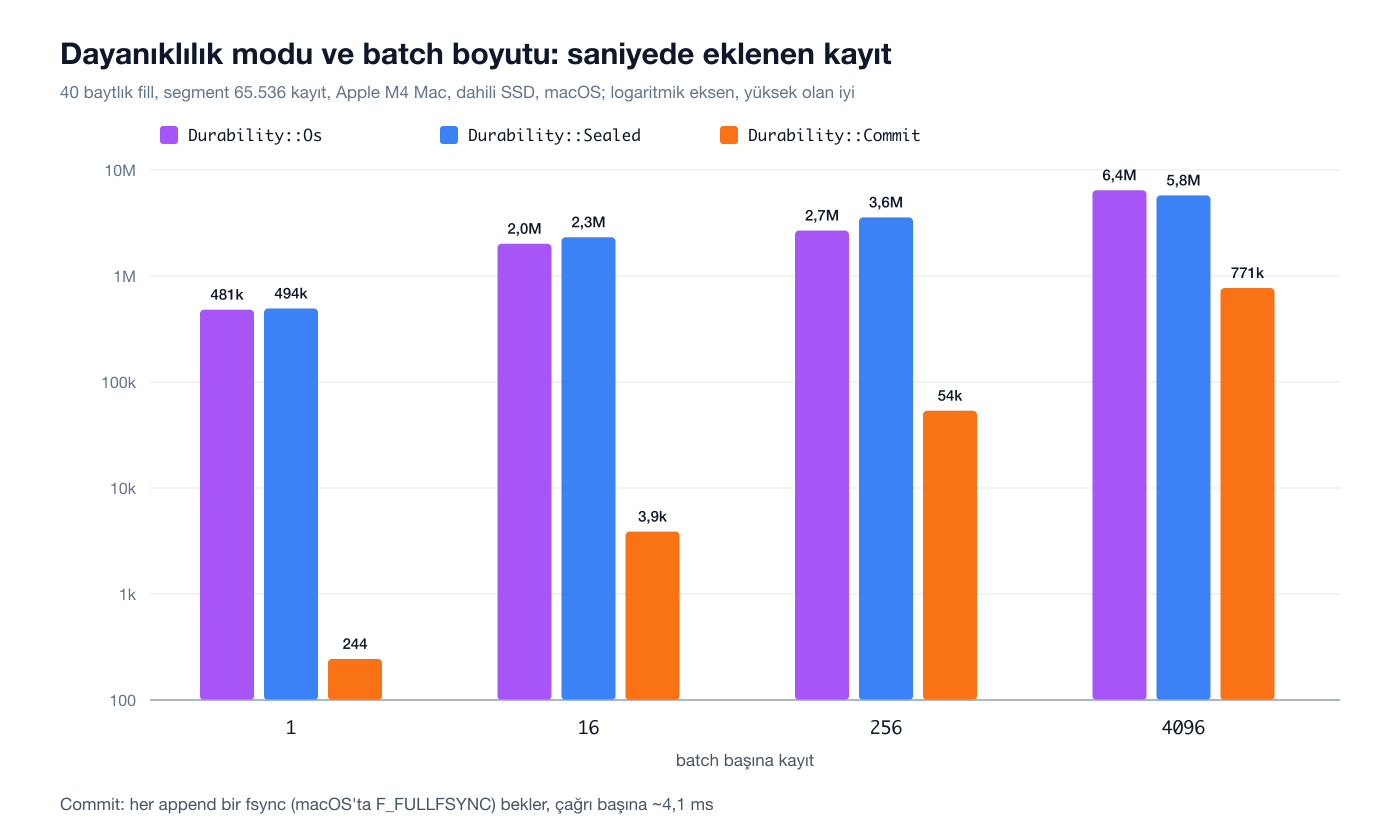
Tablonun anlattığı hikaye net:
Commitmodunda her çağrı yaklaşık 4,1 ms. Bu motorun maliyeti değil, macOS'ta Rust'ınsync_data'sının kullandığıF_FULLFSYNC'in, yani diskin kendi yazma önbelleğini boşaltmasının maliyeti. Tek kayıtlık batch'lerle bu, saniyede 244 kayıt demek.- Aynı fsync'i daha çok kayda bölüştürmek her şeyi değiştiriyor: 4096 kayıtlık batch'lerle
Commitsaniyede 770 bin kayda çıkıyor. Bu, group commit fikrinin ta kendisi ve wire yüzeyinin neden "istemci baytları batch halinde gönderir" diye tasarlandığını açıklıyor. OsveSealedçağrı başına mikrosaniyeler mertebesinde. Bu ikisinin neden neredeyse aynı çıktığına aşağıda, "bulduklarım" bölümünde döneceğim.
Okuma: sıra numarasıyla, zamanla, toplu tarama
Crate'te henüz bir sorgu dili ya da yüklem değerlendiricisi yok; şema dosyasındaki 16 alan sınırı onun için ayrılmış. Bugün olan şey, okumanın temel taşı: segments() her segmenti, en eskiden en yeniye, bir başlık ve onun anlattığı baytlar olarak veriyor. Hiçbir şey kopyalanmıyor, hiçbir şey çözülmüyor. Kapanmış segmentler için bu baytlar doğrudan mmap; aktif segment için bellek içi tampon.
Bir segmentin okunmaya değer olup olmadığına karar vermek, başlığa karşı dört karşılaştırma:
pub fn holds_seq(&self, from: u64, to: u64) -> bool {
    self.count > 0 && self.first_seq < to && self.end_seq() > from
}
pub fn holds_ts(&self, from: i64, to: i64) -> bool {
    self.count > 0 && self.min_ts < to && self.max_ts >= from
}
Aralıklar her yerde yarı açık. holds_ts ilk ve son kaydın değil gözlenen en küçük ve en büyük zaman damgasının üzerinden çalıştığı için, kayıtları sıra dışı gelen bir segment de doğru cevap veriyor.
Demo çıktısında 5..8 sıra numaralarını okurken ilk ve son segment başlığa bakılarak atlanıyor:
== read seq 5..8 (skip segments by header)
segment  0..4  skipped
seq=5 ts=1791800000001500 px=6412332 qty=15 taker=1002 maker=2002 sym=2 side=0
seq=6 ts=1791800000001750 px=6412333 qty=22 taker=1003 maker=2003 sym=0 side=1
seq=7 ts=1791800000002000 px=6412334 qty=29 taker=1004 maker=2004 sym=1 side=0
segment  8..10 skipped
Sıra numaraları yoğun olduğu için, bir segmentin içinde belirli bir kaydı bulmak arama bile gerektirmiyor: (seq - first_seq) * width. 10 milyon kayıtlık akışta tek bir kaydı numarasıyla okumak 2,1 mikrosaniye sürdü:
== one record by sequence
seq 7654321 ts 1791807654321000 px 6412331 qty 48 in 2.1 us
Zaman aralığı sorgusu da aynı mantıkla çalışıyor. Yaklaşık 2,8 saatlik market zamanını kapsayan 10 milyon fill'den bir dakikayı istediğimde 153 segmentin 151'i başlıklarına bakılarak atlandı:
== one minute out of ~2.8 hours, by timestamp
60000 records, volume 1530000; segments read 2, skipped 151; 0.166 ms
Ve toplu tarama: 10 milyon kaydın tamamı üzerinde hacim ağırlıklı ortalama fiyat (VWAP). Kayıtlar sabit adımla yürünüyor, her alan tek bir yükleme:
== full scan: VWAP and volume over every record
cold-ish 10000000 records, volume 255000000, vwap 64123.4959, 48.4 ms = 207 M rec/s, 8.26 GB/s
warm     10000000 records, volume 255000000, vwap 64123.4959, 33.1 ms = 302 M rec/s, 12.09 GB/s
Saniyede 300 milyon kayıt, tek iş parçacığı, sıcak sayfa önbelleği. "cold-ish" diyorum çünkü dosyalar az önce yazılmıştı ve büyük kısmı hâlâ önbellekteydi; gerçekten soğuk bir disk okuması daha yavaş olur.
Retention: dosya silmek
Retention, motorun en sevdiğim kısmı, çünkü neredeyse hiçbir şey yapmıyor. retain_from(cutoff), max_ts'i kesme noktasından küçük olan her kapanmış segmenti siliyor. Tarama yok, yeniden yazma yok, index bakımı yok: segment başına bir remove_file. retain_seq(cutoff) aynısını sıra numarasıyla yapıyor: "son N dakika" yerine "son N kayıt" tutmak isteyenler için.
Birkaç ayrıntı önemli:
- Test konuma göre değil her segmentin kendi
max_ts'ine göre. Saati geri atlamış bir akış tam olarak düşmesi gerekeni düşürüyor. - Aktif segmente, kayıtları ne kadar eski olursa olsun dokunulmuyor, çünkü hâlâ yazılıyor. Sessizleşmiş bir akış, başka bir şey gelip kapatana kadar son yarım segmentini tutuyor.
- Retention geçmişi siliyor, yeniden numaralandırmıyor.
next_seqkaldığı yerden devam ediyor vefirst_seqyukarı kayıyor.
Demo:
== retention: retain_from(ts = T0+1750)
dropped 4 records
Stats { records: 6, segments: 2, bytes: 368, first_seq: 4, next_seq: 10, min_ts: 1791800000001250, max_ts: 1791800000002500, appended: 10, dropped: 4 }

== reopen
Stats { records: 6, segments: 2, bytes: 368, first_seq: 4, next_seq: 10, min_ts: 1791800000001250, max_ts: 1791800000002500, appended: 10, dropped: 4 }
durability = Commit, verify failures = 0
Bir dikkat: kesme noktası T0+1750, ama düşen kayıt sadece 4. Çünkü retention segment tanesinde çalışıyor; 4..8 segmentinin max_ts'i kesme noktasının üstünde, o yüzden içindeki 1250'lik kayıt da kalıyor. Bu, "en az şunu tut" garantisi; "tam olarak şunu sil" değil.
Büyük ölçekte: 10 milyon kayıtlık akışın ilk yarısını düşürmek, üç ayrı çalıştırmada 54 ile 127 ms arasında sürdü:
== retention: drop the first half by time
dropped 4980736 records in 54.25 ms
Stats { records: 5019264, segments: 77, bytes: 200775488, first_seq: 4980736, next_seq: 10000000, ...
Kaynak kodundaki yoruma göre bu motoru yazmamın tetikleyicilerinden biri, SQL motorunda üç milyon satırlık bir DELETE'in 8,7 saniye sürmesi ve bloklamasıydı. O ölçüm benim bugün tekrarlayabileceğim bir şey değil; SQL motorunun DML yolu o zamandan beri yeniden yazıldı (0.44.2'deki "DML is one scan, ids only" commit'i). Karşılaştırma için aynı fill'leri 0.44.2 sunucusunun bugün açtığı iki motora koydum (16000 portunda, OXIDB_SQL=1, varsayılan tam dayanıklılık) ve aynı retention sorusunu sordum. Python istemcisiyle, 1 milyon kayıt:
db.sql("CREATE TABLE fills (seq BIGINT PRIMARY KEY, ts BIGINT, px INTEGER, qty INTEGER, "
       "taker INTEGER, maker INTEGER, sym INTEGER, side INTEGER)")
# 1000 satırlık INSERT'ler, her biri BEGIN/COMMIT içinde ...
db.sql(f"DELETE FROM fills WHERE ts < {cut}")

# belge motoru: insert_many ile 1000'erli, ts üzerinde index
db.create_index("fills", "ts")
db.delete("fills", {"ts": {"$lt": cut}})
ping: pong
sql insert 1000000 rows (1000/stmt): 11.15 s = 89660 rows/s
sql count: [[1000000]]
sql DELETE WHERE ts < cutoff: {'affected': 500000} in 381 ms
doc insert_many 1000000 docs (1000/call): 10.15 s = 98511 docs/s
doc delete ts < cutoff: {'deleted': 500000} in 2011 ms
doc count: 500000| Yöntem | Silinen kayıt | Süre |
|---|---|---|
SQL motoru, DELETE WHERE ts < ... | 500.000 | 381 ms |
Belge motoru, delete {ts: {$lt: ...}} | 500.000 | 2011 ms |
Ledger, retain_from (76 dosya) | 4.980.736 | 54 - 127 ms |
Bu bir yarış değil ve öyle okunmamalı: SQL ve belge motoru her satırı bulup silmeyi dayanıklı bir şekilde kaydediyor, index'leri güncelliyor, eşzamanlı okuyuculara tutarlı bir görüntü veriyor; sunucu ölçümü bir de ağ ve JSON yolu içeriyor. Asıl fark maliyetin şeklinde: SQL ve belge motorunda retention silinen satır sayısıyla orantılı, ledger'da silinen dosya sayısıyla. On kat fazla kayıt, on kat daha uzun bir silme değil; sadece on kat daha fazla unlink.
Çökme kurtarma ve bütünlük
Yarım kalan kayıt
Aktif segment oluşturulurken başlık sıfır kayıt sayısıyla yazılıyor ve sadece kapatılırken yeniden yazılıyor. Yani süreç ölürken yazılmakta olan bir dosya, sayısının sıfır olmasından tanınıyor ve güvenilmek yerine yeniden oynatılıyor. Yazmanın ortasında ölen bir süreç sona yarım bir kayıt bırakıyor. Bu kuyruk bir hata da değil bozulma da değil; hiç gerçekleşmemiş bir yazma. Kesilip atılıyor ve segment son tam kayıttan devam ediyor. Belge motorunun WAL'ının yırtık kuyruğa (torn tail) yaptığı muameleyle aynı.
Demoda aktif segmentin sonuna 20 baytlık (yarım kayıt) çöp ekleyip akışı yeniden açtım:
== torn tail: half a record after the last whole one
append 2  -> (10, 2)
00000000000000000010.seg: 144 -> 164 bytes
after reopen: 144 bytes, next_seq = 12
Dosya 144 bayta geri kesildi, iki tam kayıt korundu, next_seq 12.
CRC32
Kapanmış her segment, kayıt baytlarının CRC32'sini başlığında taşıyor. Bu sıcak yolda değil; verify() bir operatörün ya da bir çökme testinin çalıştıracağı şey. Kapanmış bir segmentte tek bir bitin değiştirilmesi yakalanıyor:
== flip one byte in a sealed segment
verify: checksum mismatch in 00000000000000000004.seg
Performans: ölçtüklerim ve ölçemediklerim
Bütün rakamlar Apple M4 Mac, 24 GB RAM, dahili SSD, macOS; tek iş parçacığı, 40 baytlık fill, Durability::Os, 1024 kayıtlık batch'ler.
| Ölçüm | Sonuç |
|---|---|
| 10 milyon fill eklemek (3 çalıştırma) | 2,29 / 2,60 / 4,03 s, yani saniyede 2,5 ile 4,4 milyon kayıt (99 ile 175 MB/s) |
| 153 segmentlik akışı açmak | 25 - 26 ms |
| 10 milyon kayıt üzerinde VWAP taraması | 33 ms sıcak (saniyede ~300 milyon kayıt) |
| 2,8 saatten 1 dakikayı zamanla okumak | 0,17 ms, 153 segmentin 151'i atlandı |
| Tek kaydı sıra numarasıyla okumak | 2,1 µs |
| İlk yarıyı retention ile düşürmek | 54 - 127 ms, 4,98 milyon kayıt |
Şimdi dürüst olmam gereken kısım. Kaynak koddaki iddia, yüz milyon kayıtlık bir akışın on bin kayıtlık bir akışla tam olarak aynı hızda eklediği. Kod düzeyinde bu doğru: eklemenin yaptığı işin hiçbir adımı geçmişin boyutuna bakmıyor. Ama bunu benim makinemde temiz bir şekilde ölçemedim. 10 milyonluk çalıştırmalarda her milyonun hızı saniyede 1,4 ile 10,4 milyon kayıt arasında oynadı ve sonraki milyonlar genellikle daha yavaştı. Bunu ayırmak için ayrı bir deney yaptım: önce 0, 3, 6 ve 9 milyon kayıtlık bir geçmiş yaz, sync et, bekle, akışı yeniden aç ve 1 milyon kayıt daha ekle. Aynı yapılandırma için sonuçlar saniyede 166 bin ile 10,6 milyon arasında dağıldı; boş akış ortalamada daha hızlıydı, ama dağılım her durumda farkı açıklayamayacak kadar genişti. Bu ölçümleri yaparken diskte sadece 2 GB civarı boş yer vardı; APFS'nin ve SSD'nin bu doluluktaki davranışı, motorun yaptığı işi ezip geçiyor. Bu yüzden "geçmiş, ekleme maliyetini etkilemez" cümlesini benim ölçümüm değil, tasarımın bir özelliği olarak okuyun. Bunu Linux'ta, boş bir diskte, perf ile CPU tarafını ayırarak tekrar ölçmek listemde.
Bulduklarım: iki hata ve bir boşluk
Bu yazıyı hazırlarken crate'i ilk kez gerçekten sürdüm ve üç şey çıktı. Hepsi crate'in henüz workspace'e girmemiş olmasının zaten anlattığı şeyi doğruluyor: bu motor bitmedi.
1. Bir test yanlış. Crate'in kendi 19 testinden 18'i geçiyor. Kalan an_order_is_forty_eight_bytes:
test schema::tests::an_order_is_forty_eight_bytes ... FAILED
assertion `left == right` failed
  left: 40
 right: 48
test result: FAILED. 18 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.05s
Burada yanlış olan kod değil test. Emir şekli 16 baytlık ayrılmış alan, beş tane 4 baytlık alan (20), bir u16 (2) ve iki u8 (2): toplam 40, 8'in katı, dolgu yok. Test 48 bekliyor. Yerleşim kuralı doğru çalışıyor; beklenti yanlış hesaplanmış.
2. Os ve Sealed aynı şeyi yapıyor. Belgelenen fark, Sealed'ın diske sadece segment kapanırken ulaşması. Ama kapatma her modda sync_all çağırıyor, append ise Commit dışındaki her modda sadece flush yapıyor (ve std::fs::File üzerinde flush zaten bir şey yapmıyor). Sonuç: bugün Durability::Os da segment kapanırken diske ulaşıyor ve iki mod birebir aynı. Yukarıdaki grafikteki farklar ölçüm gürültüsü. Bu bir veri kaybı hatası değil, Os vaat ettiğinden daha dayanıklı; ama iki ayrı ayar varsa farklı davranmaları gerekir. Ya Os kapatmada fsync'i atlamalı ya da tek moda indirilmeli.
3. Kapatmanın ortasında bir çökme penceresi. Gerçek hata bu. roll() önce yeni segment dosyasını oluşturuyor, sonra eskisini kapatıyor (başlığına kayıt sayısını yazıyor). Bu ikisinin arasında süreç ölürse diskte şu kalıyor: kayıtları tam ama başlığında sayı hâlâ sıfır olan bir eski segment ve boş bir yeni segment. open(), sayısı sıfır olan bir dosyayı "konumu ne olursa olsun yeniden oynatılır" diye işaretliyor, ama sonra onu active değişkenine koyuyor ve bir sonraki dosya (boş yeni segment) aynı değişkenin üzerine yazıyor. Eski segmentin kayıtları ne kapanmış listesine giriyor ne aktif segmente. Bunu, Commit modunda 6 kayıt yazıp sonra 0 numaralı segmentin başlığındaki sayıyı kapatma öncesi haline (sıfıra) çekerek taklit ettim:
append 6 -> (0, 6)
before: Stats { records: 6, segments: 2, bytes: 368, first_seq: 0, next_seq: 6, min_ts: 1000, max_ts: 1005, appended: 6, dropped: 0 }
after:  Stats { records: 2, segments: 1, bytes: 144, first_seq: 4, next_seq: 6, min_ts: 1004, max_ts: 1005, appended: 6, dropped: 0 }
segment 0 still on disk: 224 bytes
Fsync edilmiş, onaylanmış dört kayıt yeniden açılışta görünmez oluyor. Dosya diskte duruyor, yani veri fiziksel olarak kaybolmuyor, ama motor onu artık okumuyor. Pencere dar (iki dosya işlemi arası), ama tam olarak dayanıklılık garantisinin anlam taşıdığı yer. Çözüm basit: sayısı sıfır olan ama sonuncu olmayan bir dosyanın kayıtları dosya boyutundan sayılıp yerinde kapatılmalı. Bu, OxiDB'nin geri kalanında son aylarda kapattığım hatalarla aynı aileden: 0.44.2'nin hemen öncesindeki "five acknowledged-write losses in recovery" commit'i, belge motorunda kurtarma sırasında onaylanmış yazmaların kaybolabildiği beş yolu kapattı; bunlardan biri de "sıfır kayıtlı yırtık bir kuyruğun sonraki her eklemeyi yutması"ydı.
Para doğruluğu: CHANGELOG'dan ilgili notlar
Ledger motoru henüz devrede olmasa da, bir borsanın verisini OxiDB'ye emanet etmek için düzeltilmesi gereken şeylerin çoğu belge motorunda ve CHANGELOG'da kayıtlı. Bu motoru tasarlarken aklımdaki referanslar bunlardı:
- v0.34.0, aynı belgeye iki yazma: bir transaction içinde aynı belgeye yapılan iki yazma birbirini görmüyordu;
$inc -2ardından$inc +1, -1 yerine +1 veriyordu. CHANGELOG'un kendi ifadesiyle bu "creating money in a ledger", yani defterde para yaratıyordu. Yazmalar artık birleşiyor vefind_for_update(SELECT ... FOR UPDATE) eklendi. - fsyncgate: group commit'te bir transaction yazmalarını bellek içinde uyguluyor, sonra WAL'ı fsync ediyordu. Fsync başarısız olunca commit doğru şekilde hata dönüyordu ama reddedilen yazmalar bir sonraki checkpoint'e sızıyordu: "money moved despite the API reporting failure". Artık başarısız bir WAL fsync'i bellek içi durumu zehirliyor ve kurtarma sadece onaylanmış transaction'ları oynatıyor.
- v0.40.0, yarım uygulanmış çok koleksiyonlu transaction: iki koleksiyona yayılan bir transaction, çökmeden sonra yarım kurtarılabiliyordu. Jepsen tarzı banka testi, çok koleksiyonlu atomiklik testi ve exactly-once testinin üçü de aynı hatayla düştü.
- Exchange readiness tablosu: Raft lider değişimi boyunca sıra numarası ve işlem kimliği monotonluğu (
raft_sequence_monotonic), tekrar denemede tam bir kez uygulama (exactly_once), sipariş fill'inin beş koleksiyonda hep ya da hiç olması (multi_collection_crash).
Ledger motorunun "sıra numarasını motor atar" ve "onay, diskte olmak demektir" kuralları bu derslerin doğrudan devamı. Yukarıdaki üçüncü bulgu da, aynı disiplinin bu yeni crate'e henüz tam uygulanmadığını gösteriyor.
Sınırlar ve ödünleşimler
- Sunucuda yok. Wire komutu, istemci kütüphanesi, REST ucu yok. Bugün sadece Rust içinden, gömülü olarak kullanılabilir ve onun için bile bir
lib.rsyazmanız gerekiyor. - Sorgu katmanı yok. Yüklem değerlendirici, projeksiyon ve toplama API'si henüz yazılmadı; bugün
segments()üzerinden kendiniz yürüyorsunuz. - Şema sabit. Alan eklemek, çıkarmak ya da genişletmek yeni bir akış demek. Metin ya da değişken uzunluklu alan yok (alan adları bile 12 bayt).
- Her şey
i64.i64::MAXüstüu64değerler negatif okunur. - Retention segment tanelidir. Kesme noktasından eski kayıtların bir kısmı bir segment boyunca kalabilir; sessiz bir akışın aktif segmenti hiç düşmez.
- Tek yazar.
appendbir&mut self; eşzamanlılık modeli (akış başına bir yazar, çok okuyucu) wire katmanıyla birlikte tasarlanacak. - Çoğaltma yok. Raft kümesine bağlı değil; belge motorunun sahip olduğu çoğaltma ve sıra numarası garantileri burada henüz yok.
- Çökme penceresi ve
Os/Sealedaynılığı yukarıda anlattığım gibi açık.
OxiDB'nin geri kalanıyla ilişkisi
Ledger motorunun yerini şöyle düşünüyorum: bakiye defteri ve çift taraflı yevmiye belge motorunda transaction'larla kalıyor, çünkü orada izolasyon gerekiyor (belge motoru). Emir ve fill yevmiyesi ledger'a gidiyor, çünkü orada sıra, dayanıklılık ve retention gerekiyor. Mum grafikleri ve piyasa verisi zaman serisi motorunda, raporlama SQL motorunda, fill olaylarının dağıtımı MQTT ve AMQP üzerinden. Kaynak kodundaki yorum da bunu söylüyor: fill'ler "kablo üzerinde, tarayıcıda ve zaman serisinde de var", bu yüzden fill yevmiyesi Commit istemeyebilir.
Zaman serisi motoruyla benzerlik dikkat çekici ama amaçlar farklı: zaman serisi motoru esnek etiketler ve sıkıştırma üzerine kurulu, ledger ise motorun atadığı yoğun sıra numaraları, sıfır kodlama ve onay anlamına gelen fsync üzerine.
Sırada ne var, nasıl denenir?
Önce bu yazıda bulduğum üç şeyi düzeltmek: testi, Os modunu ve kapatma penceresini. Sonra crate'i workspace'e almak, bir lib.rs ve bir sorgu katmanı yazmak ve en önemlisi wire yüzeyi: istemcinin kayıtları tam olarak diske yazılacak baytlar halinde gönderdiği, ayrıştırma içermeyen bir ekleme komutu. Ondan sonra ledger, serideki diğer motorlar gibi bir ortam değişkeniyle açılabilecek.
O zamana kadar OxiDB'nin bugün çalışan halini denemek için sürümler GitHub releases sayfasında: macOS (arm64/x86_64), Linux (x86_64/arm64) ve Windows ikili dosyaları var; depodaki docker compose up -d ile Docker'da da ayağa kalkıyor. Ledger crate'i ise kaynak kodda oxidb-ledger/ altında duruyor; yukarıdaki #[path] hilesiyle beş dakikada kendi projenize bağlayıp testlerini çalıştırabilirsiniz. Serinin son yazısında öneri motorunu anlatacağım.