OxiDB'de loglar ve alarmlar: GELF, MessagePack, saklama ve webhook
OxiDB'nin log motoru: UDP üzerinden GELF ve MessagePack alımı, parçalı mesaj birleştirme, alan başına dinamik indeksleme, koleksiyon bazlı saklama, webhook'lu eşik alarmları ve oxidb-tail. Gerçek paketlerle denendi, bulunan kusurlarla birlikte.
Bir uygulamayı canlıya aldığınızda ilk ihtiyaç duyduğunuz şeylerden biri loglardır, ikincisi de loglarda bir şeyler ters gittiğinde size haber veren bir alarm. Genelde bunun için ayrı bir yığın kurulur: Graylog ya da Elasticsearch, önünde bir toplayıcı, yanında bir alarm servisi. OxiDB'de bu işi veritabanının kendisine yaptırdım. Sunucu UDP üzerinden GELF (Graylog Extended Log Format) ve MessagePack log kayıtlarını alıyor, bunları sıradan belge koleksiyonlarına yazıyor, koleksiyon başına saklama süresi uyguluyor ve arka planda eşik tabanlı alarmları değerlendirip webhook çağırıyor. Bu yazıda bu motorun nasıl çalıştığını, gerçek bir sunucuya gerçek paketler göndererek gösteriyorum. Denerken bulduğum birkaç kusuru da saklamadan yazıyorum.
Bu yazı OxiDB serisinin dokuzuncu yazısı. Burada anlatılan her şey belge motorunun üstüne kurulu: loglar belge, indeksler belge motorunun indeksleri, saklama süresi de onun TTL mekanizması.
Neden logları veritabanına koymak?
Küçük ve orta ölçekli bir sistemde log altyapısı çoğu zaman uygulamanın kendisinden daha fazla bakım ister. Bir Elasticsearch kümesi, onun bellek ayarları, indeks şablonları, saklama politikaları, ayrı bir alarm aracı... OxiDB zaten belgeleri saklayan, indeksleyen, sorgulayan ve TTL ile süresi dolanları silen bir motor. Log da sonuçta zaman damgalı, yapılandırılmış bir belge. O hâlde eksik olan parçalar şunlardı:
- logları ağdan ucuz bir protokolle almak (UDP, GELF, MessagePack),
- yüksek hızda gelen küçük kayıtları toplu (batch) yazmak,
- koleksiyon bazında saklama süresi,
- "son 5 dakikada 100'den fazla hata varsa webhook çağır" türünden alarmlar,
- terminalde canlı izlemek için bir araç (oxidb-tail).
Hepsi tek bir süreç içinde. Ayrı bir servis yok.
Etkinleştirme
Her giriş bir ortam değişkeniyle açılıyor. Benim denemede kullandığım komut (portlar bu yazı için seçtiğim portlar, varsayılan değil):
OXIDB_ADDR=127.0.0.1:15900 \
OXIDB_DATA=./data \
OXIDB_GELF_PORT=15908 \
OXIDB_MSGPACK_PORT=15909 \
OXIDB_UDP_PORT=15910 \
OXIDB_ALERT_INTERVAL=2 \
./oxidb-server
Sunucu açılışta ne yaptığını açıkça yazıyor:
TTL eviction: enabled (interval=1000ms)
alert evaluator: enabled (interval=2s)
oxidb-server listening on 127.0.0.1:15900 (pool_size=4, data_dir=.../data, idle_timeout=0s)
UDP log ingestion: listening on 0.0.0.0:15910 → collection '_udp_logs' (8 threads)
GELF ingestion: listening on 0.0.0.0:15908 → collection '_gelf_logs' (8 receivers, 4 writers, batch=2000, simd-json, crossbeam, auto-indexing)
MessagePack ingestion: listening on 0.0.0.0:15909 → collection '_msgpack_logs' (8 receivers, 4 writers, batch=2000, no auto-indexing)
Değişkenlerin tamamı:
| Değişken | Varsayılan | Ne yapar |
|---|---|---|
OXIDB_GELF_PORT | kapalı | GELF UDP dinleyicisi |
OXIDB_GELF_COLLECTION | _gelf_logs | GELF kayıtlarının yazılacağı koleksiyon |
OXIDB_MSGPACK_PORT | kapalı | MessagePack UDP dinleyicisi |
OXIDB_MSGPACK_COLLECTION | _msgpack_logs | MessagePack koleksiyonu |
OXIDB_MSGPACK_TTL_SECS | 604800 (7 gün) | MessagePack koleksiyonunun TTL süresi, 0 sonsuza kadar saklar |
OXIDB_UDP_PORT | kapalı | Ham UDP dinleyicisi (JSON ya da düz metin) |
OXIDB_UDP_COLLECTION | _udp_logs | Ham UDP koleksiyonu |
OXIDB_ALERT_INTERVAL | 15 saniye | Alarm değerlendirme aralığı |
OXIDB_GELF_ADDR | kapalı | Sunucunun kendi loglarını gönderdiği GELF hedefi |
OXIDB_MSGPACK_ADDR | kapalı | Sunucunun kendi REST istek logunu gönderdiği MessagePack hedefi |
Bir not: üç UDP dinleyicisi de OXIDB_ADDR ne olursa olsun 0.0.0.0 adresine bağlanıyor. Yukarıdaki çıktıda da görülüyor. UDP'de kimlik doğrulama olmadığı için bu portları bir güvenlik duvarının arkasında tutmak gerekiyor.
Görevde bana sorulan sorulardan biri OXIDB_UDP_PORT'un ayrı bir giriş olup olmadığıydı. Evet, ayrı: udp_ingest.rs içinde yaşayan, GELF'ten bağımsız, en sade giriş bu. Aşağıda ona da değineceğim.
Motorun içi: genel resim
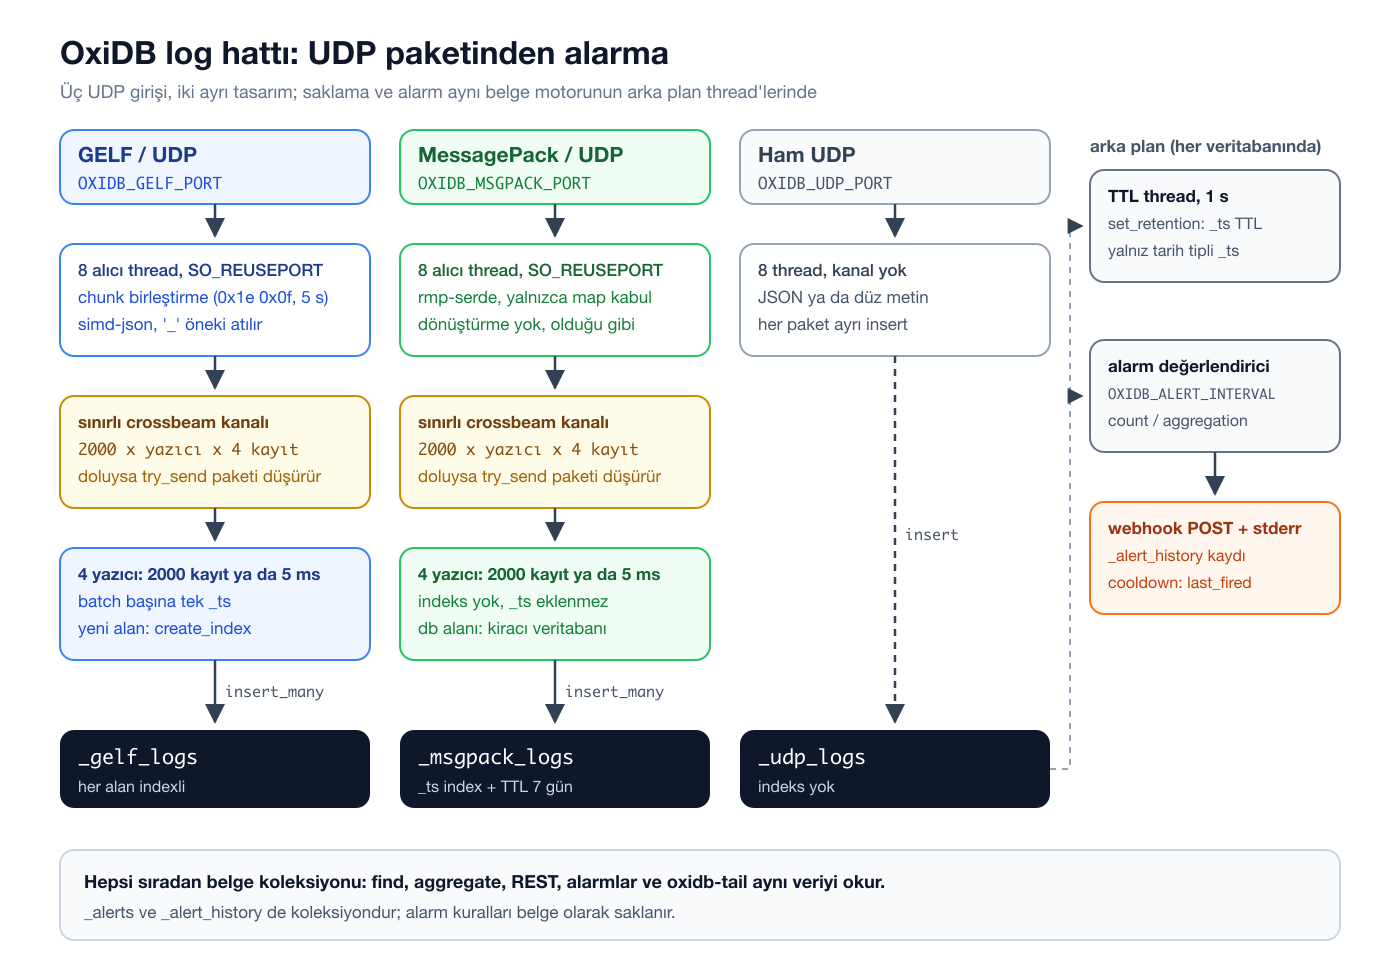
Üç giriş de aynı iskeletin farklı sürümleri:
- Alıcı thread'ler. Makinedeki çekirdek sayısı kadar, en fazla 8 thread aynı UDP portuna
SO_REUSEPORTile bağlanıyor. Çekirdek gelen paketleri bu soketler arasında dağıtıyor; tek birrecvdöngüsü darboğaz olmuyor. Her sokete 64 MB alım tamponu isteniyor (ham UDP'de 8 MB). - Sınırlı kanal. GELF ve MessagePack'te alıcılar çözdükleri belgeyi kilitsiz bir
crossbeamkanalına atıyor. Kanalın kapasitesi2000 x yazıcı sayısı x 4. Benim 10 çekirdekli makinemde 4 yazıcı vardı, yani 32.000 kayıt. - Yazıcı thread'ler. Alıcı sayısının yarısı kadar (en az 2) yazıcı kanaldan kayıt çekiyor. Biri ya 2000 kayda ulaşınca ya da ilk kayıttan itibaren 5 ms geçince batch'i kapatıp tek bir
insert_manyçağrısıyla yazıyor. - Koleksiyon. Sonuç sıradan bir belge koleksiyonu. WAL, fsync, indeksler, sorgular: hepsi belge motorunun kendisi.
Bu tasarımın kilit noktası batch. Tek tek insert yerine 2000'lik insert_many yapmak, koleksiyon kilidini, WAL yazımını ve fsync maliyetini yüzlerce kayda yayıyor. 5 ms'lik üst sınır da düşük trafikte bir kaydın sonsuza kadar beklemesini önlüyor.
GELF: Graylog formatında log almak
GELF, Graylog'un JSON tabanlı log formatı. Sürüm 1.1'de zorunlu alanlar version, host ve short_message; isteğe bağlı olarak full_message, timestamp, level (syslog seviyeleri, 0 acil, 7 debug) ve _ ile başlayan istediğiniz kadar ek alan var. Pek çok dilde hazır GELF logger'ları bulunduğu için OxiDB'yi bir Graylog yerine koymak, uygulama tarafında sadece adres değiştirmek demek.
OxiDB her mesajı şöyle dönüştürüyor:
short_messageyoksa mesaj sessizce atılıyor.- Standart alanlar (
host,short_message,full_message,timestamp,level,facility) olduğu gibi kalıyor. versionsiliniyor._usergibi ek alanların baştaki alt çizgisi kaldırılıyor: belgedeuserolarak duruyor.- Yazıcı thread batch'i yazmadan önce her belgeye
_tsekliyor. Dikkat: bu damga mesaj başına değil, batch başına bir kez alınıyor. Aynı 5 ms'lik pencereye düşen bütün kayıtlar aynı_tsdeğerini taşıyor. Bu bilinçli bir tercih: saat çağrısı bile 2000 kayıtta bir yapılıyor. Mesajın kendi zamanını istiyorsanız GELF'intimestampalanı ayrıca saklanıyor.
JSON ayrıştırma simd-json ile, yerinde (in-place) yapılıyor.
Gerçek mesajlar göndermek
Hiçbir kütüphane kullanmadan, Python'un düz soketiyle üç normal ve bir parçalı (chunked) mesaj gönderdim:
import socket, json, os, time
sock = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
dst = ("127.0.0.1", 15908)
def send(msg):
    sock.sendto(json.dumps(msg).encode(), dst)

send({"version":"1.1","host":"api-01","short_message":"Login user: baris","level":6,
      "facility":"auth","timestamp":time.time(),"_user":"baris","_client_ip":"192.0.2.10","_latency_ms":42})
send({"version":"1.1","host":"api-02","short_message":"Payment declined","level":3,
      "facility":"billing","timestamp":time.time(),"_user":"ayse","_order_id":54321,"_amount":2500.0})
send({"version":"1.1","host":"worker-1","short_message":"Retrying job SendEmail","level":4,
      "facility":"jobs","timestamp":time.time(),"_job":"SendEmail","_attempt":3})

# ~23 KB'lık bir mesaj, 8 KB'lık parçalara bölünüp TERS sırada gönderiliyor
full = "Traceback (most recent call last):\n" + "".join(f"  at frame_{i} (service.rs:{i})\n" for i in range(700))
big = json.dumps({"version":"1.1","host":"api-01","short_message":"Unhandled panic in /checkout",
      "full_message":full,"level":2,"facility":"checkout","_request_id":"req-7f3a"}).encode()
CH = 8192
parts = [big[i:i+CH] for i in range(0, len(big), CH)]
mid = os.urandom(8)
order = list(range(len(parts)))[::-1]
for seq in order:
    sock.sendto(b"\x1e\x0f" + mid + bytes([seq, len(parts)]) + parts[seq], dst)
print(f"chunked payload: {len(big)} bytes -> {len(parts)} chunks, sent in order {order}")
chunked payload: 23084 bytes -> 3 chunks, sent in order [2, 1, 0]Sunucunun stderr çıktısı, ilk kez gördüğü her alan için bir indeks oluşturduğunu gösteriyor:
GELF auto-index: created index on 'job' in '_gelf_logs'
GELF auto-index: created index on 'attempt' in '_gelf_logs'
GELF auto-index: created index on 'amount' in '_gelf_logs'
GELF auto-index: created index on 'order_id' in '_gelf_logs'
GELF auto-index: created index on 'client_ip' in '_gelf_logs'
GELF auto-index: created index on 'user' in '_gelf_logs'
GELF auto-index: created index on 'latency_ms' in '_gelf_logs'
GELF auto-index: created index on 'request_id' in '_gelf_logs'
GELF auto-index: created index on 'full_message' in '_gelf_logs'
Sorgulamak
OxiDB'nin wire protokolü uzunluk önekli JSON (4 bayt little-endian uzunluk, ardından JSON). Aşağıdaki istek ve yanıtlar bu protokolle giden gerçek mesajlar. Önce sayım:
{"cmd": "count", "collection": "_gelf_logs", "query": {}}{"ok": true, "data": {"count": 4}}Dört kayıt: üç normal mesaj ve üç parçadan birleştirilen bir mesaj. Şimdi ek alan üzerinden bir aralık sorgusu; latency_ms indeksi otomatik oluşturulduğu için bu sorgu indeks kullanıyor:
{"cmd": "find", "collection": "_gelf_logs", "query": {"latency_ms": {"$gt": 10}}}{
"ok": true,
"data": [
{
"host": "api-01",
"short_message": "Login user: baris",
"timestamp": 1791754331.033758,
"level": 6,
"facility": "auth",
"user": "baris",
"latency_ms": 42,
"client_ip": "192.0.2.10",
"_ts": "2026-10-11T21:32:11.039911+00:00",
"_id": 2,
"_version": 1
}
]
}_user belgede user olmuş, version alanı yok, _ts eklenmiş. level <= 3 sorgusu "Payment declined" kaydını ve parçalı mesajı döndürdü; ikisinin de _ts değeri tam olarak 2026-10-11T21:32:11.039911+00:00. Dört mesaj aynı batch'e düştüğü için aynı damgayı aldılar. Parçalı mesajın sağlam birleştiğini de kontrol ettim:
chunked doc: short_message='Unhandled panic in /checkout', full_message 22215 chars, 701 lines, last line ' at frame_699 (service.rs:699)'700 satırlık yığın izinin son satırı yerinde. Koleksiyonun indeks listesi de şöyle:
indexes: ['_ts', 'amount', 'attempt', 'client_ip', 'facility', 'full_message', 'host', 'job', 'latency_ms', 'level', 'order_id', 'request_id', 'short_message', 'timestamp', 'user']Parçalı (chunked) mesajların birleştirilmesi
UDP datagramları pratikte birkaç kilobaytla sınırlı olduğu için GELF büyük mesajları parçalara bölüyor. Her parçanın başında 12 baytlık bir başlık var: 2 bayt sihirli sayı (0x1e 0x0f), 8 bayt mesaj kimliği, 1 bayt sıra numarası, 1 bayt toplam parça sayısı.
OxiDB'de her alıcı thread kendi HashMap<mesaj_kimliği, ChunkBuffer> tablosunu tutuyor. Parçalar sıra numarasının gösterdiği yuvaya yerleşiyor; aynı sıra numarası ikinci kez gelirse yok sayılıyor (ilk gelen kalıyor). Son eksik parça da gelince parçalar sırayla birleştirilip ayrıştırılıyor. Yukarıdaki örnekte parçaları bilerek ters sırada gönderdim; sorun çıkmadı. Tamamlanamayan mesajlar 5 saniye sonra çöpe gidiyor. Bu süpürme her 1000 pakette bir yapılıyor, yani boş bir sunucuda yarım kalmış bir tampon biraz daha uzun yaşayabilir.
Tasarımın ince bir yanı var: tamponlar thread başına tutuluyor. SO_REUSEPORT çekirdekte kaynak adres ve porta göre dağıttığı için aynı soketten gönderilen parçalar aynı thread'e düşüyor. Bir mesajın parçalarını farklı kaynak portlardan gönderen bir istemci olsaydı parçalar farklı thread'lere dağılabilir ve mesaj hiç birleşmezdi. Bildiğim GELF kütüphaneleri bir mesajı tek soketten gönderiyor, ama bu sınırı bilmekte fayda var.
Elasticsearch tarzı dinamik indeksleme
GELF girişinin en belirgin özelliği bu: her alan ilk görüldüğü anda indeksleniyor. host, short_message, level, facility, timestamp ve _ts için indeksler sunucu açılırken oluşturuluyor. Sonrasında her yazıcı batch'teki alan adlarını topluyor, bilinen alanlar kümesiyle karşılaştırıyor; bilinmeyen bir alan varsa create_index çağırıyor. Bilinen alanlar kontrolü ortak bir mutex arkasında, hızlı yolda sadece küme üyeliği bakılıyor.
Kazancı açık: uygulamanız yarın _tenant_id diye yeni bir alan göndermeye başlarsa, hiçbir şema ya da indeks ayarı yapmadan {"tenant_id": "acme"} sorgusu indeksli çalışıyor. Elasticsearch'ün dynamic mapping'i de bunu yapıyor ve log için gerçekten rahat.
Bedeli de aynı derecede açık:
- Her alan bir B-tree indeksi. Yukarıdaki dört mesaj 15 indeks doğurdu. Buna 22 KB'lık
full_messagede dahil: koca bir yığın izinin tamamı indeks anahtarı oluyor. Yüksek kardinaliteli alanlar (istek süresi, istek kimliği) indeks belleğini ve yazma maliyetini en çok büyütenler. - Yeni alan, yazma yolunda indeks inşası demek. Bunun ölçülebilir bir yan etkisi var, aşağıda "Ölçüm" bölümünde.
Sıkıştırma desteği yok
GELF spesifikasyonu UDP mesajlarının zlib ya da gzip ile sıkıştırılabileceğini söylüyor. OxiDB'nin alıcısı sıkıştırmayı açmıyor. Denedim:
s.sendto(zlib.compress(m("zlib-compressed")), ("127.0.0.1",15908))
s.sendto(gzip.compress(m("gzip-compressed")), ("127.0.0.1",15908))
s.sendto(m("plain"), ("127.0.0.1",15908))
stored: ['plain']Sıkıştırılmış iki mesaj sessizce kayboldu. Bazı GELF istemcileri UDP'de varsayılan olarak sıkıştırma yapıyor; OxiDB'ye gönderirken bunu kapatmak gerekiyor.
MessagePack: bilerek indekslemeyen ucuz kardeş
MessagePack girişi GELF ile aynı iskeleti kullanıyor (8 alıcı, sınırlı kanal, 4 yazıcı, 2000 kayıt ya da 5 ms), ama iki önemli farkla:
- Format ikili ve kompakt. Ayrıştırma
rmp-serdeile, sadece map olan kayıtlar kabul ediliyor. Alan adı dönüştürme,_önekini silme gibi bir işlem yok; kayıt olduğu gibi yazılıyor. - Alan başına indeks yok. Bilerek.
Kaynak kodundaki gerekçe şöyle özetlenebilir: GELF'in dinamik eşlemesi her alan için bir B-tree kuruyor ve istek süresi gibi yüksek kardinaliteli alanlar belleğe hâkim oluyor. Oysa bir log akışı sadece sona ekleniyor ve nadiren rastgele bir alana göre sorgulanıyor. Çoğu zaman yapılan şey "son N kaydı göster" ya da "şu zaman aralığını göster". Bunun için tek bir _ts indeksi yetiyor. Sunucu MessagePack dinleyicisini açarken koleksiyona _ts üzerinde bir indeks ve varsayılan 7 günlük bir TTL koyuyor. Kaynak koddaki yoruma göre amaç, panelin "en yeniden eskiye" sayfalamasının tam tarama yapmaması ve koleksiyonun sınırsız büyümemesi.
Aynı kayıtların boyutunu karşılaştırdım:
GET /api/orders 200    msgpack 124 B vs JSON 169 B
POST /api/pay 502      msgpack 123 B vs JSON 167 B
GET /health 200        msgpack 116 B vs JSON 160 B
Yaklaşık yüzde 27 daha küçük paketler. Sorgu yine çalışıyor, sadece indekssiz (tam tarama) yapılıyor:
{"cmd": "find", "collection": "_msgpack_logs", "query": {"status": {"$gte": 500}}}{
"ok": true,
"data": [
{
"host": "edge-1",
"short_message": "POST /api/pay 502",
"level": 3,
"method": "POST",
"path": "/api/pay",
"status": 502,
"dur_ms": 3010,
"ts": 1791754356.749907,
"_ts": 1791754356749,
"_id": 2,
"_version": 1
}
]
}Koleksiyonun indeksleri sadece bunlar:
{"cmd": "list_indexes", "collection": "_msgpack_logs"}{
"ok": true,
"data": [
{"name": "_ts", "index_type": "field", "fields": ["_ts"], "unique": false},
{"name": "_ts_ttl", "index_type": "ttl", "fields": ["_ts"], "unique": false, "expire_after_seconds": 604800}
]
}(Bu yanıtı okunabilirlik için tek satırlara sıkıştırdım; içerik aynı.)
Kiracıya göre yönlendirme
MessagePack girişinin bir özelliği daha var: kayıtta db alanı varsa ve o adda bir veritabanı varsa, kayıt o veritabanındaki aynı adlı koleksiyona yazılıyor. Yazıcı her batch'i hedef veritabanına göre gruplayıp her gruba tek insert_many yapıyor. Gerekçe kodda yazılı: tek bir ortak log havuzu, bir projenin loglarını okuyan her sorgunun diğer bütün projelerin satırlarını da gezmesi demekti; saklama, boyut ve sorgu maliyeti herkes arasında paylaşılıyordu. Kiracının istekleri kiracının verisi. Bir proje silinince logları da onunla gidiyor. db alanı olmayan kayıtlar (kontrol düzleminin kendi istekleri) varsayılan veritabanında kalıyor; var olmayan bir veritabanını gösteren kayıt da atılmıyor, varsayılan veritabanına yazılıyor. Kiracı veritabanına ilk kez yazılırken _ts indeksi ve TTL de orada kuruluyor.
Ham UDP: en sade giriş
OXIDB_UDP_PORT üçüncü ve en basit giriş. Paket JSON olarak ayrıştırılabiliyorsa belge olarak, değilse {"message": "...", "_ts": ...} biçiminde yazılıyor. Paketin kendi _ts alanı varsa korunuyor. syslog benzeri düz metin satırlarını hiçbir dönüşüm yapmadan toplamak için uygun:
s.sendto(b'{"level":"error","msg":"disk 91% full","mount":"/var"}', ("127.0.0.1", 15910))
s.sendto(b'kernel: eth0 link down\n', ("127.0.0.1", 15910))
{
"ok": true,
"data": [
{
"level": "error",
"msg": "disk 91% full",
"mount": "/var",
"_ts": "2026-10-11T21:32:36.750067+00:00",
"_id": 1,
"_version": 1
},
{
"message": "kernel: eth0 link down",
"_ts": "2026-10-11T21:32:36.753946+00:00",
"_id": 2,
"_version": 1
}
]
}Burada kanal ve batch yok: 8 thread'in her biri paketi alıp doğrudan tek bir insert yapıyor. Dosyanın başındaki açıklama hâlâ "1 yazıcı thread batch'ler hâlinde yazar" diyor ama kod artık öyle değil. Koleksiyonda hiç indeks yok; list_indexes boş dizi döndü. Yüksek hacim için GELF ya da MessagePack girişlerini tercih ederim, ham UDP daha çok "elimde bir nc var, satırı bir yere atayım" durumları için.
Ölçüm: 50.000 paketlik patlama
GELF ile MessagePack arasındaki farkı somut görmek için tek bir Python soketinden olabildiğince hızlı 50.000'er paket gönderdim ve sonra kaç kaydın yazıldığını saydım. Ortam: Apple M4 (10 çekirdek), yerel loopback, OxiDB 0.44.2, varsayılan disk ayarları (her commit fsync'li). Gönderim her seferinde 0,16 ile 0,24 saniye sürdü; bütün kayıtlar en geç 1,2 saniye içinde sorgulanabilir oldu (ölçüm döngüm 0,5 saniyede bir sayım yaptığı için daha ince bir çözünürlüğüm yok).
GELF         sent 50000 in 0.16s, stored 50000 (100.0%), all visible after 1.17s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.18s, stored 50000 (100.0%), all visible after 1.19s (incl. 0.5s idle check)
Alanları daha önce görülmüş mesajlarda iki giriş de kayıpsızdı. Ama patlamaya yeni alan adları eklediğimde tablo değişti:
GELF         sent 50000 in 0.18s, stored 33439 (66.9%), all visible after 1.19s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.19s, stored 50000 (100.0%), all visible after 1.19s (incl. 0.5s idle check)
GELF         sent 50000 in 0.24s, stored 32751 (65.5%), all visible after 1.24s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.16s, stored 50000 (100.0%), all visible after 1.17s (incl. 0.5s idle check)
İlk denemede de aynı şey olmuştu (33.595 kayıt). Üç seferde de GELF yaklaşık üçte birini kaybetti.
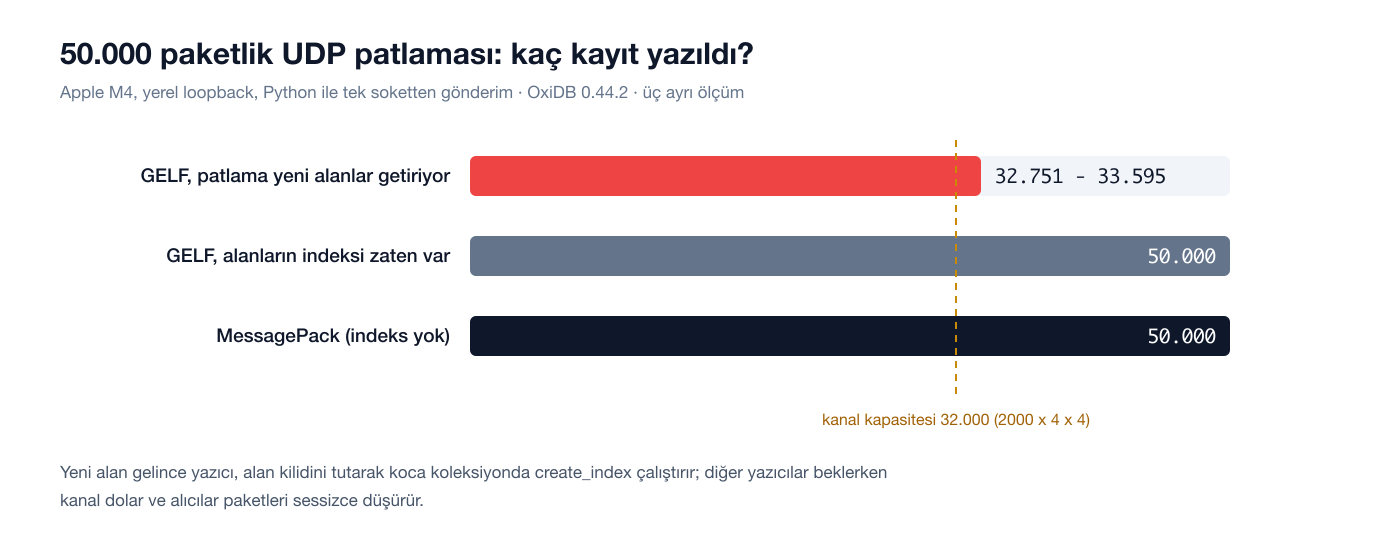
Kodu okuyunca en olası açıklama şu: yeni bir alan gören yazıcı, bilinen alanlar mutex'ini tutarken create_index çağırıyor. Koleksiyonda o sırada yüz binin üzerinde kayıt vardı, yani indeks bütün koleksiyon üzerinde inşa ediliyor. Diğer üç yazıcı da her batch'te aynı mutex'e baktığı için bekliyor. Yazıcılar dururken alıcılar kanalı dolduruyor ve kanal dolunca try_send paketi sessizce bırakıyor. Yazılan kayıt sayısının kanal kapasitesine (32.000) bir iki batch eklenmiş hâline bu kadar yakın olması bu açıklamayla uyumlu. MessagePack'te indeks inşası olmadığı için aynı patlama kayıpsız geçti.
Bu, tasarımın bilinçli bir uzlaşması: UDP'de geri basınç yok, gönderene "yavaşla" diyemezsiniz, o yüzden kuyruk dolunca düşürmek, sunucuyu kilitlemekten iyidir. Ama sonuç şu: GELF'te yeni bir alanın ilk görüldüğü an, en kötü an. Pratikte iki şey öneririm: alan kümesi sabit olan uygulamalarda ilk dağıtımdan önce birkaç örnek mesaj gönderip indeksleri ısıtmak, ya da yüksek hacimli ve değişken şemalı akışları MessagePack girişine yönlendirmek. Ayrıca kayıpların bir sayacı yok; bunu ileride bir metrik olarak eklemek istiyorum.
Saklama: set_retention ve TTL mekanizması
Saklama süresi koleksiyon başına tanımlanıyor:
{"cmd": "set_retention", "collection": "app_logs", "days": 7}İçeride olan şey çok basit: set_retention, koleksiyonun _ts alanına days x 86400 saniyelik bir TTL indeksi koyuyor ve politikayı _retention_policies koleksiyonuna bir belge olarak yazıyor. Silme işini, belge motorunun zaten var olan TTL thread'i yapıyor (dosya modunda saniyede bir, bellek modunda 100 ms'de bir). TTL taraması _ts alanının indeksinde "şu andan expire_after_seconds önceye kadar" bir aralık taraması. Silme 4096'lık parçalar hâlinde yapılıyor ve indeks yazma kilitleri parçalar arasında bırakılıyor; büyük bir birikmiş silme işi koleksiyonu uzun süre kilitlemesin diye.
Denemesi: app_logs koleksiyonuna 0, 3, 8 ve 30 günlük _ts değerleriyle dört belge yazdım ve 7 günlük saklama koydum. TTL indeksi oluşturulur oluşturulmaz süresi dolan belgeler hemen siliniyor:
{"cmd": "set_retention", "collection": "app_logs", "days": 7}{"ok": true, "data": "retention set: app_logs (7 days)"}{"cmd": "find", "collection": "app_logs", "query": {}}{
"ok": true,
"data": [
{"short_message": "0 days old", "_ts": "2026-10-11T21:33:01.272662+00:00", "_id": 1, "_version": 1},
{"short_message": "3 days old", "_ts": "2026-10-08T21:33:01.272662+00:00", "_id": 2, "_version": 1}
]
}(Yanıt yine tek satırlara sıkıştırıldı.) 8 ve 30 günlük belgeler gitti. Politika belgesi:
{"cmd": "get_retention", "collection": "app_logs"}{
"ok": true,
"data": {
"collection": "app_logs",
"retain_days": 7,
"expire_after_seconds": 604800,
"_ts": "2026-10-11T21:33:01.348133+00:00",
"_id": 1,
"_version": 1
}
}days: 0 reddediliyor (retain_days must be > 0). delete_retention TTL ayarını kaldırıyor ama _ts alan indeksini bırakıyor; list_retentions bütün politikaları listeliyor.
Bu yaklaşımın güzel tarafı yeni bir mekanizma yazmamış olmam: log saklaması, belge motorunun TTL indeksinin bir kullanım biçimi. Zaman serisi motorundaki saklamadan farkı da burada: orada mühürlenmiş bloklar bütün olarak düşürülüyor, burada belgeler indeks üzerinden tek tek siliniyor. Log için kabul edilebilir, ama çok büyük koleksiyonlarda blok düşürmek kadar ucuz değil.
Denerken bulduğum iki kusur
Saklama süresini değiştirmek TTL'i değiştirmiyor. create_ttl_index aynı alanda zaten bir TTL varsa hiçbir şey yapmıyor (idempotent). set_retention ise politika belgesini güncelliyor ama TTL'i yeniden kurmuyor:
policy record retain_days: 30
ttl index: [{'name': '_ts_ttl', 'index_type': 'ttl', 'fields': ['_ts'], 'unique': False, 'expire_after_seconds': 604800}]
Politika 30 gün diyor, ama silmeyi yapan TTL hâlâ 7 gün (604800 saniye). Geçici çözüm önce delete_retention, sonra yeniden set_retention:
after delete: [('_ts', 'field')]
after re-set to 30: [{'name': '_ts_ttl', 'index_type': 'ttl', 'fields': ['_ts'], 'unique': False, 'expire_after_seconds': 2592000}]
Sayısal _ts değerleri hiç silinmiyor. TTL taraması sadece tarih tipindeki indeks değerlerine bakıyor. Kodda bunun gerekçesi de yazılı: aralığın alt sınırı sınırsız olsaydı sayısal bir created_at alanı taşıyan bütün belgeler süreleri dolmadan silinirdi. OxiDB'de bir string değer ISO 8601 / RFC 3339 biçimindeyse indekste tarih olarak saklanıyor, sayı ise sayı olarak. Ama sunucunun kendi MsgpackLogger'ı _ts alanını epoch milisaniye olarak, yani sayı olarak yazıyor. Denedim: MessagePack girişine 10 gün önceye ait üç kayıt gönderdim, biri epoch-ms _ts ile, biri ISO string _ts ile, biri hiç _ts olmadan. 7 günlük varsayılan TTL'in çalışması için birkaç saniye bekledim:
{"cmd": "find", "collection": "_msgpack_logs", "query": {"short_message": {"$in": ["old, epoch-ms _ts", "old, ISO-8601 _ts", "no _ts at all"]}}}{
"ok": true,
"data": [
{"short_message": "no _ts at all", "_id": 5, "_version": 1},
{"short_message": "old, epoch-ms _ts", "_ts": 1790890365335, "_id": 4, "_version": 1}
]
}Sadece ISO string olan silindi. Yani 0.44.2'de _msgpack_logs üzerindeki 7 günlük varsayılan TTL, OxiDB'nin kendi REST istek logu gibi sayısal _ts taşıyan kayıtları hiç silmiyor; MessagePack girişi _ts alanı olmayan kayıtlara da damga eklemiyor. Kendi uygulamanızdan MessagePack gönderiyorsanız _ts alanını ISO 8601 string olarak yazın. Benim tarafımda yapılacak iş de belli: ya TTL taramasını sayısal epoch-ms değerleri de kapsayacak şekilde açık bir seçenekle genişletmek, ya da logger'ın ve girişin _ts değerini tarih olarak yazmasını sağlamak.
Alarmlar
Alarm kuralları _alerts koleksiyonunda belge olarak duruyor. Arka planda her veritabanı için bir oxidb-alerts thread'i OXIDB_ALERT_INTERVAL saniyede bir uyanıyor, enabled: true olan kuralları okuyor ve her birini değerlendiriyor. İki koşul tipi var:
count_threshold: kuralınqueryfiltresine,_ts >= şimdi - windowkoşulu eklenipcountçalıştırılıyor. Sonuçthresholdileoperator(gt,gte,lt,lte,eq,ne; varsayılangte) üzerinden karşılaştırılıyor.aggregation_threshold: kuralınpipelinedizisinin başına{"$match": {"_ts": {"$gte": ...}}}aşaması ekleniyor, aggregation çalıştırılıyor, ilk sonuç belgesininresult_fieldalanı (varsayılancount) eşikle karşılaştırılıyor.
window "30s", "5m", "1h" gibi yazılıyor, varsayılanı 5 dakika. Koşul sağlanırsa eylemler çalışıyor: webhook (JSON gövdeli bir HTTP POST, değerlendiriciyi bekletmesin diye ayrı bir thread'de, ateşle ve unut), stderr (sunucu loguna bir [ALERT] satırı) ve log. Hangi eylem seçilirse seçilsin _alert_history koleksiyonuna bir kayıt yazılıyor ve kuralın last_fired, last_fired_epoch ve fire_count alanları güncelleniyor.
Cooldown da bu alanlara dayanıyor: now < last_fired_epoch + cooldown_seconds ise kural hiç değerlendirilmiyor. Varsayılan 300 saniye.
Gerçek bir deneme: yerel webhook alıcısı
127.0.0.1:15906 portunda gelen her POST'u zaman damgasıyla yazan küçük bir Python HTTP sunucusu çalıştırdım:
import http.server, datetime
class H(http.server.BaseHTTPRequestHandler):
    def do_POST(self):
        n = int(self.headers.get("Content-Length", 0)); body = self.rfile.read(n)
        t = datetime.datetime.now().strftime("%H:%M:%S")
        print(f"[{t}] POST {self.path}  {body.decode()}", flush=True)
        self.send_response(204); self.end_headers()
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 15906), H).serve_forever()
Sonra iki kural tanımladım. Biri sayım eşiği, diğeri aggregation eşiği:
{"cmd": "create_alert", "name": "error-burst", "collection": "_gelf_logs",
 "condition": {"type": "count_threshold", "query": {"level": {"$lte": 3}}, "window": "1m", "threshold": 5, "operator": "gte"},
 "actions": [{"type": "webhook", "url": "http://127.0.0.1:15906/alerts"}, {"type": "stderr"}],
 "cooldown_seconds": 20}
{"ok": true, "data": "alert created: error-burst"}{"cmd": "create_alert", "name": "slow-requests", "collection": "_gelf_logs",
"condition": {"type": "aggregation_threshold", "window": "1m",
"pipeline": [{"$match": {"latency_ms": {"$gte": 500}}}, {"$group": {"_id": null, "n": {"$sum": 1}}}],
"result_field": "n", "threshold": 3, "operator": "gte"},
"actions": [{"type": "webhook", "url": "http://127.0.0.1:15906/alerts/slow"}],
"cooldown_seconds": 60}{"ok": true, "data": "alert created: slow-requests"}test_alert bir kuralı eylemleri çalıştırmadan ve cooldown'a bakmadan hemen değerlendiriyor:
{"cmd": "test_alert", "name": "error-burst"}{
"ok": true,
"data": {
"alert": "error-burst",
"type": "count_threshold",
"current_value": 0,
"threshold": 5,
"operator": "gte",
"would_fire": false
}
}Ama aggregation kuralında henüz çalışmıyor:
{"cmd": "test_alert", "name": "slow-requests"}{"ok": true, "data": {"alert": "slow-requests", "error": "unsupported condition type: aggregation_threshold"}}Ardından GELF üzerinden bir trafik senaryosu oynattım (saatler yerel saat):
[00:33:40] send 6 errors + 4 slow requests (latency >= 500 ms)
[00:33:46] send 3 more errors (still inside the 20 s cooldown)
[00:34:10] cooldown over; window still holds >= 5 errors
[00:34:20] done
Webhook alıcısının gördüğü:
[00:33:41] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:33:41Z","fired_at_epoch":1791754421,"condition_result":6,"threshold":5,"operator":"gte"}
[00:33:41] POST /alerts/slow  {"alert_name":"slow-requests","collection":"_gelf_logs","fired_at":"2026-10-11T21:33:41Z","fired_at_epoch":1791754421,"condition_result":4,"threshold":3,"operator":"gte"}
[00:34:01] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:34:01Z","fired_at_epoch":1791754441,"condition_result":9,"threshold":5,"operator":"gte"}
[00:34:21] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:34:21Z","fired_at_epoch":1791754461,"condition_result":9,"threshold":5,"operator":"gte"}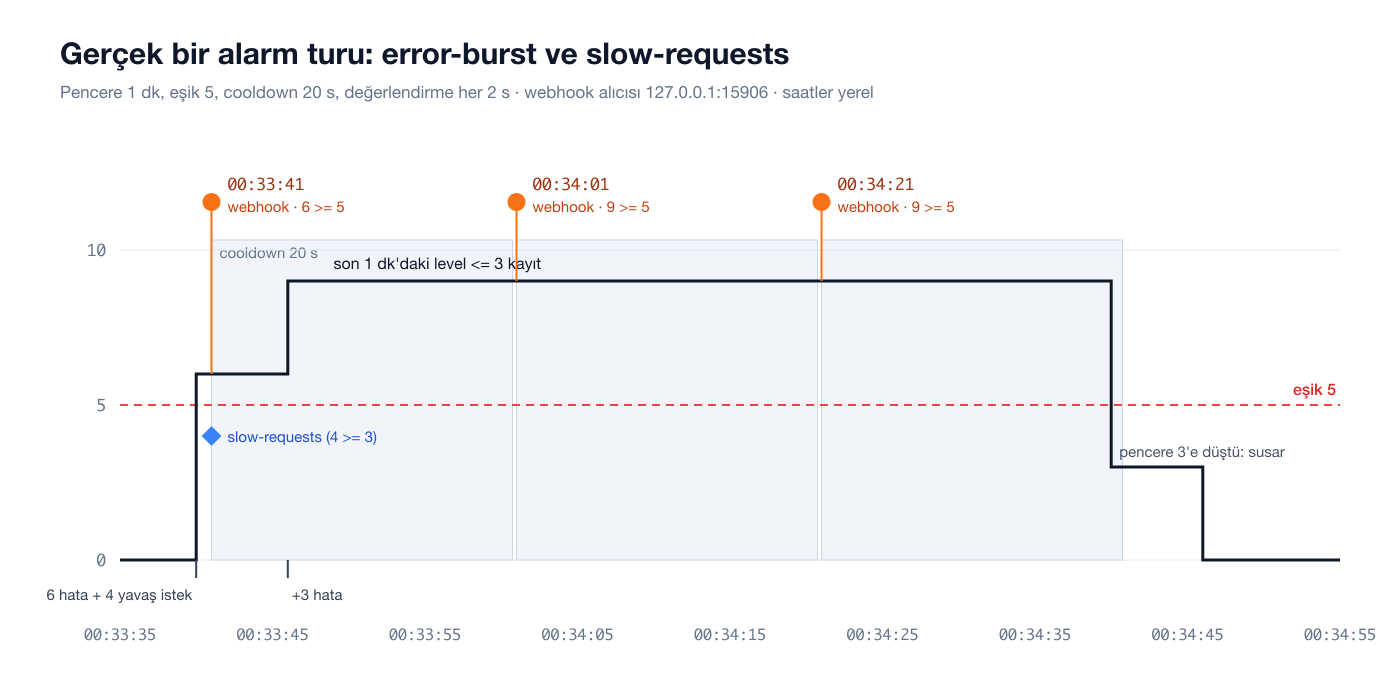
Burada birkaç şey görülüyor:
- İlk ateşleme paketlerden bir saniye sonra geldi; 2 saniyelik değerlendirme aralığının bir sonucu.
- 00:33:46'da gelen üç ek hata yeni bir bildirim üretmedi, çünkü kural cooldown içindeydi.
- Koşul doğru kaldığı sürece kural her cooldown sonunda yeniden ateşleniyor: 00:34:01 ve 00:34:21. Yani bu bir "kenar tetikli" alarm değil; koşul sürdükçe periyodik hatırlatma yapıyor. Hata 00:34:40'ta 1 dakikalık pencereden çıkınca sayı 3'e düştü ve kural sustu. "Düzeldi" bildirimi yok.
- Sunucu stderr'ine de her ateşlemede bir
[ALERT] error-burst: _gelf_logs ...satırı düştü.
Geçmiş, sorgulanabilir bir koleksiyon:
{"cmd": "list_alert_history"}{
"ok": true,
"data": [
{
"alert_name": "error-burst",
"collection": "_gelf_logs",
"fired_at": "2026-10-11T21:33:41Z",
"fired_at_epoch": 1791754421,
"condition_result": 6,
"threshold": 5,
"operator": "gte",
"actions_executed": ["webhook", "stderr"],
"_ts": "2026-10-11T21:33:41Z",
"_id": 1,
"_version": 1
},
{
"alert_name": "slow-requests",
"collection": "_gelf_logs",
"fired_at": "2026-10-11T21:33:41Z",
"fired_at_epoch": 1791754421,
"condition_result": 4,
"threshold": 3,
"operator": "gte",
"actions_executed": ["webhook"],
"_ts": "2026-10-11T21:33:41Z",
"_id": 2,
"_version": 1
}
]
}(Dört kaydın ilk ikisi; diğer ikisi 00:34:01 ve 00:34:21 ateşlemeleri.) Kuralın kendi durumu da güncellenmiş:
{'name': 'error-burst', 'enabled': True, 'cooldown_seconds': 20, 'fire_count': 3, 'last_fired': '2026-10-11T21:34:21Z', 'last_fired_epoch': 1791754461}_alert_history ve _alerts de sıradan koleksiyon olduğu için onlara da set_retention uygulanabilir ve kendileri de alarm konusu olabilir. Kuralları açıp kapatmak için ayrı bir komut yok; ben _alerts koleksiyonunda düz bir update ile enabled alanını değiştirdim:
{"cmd": "update", "collection": "_alerts", "query": {"name": {"$in": ["error-burst", "slow-requests"]}}, "update": {"$set": {"enabled": false}}}{"ok": true, "data": {"modified": 2}}Alarm tarafındaki sınırlar
Bunları da gerçek denemelerle gördüm:
- Webhook URL'sinde host adı çalışmıyor. URL ayrıştırıcı
http://localhost:15906/...biçimini kabul ediyor, ama bağlantıhost:portmetninin bir soket adresine çevrilmesiyle kuruluyor ve bu DNS çözümlemesi yapmıyor.localhostadresli bir kural ateşlendiğinde alıcıya hiçbir şey gelmedi, ama_alert_historykaydında"actions_executed": ["webhook"]yazıyordu. Webhook başarısızlığı sessiz; şimdilik URL'de IP adresi kullanın. - Sadece
http://. TLS yok. Webhook'u dış bir servise göndermek için arada bir yerel aktarıcı gerekiyor. - Yanıt okunmuyor, yeniden deneme yok. İstek yazılıp bağlantı kapatılıyor; alıcı o anda kapalıysa bildirim kayboluyor (geçmişte yine "webhook" yazıyor).
- Eşikler tam sayı. Aggregation sonucu
as_i64ile okunuyor. Ortalama gecikme 300,5 ms ikenavg > 100kuralı hiç ateşlenmedi (fire_count: 0);$sumile tam sayı çıkan sonuçlar ise sorunsuz çalıştı. Kesirli sonuçlar için şimdilik pipeline'da yuvarlama yapmak gerekiyor. - Pencere
_tsalanına göre. Alarm penceresi_tsalanını ISO string bir sınırla karşılaştırıyor; GELF ve ham UDP kayıtlarında_tstarih string'i olduğu için sorun yok, ama sayısal_tstaşıyan MessagePack kayıtları pencereye girmiyor. Denedim:_msgpack_logsüzerindestatus: 503sayan bir kural için epoch-ms_tsile gönderilen kayıttan sonratest_alert"current_value": 0döndü, aynı kaydı ISO string_tsile gönderince"current_value": 1.
Hepsi düzeltilebilir şeyler ve listemde. Ama bugünkü hâliyle alarm motoru "son N dakikada şu kadar hata" türünden işler için iyi çalışıyor.
oxidb-tail: terminalde canlı log
oxidb-tail, OxiDB'ye wire protokolüyle bağlanan bir terminal arayüzü (ratatui + crossterm). Bağımlılıkları hafif olduğu için derlemesi kısa sürdü; benim makinemde sıfırdan release derleme 15,45 saniye:
cargo build --release -p oxidb-tail
./target/release/oxidb-tail --host 127.0.0.1 --port 15900
Çalışırken GELF üzerinden 60 mesajlık bir akış gönderdim; tmux içinde yakaladığım ekran şu:
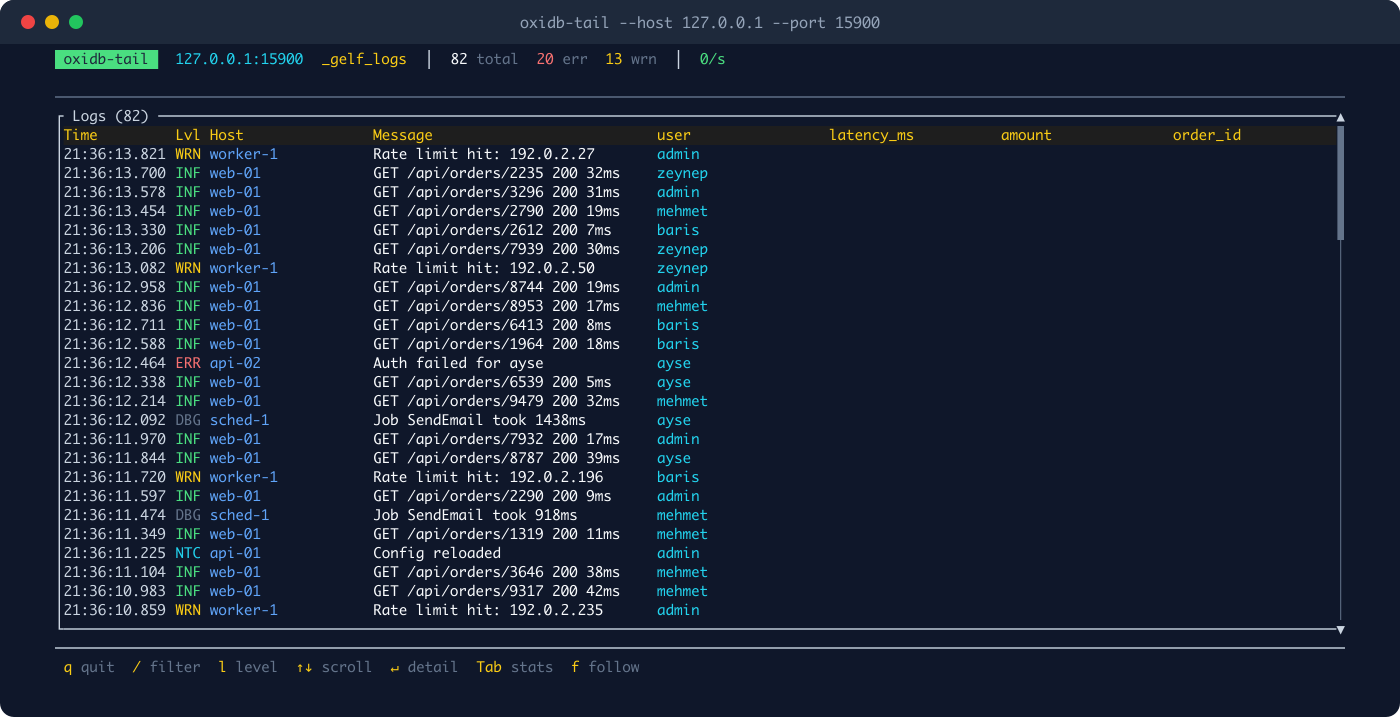
Nasıl çalıştığı basit: her --interval milisaniyede (varsayılan 500) koleksiyona {"_id": {"$gt": son_id}} sorgusu atıyor, _id'ye göre sıralı en fazla 200 kayıt alıyor. Seviyeler syslog seviyesine göre renkleniyor: 0-3 kırmızı, 4 sarı, 5 camgöbeği, 6 yeşil, 7 gri. İlk gelen batch'teki en sık ek alanları sütun olarak seçip kilitliyor. / ile metin filtresi, l ile seviye filtresi, Enter ile seçili kaydın bütün alanları, Tab ile host dağılımını gösteren bir yan panel var.
Burada da dürüst olmak gerekirse iki küçük tuhaflık var. Sütunlar ilk batch'e göre kilitlendiği için ekranda latency_ms, amount, order_id gibi bu akışta boş kalan sütunlar duruyor, client_ip ise görünmüyor. İkincisi, ilk yüklemede _id'ye göre artan sırada ilk 100 kaydı alıyor; çok büyük bir koleksiyona bağlandığınızda en eskiden başlayıp yetişmesi biraz sürüyor. Zaman sütunu da _ts alanından okunuyor, bu yüzden sayısal _ts taşıyan MessagePack koleksiyonlarında ??:??:?? gösteriyor. Araç adından da anlaşılacağı gibi GELF koleksiyonları için yazıldı.
Sunucunun kendi loglarını kendine yazması
Hikâyenin hoş bir kapanışı var: OxiDB sadece log almıyor, kendi loglarını da GELF ya da MessagePack olarak bir yere gönderebiliyor. OXIDB_GELF_ADDR ayarlıysa wire bağlantı olayları ve sunucu mesajları, OXIDB_MSGPACK_ADDR ayarlıysa REST katmanının istek logu oraya gidiyor. Hedef sunucunun kendisi de olabilir. Sunucuyu kendi portlarını gösterecek şekilde yeniden başlattım (yeniden başlatmadan önce ve sonra _gelf_logs 199.868, _msgpack_logs 250.005 kayıttı; kayıp yok):
OXIDB_GELF_ADDR=127.0.0.1:15908 OXIDB_MSGPACK_ADDR=127.0.0.1:15909 HOSTNAME=oxidb-demo ...Wire üzerinden bir bağlantı açıp kapattığımda _gelf_logs içinde:
{
 "host": "oxidb-demo",
 "short_message": "client connected: 127.0.0.1:50139",
 "timestamp": 1791754653.456128,
 "level": 6,
 "peer": "127.0.0.1:50139",
 "_ts": "2026-10-11T21:37:33.462529+00:00",
 "_id": 199869,
 "_version": 1
}
REST'i de açıp (OXIDB_HTTP_PORT) iki curl isteği attığımda _msgpack_logs içinde:
{
 "host": "oxidb-demo",
 "short_message": "GET /api/collections",
 "level": 6,
 "ts": 1791754676.108999,
 "_ts": 1791754676108,
 "app": "oxidb-server",
 "method": "GET",
 "path": "/api/collections",
 "status": "200",
 "ms": "0",
 "db": "",
 "user_agent": "curl/8.7.1",
 "_id": 250008,
 "_version": 1
}
404 dönen istek level: 4 (uyarı) olarak yazıldı. db alanı, yukarıda anlattığım kiracı yönlendirmesini besleyen alan. Ve görüldüğü gibi _ts burada sayısal; saklama kusurunun pratikte nereye dokunduğu da tam burası.
Diğer motorlarla ilişkisi
Log motoru ayrı bir depolama motoru değil, belge motorunun önüne konmuş girişler ve arkasına konmuş iki arka plan thread'i. Bunun sonucu olarak:
- Loglar üzerinde belge motorunun bütün sorgu ve aggregation yetenekleri çalışıyor. Hata mesajlarında metin araması istiyorsanız koleksiyona bir tam metin indeksi ekleyebilirsiniz.
- Dayanıklılık belge motorununki: WAL, CRC32, fsync. Yeniden başlatmada kayıt kaybı görmedim. Ama UDP'nin kendisi teslimat garantisi vermiyor; sunucuya ulaşmayan ya da kanal dolduğu için düşen paket hiçbir yerde iz bırakmıyor.
- Metrik gibi sayısal, düzenli aralıklı veriler için zaman serisi motoru daha uygun; sıkıştırma ve blok bazlı saklama orada. Log motoru düzensiz, yapılandırılmış, metin ağırlıklı kayıtlar için.
- Projenin 1.0 kararlılık ADR'si (ADR-0003) GELF girişini ve TTL indekslerini "çalışıyor ve gönderiliyor, ama 1.x içinde istek/yanıt biçimi değişebilir" grubunda tutuyor. Yani bu yüzey henüz geriye dönük uyumluluk sözü altında değil; yukarıdaki kusurları düzeltirken davranışı değiştirme serbestliğim var.
Özet ve deneme
GELF girişi "uygulamayı Graylog yerine OxiDB'ye yönlendir, her alan indeksli gelsin" kolaylığını veriyor; bedeli her alan için bir indeks ve yeni alan ilk geldiğinde yaşanabilen paket kaybı. MessagePack girişi bilerek daha az şey yapıyor: indeks yok, daha küçük paket, patlamalarda daha dayanıklı. Saklama, belge motorunun TTL mekanizmasının ince bir sarmalayıcısı; alarmlar da _alerts koleksiyonundaki belgelerin arka planda değerlendirilmesi. Hepsi tek bir süreçte, ayrı bir servis kurmadan.
Bu yazıyı hazırlarken bulduğum kusurlar (saklama süresini değiştirince TTL'in güncellenmemesi, sayısal _ts kayıtlarının hiç silinmemesi, localhost webhook'larının sessizce başarısız olması, kesirli aggregation sonuçlarının alarm üretmemesi, test_alert'in aggregation kurallarını desteklememesi, yeni alanlarda GELF paket kaybı) bir sonraki sürümlerin iş listesinde.
Denemek isterseniz hazır ikili dosyalar GitHub sürümler sayfasında duruyor; Docker imajını da depodaki Dockerfile ile oluşturabilirsiniz. En kısa yol:
OXIDB_GELF_PORT=12201 OXIDB_MSGPACK_PORT=12202 ./oxidb-serverSonra uygulamanızın GELF logger'ını UDP 12201'e yönlendirin (sıkıştırmayı kapatarak) ve oxidb-tail --host 127.0.0.1 --port 4444 ile izleyin. Serinin sonraki yazısında ledger motorunu anlatıyorum.