OxiDB SQL motoru: ayrı dosyalarda gerçek bir ilişkisel motor, PostgreSQL teli ve EF Core
OxiDB'ye belge motorunun yanında kendi WAL'ı ve dosyaları olan ikinci bir SQL motoru ekledim: gerçekten uygulanan kısıtlar, CTE'ler, pencere fonksiyonları, Cobra ile saklı prosedürler, değiştirilmemiş psql/psycopg ve EF Core.
OxiDB bir belge veritabanı olarak doğdu ve bir süre bunun üstünde de durdum: ilk denediğim SQL katmanını, belge motorunun üstüne oturtulmuş ince bir lehçe olduğu için tamamen söküp attım. Ama gerçek projelerde aynı soru dönüp dolaşıp geri geldi: "Faturalar, siparişler, stok için ilişkisel tablolar istiyorum; ayrı bir PostgreSQL kurmak zorunda mıyım?" Bu yazıda bu sorunun cevabı olarak OxiDB'ye eklediğim SQL motorunu anlatıyorum. Bir lehçe değil, kendi kataloğu, kendi WAL'ı, kendi dosyaları olan ikinci bir motor. Aynı süreçte belge motorunun yanında çalışıyor, PostgreSQL tel protokolünü konuştuğu için psql ve psycopg gibi istemciler değiştirilmeden bağlanıyor, .NET tarafında da tam bir EF Core sağlayıcısı var. Yazıdaki bütün çıktılar, yerel bir Apple M serisi Mac'te OxiDB 0.44.2 sunucusuna karşı benim çalıştırdığım oturumlardan alındı.
Bu yazı OxiDB serisinin dördüncüsü. Belge tarafını belge motoru yazısında, zaman serisi motorunu zaman serisi yazısında anlatıyorum.
Neden ayrı bir motor: ADR-0010
Kararın özü ADR-0010'da tek bir cümlede duruyor: iki motor, tek instance, farklı dosyalar. SQL motoru belge motorunun dosyalarına asla dokunmuyor, belge motoru da SQL'in dizinine girmiyor. İkisinin ortak noktası sadece süreç, port, kimlik doğrulama ve yaşam döngüsü. Ortak dosya yok, ortak kilit haritası yok, ortak depolama formatı yok.
Bunu bilerek seçtim. Önceki denemem, SQL sorgularını belge koleksiyonları üzerinde çalıştıran bir katmandı. Kâğıt üstünde ucuzdu ama ilişkisel anlamı (sabit şema, tipli kolonlar, birincil anahtar, yabancı anahtar) ilişkisel olmayan bir depoya zorla taşıyordu. Her iki dünyanın da en kötü yanlarını alıyordunuz. ADR-0010'da üç seçenek tartıştım ve ikincisini seçtim: kendi deposu, WAL'ı, kurtarma mantığı, kataloğu, planlayıcısı ve yürütücüsü olan ayrı bir oxidb-sql crate'i. Bugün bu crate yaklaşık 30 bin satır Rust.
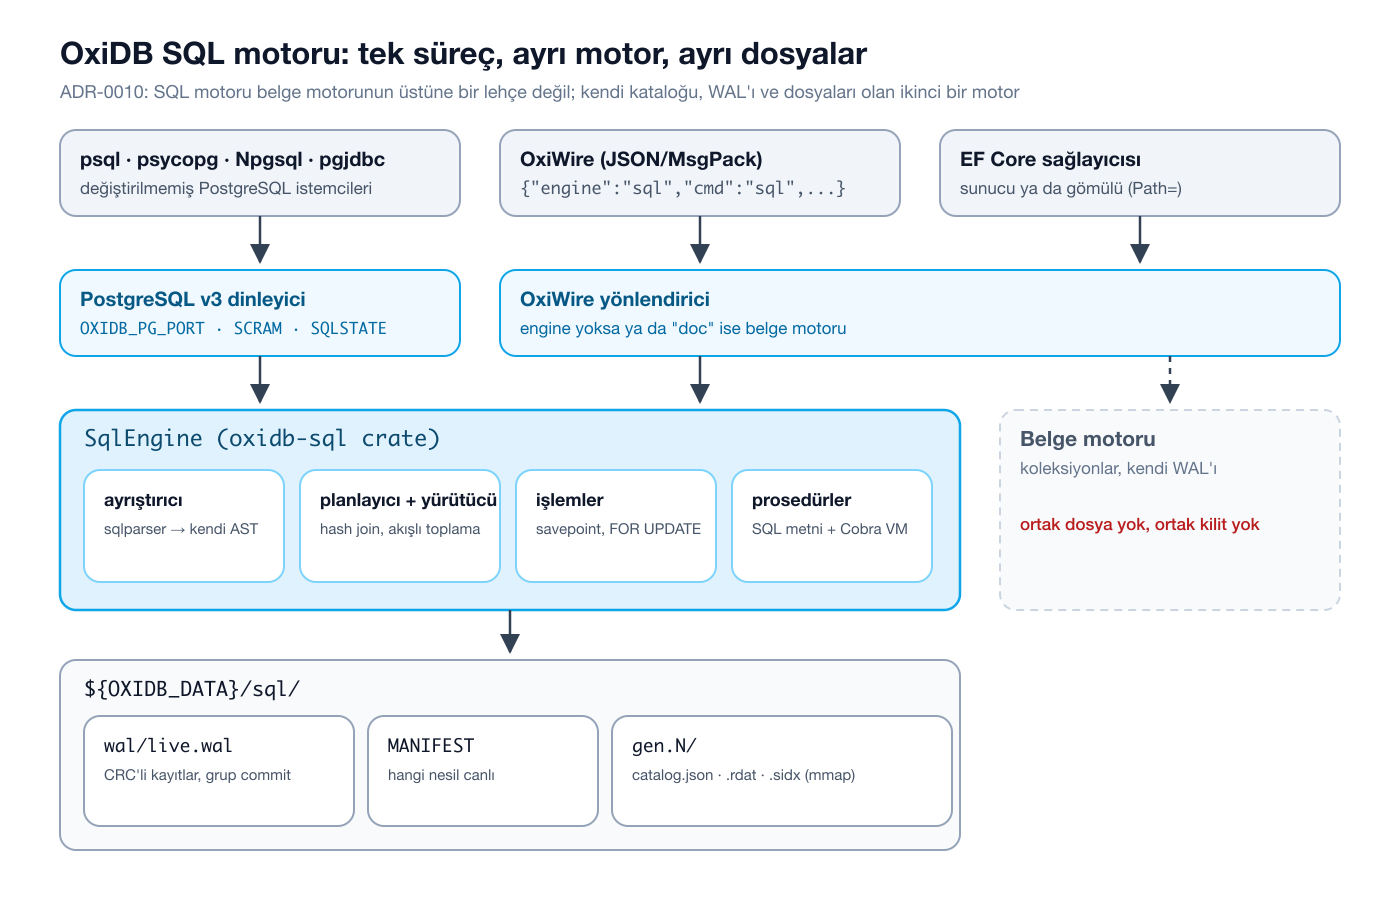
Pratikte bu ayrımın üç sonucu var:
- İsim alanları çakışmıyor.
customersadında bir SQL tablosu ilecustomersadında bir belge koleksiyonu aynı anda var olabilir, çünkü hiçbir zaman aynı dizini paylaşmıyorlar. Aşağıda bunu canlı göstereceğim. - Varsayılan olarak kapalı.
OXIDB_SQLverilmezse motor hiç kurulmuyor, maliyeti sıfır. - Tel uyumluluğu bozulmuyor. Yerel OxiWire protokolünde yönlendirme, istekteki isteğe bağlı bir
enginealanıyla yapılıyor.enginealanı olmayan her istek, eskiden olduğu gibi bayt bayt aynı yoldan belge motoruna gidiyor.
Bedeli de açık: iki motora yayılan atomik bir işlem yok. Bir belge yazımı ile bir SQL yazımı her biri kendi başına dayanıklı, ama ikisi tek bir atomik birim değil. Bunun için ADR-0011'de ortak bir sıra numarası (GSN) üzerinden bir tasarım yazdım ve sonra bilerek erteledim: gerçek kullanımda herkes bir motor seçip orada kalıyordu, buna karşılık maliyet çökme kurtarma yolunda kalıcı karmaşıklık olacaktı.
Çalıştırmak
SQL motoru ve PostgreSQL dinleyicisi iki ortam değişkeniyle açılıyor:
OXIDB_ADDR=127.0.0.1:15400 \
OXIDB_DATA=./data \
OXIDB_SQL=1 \
OXIDB_PG_PORT=15401 \
oxidb-server
Bu yazı için kendi portlarımı kullandım. Üretimde OXIDB_PG_PORT=5432 vermek mevcut bağlantı dizelerinin değişmeden çalışması demek. Sadece SQL (ve isterseniz zaman serisi) sunan bir sunucu için OXIDB_DOC=0 de verilebiliyor. Dokümantasyondaki ölçüme göre boşta bekleyen böyle bir sunucu 9,8 MB RSS ve 8 iş parçacığıyla duruyor, belge motoru açıkken bu 14,2 MB ve 23 iş parçacığı.
Önemli diğer ayarlar:
| Değişken | Varsayılan | Anlamı |
|---|---|---|
OXIDB_SQL_DATA | ${OXIDB_DATA}/sql | SQL motorunun veri dizini |
OXIDB_SQL_SYNC | full | full: her commit'te gerçek depolama flush'ı; data: işletim sistemi seviyesinde sync, birkaç kat hızlı |
OXIDB_SQL_DISK_FIRST | açık | Tablo verisi mmap'lenmiş snapshot'tan okunur, sadece checkpoint sonrası değişiklikler RAM'de |
OXIDB_SQL_CHECKPOINT_BYTES | 64 MiB | Canlı WAL bu boyutu geçince otomatik checkpoint |
OXIDB_SQL_LOCK_TIMEOUT_MS | 5000 | Satır kilidi bekleme süresi; kilitlenmeyi hataya çevirir |
Sunucu açıldıktan sonra Homebrew'dan gelen sıradan psql 18 ile bağlanıyorum. Hiçbir eklenti, hiçbir özel sürücü yok:
psql -h 127.0.0.1 -p 15401 -U admin -d oxidb -c "SELECT version();" version
---------------------
16.0 (OxiDB 0.44.2)
(1 row)Veri modeli ve DDL
Örnek veri seti olarak küçük bir mağaza kurdum: müşteriler, ürünler, siparişler ve sipariş kalemleri. Tablolar, PostgreSQL ya da MySQL'den tanıdık gelecek şekilde tanımlanıyor:
CREATE TABLE customers (
  id      INT PRIMARY KEY AUTO_INCREMENT,
  name    VARCHAR(40) NOT NULL,
  email   TEXT UNIQUE,
  city    TEXT
);
CREATE TABLE products (
  id     INT PRIMARY KEY,
  name   TEXT NOT NULL,
  price  DECIMAL(10,2) NOT NULL,
  stock  SMALLINT DEFAULT 0
);
CREATE TABLE orders (
  id          INT PRIMARY KEY AUTO_INCREMENT,
  customer_id INT NOT NULL REFERENCES customers(id) ON DELETE CASCADE,
  created_at  TIMESTAMP NOT NULL
);
CREATE TABLE order_items (
  order_id   INT NOT NULL REFERENCES orders(id) ON DELETE CASCADE,
  product_id INT NOT NULL REFERENCES products(id),
  qty        INT NOT NULL,
  CONSTRAINT pk_items PRIMARY KEY (order_id, product_id)
);
AUTO_INCREMENT (ayrıca AUTOINCREMENT ve PostgreSQL'in GENERATED ... AS IDENTITY yazımı) ile üretilen anahtarlar RETURNING ile geri okunabiliyor. EF Core ve ADO.NET de üretilen anahtarları tam olarak bu yolla okuyor:
INSERT INTO customers (name, email, city) VALUES
  ('Ayşe', 'ayse@example.com', 'İstanbul'),
  ('Mehmet', 'mehmet@example.com', 'Ankara'),
  ('Zeynep', 'zeynep@example.com', 'İzmir'),
  ('Can', 'can@example.com', 'İstanbul')
RETURNING id, name;
id | name
----+--------
1 | Ayşe
2 | Mehmet
3 | Zeynep
4 | Can
(4 rows)
INSERT 0 4Çok satırlı bir INSERT tek bir WAL toplu kaydı olarak uygulanıyor: bütün satırlar önce doğrulanıyor, sonra tek bir fsync ile hepsi birden yazılıyor. Ürünleri, altı siparişi ve on bir sipariş kalemini de aynı şekilde ekledim. İçgözlem (introspection) için SHOW TABLES, DESCRIBE, SHOW INDEXES, SHOW VIEWS ve SHOW PROCEDURES var:
DESCRIBE order_items;
   column   | type | nullable | primary_key | auto_increment
------------+------+----------+-------------+----------------
 order_id   | INT  | f        | t           | f
 product_id | INT  | f        | t           | f
 qty        | INT  | f        | f           | f
(3 rows)
Bileşik birincil anahtarın her iki kolonu da primary_key olarak işaretli ve ikisi de örtük olarak NOT NULL.
Tip sistemi bilerek küçük tutuldu: BIGINT, INT, SMALLINT, TINYINT, DOUBLE, TEXT (VARCHAR(n) dahil), BOOL, TIMESTAMP, DECIMAL ve BLOB. TIMESTAMP epoch milisaniyesi olarak saklanıyor ve UTC kabul ediliyor. Tam sayılarla ilgili ayrıca konuşmak istediğim bir ayrıntı var, onu kısıtlar bölümünde anlatıyorum.
Kısıtlar gerçekten uygulanıyor
Bir veritabanının sözdizimini kabul edip sonra sessizce görmezden geldiği bir kısıt, hiç kabul etmediği bir kısıttan daha kötüdür. Bu yüzden kural basit: ya uygulanıyor ya da dokümantasyonda açıkça "uygulanmıyor" diye yazıyor. Aşağıdaki oturumun tamamı gerçek, tam olarak psql'in gösterdiği gibi:
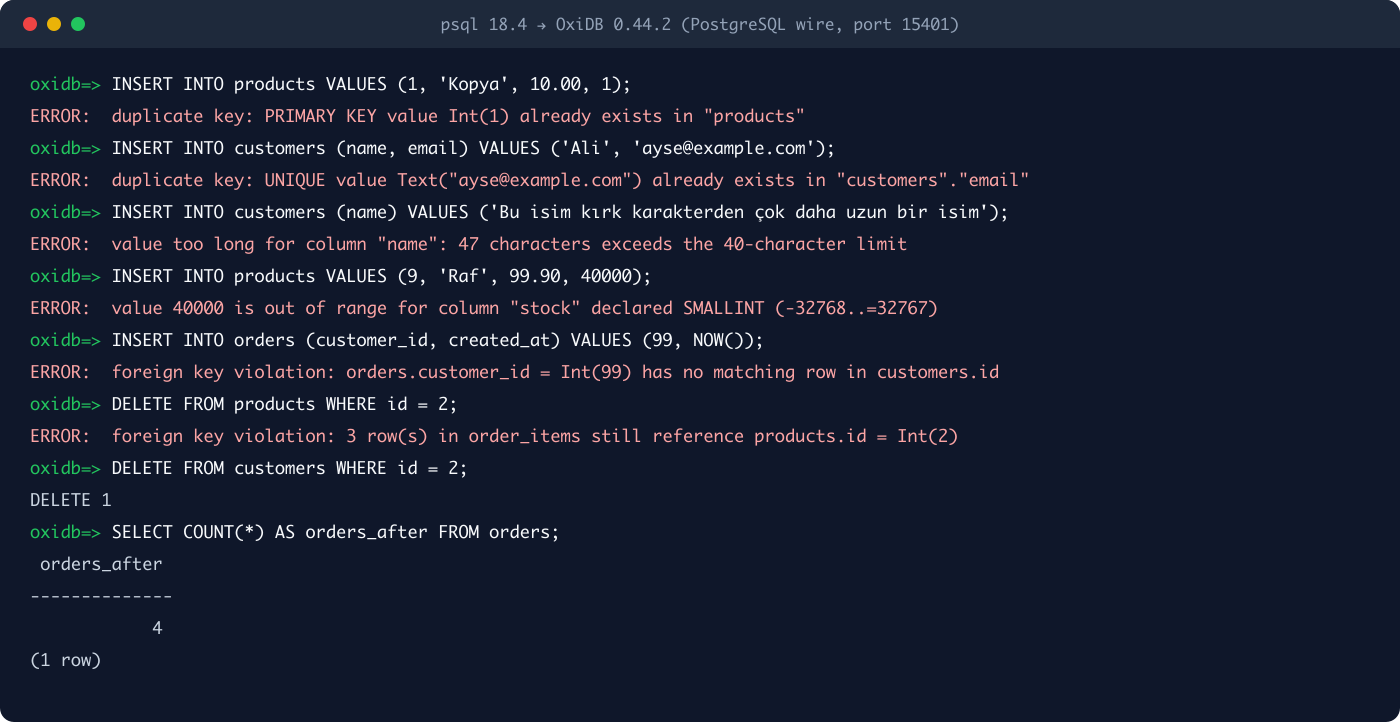
Sırayla:
- PRIMARY KEY: tekrarlanan anahtar reddediliyor. Bu kontrol düz INSERT'lerde, çok satırlı INSERT'lerde (herhangi bir satır uygulanmadan önce bütün toplu iş için), UPDATE'lerde ve işlemlerin içinde yapılıyor. Bileşik anahtar ancak bütün kolonlar eşleşirse çakışıyor;
order_itemsiçin(1, 1)reddedildi. - UNIQUE: tek kolonlu
UNIQUEuygulanıyor. NULL'lar SQL standardında olduğu gibi muaf. - NOT NULL:
namekolonuna NULL girmekschema mismatch: column "name" is NOT NULL but got NULLile reddediliyor. - VARCHAR(n): uzunluk karakter bazında sayılıyor, bayt bazında değil. 47 karakterlik Türkçe bir isim 40 karakterlik sınırı aşınca reddediliyor.
- Tam sayı genişliği: Bu ince bir nokta. Motor her tam sayıyı 64 bit saklıyor, yani
SMALLINTyerden tasarruf sağlamıyor. Ama bildirilen aralığın dışındaki bir değer sessizce genişletilmiyor, reddediliyor. Böylece bir kolonun bildirilen tipi içeriği hakkında doğru kalıyor.ALTER TABLE ... ALTER COLUMN ... TYPE SMALLINTde önce bütün satırları kuru bir çalıştırmayla kontrol ediyor: daraltma ya tamamen başarılı oluyor ya da kolona hiç dokunmuyor. - FOREIGN KEY: çocuk tarafındaki INSERT/UPDATE, ebeveyni bulmak zorunda. Ebeveyn tarafındaki DELETE ise
ON DELETE NO ACTION,RESTRICT,CASCADEveSET NULLkurallarına uyuyor.productssatırını silmeye çalışınca üç sipariş kalemi ona referans verdiği için reddedildi.customerssatırını sildiğimde iseCASCADEiki seviye boyunca işledi: Mehmet'in iki siparişi ve bu siparişlerin beş kalemi de gitti. Silmeden önce 6 sipariş ve 11 kalem vardı, sonra 4 sipariş ve 6 kalem kaldı.
PostgreSQL tel katmanı bu hataları doğru SQLSTATE kodlarına çeviriyor (23505, 23503, 23502, 22001, 22003). Sürücüler de bu sayede doğru istisna sınıfını fırlatıyor. Bunu aşağıda psycopg ile göstereceğim.
Uygulanmayan şeyleri de açıkça yazmak gerekiyor: CREATE UNIQUE INDEX sıradan bir indeks oluşturuyor, UNIQUE kısmı uygulanmıyor. Birden fazla kolonlu tablo seviyesindeki UNIQUE kabul ediliyor ama uygulanmıyor. Çok kolonlu FK'ler ve ON UPDATE eylemleri de uygulanmıyor. CHECK kısıtları ise ayrıştırma aşamasında reddediliyor. Yazı için çalışırken bir fark daha gördüm: kendi kendine referans veren bir tabloda (çalışan ve yöneticisi gibi) ebeveyn ve çocuğu aynı çok satırlı INSERT içinde eklemek reddediliyor, çünkü FK kontrolü toplu işin kendisini değil, commit edilmiş durumu görüyor. PostgreSQL bunu ifade sonunda kontrol ettiği için kabul eder. Çözüm basit: ebeveyni önce, ayrı bir ifadeyle eklemek.
Sorgular: join'ler, GROUP BY, CTE, pencere fonksiyonları
Önce iki yeni müşteri, sipariş ve kalem ekledim (Bursa'dan siparişi olmayan bir Ece dahil), sonra sorgulara geçtim. Beş tabloluk bir join, GROUP BY ve HAVING:
SELECT c.name, COUNT(DISTINCT o.id) AS orders, SUM(oi.qty * p.price) AS revenue
FROM customers c
JOIN orders o       ON o.customer_id = c.id
JOIN order_items oi ON oi.order_id = o.id
JOIN products p     ON p.id = oi.product_id
GROUP BY c.name
HAVING SUM(oi.qty * p.price) > 5000
ORDER BY revenue DESC;
name | orders | revenue
--------+--------+----------
Zeynep | 2 | 20752.00
Ayşe | 3 | 15401.00
Can | 1 | 6300.00
(3 rows)DECIMAL sonuçların iki ondalıkla gelmesi tesadüf değil: DECIMAL artık tam (exact) bir tip ve PostgreSQL teline numeric olarak metin halinde gidiyor. INNER, LEFT, RIGHT, FULL ve CROSS join'ler istenen derinlikte zincirlenebiliyor. Eşitlik join'leri hash join olarak, yoğun tam sayı anahtarlarda da doğrudan adreslenen dizi join'leri olarak çalışıyor. Eşitlik olmayan ON koşulları iç içe döngüye düşüyor. Siparişi olmayan müşterileri bulmak klasik bir anti-join:
SELECT c.name, c.city
FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
WHERE o.id IS NULL;
name | city
------+-------
Ece | Bursa
(1 row)WITH ile CTE ve pencere fonksiyonları birlikte. Her müşterinin siparişlerini tutara göre sıralayıp, müşteri bazında birikimli toplamı ve genel sıralamayı tek bir sorguda alıyorum:
WITH order_totals AS (
  SELECT o.id, o.customer_id, o.created_at, SUM(oi.qty * p.price) AS total
  FROM orders o
  JOIN order_items oi ON oi.order_id = o.id
  JOIN products p ON p.id = oi.product_id
  GROUP BY o.id, o.customer_id, o.created_at
)
SELECT customer_id, id AS order_id, total,
       ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY total DESC) AS rn,
       SUM(total)   OVER (PARTITION BY customer_id ORDER BY created_at) AS running,
       RANK()       OVER (ORDER BY total DESC) AS overall_rank
FROM order_totals
ORDER BY customer_id, created_at;
customer_id | order_id | total | rn | running | overall_rank
-------------+----------+----------+----+----------+--------------
1 | 1 | 2151.00 | 3 | 2151.00 | 6
1 | 2 | 7800.00 | 1 | 9951.00 | 2
1 | 11 | 5450.00 | 2 | 15401.00 | 4
3 | 4 | 16850.00 | 1 | 16850.00 | 1
3 | 10 | 3902.00 | 2 | 20752.00 | 5
4 | 5 | 6300.00 | 1 | 6300.00 | 3
(6 rows)ROW_NUMBER, RANK, DENSE_RANK ve COUNT/SUM/AVG/MIN/MAX pencere üzerinde çalışıyor. Pencerede ORDER BY yoksa toplam bütün bölümü kapsıyor. Varsa birikimli oluyor ve eşit sıralama anahtarına sahip satırlar aynı değeri paylaşıyor, yani standart varsayılan çerçeve. Açık çerçeveler (ROWS BETWEEN ...) henüz yok.
Yinelemesiz CTE'ler ayrıştırma aşamasında türetilmiş tablolara açılıyor. Kendine referans veren bir CTE ise anchor UNION [ALL] step biçiminde olmak zorunda ve yürütücüde sabit nokta yinelemesiyle hesaplanıyor: her adım, CTE'nin bir önceki turdaki satırlarına bağlandığı haliyle yeniden çalışıyor. UNION daha önce görülen her şeye karşı tekilleştirdiği için döngüler kendiliğinden sonlanıyor. Kaçak sorgulara karşı da 1 milyon yineleme ve 10 milyon satırlık korumalar var. Bir organizasyon şeması:
WITH RECURSIVE chain(id, depth, path) AS (
  SELECT id, 0, name FROM employees WHERE manager_id IS NULL
  UNION ALL
  SELECT e.id, c.depth + 1, c.path || ' > ' || e.name
  FROM employees e JOIN chain c ON e.manager_id = c.id
)
SELECT id, depth, path FROM chain ORDER BY path;
id | depth | path
----+-------+-----------------------------
1 | 0 | Barış
2 | 1 | Barış > Elif
4 | 2 | Barış > Elif > Deniz
6 | 3 | Barış > Elif > Deniz > Mert
5 | 2 | Barış > Elif > Selin
3 | 1 | Barış > Kerem
(6 rows)Aynı mekanizma bir tarih serisi üretmek için de kullanılabiliyor. INTERVAL ile toplama burada da çalışıyor:
WITH RECURSIVE days(d) AS (
  SELECT TIMESTAMP '2026-10-01'
  UNION ALL
  SELECT d + INTERVAL '1 day' FROM days WHERE d < TIMESTAMP '2026-10-04'
)
SELECT d FROM days;
d
---------------------
2026-10-01 00:00:00
2026-10-02 00:00:00
2026-10-03 00:00:00
2026-10-04 00:00:00
(4 rows)LATERAL, DISTINCT ON ve sıralı küme toplamları
Analitik tarafta en çok kullandığım üç PostgreSQL deyimi de var. "Her müşterinin son siparişi" sorusunun iki cevabı. Biri DISTINCT ON, yani ORDER BY'a göre her anahtarın ilk satırı:
SELECT DISTINCT ON (customer_id) customer_id, id, created_at
FROM orders
ORDER BY customer_id, created_at DESC;
customer_id | id | created_at
-------------+----+---------------------
1 | 11 | 2026-10-09 08:00:00
3 | 10 | 2026-10-08 11:20:00
4 | 5 | 2026-10-02 12:00:00
(3 rows)Diğeri LATERAL: soldaki satırlara referans verebilen ve her sol satır için yeniden çalıştırılan bir türetilmiş tablo. LEFT JOIN LATERAL ile siparişi olmayan Ece de sonuçta kalıyor:
SELECT c.name, last_o.id AS last_order, last_o.created_at
FROM customers c
LEFT JOIN LATERAL (
  SELECT id, created_at FROM orders o
  WHERE o.customer_id = c.id
  ORDER BY created_at DESC LIMIT 1
) last_o ON TRUE
ORDER BY c.name;
name | last_order | created_at
--------+------------+---------------------
Ayşe | 11 | 2026-10-09 08:00:00
Can | 5 | 2026-10-02 12:00:00
Ece | |
Zeynep | 10 | 2026-10-08 11:20:00
(4 rows)EF Core'un CROSS APPLY / OUTER APPLY ürettiği yerlerde sağlayıcı tam olarak bu [LEFT] JOIN LATERAL biçimini kullanıyor. RIGHT ve FULL LATERAL reddediliyor. Sıralı küme toplamı (ordered-set aggregate) olarak mode() WITHIN GROUP var:
SELECT mode() WITHIN GROUP (ORDER BY product_id) AS top_product,
       COUNT(DISTINCT order_id) AS orders
FROM order_items;
top_product | orders
-------------+--------
1 | 6
(1 row)Bunların yanında UNION/EXCEPT/INTERSECT (her birinin ALL biçimiyle ve standart öncelikle), herhangi bir derinlikte korelasyonlu alt sorgular, EXISTS, VALUES tablo kurucusu, görünümler (CREATE VIEW), CASE, COALESCE, NULLIF, LIKE, CAST, string ve matematik fonksiyonları da var.
Tarih aritmetiği
TIMESTAMP epoch milisaniyesi olarak saklandığı için tarih aritmetiği net ve öngörülebilir. INTERVAL literal'leri milisaniye tam sayılarına katlanıyor, ts ± aralık ve ts - ts çalışıyor. EXTRACT/date_part ve date_trunc UTC takvim hesabıyla, ISO haftalarıyla (haftalar pazartesi başlar) ve PostgreSQL'in gün numaralandırmasıyla çalışıyor:
SELECT id, created_at,
       created_at + INTERVAL '7 days'  AS due,
       date_trunc('week', created_at)  AS week,
       EXTRACT(DOW FROM created_at)    AS dow,
       (TIMESTAMP '2026-10-12' - created_at) / 86400000 AS days_ago
FROM orders ORDER BY id LIMIT 4;
id | created_at | due | week | dow | days_ago
----+---------------------+---------------------+---------------------+-----+----------
1 | 2026-09-01 10:15:00 | 2026-09-08 10:15:00 | 2026-08-31 00:00:00 | 2 | 40
2 | 2026-09-14 18:40:00 | 2026-09-21 18:40:00 | 2026-09-14 00:00:00 | 1 | 27
4 | 2026-09-20 21:30:00 | 2026-09-27 21:30:00 | 2026-09-14 00:00:00 | 0 | 21
5 | 2026-10-02 12:00:00 | 2026-10-09 12:00:00 | 2026-09-28 00:00:00 | 5 | 9
(4 rows)İki zaman damgasının farkı milisaniye döndüğü için gün sayısı için 86.400.000'e bölüyorum. Bilerek koyduğum bir sınır var: INTERVAL sadece sabit birimleri kabul ediyor, ay ve yıl reddediliyor. Çünkü "bir ay" sabit bir milisaniye değil. Takvime göre doğru ay eklemek için add_months(ts, n) var. Gün taşmalarını kırpıyor ve EF'in AddMonths/AddYears çevirisi de bunu kullanıyor.
Etkileşimli işlemler
İşlemler etkileşimli: BEGIN aynı bağlantı üzerinde istekler arasında yaşayan bir işlem açıyor. İşlemin okumaları kendi tamponlanmış yazımlarını görüyor, diğer bağlantılar commit'e kadar hiçbir şey görmüyor. Savepoint'ler kısmi geri almayı sağlıyor:
BEGIN;
UPDATE accounts SET balance = balance - 300 WHERE id = 1;
UPDATE accounts SET balance = balance + 300 WHERE id = 2;
SAVEPOINT bonus;
UPDATE accounts SET balance = balance + 1000000 WHERE id = 2;
ROLLBACK TO SAVEPOINT bonus;
SELECT id, owner, balance FROM accounts ORDER BY id;
COMMIT;
id | owner | balance
----+-------+---------
1 | Ayşe | 700.00
2 | Can | 550.00
(2 rows)Milyonluk "bonus" geri alındı, transfer kaldı. Commit tek bir atomik WAL toplu kaydı ve tek bir fsync. Bir ifade hata verirse işlem PostgreSQL'deki gibi zehirleniyor: sonraki ifadeler reddediliyor ve COMMIT'e ROLLBACK cevabı dönüyor:
BEGIN;
UPDATE accounts SET balance = balance - 50 WHERE id = 1;
UPDATE 1
INSERT INTO accounts VALUES (2, 'Kopya', 0);
ERROR:  duplicate key: PRIMARY KEY value Int(2) already exists in "accounts"
SELECT 1;
ERROR:  current transaction is aborted, commands ignored until end of transaction block
COMMIT;
ROLLBACK
Motorun kendi davranışı aslında daha basit: hata anında işlemi geri alıyor. Ama psycopg'nin with conn.transaction(): kurtarma mantığı tam olarak bu "zehirli işlem" durumuna dayandığı için PostgreSQL oturum katmanı bunu taklit ediyor.
İki bağlantının birbirini nasıl gördüğünü ve satır kilitlerini görmek için psycopg 3.3 ile küçük bir betik yazdım. Bu tamamen stok psycopg, bağlantı dizesi dışında OxiDB'ye özel hiçbir şey yok:
import psycopg, time

DSN = "host=127.0.0.1 port=15401 user=admin dbname=oxidb"
a = psycopg.connect(DSN)
b = psycopg.connect(DSN, autocommit=True)

a.execute("UPDATE accounts SET balance = balance + 100 WHERE id = 2")
print("A sees:", a.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])
print("B sees:", b.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])
a.commit()
print("B after A commits:", b.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])

a.execute("SELECT * FROM accounts WHERE id = 1 FOR UPDATE")
t = time.time()
try:
    b.execute("UPDATE accounts SET balance = 0 WHERE id = 1")
except psycopg.Error as e:
    print(f"B blocked {time.time()-t:.1f}s, then: {type(e).__name__} [{e.sqlstate}] {e}")
a.rollback()

for sql in ["INSERT INTO accounts VALUES (1, 'x', 0)",
            "INSERT INTO accounts VALUES (3, NULL, 0)",
            "SELECT * FROM nope"]:
    try:
        b.execute(sql)
    except psycopg.Error as e:
        print(f"{type(e).__name__:22} {e.sqlstate}")

cur = b.execute("SELECT owner, balance FROM accounts WHERE balance > %s ORDER BY id", (600,))
print(cur.fetchall(), [d.name + ":" + str(d.type_code) for d in cur.description])
A sees: 650.00
B sees: 550.00
B after A commits: 650.00
B blocked 5.0s, then: LockNotAvailable [55P03] lock timeout: row 1 of 'accounts' is locked by another transaction
UniqueViolation 23505
NotNullViolation 23502
UndefinedTable 42P01
[('Ayşe', Decimal('700.00')), ('Can', Decimal('650.00'))] ['owner:25', 'balance:1700']Her satırın anlattığı bir şey var. A kendi yazımını görüyor, B commit'e kadar görmüyor. SELECT ... FOR UPDATE gerçek bir satır kilidi alıyor ve B'nin yazımı 5 saniyelik kilit zaman aşımına kadar bekleyip 55P03 ile düşüyor, yani bir kilitlenme sonsuza kadar asılı kalmak yerine hataya dönüşüyor. SQLSTATE kodları psycopg'nin doğru istisna sınıflarına eşleniyor. %s parametreleri genişletilmiş protokolle sunucu tarafında bağlanıyor. DECIMAL kolonu da OID 1700 (numeric) olarak tanımlanıp Python'a Decimal olarak geliyor.
Eşzamanlılık modeli hakkında dürüst olmak gerekirse: bu bir tam MVCC değil. Açık bir işlemin yazdığı satır kimlikleri ve AUTO_INCREMENT değerleri, yazım tamponlanırken motordan rezerve ediliyor. Teklik kısıtları ise COMMIT anında commit edilmiş duruma karşı yeniden kontrol ediliyor. Siz işlem açıkken başka bir yazar sizin anahtarınızı aldıysa commit duplicate-key hatasıyla reddediliyor ve hiçbir şey uygulanmıyor. Yapılacak şey işlemi yeniden denemek. Bunun bir yan etkisi de şu: hata veren ifadeler de AUTO_INCREMENT değeri tüketiyor, tıpkı PostgreSQL sequence'leri gibi. Yukarıdaki oturumda üç başarısız müşteri INSERT'i 5, 6 ve 7 numaralarını yaktı. Bu yüzden Ece 8 numarayı aldı, birazdan OxiWire üzerinden eklediğim müşteri de 9 numarayı alacak.
Saklı prosedürler: SQL ve Cobra
İki tür saklı prosedür var. Birincisi sıfır araç gerektiren yol: SQL metni. İsimli parametreler alan, katalogda saklanan ve atomik çalışan bir DML/SELECT dizisi:
CREATE PROCEDURE transfer(src INT, dst INT, amount DECIMAL) AS BEGIN
  UPDATE accounts SET balance = balance - amount WHERE id = src;
  UPDATE accounts SET balance = balance + amount WHERE id = dst;
  SELECT id, owner, balance FROM accounts WHERE id IN (src, dst) ORDER BY id;
END;
CALL transfer(1, 2, 125.50);
id | owner | balance
----+-------+---------
1 | Ayşe | 574.50
2 | Can | 775.50
(2 rows)Parametreler oluşturma anında $N yer tutucularına yeniden yazılıyor. SHOW PROCEDURES saklanan halini gösteriyor: UPDATE accounts SET balance = balance - $3 WHERE id = $1; .... Üst seviyedeki bir CALL örtük bir işlem içinde çalışıyor, herhangi bir ifade hata verirse bütün çağrı geri alınıyor. Ama bu gövdenin kontrol akışı yok. Şuna bakın:
CALL transfer(1, 99, 10);
 id | owner | balance
----+-------+---------
  1 | Ayşe  |  564.50
(1 row)
99 numaralı hesap yok. İkinci UPDATE sıfır satıra dokundu, hata da vermedi, sonuçta Ayşe'nin 10 lirası buhar oldu. SQL metni prosedürü "hesap var mı, bakiye yetiyor mu" diye soramıyor. İşte ADR-0014'ün varlık sebebi bu.
Cobra benim yazdığım bir betik dili: bytecode derleyicisi ve yığın tabanlı bir VM'i var. ADR-0014'te .cobrac bytecode'unu saklı prosedür değişim formatı olarak seçtim. Derleyici Go'daki cobra aracı olarak kalıyor. SQL motorunun içinde ise sadece çalıştıran, Rust ile yazılmış kompakt bir Cobra VM var (oxidb-cobra crate'i). Reddettiğim alternatifler öğretici: Go çalışma zamanını cgo ile Rust sürecine bağlamak (GC, sinyal yönetimi, her çağrıda çift FFI), bir yan süreç (bir CALL çağıranın işlemi içinde çalışmak zorunda, her ifadeyi IPC ile taşımak yavaş ve kırılgan) ve SQL prosedürlerini PL/pgSQL tarzı bir lehçeye büyütmek (elimde zaten test edilmiş bir dil ve derleyici varken ikinci bir dil tasarlamak).
Aynı transferin güvenli hali:
# CREATE PROCEDURE safe_transfer(src INT, dst INT, amount DECIMAL) LANGUAGE COBRA
def run(db, src, dst, amount)
    let src_rows = db.query("SELECT balance FROM accounts WHERE id = ?", [src])
    let dst_rows = db.query("SELECT balance FROM accounts WHERE id = ?", [dst])
    if len(src_rows) == 0 or len(dst_rows) == 0
        throw "unknown account"
    end
    if src_rows[0]["balance"] < amount
        throw "insufficient funds"
    end
    db.execute("UPDATE accounts SET balance = balance - ? WHERE id = ?", [amount, src])
    db.execute("UPDATE accounts SET balance = balance + ? WHERE id = ?", [amount, dst])
    print("moved", amount, "from", src, "to", dst)
    return db.query("SELECT id, owner, balance FROM accounts ORDER BY id")
end
Taşınabilir bytecode'a derleyip base64 olarak gönderiyorum. 668 baytlık bytecode, base64 ile 892 karakter:
cobra build --portable safe_transfer.cobra
B64=$(base64 -i safe_transfer.cobrac | tr -d '\n')
psql ... -c "CREATE PROCEDURE safe_transfer(src INT, dst INT, amount DECIMAL) LANGUAGE COBRA AS '$B64';"
CALL safe_transfer(2, 1, 100);
NOTICE: moved 100.0 from 2 to 1
id | owner | balance
----+-------+---------
1 | Ayşe | 664.5
2 | Can | 675.5
(2 rows)
CALL safe_transfer(1, 99, 10);
ERROR: evaluation error: procedure "safe_transfer": line 6: uncaught throw: "unknown account"
CALL safe_transfer(2, 1, 5000);
ERROR: evaluation error: procedure "safe_transfer": line 9: uncaught throw: "insufficient funds"Birkaç ayrıntı: print çıktısı notices olarak dönüyor ve psql'de PostgreSQL NOTICE'i olarak görünüyor. Yakalanmamış bir throw bütün CALL'ı geri alıyor, hata mesajı da Cobra satır numarasını taşıyor. db.query ve db.execute çağıranın deposu üzerinden çalıştığı için prosedür CALL'ın işlemine katılıyor. Hatalar Cobra içinde try/catch ile yakalanabiliyor. Dönüş değeri sonuç kümesine şekilleniyor: sözlük bir satır, sözlük listesi bir tablo, skaler bir value kolonu oluyor.
Güvenlik ve küme tarafı için de tasarım kararları var. VM, sadece benim kaydettiğim fonksiyonlar üzerinden dışarıya erişebiliyor. Dosya sistemi, ağ ya da süreç erişimi yok. Küme modunda Raft CALL'ı bir yazma ifadesi olarak her düğümde yeniden çalıştırdığı için bytecode deterministik olmak zorunda. Bu yüzden zaman, rastgelelik, I/O ve paralellik sunan yerleşik fonksiyonlar izin listesinde yok. Bilinmeyen opcode'lar ve yerleşikler çağrı ortasında değil, CREATE anında reddediliyor. Kaçak döngülere karşı da yakalanamayan 100 milyon komutluk bir "yakıt" sınırı var.
Dürüst bir not: Cobra'nın değer modelinde tam bir ondalık tipi bu köprüde kullanılmıyor. SHOW PROCEDURES çıktısında amount DECIMAL parametresinin amount DOUBLE olarak saklandığını görüyorsunuz. Bu yüzden yukarıdaki bakiyeler 664.5 şeklinde, DECIMAL biçimlendirmesi olmadan dönüyor. Para hesabı yapan bir Cobra prosedüründe bunu bilmek gerekiyor.
Disk öncelikli depolama, WAL ve grup commit
Şimdi motorun içine geçelim. Diskteki düzen şöyle (bu, yazının sonundaki çökme testinden sonra veri dizinimin gerçek hali, kısaltılmış):
data/sql/
  MANIFEST                      {"version":1,"generation":11,"wal_seq":131}
  wal/live.wal
  gen.11/
    catalog.json
    customers.rdat   customers.$pk.sidx   customers.$uq2.sidx
    events.rdat      events.$pk.sidx
...- WAL (
wal/live.wal) SQL motorunun kendi günlüğü. BaşlıkOXSWsihirli baytlarıyla başlıyor. Her kayıt[crc32][len][seq][payload]biçiminde. Kurtarma, kayıtları yırtık bir kuyruğa (çökme yüzünden yarım kalmış bir yazım) ya da CRC uyuşmazlığına kadar okuyor. Geçerli önek, o noktaya kadar okunan her şey. - Snapshot'lar: checkpoint'te her tablonun canlı satırları
gen.N/<tablo>.rdatdosyasına yazılıyor. BaşlıkOXSR, kayıtlar[row_id][len][crc32][payload]. Snapshot her zaman bütün olarak yazılıyor (geçici dosya, fsync, rename), yani her zaman tutarlı bir zaman noktası görüntüsü. - İndeksler (
.sidx) mmap'lenen, sıralı ve sabit adımlı bir giriş tablosu. Bir B-tree değil, bilinçli olarak. Her yazıcı dosyayı checkpoint'te baştan yazdığı için bölünecek sayfa, boş alan haritası ya da sayfa seviyesinde doğru yapılması gereken bir eşzamanlılık yok. Arama sabit adımlı tabloda ikili arama, aralık taraması da alt sınır artı yürüme. - MANIFEST commit noktası. Checkpoint'i commit etmek tek bir atomik adım: geçici dosya, fsync ve
MANIFESTüzerine rename. Rename'den önce çökerse önceki MANIFEST, yani önceki sağlam nesil geçerli kalıyor. Yarım kalan nesil açılışta yok sayılıp çöpe atılıyor. Katalog ve snapshot'lar birlikte değiştiği için kurtarma, kolon sayısı snapshot'larla uyuşmayan bir katalog asla görmüyor.
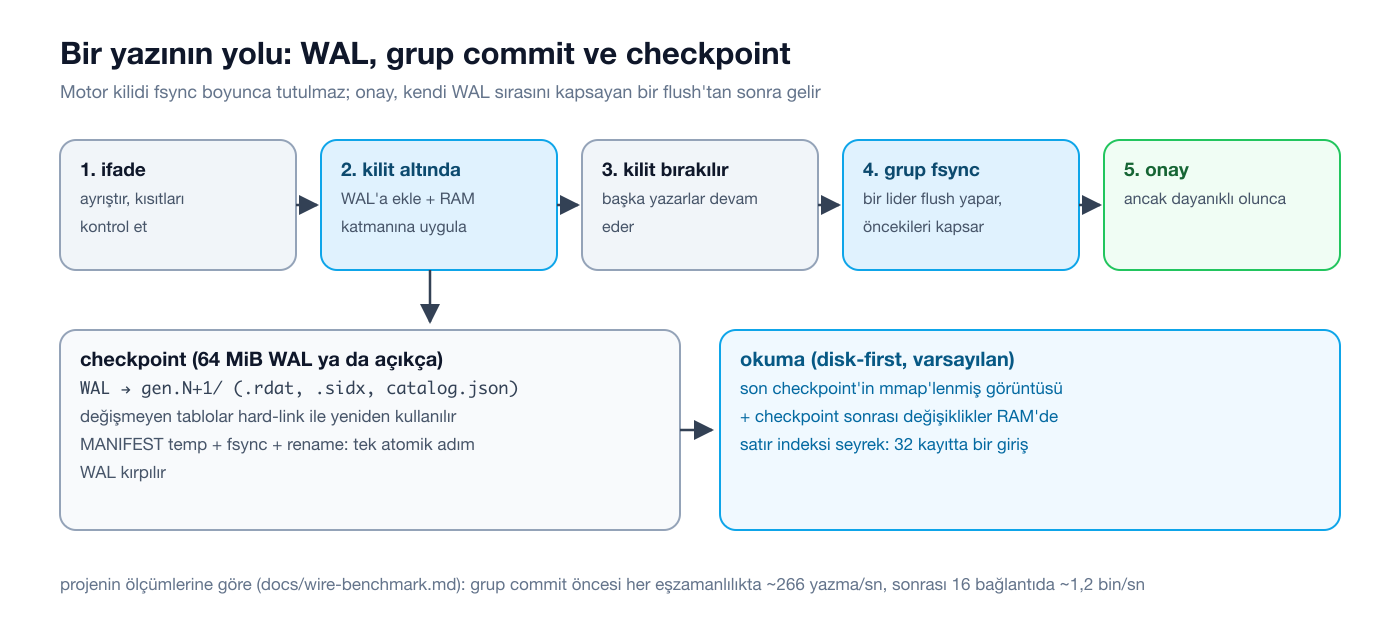
Disk öncelikli (disk-first) mod 0.41.33'ten beri varsayılan. Tablo verisi son checkpoint'in mmap'lenmiş snapshot'ından okunuyor, sadece checkpoint sonrası değişiklikler RAM'de tutuluyor. Satırlar, ikincil indeksler, birincil anahtarlar ve UNIQUE kolonlar hep mmap'lenen dosyalar. Projenin ölçümlerine göre (docs/pg-memory-benchmark.md) 1,2 milyon satırlık bir veritabanı ısınmış halde yaklaşık 39 MB ile çalışıyor. Her şeyi RAM'de tutan resident modda aynı satırlar yaklaşık 370 MB tutuyor. Bedeli taramalarda: disk-first'te her hücre çözülerek okunduğu için taramalar PostgreSQL'in 0,72-0,78 katı hızda, resident modda yaklaşık 1,0 katı. Nokta ve indeksli sorgular iki modda da aynı. Format iki modda da aynı olduğu için bir veritabanı her iki modda da açılabiliyor.
Bellek tarafında beni en çok uğraştıran şey satır ofset indeksi oldu. .rdat içindeki her satırın yerini tutan bu yapı satır başına yaklaşık 33 bayt tutuyordu. 100 milyon satırda 3,1 GB anonim bellek demek. Bunu seyrek (sparse) hale getirdim: 32 kayıtta bir giriş, belirli bir satıra ulaşmak için de kayıt başlıklarında kısa bir yürüme. Sonuç satır başına 0,69 bayt, 100 milyon satırda yaklaşık 69 MB. Sıralı okuyucular bir imleç kullanıp hiç yürümediği için taramalar bundan etkilenmiyor. Diğer iki ayrıntı: ikincil indeksler açılışta değil ilk kullanımda kuruluyor. Checkpoint de son nesilden beri değişmemiş tabloların dosyalarını yeniden yazmak yerine hard-link ile yeni nesle bağlıyor. Bu olmasaydı, ne kadar az şey değişmiş olursa olsun her checkpoint bütün veritabanını yeniden yazacaktı.
Grup commit: eşzamanlı yazarlar WAL flush'ını paylaşıyor. Bir yazım kaydını ekleyip motor kilidi altında uyguluyor, kilidi bırakıyor ve ancak ondan sonra fsync yapıyor. Bir yazar flush'ı yapmak için seçiliyor, o flush başladığında kaydı zaten diskte olan herkes bu flush'la kapsanıyor. Motor kilidi asla bir fsync boyunca tutulmuyor. Onay kuralı değişmedi: bir ifade, ancak kendi WAL sıra numarasını kapsayan bir flush'tan sonra çağırana dönüyor. Yeni olan şey şu: başka bir bağlantı bir yazımı, uygulanması ile flush'ı arasındaki pencerede okuyabiliyor. O pencerede bir çökme bu yazımı kaybettirir, ama yazar zaten hiç onay almamıştır. PostgreSQL'de de aynı pencere var. Projenin ölçümlerine göre (docs/wire-benchmark.md) grup commit öncesi her eşzamanlılık seviyesinde düz ~266 yazma/sn varken, sonrasında 16 bağlantıda ~1,2 bin/sn'ye çıkıyor. Kazanç dört civarı eşzamanlı yazardan sonra başlıyor.
Metadata seviyesinde ALTER TABLE
Bunu kendim ölçmek istedim. psycopg ile 10 bin satırlık 100 çok satırlı INSERT göndererek 1 milyon satırlık bir events tablosu yükledim (yerel Mac'te 4,7 saniye sürdü), sonra \timing açıkken kolon ekleyip çıkardım:
SELECT COUNT(*) FROM events;
  count
---------
 1000000
(1 row)

Time: 13.230 ms
ALTER TABLE events ADD COLUMN region TEXT DEFAULT 'tr';
ALTER TABLE
Time: 3.275 ms
SELECT id, kind, amount, region FROM events WHERE id = 999999;
   id   |  kind  | amount | region
--------+--------+--------+--------
 999999 | refund | 1498.5 | tr
(1 row)

Time: 0.125 ms
ALTER TABLE events DROP COLUMN region;
ALTER TABLE
Time: 4.367 ms
SELECT kind, COUNT(*), SUM(amount) FROM events GROUP BY kind ORDER BY kind;
  kind  | count  |     sum
--------+--------+-------------
 refund | 333333 | 249750499.5
 sale   | 666667 | 499499500.5
(2 rows)

Time: 98.772 ms
Bir milyon satırlık tabloya kolon eklemek 3,3 ms, çıkarmak 4,4 ms sürdü. Bunun sebebi ADD COLUMN ve DROP COLUMN'ın metadata seviyesinde olması, yani tablo büyüklüğünden bağımsız O(1). Katalog fiziksel şemayı saklıyor, yürütücü ise mantıksal bir görünüm görüyor. ADD bir yuva ekliyor ve eski satırlar okunurken yeni kolonun varsayılanıyla dolduruluyor. DROP ise kolonu yerinde bir dropped bayrağıyla mezar taşına çeviriyor (PostgreSQL'in attisdropped'ı gibi). Fiziksel hücre yerinde kalıyor ama okumada dışarıda bırakılıyor. Dayanıklılık için tek bir WAL kaydı yetiyor. Asıl O(n) yeniden yazım, zaten her satırı yeniden yazan bir sonraki checkpoint'e katlanıyor ve alan orada geri kazanılıyor. RENAME COLUMN ve ALTER COLUMN ... TYPE ise hâlâ satırlara dokunuyor. İkincisi önce bütün satırları kuru çalıştırmayla kontrol ediyor.
Çökme kurtarma
Son olarak bir çökme. Bir satır ekledim, sunucuyu kill -9 ile öldürdüm ve yeniden başlattım:
$ psql ... -c "INSERT INTO accounts VALUES (3, 'Kaza Testi', 42.00)"
INSERT 0 1
$ kill -9 $(pgrep oxidb-server)
$ oxidb-server   # restart, WAL replay
$ psql ... -c "SELECT * FROM accounts WHERE id = 3"
 id |   owner    | balance
----+------------+---------
  3 | Kaza Testi |   42.00
(1 row)
Onaylanan yazım WAL'dan geri geldi. Yeniden başlatmadan sonra, 1 milyon satırlık tablo ve açık belge motoruyla süreç yerel Mac'imde yaklaşık 65 MB RSS gösteriyordu.
Yerel protokol: OxiWire
PostgreSQL teli tek yol değil. Yerel OxiWire portunda (uzunluk önekli JSON, MsgPack ya da OxiWire kodlaması) istek zarfına "engine": "sql" eklemek yetiyor. Python standart kütüphanesiyle ham bir istek:
import json, socket, struct

def call(sock, req):
    body = json.dumps(req).encode()
    sock.sendall(struct.pack("<I", len(body)) + body)
    n = struct.unpack("<I", sock.recv(4))[0]
    buf = b""
    while len(buf) < n:
        buf += sock.recv(n - len(buf))
    return json.loads(buf)
{"engine": "sql", "cmd": "sql", "sql": "SELECT c.name, COUNT(*) AS orders FROM customers c JOIN orders o ON o.customer_id = c.id WHERE c.city = $1 GROUP BY c.name ORDER BY c.name", "params": ["İstanbul"]}
{"ok": true, "data": [{"columns": ["name", "orders"], "types": ["TEXT", "INT"], "rows": [["Ayşe", 3], ["Can", 1]]}]}
{"engine": "sql", "cmd": "sql", "sql": "INSERT INTO customers (name, email, city) VALUES (?, ?, ?)", "params": ["Deniz", "deniz@example.com", "Bursa"]}
{"ok": true, "data": [{"affected": 1, "last_insert_id": 9}]}Her ifade için bir sonuç dönüyor. types dizisi statik olarak bilinen kolon tiplerini taşıyor (ADO.NET'in GetFieldType'ı tahmin etmek zorunda kalmasın diye). ? ve $N yer tutucuları ikisi de çalışıyor. İki motorun ayrılığını da aynı soket üzerinde gösterebiliriz. engine alanı olmayan bir istek belge motoruna gidiyor ve customers adında, SQL tablosundan tamamen bağımsız bir koleksiyon oluşturuyor:
{"cmd": "insert", "collection": "customers", "doc": {"name": "doc-world"}}
{"ok": true, "data": {"id": 1}}
{"cmd": "count", "collection": "customers"}
{"ok": true, "data": {"count": 1}}
SQL tablosunda o sırada 5 müşteri var (1, 3, 4, 8 ve 9), koleksiyonda 1 belge. Aynı isim, farklı dünyalar. Python, Go, .NET ve JS istemcilerinde bu zarf bir sql() metodunun arkasında duruyor. HTTP API açıksa aynı motor POST /api/sql üzerinden de erişilebilir.
PostgreSQL tel protokolü: ADR-0023
ADR-0023'ün sorusu şuydu: OxiDB kendi protokolünü bozmadan PostgreSQL v3 protokolünü sunabilir mi, ve ilk sürümün dürüst sınırı nedir? Cevabı ucuzlaştıran üç şey zaten vardı. Dinleyiciler birbirinden bağımsızdı (RESP, MQTT, AMQP, S3 gibi dokuz dinleyici zaten çalışıyordu). SCRAM-SHA-256 sunucu tarafında zaten vardı. Motor da protokolün istediği şekillere zaten sahipti: $N parametreleri, istekler arasında park edilen etkileşimli işlemler, ifade başına bir sonuç ve statik kolon tipleri. Böylece oxidb-server/src/pg/ altında codec, kimlik doğrulama, oturum, katalog, tipler ve hatalar eklendi ve OxiWire yolunda hiçbir şey değişmedi.
İçerideki dört karar ilginç:
- Bir portal Describe ya da Execute'tan hangisi önce gelirse orada bir kez çalışıyor. PostgreSQL bir portalı çalıştırmadan tanımlayabilir. Bu motor ise bir sonucun şeklini ancak onu üreterek biliyor.
Describe'a "henüz bilmiyorum" anlamındaNoDatacevabı vermek psycopg'yi bozuyordu, çünkü psycopg kolon metadata'sını tam oradan okuyor. Bu yüzden portal ilk dokunuşta çalışıp çıktısını tamponluyor,Executede bu tamponu satır sınırına uyarak akıtıyor. Tek görünür fark, bir hatanın bir mesaj önce ortaya çıkması. - Oturum ve katalog ifadeleri motora hiç ulaşmıyor. Her istemcinin konuşmaya başlamadan gönderdiği
SET extra_float_digits = 3,version(),current_database()gibi şeyleripg/catalog.rscevaplıyor.\dtve\lmotorun kendi kataloğundan cevaplanıyor. - Önce SQLSTATE, sonra mesaj. İstemciler metne göre değil koda göre toparlanıyor. Her
SqlErrorvaryantı PostgreSQL'in kullanacağı koda eşleniyor. - pg_catalog çalıştırılmıyor, cevaplanıyor. Tanınan sorgu şekilleri (tip kataloğu, JDBC'nin
DatabaseMetaDataçağrıları,\dt,\lve katalog tablolarının bütün satır okumaları) OxiDB'nin kendi şemasından cevaplanıyor. Geri kalan her şey0A000ile reddediliyor. Boş bir sonuç döndürmek cazip ama yanlış olurdu, çünkü boş sonuç gerçek veri sanılır. Bu teorik bir kaygı değildi: psql'in\d <tablo>sorgusuna tablo listesiyle cevap vermek psql'in beklediği bir kolonda patlamasına yol açmıştı. Ret kuralı tam da bu yüzden yazıldı.
            List of tables
 Schema |    Name     | Type  | Owner
--------+-------------+-------+-------
 public | accounts    | table | admin
 public | customers   | table | admin
 public | employees   | table | admin
 public | events      | table | admin
 public | order_items | table | admin
 public | orders      | table | admin
 public | products    | table | admin
(7 rows)
Dokümantasyonda gerçek sürücülerle doğrulanan istemciler psql 18, psycopg 3.3, Npgsql 8.0, pgjdbc 42.7 (getTables, getColumns, getPrimaryKeys, getImportedKeys gibi DatabaseMetaData çağrıları dahil) ve kendi PostgreSQL sürücüsüyle DBeaver 25.3. ADR'deki en sevdiğim ders şu: hangi sürücünün çalışacağına dair her tahminim, sürücüler gerçekten çalıştırılana kadar yanlıştı. Npgsql'in gözlenen hatası (unsupported sql: function version()) zaten cevaplanan bir ifadeyi işaret ediyordu. Gerçek sebep, araya giren ifadelerle motor ifadelerini karıştıran çok ifadeli bir paketti. Baytları döken bir loglama proxy'si sorunu dakikalar içinde buldu, üzerine düşünmek bulamamıştı.
Bilinçli olarak eksik bırakılanlar da var: COPY, LISTEN/NOTIFY, isimli sunucu tarafı imleçler (DECLARE ... CURSOR), sorgu iptali, gerçek şemalar (public.users ile users aynı tablo), information_schema ve pg_dump. Ayrıca CREATE DATABASE bu porttan değil, yerel porttan çalışıyor.
EF Core: sunucu ve gömülü
.NET tarafında ADR-0013 beş aşamada tam bir EF Core hikayesi kurdu. Önce ifade yüzeyi (CASE, LIKE, EXISTS, CAST, string fonksiyonları), sonra etkileşimli işlemler, sonra bir ADO.NET sağlayıcısı (OxiDb.Data, Dapper uçtan uca çalışıyor), migration'lar için DDL ve tipler, ve en son OxiDb.EntityFrameworkCore. Sağlayıcı migration'ları (Database.Migrate() ve gerçek bir __EFMigrationsHistory tablosu), dotnet ef dbcontext scaffold ile tersine mühendisliği ve ExecuteUpdate/ExecuteDelete'i destekliyor. README'de belgelendiği gibi resmi EF Core ilişkisel spesifikasyon test paketini on iki Northwind paketinin tamamında 3832 testin 3832'sinde geçiyor. Geçmeyen senaryolar test sınıflarında açık override'lar olarak duruyor.
Bunu kendim de denedim. Depodaki 0.44.2 NuGet paketlerine karşı derlenmiş küçük bir .NET 10 konsol uygulaması:
using Microsoft.EntityFrameworkCore;
using OxiDb.EntityFrameworkCore;

var cs = args.Length > 0 ? $"Path={args[0]}" : "Host=127.0.0.1;Port=15400;Database=efshop";

using (var db = new Shop(cs))
{
    db.Database.EnsureCreated();
    var ada = new Author { Name = "Ada" };
    var linus = new Author { Name = "Linus" };
    db.Authors.AddRange(ada, linus);
    db.Posts.AddRange(
        new Post { Title = "SQL engine", Words = 4200, Author = ada },
        new Post { Title = "Time series", Words = 3100, Author = ada },
        new Post { Title = "Ledger", Words = 2800, Author = linus });
    db.SaveChanges();
    Console.WriteLine($"generated keys: ada={ada.Id}, linus={linus.Id}");
}

using (var db = new Shop(cs))
{
    var q = db.Authors
        .Select(a => new { a.Name, Posts = a.Posts.Count, Words = a.Posts.Sum(p => p.Words) })
        .Where(x => x.Words > 1000)
        .OrderByDescending(x => x.Words);
    Console.WriteLine(q.ToQueryString());
    foreach (var row in q) Console.WriteLine($"{row.Name,-6} posts={row.Posts} words={row.Words}");

    var n = db.Posts.Where(p => p.Words < 3000)
        .ExecuteUpdate(s => s.SetProperty(p => p.Words, p => p.Words + 500));
    Console.WriteLine($"ExecuteUpdate touched {n} row(s)");
}

public class Author { public int Id { get; set; } public string Name { get; set; } = ""; public List<Post> Posts { get; set; } = new(); }
public class Post { public int Id { get; set; } public string Title { get; set; } = ""; public int Words { get; set; } public int AuthorId { get; set; } public Author? Author { get; set; } }
public class Shop(string cs) : DbContext
{
    public DbSet<Author> Authors => Set<Author>();
    public DbSet<Post> Posts => Set<Post>();
    protected override void OnConfiguring(DbContextOptionsBuilder o) => o.UseOxiDb(cs);
}
Sunucu modunda (önce yerel porttan CREATE DATABASE efshop ile veritabanını oluşturdum):
connection: Host=127.0.0.1;Port=15400;Database=efshop
generated keys: ada=1, linus=2
SELECT "a"."Name", (
    SELECT COUNT(*)
    FROM "Posts" AS "p1"
    WHERE "a"."Id" = "p1"."AuthorId") AS "Posts", (
    SELECT COALESCE(SUM("p2"."Words"), 0)
    FROM "Posts" AS "p2"
    WHERE "a"."Id" = "p2"."AuthorId") AS "Words"
FROM "Authors" AS "a"
WHERE (
    SELECT COALESCE(SUM("p"."Words"), 0)
    FROM "Posts" AS "p"
    WHERE "a"."Id" = "p"."AuthorId") > 1000
ORDER BY (
    SELECT COALESCE(SUM("p0"."Words"), 0)
    FROM "Posts" AS "p0"
    WHERE "a"."Id" = "p0"."AuthorId") DESC
Ada    posts=2 words=7300
Linus  posts=1 words=2800
ExecuteUpdate touched 1 row(s)
EF'in ürettiği korelasyonlu skaler alt sorgular motorda olduğu gibi çalışıyor. Üretilen anahtarlar RETURNING ile geri okunuyor. EF'in oluşturduğu tablolar da sıradan SQL tabloları, yani aynı veriye psql ile de bakabiliyorum:
    Title    | Words
-------------+-------
 SQL engine  |  4200
 Time series |  3100
 Ledger      |  3300
(3 rows)
Gömülü modda değişen tek şey bağlantı dizesi: UseOxiDb("Path=./embedded-data"). Bütün EF Core yığını sunucu olmadan, SQLite tarzında süreç içinde çalışıyor:
connection: Path=./embedded-data
generated keys: ada=1, linus=2
Ada    posts=2 words=7300
Linus  posts=1 words=2800
ExecuteUpdate touched 0 row(s)
Son satırı açıkça belirtmem gerekiyor: yazı için çalışırken gömülü modda ExecuteUpdate'in etkilenen satır sayısını 0 olarak döndürdüğünü fark ettim. Güncelleme ise gerçekten uygulanıyor (aynı veri dizinini ikinci kez açtığımda Linus'un yazısı 3300 kelimeydi). Yani bu, gömülü yolda etkilenen satır sayısının raporlanmasıyla ilgili bir hata. Sunucu modunda sayı doğru. Bir sonraki sürümde düzelteceğim. Üçüncü bir yol olarak EF Core, değiştirilmemiş Npgsql sağlayıcısıyla PostgreSQL portu üzerinden de çalışıyor (depoda tests/efcore-npgsql-test).
Performans: projenin ölçümleri
Aşağıdaki sayıları ben ölçmedim, projenin kendi benchmark dokümanlarından alıyorum. docs/query-benchmark.md, OxiDB ve PostgreSQL'i aynı veri setiyle (beş ilişkili tabloda 1,2 milyon satır, FK'ler, bileşik birincil anahtarlar, sekiz indeks) karşılaştırıyor. İkisi de PostgreSQL teli konuştuğu için tek bir el yazımı istemci her iki sunucuyu da sürüyor ve her hücreyi çözüyor. Sürücü farkı ya da dil farkı yok. PostgreSQL ANALYZE sonrası stok ayarlarla çalışıyor ve cevapların aynı olduğu ölçümden önce kontrol ediliyor.
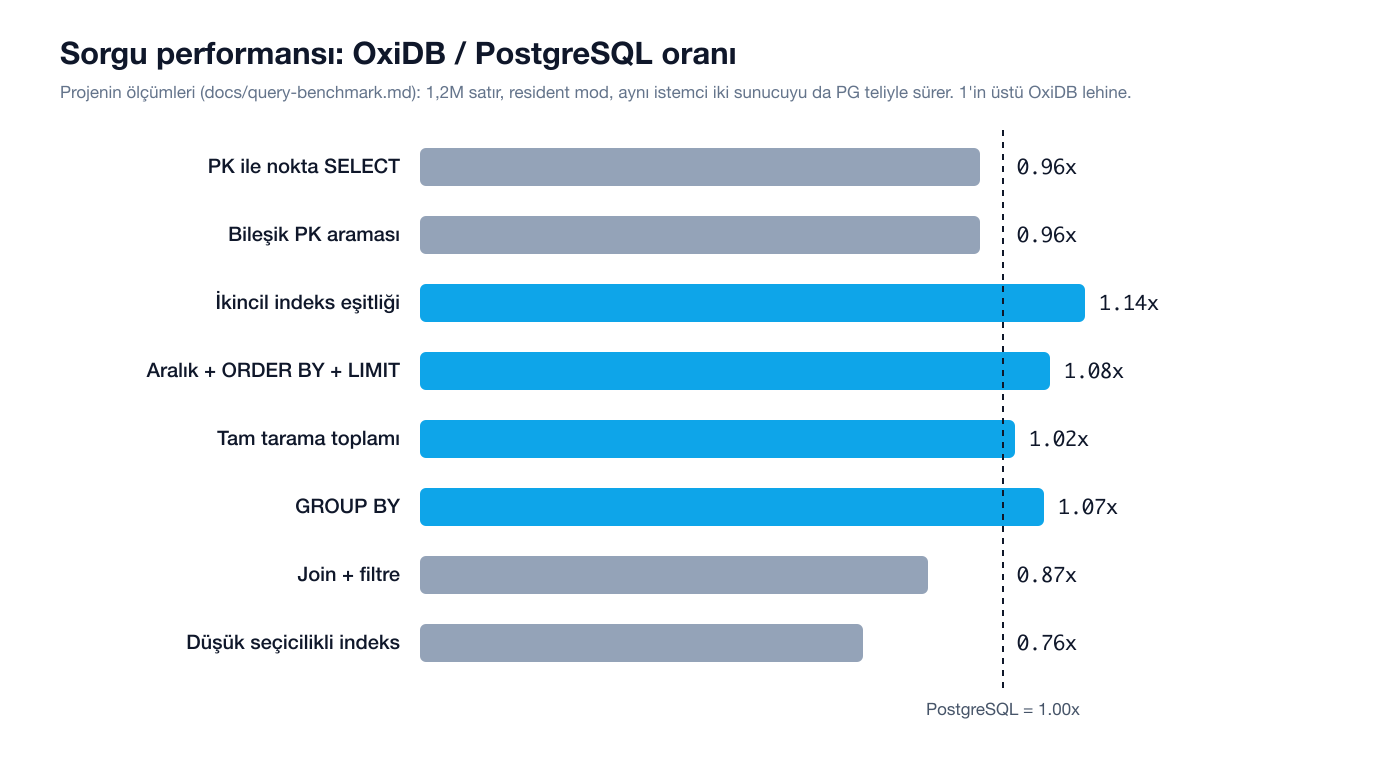
Bu tablo resident modda ölçülmüş. Disk-first'te nokta ve indeksli sorgular aynı kalıyor, taramalar ise yukarıda anlattığım gibi 0,72-0,78 kata düşüyor. Dokümanın en değerli kısmı bence "neyin hâlâ kaybettiği ve nedeni" bölümü. Join'ler 0,56 kattan 0,87 kata çıktı, ama oraya giden yolda iki ölçülmüş başarısızlık var. Index-nested-loop eşiğini yükseltmek oranı 0,29'a düşürdü. Bariz BTreeSet üyelik testi 0,22'ye düşürdü. Sonunda tam sayı anahtar aralığı üzerinde doğrudan adreslenen bir bitmap, bir satırı kurmaktan ucuz hale geldi. İlk akışlı toplama denemesi de indeksi atlıyordu ve count(*) WHERE customer_id = ? sorgusunu 25 µs'lik bir aramadan 4 ms'lik tam taramaya çevirmişti. Benchmark bunu hemen yakaladı.
docs/sql-statement-benchmark.md ise motoru çoğu istemcinin kullandığı ayrıntıda, yani istek başına bir ifadeyle ölçüyor ve bulunan altı darboğazı anlatıyor: boyutuyla büyüyen işlem maliyeti, işlem içindeki aramaların bütün tamponu döndürmesi, join'in sürücü tablosunun indeksini görmezden gelmesi gibi.
Sınırlar ve dürüst ödünleşimler
Bir araya toplarsam:
- İki motora yayılan işlem yok. Belge ve SQL yazımları ayrı ayrı atomik (ADR-0011 ertelendi).
- Bazı kısıtlar uygulanmıyor:
CREATE UNIQUE INDEX'in tekliği, çok kolonlu tabloUNIQUE'i, çok kolonlu FK'ler,ON UPDATEeylemleri.CHECKreddediliyor.ALTER TABLE ... ADD/DROP CONSTRAINTyok. - Sorgu boşlukları: açık pencere çerçeveleri,
GROUPING SETS/ROLLUP/CUBE,MERGE,TRUNCATEyok.INSERT ... ON CONFLICTayrıştırılıyor ama çakışma kısmı yok sayılıyor. Yazı için denerkenINSERT ... SELECT'in de desteklenmediğini gördüm (unsupported sql: INSERT ... SELECT). Milyon satırı bu yüzden çok satırlı INSERT'lerle yükledim. - Kendine referans veren FK aynı çok satırlı INSERT içinde ebeveyn ve çocuğu kabul etmiyor.
- İşlem modeli: tam MVCC değil. Teklik commit anında yeniden kontrol ediliyor ve çakışan commit reddediliyor. Kümede bu yeniden kontrol yapılmıyor, çünkü çoğaltılan bir commit zaten küme tarafından kabul edilmiş durumda.
ALTER TABLE, görünüm ve prosedür DDL'i işlem içinde çalışmıyor. - PostgreSQL teli: keyfi
pg_catalogsorguları,\d <tablo>,COPY,LISTEN/NOTIFY, isimli imleçler vepg_dumpyok. Dinleyici küme modunda başlatılmıyor. - Cobra prosedürleri
DECIMAL'iDOUBLEolarak görüyor. - Disk-first taramalarda resident moddan yaklaşık %30 yavaş. Taramaya ağır bir analitik iş yükünde, veri RAM'e rahatça sığıyorsa
OXIDB_SQL_DISK_FIRST=0doğru seçim.
Küme modunda ise SQL yazımları Raft üzerinden çoğaltılıyor: SQL metni ve parametreler Raft günlüğüne ekleniyor ve her düğümde yeniden çalıştırılıyor. Etkileşimli bir işlemin tek başına gelen COMMIT'i, tamponlanmış yazımları tek bir atomik girdi olarak çoğaltıyor.
OxiDB'nin geri kalanıyla ilişkisi
SQL motoru OxiDB'de bir "ya o ya bu" seçimi değil. Aynı sunucuda belgeler, zaman serileri, OxiMem anahtar-değer deposu, S3 ve mesajlaşma yüzeyleri çalışırken, ilişkisel olması gereken veri kendi dosyalarında, kendi kurallarıyla duruyor. Aynı kimlik doğrulama (SCRAM, roller, veritabanı bazında yetkiler) ve aynı çoklu veritabanı modeli (ADR-0012) her iki motorda geçerli: her veritabanının kendi SQL motoru var ve iki port da aynı veriyi görüyor. Sadece SQL'e ihtiyacınız varsa OXIDB_DOC=0 ile belge motorunu tamamen kapatıp küçük bir PostgreSQL uyumlu sunucu olarak da çalıştırabilirsiniz.
Denemek için
OxiDB'yi GitHub sürümlerinden hazır binary olarak indirebilir, Docker imajıyla çalıştırabilir ya da Rust workspace'inden derleyebilirsiniz. En kısa yol:
OXIDB_SQL=1 OXIDB_PG_PORT=5432 oxidb-server
psql -h 127.0.0.1 -p 5432 -U admin -d oxidb
Bundan sonra elinizdeki herhangi bir PostgreSQL istemcisini deneyin. Çalışmayan bir şey olursa sunucu logundaki [pg] refused catalog query: ... satırı tam olarak bana göndermeniz gereken şey. Serinin bir sonraki yazısında zaman serisi motoruna geçiyorum.