OxiDB doküman motoru: şemasız koleksiyonlar, planlayıcı ve üç aşamalı commit
OxiDB'nin çekirdeğindeki doküman motoru: MongoDB tarzı sorgular ve aggregation, index'ler ve planlayıcı, disk-first depolama, WAL, OCC transaction'lar ve okuma snapshot'ları. Hepsi gerçek bir sunucuda çalıştırılmış örneklerle.
OxiDB'yi yazmaya bir doküman veritabanı olarak başladım. Bugün aynı süreçte SQL tabloları, zaman serileri, Redis uyumlu bir anahtar-değer deposu, S3, MQTT ve AMQP de var. Ama hepsinin altında hâlâ ilk yazdığım parça duruyor: şemasız JSON koleksiyonları, MongoDB tarzı sorgular ve bir aggregation pipeline. Bu yazı o çekirdeği anlatıyor. Nasıl açılır, hangi sorguları ve güncellemeleri anlar, pipeline'da neler var, index'ler ve planlayıcı nasıl karar verir. Bir de işin içi var: belgeler diskte nasıl durur, WAL ne zaman fsync edilir, bir transaction tam olarak hangi anda "commit edilmiş" sayılır, okuma snapshot'ları yazma yolunu neden hiç değiştirmez. Gösterdiğim her çıktıyı yerel bir OxiDB 0.44.2 sunucusunda (Apple M4 Mac) kendim çalıştırdım. Uydurma sayı yok.
Seri boyunca her motoru ayrı yazıda ele alıyorum. Tam metin ve vektör arama ile coğrafi ve graf sorguları da doküman motorunun üstünde çalışıyor, ama onların kendi yazıları var: tam metin ve vektör arama, coğrafi ve graf sorguları.
Doküman motoru ne işe yarar
Doküman motoru, verisinin şekli zamanla değişen uygulamalar için var. Bir ürün kataloğunda bir üründe specs.switch alanı olur, ötekinde reviews dizisi olur. Bir sipariş belgesi bugün beş alan taşır, altı ay sonra yedi. İlişkisel bir tabloda bu, her seferinde bir migration demek. Burada ise koleksiyon ilk insert'te kendiliğinden oluşur ve her belge kendi alanlarını taşır.
Doküman motoru OxiDB'de varsayılan olarak açıktır. Başka hiçbir motoru açmadan sunucuyu başlatırsanız elinizde yalnızca o vardır. SQL motoru ise ayrı dosyalarla ayrı bir motordur (SQL motoru yazısı). Bir koleksiyon adıyla bir tablo adı hiçbir zaman çakışmaz.
Çalıştırmak
Tek ikili dosya, yapılandırma yok:
OXIDB_ADDR=127.0.0.1:15100 \
OXIDB_DATA=./data \
OXIDB_HTTP_PORT=15106 \
OXIDB_WS_PORT=15107 \
./oxidb-server --verbose
Açılışta sunucu ne yaptığını açıkça söylüyor:
[verbose] opening database at ./data/oxidb
[verbose] blob store opened
[verbose] FTS index loaded
TTL eviction: enabled (interval=1000ms)
oxidb-server listening on 127.0.0.1:15100 (pool_size=4, data_dir=./data, idle_timeout=0s)
REST HTTP API listening on 0.0.0.0:15106
WebSocket API listening on 0.0.0.0:15107
Bu kısaltılmış log'da görünmeyen bir satır daha var: sunucu "lazy sync" kapalı olduğunu, yani her commit'in fsync edildiğini (katı mod) açılışta ayrıca yazıyor.
Yerel wire protokolü basit: 4 baytlık little-endian uzunluk, ardından bir JSON nesnesi. Her isteğin bir cmd alanı var, her yanıt {"ok": true, "data": ...} ya da {"ok": false, "error": "..."} şeklinde. Yazıdaki bütün örnekleri şu birkaç satırlık Python istemcisiyle çalıştırdım. Hiçbir kütüphane gerekmiyor:
import socket, struct, json

class Ox:
    def __init__(self, port=15100):
        self.s = socket.create_connection(("127.0.0.1", port))

    def __call__(self, req):
        b = json.dumps(req).encode()
        self.s.sendall(struct.pack("<I", len(b)) + b)
        n = struct.unpack("<I", self._read(4))[0]
        return json.loads(self._read(n))

    def _read(self, n):
        d = b""
        while len(d) < n:
            d += self.s.recv(n - len(d))
        return d
Python, Go, .NET, JS/TS, Java, Julia ve Swift için hazır istemciler de var. Ayrıca kompakt ikili bir çerçeve olan OxiWire, REST ve WebSocket yüzeyleri de var. Hepsi aynı istek şeklini konuşuyor.
Veri modeli: şemasız koleksiyonlar
Bir belge eklemek için koleksiyonu önceden yaratmak gerekmiyor:
> {"cmd": "insert", "collection": "products", "doc": {"sku": "KB-01", "name": "Mechanical keyboard", "price": 89, "tags": ["usb", "rgb"], "stock": {"ist": 12, "ank": 0}, "specs": {"switch": "brown", "layout": "TR-Q"}}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "insert_many", "collection": "products", "docs": [{"sku": "MS-02", ...}, {"sku": "MN-27", ...}, {"sku": "CB-10", ...}, {"sku": "HD-05", ...}]}
< {"ok": true, "data": [2, 3, 4, 5]}
(İkinci istekteki ... kısaltma bana ait. Belgelerin tamamı aşağıdaki sorgu çıktılarında görünüyor.)
Her belgeye iki sistem alanı ekleniyor. _id, koleksiyon içinde artan bir tam sayı. _version ise her yazmada bir artıyor. _version sadece bilgi olsun diye orada durmuyor, iyimser transaction'ların bütün doğrulaması bu sayıya dayanıyor. Aşağıda ona döneceğim. İç içe alanlara nokta gösterimiyle (stock.ank, specs.switch) hem sorguda hem güncellemede erişiliyor.
Belgeler diskte JSON metni olarak değil, ikili JSONB biçiminde saklanıyor. JSONB, tek bir üst seviye alanı belgenin tamamını çözmeden okumaya izin veriyor. Planlayıcı ve index'ler bundan faydalanıyor.
Sorgular
Sorgu dili MongoDB'ninkine bilerek çok yakın: $eq $ne $gt $gte $lt $lte $in $nin $exists $regex $elemMatch $all $size $not $type $mod $and $or $nor $expr. find ayrıca sort, skip ve limit alıyor.
> {"cmd": "find", "collection": "products", "query": {"stock.ank": {"$gt": 0}, "discontinued": {"$exists": false}}, "sort": {"price": 1}, "limit": 2}
< {"ok": true, "data": [{"sku": "CB-10", "name": "USB-C cable", "price": 9, "tags": ["usb-c"], "stock": {"ist": 200, "ank": 120}, "_id": 4, "_version": 1}, {"sku": "MS-02", "name": "Wireless mouse", "price": 29, "tags": ["bluetooth"], "stock": {"ist": 40, "ank": 15}, "_id": 2, "_version": 1}]}
Dizi içindeki nesneler için $elemMatch, düzenli ifadeler için $regex, aynı belgedeki iki alanı karşılaştırmak için $expr:
> {"cmd": "find", "collection": "products", "query": {"reviews": {"$elemMatch": {"stars": {"$gte": 5}}}}}
< {"ok": true, "data": [{"sku": "MN-27", "name": "27 inch monitor", "price": 249, "tags": ["usb-c", "hdr"], "stock": {"ist": 3, "ank": 7}, "reviews": [{"by": "ayse", "stars": 5}, {"by": "mert", "stars": 3}], "_id": 3, "_version": 1}]}
> {"cmd": "find", "collection": "products", "query": {"$or": [{"name": {"$regex": "^usb", "$options": "i"}}, {"tags": {"$all": ["usb", "bluetooth"]}}]}}
< {"ok": true, "data": [{"sku": "CB-10", ...}, {"sku": "HD-05", ...}]}
> {"cmd": "find", "collection": "products", "query": {"$expr": {"$gt": ["$stock.ank", "$stock.ist"]}}}
< {"ok": true, "data": [{"sku": "MN-27", "name": "27 inch monitor", ...}]}
Bu örnekleri hazırlarken MongoDB'den gelen birini şaşırtacak bir farka denk geldim, saklamak istemiyorum. MongoDB'de {"tags": "usb"} sorgusu, tags dizisinde "usb" geçen her belgeyle eşleşir. OxiDB 0.44.2'de skaler eşitlik alanın değerinin tamamıyla karşılaştırılıyor. Yani bir dizinin elemanlarına bakmıyor:
> {"cmd": "count", "collection": "products", "query": {"tags": "usb"}}
< {"ok": true, "data": {"count": 0}}
> {"cmd": "count", "collection": "products", "query": {"tags": {"$all": ["usb"]}}}
< {"ok": true, "data": {"count": 2}}
Dizide eleman aramak için $all ya da $elemMatch kullanmak gerekiyor. Kodda (src/query.rs, eval_field_op) bu bilinçli bir dal değil, dizi semantiğinin henüz eşitliğe taşınmamış hâli. Listemde duruyor.
Güncellemeler
Güncelleme operatörleri: $set $unset $inc $mul $min $max $rename $currentDate, dizi tarafında $push ($each ve $slice ile) $pull $addToSet $pop. Bir istekte birden fazla operatör birlikte kullanılabiliyor ve bir belgeye uygulanan güncelleme atomik:
> {"cmd": "update_one", "collection": "products", "query": {"sku": "KB-01"}, "update": {"$inc": {"stock.ank": 5}, "$push": {"tags": "hot-swap"}, "$set": {"specs.switch": "red"}, "$currentDate": {"updated_at": true}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "update", "collection": "products", "query": {"tags": {"$all": ["usb-c"]}}, "update": {"$mul": {"price": 0.9}, "$addToSet": {"tags": "sale"}}}
< {"ok": true, "data": {"modified": 2}}
> {"cmd": "update_one", "collection": "products", "query": {"sku": "HD-05"}, "update": {"$rename": {"discontinued": "archived"}, "$pull": {"tags": "usb"}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "find", "collection": "products", "query": {"sku": {"$in": ["KB-01", "MN-27", "HD-05"]}}, "sort": {"sku": 1}}
< {"ok": true, "data": [
    {"sku": "HD-05", "name": "Headset", "price": 59, "tags": ["bluetooth"], "_version": 2, "_id": 5, "archived": true},
    {"sku": "KB-01", "name": "Mechanical keyboard", "price": 89, "tags": ["usb", "rgb", "hot-swap"], "stock": {"ist": 12, "ank": 5}, "specs": {"switch": "red", "layout": "TR-Q"}, "_id": 1, "_version": 2, "updated_at": "2026-10-11T21:34:50.373050+00:00"},
    {"sku": "MN-27", "name": "27 inch monitor", "price": 224.1, "tags": ["usb-c", "hdr", "sale"], ..., "_id": 3, "_version": 2}]}
Sayaç gibi çok çekişilen tek belgeler için find_and_modify var. Transaction'a girmeden atomik olarak günceller ve belgenin yeni hâlini döndürür:
> {"cmd": "find_and_modify", "collection": "counters", "query": {"_name": "invoice"}, "update": {"$inc": {"seq": 1}}}
< {"ok": true, "data": {"_name": "invoice", "seq": 1001, "_id": 1, "_version": 2}}
Aggregation pipeline
Pipeline'ı daha büyük bir veri üzerinde göstermek için 500 müşteri ve 20.000 sipariş yükledim. Siparişlerin alanları order_no, customer ("c1"..."c500"), status (paid, shipped, cancelled), amount, items ve created (2026'nın ilk yarısından ISO tarihleri). Tek bir insert_many çağrısı 5.000 belgeyi taşıyor ve 20.000 belgenin yüklenmesi 0,17 saniye sürdü.
Desteklenen aşamalar: $match $group $sort $skip $limit $project $count $unwind $addFields $lookup $facet $replaceRoot $out $setWindowFields $dateHistogram $ohlcv $densify $fill. Bunlara bir de $geoNear, $graphLookup ve $shortestPath ekleniyor, onları coğrafi ve graf yazısında anlatıyorum. $group akümülatörleri $sum $avg $min $max $count $first $last $push $addToSet $percentile.
$group ve $lookup
En çok harcayan üç müşteri, müşteri koleksiyonuyla birleştirilmiş hâliyle:
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"status": "paid"}},
    {"$group": {"_id": "$customer", "spent": {"$sum": "$amount"}, "orders": {"$sum": 1}}},
    {"$sort": {"spent": -1}}, {"$limit": 3},
    {"$lookup": {"from": "customers", "localField": "_id", "foreignField": "code", "as": "c"}},
    {"$unwind": "$c"},
    {"$project": {"_id": 0, "customer": "$_id", "name": "$c.name", "region": "$c.region", "spent": 1, "orders": 1}}]}
< {"ok": true, "data": [{"customer": "c77", "name": "Customer 77", "region": "Izmir", "spent": 10331, "orders": 39}, {"customer": "c57", "name": "Customer 57", "region": "Antalya", "spent": 10303, "orders": 35}, {"customer": "c497", "name": "Customer 497", "region": "Istanbul", "spent": 10279, "orders": 34}]}
$lookup yabancı koleksiyonda normal bir find çalıştırıyor. Bu yüzden foreignField üzerinde bir index varsa (burada customers.code için unique index var) her birleştirme bir index araması oluyor. localFields ve foreignFields dizileriyle birden çok alan üzerinden birleştirme de yapılabiliyor.
$facet
$facet aynı girdi üzerinde birkaç bağımsız alt pipeline'ı tek geçişte çalıştırıyor. Bir panodaki üç kutuyu üç ayrı taramayla değil, tek sorguyla dolduruyor:
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"created": {"$gte": "2026-06-01", "$lt": "2026-07-01"}}},
    {"$facet": {
      "byStatus": [{"$group": {"_id": "$status", "n": {"$sum": 1}}}, {"$sort": {"n": -1}}],
      "bigTicket": [{"$match": {"amount": {"$gte": 495}}}, {"$count": "n"}],
      "avgBasket": [{"$group": {"_id": null, "avgItems": {"$avg": "$items"}, "maxAmount": {"$max": "$amount"}}}]}}]}
< {"ok": true, "data": [{"byStatus": [{"_id": "paid", "n": 1935}, {"_id": "shipped", "n": 945}, {"_id": "cancelled", "n": 345}], "bigTicket": [{"n": 40}], "avgBasket": [{"_id": null, "avgItems": 3.494263565891473, "maxAmount": 500}]}]}
Alt pipeline'lar bellekteki ortak bir belge kümesi üzerinde çalışıyor, bu yüzden içlerinde $facet ya da $out kullanılamıyor (MongoDB'de de öyle). Bir şey daha: tarih karşılaştırması burada düz string karşılaştırması değil. Index'ler ISO 8601 görünümlü string'leri epoch milisaniye olarak saklıyor, aralık sorguları da tarih sırasıyla çalışıyor.
$setWindowFields
Pencere fonksiyonları satırları $group gibi tek satıra indirmeden, komşu belgelerden değer hesaplıyor. Bir müşterinin ilk beş siparişinde koşan toplam, son üç siparişin ortalaması ve bir önceki tutar:
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"customer": "c42"}}, {"$sort": {"created": 1}}, {"$limit": 5},
    {"$setWindowFields": {"partitionBy": "$customer", "sortBy": {"created": 1}, "output": {
       "running": {"$sum": "$amount", "window": {"documents": ["unbounded", "current"]}},
       "avg3": {"$avg": "$amount", "window": {"documents": [-2, 0]}},
       "prev": {"$shift": {"output": "$amount", "by": -1, "default": 0}}}}},
    {"$project": {"_id": 0, "created": 1, "amount": 1, "running": 1, "avg3": 1, "prev": 1}}]}
< {"ok": true, "data": [
    {"created": "2026-01-10T02:27:44Z", "amount": 443, "running": 443, "avg3": 443, "prev": 0},
    {"created": "2026-01-15T13:47:23Z", "amount": 421, "running": 864, "avg3": 432, "prev": 443},
    {"created": "2026-01-17T22:53:17Z", "amount": 464, "running": 1328, "avg3": 442.6666666666667, "prev": 421},
    {"created": "2026-02-06T17:02:43Z", "amount": 217, "running": 1545, "avg3": 367.3333333333333, "prev": 464},
    {"created": "2026-02-06T20:34:44Z", "amount": 313, "running": 1858, "avg3": 331.3333333333333, "prev": 217}]}
Belge pencerelerinin yanında range pencereleri de var. window: {"range": [-5, 0], "unit": "minute"} "son 5 belge" değil, gerçekten "son 5 dakika" demek. $rank, $denseRank ve $documentNumber da destekleniyor.
Zaman şekilli veri: $dateHistogram, $ohlcv, $densify, $fill
Bu dört aşamayı, ayrı bir zaman serisi motoruna ihtiyaç duymadan doküman koleksiyonlarında zamana göre analiz yapabilmek için ekledim. (Sıkıştırılmış, saklama süreli ciddi seriler için zaman serisi motoru var.)
$dateHistogram belgeleri takvim aralıklarına bölüyor. min_doc_count: 0 verilirse boş aralıkları sıfır sayıyla dolduruyor, grafik çizerken eksik gün kalmıyor:
> {"cmd": "aggregate", "collection": "logins", "pipeline": [{"$dateHistogram": {"field": "at", "interval": "1d", "min_doc_count": 0}}, {"$sort": {"_id": 1}}]}
< {"ok": true, "data": [{"_id": "2026-10-01T00:00:00Z", "count": 2}, {"_id": "2026-10-02T00:00:00Z", "count": 1}, {"_id": "2026-10-03T00:00:00Z", "count": 0}, {"_id": "2026-10-04T00:00:00Z", "count": 0}, {"_id": "2026-10-05T00:00:00Z", "count": 3}]}
$ohlcv alım satım "tick"lerini mum (candle) grafiğine çeviriyor. Girdiyi kendisi zamana göre sıralıyor, symbol ile enstrüman başına bölüyor. fill: "previous" verilirse işlemsiz dakikaya bir önceki kapanış fiyatıyla düz bir mum koyuyor:
> {"cmd": "aggregate", "collection": "ticks", "pipeline": [
    {"$ohlcv": {"time": "ts", "interval": "1m", "price": "price", "volume": "qty", "symbol": "sym", "fill": "previous"}},
    {"$project": {"_id": 0, "time": 1, "open": 1, "high": 1, "low": 1, "close": 1, "volume": 1, "count": 1}}]}
< {"ok": true, "data": [
    {"time": "2026-10-12T09:00:00Z", "open": 10.0, "high": 10.4, "low": 10.0, "close": 10.4, "volume": 150.0, "count": 2},
    {"time": "2026-10-12T09:01:00Z", "open": 10.2, "high": 10.9, "low": 10.2, "close": 10.9, "volume": 90.0, "count": 2},
    {"time": "2026-10-12T09:02:00Z", "open": 10.9, "high": 10.9, "low": 10.9, "close": 10.9, "volume": 0.0, "count": 0},
    {"time": "2026-10-12T09:03:00Z", "open": 10.7, "high": 10.7, "low": 10.7, "close": 10.7, "volume": 40.0, "count": 1}]}
$densify eksik adımları sentetik belgelerle üretiyor, $fill de onları dolduruyor: locf (son değeri taşı), linear (doğrusal ara değer) ya da sabit bir değerle. İki odalı bir sensör örneği:
> {"cmd": "aggregate", "collection": "sensor", "pipeline": [
    {"$densify": {"field": "t", "partitionByFields": ["room"], "range": {"step": 1, "bounds": "partition"}}},
    {"$fill": {"sortBy": {"t": 1}, "partitionBy": "$room", "output": {"temp": {"method": "linear"}}}},
    {"$sort": {"room": 1, "t": 1}}, {"$project": {"_id": 0, "room": 1, "t": 1, "temp": 1}}]}
< {"ok": true, "data": [
    {"room": "depo", "t": 0, "temp": 12.0}, {"room": "depo", "t": 1, "temp": 12.333333333333334},
    {"room": "depo", "t": 2, "temp": 12.666666666666666}, {"room": "depo", "t": 3, "temp": 13.0},
    {"room": "lab", "t": 0, "temp": 20.0}, {"room": "lab", "t": 1, "temp": 21.0},
    {"room": "lab", "t": 2, "temp": 22.166666666666668}, {"room": "lab", "t": 3, "temp": 23.333333333333332},
    {"room": "lab", "t": 4, "temp": 24.5}]}
Burada da kendi hatama düştüm, yazmaya değer. İlk denemede $fill'e $densify'daki gibi "partitionByFields": ["room"] verdim. $fill bu anahtarı tanımıyor, beklediği "partitionBy": "$room". Tanımadığı anahtarı da sessizce yok sayıyor. Sonuç olarak depo odasının boşluğu laboratuvarın sıcaklıklarıyla doldu (depo, t=1, temp=21.0). İki aşamanın bölümleme anahtarlarının farklı olması ve bilinmeyen anahtarın hata vermemesi, düzeltilmesi gereken bir pürüz.
Bu aşamaların bir bütçesi var. $densify ya da $ohlcv belirli bir sayının üstünde belge üretecekse sonucu sessizce kırpmıyor, hata veriyor. Bu bütçeler, $setWindowFields için bir değer bütçesiyle birlikte 0.44.2'deki bir güvenlik turunda geldi.
Index'ler ve planlayıcı
Index türleri
- Alan index'i (
create_index): eşitlik, aralık,$in, sıralama ve sayma için. - Unique index (
create_unique_index): ihlali bir hata olarak reddediyor. - Bileşik index (
create_composite_index): önek (prefix) taramaları ve kapsanan aggregation için. - TTL index (
create_ttl_index): süresi dolan belgeleri arka planda siliyor. - Tam metin ve vektör index'leri: ayrı yazıda.
Index'ler oluşturulduğu anda mevcut verinin üzerinden kendiliğinden dolduruluyor (backfill). Unique ve TTL'nin gerçek davranışı:
> {"cmd": "create_unique_index", "collection": "customers", "field": "code"}
< {"ok": true, "data": "unique index created"}
> {"cmd": "insert", "collection": "customers", "doc": {"code": "c42", "name": "Duplicate"}}
< {"ok": false, "error": "unique constraint violated: field 'code' value already exists"}

> {"cmd": "create_ttl_index", "collection": "sessions", "field": "created_at", "expireAfterSeconds": 2}
< {"ok": true, "data": "ttl index created"}
> {"cmd": "insert", "collection": "sessions", "doc": {"user": "ayse", "created_at": "2026-10-11T21:35:53Z"}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "count", "collection": "sessions"}
< {"ok": true, "data": {"count": 1}}
# 4.5 saniye sonra
> {"cmd": "count", "collection": "sessions"}
< {"ok": true, "data": {"count": 0}}
TTL taraması saniyede bir çalışıyor. Logların saklama süresi de aynı mekanizmayı kullanıyor (log ve alarm yazısı).
explain
Planlayıcının ne yaptığını görmek için explain komutu var. İçine bir find, count ya da aggregate isteği alıyor, planı bildiriyor ve sorguyu gerçekten çalıştırıp süreyi ölçüyor. Planı gerçek sorgu yolunun kullandığı fonksiyonların aynısı hesaplıyor, yani explain'in söylediğiyle motorun yaptığı birbirinden kopamıyor. Index yokken:
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "status": "paid"}}}
< {"ok": true, "data": {"strategy": "COLLSCAN", "index_used": null, "collection_docs": 20000, "candidates": null, "examined": 20000, "returned": 18, "post_filter": true, "post_filter_ops": [], "sort": "none", "duration_ms": 4.715}}customer, status ve created için alan index'leri, [status, amount] için de bileşik bir index oluşturduktan sonra:
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "status": "paid"}}}
< {"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": ["customer", "status"], "collection_docs": 20000, "candidates": 18, "examined": 18, "returned": 18, "post_filter": false, "post_filter_ops": [], "sort": "none", "duration_ms": 0.544}}
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "amount": {"$gt": 400}, "status": {"$ne": "cancelled"}}}}
< {"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": ["customer"], "collection_docs": 20000, "candidates": 34, "examined": 34, "returned": 11, "post_filter": true, "post_filter_ops": ["$ne"], "sort": "none", "duration_ms": 0.015}}
post_filter_ops index'in karşılayamadığı operatörleri listeliyor. $ne, eksik alanlı belgeleri de içermek zorunda olduğu için index'ten cevaplanmıyor. Planlayıcı bu yüzden customer index'iyle 34 adaya iniyor, $ne'yi o 34 belge üzerinde tek tek değerlendiriyor.
Seçicilik ve index kesişimi
Planlayıcı maliyet tahminini index'lerin kendisinden yapıyor. Bir eşitlik için index'teki o anahtarın belge sayısına, bir aralık için aralıktaki sayıya, $in için toplama bakıyor. $and içinde birden fazla index'li koşul varsa en seçici olanı (en az belge döndüreni) yürütücü olarak seçiyor ve tembel olarak geziyor. Diğer index'li koşulların kümeleriyle de kesişim alıyor.
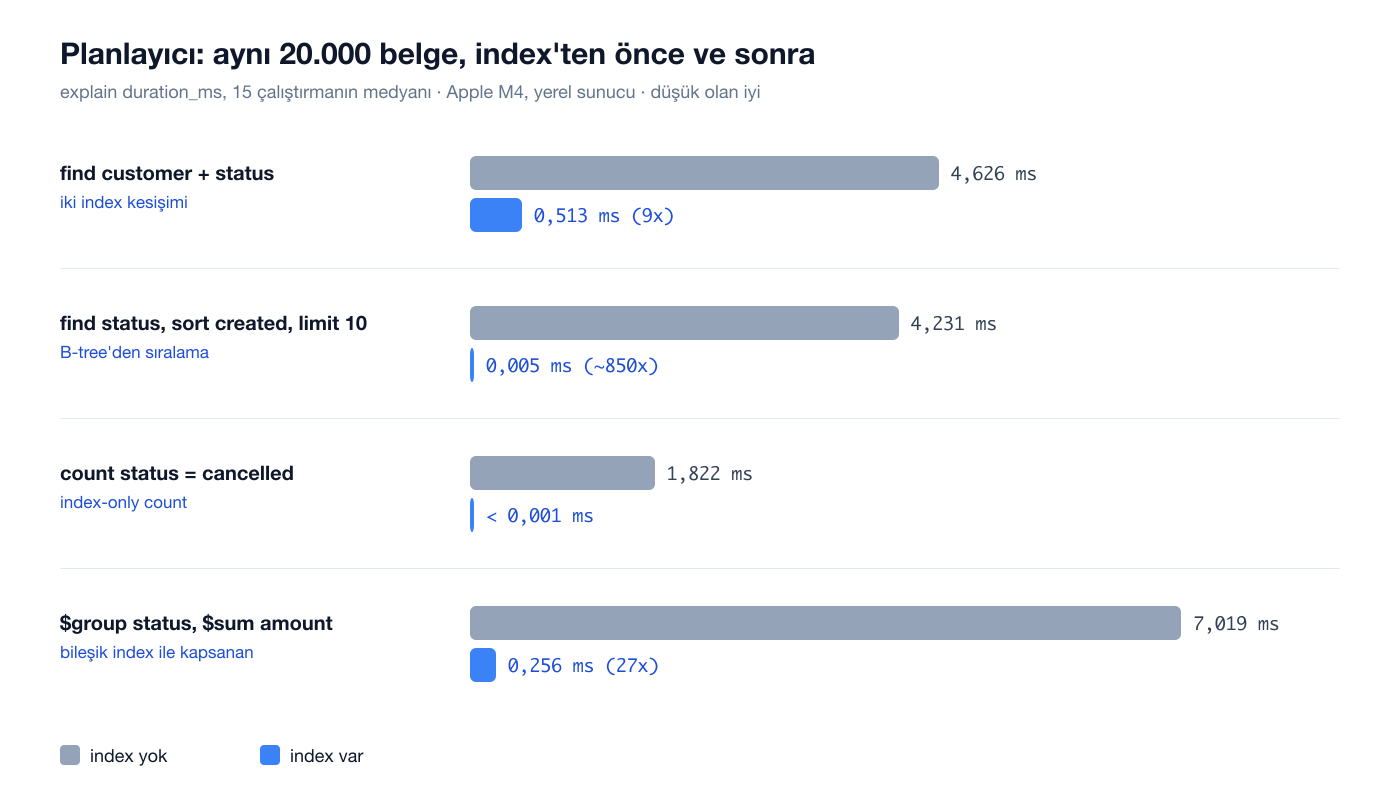
Ölçerken burada beklemediğim bir şey gördüm. Kesişim, diğer koşulların kümelerini önce tamamen üretiyor. status = paid yaklaşık 12.000 belge, bu yüzden kesişim pahalıya patlıyor:
{'customer': 'c42'}                       INDEX_SCAN ['customer']            0.007 ms
{'customer': 'c42', 'status': 'paid'}     INDEX_SCAN ['customer', 'status']  0.554 ms
{'customer': 'c42', 'items': {'$gte': 5}} INDEX_SCAN ['customer']            0.005 ms
(15 çalıştırmanın medyanı.) Seçici olmayan bir alana index koymak burada sorguyu yavaşlatıyor: 34 adayı tek tek filtrelemek, 12.000 kimlikten oluşan bir küme kurmaktan çok daha ucuz. items index'siz olduğu için üçüncü sorgu post-filter'a düşüyor ve en hızlısı oluyor. Daha iyi bir kural, yürütücünün aday sayısı küçükse kesişimden vazgeçmek olur. Bunu yapılacaklar listeme yazdım. Şimdilik pratik öneri şu: düşük kardinaliteli alanlara (durum, bayrak) tek başına index koymak yerine bileşik index'i tercih edin.
B-tree'den sıralama, index-only count, kapsanan $group
Planlayıcının üç kısa yolu var:
- Index'ten sıralama. Sıralama alanında index varsa, motor sonucu sıralamak yerine B-tree'yi sırasıyla geziyor ve
limitdolunca duruyor. Filtrenin kendi index'i yürüyüşten daha ucuz olacaksa planlayıcı bu yolu bırakıyor. explain bu kararı da aynı fonksiyonla soruyor. - Index-only count. Index'li bir eşitlik için
counthiçbir belgeye dokunmadan index'teki sayıyı okuyor. - Kapsanan
$group.[$match?] → $groupşeklindeki bir pipeline'da grup anahtarı ve$sum/$avg/$min/$maxalanlarının hepsi tek bir bileşik index'te varsa, cevap B-tree gezilerek üretiliyor. Her girdide değer çifti ve belge sayısı hazır olduğu içintoplam += değer × sayı. Hiçbir belge okunmuyor ya da çözülmüyor.
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"status": "paid"}, "sort": {"created": -1}, "limit": 10}}
< {"ok": true, "data": {"strategy": "INDEX_SORT", "index_used": "created", "collection_docs": 20000, "candidates": 11949, "examined": 20000, "returned": 10, "post_filter": false, "post_filter_ops": [], "sort": "index-backed", "duration_ms": 0.015}}
> {"cmd": "explain", "inner": {"cmd": "count", "collection": "orders", "query": {"status": "cancelled"}}}
< {"ok": true, "data": {"strategy": "INDEX_ONLY_COUNT", "index_only": true, "post_filter_ops": [], "count": 2037, "duration_ms": 0.0}}(INDEX_SORT'ta examined alanı en kötü durumu gösteriyor. Yürüyüş limit dolunca erken biter.)
Aynı dört sorgunun index'siz ve index'li süreleri:
Kapsanan $group için bir uyarı: index'teki değer tarihe çevrilmiş bir string'se ya da bir dizi/nesne serileştirmesiyse, motor orijinal değeri geri üretemeyeceği için normal yola düşüyor. Bu bir kısa yol, doğruluğu asla değiştirmiyor.
Depolama formatı
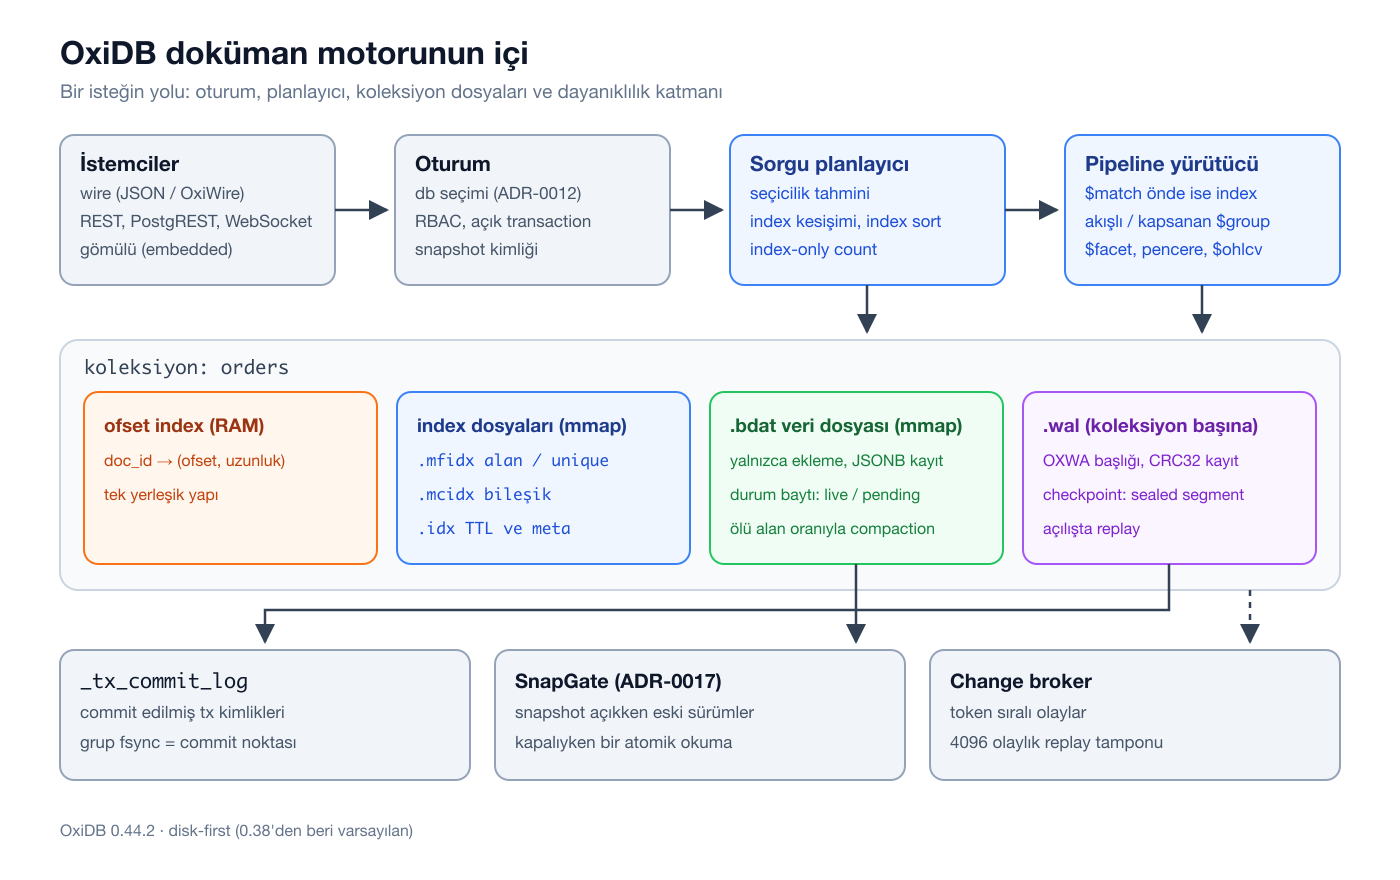
Bir süre öncesine kadar OxiDB aslında disk kalıcılığı olan bir bellek içi veritabanıydı. Her belgenin baytları RAM'de duruyordu, .btree dosyası da periyodik bir anlık görüntüydü. Bir milyon belgelik bir karşılaştırmada bellek, veri büyüklüğüyle doğru orantılı büyüyordu. Bunu ADR-0009 ile "disk-first" moduna çevirdim. 0.38'den beri varsayılan bu:
.bdatveri dosyası. Yalnızca ekleme yapılan ve mmap ile okunan bir dosya. Her kaydın başında bir durum baytı ve uzunluk var. Bir güncelleme yeni kaydı sona ekliyor, eskisini "ölü" işaretliyor.- Ofset index'i. RAM'de kalan tek yapı:
doc_id → (ofset, uzunluk). Belge başına birkaç on bayt tutuyor. ADR-0018 bunu daha da küçültmenin yollarını tartışıyor, ama 100 milyon belgede birkaç GB'lık bir taban olduğunu açıkça kabul ediyor. - Index dosyaları. Alan index'leri
.mfidx, bileşik index'ler.mcidxolarak mmap ile açılıyor. Küçük bir bellek içi yazma katmanının arkasında duruyorlar. Açılışta yeniden kurulmuyor, doğrudan eşleniyorlar. - Compaction. Ölü alan dosyanın en az yarısıysa ve dosya en az 4 MiB ise, bakım iş parçacığı canlı kayıtları yeni bir dosyaya yazıp atomik olarak yer değiştiriyor. Index'ler
doc_idile anahtarlandığı için yeniden index'leme gerekmiyor. - Sıkıştırma isteğe bağlı. Kayıt başına zstd, projenin bir milyon belgelik ölçümlerinde aggregation'ları ve index kurulumunu yaklaşık dört kat yavaşlatıyordu, disk kazancı da küçüktü. Bu yüzden 0.38.9'dan beri varsayılan sıkıştırmasız.
OXIDB_DISK_COMPRESSEDile açılabiliyor.
Koleksiyon başına seçenekler <ad>.bopts dosyasına yazılıyor. Böylece bir koleksiyonun disk formatı ortam değişkenlerinden bağımsız ve kalıcı oluyor. Deneme veritabanımın dizini şöyle görünüyordu:
$ ls -la data/oxidb | awk '{print $5, $9}'
3313100  orders.bdat
130      orders.bopts
659712   orders.created.mfidx
174430   orders.customer.mfidx
160131   orders.status.mfidx
226177   orders.status_amount.mcidx
347      orders.idx
3713108  orders.wal
0        orders.worm
8        _tx_commit_log
...
$ cat data/oxidb/accounts.bopts
{
  "disk_first": true,
  "compress": false,
  "auto_compact": true,
  "compact_min_bytes": 4194304,
  "compact_dead_ratio": 0.5
}(.worm dosyaları belge düzeyinde değiştirilemezlik kilitleri için. Bu yazının konusu değil.)
WAL ve dayanıklılık
Her koleksiyonun kendi .wal dosyası var. Dosya OXWA sihirli baytlarıyla ve bir sürüm numarasıyla başlıyor. Ardından her biri [crc32][uzunluk][yük] şeklinde kayıtlar geliyor. Yükün ilk baytı işlemin türü (insert, update, delete), sonra tx_id, doc_id ve belgenin JSONB baytları. Point-in-time recovery açıksa kayıtlar ayrıca global bir sıra numarası (GSN) ve duvar saati taşıyor. Kurtarma sırasında CRC'si tutmayan ya da yarım kalan son kayıt "yırtık kuyruk" sayılıyor ve okuma orada duruyor. Bir de xxd ile bakalım:
$ xxd data/oxidb/accounts.wal | head -3
00000000: 4f58 5741 0100 0000 c0e1 8f1e 5600 0000  OXWA........V...
00000010: 0100 0000 0000 0000 0001 0000 0000 0000  ................
00000020: 0040 0000 0410 0000 0310 0000 0810 0000  .@..............
Varsayılan mod katı: her commit, istemciye "tamam" denmeden önce fsync ediliyor. Checkpoint çevrimiçi yapılıyor ve WAL'ı kesmek yerine mühürlüyor (seal). Canlı dosya bir segment olarak yeniden adlandırılıyor, yeni bir WAL başlıyor. Böylece bir checkpoint hiçbir zaman bir yazıcıyla yarışmıyor.
Bunu kendim de denedim. Bir transaction ile iki koleksiyona yazdım, ardından tek bir auto-commit yazma yaptım. Sonra sunucuyu hiçbir kapanma şansı tanımadan kill -9 ile öldürüp yeniden başlattım:
$ python3 crash.py write
> {"cmd": "begin_tx"}
< {"ok": true, "data": {"tx_id": 7}}
> {"cmd": "insert", "collection": "ledger", "doc": {"entry": "debit", "account": "alice", "amount": 250}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "insert", "collection": "ledger_audit", "doc": {"entry": "credit", "account": "bob", "amount": 250}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
> {"cmd": "insert", "collection": "ledger", "doc": {"entry": "note", "text": "auto-commit write"}}
< {"ok": true, "data": {"id": 2}}
$ kill -9 $(cat server.pid)   # hemen, kapanış yok
$ ./start.sh
$ python3 crash.py read
> {"cmd": "find", "collection": "ledger", "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 1, "account": "alice", "amount": 250, "entry": "debit"}, {"_id": 2, "_version": 1, "entry": "note", "text": "auto-commit write"}]}
> {"cmd": "find", "collection": "ledger_audit", "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 1, "account": "bob", "amount": 250, "entry": "credit"}]}
Tek bir kill hiçbir şeyi kanıtlamaz, bunun farkındayım. Asıl güvence depodaki çökme testlerinde: belirli byte ofsetlerinde öldürme matrisleri, commit ortasında süreci öldüren ve paranın korunduğunu kontrol eden Jepsen tarzı bir banka testi, fsync hata enjeksiyonu. Bu testler cargo test -- --ignored ile çalışıyor. Dürüst olmak gerekirse, bu testler bana birkaç kez haksız olduğumu gösterdi. 0.40'ta iki koleksiyonlu bir transaction'ın çökme sonrası yarım geri gelebildiği bir hata buldular. Disk-first modda bir kayıt, commit işareti dayanıklı hâle gelmeden veri dosyasına ulaşıyordu ve açılıştaki yeniden kurulum onu canlı sanıyordu. 0.44.2'de ise bir depolama denetimi, onaylanmış bir yazmanın kaybolabileceği beş ayrı kurtarma yolu daha buldu ve kapattı. Bu yüzden aşağıdaki "pending kayıt" mekanizması var.
Transaction'lar: OCC ve üç aşamalı commit
Transaction'lar birden fazla belgeyi ve birden fazla koleksiyonu kapsayabiliyor. Model iyimser eşzamanlılık (OCC). begin_tx'ten sonra bağlantıdaki yazmalar sunucuda tamponlanıyor ("buffered"). Okunan her belge, okunduğu andaki _version ile bir okuma kümesine kaydediliyor. Commit anında küme doğrulanıyor:
> {"cmd": "begin_tx"}
< {"ok": true, "data": {"tx_id": 1}}
> {"cmd": "update", "collection": "accounts", "query": {"name": "alice"}, "update": {"$inc": {"balance": -30}}}
< {"ok": true, "data": "buffered"}
> {"cmd": "update", "collection": "accounts", "query": {"name": "bob"}, "update": {"$inc": {"balance": 30}}}
< {"ok": true, "data": "buffered"}
# başka bir bağlantıdan, commit'ten önce:
> {"cmd": "find", "collection": "accounts", "query": {}}
< {"ok": true, "data": [{"name": "alice", "balance": 100, "_id": 1, "_version": 1}, {"name": "bob", "balance": 50, "_id": 2, "_version": 1}]}
> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
# commit'ten sonra:
< {"ok": true, "data": [{"name": "alice", "balance": 70, "_id": 1, "_version": 2}, {"name": "bob", "balance": 80, "_id": 2, "_version": 2}]}
İki transaction aynı belgeyi okuyup yazmaya kalkarsa, ikinci commit eden çakışmayı öğreniyor:
A> {"cmd": "begin_tx"}                     B> {"cmd": "begin_tx"}
A> find alice  → balance 70, _version 2    B> find alice → balance 70, _version 2
A> update alice $inc -50  → "buffered"     B> update alice $inc -60 → "buffered"
A> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
B> {"cmd": "commit_tx"}
< {"ok": false, "error": "transaction conflict on 'accounts' doc 1: expected version 2, found 3"}
(Bu blok, iki bağlantının sırasını göstermek için gerçek çıktıdan derlendi. Hata mesajı aynen sunucunun.)
Commit'in içi şöyle:
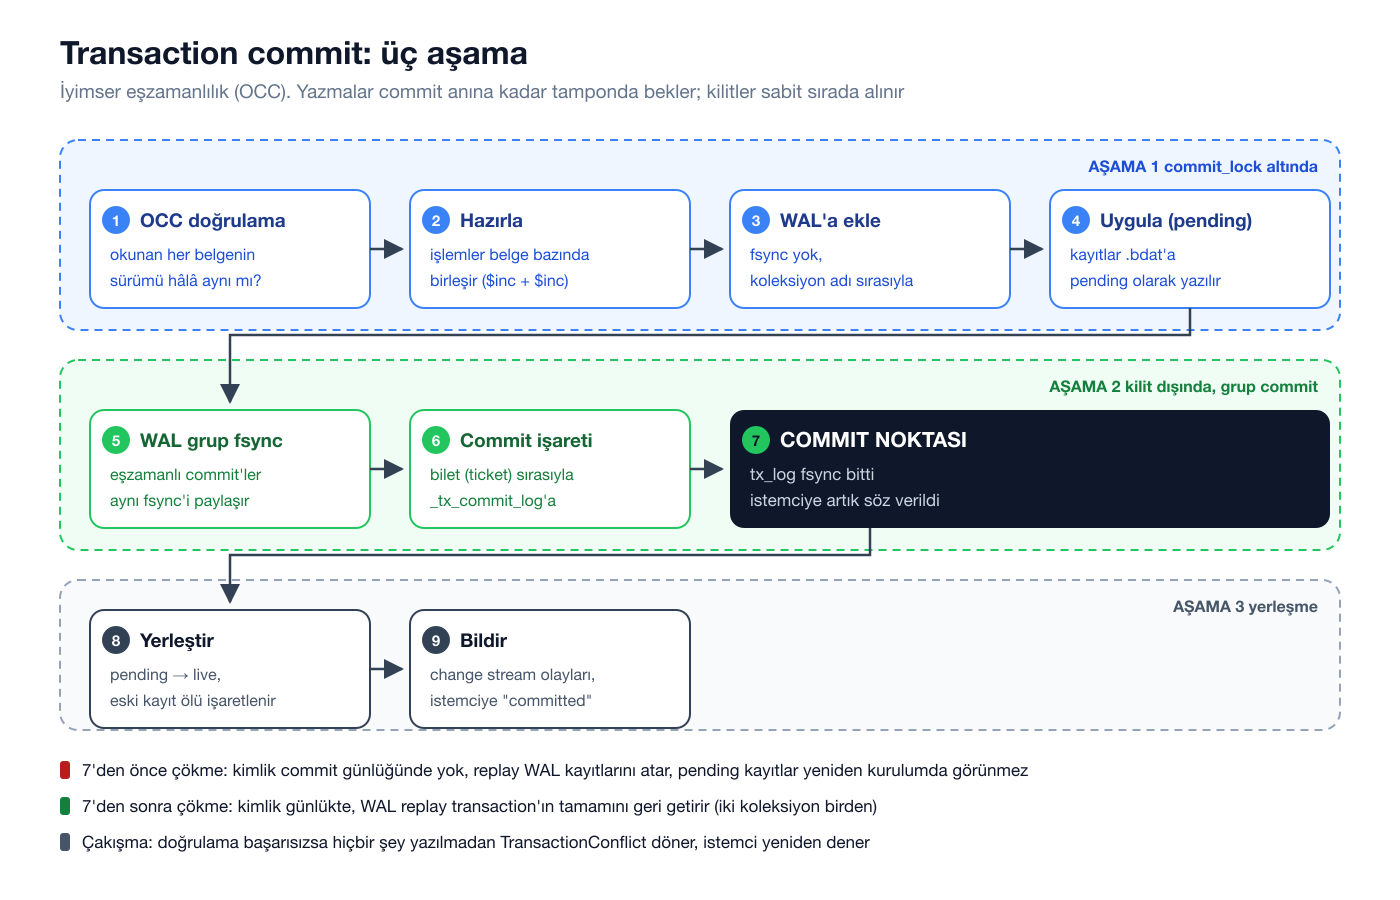
Aşama 1, motorun commit_lock kilidi altında çalışıyor. Okuma kümesi doğrulanıyor. Yazmalar hazırlanıyor, aynı belgeye yapılan ardışık işlemler ($inc -2 ve ardından $inc +1) birleştiriliyor. Kayıtlar her koleksiyonun WAL'ına fsync yapılmadan ekleniyor. Sonra veri dosyasına "pending" olarak uygulanıyor. Bu aşamada sadece bellek ve tamponlu dosya eklemeleri var.
Aşama 2 kilidin dışında. WAL'lar fsync ediliyor ama bunu sync_shared yapıyor: aynı anda commit eden transaction'lar tek bir fiziksel fsync'i paylaşıyor (grup commit). Ardından transaction kimliği bir bilet sırasıyla _tx_commit_log'a yazılıyor ve o dosyanın fsync'i bitiyor. Commit noktası tam olarak bu. Bilet sırası, bir commit'in okumuş olabileceği başka bir commit'ten önce dayanıklı hâle gelmesini engelliyor.
Aşama 3'te pending kayıtlar canlıya çevriliyor, yerine geçtikleri eski kayıtlar ölü işaretleniyor. Sonra değişiklik olayları yayımlanıyor ve istemciye "committed" dönülüyor.
Kurtarma bu sıranın tersine dayanıyor. Commit günlüğünde olmayan bir tx_id'nin WAL kayıtları replay'de atılıyor, pending kayıtlar da yeniden kurulumda görünmüyor. Commit günlüğündeki bir kimliğin kayıtları ise tamamen geri getiriliyor. İki koleksiyonlu bir transaction ya ikisinde birden var ya da hiçbirinde yok.
Kilitlenme (deadlock) neden mümkün değil? Transaction'ın koleksiyonları bir BTreeSet içinde tutuluyor. Kilitler hep aynı sırayla alınıyor: önce commit_lock, sonra koleksiyon bariyerleri ad sırasıyla. Doğrudan (transaction dışı) yazmalar da aynı sırayı kullanıyor. Döngüsel bekleme oluşamıyor, bu da kilitlenmeyi yapısal olarak imkânsız kılıyor.
Sıcak belgeler için find_for_update. Çok çekişilen bir belgede (ortak bir ücret hesabı gibi) OCC sürekli yeniden deneme fırtınasına dönüşebiliyor. find_for_update eşleşen belgeleri commit ya da rollback'e kadar karamsar biçimde kilitliyor. Öteki bekleyen sıraya giriyor:
A> {"cmd": "find_for_update", "collection": "accounts", "query": {"name": "bob"}}
< {"ok": true, "data": [{"name": "bob", "balance": 80, "_id": 2, "_version": 2}]}
B> {"cmd": "find_for_update", "collection": "accounts", "query": {"name": "bob"}, "lock_timeout_ms": 300}
< {"ok": false, "error": "lock timeout on 'accounts' doc 2: held by another transaction"}
# 305 ms beklendi
Bu kilitler yalnızca öteki for_update çağıranları dışarıda tutuyor. Doğruluğun asıl dayanağı hâlâ OCC doğrulaması. Terk edilen transaction'lar OXIDB_TX_MAX_IDLE_SECS (varsayılan 300 sn) sonunda geri alınıyor. Ortadan kaybolan bir istemci sunucuda kilit bırakamıyor, geç gelen bir istek de "bulunamadı" yerine TransactionExpired alıyor.
Garantinin kendisi. docs/isolation.md dosyasında, testlerle sabitlenmiş bir anomali tablosu var. Kısaca: commit edilen transaction'lar, okudukları ve yazdıkları belgeler açısından serileştirilebilir. Kirli okuma, kirli yazma, kayıp güncelleme ve belge okumalarına dayalı write skew engelleniyor. Bilerek bırakılan iki boşluk var. Birincisi phantom'lar: okuma kümesi sorgunun yüklemini (predicate) değil, dönen belgeleri tutuyor. İkincisi, transaction dışındaki okuyucuların bir commit'in uygulanma penceresini yarım görebilmesi. Transaction içinde kendi tamponlanmış yazmalarınızı commit'ten önce okuyamıyorsunuz, yazdığınız değeri hesaplayıp kullanmanız gerekiyor. "En fazla N açık sipariş" gibi yüklem kısıtları için önerilen yöntem, kısıtı her yazıcının okuyup güncellediği bir sayaç belgesine taşımak. Böylece OCC o belge üzerinde serileştiriyor. Aynı dosyada bir de request_id üzerinde unique index'e dayanan "tam olarak bir kez" kalıbı anlatılıyor: makbuz aynı transaction'da yazılıyor, yeniden deneme unique ihlaline çarpıp "zaten uygulandı" oluyor.
Yazma hızı
Her commit fsync ediliyorsa hız aslında fsync hızı demek. macOS'te Rust'ın sync_data çağrısı diski gerçekten boşaltan F_FULLFSYNC kullanıyor, bu da milisaniyeler sürüyor. Üç farklı yazma şeklini 1, 4 ve 16 eşzamanlı bağlantıyla ölçtüm:
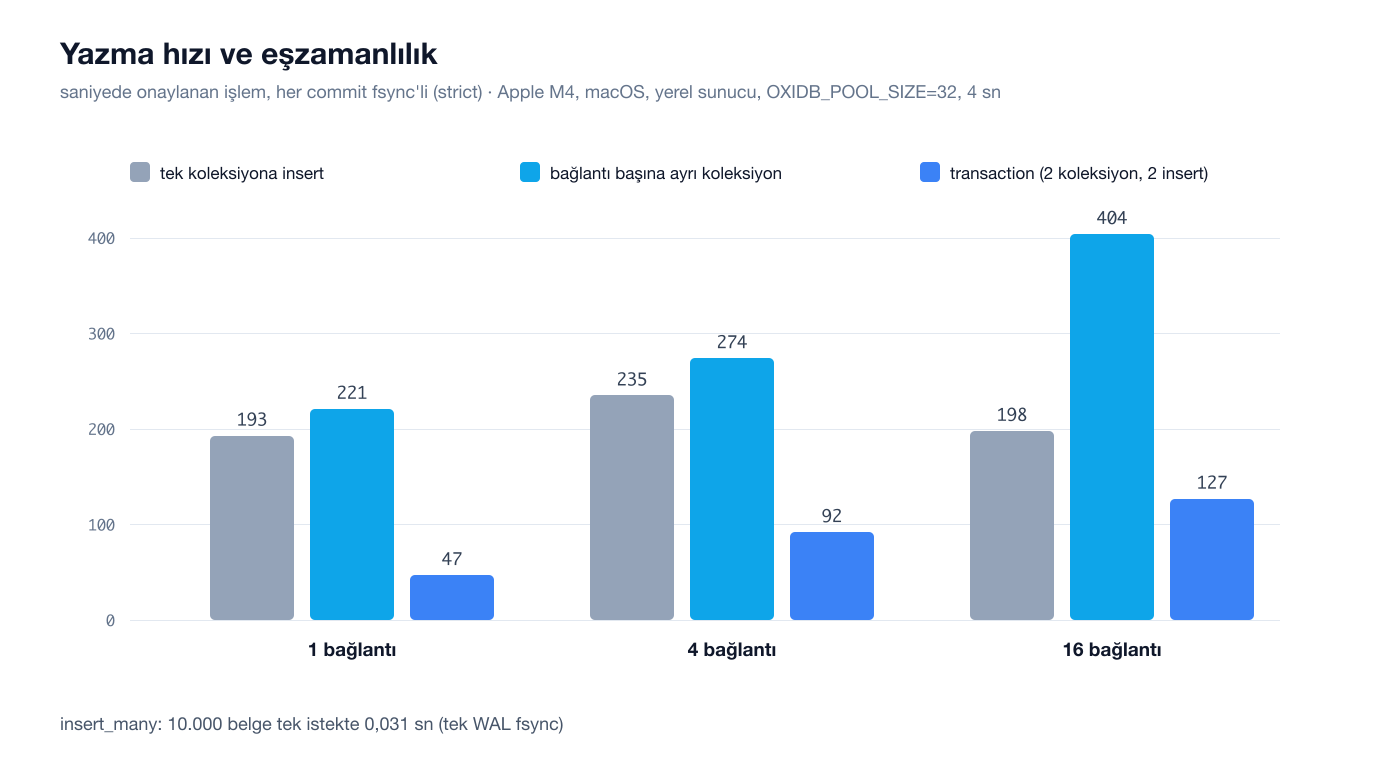
Sonuç öğretici. Aynı koleksiyona yapılan tekil auto-commit insert'ler bağlantı sayısıyla ölçeklenmiyor (193, 235, 198 işlem/sn), çünkü bu yol fsync'i koleksiyon başına sıralı yapıyor. Her bağlantı kendi koleksiyonuna yazınca 404/sn'ye çıkılıyor. Transaction'lar ise grup commit sayesinde 47'den 127 tx/sn'ye çıkıyor. Her transaction dört gidiş-dönüş ve iki koleksiyonda birer insert içeriyor. Toplu yazma bambaşka bir sınıf: 10.000 belgelik bir insert_many 0,031 saniye sürdü, çünkü tek bir WAL fsync'i paylaşıyor. Pratik ders: yoğun yazmayı toplu yapın ya da transaction'larla gruplayın. Tek koleksiyonda, tek tek, eşzamanlı ve katı dayanıklılıkla yazmak bu motorun en zayıf noktası.
MVCC-lite: okuma snapshot'ları (ADR-0017)
OCC'nin bilinçli bir boşluğu vardı: transaction dışındaki bir okuyucu, bir commit'in uygulanması sırasında A belgesini commit'ten sonraki, B belgesini commit'ten önceki hâliyle görebiliyordu. Bir bakiye toplamı raporu, hiçbir anda doğru olmamış bir toplam üretebiliyordu. ADR-0017 bunu yalnızca okuma yolunda çözüyor. Yazma yoluna, yani OCC'ye, find_for_update'e ve grup commit'e hiç dokunmuyor.
Mekanizma şu: bir snapshot açıkken, yazıcılar bir belgenin yerine geçtikleri eski baytları bellekteki bir sürüm haritasına ekleyip yollarına devam ediyorlar. Yazıcılar hiç beklemiyor. Snapshot açık değilken (varsayılan durum) bunun bedeli yazma başına tek bir atomik okuma. Snapshot commit_lock.write() altında başlıyor, her mantıksal yazma da commit_lock.read() altında kayıt düşüyor. Böylece "snapshot'tan sonra görünür olan her değişiklik" sınırı yırtılmadan tanımlanıyor. aggregate varsayılan olarak snapshot tutarlı. Açık snapshot API'si de birden çok sorguyu aynı ana sabitliyor:
> {"cmd": "snapshot_begin"}
< {"ok": true, "data": {"snap": 1000}}
# başka bir bağlantı:
> {"cmd": "update", "collection": "accounts", "query": {"name": "alice"}, "update": {"$set": {"balance": 0}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "insert", "collection": "accounts", "doc": {"name": "carol", "balance": 500}}
< {"ok": true, "data": {"id": 3}}
# ilk bağlantı:
> {"cmd": "find", "collection": "accounts", "query": {}}
< {"ok": true, "data": [{"name": "alice", "balance": 0, "_id": 1, "_version": 4}, {"name": "bob", "balance": 85, "_id": 2, "_version": 3}, {"name": "carol", "balance": 500, "_id": 3, "_version": 1}]}
> {"cmd": "snapshot_find", "collection": "accounts", "snap": 1000, "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 3, "balance": 20, "name": "alice"}, {"name": "bob", "balance": 85, "_id": 2, "_version": 3}]}
> {"cmd": "snapshot_aggregate", "collection": "accounts", "snap": 1000, "pipeline": [{"$group": {"_id": null, "total": {"$sum": "$balance"}}}]}
< {"ok": true, "data": [{"_id": null, "total": 105}]}
> {"cmd": "aggregate", "collection": "accounts", "pipeline": [{"$group": {"_id": null, "total": {"$sum": "$balance"}}}]}
< {"ok": true, "data": [{"_id": null, "total": 585}]}
> {"cmd": "snapshot_end", "snap": 1000}
< {"ok": true, "data": "snapshot closed"}
Snapshot içinde Alice'in güncellemesi geri sarılmış görünüyor, Carol ise hiç yok. Snapshot'lar OXIDB_SNAPSHOT_MAX_SECS (varsayılan 300) sonunda ölüyor. Sonsuza dek açık bırakılmış bir snapshot tanım gereği bir bellek şişmesi hatası. Süre sınırı bu hatayı, yazıcıları durdurmak yerine okuyucuya dönen bir SnapshotExpired hatasına çeviriyor.
Tam MVCC'yi neden yapmadığımı ADR'de yazdım. Tam MVCC, OCC'yi tamamlamıyor, onun yerine geçiyor. Vacuum türü şişme sorunlarını beraberinde getiriyor ve index sürümleme bedelini sadece aktif snapshot varken değil, her yerde ödetiyor. Bu motorun en değerli özelliği, garantilerinin çökme testleriyle baştan sona sınanabilecek kadar küçük olması. Bunu korumak istedim.
Değişiklik akışları ve gerçek zamanlı
watch komutu bir bağlantıyı değişiklik akışına çeviriyor. İsteğe bağlı olarak tek bir koleksiyonla sınırlanabiliyor. Her olayın artan bir token'ı var. Insert ve update olayları belgenin yeni hâlini, delete olayları eski hâlini taşıyor. Transaction'dan gelen olaylarda tx_id da bulunuyor:
W< {"event":"change","data":{"token":1,"operation":"update","collection":"accounts","doc_id":1,"document":{"name":"alice","balance":70,"_id":1,"_version":2},"tx_id":1}}
W< {"event":"change","data":{"token":2,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":80,"_id":2,"_version":2},"tx_id":1}}
W< {"event":"change","data":{"token":3,"operation":"update","collection":"accounts","doc_id":1,"document":{"name":"alice","balance":20,"_id":1,"_version":3},"tx_id":2}}
W< {"event":"change","data":{"token":4,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":85,"_id":2,"_version":3},"tx_id":5}}
Çakışan transaction (tx 3) ve geri alınan transaction (tx 4) akışta hiç görünmüyor. Olaylar commit noktasından sonra yayımlandığı için başka türlü olamaz zaten. Bağlantı koparsa resume_after ile kalınan yerden devam ediliyor. Sunucu son 4096 olayı bir tekrar tamponunda tutuyor (OXIDB_CHANGE_REPLAY_EVENTS):
> {"cmd": "watch", "collection": "accounts", "resume_after": 3}
< {"ok": true, "data": "watching"}
W< {"event":"change","data":{"token":4,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":85,"_id":2,"_version":3},"tx_id":5}}
Aynı akış WebSocket üzerinden de geliyor (OXIDB_WS_PORT, {"cmd": "subscribe", "id": "sub1", "collection": ..., "query": ...}). Burada JWT doğrulaması ve belge başına değerlendirilen satır düzeyi güvenlik kuralları da devreye giriyor.
REST ve PostgREST
HTTP tarafında iki yüzey var. Birincisi düz bir JSON REST API'si:
$ curl -s -X POST localhost:15106/api/products/documents -H "Content-Type: application/json" -d '{"doc":{"sku":"SP-01","name":"Speaker","price":120,"tags":["bluetooth"]}}'
{"id":6}
$ curl -s -X POST localhost:15106/api/orders/aggregate -H "Content-Type: application/json" -d '{"pipeline":[{"$match":{"customer":"c42"}},{"$group":{"_id":"$status","n":{"$sum":1}}},{"$sort":{"n":-1}}]}'
[{"_id":"paid","n":18},{"_id":"shipped","n":9},{"_id":"cancelled","n":7}]
İkincisi PostgREST uyumlu bir yüzey (ADR-0019). /rest/v1/{tablo} PostgREST'in URL dilbilgisini konuşuyor. Bu sayede @supabase/postgrest-js gibi istemciler değiştirilmeden çalışıyor. Aynı URL bir doküman koleksiyonuna, bir SQL tablosuna ya da bir zaman serisine gidebiliyor:
$ curl -s "localhost:15106/rest/v1/orders?customer=eq.c42&status=eq.paid&select=order_no,amount,created&order=amount.desc&limit=3"
[{"order_no":7782,"amount":456,"created":"2026-03-14T02:27:01Z"},{"order_no":1028,"amount":444,"created":"2026-04-28T19:05:23Z"},{"order_no":15018,"amount":443,"created":"2026-01-10T02:27:44Z"}]
$ curl -s "localhost:15106/rest/v1/products?or=(price.lt.20,price.gt.200)&select=sku,price"
[{"sku":"MN-27","price":224.1},{"sku":"CB-10","price":8.1}]
OXIDB_JWT_SECRET verilmezse REST API kimlik doğrulamasız açılıyor ve sunucu bunu açılışta uyarı olarak basıyor. Üretimde ya JWT ya da özel bir ağ şart.
Çoklu veritabanı (ADR-0012)
Tek süreç birden fazla veritabanı barındırabiliyor. Her birinin kendi dizini var (data/oxidb, data/tenant_a, ...). Bir veritabanı hem doküman ad alanını hem de SQL ad alanını kapsıyor, ikisine de aynı adla ulaşılıyor. Her istek bir db alanı alabiliyor ya da oturum use_db ile geçiş yapabiliyor:
> {"cmd": "create_database", "name": "tenant_a"}
< {"ok": true, "data": "database 'tenant_a' created"}
> {"cmd": "insert", "collection": "orders", "db": "tenant_a", "doc": {"order_no": 1, "amount": 42}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "list_databases"}
< {"ok": true, "data": ["oxidb", "postgres", "tenant_a"]}
> {"cmd": "use_db", "name": "tenant_a"}
< {"ok": true, "data": "switched to database 'tenant_a'"}
> {"cmd": "count", "collection": "orders"}
< {"ok": true, "data": {"count": 1}}
> {"cmd": "use_db", "name": "oxidb"}
< {"ok": true, "data": "switched to database 'oxidb'"}
> {"cmd": "count", "collection": "orders"}
< {"ok": true, "data": {"count": 20000}}postgres, PostgreSQL wire istemcileri için varsayılan veritabanının takma adı. Bir oturumun açık transaction'ı başladığı veritabanına bağlı, başka bir veritabanına giden istek commit'e kadar reddediliyor. Raft replikasyonu da veritabanı DDL'ini ve kapsamlı yazmaları taşıyor. Veritabanları arası sorgu ve transaction ise bilinçli olarak kapsam dışı.
Blob'lar
Doküman motoru küçük bir nesne deposu da taşıyor: bucket'lar, anahtarlar, içerik türü ve meta veri. Faturalar, ekler, küçük dosyalar için:
> {"cmd": "put_object", "bucket": "invoices", "key": "2026/10/INV-1001.txt", "data": "SW52b2ljZSAxMDAxOiAzIHgga2V5Ym9hcmQ=", "content_type": "text/plain", "metadata": {"customer": "c42"}}
< {"ok": true, "data": {"key": "2026/10/INV-1001.txt", "bucket": "invoices", "size": 26, "content_type": "text/plain", "etag": "2d01298f4acb19ac183c86e3fbe43e3d", "created_at": "2026-10-11T21:36:35Z", "metadata": {"customer": "c42"}, "stored_size": 26, "format_version": 1}}
Blob'lardaki metin (PDF, DOCX, HTML...) tam metin aramaya da girebiliyor. Gerçek S3 istemcileriyle konuşan yüzey ise ayrı bir konu: S3 nesne depolama yazısı.
Sınırlar ve dürüst ödünleşimler
- Sürüm öncesi (pre-1.0). Disk formatı, wire protokolü ve sorgu dili sürümler arasında geçiş yolu olmadan değişebilir. Bir sürüme sabitleyin, yükseltirken dökümü alıp yeniden yükleyin.
- Dizi eşitliği MongoDB gibi değil.
{"tags": "usb"}dizinin elemanlarına bakmıyor,$allya da$elemMatchgerekiyor. - Phantom'lar ve yüklem kısıtları. Transaction'lar okunan belgelere göre serileştirilebilir ama yüklemlere göre değil. Düz
find/countread-committed. Tutarlı bir görüntü içinaggregateya da açık snapshot kullanın. - Transaction içinde kendi yazmanızı okuyamıyorsunuz. Yazmalar commit anında birleşiyor.
- Tek koleksiyona tekil, eşzamanlı ve katı yazma ölçeklenmiyor. Toplu yazın ya da transaction ile gruplayın.
- Index kesişimi seçici olmayan index'lerde pahalı. Düşük kardinaliteli alanlara bileşik index tercih edin.
- Bellekte kalan bir taban var. Ofset index'i belge sayısıyla büyüyor. Büyük sonuç kümeleri hâlâ bellekte topluca üretiliyor. Akışlı sonuç çerçeveleri ADR-0026'da tasarlandı.
$fillile$densify'ın bölümleme anahtarları farklı ve bilinmeyen anahtarlar sessizce yok sayılıyor.
Diğer motorlarla ilişkisi
Doküman motoru OxiDB'nin geri kalanının üzerine kurulduğu zemin. WAL, commit günlüğü, şifreleme, yedekleme ve point-in-time recovery onun makinesini kullanıyor. Log toplama koleksiyonları ve TTL ile saklama süreleri onun koleksiyonları. Tam metin ve vektör index'leri, coğrafi ve graf aşamaları onun pipeline'ında çalışıyor. SQL ve zaman serisi motorları bilerek ayrı dosyalarla ayrı motorlar, ama aynı süreçte, aynı güvenlik modeliyle ve aynı veritabanı seçicisiyle yaşıyorlar. Hepsi aynı tek ikili dosyada.
Denemek için
İkili dosyalar GitHub sürümlerinde: github.com/parisxmas/OxiDB/releases (macOS arm64/x86_64, Linux x86_64/arm64, Windows). İndirip açın ve çalıştırın:
tar xzf oxidb-server-*.tar.gz
./oxidb-server
Docker ile docker compose up -d yeterli. Varsayılan olarak 127.0.0.1:4444'te dinliyor ve ./oxidb_data/ dizinine yazıyor. Bu yazıdaki istekleri yukarıdaki kısa Python istemcisiyle olduğu gibi deneyebilirsiniz. Serinin sıradaki yazısı aynı koleksiyonların üzerinde çalışan tam metin ve vektör arama.