El motor documental de OxiDB: colecciones sin esquema, el planificador y un commit en tres fases
El motor documental en el núcleo de OxiDB: consultas y agregación al estilo de MongoDB, índices y el planificador, almacenamiento disk-first, el WAL, transacciones OCC y snapshots de lectura, con cada ejemplo ejecutado contra un servidor real.
Empecé OxiDB como una base de datos documental. Hoy el mismo proceso también alberga tablas SQL, series temporales, un almacén clave-valor compatible con Redis, S3, MQTT y AMQP, pero por debajo de todo ello está la parte que escribí primero: colecciones JSON sin esquema, consultas al estilo de MongoDB y un pipeline de agregación. Este artículo trata de ese núcleo. Cómo activarlo, qué consultas y actualizaciones entiende, qué hay en el pipeline, cómo toman sus decisiones los índices y el planificador, y después el interior: cómo se guardan los documentos en disco, cuándo se hace fsync del WAL, el momento exacto en que una transacción cuenta como confirmada, y por qué los snapshots de lectura dejan intacta la ruta de escritura. Todas las salidas que se muestran aquí las ejecuté personalmente contra un servidor OxiDB 0.44.2 local en un Mac con Apple M4. Ningún número inventado.
Cada motor tiene su propio artículo en esta serie. La búsqueda de texto completo y vectorial y las etapas geoespaciales y de grafos también se ejecutan sobre el motor documental, pero tienen artículos propios: búsqueda de texto completo y vectorial y consultas geoespaciales y de grafos.
Para qué sirve el motor documental
El motor documental está pensado para aplicaciones cuyos datos cambian de forma con el tiempo. En un catálogo de productos, un artículo tiene un campo specs.switch y otro tiene un array reviews. Un documento de pedido lleva cinco campos hoy y siete dentro de seis meses. En una tabla relacional, cada uno de esos cambios es una migración. Aquí una colección se crea con su primera inserción y cada documento lleva sus propios campos.
El motor documental está activado por defecto en OxiDB. Si se arranca el servidor sin habilitar nada más, es lo único que hay. El motor SQL es un motor separado con sus propios archivos (el artículo sobre el motor SQL), así que el nombre de una colección y el de una tabla nunca pueden chocar.
Puesta en marcha
Un solo binario, sin configuración:
OXIDB_ADDR=127.0.0.1:15100 \
OXIDB_DATA=./data \
OXIDB_HTTP_PORT=15106 \
OXIDB_WS_PORT=15107 \
./oxidb-server --verbose
Al arrancar, el servidor dice lo que está haciendo:
[verbose] opening database at ./data/oxidb
[verbose] blob store opened
[verbose] FTS index loaded
TTL eviction: enabled (interval=1000ms)
oxidb-server listening on 127.0.0.1:15100 (pool_size=4, data_dir=./data, idle_timeout=0s)
REST HTTP API listening on 0.0.0.0:15106
WebSocket API listening on 0.0.0.0:15107
Hay una línea que dejé fuera de este extracto: el servidor también anuncia que la "lazy sync" está desactivada, lo que significa que se hace fsync de cada commit (modo estricto).
El protocolo de red nativo es sencillo: una longitud de 4 bytes en little-endian y después un objeto JSON. Cada petición tiene un campo cmd y cada respuesta es {"ok": true, "data": ...} o {"ok": false, "error": "..."}. Ejecuté todos los ejemplos de este artículo con este diminuto cliente de Python, sin necesidad de ninguna biblioteca:
import socket, struct, json

class Ox:
    def __init__(self, port=15100):
        self.s = socket.create_connection(("127.0.0.1", port))

    def __call__(self, req):
        b = json.dumps(req).encode()
        self.s.sendall(struct.pack("<I", len(b)) + b)
        n = struct.unpack("<I", self._read(4))[0]
        return json.loads(self._read(n))

    def _read(self, n):
        d = b""
        while len(d) < n:
            d += self.s.recv(n - len(d))
        return d
Hay clientes listos para Python, Go, .NET, JS/TS, Java, Julia y Swift, además de OxiWire (un encuadre binario compacto), REST y WebSocket. Todos hablan la misma forma de petición.
Modelo de datos: colecciones sin esquema
No hace falta crear una colección antes de insertar en ella:
> {"cmd": "insert", "collection": "products", "doc": {"sku": "KB-01", "name": "Mechanical keyboard", "price": 89, "tags": ["usb", "rgb"], "stock": {"ist": 12, "ank": 0}, "specs": {"switch": "brown", "layout": "TR-Q"}}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "insert_many", "collection": "products", "docs": [{"sku": "MS-02", ...}, {"sku": "MN-27", ...}, {"sku": "CB-10", ...}, {"sku": "HD-05", ...}]}
< {"ok": true, "data": [2, 3, 4, 5]}
(Los ... de la segunda petición son una abreviatura mía; los documentos completos aparecen en las salidas de las consultas de abajo).
Cada documento recibe dos campos de sistema. _id es un entero creciente dentro de la colección, y _version aumenta en uno con cada escritura. _version no es solo informativo: toda la validación de las transacciones optimistas se apoya en él, como veremos más adelante. A los campos anidados se accede con notación de punto (stock.ank, specs.switch) tanto en consultas como en actualizaciones.
En disco, los documentos no se almacenan como texto JSON sino en el formato binario JSONB, que permite leer un único campo de nivel superior sin decodificar todo el documento. El planificador y los índices se apoyan en eso.
Consultas
El lenguaje de consultas es deliberadamente cercano al de MongoDB: $eq $ne $gt $gte $lt $lte $in $nin $exists $regex $elemMatch $all $size $not $type $mod $and $or $nor $expr, y find también acepta sort, skip y limit.
> {"cmd": "find", "collection": "products", "query": {"stock.ank": {"$gt": 0}, "discontinued": {"$exists": false}}, "sort": {"price": 1}, "limit": 2}
< {"ok": true, "data": [{"sku": "CB-10", "name": "USB-C cable", "price": 9, "tags": ["usb-c"], "stock": {"ist": 200, "ank": 120}, "_id": 4, "_version": 1}, {"sku": "MS-02", "name": "Wireless mouse", "price": 29, "tags": ["bluetooth"], "stock": {"ist": 40, "ank": 15}, "_id": 2, "_version": 1}]}
$elemMatch para objetos dentro de arrays, $regex para patrones, $expr para comparar dos campos del mismo documento:
> {"cmd": "find", "collection": "products", "query": {"reviews": {"$elemMatch": {"stars": {"$gte": 5}}}}}
< {"ok": true, "data": [{"sku": "MN-27", "name": "27 inch monitor", "price": 249, "tags": ["usb-c", "hdr"], "stock": {"ist": 3, "ank": 7}, "reviews": [{"by": "ayse", "stars": 5}, {"by": "mert", "stars": 3}], "_id": 3, "_version": 1}]}
> {"cmd": "find", "collection": "products", "query": {"$or": [{"name": {"$regex": "^usb", "$options": "i"}}, {"tags": {"$all": ["usb", "bluetooth"]}}]}}
< {"ok": true, "data": [{"sku": "CB-10", ...}, {"sku": "HD-05", ...}]}
> {"cmd": "find", "collection": "products", "query": {"$expr": {"$gt": ["$stock.ank", "$stock.ist"]}}}
< {"ok": true, "data": [{"sku": "MN-27", "name": "27 inch monitor", ...}]}
Mientras preparaba estos ejemplos me topé con una diferencia que sorprenderá a quien venga de MongoDB, y prefiero decirlo. En MongoDB, {"tags": "usb"} encuentra todos los documentos cuyo array tags contiene "usb". En OxiDB 0.44.2, la igualdad escalar compara con el valor completo del campo y no mira dentro de un array:
> {"cmd": "count", "collection": "products", "query": {"tags": "usb"}}
< {"ok": true, "data": {"count": 0}}
> {"cmd": "count", "collection": "products", "query": {"tags": {"$all": ["usb"]}}}
< {"ok": true, "data": {"count": 2}}
Para encontrar un elemento en un array hay que usar $all o $elemMatch. En el código (src/query.rs, eval_field_op) esto no es una rama deliberada, sino semántica de arrays que todavía no ha llegado a la igualdad. Está en mi lista.
Actualizaciones
Operadores de actualización: $set $unset $inc $mul $min $max $rename $currentDate, y para arrays $push (con $each y $slice) $pull $addToSet $pop. Se pueden poner varios operadores en una misma petición, y la actualización de un documento es atómica:
> {"cmd": "update_one", "collection": "products", "query": {"sku": "KB-01"}, "update": {"$inc": {"stock.ank": 5}, "$push": {"tags": "hot-swap"}, "$set": {"specs.switch": "red"}, "$currentDate": {"updated_at": true}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "update", "collection": "products", "query": {"tags": {"$all": ["usb-c"]}}, "update": {"$mul": {"price": 0.9}, "$addToSet": {"tags": "sale"}}}
< {"ok": true, "data": {"modified": 2}}
> {"cmd": "update_one", "collection": "products", "query": {"sku": "HD-05"}, "update": {"$rename": {"discontinued": "archived"}, "$pull": {"tags": "usb"}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "find", "collection": "products", "query": {"sku": {"$in": ["KB-01", "MN-27", "HD-05"]}}, "sort": {"sku": 1}}
< {"ok": true, "data": [
    {"sku": "HD-05", "name": "Headset", "price": 59, "tags": ["bluetooth"], "_version": 2, "_id": 5, "archived": true},
    {"sku": "KB-01", "name": "Mechanical keyboard", "price": 89, "tags": ["usb", "rgb", "hot-swap"], "stock": {"ist": 12, "ank": 5}, "specs": {"switch": "red", "layout": "TR-Q"}, "_id": 1, "_version": 2, "updated_at": "2026-10-11T21:34:50.373050+00:00"},
    {"sku": "MN-27", "name": "27 inch monitor", "price": 224.1, "tags": ["usb-c", "hdr", "sale"], ..., "_id": 3, "_version": 2}]}
Para documentos individuales muy disputados, como los contadores, existe find_and_modify. Actualiza de forma atómica fuera de cualquier transacción y devuelve el documento nuevo:
> {"cmd": "find_and_modify", "collection": "counters", "query": {"_name": "invoice"}, "update": {"$inc": {"seq": 1}}}
< {"ok": true, "data": {"_name": "invoice", "seq": 1001, "_id": 1, "_version": 2}}
El pipeline de agregación
Para mostrar el pipeline sobre algo más grande cargué 500 clientes y 20.000 pedidos. Los pedidos tienen order_no, customer ("c1" a "c500"), status (paid, shipped, cancelled), amount, items y created (fechas ISO del primer semestre de 2026). Una llamada a insert_many lleva 5.000 documentos, y cargar los 20.000 tardó 0,17 segundos.
Etapas soportadas: $match $group $sort $skip $limit $project $count $unwind $addFields $lookup $facet $replaceRoot $out $setWindowFields $dateHistogram $ohlcv $densify $fill, además de $geoNear, $graphLookup y $shortestPath, que trato en el artículo sobre consultas geoespaciales y de grafos. Acumuladores de $group: $sum $avg $min $max $count $first $last $push $addToSet $percentile.
$group y $lookup
Los tres clientes que más gastan, unidos con la colección de clientes:
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"status": "paid"}},
    {"$group": {"_id": "$customer", "spent": {"$sum": "$amount"}, "orders": {"$sum": 1}}},
    {"$sort": {"spent": -1}}, {"$limit": 3},
    {"$lookup": {"from": "customers", "localField": "_id", "foreignField": "code", "as": "c"}},
    {"$unwind": "$c"},
    {"$project": {"_id": 0, "customer": "$_id", "name": "$c.name", "region": "$c.region", "spent": 1, "orders": 1}}]}
< {"ok": true, "data": [{"customer": "c77", "name": "Customer 77", "region": "Izmir", "spent": 10331, "orders": 39}, {"customer": "c57", "name": "Customer 57", "region": "Antalya", "spent": 10303, "orders": 35}, {"customer": "c497", "name": "Customer 497", "region": "Istanbul", "spent": 10279, "orders": 34}]}
$lookup ejecuta un find normal contra la colección externa, así que con un índice sobre foreignField (aquí un índice único sobre customers.code) cada unión es una búsqueda en el índice. Las uniones sobre varios campos funcionan mediante los arrays localFields y foreignFields.
$facet
$facet ejecuta varios sub-pipelines independientes sobre la misma entrada en una sola pasada, así que tres paneles de un dashboard salen de una sola consulta en lugar de tres recorridos:
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"created": {"$gte": "2026-06-01", "$lt": "2026-07-01"}}},
    {"$facet": {
      "byStatus": [{"$group": {"_id": "$status", "n": {"$sum": 1}}}, {"$sort": {"n": -1}}],
      "bigTicket": [{"$match": {"amount": {"$gte": 495}}}, {"$count": "n"}],
      "avgBasket": [{"$group": {"_id": null, "avgItems": {"$avg": "$items"}, "maxAmount": {"$max": "$amount"}}}]}}]}
< {"ok": true, "data": [{"byStatus": [{"_id": "paid", "n": 1935}, {"_id": "shipped", "n": 945}, {"_id": "cancelled", "n": 345}], "bigTicket": [{"n": 40}], "avgBasket": [{"_id": null, "avgItems": 3.494263565891473, "maxAmount": 500}]}]}
Los sub-pipelines trabajan sobre un conjunto compartido en memoria, así que $facet y $out no están permitidos dentro de ellos (MongoDB tiene la misma regla). Hay que notar también que la comparación de fechas aquí no es una simple comparación de cadenas: los índices almacenan como milisegundos desde epoch las cadenas con aspecto de ISO 8601, así que las consultas por rango se ejecutan en orden cronológico.
$setWindowFields
Las funciones de ventana calculan valores a partir de documentos vecinos sin colapsar filas como hace $group. Un total acumulado, la media de los últimos tres pedidos y el importe anterior, sobre los cinco primeros pedidos de un cliente:
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"customer": "c42"}}, {"$sort": {"created": 1}}, {"$limit": 5},
    {"$setWindowFields": {"partitionBy": "$customer", "sortBy": {"created": 1}, "output": {
       "running": {"$sum": "$amount", "window": {"documents": ["unbounded", "current"]}},
       "avg3": {"$avg": "$amount", "window": {"documents": [-2, 0]}},
       "prev": {"$shift": {"output": "$amount", "by": -1, "default": 0}}}}},
    {"$project": {"_id": 0, "created": 1, "amount": 1, "running": 1, "avg3": 1, "prev": 1}}]}
< {"ok": true, "data": [
    {"created": "2026-01-10T02:27:44Z", "amount": 443, "running": 443, "avg3": 443, "prev": 0},
    {"created": "2026-01-15T13:47:23Z", "amount": 421, "running": 864, "avg3": 432, "prev": 443},
    {"created": "2026-01-17T22:53:17Z", "amount": 464, "running": 1328, "avg3": 442.6666666666667, "prev": 421},
    {"created": "2026-02-06T17:02:43Z", "amount": 217, "running": 1545, "avg3": 367.3333333333333, "prev": 464},
    {"created": "2026-02-06T20:34:44Z", "amount": 313, "running": 1858, "avg3": 331.3333333333333, "prev": 217}]}
Además de las ventanas por documentos hay ventanas range: window: {"range": [-5, 0], "unit": "minute"} significa los últimos cinco minutos, no los últimos cinco documentos. $rank, $denseRank y $documentNumber también están soportados.
Datos con forma temporal: $dateHistogram, $ohlcv, $densify, $fill
Añadí estas cuatro etapas para poder analizar documentos a lo largo del tiempo sin un motor de series temporales aparte. (Para series comprimidas en serio, con retención, está el motor de series temporales).
$dateHistogram agrupa documentos en cubetas por intervalo de calendario, y con min_doc_count: 0 rellena con cero las cubetas vacías para que a un gráfico no le falten días:
> {"cmd": "aggregate", "collection": "logins", "pipeline": [{"$dateHistogram": {"field": "at", "interval": "1d", "min_doc_count": 0}}, {"$sort": {"_id": 1}}]}
< {"ok": true, "data": [{"_id": "2026-10-01T00:00:00Z", "count": 2}, {"_id": "2026-10-02T00:00:00Z", "count": 1}, {"_id": "2026-10-03T00:00:00Z", "count": 0}, {"_id": "2026-10-04T00:00:00Z", "count": 0}, {"_id": "2026-10-05T00:00:00Z", "count": 3}]}
$ohlcv convierte ticks de operaciones en velas. Ordena él mismo su entrada por tiempo, particiona por instrumento con symbol y, con fill: "previous", coloca en un minuto sin operaciones una vela plana que arrastra el cierre anterior:
> {"cmd": "aggregate", "collection": "ticks", "pipeline": [
    {"$ohlcv": {"time": "ts", "interval": "1m", "price": "price", "volume": "qty", "symbol": "sym", "fill": "previous"}},
    {"$project": {"_id": 0, "time": 1, "open": 1, "high": 1, "low": 1, "close": 1, "volume": 1, "count": 1}}]}
< {"ok": true, "data": [
    {"time": "2026-10-12T09:00:00Z", "open": 10.0, "high": 10.4, "low": 10.0, "close": 10.4, "volume": 150.0, "count": 2},
    {"time": "2026-10-12T09:01:00Z", "open": 10.2, "high": 10.9, "low": 10.2, "close": 10.9, "volume": 90.0, "count": 2},
    {"time": "2026-10-12T09:02:00Z", "open": 10.9, "high": 10.9, "low": 10.9, "close": 10.9, "volume": 0.0, "count": 0},
    {"time": "2026-10-12T09:03:00Z", "open": 10.7, "high": 10.7, "low": 10.7, "close": 10.7, "volume": 40.0, "count": 1}]}
$densify genera documentos sintéticos para los pasos que faltan y $fill los rellena: locf (arrastrar hacia delante el último valor), linear (interpolar) o una constante. Un ejemplo con sensores en dos salas:
> {"cmd": "aggregate", "collection": "sensor", "pipeline": [
    {"$densify": {"field": "t", "partitionByFields": ["room"], "range": {"step": 1, "bounds": "partition"}}},
    {"$fill": {"sortBy": {"t": 1}, "partitionBy": "$room", "output": {"temp": {"method": "linear"}}}},
    {"$sort": {"room": 1, "t": 1}}, {"$project": {"_id": 0, "room": 1, "t": 1, "temp": 1}}]}
< {"ok": true, "data": [
    {"room": "depo", "t": 0, "temp": 12.0}, {"room": "depo", "t": 1, "temp": 12.333333333333334},
    {"room": "depo", "t": 2, "temp": 12.666666666666666}, {"room": "depo", "t": 3, "temp": 13.0},
    {"room": "lab", "t": 0, "temp": 20.0}, {"room": "lab", "t": 1, "temp": 21.0},
    {"room": "lab", "t": 2, "temp": 22.166666666666668}, {"room": "lab", "t": 3, "temp": 23.333333333333332},
    {"room": "lab", "t": 4, "temp": 24.5}]}
Aquí tropecé con mi propio diseño, y vale la pena dejarlo por escrito. En el primer intento le pasé a $fill el mismo "partitionByFields": ["room"] que acepta $densify. $fill no conoce esa clave, espera "partitionBy": "$room", e ignora en silencio las claves que no conoce. El resultado fue el hueco del almacén rellenado con las temperaturas del laboratorio (depo, t=1, temp=21.0). Dos etapas con claves de partición distintas, y una clave desconocida que no produce error, son una aspereza que hay que corregir.
Estas etapas tienen un presupuesto. Si $densify u $ohlcv fueran a generar más de un número determinado de documentos, fallan con un error en lugar de truncar el resultado sin avisar. Esos presupuestos llegaron en una pasada de endurecimiento en la 0.44.2, junto con un presupuesto de valores para $setWindowFields.
Índices y el planificador
Tipos de índice
- Índice de campo (
create_index): igualdad, rangos,$in, ordenación y conteo. - Índice único (
create_unique_index): rechaza las violaciones con un error. - Índice compuesto (
create_composite_index): recorridos por prefijo y agregación cubierta. - Índice TTL (
create_ttl_index): elimina en segundo plano los documentos caducados. - Índices de texto completo y vectoriales: en su propio artículo.
Los índices se rellenan sobre los datos existentes en cuanto se crean. Único y TTL en acción:
> {"cmd": "create_unique_index", "collection": "customers", "field": "code"}
< {"ok": true, "data": "unique index created"}
> {"cmd": "insert", "collection": "customers", "doc": {"code": "c42", "name": "Duplicate"}}
< {"ok": false, "error": "unique constraint violated: field 'code' value already exists"}

> {"cmd": "create_ttl_index", "collection": "sessions", "field": "created_at", "expireAfterSeconds": 2}
< {"ok": true, "data": "ttl index created"}
> {"cmd": "insert", "collection": "sessions", "doc": {"user": "ayse", "created_at": "2026-10-11T21:35:53Z"}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "count", "collection": "sessions"}
< {"ok": true, "data": {"count": 1}}
# 4.5 seconds later
> {"cmd": "count", "collection": "sessions"}
< {"ok": true, "data": {"count": 0}}
El barrido TTL se ejecuta una vez por segundo. La retención de logs usa la misma maquinaria (el artículo sobre logs y alertas).
explain
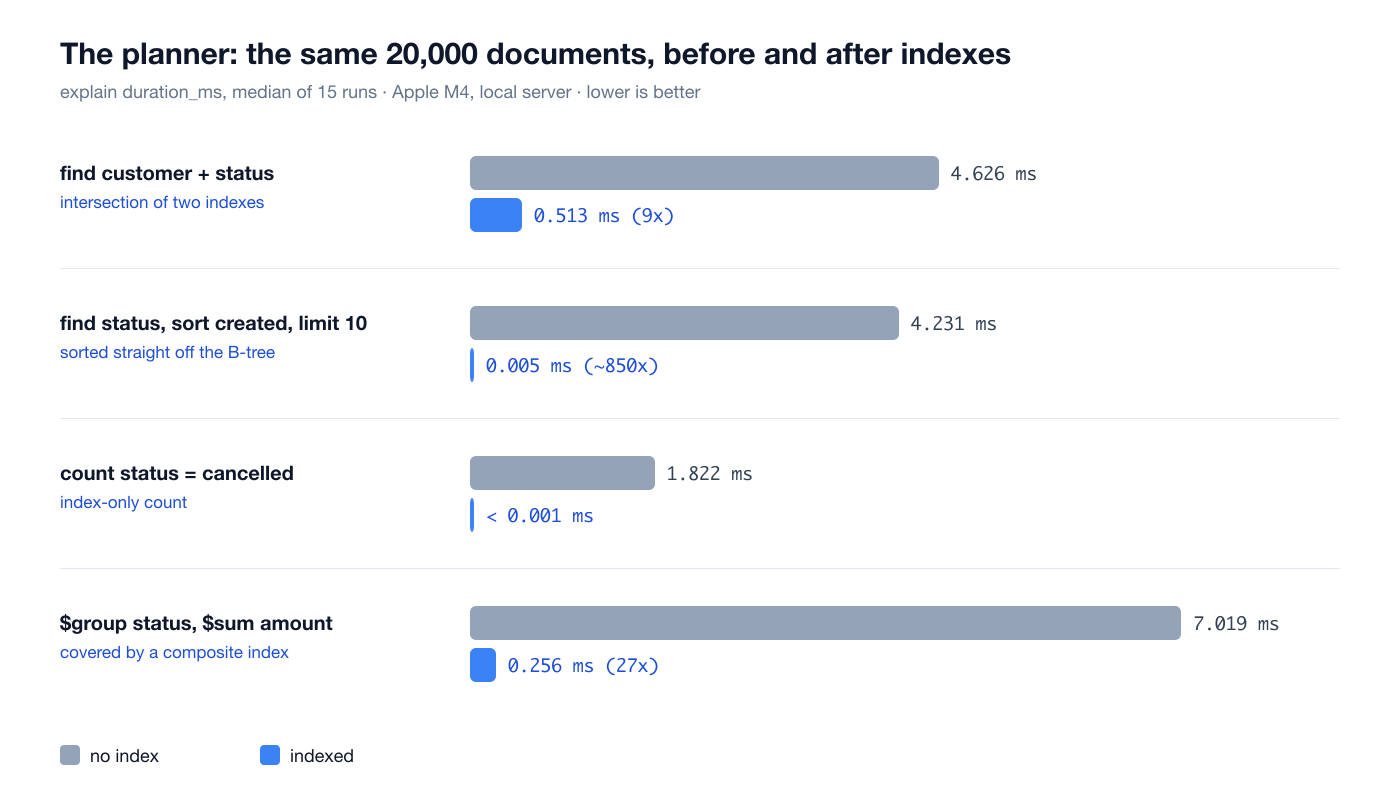
Para ver lo que hace el planificador existe explain. Envuelve un find, un count o un aggregate, informa del plan y ejecuta realmente la consulta para medir su tiempo. El plan lo calculan las mismas funciones que llama la ruta real de la consulta, así que lo que dice explain y lo que hace el motor no pueden divergir. Sin índices:
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "status": "paid"}}}
< {"ok": true, "data": {"strategy": "COLLSCAN", "index_used": null, "collection_docs": 20000, "candidates": null, "examined": 20000, "returned": 18, "post_filter": true, "post_filter_ops": [], "sort": "none", "duration_ms": 4.715}}
Tras crear índices de campo sobre customer, status y created, y un índice compuesto sobre [status, amount]:
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "status": "paid"}}}
< {"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": ["customer", "status"], "collection_docs": 20000, "candidates": 18, "examined": 18, "returned": 18, "post_filter": false, "post_filter_ops": [], "sort": "none", "duration_ms": 0.544}}
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "amount": {"$gt": 400}, "status": {"$ne": "cancelled"}}}}
< {"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": ["customer"], "collection_docs": 20000, "candidates": 34, "examined": 34, "returned": 11, "post_filter": true, "post_filter_ops": ["$ne"], "sort": "none", "duration_ms": 0.015}}
post_filter_ops enumera los operadores que un índice no puede atender. $ne tiene que incluir los documentos que carecen del campo, así que no se responde desde el índice. El planificador reduce a 34 candidatos mediante el índice de customer y evalúa $ne sobre esos 34.
Selectividad e intersección de índices
El planificador estima el coste a partir de los propios índices: el número de claves para una igualdad, el recuento dentro de un rango, la suma para $in. Cuando un $and tiene varias condiciones indexadas, elige la más selectiva (la que devuelve menos documentos) como conductora y la recorre de forma perezosa, intersecándola con los conjuntos de las demás condiciones indexadas.
Al medir esto encontré algo que no esperaba. La intersección materializa primero los conjuntos de las otras condiciones, y status = paid son unos 12.000 documentos, así que la intersección resulta cara:
{'customer': 'c42'}                       INDEX_SCAN ['customer']            0.007 ms
{'customer': 'c42', 'status': 'paid'}     INDEX_SCAN ['customer', 'status']  0.554 ms
{'customer': 'c42', 'items': {'$gte': 5}} INDEX_SCAN ['customer']            0.005 ms
(Mediana de 15 ejecuciones). Un índice sobre un campo poco selectivo hace más lenta esta consulta: filtrar 34 candidatos uno por uno es mucho más barato que construir un conjunto de 12.000 identificadores. La tercera consulta, cuya condición sobre items no tiene índice y cae en un post-filtro, es la más rápida. Una regla mejor se saltaría la intersección cuando el número de candidatos de la conductora es pequeño; eso está en mi lista. Mientras tanto, el consejo práctico es preferir un índice compuesto a un índice independiente sobre campos de baja cardinalidad (estados, indicadores).
Ordenar desde el B-tree, conteo solo con índice, $group cubierto
El planificador tiene tres atajos:
- Ordenar desde el índice. Si el campo de ordenación tiene un índice, el motor recorre el B-tree en orden en lugar de ordenar el resultado, y se detiene cuando se completa el
limit. Si el propio índice del filtro fuera más barato que el recorrido, el planificador renuncia al recorrido; explain se hace la misma pregunta mediante la misma función. - Conteo solo con índice. Para una igualdad indexada,
countlee el número del índice sin tocar ningún documento. $groupcubierto. En un pipeline[$match?] → $groupdonde la clave de agrupación y todos los campos de$sum/$avg/$min/$maxestán en un mismo índice compuesto, la respuesta sale de recorrer ese B-tree. Cada entrada ya tiene la tupla de valores y su número de documentos, así quesum += value × count. No se lee ni se decodifica ningún documento.
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"status": "paid"}, "sort": {"created": -1}, "limit": 10}}
< {"ok": true, "data": {"strategy": "INDEX_SORT", "index_used": "created", "collection_docs": 20000, "candidates": 11949, "examined": 20000, "returned": 10, "post_filter": false, "post_filter_ops": [], "sort": "index-backed", "duration_ms": 0.015}}
> {"cmd": "explain", "inner": {"cmd": "count", "collection": "orders", "query": {"status": "cancelled"}}}
< {"ok": true, "data": {"strategy": "INDEX_ONLY_COUNT", "index_only": true, "post_filter_ops": [], "count": 2037, "duration_ms": 0.0}}
(Para INDEX_SORT, el campo examined informa del peor caso; el recorrido se detiene antes en cuanto se completa el limit).
Las mismas cuatro consultas sin índices y con ellos:
Una advertencia sobre el $group cubierto: si el valor indexado es una cadena que se convirtió en fecha, o la serialización de un array o de un objeto, el motor no puede reproducir el valor original y recurre a la ruta normal. Es un atajo y nunca cambia la respuesta.
Formato de almacenamiento
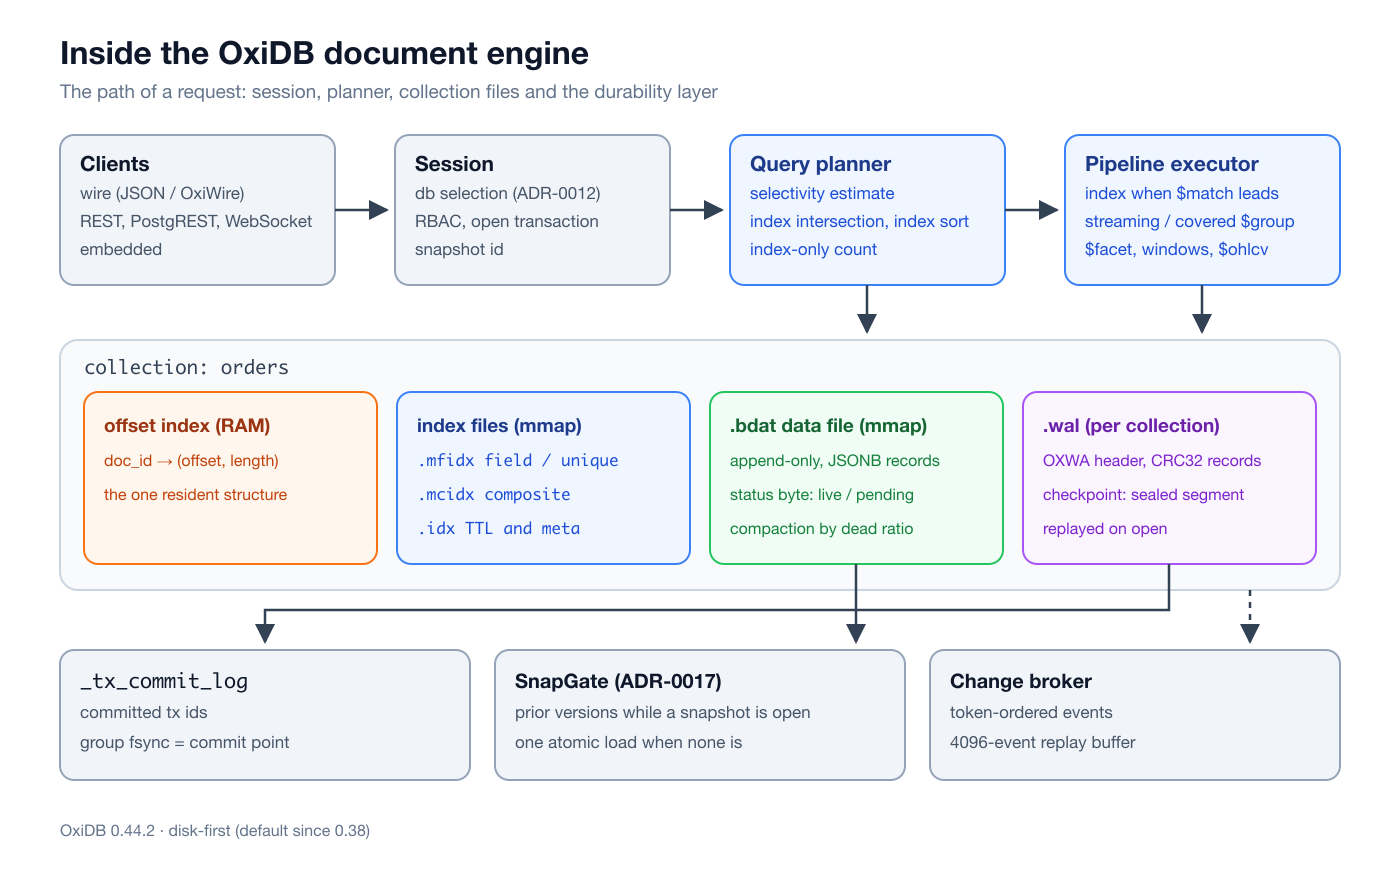
Hasta hace unos meses, OxiDB era en realidad una base de datos en memoria con persistencia en disco: los bytes de cada documento vivían en RAM y el archivo .btree era un snapshot periódico. En una comparación con un millón de documentos, la memoria crecía a la par que los datos. Lo cambié con el modo "disk-first" en el ADR-0009, y es el predeterminado desde la 0.38:
- El archivo de datos
.bdat. Solo de añadido, leído mediante mmap. Cada registro empieza con un byte de estado y una longitud. Una actualización añade el registro nuevo y marca el antiguo como muerto. - El índice de desplazamientos. La única estructura que permanece en RAM:
doc_id → (offset, length), unas pocas decenas de bytes por documento. El ADR-0018 analiza formas de reducirlo aún más, y reconoce abiertamente que con 100 millones de documentos supone un mínimo de varios GB. - Archivos de índice. Los índices de campo como
.mfidxy los compuestos como.mcidx, abiertos mediante mmap detrás de una pequeña capa de escritura en memoria. Al arrancar se mapean, no se reconstruyen. - Compactación. Cuando el espacio muerto es al menos la mitad del archivo y el archivo ocupa al menos 4 MiB, el hilo de mantenimiento escribe los registros vivos en un archivo nuevo y lo intercambia de forma atómica. Los índices están indexados por
doc_id, así que no hay que reindexar nada. - La compresión es opcional. En las propias mediciones del proyecto con un millón de documentos, zstd por registro hacía las agregaciones y la construcción de índices unas cuatro veces más lentas, a cambio de un pequeño ahorro de disco, así que desde la 0.38.9 el valor por defecto es sin comprimir.
OXIDB_DISK_COMPRESSEDla activa.
Las opciones de cada colección se escriben en <name>.bopts, lo que hace que el formato en disco de una colección sea persistente e independiente de las variables de entorno. El directorio de mi base de datos de prueba tenía este aspecto:
$ ls -la data/oxidb | awk '{print $5, $9}'
3313100  orders.bdat
130      orders.bopts
659712   orders.created.mfidx
174430   orders.customer.mfidx
160131   orders.status.mfidx
226177   orders.status_amount.mcidx
347      orders.idx
3713108  orders.wal
0        orders.worm
8        _tx_commit_log
...
$ cat data/oxidb/accounts.bopts
{
  "disk_first": true,
  "compress": false,
  "auto_compact": true,
  "compact_min_bytes": 4194304,
  "compact_dead_ratio": 0.5
}
(Los archivos .worm contienen bloqueos de inmutabilidad a nivel de documento, que quedan fuera del alcance de este artículo).
WAL y durabilidad
Cada colección tiene su propio archivo .wal. Empieza con los bytes mágicos OXWA y una versión, seguidos de registros con la forma [crc32][length][payload]. El primer byte del payload es la operación (insert, update, delete), luego tx_id, doc_id y los bytes JSONB del documento. Con la recuperación a un punto en el tiempo activada, los registros también llevan un número de secuencia global (GSN) y la hora del reloj. Durante la recuperación, un registro cuyo CRC no coincide, o un último registro escrito a medias, se trata como una cola rota y la lectura se detiene ahí. Con xxd:
$ xxd data/oxidb/accounts.wal | head -3
00000000: 4f58 5741 0100 0000 c0e1 8f1e 5600 0000  OXWA........V...
00000010: 0100 0000 0000 0000 0001 0000 0000 0000  ................
00000020: 0040 0000 0410 0000 0310 0000 0810 0000  .@..............
El modo por defecto es estricto: se hace fsync de cada commit antes de comunicar al cliente que tuvo éxito. Los checkpoints se ejecutan en línea y sellan el WAL en lugar de truncarlo: el archivo vivo se renombra como un segmento y empieza un WAL nuevo, así que un checkpoint nunca compite con un escritor.
Lo probé yo mismo. Una transacción escribió en dos colecciones, después siguió una escritura en auto-commit, y entonces maté el servidor con kill -9, sin darle ninguna oportunidad de apagarse, y lo volví a arrancar:
$ python3 crash.py write
> {"cmd": "begin_tx"}
< {"ok": true, "data": {"tx_id": 7}}
> {"cmd": "insert", "collection": "ledger", "doc": {"entry": "debit", "account": "alice", "amount": 250}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "insert", "collection": "ledger_audit", "doc": {"entry": "credit", "account": "bob", "amount": 250}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
> {"cmd": "insert", "collection": "ledger", "doc": {"entry": "note", "text": "auto-commit write"}}
< {"ok": true, "data": {"id": 2}}
$ kill -9 $(cat server.pid)   # immediately, no shutdown
$ ./start.sh
$ python3 crash.py read
> {"cmd": "find", "collection": "ledger", "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 1, "account": "alice", "amount": 250, "entry": "debit"}, {"_id": 2, "_version": 1, "entry": "note", "text": "auto-commit write"}]}
> {"cmd": "find", "collection": "ledger_audit", "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 1, "account": "bob", "amount": 250, "entry": "credit"}]}
Ya sé que una sola muerte del proceso no demuestra nada. La garantía real está en las pruebas de caída del repositorio: matrices de muertes en desplazamientos de bytes concretos, un banco al estilo Jepsen que mata el proceso a mitad de un commit y comprueba que el dinero se conserva, e inyección de fallos de fsync, todo ejecutado con cargo test -- --ignored. Siendo sincero, esas pruebas me han demostrado que estaba equivocado más de una vez. En la 0.40 encontraron un error por el que una transacción que abarcaba dos colecciones podía volver a medio aplicar tras una caída: en modo disk-first, un registro llegaba al archivo de datos antes de que su marca de commit fuera duradera, y la reconstrucción al abrir lo tomaba por vivo. En la 0.44.2, una auditoría del almacenamiento encontró y cerró cinco rutas de recuperación más por las que podía perderse una escritura confirmada. Esa historia es la razón de que exista el mecanismo de "registro pendiente" que se describe más abajo.
Transacciones: OCC y el commit en tres fases
Las transacciones pueden abarcar varios documentos y varias colecciones. El modelo es el control de concurrencia optimista (OCC). Tras begin_tx, las escrituras en la conexión se almacenan en búfer en el servidor ("buffered"), y cada documento leído se registra en un conjunto de lectura con el _version que tenía en ese momento. En el commit se valida el conjunto de lectura:
> {"cmd": "begin_tx"}
< {"ok": true, "data": {"tx_id": 1}}
> {"cmd": "update", "collection": "accounts", "query": {"name": "alice"}, "update": {"$inc": {"balance": -30}}}
< {"ok": true, "data": "buffered"}
> {"cmd": "update", "collection": "accounts", "query": {"name": "bob"}, "update": {"$inc": {"balance": 30}}}
< {"ok": true, "data": "buffered"}
# from another connection, before the commit:
> {"cmd": "find", "collection": "accounts", "query": {}}
< {"ok": true, "data": [{"name": "alice", "balance": 100, "_id": 1, "_version": 1}, {"name": "bob", "balance": 50, "_id": 2, "_version": 1}]}
> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
# after the commit:
< {"ok": true, "data": [{"name": "alice", "balance": 70, "_id": 1, "_version": 2}, {"name": "bob", "balance": 80, "_id": 2, "_version": 2}]}
Si dos transacciones leen y escriben el mismo documento, la segunda en confirmar se entera del conflicto:
A> {"cmd": "begin_tx"}                     B> {"cmd": "begin_tx"}
A> find alice  → balance 70, _version 2    B> find alice → balance 70, _version 2
A> update alice $inc -50  → "buffered"     B> update alice $inc -60 → "buffered"
A> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
B> {"cmd": "commit_tx"}
< {"ok": false, "error": "transaction conflict on 'accounts' doc 1: expected version 2, found 3"}
(Este bloque está condensado a partir de la salida real para mostrar el orden entre dos conexiones; el mensaje de error es el del servidor, literal).
Dentro del commit:
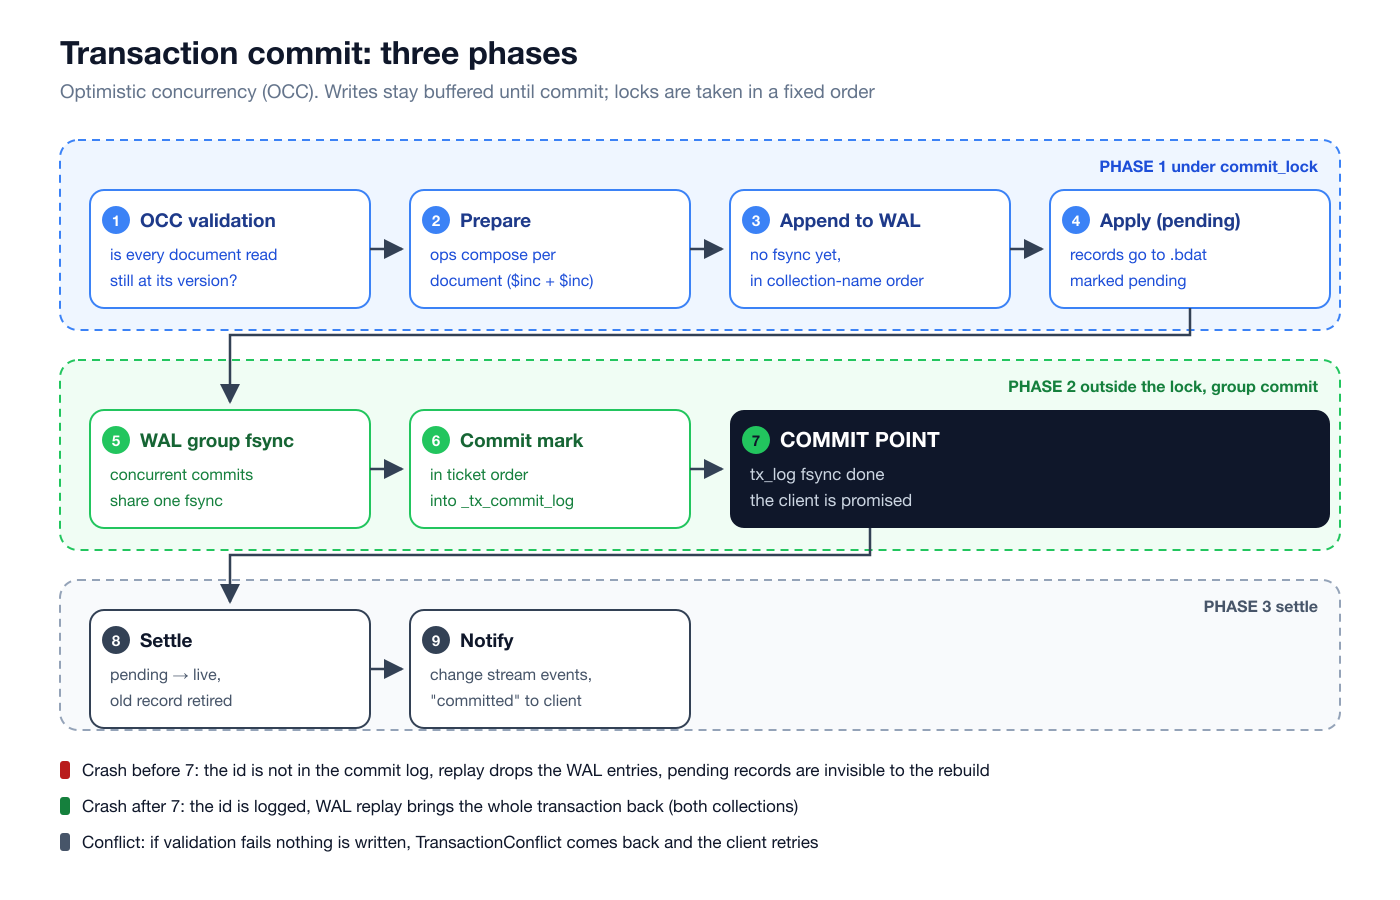
La fase 1 se ejecuta bajo el commit_lock del motor. Se valida el conjunto de lectura. Se preparan las escrituras, componiendo las operaciones sucesivas sobre un mismo documento ($inc -2 y luego $inc +1). Los registros se añaden al WAL de cada colección sin fsync, y después se aplican al archivo de datos como "pendientes". Todo en esta fase es memoria y añadidos en búfer a archivos.
La fase 2 se ejecuta fuera del bloqueo. Se hace fsync de los WAL, pero mediante sync_shared, de modo que las transacciones que confirman al mismo tiempo comparten un único fsync físico (group commit). Luego el identificador de transacción se escribe en _tx_commit_log en orden de ticket, y se completa el fsync de ese archivo. Ese es exactamente el punto de commit. El orden de ticket garantiza que un commit no puede volverse duradero antes que otro commit cuyas escrituras pueda haber leído.
En la fase 3, los registros pendientes pasan a estar vivos y los registros que desplazaron se marcan como muertos. Después se publican los eventos de cambio y el cliente recibe "committed".
La recuperación se apoya en este orden a la inversa. Las entradas del WAL de un tx_id que no está en el log de commits se descartan en la reproducción, y los registros pendientes son invisibles para la reconstrucción. Las entradas de un identificador que sí está en el log se recuperan por completo. Una transacción que abarca dos colecciones está en ambas o en ninguna.
Por qué no puede haber interbloqueos. Las colecciones de una transacción se guardan en un BTreeSet, y los bloqueos siempre se toman en el mismo orden: primero commit_lock, luego las barreras de las colecciones por nombre. Las escrituras directas (no transaccionales) usan el mismo orden. No puede formarse un ciclo de esperas, así que el interbloqueo es estructuralmente imposible.
find_for_update para documentos disputados. Sobre un documento muy disputado (una cuenta de comisiones compartida, por ejemplo), OCC puede convertirse en una tormenta de reintentos. find_for_update bloquea de forma pesimista los documentos coincidentes hasta el commit o el rollback, y los demás hacen cola:
A> {"cmd": "find_for_update", "collection": "accounts", "query": {"name": "bob"}}
< {"ok": true, "data": [{"name": "bob", "balance": 80, "_id": 2, "_version": 2}]}
B> {"cmd": "find_for_update", "collection": "accounts", "query": {"name": "bob"}, "lock_timeout_ms": 300}
< {"ok": false, "error": "lock timeout on 'accounts' doc 2: held by another transaction"}
# waited 305 ms
Estos bloqueos solo excluyen a otros llamantes de for_update; la validación de OCC sigue siendo la red de seguridad de la corrección. Las transacciones abandonadas hacen rollback tras OXIDB_TX_MAX_IDLE_SECS (300 s por defecto), así que un cliente que desaparece no puede dejar bloqueos en el servidor, y a una petición tardía se le responde TransactionExpired en lugar de "not found".
La garantía en sí. docs/isolation.md tiene una tabla de anomalías fijada por pruebas. En resumen: las transacciones confirmadas son serializables respecto a los documentos que leyeron y escribieron. Se evitan las lecturas sucias, las escrituras sucias, las actualizaciones perdidas y el write skew sobre lecturas de elementos. Quedan dos huecos a propósito. El primero son los fantasmas: el conjunto de lectura contiene los documentos devueltos, no el predicado de la consulta. El segundo es que los lectores no transaccionales pueden ver a medio hacer la ventana de aplicación de un commit. Dentro de una transacción no se pueden leer las propias escrituras en búfer antes del commit; hay que calcular el valor que se escribió. Para restricciones de predicado como "como máximo N pedidos abiertos", el patrón recomendado es trasladar la restricción a un documento contador que todo escritor lee y actualiza, de modo que OCC serialice sobre él. El mismo archivo describe un patrón exactly-once basado en un índice único sobre request_id: el recibo se escribe en la misma transacción, y un reintento choca con la violación de unicidad y se convierte en "ya aplicado".
Rendimiento de escritura
Cuando se hace fsync de cada commit, el rendimiento es en realidad el rendimiento del fsync. En macOS, el sync_data de Rust usa F_FULLFSYNC, que vacía de verdad la unidad y tarda milisegundos. Medí tres formas de escritura con 1, 4 y 16 conexiones concurrentes:
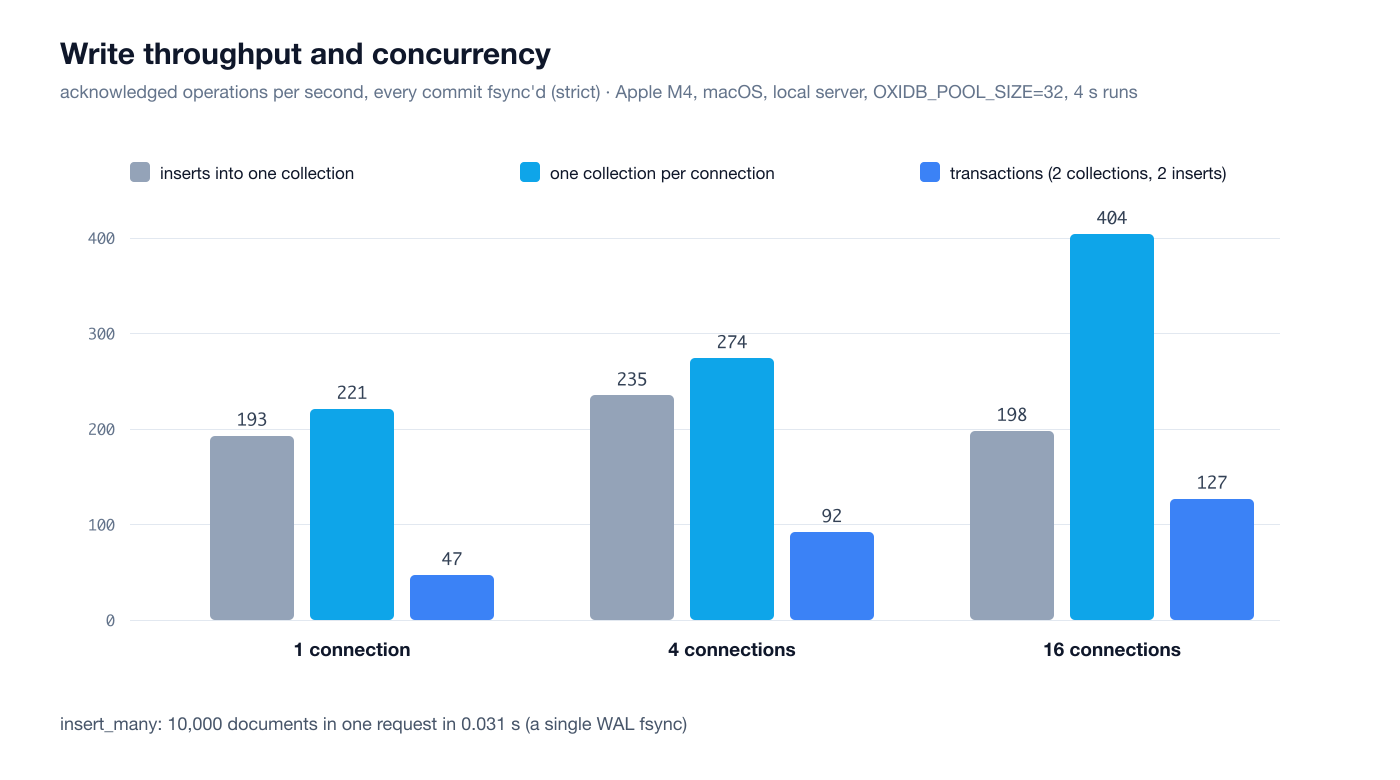
El resultado es instructivo. Las inserciones individuales en auto-commit sobre la misma colección no escalan con las conexiones (193, 235, 198 ops/s), porque esa ruta hace su fsync en serie por colección. Cuando cada conexión escribe en su propia colección, sube a 404/s. Las transacciones pasan de 47 a 127 tx/s gracias al group commit, y cada transacción son cuatro idas y vueltas con una inserción en cada una de dos colecciones. Las escrituras por lotes están en otra categoría: un insert_many de 10.000 documentos tardó 0,031 segundos porque comparte un único fsync del WAL. La lección práctica: agrupar las escrituras pesadas en lotes o en transacciones. Las escrituras individuales, concurrentes y estrictamente duraderas sobre una misma colección son el punto más débil de este motor.
MVCC-lite: snapshots de lectura (ADR-0017)
OCC tenía un hueco deliberado: un lector no transaccional podía ver el documento A después de un commit y el documento B antes de él mientras ese commit se estaba aplicando. Un informe que suma saldos podía producir un total que nunca fue cierto en ningún momento. El ADR-0017 lo corrige solo en la ruta de lectura. La ruta de escritura (OCC, find_for_update, group commit) no se toca.
El mecanismo: mientras hay un snapshot abierto, los escritores añaden los bytes que desplazan a un mapa de versiones en memoria y siguen adelante. Los escritores nunca esperan. Sin ningún snapshot abierto, que es lo predeterminado, el coste es una carga atómica por escritura. Un snapshot comienza bajo commit_lock.write() y cada escritura lógica se registra bajo commit_lock.read(), así que "cada cambio que se hizo visible después de que empezara el snapshot" tiene un límite limpio. aggregate es consistente con snapshot por defecto, y la API explícita de snapshots fija varias consultas en el mismo instante:
> {"cmd": "snapshot_begin"}
< {"ok": true, "data": {"snap": 1000}}
# another connection:
> {"cmd": "update", "collection": "accounts", "query": {"name": "alice"}, "update": {"$set": {"balance": 0}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "insert", "collection": "accounts", "doc": {"name": "carol", "balance": 500}}
< {"ok": true, "data": {"id": 3}}
# the first connection:
> {"cmd": "find", "collection": "accounts", "query": {}}
< {"ok": true, "data": [{"name": "alice", "balance": 0, "_id": 1, "_version": 4}, {"name": "bob", "balance": 85, "_id": 2, "_version": 3}, {"name": "carol", "balance": 500, "_id": 3, "_version": 1}]}
> {"cmd": "snapshot_find", "collection": "accounts", "snap": 1000, "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 3, "balance": 20, "name": "alice"}, {"name": "bob", "balance": 85, "_id": 2, "_version": 3}]}
> {"cmd": "snapshot_aggregate", "collection": "accounts", "snap": 1000, "pipeline": [{"$group": {"_id": null, "total": {"$sum": "$balance"}}}]}
< {"ok": true, "data": [{"_id": null, "total": 105}]}
> {"cmd": "aggregate", "collection": "accounts", "pipeline": [{"$group": {"_id": null, "total": {"$sum": "$balance"}}}]}
< {"ok": true, "data": [{"_id": null, "total": 585}]}
> {"cmd": "snapshot_end", "snap": 1000}
< {"ok": true, "data": "snapshot closed"}
Dentro del snapshot, la actualización de Alice está deshecha y Carol no existe. Los snapshots caducan tras OXIDB_SNAPSHOT_MAX_SECS (300 por defecto). Un snapshot que se mantiene abierto para siempre es, por definición, un error de crecimiento descontrolado, y el límite lo convierte en un error SnapshotExpired para el lector en lugar de bloquear a los escritores.
El ADR explica por qué no construí un MVCC completo. El MVCC completo no complementa a OCC, lo sustituye. Trae problemas de crecimiento descontrolado del tipo que requiere vacuum y cobra el precio del versionado de índices en todas partes, en lugar de solo mientras hay un snapshot activo. La propiedad más valiosa de este motor es que sus garantías son lo bastante pequeñas como para probarlas exhaustivamente frente a caídas, y quería conservar eso.
Change streams y tiempo real
El comando watch convierte una conexión en un change stream, opcionalmente limitado a una colección. Cada evento tiene un token creciente. Las inserciones y actualizaciones llevan el documento nuevo, los borrados el antiguo, y los eventos de una transacción también llevan su tx_id:
W< {"event":"change","data":{"token":1,"operation":"update","collection":"accounts","doc_id":1,"document":{"name":"alice","balance":70,"_id":1,"_version":2},"tx_id":1}}
W< {"event":"change","data":{"token":2,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":80,"_id":2,"_version":2},"tx_id":1}}
W< {"event":"change","data":{"token":3,"operation":"update","collection":"accounts","doc_id":1,"document":{"name":"alice","balance":20,"_id":1,"_version":3},"tx_id":2}}
W< {"event":"change","data":{"token":4,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":85,"_id":2,"_version":3},"tx_id":5}}
La transacción en conflicto (tx 3) y la que hizo rollback (tx 4) nunca aparecen en el stream, lo que se deriva de que los eventos se publican después del punto de commit. Si la conexión se cae, resume_after retoma donde se quedó; el servidor guarda los últimos 4096 eventos en un búfer de reproducción (OXIDB_CHANGE_REPLAY_EVENTS):
> {"cmd": "watch", "collection": "accounts", "resume_after": 3}
< {"ok": true, "data": "watching"}
W< {"event":"change","data":{"token":4,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":85,"_id":2,"_version":3},"tx_id":5}}
El mismo stream está disponible por WebSocket (OXIDB_WS_PORT, {"cmd": "subscribe", "id": "sub1", "collection": ..., "query": ...}), con autenticación JWT y reglas de seguridad a nivel de fila evaluadas por documento.
REST y PostgREST
Hay dos superficies HTTP. La primera es una API REST JSON sencilla:
$ curl -s -X POST localhost:15106/api/products/documents -H "Content-Type: application/json" -d '{"doc":{"sku":"SP-01","name":"Speaker","price":120,"tags":["bluetooth"]}}'
{"id":6}
$ curl -s -X POST localhost:15106/api/orders/aggregate -H "Content-Type: application/json" -d '{"pipeline":[{"$match":{"customer":"c42"}},{"$group":{"_id":"$status","n":{"$sum":1}}},{"$sort":{"n":-1}}]}'
[{"_id":"paid","n":18},{"_id":"shipped","n":9},{"_id":"cancelled","n":7}]
La segunda es una superficie compatible con PostgREST (ADR-0019). /rest/v1/{table} habla la gramática de URL de PostgREST, así que clientes como @supabase/postgrest-js funcionan sin modificaciones, y la misma URL puede llegar a una colección de documentos, a una tabla SQL o a una serie temporal:
$ curl -s "localhost:15106/rest/v1/orders?customer=eq.c42&status=eq.paid&select=order_no,amount,created&order=amount.desc&limit=3"
[{"order_no":7782,"amount":456,"created":"2026-03-14T02:27:01Z"},{"order_no":1028,"amount":444,"created":"2026-04-28T19:05:23Z"},{"order_no":15018,"amount":443,"created":"2026-01-10T02:27:44Z"}]
$ curl -s "localhost:15106/rest/v1/products?or=(price.lt.20,price.gt.200)&select=sku,price"
[{"sku":"MN-27","price":224.1},{"sku":"CB-10","price":8.1}]
Sin OXIDB_JWT_SECRET, la API REST queda abierta sin autenticación, y el servidor imprime una advertencia al respecto al arrancar. En producción conviene usar JWT o una red privada.
Varias bases de datos (ADR-0012)
Un solo proceso puede alojar varias bases de datos, cada una en su propio directorio (data/oxidb, data/tenant_a, ...). Una base de datos abarca tanto el espacio de nombres documental como el espacio de nombres SQL, a los que se accede con el mismo nombre. Cada petición puede llevar un campo db, o la sesión puede cambiar con use_db:
> {"cmd": "create_database", "name": "tenant_a"}
< {"ok": true, "data": "database 'tenant_a' created"}
> {"cmd": "insert", "collection": "orders", "db": "tenant_a", "doc": {"order_no": 1, "amount": 42}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "list_databases"}
< {"ok": true, "data": ["oxidb", "postgres", "tenant_a"]}
> {"cmd": "use_db", "name": "tenant_a"}
< {"ok": true, "data": "switched to database 'tenant_a'"}
> {"cmd": "count", "collection": "orders"}
< {"ok": true, "data": {"count": 1}}
> {"cmd": "use_db", "name": "oxidb"}
< {"ok": true, "data": "switched to database 'oxidb'"}
> {"cmd": "count", "collection": "orders"}
< {"ok": true, "data": {"count": 20000}}
postgres es un alias de la base de datos predeterminada para los clientes del protocolo de PostgreSQL. La transacción abierta de una sesión está ligada a la base de datos en la que empezó, y una petición a otra base de datos se rechaza hasta el commit. La replicación con Raft también transporta el DDL de bases de datos y las escrituras con ámbito. Las consultas y transacciones entre bases de datos quedan deliberadamente fuera del alcance.
Blobs
El motor documental también incluye un pequeño almacén de objetos: buckets, claves, un tipo de contenido y metadatos. Sirve para facturas, adjuntos y archivos pequeños:
> {"cmd": "put_object", "bucket": "invoices", "key": "2026/10/INV-1001.txt", "data": "SW52b2ljZSAxMDAxOiAzIHgga2V5Ym9hcmQ=", "content_type": "text/plain", "metadata": {"customer": "c42"}}
< {"ok": true, "data": {"key": "2026/10/INV-1001.txt", "bucket": "invoices", "size": 26, "content_type": "text/plain", "etag": "2d01298f4acb19ac183c86e3fbe43e3d", "created_at": "2026-10-11T21:36:35Z", "metadata": {"customer": "c42"}, "stored_size": 26, "format_version": 1}}
El texto dentro de los blobs (PDF, DOCX, HTML y más) también puede alimentar la búsqueda de texto completo. La superficie que habla con clientes S3 reales es otro tema: el artículo sobre almacenamiento de objetos S3.
Límites y compromisos honestos
- Anterior a la 1.0. El formato en disco, el protocolo de red y el lenguaje de consultas pueden cambiar entre versiones sin ruta de migración. Conviene fijar una versión, y volcar y recargar al actualizar.
- La igualdad sobre arrays no es la de MongoDB.
{"tags": "usb"}no mira dentro del array; hay que usar$allo$elemMatch. - Fantasmas y restricciones de predicado. Las transacciones son serializables sobre los documentos que leen, no sobre predicados. Los
find/countsimples son read-committed. Para una vista consistente, usaraggregateo un snapshot explícito. - No se pueden leer las propias escrituras dentro de una transacción. Las escrituras se componen en el commit.
- Las escrituras individuales, concurrentes y estrictas sobre una misma colección no escalan. Hay que agruparlas en lotes o en transacciones.
- La intersección de índices es cara con índices poco selectivos. Para campos de baja cardinalidad, mejor índices compuestos.
- Hay un mínimo residente. El índice de desplazamientos crece con el número de documentos, y los conjuntos de resultados grandes todavía se materializan en memoria; los frames de resultados en streaming están diseñados en el ADR-0026.
$filly$densifyaceptan claves de partición distintas, y las claves desconocidas se ignoran en silencio.
Cómo encaja con el resto de OxiDB
El motor documental es el suelo sobre el que se apoya el resto de OxiDB. El WAL, el log de commits, el cifrado, las copias de seguridad y la recuperación a un punto en el tiempo usan su maquinaria. Las colecciones de ingesta de logs y su retención basada en TTL son colecciones suyas. Los índices de texto completo y vectoriales y las etapas geoespaciales y de grafos se ejecutan en su pipeline. Los motores SQL y de series temporales son deliberadamente motores separados con archivos separados, pero viven en el mismo proceso, bajo el mismo modelo de seguridad y el mismo selector de base de datos, todo en un solo binario.
Probarlo
Los binarios están en las releases de GitHub: github.com/parisxmas/OxiDB/releases (macOS arm64/x86_64, Linux x86_64/arm64, Windows). Se descarga, se descomprime y se ejecuta:
tar xzf oxidb-server-*.tar.gz
./oxidb-server
Con Docker basta con docker compose up -d. Por defecto escucha en 127.0.0.1:4444 y escribe en ./oxidb_data/. Las peticiones de este artículo se pueden probar tal cual con el pequeño cliente de Python de arriba. El siguiente artículo de la serie es búsqueda de texto completo y vectorial, que funciona sobre estas mismas colecciones.