fastroute: un autorouter de PCB rápido y de código abierto para KiCad (portando Freerouting a Rust)
Un port fiel de Freerouting a Rust: resultados idénticos byte a byte a Java, cinco veces más velocidad y mucha menos memoria, errores antiguos corregidos, vista en vivo, igualación de longitudes, pares diferenciales, impedancia controlada y un plugin para KiCad. Mediciones y capturas de ejecuciones reales.
La parte más larga del diseño de una placa de circuito impreso (PCB) suele ser el enrutado: convertir cientos de conexiones en pistas de cobre que nunca se acerquen entre sí más de una distancia fijada, cambiando de capa mediante vías. La herramienta de código abierto a la que los usuarios de KiCad llevan años recurriendo es Freerouting, un autorouter escrito en Java. fastroute es Freerouting portado a Rust: los mismos algoritmos, la misma entrada y salida (Specctra .dsn → .ses), la misma línea de comandos; pero sin Java, varias veces más rápido y con una fracción de la memoria.
En este artículo recorro el proyecto de principio a fin: por qué y cómo lo porté, qué significa producir resultados "idénticos byte a byte" a los de Java, las aceleraciones que no cambian el resultado, los errores que se corrigieron y las funciones nuevas que Freerouting no tiene (igualación de longitudes, pares diferenciales, impedancia controlada, una vista en vivo). Hice las capturas de la vista en vivo ejecutando el proyecto en mi propia máquina; en todo momento indico qué mediciones son mías y cuáles proceden de los documentos del proyecto.
Sitio del proyecto: fastroute.baltavista.com · código fuente: github.com/parisxmas/fastroute. (Cuidado con el nombre parecido: no tiene relación con FastRoute, el enrutador global para diseño de circuitos integrados que se usa en OpenROAD.)
¿Por qué reescribir Freerouting?
Freerouting es un buen enrutador; sus algoritmos han madurado con los años y se han probado en muchas placas reales. Pero al usarlo había tres cosas que surgían una y otra vez:
- Java. Usar el plugin de KiCad requiere un runtime de Java aparte: instalación, incompatibilidades de versión y gigabytes de memoria en placas grandes.
- Velocidad. Una placa de tamaño medio puede tardar minutos; una grande, horas.
- Errores. Al leer el código encontré errores que afectan directamente al resultado y que llevaban años ahí. Por ejemplo, cuando el autorouter se detiene por sí mismo, el optimizador no llega a ejecutarse nunca, porque la petición de parada sigue activa y todos los candidatos del optimizador fallan como "detenidos".
En lugar de escribir un enrutador nuevo desde cero, opté por portar Freerouting fielmente. La gran ventaja es que es medible: la pregunta "¿es correcto el port?" tiene una respuesta definida. Con la misma placa y los mismos ajustes, si produce la misma salida que Java, es correcto. Las aceleraciones y mejoras las puse únicamente sobre esa base sólida.
Estructura del proyecto
fastroute es un workspace de Cargo: unas 70.000 líneas de Rust, más unas 2.400 líneas de Python para el plugin de KiCad:
| Crate | Contenido |
|---|---|
fr-dsn | Lector de S-expressions de Specctra y modelo DSN tipado |
fr-geom | Geometría plana (el equivalente del paquete geometry.planar de Java) |
fr-jcompat | Emulación exacta a nivel de bits del comportamiento de la biblioteca de Java del que depende el enrutador |
fr-settings | Ajustes del enrutador, valores por defecto, fuentes de ajustes desde la línea de comandos y desde el DSN |
fr-engine | Modelo de placa, árboles de búsqueda, autorouter, pull-tight/shove/optimizador, DRC, puntuación, pipeline |
fr-io | Cargador DSN → placa, procesamiento posterior a la carga, escritor y lector de SES |
fastroute | Herramienta de línea de comandos y servidor de la vista en vivo |
El port avanzó de abajo arriba por unidades: primero la capa de compatibilidad con Java, las estructuras de datos, las reglas y la biblioteca; después los elementos de la placa y los árboles de búsqueda (unas 13.000 líneas de Java), el DRC y la puntuación, la optimización y la placa de enrutado, el núcleo del autorouting (expansion rooms, búsqueda en laberinto, búsqueda de caminos) y, por último, el pipeline. El primer commit fue el 27 de septiembre; 82 commits después, el 7 de octubre salió la versión 0.1.13.
¿Qué significa "idéntico byte a byte"?
En el modo --parity, fastroute produce un archivo SES idéntico byte a byte al que escribe el modo determinista de Freerouting (optimizador de un solo hilo, límites de tiempo basados en recuentos). Antes de escribir esa afirmación lo probé yo mismo. Enruté la placa interf_u de las demos de KiCad en mi Apple M4 con fastroute 0.1.13 en modo --parity y comparé la salida con la salida de referencia de Java que se guarda en el proyecto:
$ fastroute -de interf_u.dsn -do interf.ses --parity
...
   12.563 INFO  routing finished in 12.55 s

$ cmp reference/parity-baseline/interf_u.ses interf.ses && echo IDENTICAL
IDENTICAL
$ shasum -a 256 reference/parity-baseline/interf_u.ses interf.ses
2e174236513ccab65daa…  reference/parity-baseline/interf_u.ses
2e174236513ccab65daa…  interf.ses
Llegar ahí exige mucho más que portar correctamente los algoritmos. El resultado del enrutador depende de los comportamientos más sutiles de la biblioteca estándar de Java. Por ejemplo:
- Números aleatorios. El optimizador y las mezclas de orden usan
java.util.RandomyCollections.shuffle. Reproducir el mismo orden requiere una copia exacta del generador lineal congruencial de 48 bits y del bucle de rechazo basado en desbordamiento denextInt(bound). - Comparadores no transitivos. En algunos sitios se usa el
TreeMapde Java con comparadores que no son matemáticamente transitivos. El resultado depende entonces de la estructura rojinegra del árbol, así queTreeMapse reescribió por separado, con las mismas reglas de equilibrado. - Orden del hash. El orden de iteración de un
HashMap<Integer, …>afecta al resultado exactamente en un lugar; ahí se emula el orden de iteración de Java. - Coma flotante. Se conserva el orden de las operaciones y no se usa
mul_add(fused multiply-add); las puntuaciones se calculan enf32con las mismas conversiones que en Java; se usan la suma compensada deDoubleStream.sumy fdlibm (libm) para la trigonometría. - Comparación de cadenas.
String.compareTotrabaja con unidades de código UTF-16. - La forma del árbol de búsqueda. Algunas consultas geométricas recorren el árbol por sí mismas y van reduciendo la consulta sobre la marcha; el orden de visita cambia las rooms que se generan. Por eso el
MinAreaTreede Rust reproduce la forma exacta del árbol de Java.
Este es un fragmento del port de java.util.Random en fr-jcompat. La condición de rechazo de Java, que se apoya en el desbordamiento de enteros, se escribe explícitamente en Rust con wrapping_sub y wrapping_add:
/// `protected int next(int bits)`, `1 <= bits <= 32`.
#[inline]
pub fn next(&mut self, bits: u32) -> i32 {
    debug_assert!((1..=32).contains(&bits));
    self.seed = self.seed.wrapping_mul(Self::MULTIPLIER).wrapping_add(Self::ADDEND) & Self::MASK;
    // (int) (nextseed >>> (48 - bits))
    ((self.seed as u64) >> (48 - bits)) as i32
}

/// `Random.nextInt(int bound)`. Panics if `bound <= 0` (Java throws `IllegalArgumentException`).
pub fn next_int_bound(&mut self, bound: i32) -> i32 {
    assert!(bound > 0, "bound must be positive");
    let mut r = self.next(31);
    let m = bound - 1;
    if (bound & m) == 0 {
        // power of two
        r = ((bound as i64 * r as i64) >> 31) as i32;
    } else {
        let mut u = r;
        loop {
            r = u % bound;
            // Java relies on int overflow to reject values from the incomplete last range.
            if u.wrapping_sub(r).wrapping_add(m) >= 0 {
                break;
            }
            u = self.next(31);
        }
    }
    r
}
La corrección se comprobó capa a capa: un volcado canónico de la placa tras la carga, estadísticas exactas a nivel de bits, marcadores de traza por conexión, hash y puntuación por pasada y, por último, el diff del SES. El primer gran hito fue que el SES "sin enrutar", escrito con el enrutado desactivado, fuera idéntico al de Java en las 20 placas de benchmark; el lector de DSN también se probó con 2.470 archivos de ejemplo. Después llegó el pipeline completo: en modo --parity, 20 de 20 placas son idénticas byte a byte a Java.
Lo único que deliberadamente no se portó son los errores del lector de DSN de Java. En 12 de los archivos de ejemplo, el escáner JFlex elimina de los nombres las letras no ASCII, pierde la sincronización en algunas cadenas entre comillas o desplaza un carácter del nombre de un pin al pin siguiente. fastroute los lee correctamente, así que esas placas no pueden compararse con Java.
La vista en vivo
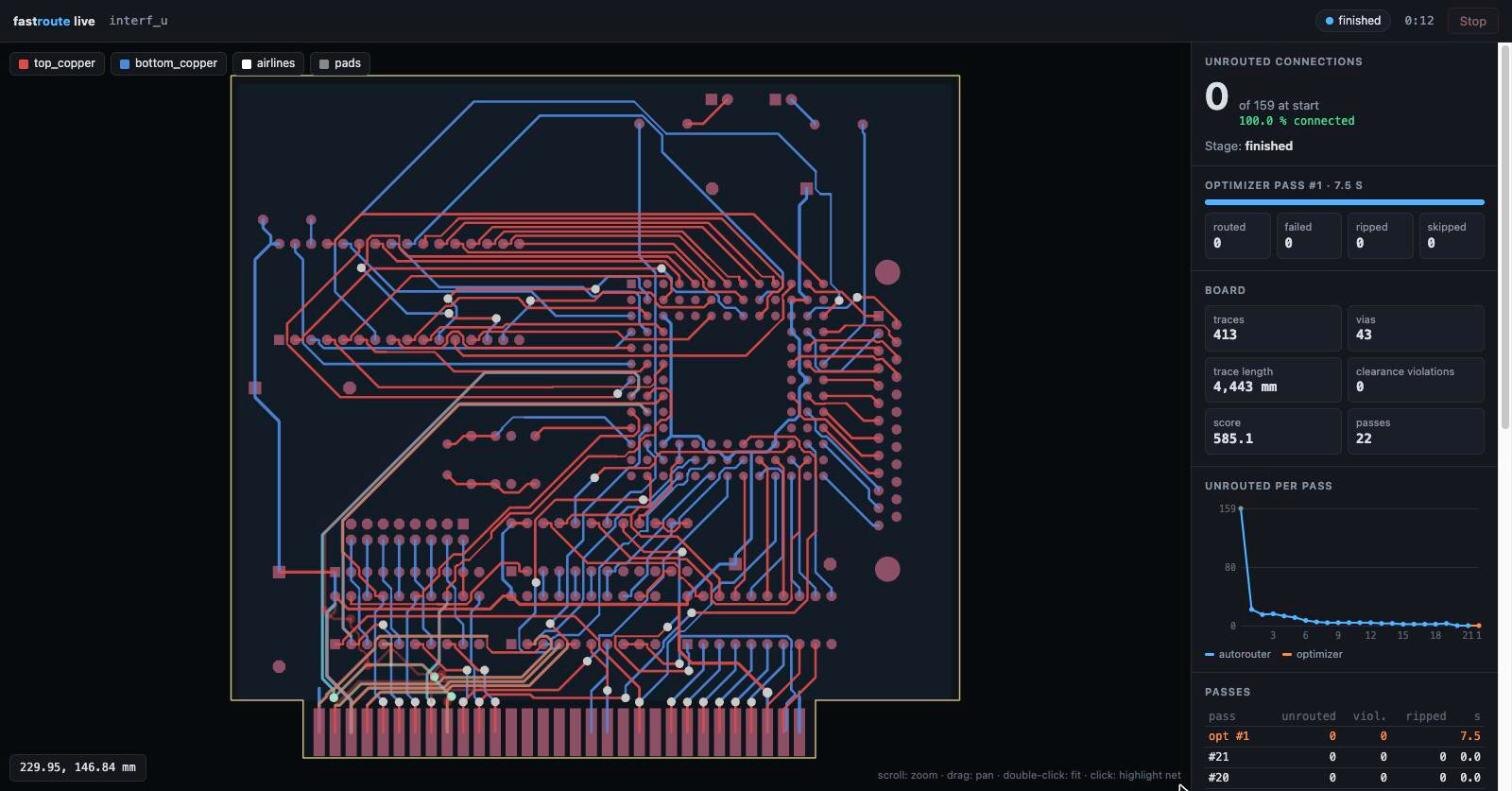
Lo primero que Freerouting no tiene: ver cómo se enruta la placa en el navegador. Con --live, fastroute abre una página local que no necesita internet. Ahí están las pistas que aparecen y se arrancan, las conexiones restantes (airlines), el progreso de cada pasada, un gráfico de conexiones sin enrutar por pasada, las violaciones de distancia, la puntuación y el registro. Hay zoom, activación y desactivación de capas, resaltado de nets y un botón "Stop" que conserva el mejor resultado. Los resultados son los mismos con o sin la vista en vivo.
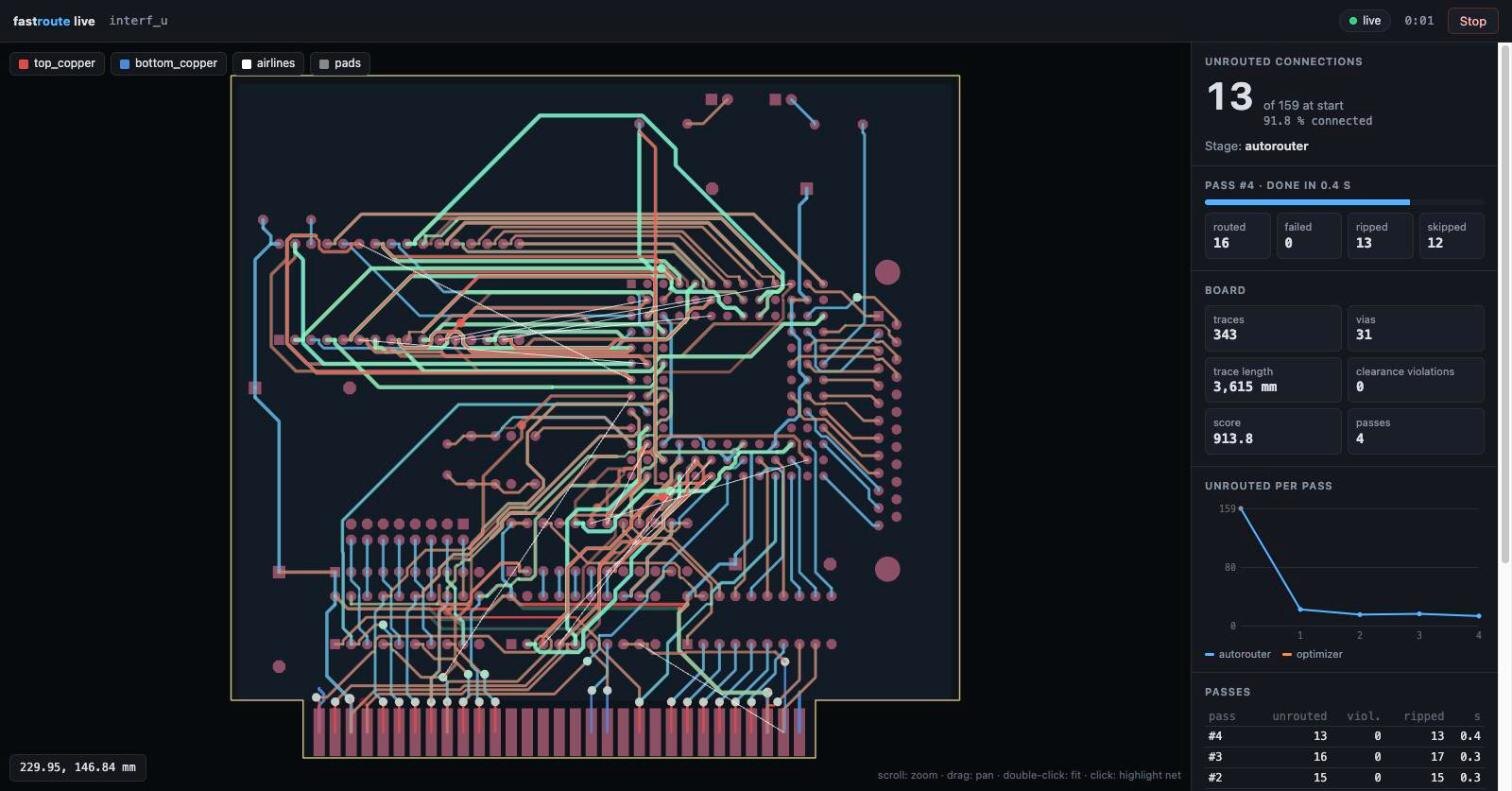
El fotograma anterior corresponde a la pasada 4 de la placa interf_u. Las pistas verdes son las colocadas en esa pasada; las líneas blancas, las conexiones aún sin enrutar. La placa empieza con 159 conexiones y baja de 20 en la primera pasada, como muestra el gráfico de la derecha. En el estado final de la imagen de portada, las 159 conexiones están enrutadas sin ninguna violación.
Como ejemplo más difícil ejecuté la placa CM5_MINIMA_3 de 6 capas (una placa portadora para el Raspberry Pi Compute Module 5). Esta placa no puede enrutarse por completo. Para las conexiones restantes, fastroute vuelve a ejecutar el enrutador en paralelo con distintos órdenes en su etapa multi-start:
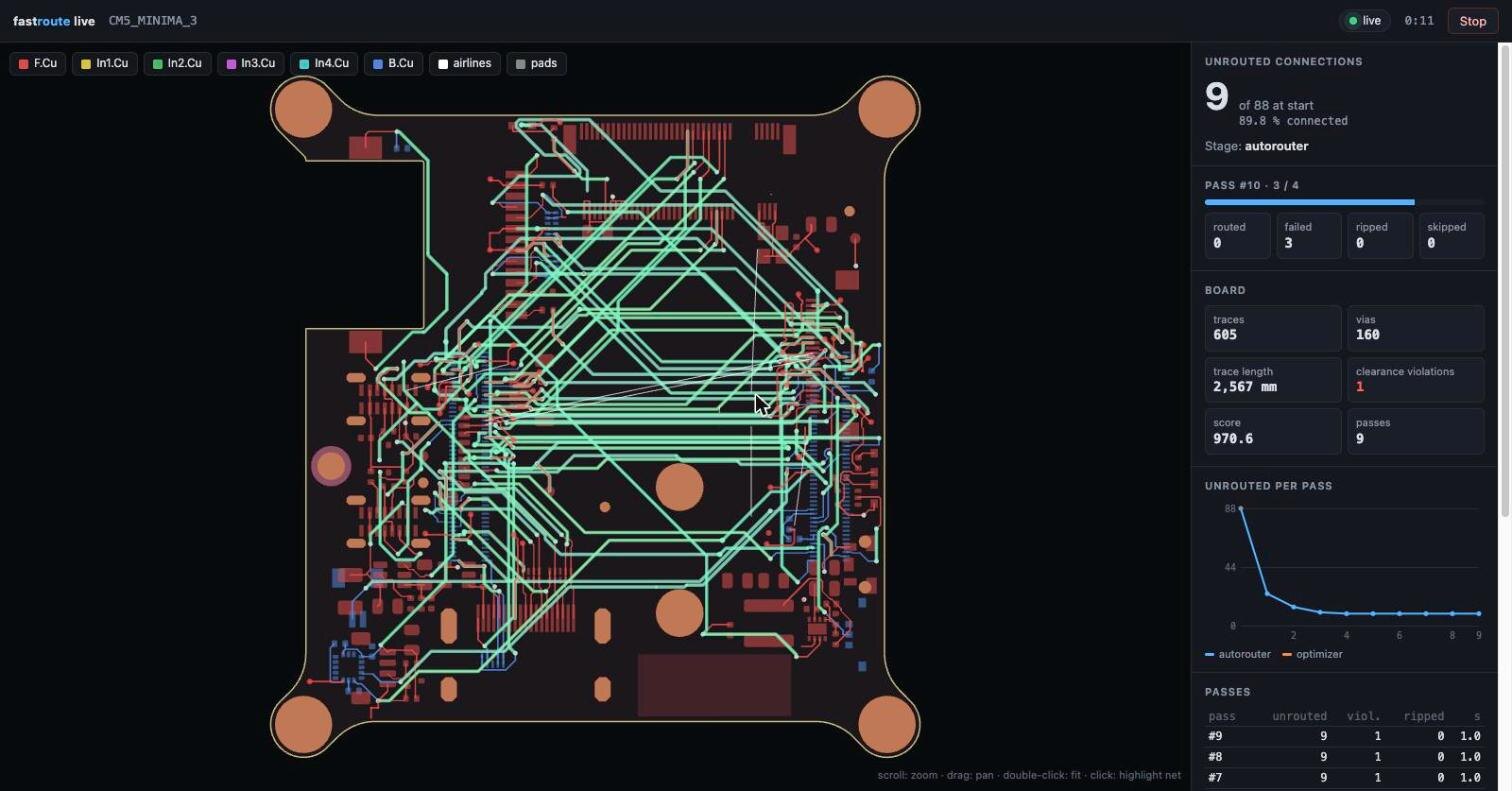
La ejecución terminó en 41 segundos en mi máquina, con 7 de 88 conexiones pendientes. Eso coincide exactamente con la mejora "CM5: 8 → 7 sin enrutar" de los documentos del proyecto; la única violación restante ya existía antes, entre dos elementos fijos del diseño cargado.
Acelerar sin cambiar el resultado
Una vez que el port funcionó correctamente, empezaron las aceleraciones. La regla era sencilla: ningún paso puede cambiar el resultado. Después de cada paso se comprobaban todas las pruebas, el pipeline completo en 10 placas y que el optimizador paralelo diera el mismo resultado con 1 y con 8 hilos. Con FASTROUTE_VERIFY_CACHES=1, cada resultado memoizado o indexado se calcula también a la manera antigua y se compara. Lo más destacado:
- Listas de contactos memoizadas, cacheadas según "épocas" de contenido del repositorio de elementos y del árbol de búsqueda. CM5: 22,7 → 13,7 s; solo la etapa de fanout, 18,9 → 1,8 s.
- Máscaras de capa en el árbol de búsqueda. Cada hoja lleva el bit de su capa y los nodos internos la unión; las consultas a las que no les importa otra capa se saltan subárboles enteros. CM5: 13,4 → 10,5 s.
- Un índice espacial secundario. Una rejilla jerárquica por capa sobre los rangos de hojas; el resultado ordenado de Java se conserva exactamente.
- Pruebas de intersección sin copias en la geometría, la eliminación de un O(n²) en las comprobaciones de shove y el asignador mimalloc.
- Streaming en el optimizador paralelo: los candidatos se reparten a los hilos en orden y los resultados se consumen estrictamente en el orden de los candidatos, de modo que el resultado no depende del número de hilos.
- Optimización guiada por perfiles (PGO): una compilación entrenada con sus propias placas, otro 13-18 %.
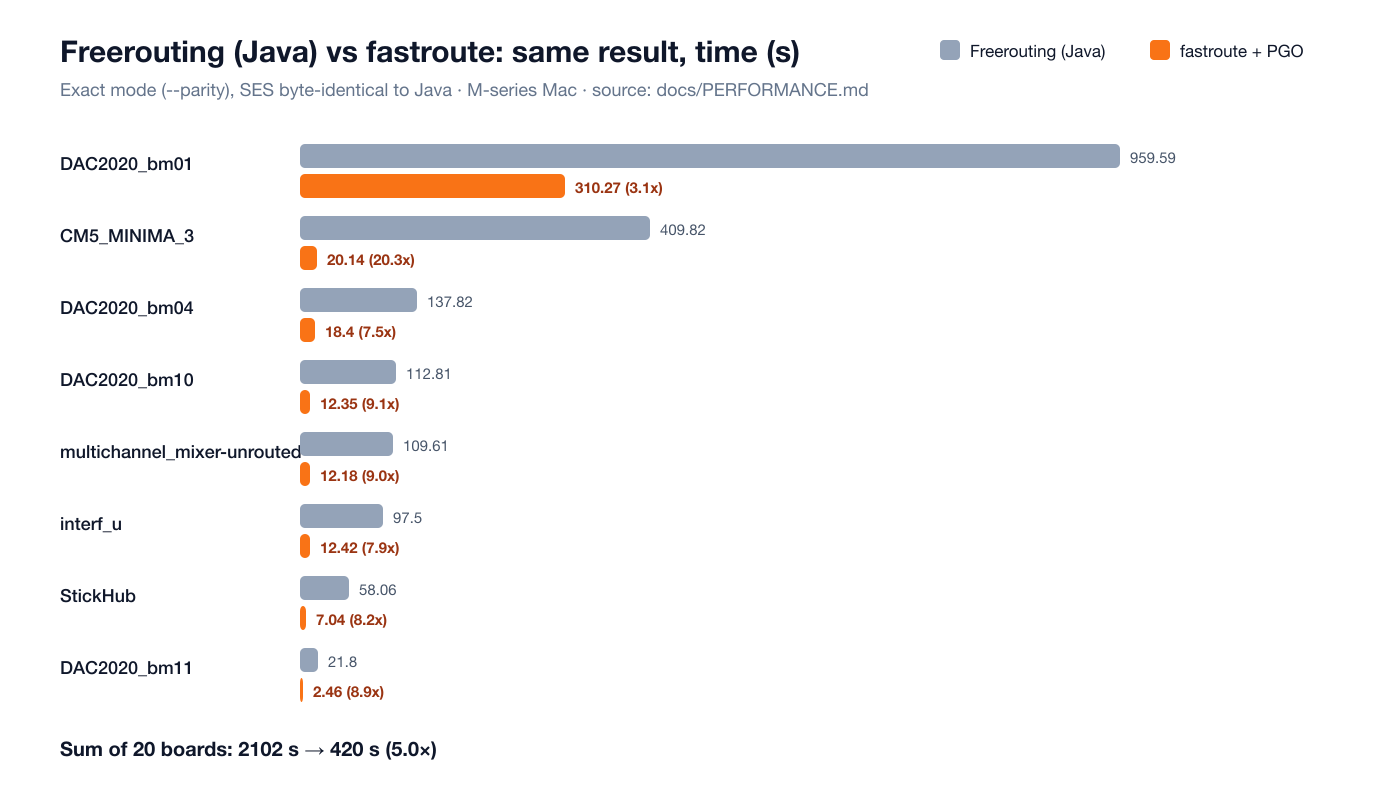
En las mediciones del propio proyecto (Mac de la serie M, modo exacto, arranque de la JVM incluido), la suma de 20 placas pasa de 2.102 segundos a 420 segundos, unas 5 veces. La aceleración por placa va de 3 a 60 veces. Mi propia medición para interf_u:
| Tiempo | Memoria pico | Resultado | |
|---|---|---|---|
| Freerouting (Java), la referencia del proyecto | 97,5 s | 1.417 MB | 0 sin enrutar, 0 violaciones |
fastroute 0.1.13, --parity | 12,6 s | 166 MB | SES idéntico byte a byte a Java |
| fastroute 0.1.13, por defecto (paralelo) | 3,3 s | 449 MB | 0 sin enrutar, 0 violaciones |
El modo por defecto ejecuta el optimizador en paralelo. Sus resultados no son idénticos a los de Java, pero son deterministas para cualquier número de hilos. La memoria en el modo paralelo recibió atención propia: una copia de la placa era antes una copia profunda de 37 MB. Los elementos y los nodos del árbol se dividieron en bloques de 64 copiados al escribir (CowVec), y ahora una copia cuesta 1-3 MB. En una placa de prueba de 874 componentes y 6 capas, la memoria pico bajó de 2.593 MB a 1.103 MB.
Errores corregidos
Un efecto secundario agradable de un port fiel es que los errores del código Java quedan a la vista. Se corrigen por defecto (--parity conserva exactamente el comportamiento de Freerouting). Algunos de ellos:
| En Freerouting | En fastroute |
|---|---|
| Cuando el autorouter se detiene por sí mismo, la petición de parada sigue activa; todos los candidatos del optimizador fallan y, en la práctica, el optimizador nunca se ejecuta | La parada propia del enrutador se retira antes del optimizador |
| Cuando la regla de estancamiento detiene el autorouter, se omite la eliminación final de colas; los escapes de fanout sin usar (vía + stub) se quedan en la placa | Las colas se eliminan en todos los casos |
| La puntuación del optimizador se limita a 0; en placas cuya puntuación está por debajo de 0 (p. ej. DAC2020_bm01) nunca puede aceptarse ningún candidato | Se comparan las puntuaciones sin limitar (bm01: −182 → 107) |
| Se rechaza una conexión que termina en una vía hacia la capa de plano de su propia net | Esas conexiones se aceptan (de 24 a 0 sin enrutar en una placa ESP32-S3 de 4 capas) |
| A partir del segundo fallo, una conexión que falla arranca toda su net cada vez; las nets grandes (GND, 3V3) oscilan | La net se arranca una sola vez |
| Las pistas de las nets con un pad sobre el borde de la placa o fuera de él ignoran por completo el contorno y pueden salirse de la placa | El exterior del contorno es una zona prohibida (keepout), salvo justo alrededor de esos pads |
| El lexer de DSN elimina las letras no ASCII y pierde la sincronización en algunas cadenas entre comillas | Se analizan correctamente |
Un enrutador mejor
Más allá de los errores, también se mejoraron el enrutado y la optimización:
- Pasadas de autorouting en paralelo. Freerouting enruta las conexiones de una pasada una tras otra. fastroute trabaja con hasta dos conexiones por hilo a la vez, cada una sobre una copia de la placa tal como estaba cuando empezó la conexión, y confirma los resultados en el orden de inicio. En la placa de prueba de 874 componentes, la etapa de enrutado pasó de 1.413 s a 508 s con 8 hilos.
- Multi-start (
--multi-start). Si quedan conexiones, el enrutador se vuelve a ejecutar en paralelo con órdenes mezclados y se conserva el mejor resultado (bm05: 7 → 2, StickHub: 3 → 1 sin enrutar). - Deshacer pasadas malas. Una pasada que termina mucho peor que la mejor hasta el momento se deshace; Java seguía adelante desde la placa peor.
- El optimizador en placas parcialmente enrutadas (Freerouting omite el optimizador si queda aunque sea una conexión) y pasadas voraces que aplican no solo el mejor candidato de cada pasada, sino también los demás que mejoran.
- Puntos de control y límites de tiempo. El archivo de sesión contiene siempre la mejor placa hasta el momento;
--max-time, Ctrl+C o SIGTERM detienen la ejecución y conservan el resultado. - Diagnóstico.
--reportescribe un resumen JSON con cada conexión sin enrutar y cada violación.--diagnosevuelve a enrutar por separado cada conexión sin enrutar y clasifica el motivo: ¿estorban otras pistas (congestión) o son la geometría o las reglas (bloqueo)?
Igualación de longitudes
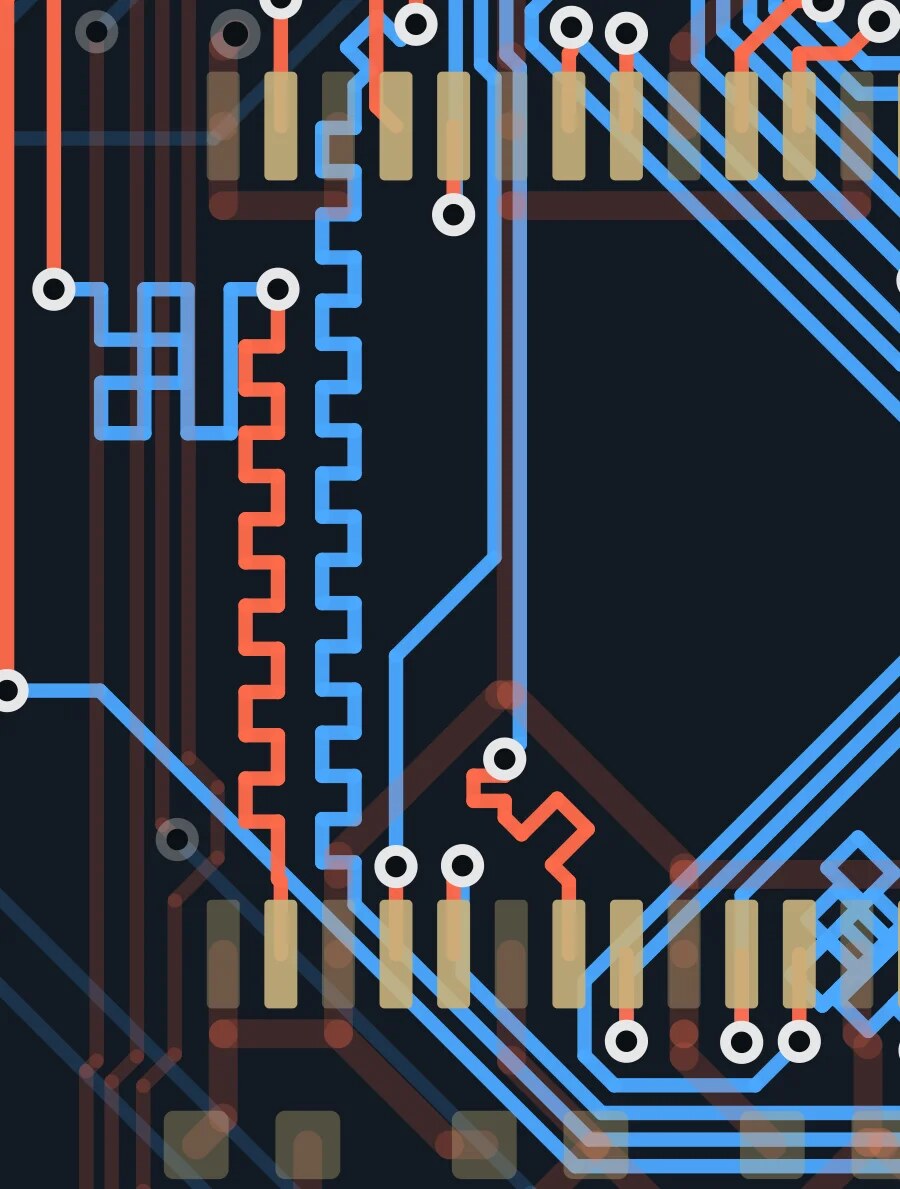
Freerouting no tiene igualación de longitudes. Tras enrutar y optimizar, fastroute puede igualar grupos de nets (un bus de memoria, por ejemplo). El objetivo es la net más larga del grupo o una longitud dada. Se añaden meandros serpenteantes a los segmentos rectos más largos de las nets más cortas. Cada meandro se prueba sobre una copia de la placa y solo se conserva si una pista de prueba algo más ancha no tiene ninguna violación de distancia, de modo que el resultado también queda limpio en el DRC de KiCad. Igual que hace KiCad, se suma a la longitud la altura del stackup que atraviesa una vía.
Pares diferenciales
Freerouting enruta las dos nets de un par de forma independiente, así que rara vez discurren una junto a otra. Con --pairs, fastroute enruta primero los pares sobre la placa vacía y hace que una net siga a la otra a la separación del par. Las pistas de la net principal se encadenan y se desplazan lateralmente, el camino desplazado se comprueba en cuanto a distancias en tramos de 0,2 mm, los tramos libres se convierten en las pistas de la net seguidora y el enrutador de laberinto los une a los pines. El cambio solo se conserva si no se pierde ninguna conexión y mejora la puntuación "longitud acoplada − 0,5 × diferencia de longitud". Por último, la net más corta recibe meandros hasta que las dos longitudes quedan dentro de la tolerancia.
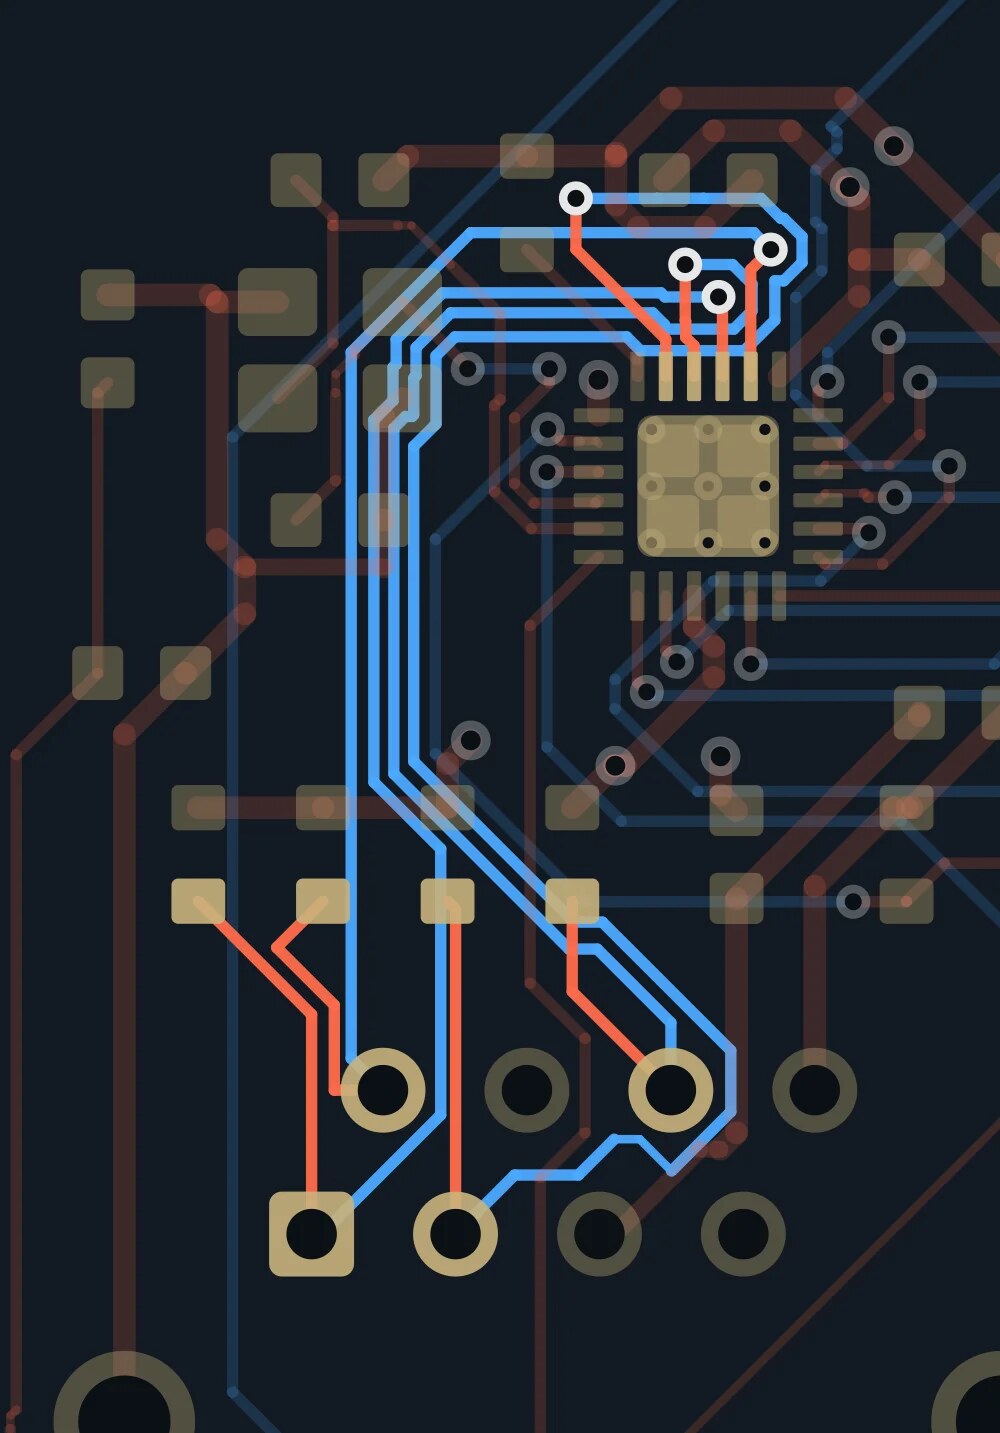
En la placa de prueba STM32H7 del proyecto (4 capas, USB y dos pares de Ethernet), los desfases dentro de cada par pasaron de 1,8 / 2,7 / 14,5 mm a 0,1 / 0,25 / 0,25 mm, sin conexiones sin enrutar y sin errores de DRC de KiCad.
Impedancia controlada
Freerouting tiene un ancho de pista por clase de net y capa; no sabe nada de impedancia. impedance_cli.py, en el plugin de KiCad de fastroute, calcula los anchos de pista a partir del stackup de la placa. Las capas exteriores se calculan como microstrip (Hammerstad-Jensen con la corrección de espesor de Wadell) y las interiores como stripline (Wheeler); los pares diferenciales reciben el término de acoplamiento de IPC-2141. Los anchos se escriben en reglas .kicad_dru que comprueba el DRC de KiCad. Para esas clases, el enrutador desactiva el estrechamiento (neck-down) en los pines, que de otro modo rompería el ancho. En la placa de prueba, los 30 errores de ancho de la clase de 50 Ω quedaron en cero.
El plugin de KiCad
El plugin exporta la placa, rellena los huecos de la exportación Specctra de KiCad, ejecuta el enrutador e importa el resultado. Eso requiere mucho más detalle del que parece a primera vista:
- Se trasladan las reglas
.kicad_dru: distancias entre clases, anchos de pista por capa, reglas de longitud y de desfase, separaciones de pares diferenciales; también el ancho mínimo de pista y la distancia del cobre al borde. - KiCad exporta cada zona como un plano y cada área de reglas como una zona prohibida. El plugin corrige esto y vuelve a rellenar las zonas tras el enrutado. Como las áreas de reglas que no prohibían nada estaban cerrando canales enteros, Freerouting dejaba 160 conexiones sin enrutar en la demo multichannel_mixer; con el plugin, cero.
- Los textos en cobre, las reglas de distancia a taladros y las distancias locales de los pads sin net se convierten en zonas prohibidas; se conservan las vías de cosido de las zonas.
- El resultado se comprueba con el propio DRC de KiCad. En las demos de KiCad, tras volver a enrutar desde cero:
| Placa | Flujo con Freerouting sin más (sin conectar / violaciones) | Plugin de fastroute (sin conectar / violaciones) |
|---|---|---|
| complex_hierarchy | 83 / 3 | 0 / 0 (0,7 s) |
| interf_u | 8 / 346 | 0 / 2 (5,6 s) |
| pic_programmer | 0 / 118 | 0 / 0 (0,7 s) |
| ecc83-pp | 0 / 6 | 0 / 0 (0,3 s) |
| sonde xilinx | 1 / 122 | 0 / 36 (0,4 s) |
Las violaciones restantes (pads cerca del borde de la placa, radios térmicos) también existen en los diseños originales.
Placas enrutadas con fastroute
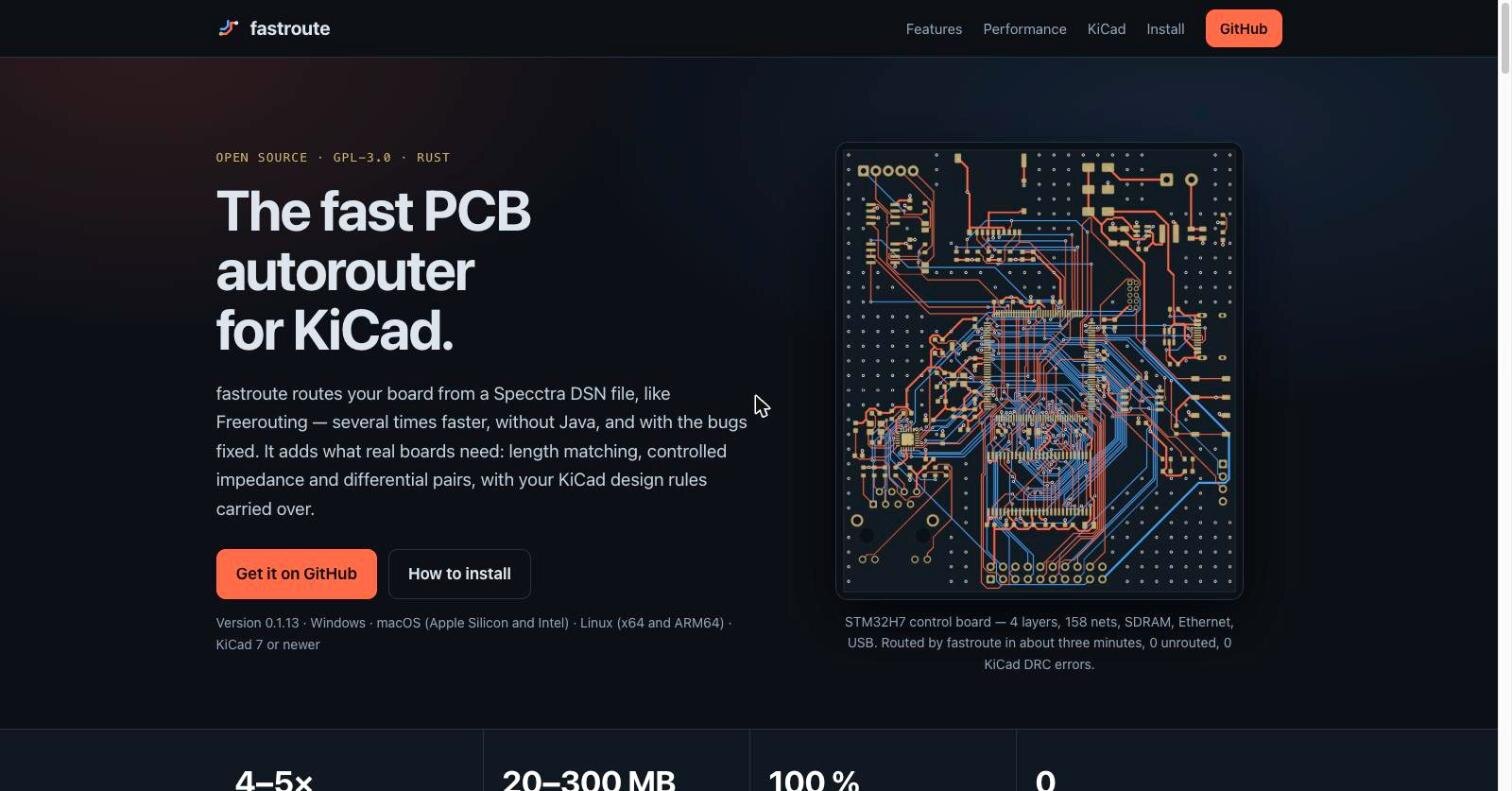
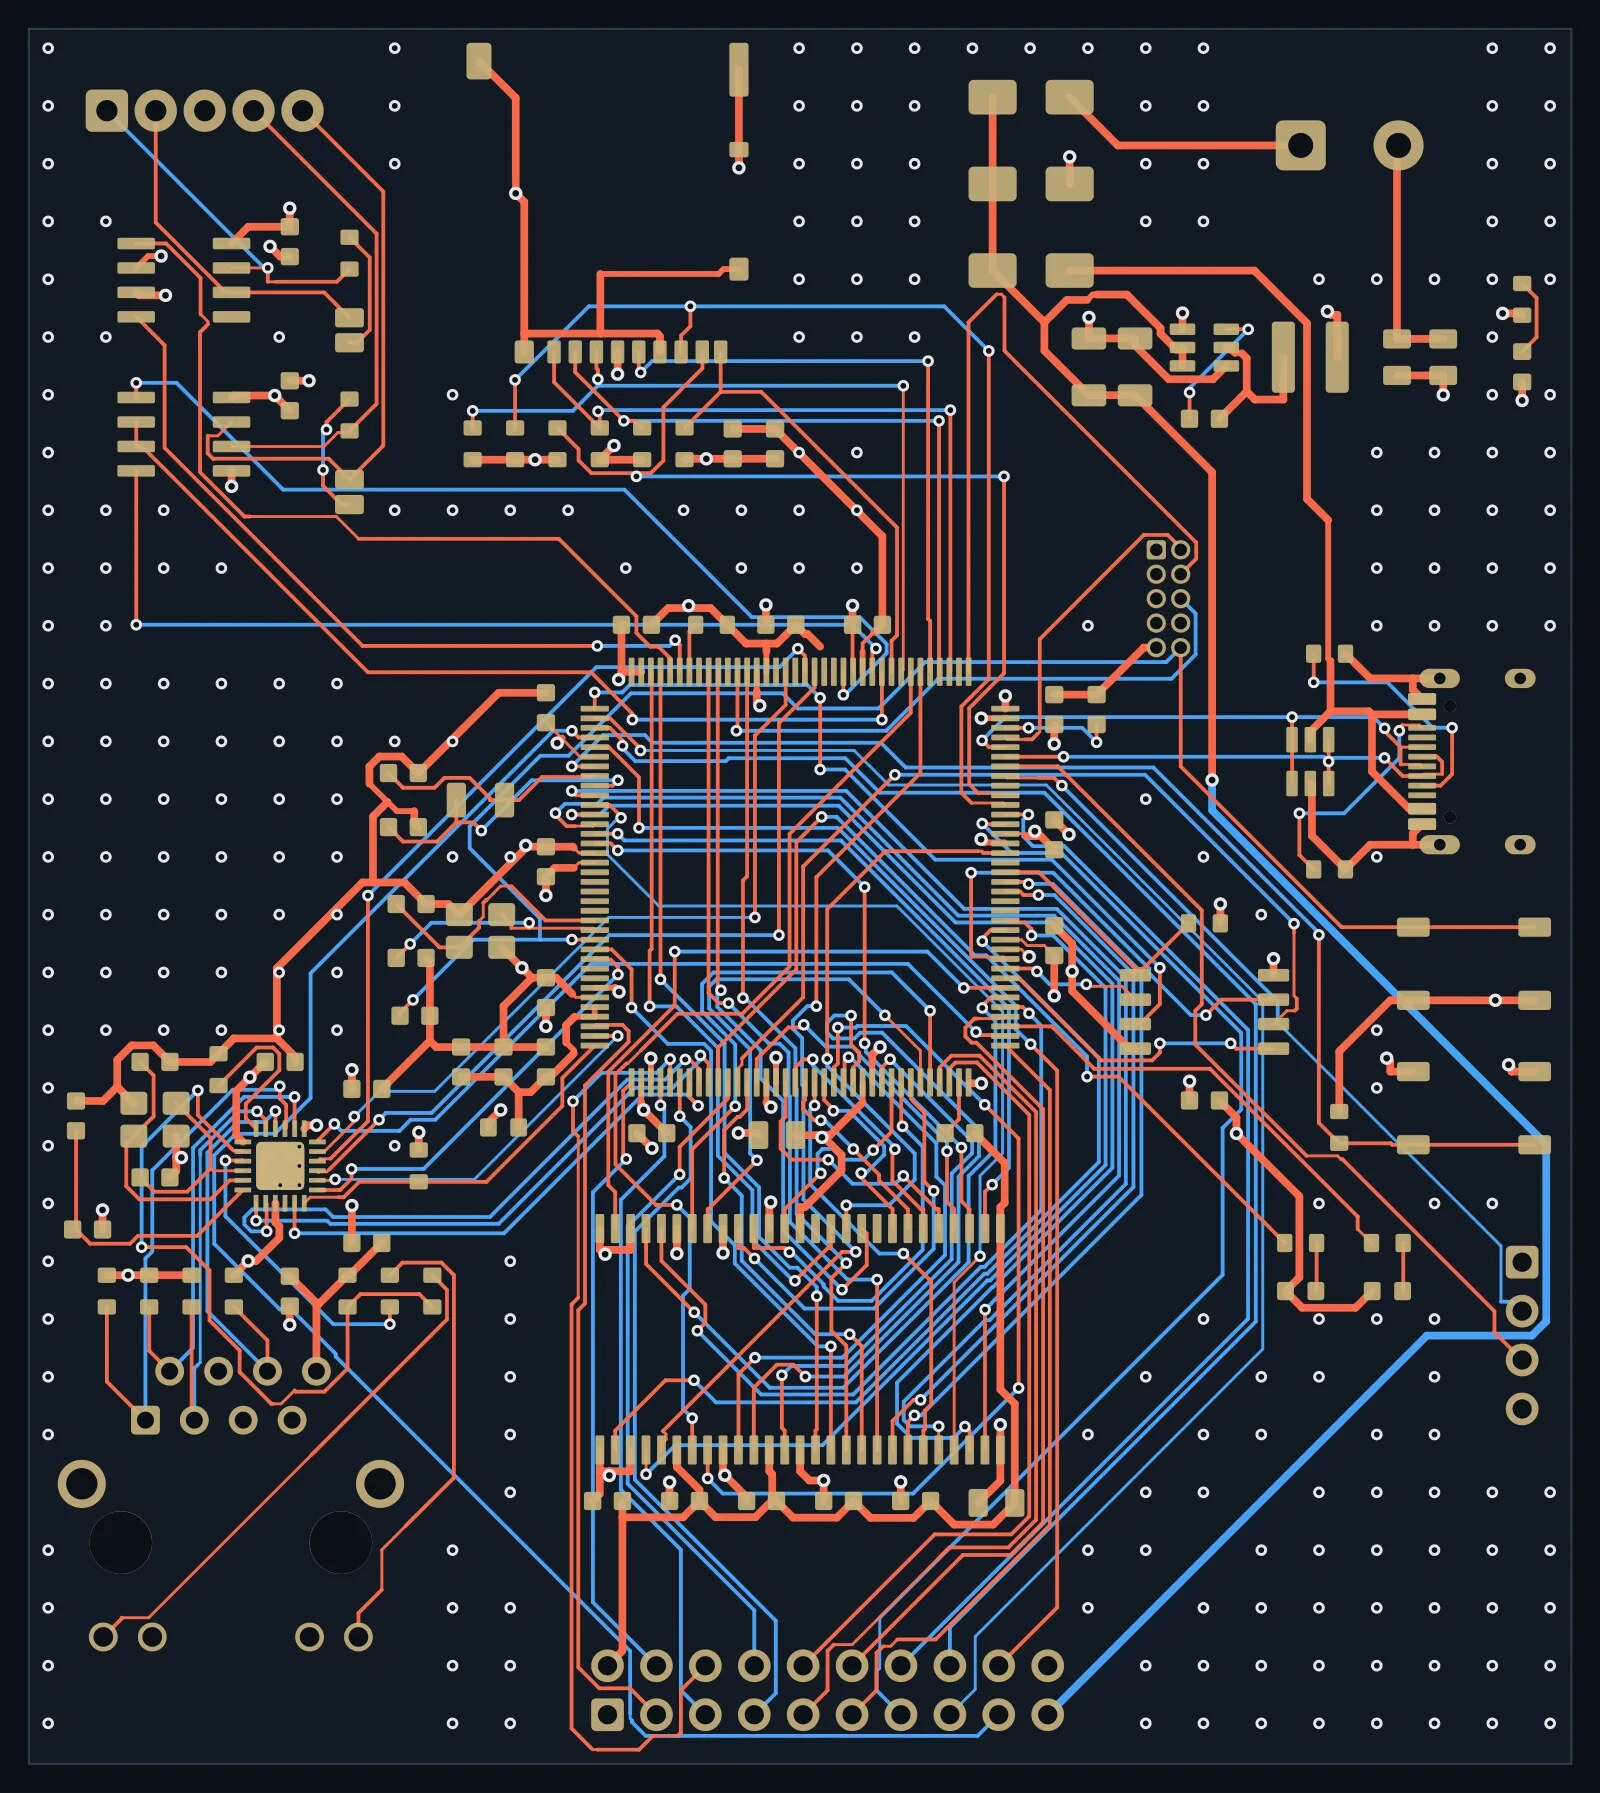
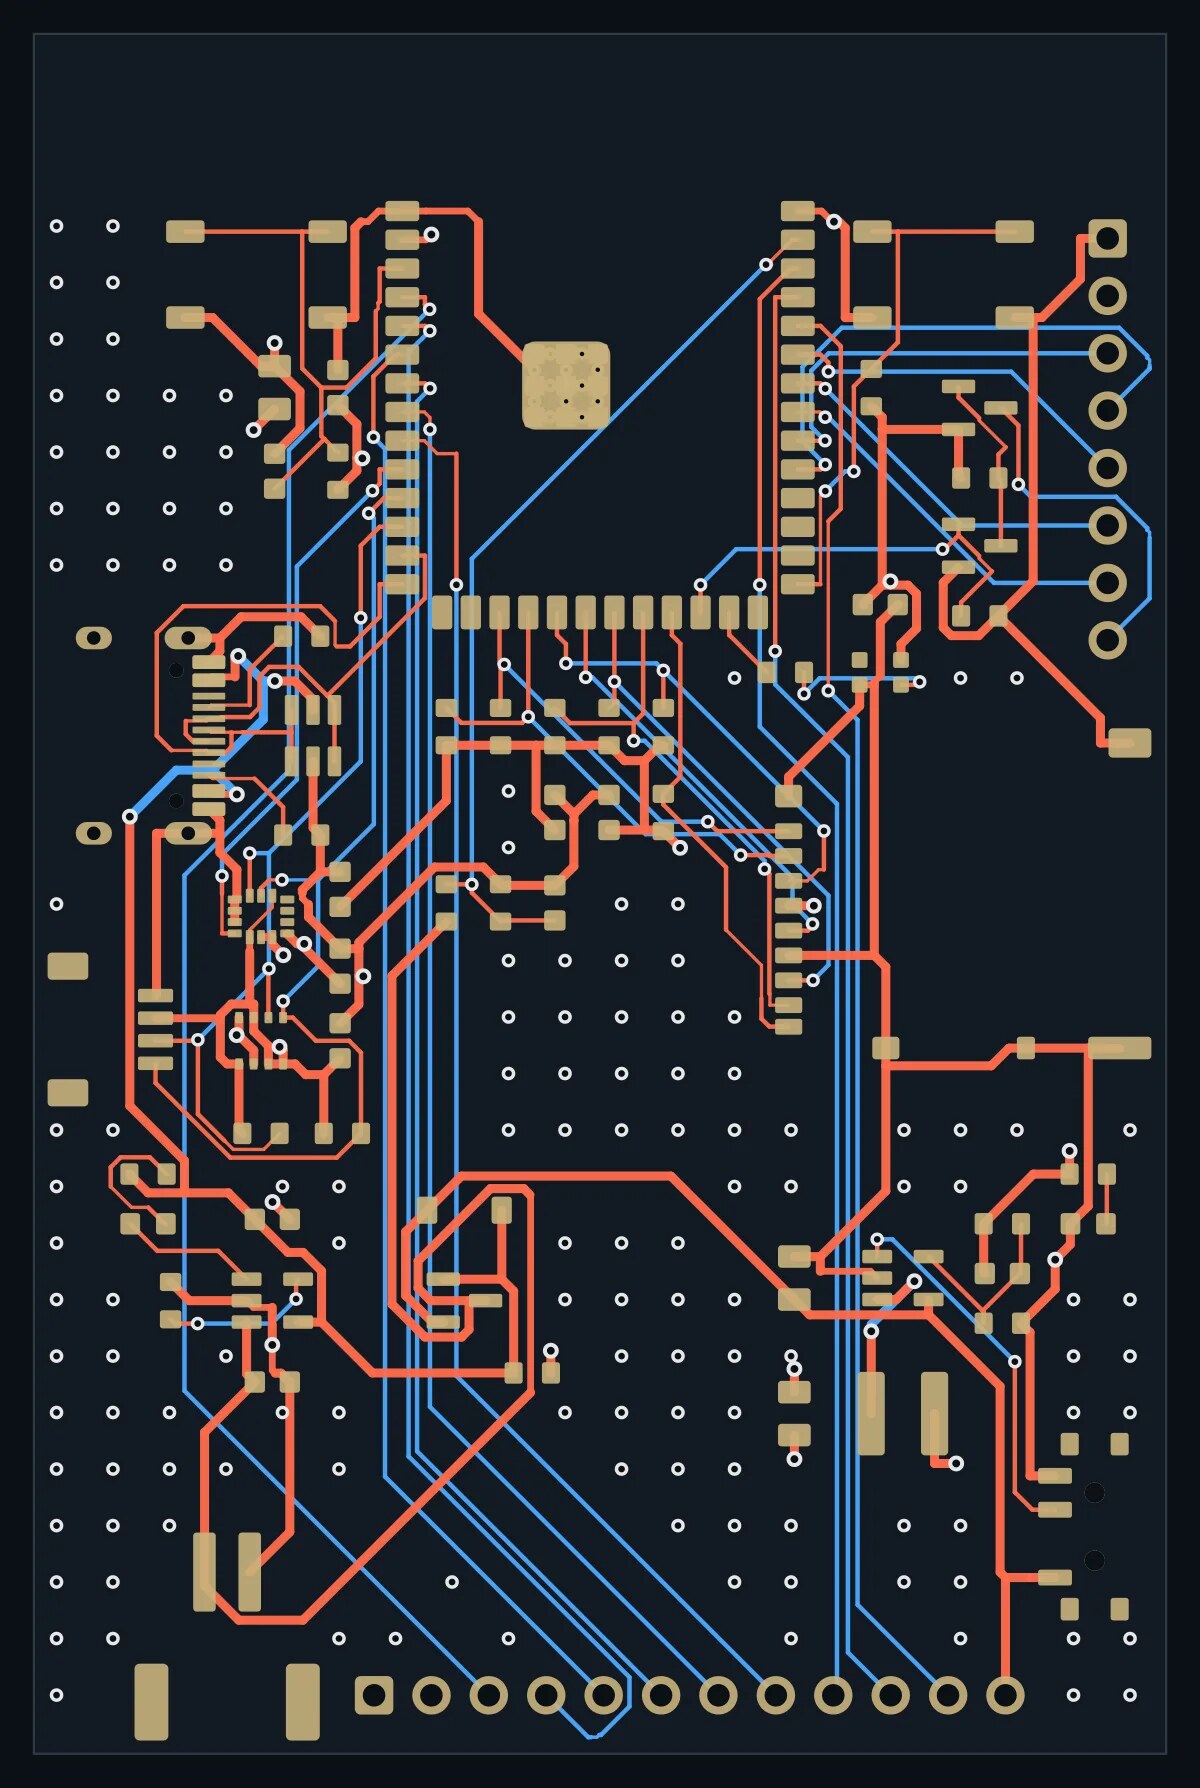
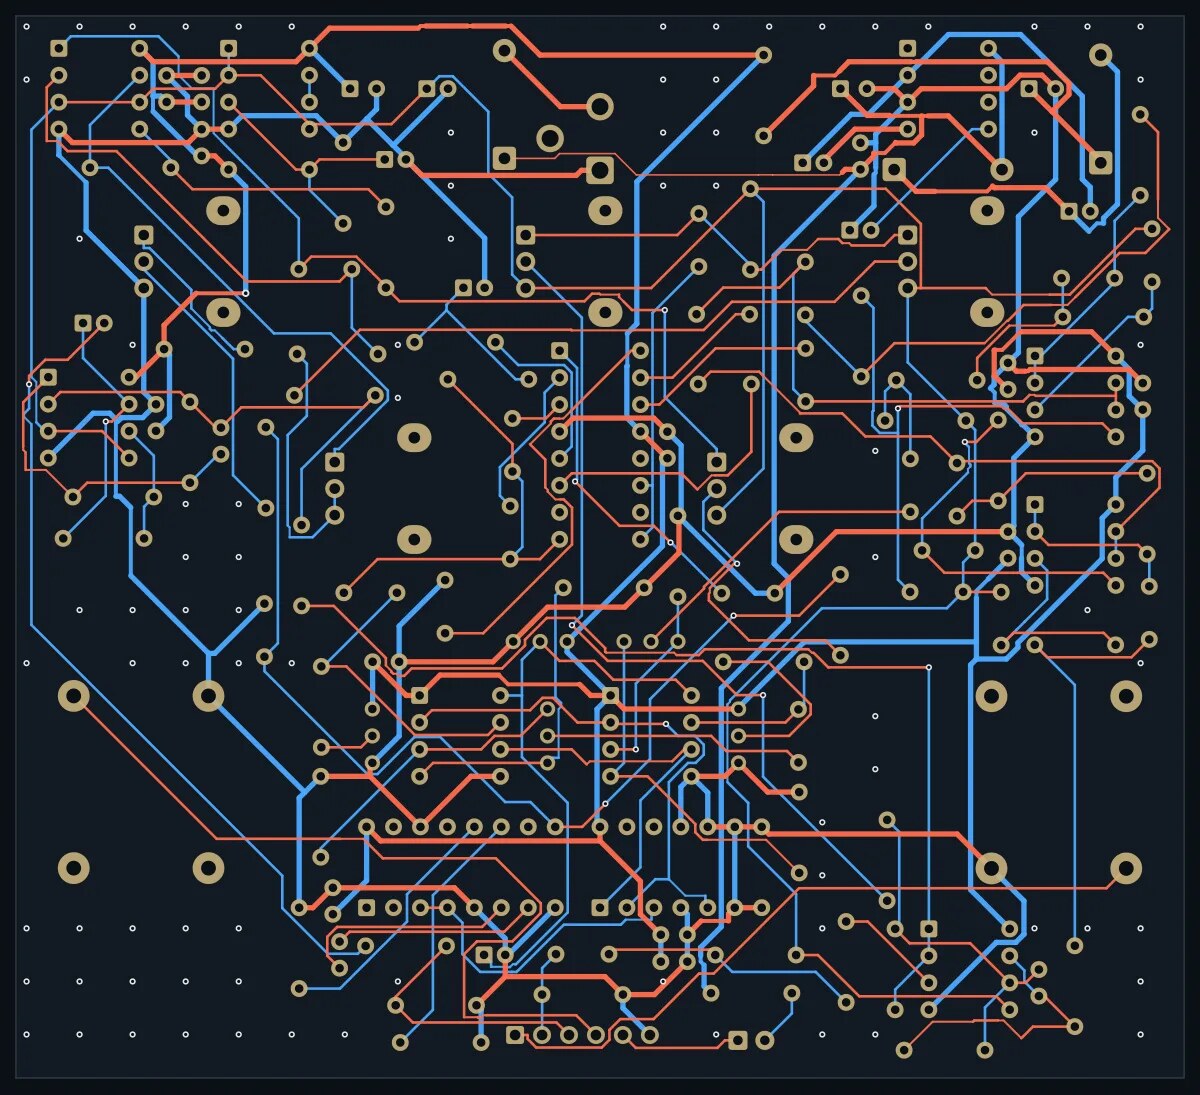
Las placas de ejemplo del sitio se enrutaron todas con fastroute. La placa de control STM32H7 (4 capas, 158 nets, SDRAM, Ethernet, USB) se enrutó en unos tres minutos, con cero conexiones sin enrutar y cero errores de DRC de KiCad:
Instalación
El paquete del plugin para KiCad 7 y versiones posteriores está en la página de releases de GitHub. Se instala con "Install from File" en el Plugin and Content Manager de KiCad; dentro del paquete hay binarios para Windows, macOS (Apple Silicon e Intel) y Linux (x64 y ARM64), y no hace falta Java. fastroute también funciona por sí solo desde la línea de comandos, con cualquier archivo Specctra DSN:
# route, write the result to board.ses
fastroute -de board.dsn -do board.ses

# stop after 10 minutes, keep the best result
fastroute -de board.dsn -do board.ses --max-time=600

# watch it route in the browser
fastroute -de board.dsn -do board.ses --live

# exactly Freerouting's result
fastroute -de board.dsn -do board.ses --parity
Las opciones de Freerouting (-mp, --router.*) funcionan como antes. Para compilar desde el código fuente basta con cargo build --release -p fastroute; scripts/build-pgo.sh produce una compilación alrededor de un 15 % más rápida.
Conclusión
fastroute me volvió a mostrar algo: al portar una pieza de software grande, la herramienta más valiosa es una medida definida de la corrección. El objetivo de ser "idéntico byte a byte a Java" hizo el trabajo más difícil; hubo que emular todo, desde el generador de números aleatorios de Java hasta las reglas de equilibrado de TreeMap. Pero gracias a ese objetivo pude demostrar que cada aceleración no rompía el resultado, y distinguir cada error con la pregunta "¿es un error del port o del propio Freerouting?". El resultado es una herramienta que enruta las mismas placas cinco veces más rápido, sin Java y con mucha menos memoria, y que además añade las funciones que necesitan las placas reales.
fastroute es software libre bajo GPL-3.0-or-later y una obra derivada de Freerouting; el mérito de los algoritmos de enrutado corresponde a los autores de Freerouting. Lo desarrollo en mi tiempo libre. Si resulta útil, se puede apoyar a través de GitHub Sponsors u Open Collective; los informes de errores con una placa que muestre el problema son igual de bienvenidos (basta con un archivo .dsn). Me alegrará recibir preguntas en X o LinkedIn.