Rill: un lenguaje funcional concurrente al estilo de Go y sin recolector de basura (de los fundamentos a un servidor web)
Un largo recorrido por Rill de principio a fin: tipos de datos algebraicos, Result y ?, recursión de cola, strands y canales, tiempos de espera con select, gestión de memoria sin recolector de basura y el servidor en Rill detrás de este blog. Todos los ejemplos se ejecutaron; las salidas son reales.
Durante algunos años me volvía una y otra vez la misma pregunta: ¿se puede reunir en un solo lenguaje el sistema de tipos de Haskell y OCaml, el modelo de concurrencia de Go y una velocidad cercana a la de C, sin una máquina virtual ni un recolector de basura de por medio? Rill es el lenguaje que escribí para buscar la respuesta. La página que se está leyendo ahora mismo la sirve un servidor HTTP escrito en Rill.
Va a ser un recorrido largo. Empezamos por los fundamentos del lenguaje y pasamos por los tipos de datos algebraicos, la propagación de errores con ?, los bucles que en realidad son recursión de cola, la concurrencia con strands y canales, la gestión de memoria sin recolector de basura y, por último, el servidor que hay detrás de este blog. Compilé y ejecuté cada ejemplo de código de este artículo antes de escribirlo. Las salidas son salidas reales. (Las cadenas dentro de los programas están en turco porque son exactamente los programas que ejecuté.)
Qué es Rill y qué no es
Rill es un lenguaje funcional estricto y con tipado estático. Compila directamente a código nativo a través de LLVM. Un puñado de decisiones fundamentales le dan su carácter:
- Inferencia de tipos en todas partes. Las anotaciones son opcionales. Los genéricos, los traits y requisitos como "este tipo debe ser ordenable" los infiere y comprueba el compilador.
- Tipos de datos algebraicos y pattern matching. Patrones anidados, guardas y un comprobador de exhaustividad que nombra el caso que se olvidó.
- Sin recolector de basura. La memoria se gestiona con conteo de referencias insertado en tiempo de compilación (al estilo Perceus). Un valor se libera en el instante en que muere; no hay pausas.
- El modelo de concurrencia de Go.
spawny canales tipados sobre hilos verdes. Rill los llama strands (el equivalente de una goroutine en Go). - Código nativo a través de LLVM -O3. Los genéricos se monomorfizan; nada se empaqueta (boxing) y las llamadas a traits se resuelven en tiempo de compilación. Un "Hello world" ocupa 33 KB.
- Una única sintaxis canónica.
rill fmtda a cada programa exactamente una forma de escribirse.
Lo que Rill no tiene es igual de deliberado: no hay variables mutables, ni excepciones, ni null, ni conversiones implícitas, ni herencia. Lo único que cambia son piezas de almacenamiento: un elemento de un búfer (Buf) y una entrada de un Map. Incluso ahí, lo que cambia no es una vinculación, sino el almacenamiento al que apunta el nombre.
Primeros pasos: instalación y "hola"
El compilador está escrito en Rust y necesita LLVM 21:
brew install llvm@21
cargo build --release
./target/release/rill run examples/hello.rill
./target/release/rill build main.rill -o main && ./main
Toda la cadena de herramientas vive en un único binario: build, run, check, test, fmt, repl, doc, explain y un servidor de lenguaje (rill lsp). Ver en el editor el tipo del nombre bajo el cursor es el único lugar donde se pronuncia una firma en voz alta en un lenguaje que lo infiere todo.
Tipos de datos algebraicos y pattern matching
En Rill un tipo de datos es la lista de sus constructores. El ejemplo siguiente define tres figuras y calcula el área de cada una. Para el triángulo usamos la fórmula de Herón y, para la raíz cuadrada, llamamos directamente a la biblioteca matemática de C:
type Shape
  Circle(r: Float)
  Rect(w: Float, h: Float)
  Triangle(a: Float, b: Float, c: Float)

fn area(s) = match s
  Circle(r) -> 3.14159 * r * r
  Rect(w, h) -> w * h
  Triangle(a, b, c) ->
    p = (a + b + c) / 2.0
    sqrt(p * (p - a) * (p - b) * (p - c))

fn describe(s) = match s
  Circle(r) if r > 10.0 -> "büyük bir daire"
  Circle(_) -> "bir daire"
  Rect(w, h) if w == h -> "bir kare"
  Rect(_, _) -> "bir dikdörtgen"
  Triangle(_, _, _) -> "bir üçgen"

extern "m" fn sqrt(x: Float) -> Float

fn main() =
  shapes = Cons(Circle(1.0), Cons(Rect(2.0, 2.0), Cons(Triangle(3.0, 4.0, 5.0), Cons(Circle(12.0), Nil))))
  each(shapes, \s -> println(describe(s) + ": " + float_to_str(area(s))))
  println(fold(map(shapes, area), 0.0, \acc, a -> acc + a))
Salida:
bir daire: 3.14159
bir kare: 4
bir üçgen: 6
büyük bir daire: 452.38895999999994
465.53054999999995
Vale la pena señalar algunas cosas:
- No escribimos ni un solo tipo (aparte de los campos de los constructores). El compilador deduce por sí solo que
areaesShape -> Float. - Las guardas
ifdedescribeno cubren nada. La líneaCircle(r) if r > 10.0no cuenta por sí sola como cobertura de los círculos; si se borra la líneaCircle(_)que está debajo, el compilador nombra el casoCircle(_)que falta. Una rama con guarda no puede "ocultar" un caso. - La línea
extern "m" fn sqrt(...)enlaza la función directamente desde lalibmde C. No hay ninguna capa envoltorio en medio. - Los números de coma flotante se imprimen en la forma más corta que se vuelve a leer exactamente igual:
452.38895999999994es precisamente el número calculado.
Los campos de un tipo con un solo constructor se pueden leer con un punto (p.x). Un tipo con varios constructores solo puede responderse con match, porque el campo podría no estar ahí. En lugar de modificar un registro se construye uno nuevo: { p | health = p.health - 35 } se lee como "todo lo que tiene p, salvo esto".
Los errores son valores: Result y ?
Rill no tiene excepciones. Una función que puede fallar lo dice en su tipo y quien la llama no puede olvidarlo. Antes eso tenía un coste: un match por cada llamada, del que dos de cada tres líneas eran siempre las mismas. El operador ? es exactamente esas dos líneas: el valor dentro del Ok, o si no, el Err de toda la función.
Escribamos un pequeño lector de configuración:
type Config
  Config(host: Str, port: Int)

fn field(text, key) =
  found = find(lines(text), \l -> starts_with(l, key + "="))
  match found
    Some(l) -> Ok(str_sub(l, str_len(key) + 1, str_len(l)))
    None -> Err("eksik alan: " + key)

fn number(s) =
  n = str_to_int(s)
  if n > 0 && n < 65536 then Ok(n) else Err("geçersiz port: " + s)

fn parse_config(text) =
  host = field(text, "host")?
  port = number(field(text, "port")?)?
  Ok(Config(host, port))

fn main() =
  println(parse_config("host=127.0.0.1\nport=8080"))
  println(parse_config("host=127.0.0.1"))
  println(parse_config("host=x\nport=99999"))
Ok(Config(127.0.0.1, 8080))
Err(eksik alan: port)
Err(geçersiz port: 99999)? no añade nada en tiempo de ejecución. El compilador convierte el resto del bloque en la rama Ok y genera el match que se habría escrito a mano. Una llamada de cola después de un ? sigue siendo una llamada de cola. Cuando las capas tienen sus propios tipos de error y el tipo de error de la función se define como un tipo suma (como type AppErr con Io(IoErr) y Parse(ParseErr)), ? propaga hacia fuera el error de la capa inferior envuelto en el constructor correspondiente. Nada se convierte en silencio a menos que el tipo lo declare.
Sin bucles y, aun así, con bucles
Rill no tiene un bucle while clásico. Lo que tiene en su lugar es recursión de cola, y eso es una promesa, no una sugerencia: las funciones de Rill se compilan con la convención de llamada de cola garantizada de LLVM y la llamada se marca como musttail. El optimizador no puede retirar esa garantía. Incluso un bucle escrito como varias funciones que se llaman entre sí en posición de cola se ejecuta con pila constante.
fn sum_to(n) =
  fn go(i, acc) = if i > n then acc else go(i + 1, acc + i)
  go(1, 0)

fn main() =
  println(sum_to(100000000))
  squares = buf_int(10)
  for i in 0..10
    squares[i] = i * i
  total = for i in 0..10 with acc = 0
    acc + squares[i]
  println(total)
  println(range(1, 20) |> filter(\x -> x % 3 == 0) |> map(\x -> x * x) |> sum)
  words = split("rill ile yaz rill ile derle rill ile çalıştır", " ")
  counts = map_new()
  each(words, \w -> map_set(counts, w, map_or(counts, w, 0) + 1))
  println(sort_by(map_items(counts), fst))
5000000050000000
285
819
Cons((derle, 1), Cons((ile, 3), Cons((rill, 3), Cons((yaz, 1), Cons((çalıştır, 1), Nil)))))En este pequeño programa hay cuatro ideas:
- Las funciones locales son bucles, no closures.
gove lande la función que la contiene. El compilador la eleva al nivel superior y pasancomo parámetro. No se reserva nada y 100 millones de pasos se ejecutan con pila constante. for ... withdevuelve lo que lleva consigo. El valor del cuerpo se convierte en el siguienteacc. Escribiracc = acc + v[i]en el cuerpo se rechaza, y el error indica que se usewith, porque de lo contrario el bucle tiraría a la basura cada iteración.- Un pipeline se convierte en un único bucle. La cadena
range |> filter |> map |> sumse genera como un solo bucle sin ninguna lista cuando los elementos son números y las funciones se escriben como lambdas. Map(k, v)es una tabla hash. Cualquier cosa con igualdad estructural puede ser una clave; el compilador escribe la función hash a partir del tipo.m[k]devuelve unOptionporque la clave podría no estar. El orden de una tabla pertenece a la tabla; cuando se necesita un orden, se pide explícitamente consort_by.
Concurrencia: strands y canales
Rill usa el modelo de Go: muchos hilos ligeros que se comunican mediante canales de encuentro (rendezvous). Los strands son realmente baratos: 100.000 strands ocupan unos 53 MB y arrancan en microsegundos. El secreto es el modelo de pila copy-on-block: un strand aparcado cuesta unos 300 bytes.
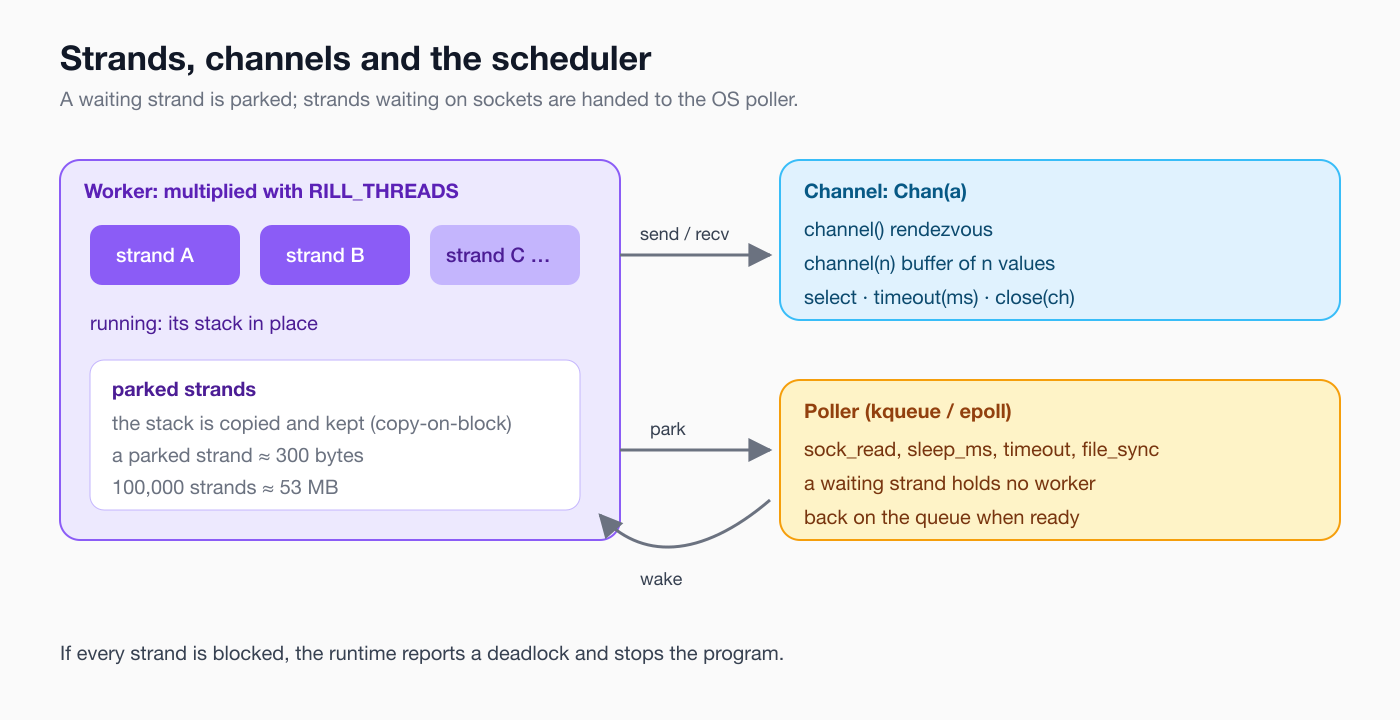
Primero escribamos un pool de trabajadores. Cuatro strands trabajadores escuchan en un canal de tareas; cada uno calcula el número de Fibonacci para la n que recibe y devuelve el resultado como una tupla:
fn fib(n) = if n < 2 then n else fib(n - 1) + fib(n - 2)

fn worker(id, jobs, results) =
  n = recv(jobs)
  send(results, (id, n, fib(n)))
  worker(id, jobs, results)

fn collect(results, k, acc) =
  if k == 0 then acc else collect(results, k - 1, Cons(recv(results), acc))

fn main() =
  jobs = channel(16)
  results = channel(16)
  for id in 0..4
    spawn worker(id, jobs, results)
  for n in 25..33
    send(jobs, n)
  got = sort_by(collect(results, 8, Nil), job_of)
  each(got, report)

fn job_of(t) =
  (_, n, _) = t
  n

fn report(t) =
  (id, n, f) = t
  println("fib(" + int_to_str(n) + ") = " + int_to_str(f) + "  [işçi " + int_to_str(id) + "]")
fib(25) = 75025 [işçi 0]
fib(26) = 121393 [işçi 0]
fib(27) = 196418 [işçi 0]
fib(28) = 317811 [işçi 0]
fib(29) = 514229 [işçi 0]
fib(30) = 832040 [işçi 0]
fib(31) = 1346269 [işçi 1]
fib(32) = 2178309 [işçi 1]Que el trabajador 0 haga la mayoría de las tareas no es un error. En la compilación por defecto hay un único hilo trabajador y los strands se turnan en él. Que worker se llame a sí mismo indefinidamente tampoco es un problema; es una llamada de cola y la pila no crece.
Para tener paralelismo real, se compila el programa con --parallel y se indica el número de trabajadores con RILL_THREADS. Le di al mismo pool 8 tareas iguales (8 × fib(35)) y tomé la mediana de 11 ejecuciones en un M4. El arranque del proceso está incluido en el tiempo:
| Compilación | Tiempo (mediana) |
|---|---|
rill build (un trabajador) | 131 ms |
rill build --parallel, RILL_THREADS=8 | 53 ms |
Sin cambiar una sola línea, el código pasó a ser unas 2,5 veces más rápido. Una advertencia: en una compilación --parallel no hay ningún bloqueo sobre el almacenamiento compartido por los strands (un Map, un Buf). El compilador pide marcar con apart(x) los valores que se comparten a propósito; esa es la promesa de que "escribo en ellos por separado".
Tiempos de espera: select y timeout
Cuando se espera a un servicio, no se quiere esperar para siempre. select espera en varios canales a la vez y ejecuta la rama del que esté listo primero. Una rama timeout(ms) queda lista cuando no ha pasado nada durante ese tiempo:
fn slow(ch, ms, v) =
  sleep_ms(ms)
  send(ch, v)

fn ask(ch, ms) =
  r = select
    v = recv(ch) -> "yanıt geldi: " + v
    timeout(ms) -> "zaman aşımı (" + int_to_str(ms) + " ms)"
  r

fn main() =
  fast = channel()
  spawn slow(fast, 10, "hızlı servis")
  println(ask(fast, 100))
  lazy = channel()
  spawn slow(lazy, 500, "yavaş servis")
  println(ask(lazy, 100))
yanıt geldi: hızlı servis
zaman aşımı (100 ms)Aquí hay un detalle de ingeniería importante: la rama timeout no gasta ni un strand ni un canal. Se aparca dentro del poller, junto a los canales, y no cuesta nada mientras espera. Antes de esto, cada select que necesitaba un tiempo de espera gastaba un strand y un canal como su propio reloj. Para un servidor que pone un plazo a cada petición en curso, eso significaba un strand por petición.
El mismo mecanismo detiene un programa: close(ch) despierta con una única difusión a todos los que esperan en el canal, y wait_signal() es la forma en que el programa se entera de que debe detenerse. Si todos los strands están bloqueados, el runtime informa de un deadlock y detiene el programa en lugar de quedarse colgado en silencio.
Un anillo de 100.000 strands
La prueba de estrés clásica para un modelo de concurrencia: conectamos 100.000 strands en un anillo mediante canales. Cada strand suma uno al número que recibe y lo pasa al siguiente:
fn relay(inp, out) =
  v = recv(inp)
  send(out, v + 1)

fn build(first, prev, k) =
  if k == 0 then prev
  else
    next = channel()
    spawn relay(prev, next)
    build(first, next, k - 1)

fn main() =
  t0 = now_nanos()
  first = channel()
  last = build(first, first, 100000)
  send(first, 0)
  println(recv(last))
  println(int_to_str((now_nanos() - t0) / 1000000) + " ms")
100000
10 msCrear 100.000 strands y 100.000 canales y enviar un mensaje que dé toda la vuelta al anillo tardó entre 8 y 17 ms en mi máquina, y el proceso alcanzó un pico de 68 MB. Las mediciones comparativas del repositorio de Rill (Apple M4, mediana de 25 ejecuciones, salidas verificadas como idénticas en los tres lenguajes) son las siguientes:
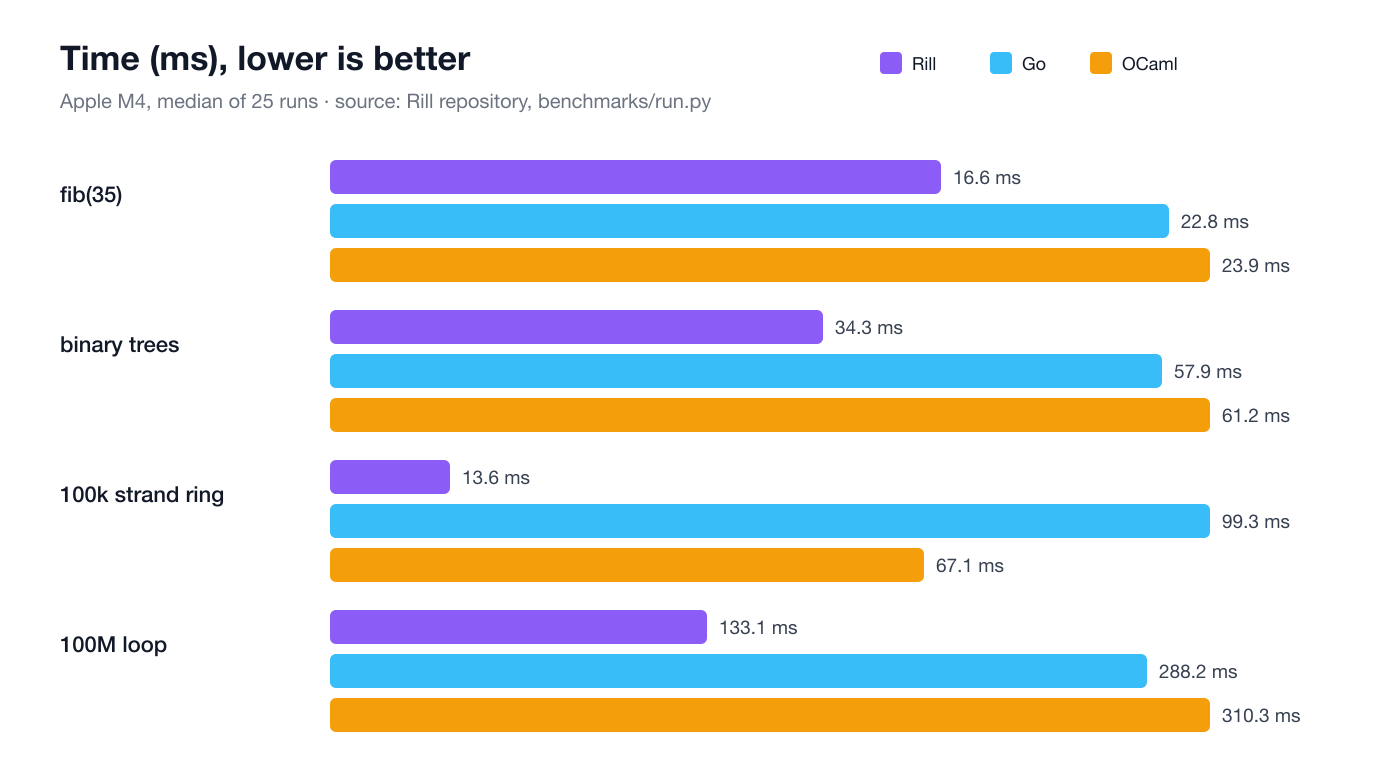
La velocidad de cálculo viene de LLVM. El resultado en reserva de memoria (árboles binarios) viene del conteo de referencias con un asignador con pool y de los constructores sin parámetros, que nunca reservan memoria. El resultado en concurrencia viene del modelo de pila copy-on-block. De los tres lenguajes, Rill es también el más pequeño en memoria pico y en tamaño de binario: 32-34 KB frente a 2,1 MB de Go y alrededor de 1 MB de OCaml.
Memoria sin recolector de basura
Esta es mi parte favorita de Rill. El compilador inserta por sí mismo las operaciones de conteo de referencias, siguiendo reglas de propiedad (al estilo Perceus). La memoria se libera en el instante en que muere la última referencia, de forma determinista y sin pausas. Los constructores sin parámetros como Nil y None son singletons estáticos y nunca reservan memoria.
La parte realmente bonita es la reutilización. Cuando un match desmonta una caja y nada más puede alcanzarla por nombre, el siguiente constructor con la misma forma se construye dentro de esa caja, no en una nueva. Por eso map, filter, reverse y split recorren una lista sin reservar nada; cada uno escribe cada eslabón encima del eslabón que leyó.
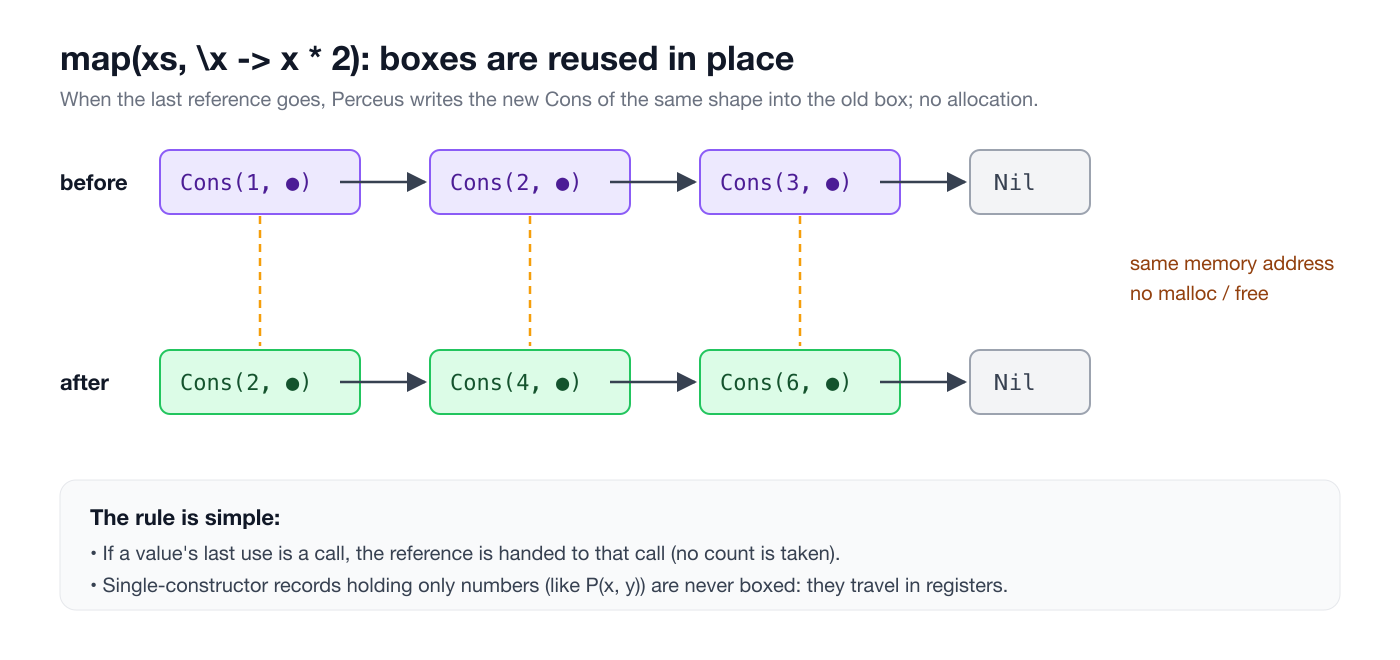
Estas decisiones no se ven en el código fuente, pero no hace falta adivinarlas. rill explain es el propio informe del generador de código:
type Point
  P(x: Float, y: Float)

fn total(xs, acc) = match xs
  Nil -> acc
  Cons(x, rest) -> total(rest, acc + x)

fn main() =
  xs = Cons(1, Cons(2, Cons(3, Nil)))
  doubled = map(xs, \x -> x * 2)
  println(total(doubled, 0))
  p = P(1.0, 2.0)
  println(p.x + p.y)
  println(range(1, 1000) |> filter(\x -> x % 7 == 0) |> map(\x -> x * x) |> sum)
$ rill explain explain.rill
fn total(xs, acc) # line 4
`xs` is borrowed: never kept or given away here, so the caller's reference is enough
line 6: `rest` is passed to the tail call borrowed: the callee never keeps it
fn main() # line 8
line 9: `Cons(..)` allocates a box with 2 field(s)
line 10: `map` walks the list in place, writing each link over the one it read
line 12: `P(..)` is a flat value: in registers, no box and no count
line 14: this pipeline is one loop: no list is builtEl informe se lee línea a línea:
totaltoma prestada la lista: como no se queda con nada, la referencia de quien llama basta y el contador nunca se toca.maprecorre la lista en el sitio; no se reservan celdas nuevas paradoubled.P(1.0, 2.0)es un valor plano: un registro de un solo constructor que solo contiene números nunca se empaqueta y viaja en registros.(q, r) = divmod(a, b)cuesta lo mismo que devolver dos números en C.- El pipeline es un único bucle; no se construye ninguna lista intermedia.
La única debilidad conocida del conteo de referencias son los ciclos: no puede liberar un valor que se contiene a sí mismo. En un programa hecho de valores inmutables, la única forma de construir un ciclo es que una pieza de almacenamiento contenga algo que la contenga a ella. Rill rechaza m[k] = v cuando v contiene m en el punto en que se escribe. Para los casos que no pueden verse en tiempo de compilación, como dos mapas que se contienen mutuamente, ejecutar con RILL_ALLOC_CHECK=1 produce un informe que nombra las funciones que crearon los bloques que nunca se liberaron.
Suficiente E/S para escribir servidores
Un strand que espera en un socket queda aparcado mientras el planificador consulta al sistema operativo. Así que un strand por conexión no cuesta nada mientras espera. Todo lo que hay por encima de TCP es código Rill corriente. El módulo web/http es un servidor HTTP/1.1 de unos pocos cientos de líneas: análisis de peticiones, enrutamiento, respuestas y keep-alive. Este es un servidor web completo:
import "web/http" as h

fn route(req: h.Request) =
  p = h.path_of(req.path)
  if p == "/" then h.html_response(200, "<h1>Merhaba Rill!</h1>")
  else if p == "/selam" then h.text_response(200, "selam " + h.param(h.query_of(req.path), "ad"))
  else h.json_response(404, "{\"hata\":\"bulunamadı\"}")

fn main() = h.serve_n(18777, \req -> route(req), 10)
$ curl localhost:18777/
<h1>Merhaba Rill!</h1>
$ curl "localhost:18777/selam?ad=Bar%C4%B1%C5%9F"
selam Barış
$ curl localhost:18777/x
{"hata":"bulunamadı"}El binario compilado ocupa 119 KB. serve_n responde a un número fijo de peticiones y se detiene, para las pruebas; un servidor real usa serve o serve_taking. La biblioteca también se ha pensado frente a ataques: una conexión que no envía nada se corta a los 15 segundos, las cabeceras de la petición están limitadas a 64 KB y el cuerpo a 1 MB, y una petición que lleva a la vez Content-Length y Transfer-Encoding (request smuggling) se rechaza sin respuesta.
En la medición del repositorio de Rill, el mismo servicio de una sola ruta se compara con net/http de Go:
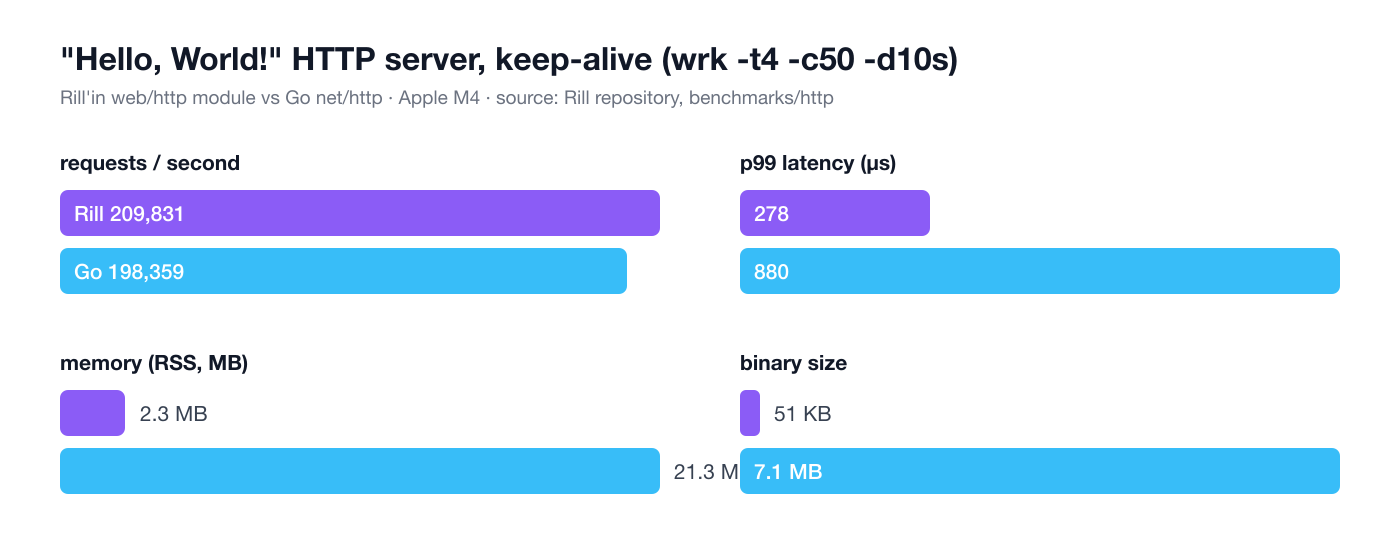
Con keep-alive, Rill va por delante tanto en rendimiento como en latencia y usa unas 9 veces menos memoria. La razón de que la latencia p99 sea 3,2 veces más ajustada es sencilla: nada se detiene a recoger basura.
¿Cómo funciona este blog?
La página que se está leyendo reúne todas las piezas anteriores. El servidor es un único binario escrito en Rill (unos 600 KB). Detrás está OxiDB, una base de datos propia que sirve motores de documentos, SQL, clave-valor en memoria y S3 desde un solo proceso. La interfaz es zap, mi biblioteca reactiva de grano fino sin DOM virtual.
| Capa | Tecnología | Qué hace |
|---|---|---|
| HTTP | Rill web/http | Un strand por conexión, keep-alive |
| Plantillas | tools/tmplgen | Las plantillas se convierten en código Rill en tiempo de compilación |
| Markdown | md.rill | El HTML de este artículo, generado una sola vez al guardarlo |
| SQL | OxiDB SQL | Artículos y etiquetas; transacciones y claves foráneas |
| NoSQL | Documentos de OxiDB | Búsqueda de texto completo con stemming y analítica de visitas |
| En memoria | OxiMem (RESP) | Sesiones, contadores, caché de páginas, limitación de tasa |
| Almacén de objetos | OxiDB S3 | Las imágenes de este artículo, con peticiones firmadas con SigV4 |
Me gusta especialmente que las plantillas se traduzcan a Rill en tiempo de compilación. Una plantilla es en realidad una función. El texto estático se convierte en literales de cadena y las etiquetas en el código que representan. Renderizar una página no es más que una serie de concatenaciones a un StrBuf; en tiempo de ejecución no se analiza nada ni se busca ningún nombre:
%% import "views"
%= t_card(c: Card)
<article class="card">
  <p class="meta"><time datetime="<%= c.iso %>"><%= c.date %></time> · <%= c.reading %> dk okuma</p>
  <h2><a href="/yazi/<%= c.slug %>"><%= c.title %></a></h2>
  <% if len(c.tags) > 0 %><p class="tags"><% each t in c.tags %><a href="/etiket/<%= t %>">#<%= t %></a><% end %></p><% end %>
</article>
Todo lo que hay dentro de <%= ... %> es código Rill normal y se escapa como HTML automáticamente. No hay un segundo lenguaje de expresiones que aprender.
Lo que ocurre cuando se lee un artículo también muestra bien el modelo de concurrencia de Rill. Primero se busca la página en la caché de OxiMem. El contador de visitas se incrementa en OxiMem de inmediato y se coloca en la página. El documento para la colección events, usado para la analítica, se entrega a un strand aparte (spawn), de modo que la página no espera al fsync de la base de datos. Las conexiones a la base de datos son un pool dentro de un canal: una petición toma una conexión, la usa y la devuelve. Una petición que no encuentra conexión espera. Eso le da al servidor, gratis, la contrapresión (backpressure) que de todos modos quiere:
fn make_pool(host, port, n) =
  ch = channel(n)
  fn fill(k) =
    if k <= 0 then Ok(ch)
    else
      match connect_to(host, port)
        Err(e) -> Err(e)
        Ok(fd) ->
          send(ch, fd)
          fill(k - 1)
  fill(n)

fn with_conn(pool, ask) =
  fd = recv(pool)
  res = ask(fd)
  send(pool, fd)
  res
Guardar un artículo es una única transacción en el motor SQL. Primero la fila y después se sustituyen sus etiquetas. Un nombre de enlace (slug) que ya usa otro artículo lo rechaza la restricción UNIQUE, y ese rechazo se convierte en la respuesta que se muestra al usuario:
fn save_post(fd, d: Draft) =
  now = now_iso()
  ignore(exec(fd, "BEGIN", Nil))
  saved = if d.id > 0 then update_post(fd, d, now) else insert_post(fd, d, now)
  match saved
    Err(e) ->
      ignore(exec(fd, "ROLLBACK", Nil))
      Err(e)
    Ok(id) -> match replace_tags(fd, id, d.tags)
      Err(e) ->
        ignore(exec(fd, "ROLLBACK", Nil))
        Err(e)
      Ok(_) -> match exec(fd, "COMMIT", Nil)
        Err(e) -> Err(e)
        Ok(_) ->
          reindex(fd, id)
          Ok(id)
Pruebas
Una prueba es una función cuyo nombre empieza por test_ y que no recibe nada. rill test compila el archivo una vez y ejecuta cada prueba en su propio proceso, de modo que una prueba que falla no afecta al resto. Las pruebas del conversor de Markdown de este blog tienen este aspecto:
fn test_plain_and_slug() =
  assert_eq(md_plain("# Başlık\n\nBir **iki**, `üç`"), "Başlık Bir iki, üç")
  assert_eq(slugify("Rill ile Çalışma Zamanı: 101!"), "rill-ile-calisma-zamani-101")
$ rill test src/md.rill
ok test_blocks
ok test_plain_and_slug
2 tests: 2 passed, 0 failedLos ejemplos de los comentarios de documentación también son pruebas. Una línea de comentario sangrada con cuatro espacios es un ejemplo; la salida esperada va después de # =>, y rill doctest los ejecuta y los comprueba. Cada función de la biblioteca estándar tiene un ejemplo así, de modo que lo que muestran las páginas de referencia es lo que el código hace realmente.
Lo que fue difícil y lo que aprendí
Los temas que más tiempo me llevaron al escribir Rill fueron los que a primera vista parecían más sencillos:
- El orden de las sumas en coma flotante. Repartir una suma de
Floaten carriles vectoriales cambia el orden de las sumas, y eso cambia el resultado en los últimos bits. Rill quiere que+signifique lo que dice, así que no lo hace por defecto. Una función que acepta la reordenación lo dice explícitamente confast fn; así, un producto escalar se vuelve cinco veces más rápido. - El límite de la promesa de llamada de cola. La promesa se cumple a través de los registros de la máquina. Más de seis parámetros enteros o punteros hacen que se recurra a la convención de llamada de C. El compilador avisa cuando funciones así se llaman entre sí; la solución es agrupar los parámetros sobrantes en una sola tupla, porque una tupla es un único puntero.
- Caracteres frente a bytes.
#s,s[i]ys[i:j]son bytes y lo siguen siendo; un lexer y un protocolo de red quieren bytes."günaydın"tiene diez bytes pero ocho letras. Los caracteres viven un nivel más arriba, en funciones que lo dicen en su nombre (char_count,char_take). - Una única sintaxis canónica. Que
rill fmtdé a cada programa exactamente una forma de escribirse hace que el lenguaje sea predecible de leer, de comparar en un diff y de generar. El generador de plantillas de este blog también se beneficia de ello.
La mejor prueba de un lenguaje es escribir algo real con él. Este blog fue, para mí, la primera prueba real de la afirmación de Rill de tener "suficiente E/S para escribir servidores".
Conclusión
Rill es un experimento para reunir la seguridad de tipos de la familia ML, el modelo de strands y canales de Go y un rendimiento cercano al de C, sin recolector de basura. Gracias a la inferencia de tipos, el código es tan breve como en un lenguaje de scripting. Gracias al conteo de referencias en tiempo de compilación, el comportamiento de la memoria es predecible y visible con rill explain. Gracias a la garantía de llamada de cola, los bucles pueden escribirse como funciones, y los strands son tan baratos que abrir uno por conexión deja de ser una preocupación.
Lo siguiente son más plataformas (los primeros experimentos en RISC-V y en el ESP32 ya funcionan), una biblioteca estándar más rica y más capacidades en el servidor de lenguaje. Me alegrará conocer preguntas o experimentos en X o LinkedIn. En el próximo artículo escribiré sobre OxiDB, la base de datos que hay detrás de este blog, y sobre cómo sirve cuatro modelos de datos distintos desde un solo proceso.