Búsqueda de texto completo y vectorial en OxiDB
La capa de búsqueda de OxiDB: ranking BM25, stemming con Snowball en 18 idiomas con ejemplos en turco, fragmentos resaltados, búsqueda dentro de archivos PDF/DOCX/XLSX, un inverted index con mmap, k-NN con HNSW y mediciones reales de recall.
Una vez que un documento está en OxiDB, interesa encontrarlo por algo más que la igualdad de campos: por las palabras que contiene y por otros documentos que significan algo parecido. No quería que eso exigiera un clúster de Elasticsearch aparte ni una base de datos vectorial aparte, así que construí ambas cosas dentro del mismo proceso. La búsqueda de texto completo en OxiDB tiene ranking BM25, stemming con Snowball, fragmentos resaltados con <mark> y extracción de texto de PDF, DOCX y XLSX. La búsqueda vectorial hace k-NN con distancia coseno, euclidiana o producto escalar, con un recorrido exacto en colecciones pequeñas y paso a HNSW en las grandes. Este artículo explica cómo usar ambas, cómo funcionan por dentro y dónde se quedan cortas, con sesiones reales. Todas las salidas que aparecen aquí provienen de un servidor OxiDB 0.44.2 que ejecuté para este artículo en mi propia máquina (Apple M4, local).
Este es el segundo artículo de la serie. El modelo de documentos, el lenguaje de consultas y los tipos de índice se tratan en el artículo sobre el motor de documentos; aquí me centro en la capa de búsqueda construida sobre ellos.
Dos tipos de búsqueda, un solo proceso
"Búsqueda" significa dos cosas distintas en OxiDB:
| Búsqueda de texto completo | Búsqueda vectorial | |
|---|---|---|
| Encuentra | Documentos que contienen las palabras de la consulta (reducidas a su raíz) | Los k vectores más cercanos al vector de consulta |
| Índice | create_text_index (colecciones), automático (blobs/archivos) | create_vector_index |
| Ranking | BM25 (_score) | Distancia (_distance) más una similitud de 0 a 1 (_similarity) |
| Comando | text_search, search | vector_search |
| En disco | .mtidx (inverted index con mmap) | no se persiste en 0.44.2 (ver más abajo) |
La búsqueda de texto completo tiene a su vez dos caras. En los documentos de una colección, los campos de texto que se eligen con create_text_index se indexan y se buscan con text_search. Los archivos que se guardan en el blob store (el almacenamiento de objetos compatible con S3) se convierten a texto según su tipo de contenido, van a un índice global aparte y se buscan con search. Ambas usan el mismo tokenizador y el mismo código BM25.
No hay ningún flag para activar la búsqueda: si el motor de documentos está en marcha (la opción por defecto), los comandos de búsqueda están disponibles. El idioma y los parámetros de BM25 son variables de entorno. Para este artículo ejecuté dos servidores, uno con stemming en turco y otro en inglés:
OXIDB_ADDR=127.0.0.1:15200 OXIDB_DATA=./data-tr OXIDB_FTS_LANG=tr \
OXIDB_S3_PORT=15210 OXIDB_HTTP_PORT=15220 ./oxidb-server
Al arrancar, el servidor imprime la configuración en una línea:
FTS: lang=turkish k1=1.2 b=0.75 (BM25)Búsqueda de texto completo en una colección
Creación del índice
Inserté unos cuantos documentos en turco y construí un índice de texto sobre dos campos. El protocolo nativo es JSON con prefijo de longitud; estas peticiones viajaron por él y las respuestas son exactamente las que devolvió el servidor:
{"cmd": "insert_many", "collection": "yazilar", "docs": [
  {"baslik": "Kütüphanedeki eski kitaplar", "metin": "Kütüphanedeki eski kitaplar yeniden düzenlendi, raflar alfabetik sıraya kondu."},
  {"baslik": "Bir romana dönüş", "metin": "Bu kitabı okumadan önce yazarın ilk romanına bakmanızı öneririm."},
  {"baslik": "Haritada edebiyat", "metin": "Kitaplarda geçen yer adlarını tek tek haritaya döktüm."},
  {"baslik": "Rust ile veritabanı yazmak", "metin": "Kendi veritabanımı yazarken tuttuğum notlar: sayfa yapısı, WAL ve indeksler."},
  {"baslik": "Kahve demlemenin altı yolu", "metin": "French press, V60 ve moka pot ile kahve demlemek üzerine kısa bir rehber."},
  {"baslik": "Çocuklar için masallar", "metin": "Çocuklar için resimli masal kitapları seçerken dikkat ettiğim şeyler."},
  {"baslik": "Veritabanlarında indeks seçimi", "metin": "Veritabanlarında hangi alana indeks koymalı? Seçicilik ve sorgu planı."},
  {"baslik": "Kitapçıda bir öğleden sonra", "metin": "Sahaftan aldığım kitapların listesi ve kısa notlarım."}
]}
{"cmd": "create_text_index", "collection": "yazilar", "fields": ["baslik", "metin"]}
{"cmd": "list_indexes", "collection": "yazilar"}
{"ok": true, "data": [1, 2, 3, 4, 5, 6, 7, 8]}
{"ok": true, "data": "text index created"}
{"ok": true, "data": [{"name": "_text", "index_type": "text", "fields": ["baslik", "metin"], "unique": false}]}Los documentos existentes se indexan retroactivamente al crear el índice. Hay un único índice de texto por colección, siempre llamado _text; puede abarcar varios campos, y las rutas de campo admiten notación de puntos (meta.summary). También se leen los arrays de cadenas; los números y otros tipos se omiten.
Stemming en turco
Lo primero que quería comprobar es que los sufijos del turco no rompen la búsqueda. El turco es una lengua aglutinante: "kitap" (libro) se convierte en "kitaplar" (libros), "kitaplarda" (en los libros), "kitabı" (el libro, en acusativo, con la p suavizada a b). Una búsqueda de cualquiera de ellas debería encontrar las demás:
== kitap ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
0.5500  _id=8  Kitapçıda bir öğleden sonra
0.5276  _id=2  Bir romana dönüş
0.5069  _id=3  Haritada edebiyat
0.5069  _id=6  Çocuklar için masallar

== kitaplar ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
...
== kitaplarda ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
...
Las tres consultas devuelven los mismos cinco documentos con puntuaciones idénticas, porque se reducen a la misma raíz. El suavizado b/p de "kitabı" lo resuelven las reglas de Snowball para el turco. Una ejecución condensada del mismo experimento:
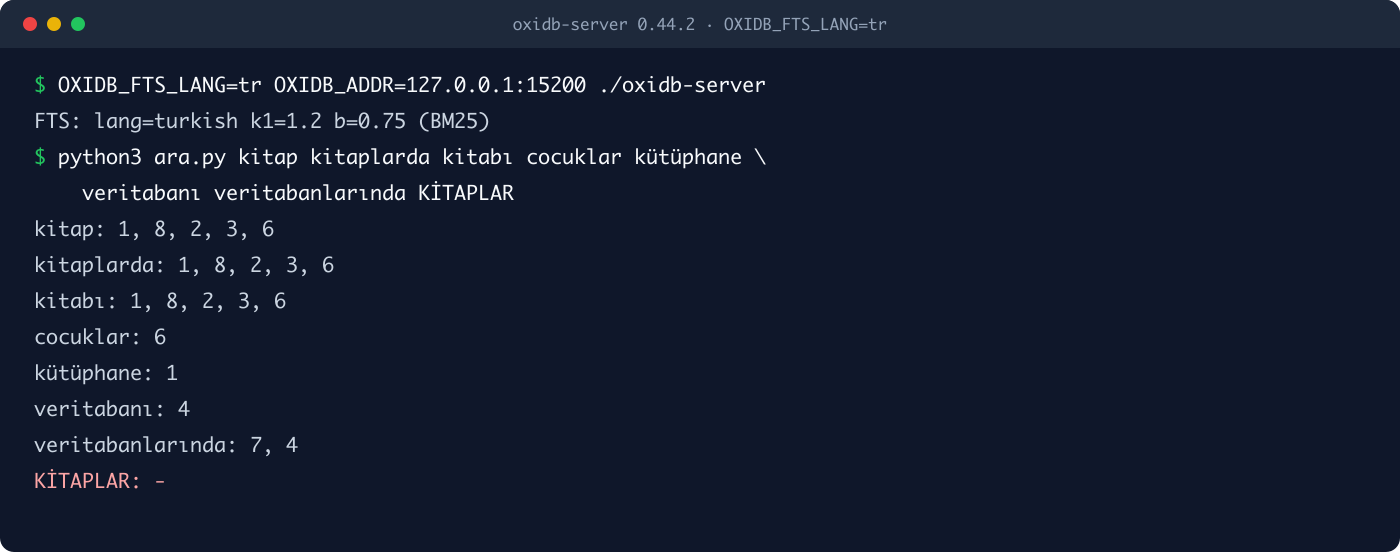
Los números de documento: 1 "eski kitaplar", 2 "Bu kitabı", 3 "Kitaplarda geçen", 6 "masal kitapları", 8 "kitapların listesi", 4 "veritabanı, veritabanımı" (base de datos, mi base de datos), 7 "Veritabanlarında" (en las bases de datos).
Hay dos cosas que llaman la atención. Escribir cocuklar sin caracteres turcos encuentra igualmente "Çocuklar" (niños), porque el tokenizador elimina los diacríticos antes del stemming (ç→c, ş→s, ğ→g, ı→i, ö→o, ü→u). Es un efecto secundario útil para quien no tiene teclado turco. La misma sesión muestra también el coste de esa decisión; vuelvo a ello en el apartado de límites.
Cómo se interpreta una consulta
text_search combina los términos de la consulta con OR: cualquier documento que coincida con algún término entra en el resultado, y los que coinciden con más términos puntúan más alto. Una búsqueda de eski kitaplar ("libros antiguos") pone arriba el único documento que contiene "eski" y lista a continuación los que solo contienen "kitap":
== eski kitaplar == 1:3.041; 8:0.550; 2:0.528; 3:0.507; 6:0.507No hay búsqueda de frases entre comillas, ni operadores AND/NOT, ni ponderación por campo. Lo mantuve simple a propósito: la consulta pasa por el mismo tokenizador que los documentos y las contribuciones de los términos se suman. Los empates se resuelven por _id; eso lo añadí más tarde, porque cuando los empates salían en el orden de iteración del hash map, la paginación devolvía páginas distintas de una ejecución a otra.
Fragmentos resaltados: <mark>
Si se pasa highlight, cada resultado incluye fragmentos cortos etiquetados con <mark> de cada campo de texto indexado. Como usa el mismo tokenizador, una consulta de kitaplar también marca kitabı. Esta vez usé la interfaz REST con curl a secas:
curl -s -X POST http://127.0.0.1:15220/api/yazilar/text_search \
  -H 'Content-Type: application/json' \
  -d '{"query":"çocuk kitapları","limit":2,"highlight":{"snippet_chars":50,"max_snippets":1}}'
[
{
"_id": 6,
"_version": 1,
"baslik": "Çocuklar için masallar",
"metin": "Çocuklar için resimli masal kitapları seçerken dikkat ettiğim şeyler.",
"_score": 3.0199245077882484,
"_highlights": {
"baslik": ["<mark>Çocuklar</mark> için masallar"],
"metin": ["<mark>Çocuklar</mark> için resimli masal <mark>kitapları</mark> seçerken dikkat ettiği"]
}
},
{
"_id": 1,
"_version": 1,
"baslik": "Kütüphanedeki eski kitaplar",
"metin": "Kütüphanedeki eski kitaplar yeniden düzenlendi, raflar alfabetik sıraya kondu.",
"_score": 0.6557111258304198,
"_highlights": {
"baslik": ["Kütüphanedeki eski <mark>kitaplar</mark>"],
"metin": ["Kütüphanedeki eski <mark>kitaplar</mark> yeniden düzenlendi, raf"]
}
}
]highlight: true usa los valores por defecto (80 caracteres, como máximo 3 fragmentos); con un objeto se pueden fijar snippet_chars y max_snippets. Los fragmentos se ordenan por densidad de coincidencias. Los puntos de corte se ajustan a los límites de carácter UTF-8: cortar un string de Rust en mitad de una letra turca provoca un panic, así que lo pruebo específicamente con texto en turco. Las etiquetas se pueden cambiar a nivel de biblioteca (highlight_with_tags); el servidor usa <mark>. El resaltado vuelve a tokenizar el texto de cada resultado, así que no es gratis: solo se hace cuando se pide y recorre como mucho los primeros 256 KB de cada campo (OXIDB_FTS_MAX_HIGHLIGHT_BYTES).
Las actualizaciones y los borrados se ven al instante
El índice de texto de la colección se actualiza dentro de la ruta de escritura, así que en cuanto un update retorna, la búsqueda ya ve el texto nuevo:
text_search 'moka' -> 5:1.595
>>> {"cmd": "update", "collection": "yazilar", "query": {"_id": 5}, "update": {"$set": {"metin": "Moka pot ile kahve: bir kitaptan öğrendiğim üç püf noktası."}}}
{"ok": true, "data": {"modified": 1}}
text_search 'moka' -> 5:1.210
text_search 'kitap' -> 1:0.430, 8:0.361, 2:0.346, 3:0.332, 6:0.332, 5:0.307
>>> {"cmd": "delete", "collection": "yazilar", "query": {"_id": 5}}
{"ok": true, "data": {"deleted": 1}}
text_search 'moka' ->
En cuanto el documento 5 contuvo "kitaptan" ("de un libro") se unió a los resultados de kitap, y la puntuación de todos los demás documentos bajó: ahora hay más documentos que contienen el término, así que su IDF disminuyó. Después del borrado, moka no devuelve nada.
BM25: de dónde salen las puntuaciones
La primera versión usaba TF-IDF. Tenía dos problemas: los documentos largos ganaban solo por ser largos, y un documento que repetía una palabra diez veces obtenía diez veces la puntuación. En la 0.25.9 cambié a BM25 con los valores por defecto de Lucene/Elasticsearch, k1 = 1.2 y b = 0.75.
La contribución de un término a la puntuación de un documento:
idf   = ln( (N - df + 0.5) / (df + 0.5) + 1 )
norm  = 1 - b + b * (dl / avgdl)
score = idf * tf * (k1 + 1) / (tf + k1 * norm)
N es el número de documentos, df el número de los que contienen el término, tf la frecuencia del término en este documento, dl el número de tokens del documento y avgdl la media del corpus. En las consultas de varios términos, las contribuciones se suman.
Para ver el comportamiento, preparé a propósito tres documentos en el servidor en inglés: una nota de 8 tokens que menciona "raft" dos veces, un texto de 54 tokens que lo menciona una vez y un documento de 35 tokens que lo repite 13 veces.
== raft ==
1.8004  _id=3  Raft raft raft
1.5453  _id=1  Raft in five minutes
0.5291  _id=2  Notes from a long week of operations
Trece repeticiones solo ganan un 16% más que dos: eso es la saturación de k1. Recalculé las puntuaciones con la fórmula en Python (N=8, avgdl=18.5, df=3, idf=0.9445) y coinciden hasta el cuarto decimal: 1.5453, 0.5291, 1.8004.
Después reinicié el servidor con OXIDB_FTS_B=0, desactivando la normalización por longitud:
FTS: lang=english k1=1.2 b=0 (BM25)
== raft (b=0) ==
1.9022  _id=3  Raft raft raft
1.2986  _id=1  Raft in five minutes
0.9445  _id=2  Notes from a long week of operations
El documento largo pasó de 0.53 a 0.94 y la nota corta bajó de 1.55 a 1.30. No hizo falta reindexar: k1 y b se aplican en tiempo de consulta, y el índice solo almacena tf, dl y el número total de tokens.
Configuración
Todos los parámetros de FTS se leen una sola vez al arrancar el proceso y se guardan en caché (OnceLock), así que cambiarlos requiere un reinicio:
| Variable | Valor por defecto | Qué hace |
|---|---|---|
OXIDB_FTS_LANG | english | Idioma de Snowball: tr, de, fr, es, it, pt, ru, nl, da, fi, hu, no, ro, el, ar, sv, ta, en (18 idiomas) |
OXIDB_FTS_K1 | 1.2 | Saturación de la frecuencia de términos (> 0) |
OXIDB_FTS_B | 0.75 | Normalización por longitud (de 0 a 1) |
OXIDB_FTS_SCORE_CAP | 200000 | Máximo de documentos distintos que puntúa una búsqueda; 0 = sin límite |
OXIDB_FTS_MAX_EXTRACT_BYTES | 4 MB | Máximo de texto extraído de un archivo; 0 = sin límite |
OXIDB_FTS_MAX_HIGHLIGHT_BYTES | 256 KB | Máximo de texto que recorre un resaltado |
OXIDB_FTS_WORKERS | 1 | Hilos de trabajo para indexar archivos |
OXIDB_FTS_FLUSH_INTERVAL_MS | 1000 | Cada cuánto se escribe en disco el índice de blobs |
OXIDB_OCR_LANGS | eng | Idiomas de Tesseract, p. ej. eng+tur (solo con la feature ocr) |
OXIDB_OCR_PREPROCESS | activado | Escala de grises, ampliación 2x y umbral de Otsu antes del OCR |
Una advertencia: el índice almacena términos ya reducidos a su raíz. Si se cambia OXIDB_FTS_LANG sobre datos existentes, las consultas se procesan con el idioma nuevo mientras el índice contiene las raíces del anterior. Tras un cambio de idioma hay que eliminar _text con drop_index y crear el índice de nuevo.
Búsqueda dentro de archivos
Cuando se escribe un archivo en el blob store (con put_object nativo o con un PUT de S3), el servidor lo pone en una cola de FTS. Un hilo de trabajo lee el archivo, extrae el texto según su tipo de contenido y lo añade al índice global. Tipos admitidos:
| Tipo de contenido | Cómo |
|---|---|
text/* | Tal cual |
text/html, text/xml, application/xml | Sin etiquetas |
application/json | Se recogen recursivamente todos los valores de texto |
application/pdf | pdf_extract |
| DOCX | Texto de word/document.xml |
| XLSX | Texto de las celdas en xl/sharedStrings.xml |
image/png, jpeg, tiff, bmp | OCR con Tesseract, solo si se compila con --features ocr |
Lo probé con seis archivos: una nota de reunión en HTML, un catálogo de productos en XML, un archivo de configuración en JSON, un borrador de contrato en DOCX generado con textutil de macOS, una lista de existencias en XLSX y una factura en PDF generada con cupsfilter, todos con contenido en turco. Cinco entraron por el protocolo nativo; el PDF pasó por la interfaz S3 con curl a secas, sin ninguna biblioteca cliente:
curl -s -i -X PUT --data-binary @fatura.pdf -H "Content-Type: application/pdf" \
  http://127.0.0.1:15210/belgeler/fatura.pdf
HTTP/1.1 200 OK
Server: OxiDB-S3
ETag: "a249de4c7ae443472e09ffd73baf6b86"(Aquí la autenticación de S3 estaba desactivada, por eso se aceptó un PUT sin firmar. La parte de S3 se trata en detalle en el artículo sobre S3.)
Como la indexación es asíncrona, fts_status muestra lo que ha pasado: la profundidad de la cola, lo que está haciendo cada hilo de trabajo y cómo terminaron los trabajos recientes:
{"cmd": "fts_status"}
queue_depth: 0, workers: [{"id": 0, "current": null}]
toplanti.html  indexed  0 ms
katalog.xml    indexed  0 ms
ayarlar.json   indexed  0 ms
sozlesme.docx  indexed  0 ms
stok.xlsx      skipped  "no extractor for content type"
fatura.pdf     indexed  3 ms
(La respuesta es JSON; la aplané en líneas para que se lea mejor.) El XLSX se omitió, y el motivo es interesante. Lo había generado con openpyxl de Python, que escribe el texto de las celdas en línea en lugar de en sharedStrings.xml, y el extractor de OxiDB solo lee sharedStrings.xml. Los archivos guardados por el propio Excel usan la tabla de cadenas compartidas, así que la mayoría de los archivos reales no dan problemas, pero el mensaje "no extractor for content type" es engañoso en este caso: el extractor existe, solo que no encontró texto. Volví a empaquetar la misma tabla con una tabla de cadenas compartidas y la subí de nuevo a la misma clave por S3, y se indexó; una sobrescritura elimina la entrada antigua del índice y añade la nueva.
Búsquedas:
== kitap ==      ayarlar.json:0.822; stok.xlsx:0.757; toplanti.html:0.612
== depozito ==   sozlesme.docx:1.426
== kahve ==      katalog.xml:1.221; stok.xlsx:1.124
== tedarikçi ==  stok.xlsx:1.682
== faturası ==   fatura.pdf:1.109
search también admite resaltado, pero aquí cuesta más: el índice no almacena el texto, así que el archivo de cada resultado se vuelve a leer y su texto se vuelve a extraer. Por eso solo se hace cuando se pide:
{"cmd": "search", "query": "kitaplar", "bucket": "belgeler", "limit": 5,
 "highlight": {"snippet_chars": 70, "max_snippets": 1}}
{"ok": true, "data": [
{"bucket": "belgeler", "key": "ayarlar.json", "score": 1.0502388364929411,
"highlights": ["OxiDB demo <mark>Kitap</mark> arşivi için arama ayarları tr e"]},
{"bucket": "belgeler", "key": "toplanti.html", "score": 0.7880432878539266,
"highlights": ["in indeksleme kuyruğu konuşuldu. <mark>Kitapların</mark> PDF sürümleri de aranabilir olac"]}
]}Defensa frente a archivos hostiles
Extraer texto implica analizar entradas no confiables. DOCX y XLSX son archivos zip, y una subida de 100 KB puede inflarse hasta gigabytes. Por eso los lectores de zip dejan de leer al llegar a cuatro veces el límite de texto de 4 MB (Read::take) y la bomba nunca llega a inflarse por completo. Con PDF eso no es posible, porque pdf_extract gestiona su propia memoria; puedo truncar su salida después, pero no puedo acotar la memoria interna de la biblioteca desde fuera, y el código lo dice explícitamente. Los extractores pueden provocar un panic con entradas mal formadas, así que cada trabajo se ejecuta dentro de catch_unwind: con un solo hilo de trabajo, un único panic detenía antes en silencio la indexación de archivos durante el resto de la vida del proceso.
OCR
El texto de las imágenes está detrás de la feature ocr porque necesita las bibliotecas de sistema Tesseract y Leptonica. Antes, la imagen se convierte a escala de grises, se amplía 2x y se binariza con el método de Otsu, lo que marca una diferencia real con fotos de documentos hechas con el móvil. El Dockerfile del repositorio compila el servidor con --features cluster,ocr. El binario precompilado para macOS que usé no tiene OCR: cuando subí un PNG, fts_status informó honestamente skipped: no extractor for content type.
Por dentro: cómo se almacena el inverted index
Tokenizador
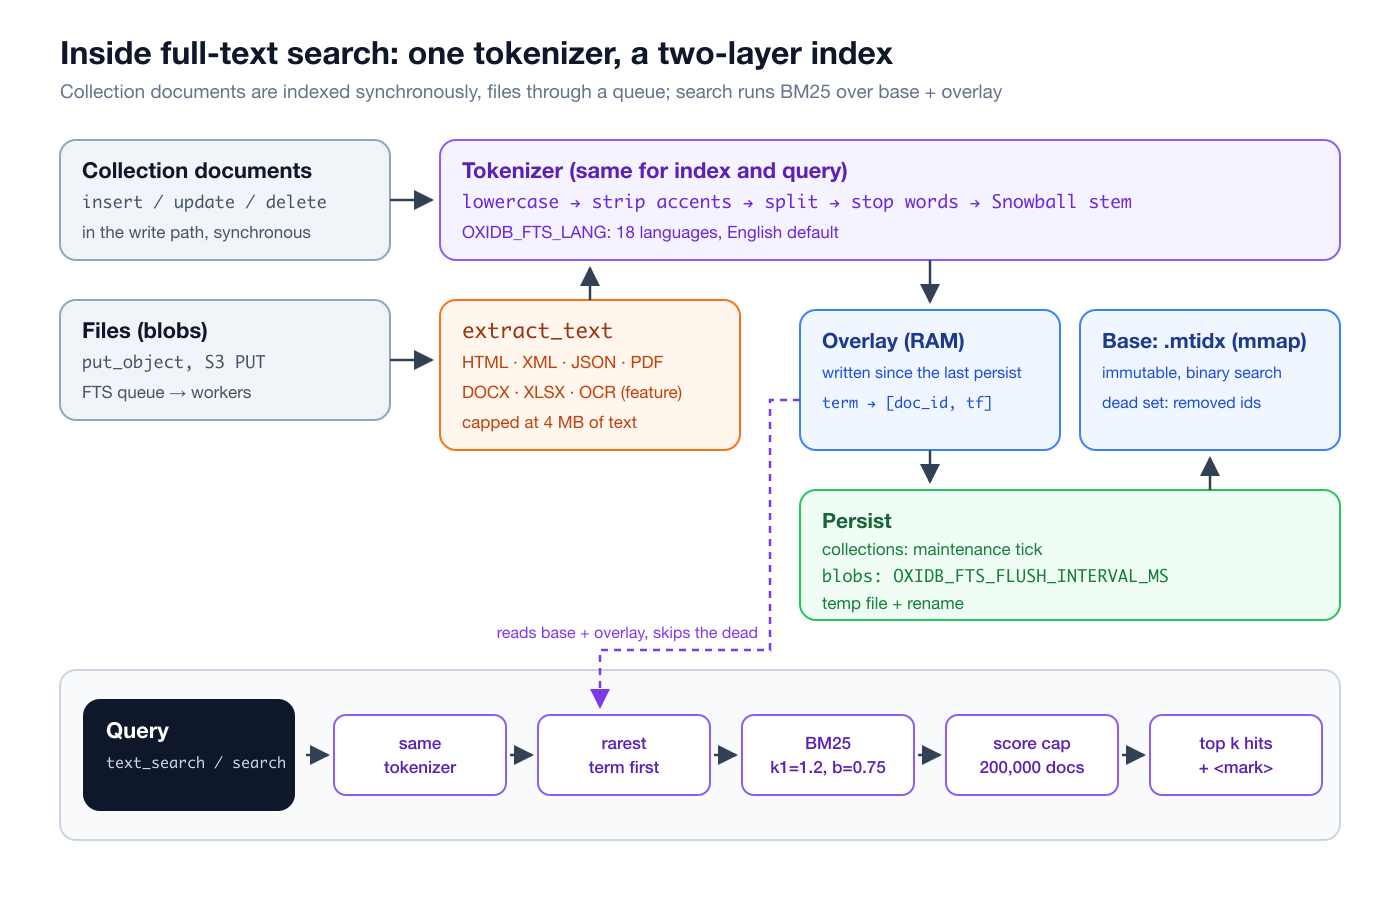
La indexación y las consultas pasan por la misma función: pasar a minúsculas, eliminar diacríticos, dividir por caracteres no alfanuméricos, descartar los fragmentos de una letra y las stop words, y aplicar stemming con Snowball. La lista de stop words es la unión de las listas en inglés y en turco y se aplica siempre, sea cual sea el idioma configurado.
Índice de colección: overlay más una base con mmap
En la primera versión, el índice de texto de la colección vivía entero en RAM y se reconstruía recorriendo la colección cada vez que se abría. Según la medición del propio proyecto (examples/fts_mem_bench.rs, 1 millón de documentos con unos 120 bytes de texto cada uno), ese índice ocupaba 1015 MB mientras que los documentos en sí ocupaban 38 MB. Primero interné los términos con Arc<str> para bajarlo a 785 MB y después le di al índice una forma en disco.
El modelo actual es el modelo .mfidx de los índices de campo aplicado a las postings:
- Base (
<collection>.mtidx): un archivo inmutable abierto con mmap. Una cabecera (magicOXTI, versión, campos, número total de tokens), una tabla de documentos de paso fijo (doc_id u64, dl u32), las postings (12 bytes cada una:doc_id u64, freq u32), una tabla de términos ordenada por bytes y las cadenas de los términos. Tanto la búsqueda de documentos como la de términos son búsquedas binarias directamente sobre el mmap. - Overlay: un pequeño índice en RAM para los documentos escritos desde la última persistencia.
- Conjunto de muertos: la base no se puede editar, así que los ids de los documentos eliminados o reindexados van a un conjunto y la búsqueda se salta sus postings de la base. Es la misma idea que el bitmap de documentos borrados de Lucene.
Los primeros bytes del archivo de mi ejecución:
00000000: 4f58 5449 0100 0000 0200 0500 7469 746c  OXTI........titl
00000010: 6504 0062 6f64 7994 0000 0000 0000 0008  e..body.........
La persistencia ocurre en el tick periódico de mantenimiento en el que se hace snapshot de los documentos: se fusionan la base y el overlay, se descartan los muertos y se escribe un archivo nuevo. La escritura se hace en streaming, término a término; en el archivo las postings van antes que la tabla de términos, así que las postings de cada término se añaden directamente al disco y solo la tabla de términos, del tamaño del vocabulario, espera en memoria. El archivo se escribe con un nombre temporal y se coloca en su sitio con rename, de modo que un fallo deja en vigor el archivo anterior. Si al abrir el archivo falta, está truncado o corrupto, se recorre la colección y se reconstruye el índice. La misma reconstrucción ocurre cuando la recuperación tras un fallo ha reproducido entradas del WAL, porque el índice en disco se escribió antes del fallo y no conoce los registros recuperados.
En las mediciones del proyecto tras este cambio, con 1 millón de documentos el índice residente ocupa 0 MB (mmap), el pico de construcción es de 265 MB con una persistencia cada 200k documentos, y una búsqueda de un término común tiene un pico de 7.3 MB y tarda 35 ms.
Hice una prueba más pequeña en mi máquina: 200,000 documentos de 12 palabras aleatorias cada uno, con "coffee" en la mitad, "curtain" en el 5% y "emerald" en el 0.1%. (Este servidor seguía funcionando con b=0 del experimento anterior; eso no afecta a los tiempos.)
N=200000: insert 2.1s, create_text_index 4.06s
'emerald'          hits(top10)=10  p50=0.11 ms  p95=0.20 ms
'curtain'          hits(top10)=10  p50=1.25 ms  p95=2.42 ms
'coffee'           hits(top10)=10  p50=8.80 ms  p95=11.22 ms
'coffee emerald'   hits(top10)=10  p50=8.81 ms  p95=10.73 ms
Los tiempos incluyen el viaje de ida y vuelta del cliente de Python. El archivo .mtidx ocupó 33 MB (unos 2.7 millones de postings a 12 bytes).
Por qué hay un límite de puntuación
BM25 término a término mantiene una entrada de puntuación por cada documento coincidente antes de aplicar limit. Un término presente en medio millón de documentos supone esa misma cantidad de entradas para una sola búsqueda; el proyecto midió 25 MB por consulta con 500k coincidencias y 51 MB con 1M. Multiplicado por las búsquedas concurrentes, aquello era un OOM. Ahora una búsqueda puntúa como máximo 200,000 documentos distintos. Lo que hace que esto sea seguro es el orden: los términos se procesan del más raro al más común, así que todos los documentos que coinciden con un término raro e informativo se puntúan antes de que se llene el presupuesto, y lo que recorta el límite es la cola de la lista del término más común (el menos informativo). Una vez alcanzado el límite, los documentos ya puntuados siguen acumulando; los nuevos no se admiten.
El índice de blobs y las escrituras por lotes
El índice de archivos usa el mismo modelo (_fts/index.mtidx) con dos diferencias: los documentos se identifican por (bucket, key), así que las postings llevan un ordinal de 4 bytes (8 bytes por posting), y cada documento registra el tamaño en bytes de su texto extraído para contabilizar las cuotas por bucket. En la primera versión el índice era un único index.json, y cada documento añadido reescribía el archivo entero: N² escrituras en disco en una ingesta masiva. Ahora los hilos de trabajo solo marcan el índice como modificado, y un proceso de volcado en segundo plano lo escribe como mucho una vez cada OXIDB_FTS_FLUSH_INTERVAL_MS (1 segundo por defecto). Un index.json heredado se migra al formato mmap en la primera apertura y se elimina; uno corrupto se pone en cuarentena y el índice arranca vacío, porque el FTS es un dato derivado y no debe bloquear el arranque.
Aquí hay un compromiso de consistencia: el índice de la colección está al día en el momento de la escritura, mientras que el índice de blobs va unos milisegundos por detrás hasta que se vacía la cola. Un search justo después de un put_object puede no ver todavía el archivo nuevo. Para eso precisamente existe fts_status.
Búsqueda vectorial
La búsqueda vectorial sirve para guardar embeddings junto a los documentos y preguntar "qué documentos están más cerca en significado de esta consulta". OxiDB no genera embeddings; el vector se calcula aparte (con un modelo) y se guarda en un campo del documento como un array de números.
Índice y consulta
Para este artículo no usé ningún modelo de embeddings. Para mostrar el mecanismo usé vectores de cuatro dimensiones escritos a mano, en los que las dimensiones representan "bases de datos", "búsqueda", "café" y "libros":
{"cmd": "insert_many", "collection": "articles", "docs": [
  {"title": "B-tree page splits explained",       "emb": [0.9, 0.2, 0.0, 0.1]},
  {"title": "Building an inverted index",         "emb": [0.6, 0.9, 0.0, 0.1]},
  {"title": "BM25 by hand",                       "emb": [0.3, 1.0, 0.0, 0.2]},
  {"title": "HNSW graphs for embeddings",         "emb": [0.5, 0.8, 0.0, 0.0]},
  {"title": "Pour-over coffee ratios",            "emb": [0.0, 0.0, 1.0, 0.1]},
  {"title": "Coffee shops with good bookshelves", "emb": [0.0, 0.1, 0.7, 0.7]},
  {"title": "Second-hand books in Istanbul",      "emb": [0.0, 0.1, 0.1, 1.0]},
  {"title": "Reading list: database internals",   "emb": [0.8, 0.3, 0.0, 0.8]}
]}
{"cmd": "create_vector_index", "collection": "articles", "field": "emb", "dimension": 4, "metric": "cosine"}
{"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": [0.7, 0.7, 0.0, 0.0], "limit": 3}
{"ok": true, "data": [
{"title": "Building an inverted index", "emb": [0.6, 0.9, 0.0, 0.1], "_id": 2, "_version": 1,
"_similarity": 0.9882084, "_distance": 0.023583233},
{"title": "HNSW graphs for embeddings", "emb": [0.5, 0.8, 0.0, 0.0], "_id": 4, "_version": 1,
"_similarity": 0.9871956, "_distance": 0.025608778},
{"title": "BM25 by hand", "emb": [0.3, 1.0, 0.0, 0.2], "_id": 3, "_version": 1,
"_similarity": 0.9323735, "_distance": 0.1352529}
]}Un vector de consulta como "libros para leer con un café" ([0, 0, 0.6, 0.8]) cae en una esquina completamente distinta:
sim=0.9925  dist=0.0151  Coffee shops with good bookshelves
sim=0.9258  dist=0.1485  Second-hand books in Istanbul
sim=0.8383  dist=0.3234  Pour-over coffee ratios
sim=0.7734  dist=0.4532  Reading list: database internals
Las reglas son sencillas: cada índice vectorial está ligado a un campo (la notación de puntos funciona), una colección puede tener varios índices vectoriales sobre campos distintos, y los documentos existentes se indexan retroactivamente al crear el índice. Un vector con la dimensión equivocada es un error; un documento sin el campo se omite en silencio. Los resultados vuelven como documentos completos con _distance (cuanto menor, mejor) y _similarity (de 0 a 1, cuanto mayor, mejor) añadidos.
Tres métricas, tres respuestas distintas
La elección de la métrica cambia de verdad el resultado. Para mostrarlo puse los mismos cuatro puntos en tres campos, indexé cada uno con una métrica distinta y consulté con [1, 1]. B apunta en la misma dirección que A pero es cinco veces más largo:
query = [1.0, 1.0]
-- cosine
   A [1.0, 1.0]   distance=-1.19209e-07 similarity=1.0000
   B [5.0, 5.0]   distance=0           similarity=1.0000
   C [1.2, 0.8]   distance=0.0194193   similarity=0.9903
   D [-1.0, 2.0]  distance=0.683772    similarity=0.6581
-- euclidean
   A [1.0, 1.0]   distance=0           similarity=1.0000
   C [1.2, 0.8]   distance=0.282843    similarity=0.7795
   D [-1.0, 2.0]  distance=2.23607     similarity=0.3090
   B [5.0, 5.0]   distance=5.65685     similarity=0.1502
-- dot_product
   B [5.0, 5.0]   distance=-10         similarity=0.0000
   A [1.0, 1.0]   distance=-2          similarity=0.1192
   C [1.2, 0.8]   distance=-2          similarity=0.1192
D [-1.0, 2.0] distance=-1 similarity=0.2689- cosine (
1 - cos) solo mira la dirección: A y B empatan. Es la opción por defecto y la adecuada para embeddings de texto. El-1.19e-07de A es redondeo de coma flotante. - euclidean mira la distancia real: B cae al último puesto.
- dot_product (
-a·b) premia la magnitud: B queda primero. Con vectores normalizados da el mismo orden que cosine y es más barato.
Al preparar esta tabla encontré un bug: con producto escalar el ranking es correcto, pero _similarity está invertida. B, la mejor coincidencia, tiene similitud 0.0000 y D, la peor, 0.2689. El comentario del código dice "sigmoid(dot)", pero calcula 1 / (1 + e^(-distance)) y, como distance ya es -dot, eso es sigmoid(-dot). docs/vector-search.md describe además otra fórmula distinta ((1 + d) / 2). Hasta que lo corrija, con producto escalar conviene usar _distance. list_indexes muestra la métrica como dotproduct; las peticiones aceptan tanto dot_product como dotproduct, y un nombre de métrica no reconocido vuelve en silencio a cosine.
Recorrido exacto o HNSW
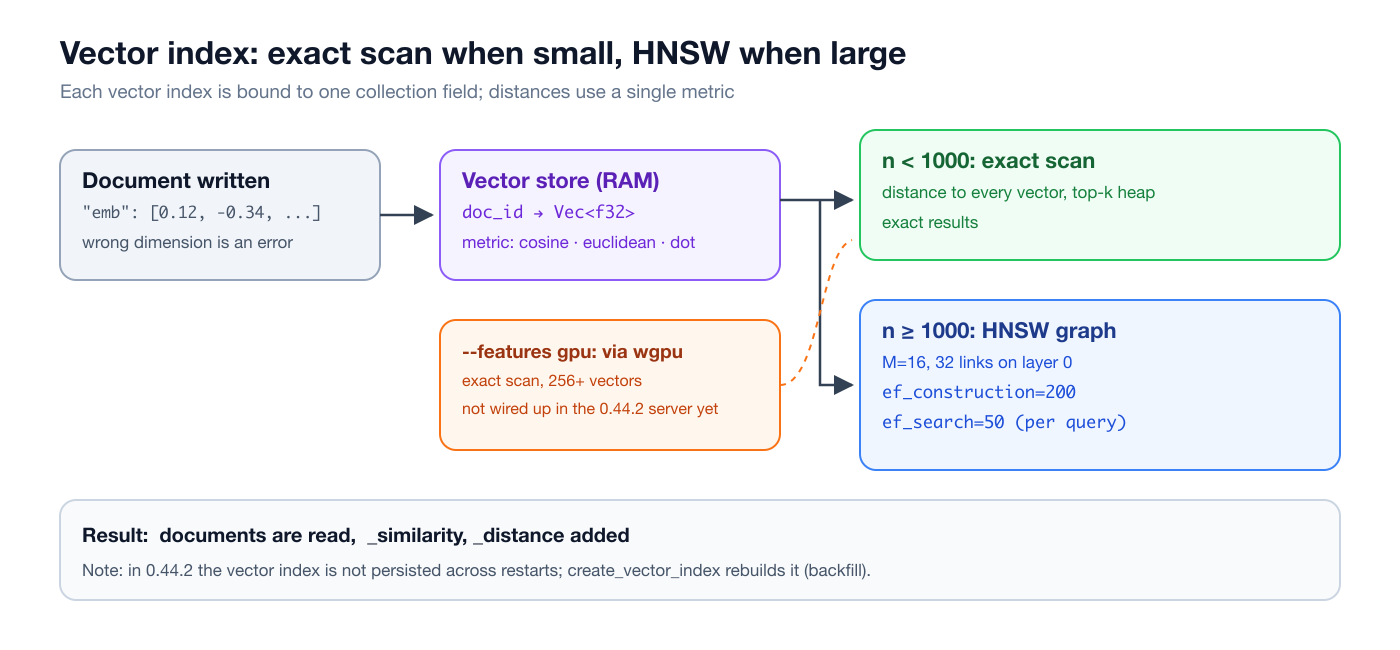
Mientras el índice tiene menos de 1000 vectores, cada consulta calcula la distancia a todos los vectores y guarda los k más cercanos en un heap; el resultado es exacto. Al llegar a 1000 se construye un grafo HNSW (Hierarchical Navigable Small World), y las inserciones posteriores se añaden a él de forma incremental. Parámetros: M = 16 enlaces (32 en la capa 0), ef_construction = 200, y ef_search vale 50 por defecto y se puede fijar en cada petición. Al eliminar un nodo se cortan sus enlaces con sus vecinos, el grafo se reconstruye cuando más del 20% de sus nodos están borrados y, si el número baja de 500, el grafo se descarta y la búsqueda vuelve al recorrido exacto.
La documentación afirma un "recall >95%" para HNSW. Quise medirlo. Generé vectores sintéticos agrupados en torno a 50 centros (más parecidos a embeddings reales que el ruido uniforme), calculé los resultados exactos por coseno para 200 consultas con numpy y los comparé con el top 10 que devolvió OxiDB:
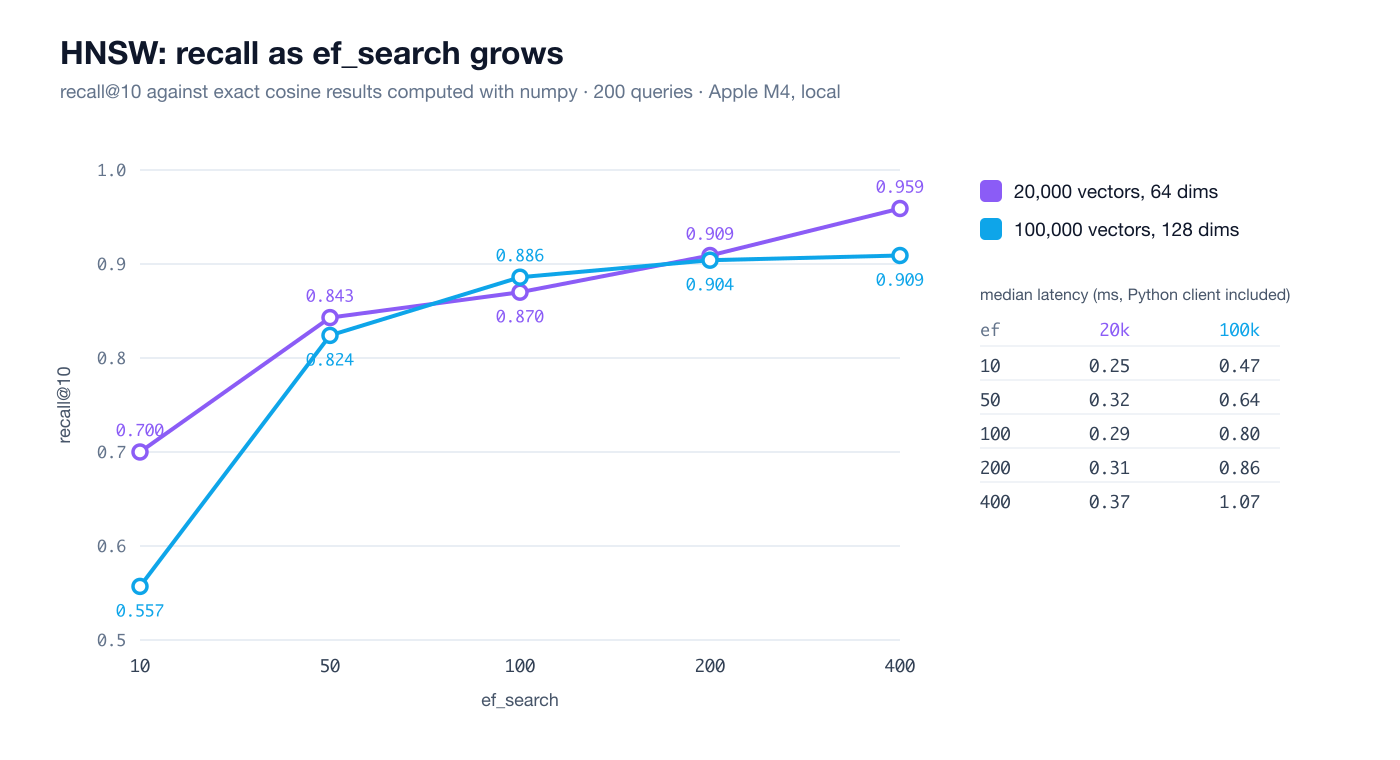
N=20000 D=64: insert 1.03s, create_vector_index 2.28s
ef_search=10   recall@10=0.700  latency p50=0.25 ms  p95=0.35 ms
ef_search=50   recall@10=0.843  latency p50=0.32 ms  p95=0.65 ms
ef_search=100  recall@10=0.870  latency p50=0.29 ms  p95=0.40 ms
ef_search=200  recall@10=0.909  latency p50=0.31 ms  p95=0.39 ms
ef_search=400  recall@10=0.959  latency p50=0.37 ms  p95=0.51 ms

N=100000 D=128: insert 9.92s, create_vector_index 34.45s
ef_search=10   recall@10=0.557  latency p50=0.47 ms  p95=0.54 ms
ef_search=50   recall@10=0.824  latency p50=0.64 ms  p95=0.74 ms
ef_search=100  recall@10=0.886  latency p50=0.80 ms  p95=1.11 ms
ef_search=200  recall@10=0.904  latency p50=0.86 ms  p95=0.97 ms
ef_search=400  recall@10=0.909  latency p50=1.07 ms  p95=1.31 ms
El resultado honesto: con estos datos, el ef_search=50 por defecto da un recall del 82-84%, no del 95%. Con 20k vectores, ef_search=400 llega al 96%; con 100k se estanca en torno al 91%, lo que significa que ahí el límite es la calidad del grafo, no la amplitud de la búsqueda. La latencia se mantiene en torno a un milisegundo en ambos casos (incluido el viaje de ida y vuelta del cliente de Python). Mi consejo práctico: si el recall importa, hay que pasar un ef_search de 200-400. Si se necesitan resultados exactos, ahora mismo no hay forma de forzar un recorrido exacto por encima de 1000 vectores; ese umbral está fijado en el código. En una ejecución de control con 900 vectores, el recall fue 1.000 con cualquier ef_search, como era de esperar.
GPU
Al compilar con --features gpu, src/gpu.rs ejecuta un compute shader WGSL a través de wgpu: tres puntos de entrada para coseno, euclidiana y producto escalar, workgroups de 256, un hilo de GPU por vector almacenado que calcula su distancia a la consulta, y la CPU elige los k mejores. Metal en macOS, Vulkan en Linux, DX12 en Windows. El diseño delega a la GPU los recorridos exactos de 256 vectores o más.
Pero al leer el código para este artículo descubrí que el servidor 0.44.2 inicializa la GPU al arrancar, imprime "GPU compute: enabled" y entrega el handle al motor, y el motor nunca lo pasa a los índices vectoriales de las colecciones (VectorIndex::set_gpu no se llama en ningún sitio). Así que en esta versión la ruta de GPU no se usa en la práctica. De todos modos, el binario que usé estaba compilado sin la feature de GPU, así que no medí nada en GPU. Terminar ese cableado está en mi lista.
Persistencia: el índice vectorial se pierde al reiniciar
docs/vector-search.md dice que el índice se guarda en archivos .vidx y se restaura al arrancar. Eso es cierto para el antiguo motor Collection. En las colecciones B-tree que usa hoy el servidor, el índice vectorial no se escribe ni en los metadatos de índices ni en disco. Después de reiniciar el servidor:
>>> {"cmd": "list_indexes", "collection": "articles"}
{"ok": true, "data": []}
>>> {"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": [0.7, 0.7, 0, 0], "limit": 2}
{"ok": false, "error": "invalid query: no vector index on field 'emb'; create one with create_vector_index"}
Tras el mismo reinicio, el índice de texto volvió al instante desde .mtidx con puntuaciones idénticas. No se pierde ningún dato, porque los vectores viven en los documentos: create_vector_index es idempotente y reconstruye a partir de ellos. Pero con 100k × 128 dimensiones eso lleva 34 segundos. Llamar a create_vector_index al arrancar la aplicación es hoy la respuesta práctica. En el ADR-0003 dejé la búsqueda vectorial fuera de la promesa de estabilidad de la 1.0, marcada como "APIs and on-disk format may change"; esta carencia es una cara concreta de esa decisión.
Uso híbrido
La búsqueda por palabras clave y la búsqueda semántica son buenas en cosas distintas. BM25 no se pierde nombres propios poco frecuentes, códigos de producto ni palabras exactas; la búsqueda vectorial capta sinónimos y preguntas del tipo "algo como esto". OxiDB no tiene un único comando que combine ambas, pero las dos devuelven los mismos documentos con los mismos _id, así que fusionarlas en el cliente es fácil. El método más robusto es Reciprocal Rank Fusion (RRF), que ignora las escalas de puntuación y solo combina posiciones. El código que usé:
def hybrid(text, vec, k=5, rrf_k=60):
    t = o.req({"cmd": "text_search", "collection": "articles", "query": text, "limit": 20})["data"]
    v = o.req({"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": vec, "limit": 20})["data"]
    fused, title = {}, {}
    for rank, d in enumerate(t, 1):
        fused[d["_id"]] = fused.get(d["_id"], 0) + 1 / (rrf_k + rank); title[d["_id"]] = d["title"]
    for rank, d in enumerate(v, 1):
        fused[d["_id"]] = fused.get(d["_id"], 0) + 1 / (rrf_k + rank); title[d["_id"]] = d["title"]
    ...

hybrid("coffee", [0.0, 0.1, 0.1, 1.0])
Añadí un índice de texto sobre title a la misma colección articles y pedí la palabra "coffee" junto con un vector que apunta a "libros":
text   : [('Pour-over coffee ratios', 1.281), ('Coffee shops with good bookshelves', 1.281)]
vector : [('Second-hand books in Istanbul', 1.0), ('Coffee shops with good bookshelves', 0.888), ('Reading list: database internals', 0.851), ('BM25 by hand', 0.64)]
RRF    :
  1. 0.03226  Coffee shops with good bookshelves
  2. 0.03178  Pour-over coffee ratios
  3. 0.01639  Second-hand books in Istanbul
  4. 0.01587  Reading list: database internals
  5. 0.01562  BM25 by hand
"Coffee shops with good bookshelves" aparece en ambas listas y sale primero aunque no ganó en ninguna. Otros patrones que uso:
- Generar candidatos y reordenar: tomar 100 candidatos con
text_searchy reordenarlos en el cliente por coseno frente a los embeddings de los documentos devueltos. No hace falta ningún índice vectorial. - Búsqueda vectorial filtrada: ni
vector_searchnitext_searchaceptan un filtro. Hay que pedir de más (limit: 100) y aplicar la condición de campo en el cliente, u obtener primero confindlos_idpermitidos y hacer la intersección. - Archivos más documentos: guardar los PDF en el blob store y encontrarlos con
search, y guardar los metadatos y el embedding de cada archivo en una colección.
La búsqueda vectorial responde a "qué elemento se parece a este" a partir de embeddings producidos por un modelo. "Qué más compraron quienes compraron esto" es una pregunta distinta, que se responde a partir del comportamiento observado y sin ningún modelo. Para eso construí un motor aparte, que se trata en el artículo sobre el motor de recomendaciones.
Límites y compromisos
Snowball se basa en reglas y no es perfecto con una lengua aglutinante como el turco. Esto es lo que vi en los experimentos para este artículo:
veritabanıyveritabanlarındase reducen a raíces distintas. Una búsqueda deveritabanıno encontró el documento "Veritabanlarında indeks seçimi", mientras queveritabanlarındasí encontró el que contieneveritabanımı.fatura(factura) no encontró "faturası" en el PDF;faturasısí.demleme(infusión) tampoco encontródemlemeknidemlemenin.- Los diacríticos se eliminan antes del stemming. Eso ayuda a las consultas en ASCII, pero el stemmer turco ve
iysen lugar deıyş, lo que puede explicar algunos de los fallos anteriores. KİTAPLARno encontró nada. Elto_lowercasede Rust convierte la mayúscula turcaİenimás un punto combinante (U+0307); el punto combinante no es alfanumérico, así que la palabra se divide en "ki" y "taplar". Es un bug y se corregirá; mientras tanto, conviene pasar las consultas a minúsculas en el cliente con las reglas del turco.- La lista de stop words es inglés más turco y se aplica siempre: en un índice en turco, una búsqueda de
not("nota" en turco) no devuelve nada, porque "not" es una stop word en inglés.
Además: no hay búsqueda de frases, coincidencia aproximada ni ponderación por campo; el idioma es global para el proceso, no por colección; el índice de blobs va unos milisegundos por detrás; el índice vectorial vive en RAM y hay que reconstruirlo tras un reinicio; el recall de HNSW está por debajo del 95% con la configuración por defecto; vector_search no acepta filtros, y el método vector_search del cliente de Python todavía no pasa ef_search (una petición en bruto sí puede).
Lo que obtengo a cambio: un único binario, una única copia de los datos, un índice de texto que se actualiza junto con el documento, postings en disco que no inflan la RAM y la posibilidad de subir un PDF a S3 con curl y buscar dentro de él en menos de un segundo. Además del protocolo nativo, los comandos están disponibles por REST (POST /api/{collection}/text_search, donde también se aplican las reglas de lectura a nivel de fila) y como herramientas en el servidor MCP. El repositorio incluye también una pequeña interfaz de búsqueda con subida por arrastrar y soltar, un visor de documentos y resultados resaltados en examples/fts-load-tests, y una demo aparte en examples/fts-demo.
Cómo probarlo
Los binarios precompilados y las notas de versión están en la página de releases de GitHub. La imagen de Docker se compila con soporte de OCR. Para buscar en turco basta con esto:
OXIDB_FTS_LANG=tr ./oxidb-serverDespués, create_text_index sobre una colección, unos cuantos PDF en un bucket, y text_search y search. Si se tienen embeddings, se pueden poner junto a los documentos con create_vector_index, pero hay que acordarse de repetir esa llamada después de un reinicio. El siguiente artículo de la serie trata las consultas geoespaciales y el recorrido de grafos sobre los mismos documentos: consultas geoespaciales y de grafos.