MQTT y AMQP en OxiDB: un PUBACK significa en disco
Los brokers MQTT 3.1.1 y AMQP 0-9-1 dentro de OxiDB: QoS 1/2 honestos, sesiones y colas durables que sobreviven a kill -9, ingesta de MQTT a colecciones y un worker AMQP que consume las publicaciones MQTT de un sensor.
OxiDB incluye dos brokers de mensajería: un broker MQTT 3.1.1 y un broker AMQP 0-9-1 (el protocolo que habla RabbitMQ). Ambos viven en el mismo binario, en el mismo proceso, y ambos obtienen su durabilidad del mismo lugar: la ruta de escritura con fsync del motor de documentos. Este artículo recorre toda la capa: por qué puse un broker dentro de una base de datos, cómo conseguí que el broker MQTT cumpliera realmente su promesa de "QoS 1", por qué añadí AMQP encima, cómo las lecturas de un sensor MQTT acaban en la cola de un worker AMQP y qué estructuras de datos hacen que todo funcione. Todos los ejemplos se ejecutaron en mi propia máquina (Apple M4, macOS, en local) contra un proceso real de oxidb-server 0.44.2, y nada en el lado del cliente es específico de OxiDB: mosquitto_pub/mosquitto_sub, paho-mqtt 2.1.0 y pika 1.4.4, de serie y sin modificar.
¿Por qué hay un broker dentro de una base de datos?
El broker MQTT nació para un escenario IoT. En la demo ColdChain, unas sondas de temperatura envían lecturas por MQTT y esas lecturas deben almacenarse y consultarse. La configuración clásica necesita tres piezas para ello: un broker (Mosquitto, EMQX), un servicio puente y una base de datos. En su lugar, coloqué el broker en el borde de la base de datos: una lectura puede escribirse en el motor de documentos en el momento en que llega, pasar al motor de series temporales y llegar también a los suscriptores de OxiMem (la capa compatible con Redis).
En algún momento surgió la pregunta obvia: ya que hay un broker, ¿debería OxiDB incorporar un motor de mensajería separado al estilo de Kafka o RabbitMQ? La respuesta está escrita en el ADR-0015 (uno de los registros de decisiones de arquitectura del proyecto), y es que no. El valor de Kafka está en el liderazgo por partición con replicación ISR. Poner eso encima del clúster Raft de líder único de OxiDB implica o bien encaminar cada mensaje a través de un único líder Raft (tirando por la borda el paralelismo por particiones, que es precisamente lo importante) o bien pelearse con el modelo de consenso. Habría sido un Kafka falso o un lastre para el clúster. Así que decidí hacer honesto el broker que ya tenía y, más tarde, añadí AMQP encima (ADR-0016).
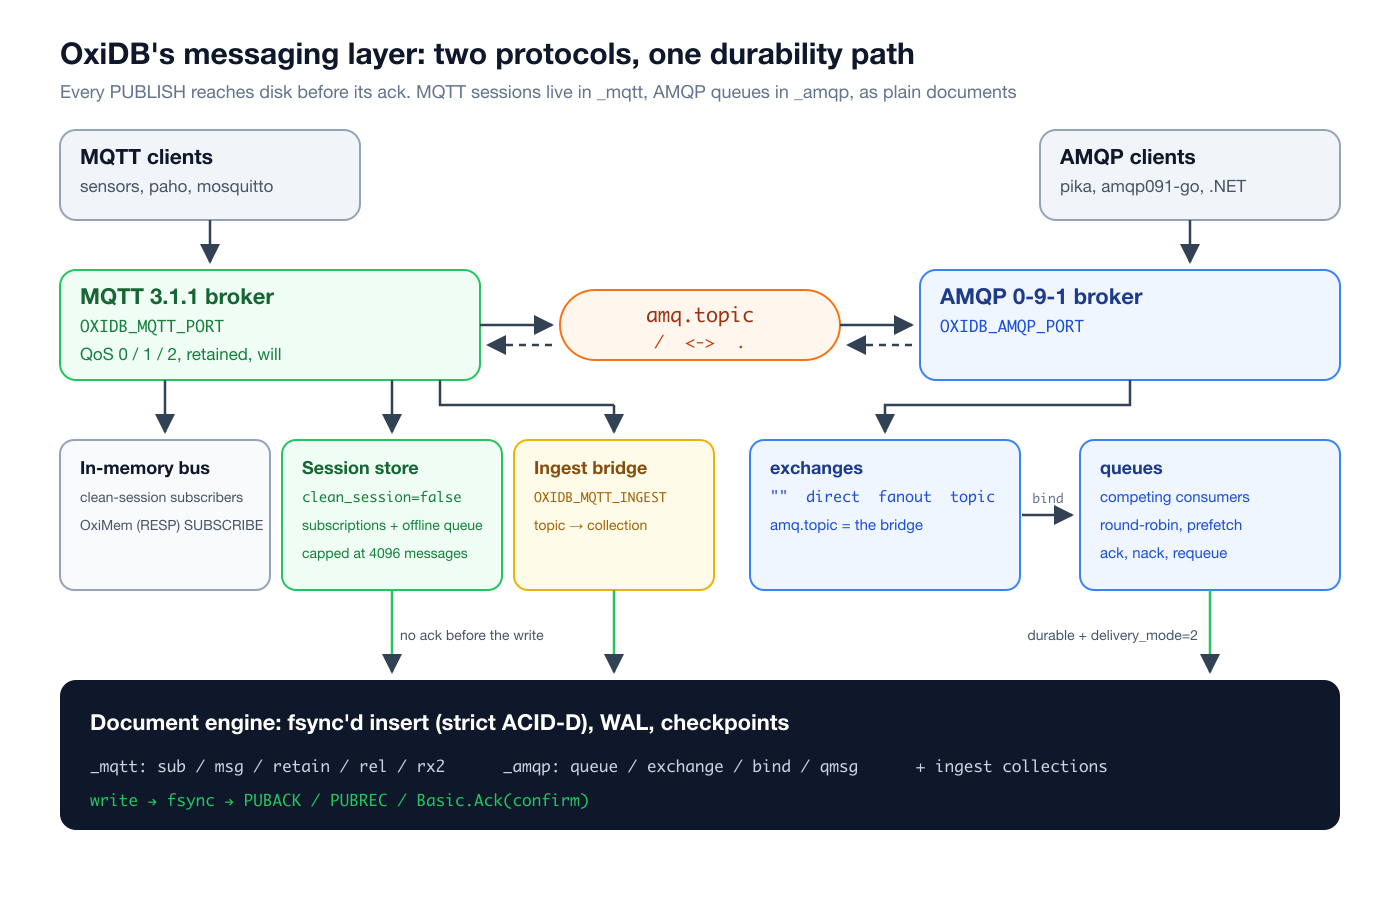
La idea central de este artículo: en OxiDB, en el momento en que se confirma un mensaje (PUBACK en MQTT, un publisher confirm en AMQP), ese mensaje está en disco, con fsync. El broker no tiene ningún formato de archivo nuevo. Las sesiones, los mensajes en cola y los valores retenidos son documentos normales en las colecciones _mqtt y _amqp.
Activarlo: unas cuantas variables de entorno
Todos los listeners de protocolo están desactivados por defecto y no cuestan nada mientras lo están. Para los experimentos de este artículo arranqué el servidor así (con puertos de mi rango asignado):
OXIDB_ADDR=127.0.0.1:15800 \
OXIDB_DATA=$PWD/data \
OXIDB_MQTT_PORT=15804 \
OXIDB_AMQP_PORT=15805 \
OXIDB_MQTT_PERSIST=1 \
OXIDB_MQTT_INGEST="sensors/#:sensor_readings,fleet/+/pos:pings" \
oxidb-server| Variable | Qué hace |
|---|---|
OXIDB_MQTT_PORT | Listener MQTT 3.1.1 |
OXIDB_MQTT_PERSIST | Escribe las sesiones persistentes, los mensajes QoS 1/2 en cola y los valores retenidos a través del motor de documentos, de modo que sobreviven a una caída. Desactivado por defecto |
OXIDB_MQTT_INGEST | Puente de MQTT a colección: una lista de rutas topic-filter:collection, se admiten comodines |
OXIDB_MQTT_USER / OXIDB_MQTT_PASSWORD | Si están definidas, CONNECT debe llevar un usuario y una contraseña coincidentes |
OXIDB_AMQP_PORT | Listener AMQP 0-9-1. Con MQTT también activo, el exchange amq.topic hace de puente entre ambos |
OXIDB_AMQP_USER / OXIDB_AMQP_PASSWORD | Autenticación PLAIN; abierto si no están definidas |
El log de arranque indica qué partes están activas (el servidor usa una raya larga en estas líneas; aquí la sustituí por un guion, todo lo demás es literal):
MQTT listening on 0.0.0.0:15804
MQTT persistence on - recovered 0 sessions, 0 pending messages
MQTT ingest bridge on - 2 route(s)
AMQP listening on 0.0.0.0:15805 - recovered 0 durable queues, 0 messages
Un detalle que conviene notar: los listeners MQTT y AMQP se enlazan a 0.0.0.0, así que el 127.0.0.1 de OXIDB_ADDR no los cubre. En producción, active la autenticación o proteja los puertos con un firewall.
MQTT 3.1.1: primero la parte corriente
Lo básico que cualquier broker debería hacer: topics, suscripciones con comodines y mensajes retenidos. Publico dos temperaturas de habitaciones como retenidas, me suscribo con home/+/temp y luego publico dos mensajes más:
mosquitto_pub -p 15804 -t 'home/livingroom/temp' -m '22.4' -r -q 1
mosquitto_pub -p 15804 -t 'home/kitchen/temp'    -m '24.1' -r -q 1
mosquitto_sub -p 15804 -t 'home/+/temp' -v -q 1 &
mosquitto_pub -p 15804 -t 'home/bedroom/temp'     -m '19.8' -q 1
mosquitto_pub -p 15804 -t 'home/bedroom/humidity' -m '55'   -q 1
home/livingroom/temp 22.4
home/kitchen/temp 24.1
home/bedroom/temp 19.8Las dos primeras líneas son los valores retenidos que se entregan en el momento en que el suscriptor se conecta; la tercera es en vivo. home/bedroom/humidity no coincide con el filtro. + coincide exactamente con un nivel, y un # al final coincide con el resto (incluido nada).
Esto lo hace cualquier broker. Lo que distingue al de OxiDB es lo que significa QoS.
QoS honesto: la historia del ADR-0015
MQTT tiene tres niveles de entrega. QoS 0 es "como máximo una vez": disparar y olvidar. QoS 1 es "al menos una vez": el broker debe conservar un mensaje hasta que el suscriptor envíe su PUBACK, retransmitirlo con el flag DUP si se rompe la conexión y, para un cliente que se conectó con clean_session=false, guardar los mensajes que llegan mientras está desconectado y reproducirlos cuando vuelve. QoS 2 es "exactamente una vez": un handshake en dos fases PUBREC/PUBREL/PUBCOMP más deduplicación por packet id.
El primer broker MQTT de OxiDB no cumplía esa promesa, pero se comportaba como si la cumpliera. Cuando audité mi propio código mientras escribía el ADR-0015, esto es lo que encontré: el bucle de entrega activaba el flag de QoS 1 y asignaba un packet id, y la web decía "QoS 1 delivery with packet ids". Pero:
- un mensaje QoS 1 entregado no se guardaba en ningún sitio mientras esperaba su PUBACK, así que nunca podía volver a entregarse;
- el PUBACK de un suscriptor se leía y se descartaba, porque no había ningún registro que confirmar;
- una publicación solo llegaba a los suscriptores que tenían un canal vivo en ese instante, así que un suscriptor que se desconectaba un momento perdía el mensaje por completo;
clean_session=falseno hacía nada; CONNACK siempre decíasession_present=0.
El protocolo decía al-menos-una-vez y el comportamiento era como-máximo-una-vez. Lo clasifiqué como un bug de corrección: el sistema afirmaba una garantía que no cumplía. Primero corregí la documentación para que reflejara la realidad y después elevé el comportamiento a lo que la documentación afirmaba antes. La regla es sencilla: un broker que promete menos y entrega más es aceptable; lo contrario es el bug en sí.
Sesiones persistentes: el receptor pertenece a la sesión, no al socket
La corrección gira en torno a un pequeño cambio de diseño. En el broker antiguo, SUBSCRIBE entregaba a la conexión un mpsc::Receiver; cuando el socket se cerraba, el receptor se liberaba y todo lo que se enviaba al canal se evaporaba. En el nuevo diseño el receptor pertenece a la sesión. Un canal mpsc sigue almacenando en búfer mientras su receptor esté vivo aunque nadie lea, así que una publicación dirigida a una sesión desconectada sigue llegando al canal. Mientras hay una conexión asociada, la conexión lo vacía; mientras no la hay, un único hilo recolector de todo el broker (cada 500 ms) lo vacía en la cola acotada de la sesión.
Una sesión es un struct indexado por client id: la lista de suscripciones, los mensajes salientes que esperan PUBACK (en un BTreeMap por packet id, para que la reentrega sea ordenada), la cola de mensajes que llegaron mientras estaba desconectada, dos conjuntos para QoS 2 y un contador de generación. Cuando llega un segundo CONNECT con el mismo client id (MQTT-3.1.4-2: gana el recién llegado), la generación se incrementa; la conexión antigua que perdió la carrera de la toma de control ve el cambio y termina en lugar de entregar por duplicado.
La cola de desconexión está acotada: MAX_QUEUED = 4096 por sesión. Cuando se llena, se descarta el mensaje más antiguo y sube un contador (dropped). En telemetría, la lectura más reciente es la que vale la pena conservar, y QoS 1 promete "al menos una vez", no "nunca se pierde con un atasco ilimitado frente a un consumidor muerto". Un consumidor lento no debe poder dejar al broker sin memoria.
OXIDB_MQTT_PERSIST: probarlo con SIGKILL
Las sesiones en memoria protegen frente a las desconexiones de los clientes, pero un reinicio del servidor las borra. Con OXIDB_MQTT_PERSIST=1, las sesiones, los mensajes en cola y los valores retenidos se escriben a través del WAL del motor de documentos. Aquí me tomé en serio la propia regla del ADR: "un test que pasa sin un subproceso matado con SIGKILL no demuestra nada". Así que este lo ejecuté con kill -9.
El escenario: un worker de una cámara frigorífica se suscribe a plant/+/alarm con QoS 1 y una sesión persistente, y luego se desconecta. Una sonda publica tres alarmas y espera un PUBACK por cada una. Después mato el servidor, lo reinicio y vuelvo a conectar el worker. El lado de Python usa paho-mqtt:
import paho.mqtt.client as mqtt
from paho.mqtt.enums import CallbackAPIVersion

def client(cid, clean):
    return mqtt.Client(CallbackAPIVersion.VERSION2, client_id=cid, clean_session=clean)

# 1) subscribe, then drop
c = client("cold-room-worker", False)
def on_connect(c, u, flags, rc, props):
    print(f"CONNACK rc={rc} session_present={flags.session_present}")
    c.subscribe("plant/+/alarm", qos=1)
def on_subscribe(c, u, mid, rcs, props):
    print(f"SUBACK granted={[r.value for r in rcs]}")
    c.disconnect()

# 2) publisher: wait for the PUBACK of every message
p = client("probe-17", True)
info = p.publish("plant/room1/alarm", '{"seq": 1, "temp_c": -12.5}', qos=1)
info.wait_for_publish()
Suscribirse y desconectarse, y luego tres publicaciones:
CONNACK rc=Success session_present=False
SUBACK granted=[1]
PUBACK mid=1 topic=plant/room1/alarm
PUBACK mid=2 topic=plant/room2/alarm
PUBACK mid=3 topic=plant/room1/alarm
PUBACK mid=4 topic=plant/status (retained)
En este punto miré la colección _mqtt con el propio cliente Python de OxiDB a través del protocolo nativo. Todo el estado del broker está ahí, como documentos normales:
{"_kind": "retain", "topic": "home/livingroom/temp", "payload": "22.4", "_id": 1, "_version": 1}
{"_kind": "retain", "topic": "home/kitchen/temp", "payload": "24.1", "_id": 2, "_version": 1}
{"_kind": "sub", "client": "cold-room-worker", "filter": "plant/+/alarm", "qos": 1, "_id": 3, "_version": 1}
{"_kind": "msg", "client": "cold-room-worker", "seq": 1, "topic": "plant/room1/alarm", "payload": "{\"seq\": 1, \"temp_c\": -12.5}", "qos": 1, "_id": 4, "_version": 1}
{"_kind": "msg", "client": "cold-room-worker", "seq": 2, "topic": "plant/room2/alarm", "payload": "{\"seq\": 2, \"temp_c\": -3.1}", "qos": 1, "_id": 5, "_version": 1}
{"_kind": "msg", "client": "cold-room-worker", "seq": 3, "topic": "plant/room1/alarm", "payload": "{\"seq\": 3, \"temp_c\": 4.8}", "qos": 1, "_id": 6, "_version": 1}
{"_kind": "retain", "topic": "plant/status", "payload": "online", "_id": 7, "_version": 1}
Ahora kill -9, un reinicio y el regreso del worker. El log de arranque:
MQTT persistence on - recovered 1 sessions, 3 pending messagesEl worker se reconecta con el mismo client id y clean_session=false; por separado, un cliente "dashboard" con sesión limpia se suscribe a plant/status:
CONNACK rc=Success session_present=True
PUBLISH topic=plant/room1/alarm qos=1 dup=0 payload={"seq": 1, "temp_c": -12.5}
PUBLISH topic=plant/room2/alarm qos=1 dup=0 payload={"seq": 2, "temp_c": -3.1}
PUBLISH topic=plant/room1/alarm qos=1 dup=0 payload={"seq": 3, "temp_c": 4.8}
PUBLISH topic=plant/status retain=1 payload=online
session_present=True por fin significa algo: la suscripción volvió de un proceso matado. Las tres alarmas se entregaron en orden de seq, y el valor retenido online también sobrevivió al reinicio. A medida que el worker envía el PUBACK de cada mensaje, se borra su registro _kind: "msg"; después de la ejecución, la misma consulta volvió vacía.
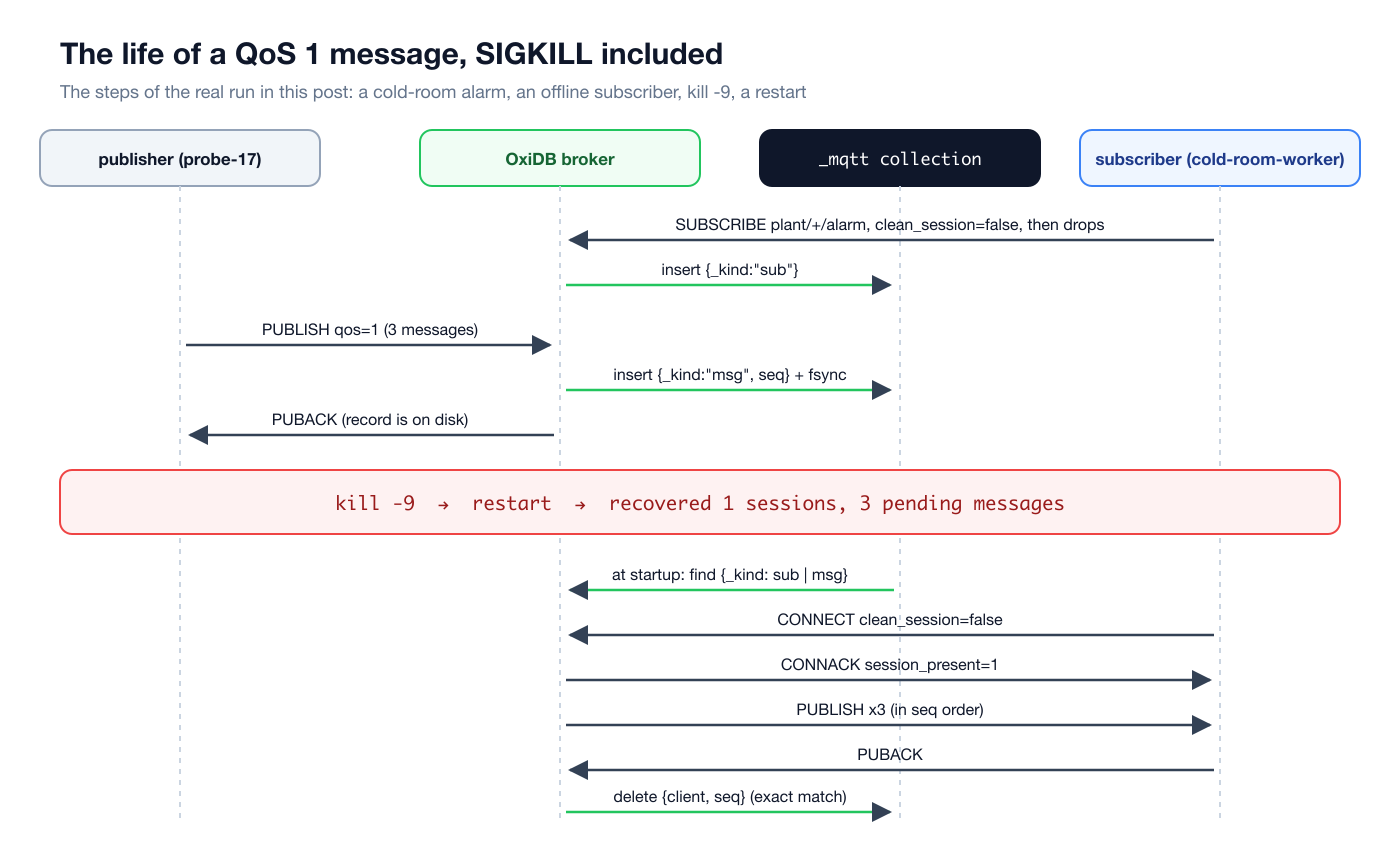
Hay un detalle pequeño pero importante en ese borrado: al recibir el PUBACK, el registro se borra por (client, seq), no por contenido. Borrar por contenido colapsa los duplicados: si se publica el mismo payload dos veces y se confirma una vez, una coincidencia por contenido borra ambos registros y rompe silenciosamente el al-menos-una-vez de la segunda copia. Por eso cada mensaje en vuelo en memoria lleva el número de secuencia de su registro en disco.
La recuperación también tiene su propio límite. Una ventana de caída puede dejar más de MAX_QUEUED registros en disco; al arrancar se cargan los más recientes y el excedente se borra también del disco, porque de lo contrario un reinicio resucitaría mensajes que el límite ya había descartado.
QoS 2: exactamente una vez
QoS 2 funciona en ambas direcciones. El flag -d de los clientes mosquitto muestra el flujo de paquetes. Un contador publica en meter/42/kwh con QoS 2, y un cliente de facturación está suscrito a meter/+/kwh con QoS 2:
Client meter-42 sending CONNECT
Client meter-42 received CONNACK (0)
Client meter-42 sending PUBLISH (d0, q2, r0, m1, 'meter/42/kwh', ... (6 bytes))
Client meter-42 received PUBREC (Mid: 1)
Client meter-42 sending PUBREL (m1)
Client meter-42 received PUBCOMP (Mid: 1, RC:0)
Client meter-42 sending DISCONNECT
Client billing sending SUBSCRIBE (Mid: 1, Topic: meter/+/kwh, QoS: 2, Options: 0x00)
Client billing received SUBACK
Subscribed (mid: 1): 2
Client billing received PUBLISH (d0, q2, r0, m1, 'meter/42/kwh', ... (6 bytes))
Client billing sending PUBREC (m1, rc0)
Client billing received PUBREL (Mid: 1)
Client billing sending PUBCOMP (m1)
1532.7Dos conjuntos sostienen esto. En el lado entrante, rx2: los packet ids de las publicaciones que ya he distribuido pero cuyo PUBREL todavía no he visto. Si el publicador retransmite con el mismo id (DUP), el id está en el conjunto, así que solo repito el PUBREC y no vuelvo a distribuir el mensaje; ese conjunto es toda la diferencia entre "exactamente una vez" y "al menos una vez con un handshake más elaborado". En el lado saliente, pubrel_pending: los ids de los que he recibido un PUBREC y a los que debo un PUBCOMP. El registro del mensaje se borra en el PUBREC (a partir de ahí el mensaje es del receptor), pero la obligación del PUBREL tiene que sobrevivir, o la máquina de estados del suscriptor se queda atascada en un id pendiente para siempre. Con la persistencia activada, ambos conjuntos van a disco como documentos _kind: "rx2" y _kind: "rel"; el exactamente-una-vez también tiene que sobrevivir a una caída.
Ningún ack antes de la escritura. ¿Cuánto cuesta?
El orden de la ruta de publicación está detallado en mqtt.rs: distribuir al bus en memoria, luego el insert con fsync para las sesiones persistentes, luego pasarlo al puente AMQP y al puente de ingesta y, solo entonces, enviar el PUBACK (PUBREC en QoS 2). Así que un PUBACK no significa "lo he recibido"; significa "está en disco para cada suscriptor durable que lo vaya a necesitar".
Eso tiene que costar algo, así que lo medí. Misma máquina (Apple M4, directorio de datos en el SSD interno), 500 publicaciones QoS 1 secuenciales con paho, esperando cada PUBACK. En la primera ejecución ningún suscriptor persistente coincidía con el topic; en la segunda, uno sí (desconectado):
bench/nobody: 500 sequential QoS1 publishes, p50=0.059 ms p99=0.185 ms total=0.03 s
bench/durable: 500 sequential QoS1 publishes, p50=4.164 ms p99=9.006 ms total=2.25 s
Aproximadamente 70 veces, y todo es fsync. En macOS, OxiDB usa un vaciado completo al almacenamiento estable (F_FULLFSYNC), que cuesta unos milisegundos. Si no coincide ningún suscriptor persistente, no hay ningún fsync; si el servidor no tiene ninguna sesión persistente, toda la ruta se omite con una sola carga atómica (el flag has_durable). Solo pagan quienes lo necesitan. Son cifras del peor caso, secuenciales en una sola conexión; con varios publicadores el panorama cambia, y el group commit que describo en la sección de AMQP existe precisamente para eso.
OXIDB_MQTT_INGEST: de un topic a un documento consultable
El puente de ingesta es la pieza más práctica que escribí para quienes usan MQTT como entrada de datos. OXIDB_MQTT_INGEST es una lista de rutas topic-filter:collection separadas por comas. Cada publicación que coincide se convierte en un documento de esa colección:
- si el payload es un objeto JSON, el propio objeto se convierte en el documento (así
{"value": ..}se puede consultar comovalue, no comopayload.value); - cualquier otra cosa se envuelve como
{"payload": ...}; - en ambos casos el documento recibe
_topic(el topic concreto en el que se publicó; con una ruta con comodines, así se distinguen las filas) y_received_at(milisegundos epoch).
El parser divide cada entrada por su último :, porque un nivel de topic MQTT puede contener ese carácter. Una ruta mal formada impide que el servidor arranque: un filtro con # en medio (a/#/b) no coincide con nada según la especificación MQTT, así que es una errata, y no quería que se convirtiera en un puente que en silencio nunca se dispara.
Cinco publicaciones, una de ellas sin ruta asignada:
mosquitto_pub -p 15804 -q 1 -t sensors/greenhouse/temp     -m '{"value": 27.3, "unit": "C"}'
mosquitto_pub -p 15804 -q 1 -t sensors/greenhouse/humidity -m '{"value": 71, "unit": "%"}'
mosquitto_pub -p 15804 -q 1 -t sensors/garage/temp         -m '18.9'
mosquitto_pub -p 15804 -q 1 -t fleet/u42/pos -m '{"lat": 41.0151, "lon": 28.9795, "speed": 34}'
mosquitto_pub -p 15804 -q 1 -t chat/general  -m '{"msg": "not mapped"}'
Después, un vistazo a las colecciones con el cliente nativo:
with OxiDbClient(port=15800) as db:
    print("collections:", sorted(...db.list_collections()))
    for d in db.find("sensor_readings", {}):
        print(json.dumps(d, ensure_ascii=False))
    for d in db.find("sensor_readings", {"value": {"$gte": 25}}):
        print(d["_topic"], d["value"], d["unit"])
    for d in db.find("pings", {}):
        print(json.dumps(d))
collections: ['_alerts', '_amqp', '_mqtt', '_schedules', 'pings', 'sensor_readings']
{"value": 27.3, "unit": "C", "_topic": "sensors/greenhouse/temp", "_received_at": 1791754335817, "_id": 1, "_version": 1}
{"value": 71, "unit": "%", "_topic": "sensors/greenhouse/humidity", "_received_at": 1791754335830, "_id": 2, "_version": 1}
{"payload": 18.9, "_topic": "sensors/garage/temp", "_received_at": 1791754335839, "_id": 3, "_version": 1}
--- find value >= 25
sensors/greenhouse/temp 27.3 C
sensors/greenhouse/humidity 71 %
--- pings
{"lat": 41.0151, "lon": 28.9795, "speed": 34, "_topic": "fleet/u42/pos", "_received_at": 1791754335848, "_id": 1, "_version": 1}chat/general no fue a ninguna parte. Un número suelto como 18.9 se envolvió bajo payload. Todo lo demás es ahora un documento normal: se puede indexar, agregar y usar con todo el lenguaje de consultas del motor de documentos. La colección pings, con sus coordenadas, está lista para consultas geoespaciales.
El insert ocurre antes del ack de QoS del broker, así que una publicación confirmada también está de forma durable en la colección. Cuando el puente no está configurado, su coste por publicación es una carga atómica (OnceLock::get).
AMQP 0-9-1: lo que MQTT no puede expresar
En el ADR-0015 había aplazado, no rechazado, una cola durable al estilo de RabbitMQ: "una vez que existan las sesiones persistentes, un almacén de mensajes en vuelo y la reentrega respaldada por el WAL, una superficie de cola durable es un incremento encima, no un motor aparte". Luego la pregunta volvió en forma de protocolo: ¿pueden los clientes de RabbitMQ existentes hablar con OxiDB?
AMQP no es una extensión de MQTT; es un segundo protocolo con una semántica realmente nueva: los consumidores en competencia. Una suscripción MQTT copia cada mensaje a cada suscriptor que coincide. Una cola AMQP entrega cada mensaje exactamente a uno de sus consumidores. Eso es distribución de trabajo, la razón por la que RabbitMQ se sitúa entre los productores y los grupos de workers. OxiDB tenía pub/sub (MQTT, OxiMem) pero no una cola de trabajo.
Mantuve el alcance deliberadamente estrecho y tracé la línea con honestidad. Soportado: el handshake de conexión (PLAIN), canales, heartbeats, el exchange por defecto ("", encamina por nombre de cola), los exchanges direct, fanout y topic, Queue.Declare (durable, exclusive, auto-delete, con nombre asignado por el servidor, passive), Queue.Bind, cuerpos de varios frames, Basic.Consume/Deliver/Get/Cancel, Basic.Ack (incluido multiple), Basic.Nack/Reject, prefetch con Basic.Qos, el flag mandatory con Basic.Return, y publisher confirms. Fuera del alcance: la clase tx, los exchanges headers, los bindings de exchange a exchange, el TTL y la prioridad por mensaje, los argumentos de dead-letter, los exchanges alternativos, AMQP 1.0 (un protocolo completamente distinto), los streams y cualquier interfaz de gestión.
Exchanges: direct, fanout, topic
Todos ellos en un solo script de pika:
import pika
conn = pika.BlockingConnection(pika.ConnectionParameters("127.0.0.1", 15805))
ch = conn.channel()

ch.exchange_declare("orders", exchange_type="direct")
for q, key in [("q.paid", "paid"), ("q.refund", "refunded")]:
    ch.queue_declare(q); ch.queue_bind(q, "orders", routing_key=key)
for key, body in [("paid", "order-1001"), ("refunded", "order-0999"),
                  ("paid", "order-1002"), ("cancelled", "order-1003")]:
    ch.basic_publish("orders", key, body)

ch.exchange_declare("cache-bust", exchange_type="fanout")
for q in ("node-a", "node-b", "node-c"):
    ch.queue_declare(q); ch.queue_bind(q, "cache-bust")
ch.basic_publish("cache-bust", "ignored", "invalidate:/products/42")

ch.exchange_declare("logs", exchange_type="topic")
binds = {"all-errors": "*.error", "eu-everything": "eu.#", "eu-west-db": "eu.west.db.*"}
for q, pat in binds.items():
    ch.queue_declare(q); ch.queue_bind(q, "logs", routing_key=pat)
for key in ["api.error", "eu.west.db.error", "eu.west.db.slow", "eu", "us.east.api.info"]:
    ch.basic_publish("logs", key, key)
Vaciando las colas con basic_get:
server product: OxiDB

== direct exchange
q.paid   -> ['order-1001', 'order-1002']
q.refund -> ['order-0999']

== fanout exchange
node-a -> ['invalidate:/products/42']
node-b -> ['invalidate:/products/42']
node-c -> ['invalidate:/products/42']

== topic exchange
all-errors     *.error        -> ['api.error']
eu-everything  eu.#           -> ['eu.west.db.error', 'eu.west.db.slow', 'eu']
eu-west-db     eu.west.db.*   -> ['eu.west.db.error', 'eu.west.db.slow']
El pedido cancelled no coincidió con ningún binding y se descartó (comportamiento normal de AMQP sin mandatory). En el exchange topic, * coincide exactamente con una palabra y # con cero o más: eu.# también capturó la clave eu sola, mientras que *.error no se quedó con eu.west.db.error, de cuatro palabras.
Confirms, mandatory, nack y un rechazo honesto
ch.confirm_delivery()
ch.queue_declare("jobs")
ch.basic_publish("", "jobs", "resize:img-1.png")
try:
    ch.basic_publish("", "no-such-queue", "lost?", mandatory=True)
except pika.exceptions.UnroutableError as e:
    ...
m, _, body = ch.basic_get("jobs");  ch.basic_nack(m.delivery_tag, requeue=True)
m, _, body = ch.basic_get("jobs");  ch.basic_ack(m.delivery_tag)
ch.exchange_declare("hdr", exchange_type="headers")
== publisher confirms + mandatory
confirmed: resize:img-1.png
UnroutableError: ['NO_ROUTE'] [312]
== nack with requeue
got resize:img-1.png redelivered = False -> basic_nack(requeue=True)
got resize:img-1.png redelivered = True -> basic_ack
== unsupported exchange type
ChannelClosedByBroker: 540 exchange type 'headers' is outside ADR-0016's scope; supported: direct, fanout, topicLa última línea es mi parte favorita del diseño. Un cliente que usa algo que no implemento recibe un error de canal que menciona el ADR (540 NOT_IMPLEMENTED), no una aceptación silenciosa. Un exchange headers que se acepta sin decir nada y nunca encamina nada es el tipo de problema que lleva días depurar.
Un detalle sobre mandatory: el Basic.Return se envía antes del confirm. pika recoge el return, luego ve el ack y lanza UnroutableError, que es también lo que hace RabbitMQ. El cliente de .NET me enseñó que un Return sin un ack detrás no debe quedarse en el búfer hasta el siguiente heartbeat, así que ahora cada lote termina exactamente con un flush.
Consumidores en competencia y prefetch
Esta es la funcionalidad por la que se añadió AMQP. Dos workers consumen la misma cola: uno rápido (50 ms por tarea) y uno lento (500 ms). Puse 12 tareas en la cola, primero sin prefetch y luego con basic_qos(prefetch_count=1):
def worker(name, cost):
    conn = pika.BlockingConnection(P); ch = conn.channel()
    ch.queue_declare(Q, durable=True)
    if prefetch: ch.basic_qos(prefetch_count=prefetch)
    def on_msg(ch, m, props, body):
        time.sleep(cost)
        log.append((name, body.decode()))
        ch.basic_ack(m.delivery_tag)
    ch.basic_consume(Q, on_msg)
    ...
prefetch=unlimited fast: 6 jobs ['job-02', 'job-04', 'job-06', 'job-08', 'job-10', 'job-12']
prefetch=unlimited slow: 6 jobs ['job-01', 'job-03', 'job-05', 'job-07', 'job-09', 'job-11']
prefetch=1 fast: 10 jobs ['job-01', 'job-03', 'job-04', 'job-05', 'job-06', 'job-07', 'job-08', 'job-09', 'job-10', 'job-12']
prefetch=1 slow: 2 jobs ['job-02', 'job-11']Sin prefetch es round-robin puro: cada tarea va al siguiente consumidor por turno, y el worker rápido se queda ocioso mientras el lento dedica tres segundos a sus seis. Con prefetch=1, cada worker puede tener como máximo un mensaje sin confirmar; a un consumidor que está en su límite se le salta el turno en favor de uno con capacidad. El worker rápido recibió 10 tareas y el lento 2. Ese es todo el sentido del prefetch: un worker ocupado no debe bloquear la cola que tiene detrás.
Los mensajes sin confirmar vuelven al principio de la cola, marcados con redelivered=true, cuando muere su canal o su conexión. Sus registros en disco nunca se borraron, así que una caída en esa ventana no cambia nada.
La durabilidad sigue al protocolo: una cola durable y kill -9
MQTT necesitaba OXIDB_MQTT_PERSIST porque MQTT 3.1.1 no tiene en el protocolo ningún concepto de almacenamiento. AMQP sí: el cliente declara una cola durable y publica con delivery_mode=2 (persistente). Declara su intención en el protocolo. Por eso no existe OXIDB_AMQP_PERSIST: una cola durable con mensajes persistentes es durable, sin más. Una cola transitoria vive en memoria, porque el cliente lo pidió así al no decir durable.
La prueba: tres facturas persistentes en la cola durable invoices, más un borrador con delivery_mode=1, más un mensaje en la cola transitoria scratch, todo con publisher confirms. Después, la colección _amqp:
{"_kind": "queue", "name": "invoices", "_id": 31, "_version": 1}
{"_kind": "qmsg", "queue": "invoices", "seq": 25, "exchange": "", "rkey": "invoices", "props": "kAAKdGV4dC9wbGFpbgI=", "body": "aW52b2ljZS0x", "_id": 32, "_version": 1}
{"_kind": "qmsg", "queue": "invoices", "seq": 26, "exchange": "", "rkey": "invoices", "props": "kAAKdGV4dC9wbGFpbgI=", "body": "aW52b2ljZS0y", "_id": 33, "_version": 1}
{"_kind": "qmsg", "queue": "invoices", "seq": 27, "exchange": "", "rkey": "invoices", "props": "kAAKdGV4dC9wbGFpbgI=", "body": "aW52b2ljZS0z", "_id": 34, "_version": 1}
(La colección también contenía registros de colas de experimentos anteriores; aquí dejé solo las líneas de invoices.) El borrador y el mensaje de scratch no están en disco: uno no es persistente y la cola del otro no es durable. El cuerpo y las propiedades se guardan codificados en base64. props es la sección de propiedades del content header, literal tal como llega por la red, así que el broker devuelve content_type, los correlation ids y las cabeceras de aplicación en la entrega sin modelar ninguno de ellos.
Después, kill -9 y un reinicio:
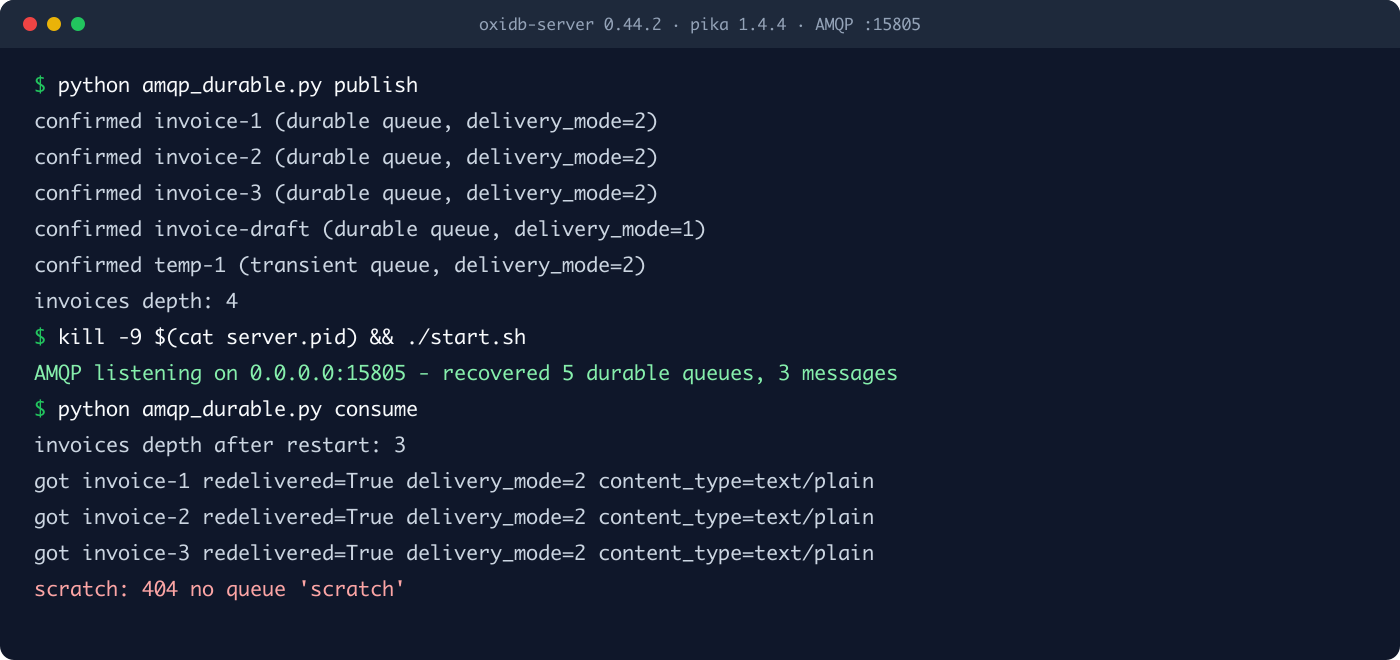
Los mensajes persistentes volvieron con content_type=text/plain intacto, y la cola transitoria ha desaparecido (404). Cada mensaje recuperado lleva redelivered=True. Es deliberadamente conservador: "puede que este mensaje se entregara antes de la caída" es la promesa que el flag existe para cumplir, y llevar la cuenta del estado exacto de entrega costaría una escritura en disco por entrega.
Aquí también noté una cosa pequeña: el log dice "recovered 5 durable queues", pero solo había tres colas durables distintas. El motivo es que Queue.Declare escribe su registro como "borrar y luego insertar" sin tener el lock del broker, así que cuando tres conexiones declararon la misma cola en el mismo momento (los dos workers y la conexión de preparación en la prueba de prefetch), acabaron dos registros en disco. La recuperación deduplica con entry().or_insert, así que el comportamiento no se ve afectado; solo el contador de arranque cuenta registros. Un pequeño fallo que corregiré en la próxima versión.
El puente de MQTT a AMQP
La última fase del ADR-0016 conecta los dos protocolos dentro de un mismo binario, igual que lo hace el propio plugin MQTT de RabbitMQ: cada publicación MQTT se encamina al exchange topic amq.topic con / convertido en ., y cada publicación AMQP a amq.topic sale por el lado MQTT con . convertido de nuevo en /. amq.topic se declara de antemano al arrancar, así que enlazarse a él no requiere exchange_declare.
El escenario: un sensor de una caldera publica por MQTT en sensors/boiler/temp; un worker AMQP ha enlazado su cola durable temp-alerts a amq.topic con el patrón sensors.*.temp:
ch.queue_declare("temp-alerts", durable=True)
ch.queue_bind("temp-alerts", "amq.topic", routing_key="sensors.*.temp")   # amq.topic is pre-declared
ch.basic_qos(prefetch_count=10)
def on_msg(ch, m, props, body):
    print(f"[amqp worker] exchange={m.exchange} routing_key={m.routing_key} "
          f"delivery_mode={props.delivery_mode} body={body.decode()}")
    ch.basic_ack(m.delivery_tag)
ch.basic_consume("temp-alerts", on_msg)
mosquitto_pub -p 15804 -i boiler-probe -q 1 -t sensors/boiler/temp -m '{"value": 91.5, "unit": "C"}' -d
mosquitto_pub -p 15804 -q 1 -t sensors/boiler/pressure -m '{"value": 2.1, "unit": "bar"}'Client boiler-probe sending CONNECT
Client boiler-probe received CONNACK (0)
Client boiler-probe sending PUBLISH (d0, q1, r0, m1, 'sensors/boiler/temp', ... (28 bytes))
Client boiler-probe received PUBACK (Mid: 1, RC:0)[amqp worker] waiting on temp-alerts <- amq.topic 'sensors.*.temp'
[amqp worker] exchange=amq.topic routing_key=sensors.boiler.temp delivery_mode=2 body={"value": 91.5, "unit": "C"}La lectura de presión no coincidía con el patrón, así que el worker nunca la vio. Una publicación MQTT QoS 1 pasa a AMQP como delivery_mode=2: un mensaje que llegó con una promesa de durabilidad la conserva al cruzar el puente. Y como la misma publicación también coincidía con la ruta de ingesta sensors/#, se escribió en sensor_readings al mismo tiempo:
{"value": 91.5, "unit": "C", "_topic": "sensors/boiler/temp", "_received_at": 1791754410602, "_id": 4, "_version": 1}Un solo PUBLISH de MQTT: a los suscriptores MQTT en vivo, a una cola de trabajo AMQP y a una colección consultable. Todo ello antes del PUBACK.
La dirección inversa también funciona. Publiqué un comando desde AMQP en amq.topic con la clave devices.valve7.cmd, y un mosquitto_sub en devices/+/cmd lo recibió:
[amqp publisher] confirmed amq.topic devices.valve7.cmd
devices/valve7/cmd {"open": false}
El puente tiene protección contra bucles: una publicación que entra en amq.topic desde MQTT se marca con bridge: false y nunca se reenvía de vuelta a MQTT.
Por último, probé el caso más difícil del puente: con el worker caído, el sensor publica dos lecturas QoS 1, el servidor muere con kill -9, vuelve y solo entonces se conecta el worker:
published 2 (worker offline)
AMQP listening on 0.0.0.0:15805 - recovered 6 durable queues, 2 messages
[amqp worker] waiting on temp-alerts <- amq.topic 'sensors.*.temp'
[amqp worker] exchange=amq.topic routing_key=sensors.boiler.temp delivery_mode=2 body={"value": 92.8, "unit": "C"}
[amqp worker] exchange=amq.topic routing_key=sensors.boiler.temp delivery_mode=2 body={"value": 95.1, "unit": "C"}
El PUBACK que recibió el sensor significaba que la copia en la cola AMQP también estaba en disco, y lo estaba. Como amq.topic cuenta como durable, el binding de una cola durable a él (_kind: "bind") también se escribe en disco; el binding sobrevivió al reinicio junto con los mensajes.
Cómo funciona por dentro
Almacenamiento: ningún formato nuevo, solo documentos
Ambos brokers guardan su estado en dos colecciones separadas, como documentos diferenciados por un campo _kind:
| Colección | _kind | Contenido |
|---|---|---|
_mqtt | sub | client, filtro, QoS concedido |
_mqtt | msg | client, seq, topic, payload, QoS: un mensaje que espera PUBACK o en cola |
_mqtt | retain | el último valor retenido por topic (un payload vacío lo borra) |
_mqtt | rel, rx2 | las dos mitades de QoS 2: obligaciones de PUBREL e ids de deduplicación entrantes |
_amqp | exchange, queue, bind | topología durable |
_amqp | qmsg | cola, seq, exchange, routing key, props y body en base64 |
Como escribí en el ADR-0015, el motivo es que no quería una segunda ruta de durabilidad que probar. La maquinaria de colecciones y WAL del motor de documentos ya resuelve la recuperación tras caídas, los checkpoints y el PITR, y el broker obtiene todo eso gratis. El servidor arranca en modo "strict ACID-D": cada commit se hace con fsync. Las colecciones están separadas para que ningún broker pueda corromper la recuperación del otro.
La recuperación se ejecuta al arrancar, antes de que el listener acepte su primera conexión: consultas find por _kind, mensajes ordenados por seq y vueltos a encolar, y el contador de secuencia reanudado en uno más que el mayor seq visto.
Coincidencia de topics: dos protocolos, dos conjuntos de reglas
Los comodines de MQTT y AMQP se parecen, pero no son iguales, y el código tiene dos matchers distintos:
- MQTT (niveles separados por
/):+es exactamente un nivel;#solo es válido como último nivel y significa "el resto, incluido nada". El broker compila cada filtro de suscripción una vez en una regex anclada (^...$):+se convierte en[^/]+y un/#al final se convierte en(/.*)?(por esosensors/#también coincide consensorsa secas). Un filtro sin comodines se convierte en una coincidencia exacta medianteregex::escape. El puente de ingesta aplica las mismas reglas sin regex, con una pequeña función recursiva sobre slices de niveles. - AMQP (palabras separadas por
.):*es exactamente una palabra,#es cero o más palabras y puede aparecer en cualquier parte del patrón.topic_matchesmaneja#con una recursión de dos ramas: consumir el#, o tragarse una palabra de la clave y quedarse en el#.
El puente une ambos mundos cambiando solo el separador (/ y .), exactamente como el plugin MQTT de RabbitMQ. Un binding AMQP usa sus propias reglas como patrón (sensors.*.temp), y un filtro MQTT usa las suyas.
Incluso cuando varios bindings de un exchange coinciden con la misma cola, la cola recibe una sola copia: la lista de destinos se ordena y se deduplica (semántica de RabbitMQ).
La cola AMQP: un objeto compartido
En MQTT el estado durable pertenece a un cliente (la sesión). En AMQP una cola es un objeto compartido con una lista de consumidores y un puntero de round-robin. Cada conexión se ejecuta en su propio hilo y le pregunta al broker "¿qué entregas me debes?" (poll). Cada mensaje listo va al siguiente consumidor por turno; si ese turno pertenece a otra conexión, el mensaje espera a la pasada de esa conexión. Eso es lo que hace que los consumidores compitan de verdad, en lugar de que el que sondea más rápido se lo lleve todo. Un consumidor que está en su límite de prefetch se salta.
La primera versión de este diseño tenía una latencia de extremo a extremo de 51 ms por culpa de un tick de sondeo de 50 ms. Según las notas del proyecto, bajó a 1,15 ms con un tick adaptativo de 1 ms, y luego a 0,02 ms con un despertar entre hilos: cada conexión consumidora tiene un pipe no bloqueante cuyo extremo de lectura está en su conjunto de poll(2) junto al socket TCP; cuando un mensaje llega a una cola, el publicador escribe un byte en el pipe de cada uno de los consumidores de esa cola y su espera en el kernel termina de inmediato. (Solo en Unix; las demás plataformas mantienen el tick adaptativo.)
Group commit: no un fsync por mensaje
La primera versión de la publicación durable hacía un fsync por mensaje; según las mediciones del proyecto, eso daba 264 mensajes por segundo en una sola conexión. Dos capas lo cambiaron:
- Agrupación por conexión. La conexión encamina las publicaciones de una ráfaga en pipeline con
prepare_publishy las acumula (hasta 256, o hasta que se vacía el búfer del socket), luego las escribe todas con un soloinsert_manyy envía los confirms en el orden de publicación. El orden importa: la escritura en disco va primero. Un ack que compite con el encolado y borra un registro que todavía no se ha escrito resucitaría un mensaje ya consumido tras una caída; la antigua ruta mensaje a mensaje tenía exactamente esa ventana mal resuelta. - Group commit entre conexiones. Si no hay ningún commit en disco, la conexión que llega se convierte en líder y escribe todo lo pendiente, ronda tras ronda; las conexiones que llegan mientras está en disco comparten la siguiente ronda y esperan su generación en un
Condvar. La ventana del lote es la propia duración del fsync, así que un publicador solitario lidera su propia ronda de inmediato y no paga nada por esto.
Límites
Ambos brokers siguen la misma disciplina: un consumidor lento o muerto no debe agotar la memoria del broker, y la pérdida nunca debe ser silenciosa. La cola de sesión MQTT está limitada a 4096 mensajes y la cola de mensajes listos de AMQP a 100.000; en ambas se descarta el más antiguo, sube un contador y también se borra el registro en disco del mensaje descartado. Esa última parte importa: si el límite no se aplicara al disco, un consumidor muerto haría crecer la colección para siempre y un reinicio resucitaría mensajes que el límite ya había descartado. Lo aprendí primero en el lado MQTT y en AMQP lo hice bien desde el principio.
Benchmarks del proyecto: comparación con RabbitMQ
El repositorio tiene un benchmark que ejecuta OxiDB y RabbitMQ con el mismo cliente Go (rabbitmq/amqp091-go) y los mismos escenarios. No ejecuté estas cifras para este artículo; son mediciones del propio proyecto del 2026-07-17, en un MacBook arm64, OxiDB 0.36.12 frente a RabbitMQ 4.x (brew), con cuerpos de 100 bytes:
| Escenario | OxiDB | RabbitMQ | Ratio |
|---|---|---|---|
| publish confirms, en pipeline | 246,295 msg/s | 164,224 msg/s | 1.50x |
| publish confirm, secuencial (p50/p99) | 0.02/0.03 ms | 0.03/0.06 ms | 1.74x |
| publicación durable, en pipeline | 53,724 msg/s | 159,614 msg/s | 0.34x |
| publicación durable, 8 conexiones | 103,307 msg/s | 93,172 msg/s | 1.11x |
| throughput de extremo a extremo | 318,330 msg/s | 246,076 msg/s | 1.29x |
| latencia de extremo a extremo (p50/p99) | 0.02/0.05 ms | 0.04/0.06 ms | 1.52x |
La única fila perdedora es una derrota honesta: cada confirm durable de OxiDB está detrás de un F_FULLFSYNC real del lote en el que llegó. Según las notas del proyecto, las colas clásicas de RabbitMQ vacían a disco de forma perezosa a intervalos, así que su confirm persistente no demuestra por sí solo que el mensaje esté en almacenamiento estable. Con ocho conexiones entra en juego el group commit y el resultado se invierte.
Límites y compromisos honestos
- Local al nodo. Las sesiones MQTT y las colas AMQP viven en el nodo en el que viven las conexiones. Un cliente que se reconecta a otro nodo tras un failover no reanuda su sesión. No es casualidad: una cola entre nodos es el diseño de log compartido (Kafka) que ambos ADR rechazan. Los datos durables detrás de la cola (colecciones, series temporales) ya los replican los motores.
- MQTT 3.1.1, no MQTT 5. No hay shared subscriptions, expiración de mensajes ni reason codes. Si se quieren consumidores en competencia, la respuesta es una cola AMQP.
- Un subconjunto de AMQP. La lista de lo que queda fuera del alcance es firme: nada de
tx, exchanges headers, TTL, prioridad, dead-lettering, AMQP 1.0 ni interfaz de gestión. Los clientes que los usan reciben un error explícito. - Las colas acotadas descartan lo más antiguo. Correcto para telemetría, discutible para una cola de pagos. Una cola que se acerca a su límite es motivo de alerta.
- Reentrega conservadora. Cada mensaje AMQP recuperado tras una caída llega con
redelivered=true. Los consumidores deberían ser idempotentes de todos modos; eso es lo que implica el al-menos-una-vez de AMQP. - El coste del fsync es real. En mi ejecución con un solo publicador, secuencial y durable, la diferencia fue de unas 70 veces. Para telemetría que no necesita durabilidad, QoS 0 o una sesión limpia siguen siendo la ruta más barata.
- Autenticación sencilla. Usuario/contraseña en MQTT y PLAIN en AMQP; si no están definidos, los listeners quedan abiertos y enlazados a
0.0.0.0.
Cómo encaja con el resto de OxiDB
La capa de mensajería no es un producto en sí misma; es la puerta de entrada de OxiDB. Las publicaciones MQTT llegan también a los clientes SUBSCRIBE compatibles con Redis de OxiMem a través del bus en memoria (y al revés). El puente de ingesta escribe las lecturas en el motor de documentos, donde el motor SQL puede consultarlas y desde donde las métricas de larga duración pueden pasar al motor de series temporales. Un grupo de workers AMQP puede consumir trabajo que llegó por MQTT y escribir sus resultados de vuelta en OxiDB. Los logs y las alertas tienen su propio artículo en esta serie: logs y alertas.
Para mí, la verdadera lección de esta capa fue que la propiedad más importante de un broker no es su velocidad, sino que su promesa en el protocolo y su comportamiento sean lo mismo. En OxiDB un PUBACK ahora significa "en disco", y lo demuestro con un kill -9 cada vez.
Probarlo
Los binarios precompilados y las imágenes de Docker están en la página de releases de GitHub. Dos variables de entorno activan MQTT y AMQP:
OXIDB_MQTT_PORT=1883 OXIDB_AMQP_PORT=5672 OXIDB_MQTT_PERSIST=1 oxidb-serverDespués de eso, se pueden usar las herramientas de siempre: mosquitto_pub, paho-mqtt, pika, amqp091-go o RabbitMQ.Client. Ninguna de ellas se modificó para OxiDB. Lo siguiente en la serie es el motor de logs y alertas.