El motor SQL de OxiDB: un motor relacional real en sus propios archivos, con el protocolo de PostgreSQL y EF Core
Añadí a OxiDB un segundo motor junto al documental, con su propio WAL y sus propios archivos: restricciones que se aplican, CTE, funciones de ventana, procedimientos almacenados en bytecode de Cobra, psql/psycopg sin modificar y EF Core.
OxiDB nació como una base de datos documental, y durante un tiempo fui terco al respecto: la primera capa SQL que probé, un dialecto delgado montado sobre el motor documental, la eliminé por completo. Pero los proyectos reales seguían haciendo la misma pregunta: "Quiero tablas relacionales para facturas, pedidos y stock. ¿De verdad tengo que ejecutar un PostgreSQL aparte?". Este artículo trata de mi respuesta, el motor SQL que añadí a OxiDB. No es un dialecto. Es un segundo motor con su propio catálogo, su propio WAL y sus propios archivos. Se ejecuta en el mismo proceso junto al motor documental, habla el protocolo de red de PostgreSQL, de modo que clientes como psql y psycopg se conectan sin modificaciones, y en el lado de .NET cuenta con un proveedor completo de EF Core. Todas las salidas de este artículo provienen de sesiones que ejecuté personalmente contra un servidor OxiDB 0.44.2 en un Mac local con Apple serie M.
Este es el cuarto artículo de la serie sobre OxiDB. La parte documental se trata en el artículo sobre el motor documental y el motor de series temporales en el artículo sobre series temporales.
Por qué un motor separado: ADR-0010
El núcleo de la decisión cabe en una sola frase del ADR-0010: dos motores, una instancia, archivos distintos. El motor SQL nunca toca los archivos del motor documental, y el motor documental nunca entra en el directorio SQL. Lo único que comparten es el proceso, el puerto, la autenticación y el ciclo de vida. Nada de archivos compartidos, nada de mapa de bloqueos compartido, nada de formato de almacenamiento compartido.
Fue deliberado. Mi intento anterior ejecutaba consultas SQL sobre colecciones de documentos. Era barato sobre el papel, pero arrastraba la semántica relacional (esquemas fijos, columnas tipadas, claves primarias, claves foráneas) a un almacén que no es relacional, y se obtenía lo peor de ambos mundos. El ADR-0010 sopesó tres opciones y eligió la segunda: un crate oxidb-sql independiente, dueño de su almacenamiento, su WAL, su recuperación, su catálogo, su planificador y su ejecutor. Hoy ese crate tiene unas 30 mil líneas de Rust.
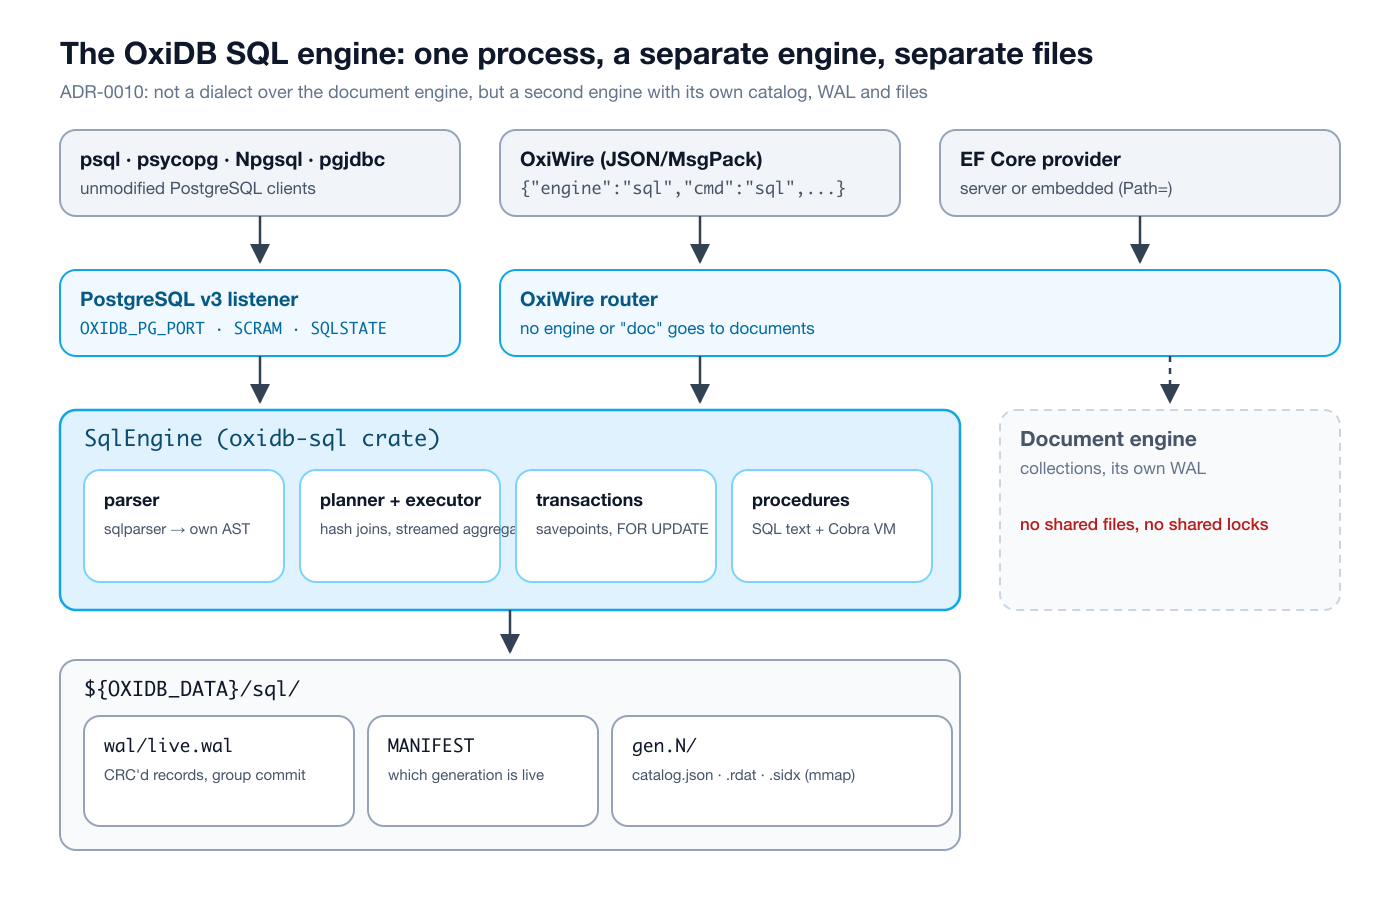
En la práctica, la separación tiene tres consecuencias:
- Los espacios de nombres nunca chocan. Una tabla SQL llamada
customersy una colección de documentos llamadacustomerspueden existir al mismo tiempo, porque nunca comparten directorio. Lo muestro en vivo más abajo. - Desactivado por defecto. Sin
OXIDB_SQLel motor nunca se construye y no cuesta nada. - La compatibilidad del protocolo queda intacta. En el protocolo nativo OxiWire, el enrutamiento se hace mediante un campo opcional
engineen la petición. Cualquier petición sin él va al motor documental exactamente por el mismo camino de código que antes.
El coste es igual de explícito: no existe una transacción atómica que abarque ambos motores. Una escritura documental y una escritura SQL son duraderas cada una por su cuenta, pero nunca forman una unidad atómica. Escribí un diseño para eso en el ADR-0011, basado en un número de secuencia global compartido, y luego lo aplacé deliberadamente: cada carga de trabajo real elegía un motor y se quedaba en él, mientras que el precio habría sido una complejidad permanente en la ruta de recuperación tras caídas, el único lugar donde menos puede permitirse la complejidad.
Puesta en marcha
El motor SQL y el listener de PostgreSQL se activan con dos variables de entorno:
OXIDB_ADDR=127.0.0.1:15400 \
OXIDB_DATA=./data \
OXIDB_SQL=1 \
OXIDB_PG_PORT=15401 \
oxidb-server
Para este artículo usé mis propios puertos. En producción, OXIDB_PG_PORT=5432 significa que las cadenas de conexión existentes funcionan sin cambios. Para un servidor que solo sirve SQL (y opcionalmente series temporales) también se puede establecer OXIDB_DOC=0. Según la documentación, un servidor así se queda en reposo con 9,8 MB de RSS y 8 hilos, frente a 14,2 MB y 23 hilos con el motor documental activado.
Los demás ajustes que importan:
| Variable | Valor por defecto | Significado |
|---|---|---|
OXIDB_SQL_DATA | ${OXIDB_DATA}/sql | Directorio de datos del motor SQL |
OXIDB_SQL_SYNC | full | full: un vaciado real al almacenamiento en cada commit; data: sincronización a nivel del sistema operativo, varias veces más rápida |
OXIDB_SQL_DISK_FIRST | activado | Datos de las tablas servidos desde el snapshot mapeado con mmap, solo los cambios posteriores al checkpoint en RAM |
OXIDB_SQL_CHECKPOINT_BYTES | 64 MiB | Checkpoint automático cuando el WAL vivo supera este tamaño |
OXIDB_SQL_LOCK_TIMEOUT_MS | 5000 | Espera por bloqueo de fila; convierte un interbloqueo en un error |
Una vez que el servidor está en marcha, me conecto con un psql 18 normal de Homebrew. Sin extensiones, sin un driver especial:
psql -h 127.0.0.1 -p 15401 -U admin -d oxidb -c "SELECT version();" version
---------------------
16.0 (OxiDB 0.44.2)
(1 row)Modelo de datos y DDL
Para los ejemplos construí una pequeña tienda: clientes, productos, pedidos y líneas de pedido. El DDL debería resultar familiar a quien venga de PostgreSQL o MySQL:
CREATE TABLE customers (
  id      INT PRIMARY KEY AUTO_INCREMENT,
  name    VARCHAR(40) NOT NULL,
  email   TEXT UNIQUE,
  city    TEXT
);
CREATE TABLE products (
  id     INT PRIMARY KEY,
  name   TEXT NOT NULL,
  price  DECIMAL(10,2) NOT NULL,
  stock  SMALLINT DEFAULT 0
);
CREATE TABLE orders (
  id          INT PRIMARY KEY AUTO_INCREMENT,
  customer_id INT NOT NULL REFERENCES customers(id) ON DELETE CASCADE,
  created_at  TIMESTAMP NOT NULL
);
CREATE TABLE order_items (
  order_id   INT NOT NULL REFERENCES orders(id) ON DELETE CASCADE,
  product_id INT NOT NULL REFERENCES products(id),
  qty        INT NOT NULL,
  CONSTRAINT pk_items PRIMARY KEY (order_id, product_id)
);
Las claves generadas por AUTO_INCREMENT (también escrito AUTOINCREMENT, o el GENERATED ... AS IDENTITY de PostgreSQL) pueden leerse de vuelta con RETURNING, que es exactamente como EF Core y ADO.NET leen las claves generadas:
INSERT INTO customers (name, email, city) VALUES
  ('Ayşe', 'ayse@example.com', 'İstanbul'),
  ('Mehmet', 'mehmet@example.com', 'Ankara'),
  ('Zeynep', 'zeynep@example.com', 'İzmir'),
  ('Can', 'can@example.com', 'İstanbul')
RETURNING id, name;
id | name
----+--------
1 | Ayşe
2 | Mehmet
3 | Zeynep
4 | Can
(4 rows)
INSERT 0 4Un INSERT de varias filas se aplica como un único lote del WAL: primero se valida cada fila y luego todas se escriben con un solo fsync. De la misma forma añadí productos, seis pedidos y once líneas de pedido. Para la introspección están SHOW TABLES, DESCRIBE, SHOW INDEXES, SHOW VIEWS y SHOW PROCEDURES:
DESCRIBE order_items;
   column   | type | nullable | primary_key | auto_increment
------------+------+----------+-------------+----------------
 order_id   | INT  | f        | t           | f
 product_id | INT  | f        | t           | f
 qty        | INT  | f        | f           | f
(3 rows)
Ambas columnas de la clave primaria compuesta aparecen marcadas como primary_key, y ambas son implícitamente NOT NULL.
El sistema de tipos es deliberadamente pequeño: BIGINT, INT, SMALLINT, TINYINT, DOUBLE, TEXT (incluido VARCHAR(n)), BOOL, TIMESTAMP, DECIMAL y BLOB. TIMESTAMP se almacena como milisegundos desde epoch y se trata como UTC. Hay un detalle sobre los enteros que merece su propio párrafo, al que llego en la sección de restricciones.
Restricciones que realmente se aplican
Una restricción que una base de datos acepta y luego ignora en silencio es peor que una que rechaza. Así que la regla es simple: o se aplica, o la documentación dice explícitamente que no. Toda la sesión de abajo es real, exactamente como la imprimió psql:
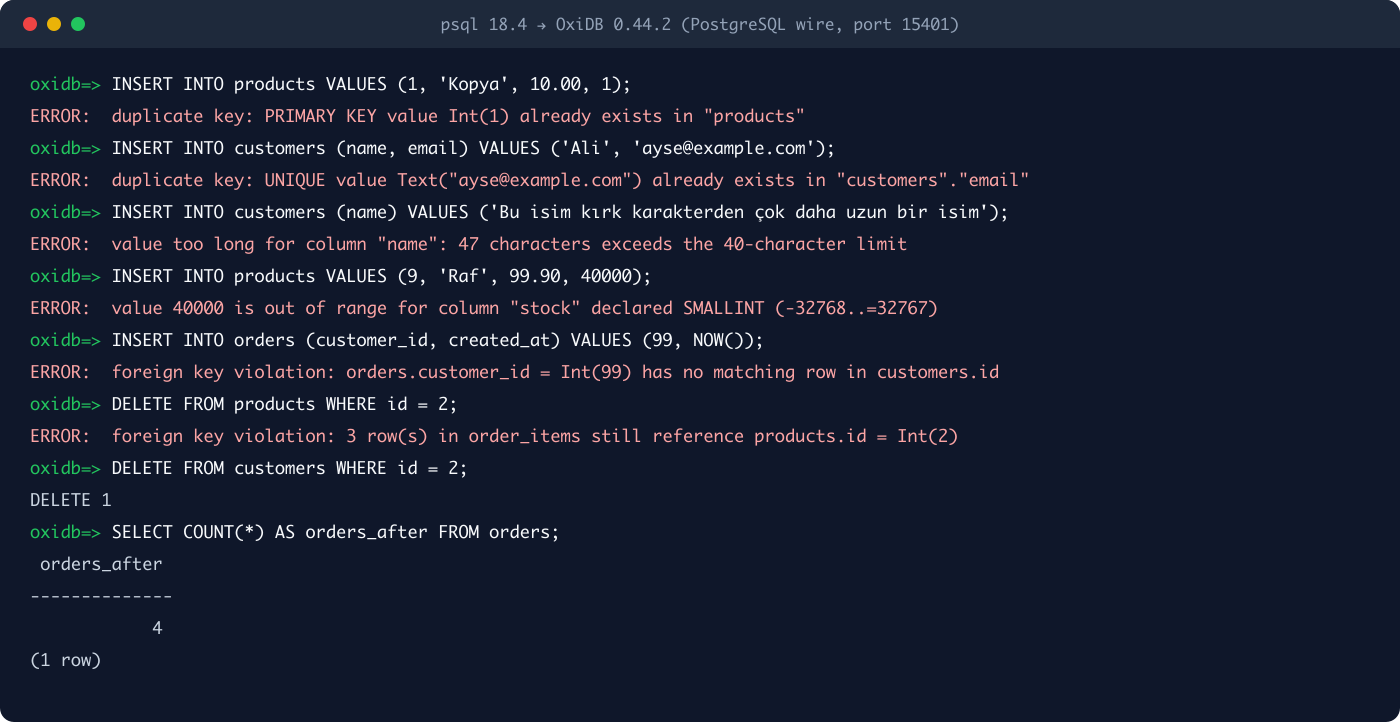
En orden:
- PRIMARY KEY: una clave duplicada se rechaza, en INSERT simples, en INSERT de varias filas (se comprueba sobre todo el lote antes de aplicar ninguna fila), en UPDATE y dentro de transacciones. Una clave compuesta solo colisiona cuando coinciden todas sus columnas;
(1, 1)fue rechazada paraorder_items. - UNIQUE: se aplica
UNIQUEde una sola columna, con los NULL exentos, como dice el estándar SQL. - NOT NULL: un
nameNULL se rechaza conschema mismatch: column "name" is NOT NULL but got NULL. - VARCHAR(n): la longitud se cuenta en caracteres, no en bytes. Un nombre turco de 47 caracteres rompe el límite de 40 caracteres.
- Ancho de los enteros: este es sutil. El motor almacena todos los enteros en 64 bits, así que
SMALLINTno ahorra espacio. Pero un valor fuera del rango declarado se rechaza en lugar de ampliarse en silencio, de modo que el tipo declarado de una columna sigue siendo fiel a su contenido.ALTER TABLE ... ALTER COLUMN ... TYPE SMALLINThace primero una prueba en seco sobre cada fila almacenada, así que el estrechamiento o tiene éxito por completo o deja la columna intacta. - FOREIGN KEY: un INSERT/UPDATE de un hijo debe encontrar a su padre, y un DELETE del padre respeta
ON DELETE NO ACTION,RESTRICT,CASCADEySET NULL. Borrar un producto fue rechazado porque tres líneas de pedido aún lo referenciaban. Borrar un cliente se propagó en cascada dos niveles: los dos pedidos de Mehmet y sus cinco líneas se fueron con él. Antes del borrado había 6 pedidos y 11 líneas; después, 4 y 6.
La capa del protocolo de PostgreSQL asigna estos errores a los códigos SQLSTATE adecuados (23505, 23503, 23502, 22001, 22003), de modo que los drivers lanzan la clase de excepción correcta. Lo muestro con psycopg más abajo.
Lo que no se aplica hay que decirlo con la misma claridad: CREATE UNIQUE INDEX crea un índice normal y su UNIQUE no se aplica. Un UNIQUE a nivel de tabla sobre varias columnas se acepta y no se aplica. Las FK de varias columnas y las acciones ON UPDATE tampoco se aplican. Las restricciones CHECK se rechazan en el análisis sintáctico. Mientras trabajaba en este artículo encontré otra diferencia: en una tabla autorreferenciada (un empleado y su responsable) no se puede insertar el padre y el hijo en el mismo INSERT de varias filas, porque la comprobación de FK ve el estado confirmado y no el propio lote. PostgreSQL comprueba al final de la sentencia y lo acepta. La solución es sencilla: insertar primero el padre, en su propia sentencia.
Consultas: joins, GROUP BY, CTE, funciones de ventana
Añadí un par de clientes, pedidos y líneas más (incluida Ece, de Bursa, que todavía no tiene pedidos) y pasé a las consultas. Un join de cinco tablas con GROUP BY y HAVING:
SELECT c.name, COUNT(DISTINCT o.id) AS orders, SUM(oi.qty * p.price) AS revenue
FROM customers c
JOIN orders o       ON o.customer_id = c.id
JOIN order_items oi ON oi.order_id = o.id
JOIN products p     ON p.id = oi.product_id
GROUP BY c.name
HAVING SUM(oi.qty * p.price) > 5000
ORDER BY revenue DESC;
name | orders | revenue
--------+--------+----------
Zeynep | 2 | 20752.00
Ayşe | 3 | 15401.00
Can | 1 | 6300.00
(3 rows)Los dos decimales no son casualidad: DECIMAL ahora es un tipo exacto, y viaja por el protocolo de PostgreSQL como numeric en forma de texto. Los joins INNER, LEFT, RIGHT, FULL y CROSS se encadenan a cualquier profundidad. Los equi-joins se ejecutan como hash joins, o como joins de array de direccionamiento directo para claves enteras densas; las condiciones ON que no son de igualdad recurren a bucles anidados. Encontrar clientes sin pedidos es un anti-join clásico:
SELECT c.name, c.city
FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
WHERE o.id IS NULL;
name | city
------+-------
Ece | Bursa
(1 row)CTE mediante WITH y funciones de ventana juntas. Una sola consulta ordena los pedidos de cada cliente por total, mantiene un total acumulado por cliente y un ranking global:
WITH order_totals AS (
  SELECT o.id, o.customer_id, o.created_at, SUM(oi.qty * p.price) AS total
  FROM orders o
  JOIN order_items oi ON oi.order_id = o.id
  JOIN products p ON p.id = oi.product_id
  GROUP BY o.id, o.customer_id, o.created_at
)
SELECT customer_id, id AS order_id, total,
       ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY total DESC) AS rn,
       SUM(total)   OVER (PARTITION BY customer_id ORDER BY created_at) AS running,
       RANK()       OVER (ORDER BY total DESC) AS overall_rank
FROM order_totals
ORDER BY customer_id, created_at;
customer_id | order_id | total | rn | running | overall_rank
-------------+----------+----------+----+----------+--------------
1 | 1 | 2151.00 | 3 | 2151.00 | 6
1 | 2 | 7800.00 | 1 | 9951.00 | 2
1 | 11 | 5450.00 | 2 | 15401.00 | 4
3 | 4 | 16850.00 | 1 | 16850.00 | 1
3 | 10 | 3902.00 | 2 | 20752.00 | 5
4 | 5 | 6300.00 | 1 | 6300.00 | 3
(6 rows)ROW_NUMBER, RANK, DENSE_RANK y COUNT/SUM/AVG/MIN/MAX funcionan sobre una ventana. Sin un ORDER BY en la ventana, un agregado cubre toda la partición; con uno, es acumulativo y las filas pares (claves de ordenación iguales) comparten el valor, que es el marco por defecto del estándar. Los marcos explícitos (ROWS BETWEEN ...) todavía no están.
Las CTE no recursivas se transforman en tablas derivadas durante el análisis sintáctico. Una CTE autorreferenciada debe tener la forma anchor UNION [ALL] step y el ejecutor la materializa por iteración de punto fijo: cada paso se vuelve a ejecutar con la CTE ligada a las filas de la iteración anterior. UNION elimina duplicados frente a todo lo visto hasta el momento, así que los ciclos terminan por sí solos, y hay salvaguardas en un millón de iteraciones y diez millones de filas contra consultas desbocadas. Un organigrama:
WITH RECURSIVE chain(id, depth, path) AS (
  SELECT id, 0, name FROM employees WHERE manager_id IS NULL
  UNION ALL
  SELECT e.id, c.depth + 1, c.path || ' > ' || e.name
  FROM employees e JOIN chain c ON e.manager_id = c.id
)
SELECT id, depth, path FROM chain ORDER BY path;
id | depth | path
----+-------+-----------------------------
1 | 0 | Barış
2 | 1 | Barış > Elif
4 | 2 | Barış > Elif > Deniz
6 | 3 | Barış > Elif > Deniz > Mert
5 | 2 | Barış > Elif > Selin
3 | 1 | Barış > Kerem
(6 rows)El mismo mecanismo genera una serie de fechas, con la aritmética de INTERVAL funcionando dentro de la recursión:
WITH RECURSIVE days(d) AS (
  SELECT TIMESTAMP '2026-10-01'
  UNION ALL
  SELECT d + INTERVAL '1 day' FROM days WHERE d < TIMESTAMP '2026-10-04'
)
SELECT d FROM days;
d
---------------------
2026-10-01 00:00:00
2026-10-02 00:00:00
2026-10-03 00:00:00
2026-10-04 00:00:00
(4 rows)LATERAL, DISTINCT ON y agregados de conjunto ordenado
Los tres modismos de PostgreSQL que más uso en analítica también están. "El último pedido de cada cliente" tiene dos respuestas. Una es DISTINCT ON, la primera fila por clave según el ORDER BY:
SELECT DISTINCT ON (customer_id) customer_id, id, created_at
FROM orders
ORDER BY customer_id, created_at DESC;
customer_id | id | created_at
-------------+----+---------------------
1 | 11 | 2026-10-09 08:00:00
3 | 10 | 2026-10-08 11:20:00
4 | 5 | 2026-10-02 12:00:00
(3 rows)La otra es LATERAL: una tabla derivada que puede referenciar las filas a su izquierda y se vuelve a ejecutar por cada fila izquierda. Con LEFT JOIN LATERAL, Ece permanece en el resultado aunque no tenga pedidos:
SELECT c.name, last_o.id AS last_order, last_o.created_at
FROM customers c
LEFT JOIN LATERAL (
  SELECT id, created_at FROM orders o
  WHERE o.customer_id = c.id
  ORDER BY created_at DESC LIMIT 1
) last_o ON TRUE
ORDER BY c.name;
name | last_order | created_at
--------+------------+---------------------
Ayşe | 11 | 2026-10-09 08:00:00
Can | 5 | 2026-10-02 12:00:00
Ece | |
Zeynep | 10 | 2026-10-08 11:20:00
(4 rows)Allí donde EF Core produce CROSS APPLY / OUTER APPLY, el proveedor genera exactamente esta forma [LEFT] JOIN LATERAL. RIGHT y FULL LATERAL se rechazan. Para los agregados de conjunto ordenado está mode() WITHIN GROUP:
SELECT mode() WITHIN GROUP (ORDER BY product_id) AS top_product,
       COUNT(DISTINCT order_id) AS orders
FROM order_items;
top_product | orders
-------------+--------
1 | 6
(1 row)Además de esto: UNION/EXCEPT/INTERSECT (cada uno con una forma ALL y la precedencia estándar), subconsultas correlacionadas a cualquier profundidad, EXISTS, el constructor de tablas VALUES, vistas (CREATE VIEW), CASE, COALESCE, NULLIF, LIKE, CAST, y funciones de cadenas y matemáticas.
Aritmética de fechas
Como TIMESTAMP son milisegundos desde epoch, la aritmética de fechas es simple y predecible. Los literales INTERVAL se reducen a enteros de milisegundos, y funcionan tanto ts ± interval como ts - ts. EXTRACT/date_part y date_trunc usan cálculo de calendario en UTC, semanas ISO (las semanas empiezan el lunes) y la numeración de días de la semana de PostgreSQL:
SELECT id, created_at,
       created_at + INTERVAL '7 days'  AS due,
       date_trunc('week', created_at)  AS week,
       EXTRACT(DOW FROM created_at)    AS dow,
       (TIMESTAMP '2026-10-12' - created_at) / 86400000 AS days_ago
FROM orders ORDER BY id LIMIT 4;
id | created_at | due | week | dow | days_ago
----+---------------------+---------------------+---------------------+-----+----------
1 | 2026-09-01 10:15:00 | 2026-09-08 10:15:00 | 2026-08-31 00:00:00 | 2 | 40
2 | 2026-09-14 18:40:00 | 2026-09-21 18:40:00 | 2026-09-14 00:00:00 | 1 | 27
4 | 2026-09-20 21:30:00 | 2026-09-27 21:30:00 | 2026-09-14 00:00:00 | 0 | 21
5 | 2026-10-02 12:00:00 | 2026-10-09 12:00:00 | 2026-09-28 00:00:00 | 5 | 9
(4 rows)La diferencia entre dos timestamps está en milisegundos, de ahí la división entre 86.400.000 para obtener días. Hay un límite intencionado: INTERVAL solo acepta unidades fijas, y los meses y años se rechazan, porque "un mes" no es un número fijo de milisegundos. Para meses correctos según el calendario existe add_months(ts, n), que ajusta los días que desbordan y es a lo que se traducen AddMonths/AddYears de EF.
Transacciones interactivas
Las transacciones son interactivas: BEGIN abre una transacción que vive a través de varias peticiones en la misma conexión. Sus lecturas ven sus propias escrituras en búfer, y las demás conexiones no ven nada hasta el commit. Los savepoints permiten un rollback parcial:
BEGIN;
UPDATE accounts SET balance = balance - 300 WHERE id = 1;
UPDATE accounts SET balance = balance + 300 WHERE id = 2;
SAVEPOINT bonus;
UPDATE accounts SET balance = balance + 1000000 WHERE id = 2;
ROLLBACK TO SAVEPOINT bonus;
SELECT id, owner, balance FROM accounts ORDER BY id;
COMMIT;
id | owner | balance
----+-------+---------
1 | Ayşe | 700.00
2 | Can | 550.00
(2 rows)El "bonus" de un millón de liras desapareció; la transferencia se mantiene. El commit es un único lote atómico del WAL y un único fsync. Cuando una sentencia falla, la transacción queda envenenada al estilo de PostgreSQL: las sentencias posteriores se rechazan y COMMIT responde ROLLBACK:
BEGIN;
UPDATE accounts SET balance = balance - 50 WHERE id = 1;
UPDATE 1
INSERT INTO accounts VALUES (2, 'Kopya', 0);
ERROR:  duplicate key: PRIMARY KEY value Int(2) already exists in "accounts"
SELECT 1;
ERROR:  current transaction is aborted, commands ignored until end of transaction block
COMMIT;
ROLLBACK
El motor en sí es más simple que eso: hace rollback de la transacción en el momento del error. La capa de sesión de PostgreSQL emula el estado envenenado porque la recuperación de with conn.transaction(): de psycopg depende de ello.
Para mostrar cómo se ven dos conexiones entre sí, y qué hacen los bloqueos de fila, escribí un pequeño script con psycopg 3.3. Es psycopg estándar; nada en él es específico de OxiDB salvo la cadena de conexión:
import psycopg, time

DSN = "host=127.0.0.1 port=15401 user=admin dbname=oxidb"
a = psycopg.connect(DSN)
b = psycopg.connect(DSN, autocommit=True)

a.execute("UPDATE accounts SET balance = balance + 100 WHERE id = 2")
print("A sees:", a.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])
print("B sees:", b.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])
a.commit()
print("B after A commits:", b.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])

a.execute("SELECT * FROM accounts WHERE id = 1 FOR UPDATE")
t = time.time()
try:
    b.execute("UPDATE accounts SET balance = 0 WHERE id = 1")
except psycopg.Error as e:
    print(f"B blocked {time.time()-t:.1f}s, then: {type(e).__name__} [{e.sqlstate}] {e}")
a.rollback()

for sql in ["INSERT INTO accounts VALUES (1, 'x', 0)",
            "INSERT INTO accounts VALUES (3, NULL, 0)",
            "SELECT * FROM nope"]:
    try:
        b.execute(sql)
    except psycopg.Error as e:
        print(f"{type(e).__name__:22} {e.sqlstate}")

cur = b.execute("SELECT owner, balance FROM accounts WHERE balance > %s ORDER BY id", (600,))
print(cur.fetchall(), [d.name + ":" + str(d.type_code) for d in cur.description])
A sees: 650.00
B sees: 550.00
B after A commits: 650.00
B blocked 5.0s, then: LockNotAvailable [55P03] lock timeout: row 1 of 'accounts' is locked by another transaction
UniqueViolation 23505
NotNullViolation 23502
UndefinedTable 42P01
[('Ayşe', Decimal('700.00')), ('Can', Decimal('650.00'))] ['owner:25', 'balance:1700']Cada línea dice algo. A ve su propia escritura; B no la ve hasta el commit. SELECT ... FOR UPDATE toma un bloqueo de fila real, y la escritura de B agota el tiempo de espera de bloqueo de 5 segundos y falla con 55P03, de modo que un interbloqueo se convierte en un error en lugar de colgarse para siempre. Los SQLSTATE se asignan a las clases de excepción adecuadas de psycopg. Los parámetros %s se vinculan en el servidor mediante el protocolo extendido. Y la columna DECIMAL se describe como OID 1700 (numeric) y llega a Python como un Decimal.
Siendo honesto sobre el modelo de concurrencia: esto no es MVCC completo. Los identificadores de fila y los valores de AUTO_INCREMENT que escribe una transacción abierta se reservan en el motor a medida que pone en búfer cada escritura, y la unicidad se vuelve a comprobar contra el estado confirmado en el COMMIT. Si otro escritor tomó una de tus claves mientras tu transacción estaba abierta, el commit se rechaza con un error de clave duplicada y nada de ella se escribe; hay que reintentar la transacción. Un efecto secundario: las sentencias fallidas también consumen valores de AUTO_INCREMENT, igual que las secuencias de PostgreSQL. En la sesión anterior, tres INSERT de clientes fallidos quemaron los identificadores 5, 6 y 7. Por eso Ece obtuvo el 8, y el cliente que añado por OxiWire dentro de un momento obtiene el 9.
Procedimientos almacenados: SQL y Cobra
Hay dos tipos de procedimientos almacenados. El primero es el camino sin herramientas adicionales: texto SQL. Un lote de DML/SELECT con nombre y parámetros, almacenado en el catálogo y ejecutado de forma atómica:
CREATE PROCEDURE transfer(src INT, dst INT, amount DECIMAL) AS BEGIN
  UPDATE accounts SET balance = balance - amount WHERE id = src;
  UPDATE accounts SET balance = balance + amount WHERE id = dst;
  SELECT id, owner, balance FROM accounts WHERE id IN (src, dst) ORDER BY id;
END;
CALL transfer(1, 2, 125.50);
id | owner | balance
----+-------+---------
1 | Ayşe | 574.50
2 | Can | 775.50
(2 rows)Los parámetros se reescriben como marcadores $N en la creación, y SHOW PROCEDURES muestra la forma almacenada: UPDATE accounts SET balance = balance - $3 WHERE id = $1; .... Un CALL de nivel superior se ejecuta en una transacción implícita, así que cualquier sentencia que falle hace rollback de toda la llamada. Pero el cuerpo no tiene control de flujo. Fíjate en esto:
CALL transfer(1, 99, 10);
 id | owner | balance
----+-------+---------
  1 | Ayşe  |  564.50
(1 row)
La cuenta 99 no existe. El segundo UPDATE tocó cero filas sin fallar, y las 10 liras de Ayşe se evaporaron. Un procedimiento de texto SQL no puede preguntar "¿existe la cuenta, alcanza el saldo?". Justamente por eso existe el ADR-0014.
Cobra es un lenguaje de scripting que escribí, con un compilador a bytecode y una VM de pila. En el ADR-0014 elegí el bytecode .cobrac como formato de intercambio para los procedimientos almacenados. El compilador sigue siendo la herramienta cobra en Go; dentro del motor SQL hay una VM de Cobra compacta escrita en Rust (el crate oxidb-cobra) que solo ejecuta. Las alternativas descartadas son instructivas: enlazar el runtime de Go en el proceso Rust con cgo (GC, manejo de señales, doble FFI en cada llamada), un proceso sidecar (un CALL tiene que ejecutarse dentro de la transacción del llamante, y llevar cada sentencia por IPC es lento y frágil), y hacer crecer los procedimientos SQL hasta un dialecto al estilo PL/pgSQL (diseñar un segundo lenguaje cuando ya tenía en casa un lenguaje y un compilador probados).
La versión segura de la misma transferencia:
# CREATE PROCEDURE safe_transfer(src INT, dst INT, amount DECIMAL) LANGUAGE COBRA
def run(db, src, dst, amount)
    let src_rows = db.query("SELECT balance FROM accounts WHERE id = ?", [src])
    let dst_rows = db.query("SELECT balance FROM accounts WHERE id = ?", [dst])
    if len(src_rows) == 0 or len(dst_rows) == 0
        throw "unknown account"
    end
    if src_rows[0]["balance"] < amount
        throw "insufficient funds"
    end
    db.execute("UPDATE accounts SET balance = balance - ? WHERE id = ?", [amount, src])
    db.execute("UPDATE accounts SET balance = balance + ? WHERE id = ?", [amount, dst])
    print("moved", amount, "from", src, "to", dst)
    return db.query("SELECT id, owner, balance FROM accounts ORDER BY id")
end
Lo compilo a bytecode portable y lo envío como base64; 668 bytes de bytecode, 892 caracteres de base64:
cobra build --portable safe_transfer.cobra
B64=$(base64 -i safe_transfer.cobrac | tr -d '\n')
psql ... -c "CREATE PROCEDURE safe_transfer(src INT, dst INT, amount DECIMAL) LANGUAGE COBRA AS '$B64';"
CALL safe_transfer(2, 1, 100);
NOTICE: moved 100.0 from 2 to 1
id | owner | balance
----+-------+---------
1 | Ayşe | 664.5
2 | Can | 675.5
(2 rows)
CALL safe_transfer(1, 99, 10);
ERROR: evaluation error: procedure "safe_transfer": line 6: uncaught throw: "unknown account"
CALL safe_transfer(2, 1, 5000);
ERROR: evaluation error: procedure "safe_transfer": line 9: uncaught throw: "insufficient funds"Algunos detalles. La salida de print vuelve como notices, y psql la muestra como un NOTICE de PostgreSQL. Un throw no capturado hace rollback de todo el CALL, y el error lleva el número de línea de Cobra. db.query y db.execute se ejecutan a través del almacén del llamante, así que el procedimiento se une a la transacción del CALL, y los errores de base de datos pueden capturarse en Cobra con try/catch. El valor de retorno se convierte en un conjunto de resultados: un dict se convierte en una fila, una lista de dicts en una tabla, y un escalar en una única columna value.
La seguridad y el clustering también dieron forma al diseño. La VM solo llega al mundo exterior a través de las funciones que registro: sin acceso al sistema de archivos, a la red ni a procesos. En modo clúster, Raft replica CALL como una sentencia de escritura y la vuelve a ejecutar en cada nodo, así que el bytecode debe ser determinista. Por eso la lista de builtins permitidos excluye el tiempo, la aleatoriedad, la E/S y el paralelismo, y los opcodes y builtins desconocidos se rechazan en el CREATE, no a mitad de una llamada. Un límite de combustible no capturable de 100 millones de instrucciones acota los bucles desbocados.
Una nota honesta: este puente no usa un tipo decimal exacto para los valores de Cobra. SHOW PROCEDURES muestra que el parámetro amount DECIMAL se almacena como amount DOUBLE, y por eso los saldos de arriba vuelven como 664.5 sin el formato de DECIMAL. Conviene saberlo antes de escribir lógica monetaria en un procedimiento de Cobra.
Almacenamiento disk-first, el WAL y el group commit
Ahora, el interior del motor. Esta es la estructura en disco, el estado real de mi directorio de datos tras la prueba de caída del final de esta sección (abreviado):
data/sql/
  MANIFEST                      {"version":1,"generation":11,"wal_seq":131}
  wal/live.wal
  gen.11/
    catalog.json
    customers.rdat   customers.$pk.sidx   customers.$uq2.sidx
    events.rdat      events.$pk.sidx
...- El WAL (
wal/live.wal) es el registro propio del motor SQL. La cabecera empieza con el número mágicoOXSW, y cada registro es[crc32][len][seq][payload]. La recuperación lee registros hasta encontrar una cola rota (una escritura interrumpida por una caída) o un CRC que no coincide; el prefijo válido es todo lo leído hasta ese punto. - Snapshots: en el checkpoint, las filas vivas de cada tabla se escriben en
gen.N/<table>.rdat, con cabeceraOXSRy registros[row_id][len][crc32][payload]. Un snapshot siempre se escribe entero (archivo temporal, fsync, rename), así que siempre es una imagen consistente de un instante. - Los índices (
.sidx) son una tabla de entradas ordenada, de paso fijo y mapeada con mmap. No es un B-tree, a propósito: cada escritor reescribe el archivo entero en el momento del checkpoint, así que no hay páginas que dividir, ni mapa de espacio libre, ni concurrencia a nivel de página en la que equivocarse. Una búsqueda es una búsqueda binaria sobre una tabla de paso fijo, y un recorrido por rango es un límite inferior más un avance secuencial. - MANIFEST es el punto de commit. Confirmar un checkpoint es un único paso atómico: un archivo temporal, un fsync y un rename sobre
MANIFEST. Una caída antes del rename deja vigente el MANIFEST anterior, y con él la generación intacta anterior; la generación a medio construir se ignora al abrir y se recolecta como basura. Como el catálogo y los snapshots cambian juntos, la recuperación nunca ve un catálogo cuyo número de columnas no coincida con sus snapshots.
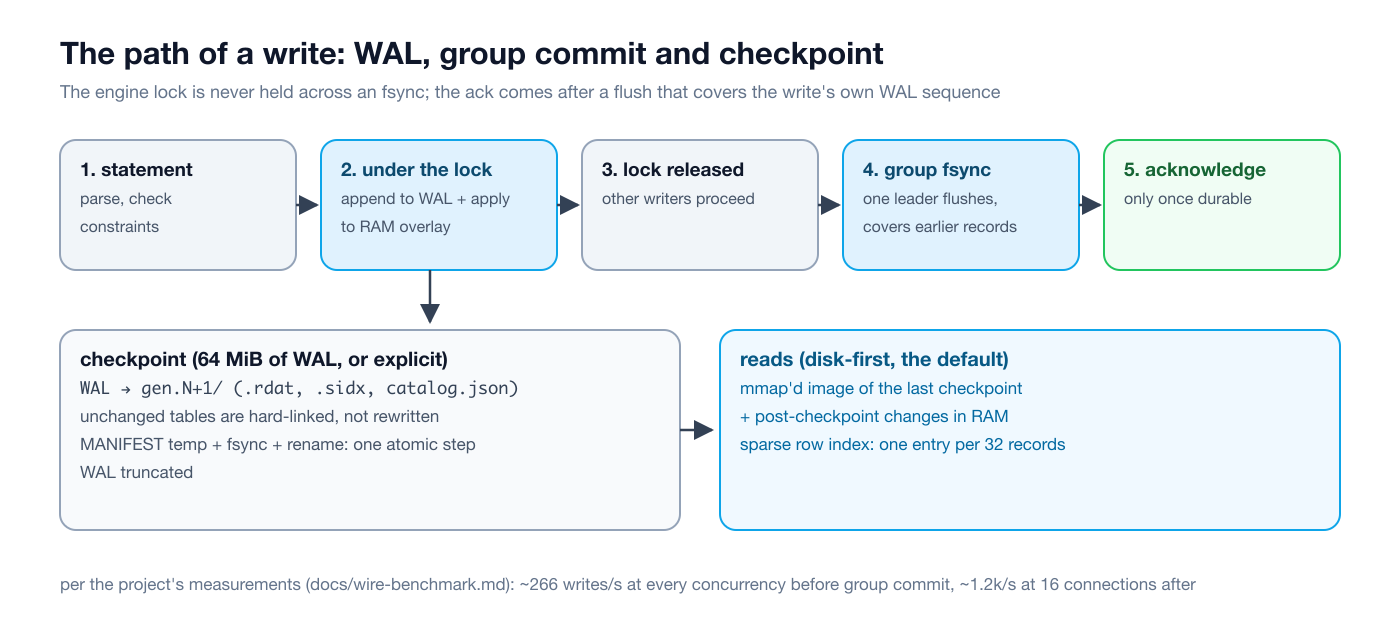
El modo disk-first es el predeterminado desde la 0.41.33. Los datos de las tablas se sirven desde el snapshot mapeado con mmap del último checkpoint, y solo los cambios posteriores al checkpoint se mantienen en RAM. Filas, índices secundarios, claves primarias y columnas UNIQUE son todos archivos mapeados. Según las mediciones del proyecto (docs/pg-memory-benchmark.md), una base de datos caliente de 1,2 millones de filas funciona con unos 39 MB, frente a unos 370 MB para las mismas filas en modo residente, donde todo está en RAM. El precio se paga en los recorridos: disk-first decodifica cada celda, así que los recorridos van a entre 0,72 y 0,78 veces la velocidad de PostgreSQL, frente a cerca de 1,0 en modo residente. Las consultas puntuales e indexadas son iguales en ambos. El formato en disco es idéntico en los dos casos, así que una base de datos se abre en cualquiera de los modos.
Lo que más esfuerzo me costó en el lado de la memoria fue el índice de desplazamientos de filas: la estructura que registra dónde vive cada fila en el archivo .rdat costaba unos 33 bytes por fila, lo que con 100 millones de filas serían 3,1 GB de memoria anónima. Lo hice disperso: una entrada cada 32 registros, más un breve recorrido por las cabeceras de los registros para llegar a una fila concreta. Eso son 0,69 bytes por fila, unos 69 MB con 100 millones de filas. Los lectores secuenciales usan un cursor y nunca hacen ese recorrido, así que los escaneos no se ven afectados. Dos detalles más: los índices secundarios se construyen en el primer uso y no al abrir, y un checkpoint crea enlaces duros a los archivos de las tablas que no han cambiado desde la generación anterior en lugar de volver a escribirlos. Sin eso, cada checkpoint reescribía toda la base de datos por poco que hubiera cambiado.
Group commit: los escritores concurrentes comparten su vaciado del WAL. Una escritura añade su registro y lo aplica bajo el bloqueo del motor, libera el bloqueo y solo entonces hace fsync. Se elige a un escritor para realizar el vaciado, y este cubre a todos aquellos cuyo registro ya estaba en disco cuando empezó. El bloqueo del motor nunca se mantiene durante un fsync. La regla de confirmación no cambió: una sentencia vuelve a su llamante solo después de un vaciado que cubra su propia secuencia del WAL. Lo que ahora es observable es que otra conexión puede leer una escritura en la ventana entre su aplicación y su vaciado. Una caída en ese momento la pierde, pero su escritor nunca recibió confirmación; PostgreSQL tiene la misma ventana. Según las mediciones del proyecto (docs/wire-benchmark.md), el rendimiento pasó de unas ~266 escrituras/s planas en todos los niveles de concurrencia antes del group commit a ~1,2k/s con 16 conexiones después. La ganancia empieza a partir de unos cuatro escritores concurrentes.
ALTER TABLE solo de metadatos
Esto quería medirlo yo mismo. Cargué una tabla events de un millón de filas con psycopg, enviando 100 INSERT de varias filas de 10.000 filas cada uno (4,7 segundos en mi Mac local), y luego añadí y eliminé una columna con \timing activado:
SELECT COUNT(*) FROM events;
  count
---------
 1000000
(1 row)

Time: 13.230 ms
ALTER TABLE events ADD COLUMN region TEXT DEFAULT 'tr';
ALTER TABLE
Time: 3.275 ms
SELECT id, kind, amount, region FROM events WHERE id = 999999;
   id   |  kind  | amount | region
--------+--------+--------+--------
 999999 | refund | 1498.5 | tr
(1 row)

Time: 0.125 ms
ALTER TABLE events DROP COLUMN region;
ALTER TABLE
Time: 4.367 ms
SELECT kind, COUNT(*), SUM(amount) FROM events GROUP BY kind ORDER BY kind;
  kind  | count  |     sum
--------+--------+-------------
 refund | 333333 | 249750499.5
 sale   | 666667 | 499499500.5
(2 rows)

Time: 98.772 ms
Añadir una columna a una tabla de un millón de filas tardó 3,3 ms, y eliminarla 4,4 ms. Eso se debe a que ADD COLUMN y DROP COLUMN solo tocan metadatos, O(1) sea cual sea el tamaño de la tabla. El catálogo almacena el esquema físico, mientras que el ejecutor ve una vista lógica. ADD añade una ranura, y las filas antiguas se leen rellenadas con el valor por defecto de la nueva columna. DROP marca la columna como eliminada en su sitio con un indicador dropped (como el attisdropped de PostgreSQL); la celda física se queda y se descarta en la proyección al leer. La durabilidad descansa en un único registro del WAL. La verdadera reescritura O(n) se pliega en el siguiente checkpoint, que de todos modos reescribe todas las filas, y es ahí donde se recupera el espacio. RENAME COLUMN y ALTER COLUMN ... TYPE todavía tocan las filas; el segundo hace primero una prueba en seco sobre cada fila.
Recuperación tras caídas
Por último, una caída. Inserté una fila, maté el servidor con kill -9 y lo volví a arrancar:
$ psql ... -c "INSERT INTO accounts VALUES (3, 'Kaza Testi', 42.00)"
INSERT 0 1
$ kill -9 $(pgrep oxidb-server)
$ oxidb-server   # restart, WAL replay
$ psql ... -c "SELECT * FROM accounts WHERE id = 3"
 id |   owner    | balance
----+------------+---------
  3 | Kaza Testi |   42.00
(1 row)
La escritura confirmada volvió desde el WAL. Tras el reinicio, con la tabla de un millón de filas y el motor documental activado, el proceso mostraba unos 65 MB de RSS en mi Mac local.
El protocolo nativo: OxiWire
El protocolo de PostgreSQL no es la única vía de entrada. En el puerto nativo OxiWire (JSON con prefijo de longitud, MsgPack o la codificación OxiWire), basta con añadir "engine": "sql" al sobre de la petición. Una petición en bruto usando solo la biblioteca estándar de Python:
import json, socket, struct

def call(sock, req):
    body = json.dumps(req).encode()
    sock.sendall(struct.pack("<I", len(body)) + body)
    n = struct.unpack("<I", sock.recv(4))[0]
    buf = b""
    while len(buf) < n:
        buf += sock.recv(n - len(buf))
    return json.loads(buf)
{"engine": "sql", "cmd": "sql", "sql": "SELECT c.name, COUNT(*) AS orders FROM customers c JOIN orders o ON o.customer_id = c.id WHERE c.city = $1 GROUP BY c.name ORDER BY c.name", "params": ["İstanbul"]}
{"ok": true, "data": [{"columns": ["name", "orders"], "types": ["TEXT", "INT"], "rows": [["Ayşe", 3], ["Can", 1]]}]}
{"engine": "sql", "cmd": "sql", "sql": "INSERT INTO customers (name, email, city) VALUES (?, ?, ?)", "params": ["Deniz", "deniz@example.com", "Bursa"]}
{"ok": true, "data": [{"affected": 1, "last_insert_id": 9}]}Hay un resultado por sentencia. El array types lleva los tipos de columna conocidos estáticamente (para que GetFieldType de ADO.NET no tenga que adivinar), y funcionan tanto los marcadores ? como $N. La separación entre los dos motores se ve en el mismo socket: una petición sin campo engine va al motor documental y crea una colección customers completamente independiente de la tabla SQL:
{"cmd": "insert", "collection": "customers", "doc": {"name": "doc-world"}}
{"ok": true, "data": {"id": 1}}
{"cmd": "count", "collection": "customers"}
{"ok": true, "data": {"count": 1}}
En ese momento la tabla SQL contiene 5 clientes (identificadores 1, 3, 4, 8 y 9) y la colección contiene 1 documento. Mismo nombre, mundos distintos. Los clientes de Python, Go, .NET y JS ocultan este sobre detrás de un método sql(), y con la API HTTP activada el mismo motor es accesible en POST /api/sql.
El protocolo de red de PostgreSQL: ADR-0023
La pregunta que responde el ADR-0023 es: ¿puede OxiDB servir el protocolo v3 de PostgreSQL sin alterar el suyo propio, y cuál es el límite honesto de una primera versión? Tres cosas que ya existían en el código lo abarataron. Los listeners ya eran independientes (nueve en total, entre ellos RESP, MQTT, AMQP y S3). SCRAM-SHA-256 ya existía en el lado del servidor. Y el motor ya tenía las formas que necesita el protocolo: parámetros $N, transacciones interactivas aparcadas entre peticiones, un resultado por sentencia y tipos de columna conocidos estáticamente. Así que oxidb-server/src/pg/ ganó un códec, autenticación, sesión, catálogo, tipos y errores, y no cambió nada en la ruta de OxiWire.
Cuatro decisiones internas merecen describirse:
- Un portal se ejecuta una sola vez, en Describe o en Execute, lo que llegue primero. PostgreSQL puede describir un portal sin ejecutarlo. Este motor informa de la forma de un resultado produciéndolo. Responder a
DescribeconNoData(el honesto "todavía no lo sé") rompía psycopg, que lee sus metadatos de columnas justamente de ahí. Así que un portal se ejecuta al primer contacto y almacena su salida en un búfer, yExecutetransmite ese búfer respetando el límite de filas. La única diferencia visible es que un error aparece un mensaje antes. - Las sentencias de sesión y de catálogo nunca llegan al motor.
SET extra_float_digits = 3, que todo cliente envía antes de empezar siquiera a hablar,version(),current_database()y similares los respondepg/catalog.rs.\dty\lsalen del propio catálogo del motor. - Primero los SQLSTATE, después los mensajes. Los clientes se recuperan según el código, no según el texto, así que cada variante de
SqlErrorse asigna al código que usaría PostgreSQL. - pg_catalog se responde, no se ejecuta. Las formas de consulta reconocidas (el catálogo de tipos, las llamadas
DatabaseMetaDatade JDBC,\dt,\ly las lecturas de filas completas de las tablas del catálogo) se sirven desde el propio esquema de OxiDB. Todo lo demás se rechaza con0A000. Devolver un resultado vacío sería tentador y erróneo, porque un resultado vacío se cree. No era teórico: responder a la sonda\d <table>de psql con la lista de tablas hacía que psql fallara en una columna que esperaba, y así se escribió la regla del rechazo.
            List of tables
 Schema |    Name     | Type  | Owner
--------+-------------+-------+-------
 public | accounts    | table | admin
 public | customers   | table | admin
 public | employees   | table | admin
 public | events      | table | admin
 public | order_items | table | admin
 public | orders      | table | admin
 public | products    | table | admin
(7 rows)
La documentación enumera los clientes verificados contra los drivers reales: psql 18, psycopg 3.3, Npgsql 8.0, pgjdbc 42.7 (incluidas llamadas DatabaseMetaData como getTables, getColumns, getPrimaryKeys y getImportedKeys) y DBeaver 25.3 con su driver nativo de PostgreSQL. Mi lección favorita del ADR: cada predicción que hice sobre qué drivers funcionarían resultó errónea hasta que los drivers se ejecutaron de verdad. El fallo observado de Npgsql (unsupported sql: function version()) apuntaba a una sentencia que ya se manejaba; la causa real era un lote de varias sentencias que mezclaba sentencias interceptadas y sentencias del motor. Un proxy de registro que volcaba los bytes exactos lo encontró en minutos. Razonar sobre ello no lo había conseguido.
Lo que falta deliberadamente: COPY, LISTEN/NOTIFY, cursores con nombre del lado del servidor (DECLARE ... CURSOR), cancelación de consultas, esquemas reales (public.users y users son la misma tabla), information_schema y pg_dump. Además, CREATE DATABASE se ejecuta en el puerto nativo, no en este.
EF Core: servidor y embebido
En el lado de .NET, el ADR-0013 construyó una historia completa de EF Core en cinco fases: primero la superficie de expresiones (CASE, LIKE, EXISTS, CAST, funciones de cadenas), luego las transacciones interactivas, después un proveedor ADO.NET (OxiDb.Data, con Dapper funcionando de extremo a extremo), luego DDL y tipos para las migraciones, y finalmente OxiDb.EntityFrameworkCore. El proveedor admite migraciones (Database.Migrate() con una tabla __EFMigrationsHistory real), ingeniería inversa con dotnet ef dbcontext scaffold, y ExecuteUpdate/ExecuteDelete. Según el README, supera la suite oficial de especificación relacional de EF Core, 3832 de 3832 en las doce suites de Northwind; los pocos límites conocidos son sobrescrituras explícitas en las clases de prueba.
Lo probé yo mismo: una pequeña aplicación de consola .NET 10 compilada contra los paquetes NuGet 0.44.2 del repositorio:
using Microsoft.EntityFrameworkCore;
using OxiDb.EntityFrameworkCore;

var cs = args.Length > 0 ? $"Path={args[0]}" : "Host=127.0.0.1;Port=15400;Database=efshop";

using (var db = new Shop(cs))
{
    db.Database.EnsureCreated();
    var ada = new Author { Name = "Ada" };
    var linus = new Author { Name = "Linus" };
    db.Authors.AddRange(ada, linus);
    db.Posts.AddRange(
        new Post { Title = "SQL engine", Words = 4200, Author = ada },
        new Post { Title = "Time series", Words = 3100, Author = ada },
        new Post { Title = "Ledger", Words = 2800, Author = linus });
    db.SaveChanges();
    Console.WriteLine($"generated keys: ada={ada.Id}, linus={linus.Id}");
}

using (var db = new Shop(cs))
{
    var q = db.Authors
        .Select(a => new { a.Name, Posts = a.Posts.Count, Words = a.Posts.Sum(p => p.Words) })
        .Where(x => x.Words > 1000)
        .OrderByDescending(x => x.Words);
    Console.WriteLine(q.ToQueryString());
    foreach (var row in q) Console.WriteLine($"{row.Name,-6} posts={row.Posts} words={row.Words}");

    var n = db.Posts.Where(p => p.Words < 3000)
        .ExecuteUpdate(s => s.SetProperty(p => p.Words, p => p.Words + 500));
    Console.WriteLine($"ExecuteUpdate touched {n} row(s)");
}

public class Author { public int Id { get; set; } public string Name { get; set; } = ""; public List<Post> Posts { get; set; } = new(); }
public class Post { public int Id { get; set; } public string Title { get; set; } = ""; public int Words { get; set; } public int AuthorId { get; set; } public Author? Author { get; set; } }
public class Shop(string cs) : DbContext
{
    public DbSet<Author> Authors => Set<Author>();
    public DbSet<Post> Posts => Set<Post>();
    protected override void OnConfiguring(DbContextOptionsBuilder o) => o.UseOxiDb(cs);
}
En modo servidor (tras crear la base de datos con CREATE DATABASE efshop en el puerto nativo):
connection: Host=127.0.0.1;Port=15400;Database=efshop
generated keys: ada=1, linus=2
SELECT "a"."Name", (
    SELECT COUNT(*)
    FROM "Posts" AS "p1"
    WHERE "a"."Id" = "p1"."AuthorId") AS "Posts", (
    SELECT COALESCE(SUM("p2"."Words"), 0)
    FROM "Posts" AS "p2"
    WHERE "a"."Id" = "p2"."AuthorId") AS "Words"
FROM "Authors" AS "a"
WHERE (
    SELECT COALESCE(SUM("p"."Words"), 0)
    FROM "Posts" AS "p"
    WHERE "a"."Id" = "p"."AuthorId") > 1000
ORDER BY (
    SELECT COALESCE(SUM("p0"."Words"), 0)
    FROM "Posts" AS "p0"
    WHERE "a"."Id" = "p0"."AuthorId") DESC
Ada    posts=2 words=7300
Linus  posts=1 words=2800
ExecuteUpdate touched 1 row(s)
Las subconsultas escalares correlacionadas que genera EF se ejecutan tal cual, y las claves generadas vuelven mediante RETURNING. Las tablas que creó EF son tablas SQL normales, así que puedo ver los mismos datos desde psql:
    Title    | Words
-------------+-------
 SQL engine  |  4200
 Time series |  3100
 Ledger      |  3300
(3 rows)
En modo embebido lo único que cambia es la cadena de conexión, UseOxiDb("Path=./embedded-data"), y toda la pila de EF Core se ejecuta dentro del proceso sin servidor, al estilo de SQLite:
connection: Path=./embedded-data
generated keys: ada=1, linus=2
Ada    posts=2 words=7300
Linus  posts=1 words=2800
ExecuteUpdate touched 0 row(s)
Tengo que señalar esa última línea: mientras trabajaba en este artículo noté que en modo embebido ExecuteUpdate informa de 0 filas afectadas. La actualización en sí se aplica (cuando abrí el mismo directorio de datos una segunda vez, el artículo de Linus tenía 3300 palabras), así que se trata de un error en cómo la ruta embebida informa del número de filas afectadas. El modo servidor lo informa correctamente. Lo corregiré en la próxima versión. Como tercera vía, EF Core también funciona a través del proveedor Npgsql sin modificar sobre el puerto de PostgreSQL (tests/efcore-npgsql-test en el repositorio).
Rendimiento: las mediciones del proyecto
Los números de abajo no los medí yo; provienen de los propios documentos de benchmark del proyecto. docs/query-benchmark.md compara OxiDB y PostgreSQL sobre el mismo conjunto de datos (1,2 millones de filas en cinco tablas relacionadas con claves foráneas, claves primarias compuestas y ocho índices). Como ambos hablan el protocolo de PostgreSQL, un único cliente escrito a mano maneja los dos servidores y decodifica cada celda, así que no hay diferencia de driver ni de lenguaje. PostgreSQL se ejecuta con la configuración estándar tras ANALYZE, y se comprobó que las respuestas fueran idénticas antes de medir nada.
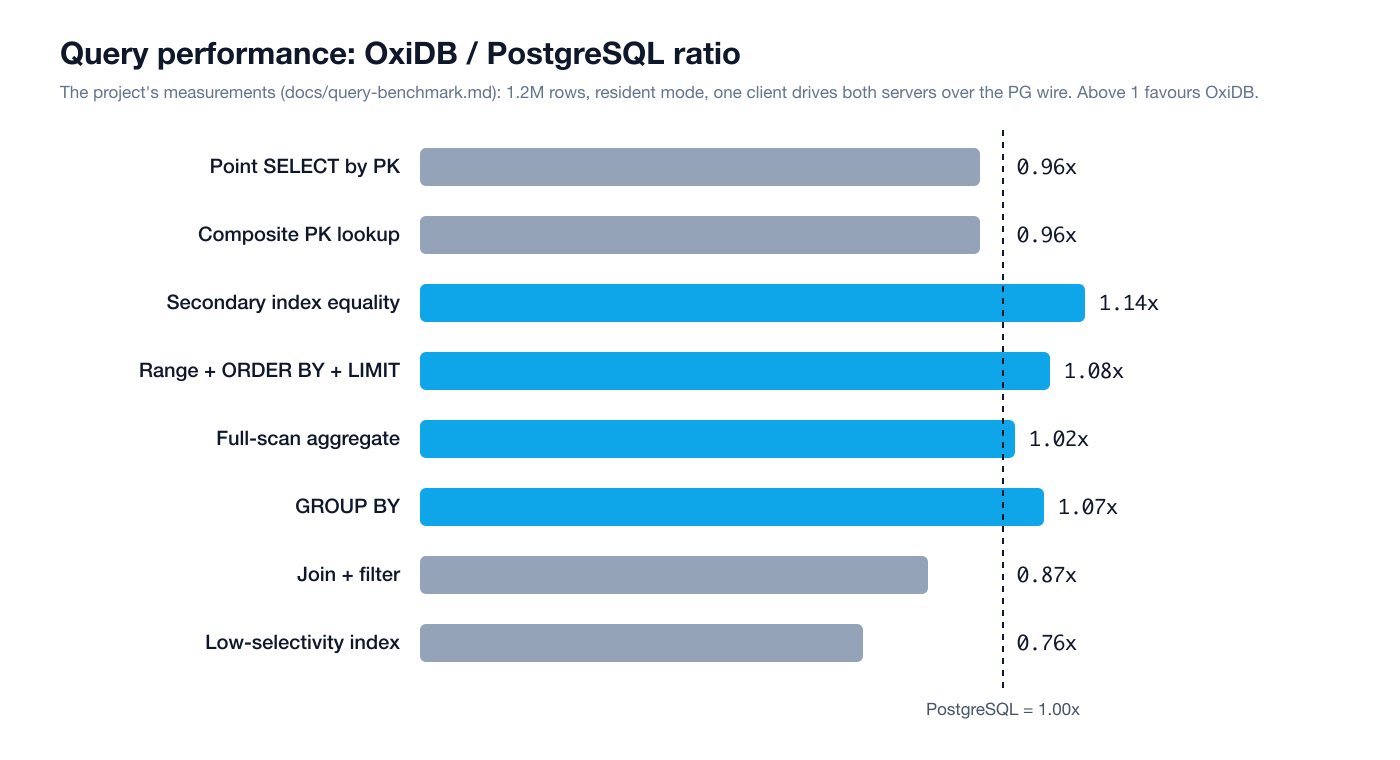
Esta tabla se midió en modo residente. En modo disk-first, las consultas puntuales e indexadas se mantienen igual, mientras que los recorridos bajan a 0,72-0,78x, como se describió arriba. Para mí, la parte más valiosa de ese documento es la sección "qué sigue perdiendo, y por qué". Los joins pasaron de 0,56x a 0,87x, pero por el camino hubo dos fracasos medidos: subir el umbral del index-nested-loop lo empeoró (0,29x), y la prueba de pertenencia obvia con BTreeSet fue aún peor (0,22x). Lo que finalmente funcionó fue un bitmap de direccionamiento directo sobre el rango de claves enteras, lo bastante barato como para superar el coste de construir una fila. El primer intento de agregado en streaming también se saltaba el índice, convirtiendo count(*) WHERE customer_id = ? de una búsqueda de 25 µs en un recorrido completo de 4 ms. El benchmark lo detectó de inmediato.
docs/sql-statement-benchmark.md mide el motor con la granularidad con la que lo usan la mayoría de los clientes, una sentencia por petición, y describe los seis cuellos de botella que encontró: el coste de una transacción creciendo con su tamaño, búsquedas dentro de una transacción que devolvían toda la capa superpuesta, la tabla conductora de un join ignorando su índice, y así sucesivamente.
Límites y compromisos honestos
Reunidos en un solo lugar:
- No hay transacciones que abarquen ambos motores. Las escrituras documentales y SQL son atómicas cada una por su cuenta (el ADR-0011 está aplazado).
- Algunas restricciones no se aplican: la unicidad de
CREATE UNIQUE INDEX, elUNIQUEde varias columnas a nivel de tabla, las FK de varias columnas y las accionesON UPDATE.CHECKse rechaza, y no existeALTER TABLE ... ADD/DROP CONSTRAINT. - Carencias en las consultas: no hay marcos de ventana explícitos, ni
GROUPING SETS/ROLLUP/CUBE, niMERGE, niTRUNCATE.INSERT ... ON CONFLICTse analiza, pero su cláusula de conflicto se ignora. Probando cosas para este artículo también descubrí queINSERT ... SELECTno está soportado (unsupported sql: INSERT ... SELECT), y por eso cargué el millón de filas con INSERT de varias filas. - Las FK autorreferenciadas no aceptan padre e hijo en el mismo INSERT de varias filas.
- Modelo de transacciones: no es MVCC completo. La unicidad se vuelve a comprobar en el commit y un commit en conflicto se rechaza. En un clúster esa nueva comprobación se omite, porque un commit replicado ya ha sido acordado por el clúster. El DDL de
ALTER TABLE, de vistas y de procedimientos no puede ejecutarse dentro de una transacción. - Protocolo de PostgreSQL: no hay consultas arbitrarias a
pg_catalog, ni\d <table>, niCOPY, niLISTEN/NOTIFY, ni cursores con nombre, nipg_dump. El listener no se inicia en modo clúster. - Los procedimientos de Cobra ven
DECIMALcomoDOUBLE. - Disk-first es aproximadamente un 30% más lento que el modo residente en los recorridos. Para analítica con muchos recorridos sobre datos que caben holgadamente en RAM,
OXIDB_SQL_DISK_FIRST=0es la elección correcta.
En modo clúster, las escrituras SQL se replican mediante Raft: el texto SQL y los parámetros se añaden al log de Raft y se vuelven a ejecutar en cada nodo. Un COMMIT aislado de una transacción interactiva replica sus escrituras en búfer como una única entrada atómica.
Cómo encaja con el resto de OxiDB
En OxiDB, el motor SQL no es una elección excluyente. Mientras los documentos, las series temporales, el almacén clave-valor OxiMem, S3 y las superficies de mensajería se ejecutan en el mismo servidor, los datos que deben ser relacionales viven en sus propios archivos bajo sus propias reglas. La misma autenticación (SCRAM, roles, permisos por base de datos) y el mismo modelo multibase de datos (ADR-0012) se aplican a ambos motores: cada base de datos tiene su propio motor SQL, y ambos puertos ven los mismos datos. Y si SQL es todo lo que se necesita, OXIDB_DOC=0 apaga por completo el motor documental y deja un pequeño servidor compatible con PostgreSQL.
Pruébalo
OxiDB se puede descargar como binario listo para usar desde las releases de GitHub, ejecutar con la imagen de Docker o compilar desde el workspace de Rust. El camino más corto:
OXIDB_SQL=1 OXIDB_PG_PORT=5432 oxidb-server
psql -h 127.0.0.1 -p 5432 -U admin -d oxidb
Después, apunta a él cualquier cliente de PostgreSQL que tengas. Si algo no funciona, la línea [pg] refused catalog query: ... del log del servidor es exactamente lo que hay que enviarme. El siguiente artículo de la serie pasa a el motor de series temporales.