OxiDB の SQL エンジン:独自ファイルで動く本物のリレーショナルエンジン、PostgreSQL ワイヤと EF Core
OxiDB のドキュメントエンジンの隣に、独自の WAL とファイルを持つ SQL エンジンを追加しました。強制される制約、CTE、ウィンドウ関数、Cobra バイトコードのストアドプロシージャ、無改造の psql/psycopg と EF Core に対応します。
OxiDB はドキュメントデータベースとして生まれ、私はしばらくその点に頑固にこだわっていました。最初に試した SQL レイヤー、つまりドキュメントエンジンの上に乗る薄い方言は、丸ごと取り除いてしまったほどです。しかし実際のプロジェクトでは、同じ質問が何度も繰り返されました。「請求書、注文、在庫のためにリレーショナルなテーブルが欲しい。本当に別途 PostgreSQL を動かさないといけないの?」この記事は、その質問に対する私の答え、つまり OxiDB に追加した SQL エンジンについてのものです。これは方言ではありません。独自のカタログ、独自の WAL、独自のファイルを持つ 2 つ目のエンジンです。ドキュメントエンジンと同じプロセス内で隣り合って動作し、PostgreSQL のワイヤプロトコルを話すので psql や psycopg のようなクライアントが無改造で接続できます。さらに .NET 側には完全な EF Core プロバイダーがあります。この記事に載せている出力はすべて、ローカルの Apple M シリーズ Mac 上の OxiDB 0.44.2 サーバーに対して私自身が実行したセッションから取ったものです。
これは OxiDB シリーズの 4 本目の記事です。ドキュメント側についてはドキュメントエンジンの記事で、時系列エンジンについては時系列の記事で解説しています。
なぜ別のエンジンなのか:ADR-0010
この決定の核心は、ADR-0010 の一文に収まります。2 つのエンジン、1 つのインスタンス、そして別々のファイル。SQL エンジンはドキュメントエンジンのファイルに一切触れず、ドキュメントエンジンも SQL のディレクトリには決して入りません。両者が共有するのはプロセス、ポート、認証、ライフサイクルだけです。共有ファイルも、共有ロックマップも、共有ストレージフォーマットもありません。
これは意図的なものです。以前の試みでは、SQL クエリをドキュメントコレクションの上で実行していました。紙の上では安上がりでしたが、リレーショナルなセマンティクス(固定スキーマ、型付きカラム、主キー、外部キー)をリレーショナルではないストアに持ち込むことになり、両方の世界の悪いところだけを得る結果になりました。ADR-0010 では 3 つの選択肢を比較し、2 つ目を選びました。ストレージ、WAL、リカバリ、カタログ、プランナー、エグゼキューターを自前で持つ独立した oxidb-sql crate です。現在、この crate はおよそ 3 万行の Rust コードになっています。
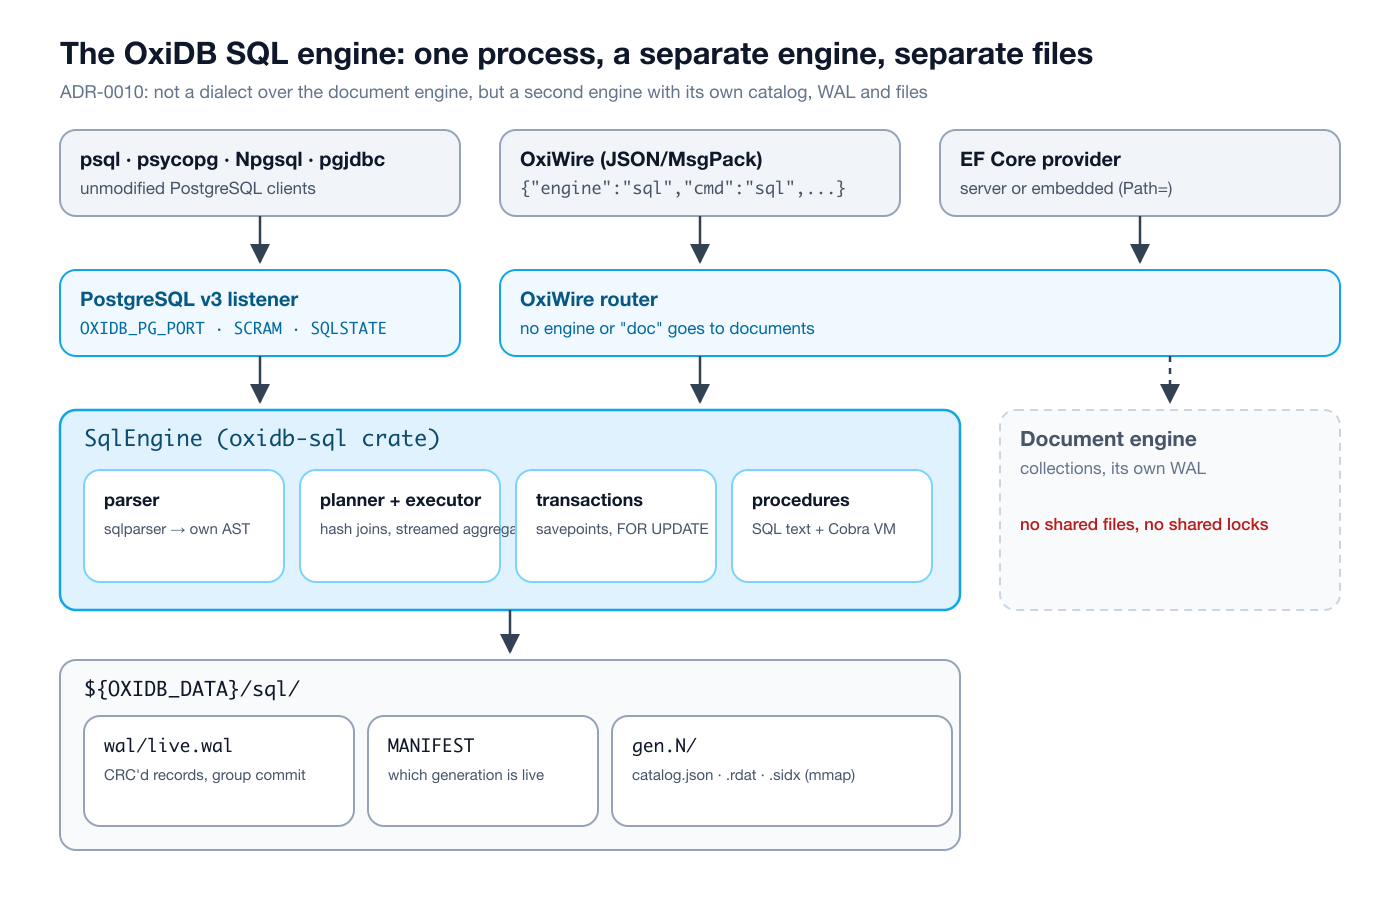
実際には、この分離から 3 つの帰結が生まれます。
- 名前空間が衝突しない。
customersという SQL テーブルとcustomersというドキュメントコレクションは同時に存在できます。ディレクトリを共有することがないからです。これは後ほど実際に動かして見せます。 - デフォルトでオフ。
OXIDB_SQLがなければエンジンは生成されず、コストはゼロです。 - ワイヤ互換性は手つかずのまま。 ネイティブの OxiWire プロトコルでは、リクエスト内の任意の
engineフィールドでルーティングします。このフィールドを持たないリクエストは、以前とまったく同じコードパスでドキュメントエンジンに届きます。
代償も同じくらい明確です。両方のエンジンにまたがるアトミックなトランザクションはありません。ドキュメントへの書き込みと SQL への書き込みは、それぞれ単独では永続的ですが、1 つのアトミックな単位にはなりません。そのための設計は、共有のグローバルシーケンス番号をベースに ADR-0011 にまとめましたが、あえて先送りにしました。実際のワークロードはどれも 1 つのエンジンを選んでそこに留まっていた一方で、その代償はクラッシュリカバリのパスに恒久的な複雑さを持ち込むことでした。そこは複雑さを最も許容できない場所です。
動かしてみる
SQL エンジンと PostgreSQL リスナーは、2 つの環境変数で有効にします。
OXIDB_ADDR=127.0.0.1:15400 \
OXIDB_DATA=./data \
OXIDB_SQL=1 \
OXIDB_PG_PORT=15401 \
oxidb-server
この記事では自分用のポートを使いました。本番環境では OXIDB_PG_PORT=5432 にすれば、既存の接続文字列がそのまま使えます。SQL だけ(必要なら時系列も)を提供するサーバーであれば、OXIDB_DOC=0 も設定できます。ドキュメントによると、そのようなサーバーはアイドル時に 9.8 MB の RSS と 8 スレッドで動作し、ドキュメントエンジンを有効にした場合の 14.2 MB と 23 スレッドを下回ります。
その他の重要な設定は次のとおりです。
| 変数 | デフォルト | 意味 |
|---|---|---|
OXIDB_SQL_DATA | ${OXIDB_DATA}/sql | SQL エンジンのデータディレクトリ |
OXIDB_SQL_SYNC | full | full:コミットごとに本物のストレージフラッシュ。data:OS レベルの sync で、数倍高速 |
OXIDB_SQL_DISK_FIRST | オン | テーブルデータを mmap したスナップショットから提供し、チェックポイント後の変更だけを RAM に置く |
OXIDB_SQL_CHECKPOINT_BYTES | 64 MiB | ライブ WAL がこのサイズを超えたら自動チェックポイント |
OXIDB_SQL_LOCK_TIMEOUT_MS | 5000 | 行ロックの待ち時間。デッドロックをエラーに変える |
サーバーが起動したら、Homebrew で入れた素の psql 18 で接続します。拡張機能も特別なドライバーも不要です。
psql -h 127.0.0.1 -p 15401 -U admin -d oxidb -c "SELECT version();" version
---------------------
16.0 (OxiDB 0.44.2)
(1 row)データモデルと DDL
例として、顧客、商品、注文、注文明細からなる小さなショップを作りました。DDL は PostgreSQL や MySQL でおなじみの形のはずです。
CREATE TABLE customers (
  id      INT PRIMARY KEY AUTO_INCREMENT,
  name    VARCHAR(40) NOT NULL,
  email   TEXT UNIQUE,
  city    TEXT
);
CREATE TABLE products (
  id     INT PRIMARY KEY,
  name   TEXT NOT NULL,
  price  DECIMAL(10,2) NOT NULL,
  stock  SMALLINT DEFAULT 0
);
CREATE TABLE orders (
  id          INT PRIMARY KEY AUTO_INCREMENT,
  customer_id INT NOT NULL REFERENCES customers(id) ON DELETE CASCADE,
  created_at  TIMESTAMP NOT NULL
);
CREATE TABLE order_items (
  order_id   INT NOT NULL REFERENCES orders(id) ON DELETE CASCADE,
  product_id INT NOT NULL REFERENCES products(id),
  qty        INT NOT NULL,
  CONSTRAINT pk_items PRIMARY KEY (order_id, product_id)
);AUTO_INCREMENT(AUTOINCREMENT や PostgreSQL の GENERATED ... AS IDENTITY とも書けます)で生成されたキーは RETURNING で読み戻せます。これはまさに EF Core や ADO.NET が生成キーを読み取る方法です。
INSERT INTO customers (name, email, city) VALUES
  ('Ayşe', 'ayse@example.com', 'İstanbul'),
  ('Mehmet', 'mehmet@example.com', 'Ankara'),
  ('Zeynep', 'zeynep@example.com', 'İzmir'),
  ('Can', 'can@example.com', 'İstanbul')
RETURNING id, name;
id | name
----+--------
1 | Ayşe
2 | Mehmet
3 | Zeynep
4 | Can
(4 rows)
INSERT 0 4複数行の INSERT は 1 つの WAL バッチとして適用されます。まずすべての行を検証し、そのあと全行が 1 回の fsync で書き込まれます。同じ方法で商品、6 件の注文、11 件の注文明細を追加しました。イントロスペクション用には SHOW TABLES、DESCRIBE、SHOW INDEXES、SHOW VIEWS、SHOW PROCEDURES があります。
DESCRIBE order_items;
   column   | type | nullable | primary_key | auto_increment
------------+------+----------+-------------+----------------
 order_id   | INT  | f        | t           | f
 product_id | INT  | f        | t           | f
 qty        | INT  | f        | f           | f
(3 rows)
複合主キーの両カラムに primary_key のフラグが立っており、どちらも暗黙的に NOT NULL です。
型システムは意図的に小さくしてあります。BIGINT、INT、SMALLINT、TINYINT、DOUBLE、TEXT(VARCHAR(n) を含む)、BOOL、TIMESTAMP、DECIMAL、BLOB です。TIMESTAMP はエポックミリ秒として保存され、UTC として扱われます。整数については 1 段落を割くに値する細かい点が 1 つあり、それは制約のセクションで触れます。
実際に強制される制約
データベースが受け入れたうえで黙って無視する制約は、拒否される制約よりも悪いものです。ですからルールは単純です。強制されるか、そうでなければ強制されないことをドキュメントにはっきり書くか、のどちらかです。以下のセッションはすべて本物で、psql が出力したそのままです。
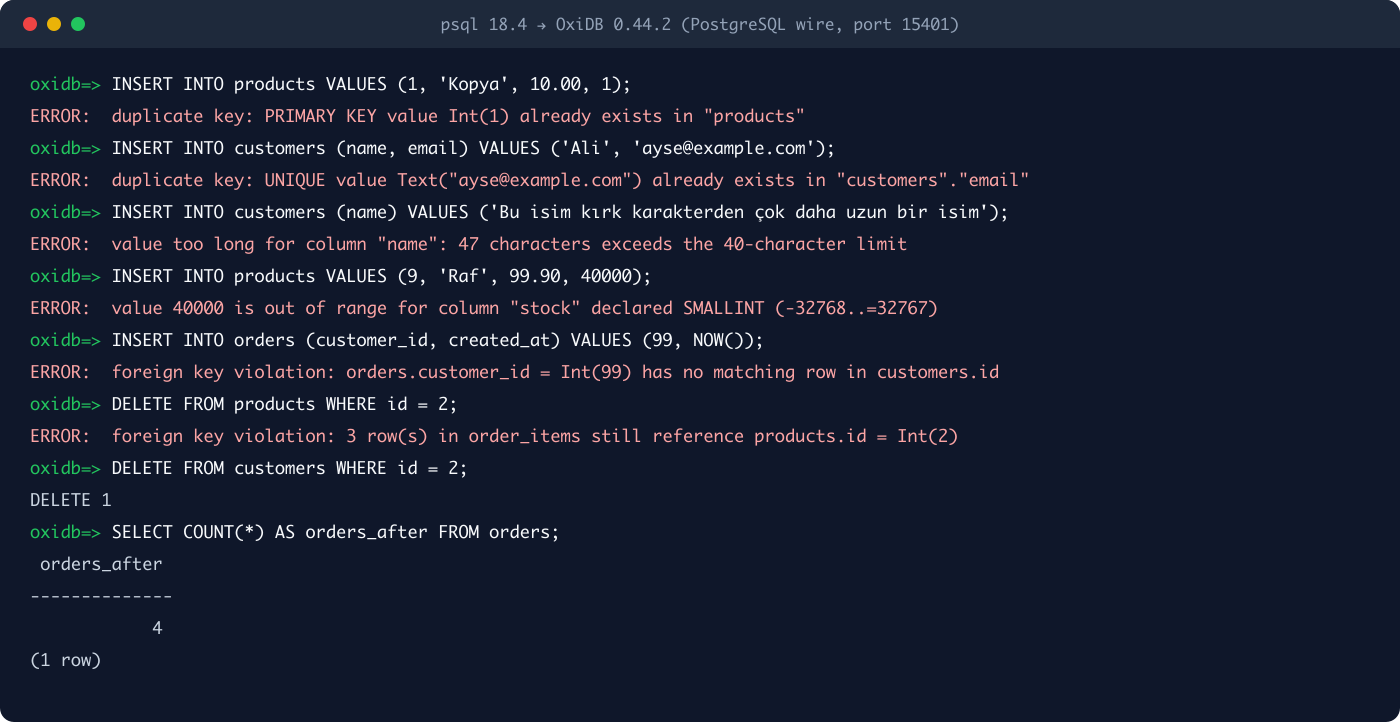
順番に見ていきます。
- PRIMARY KEY:重複キーは拒否されます。通常の INSERT でも、複数行 INSERT でも(どの行を適用するよりも前に、バッチ全体にわたってチェックされます)、UPDATE でも、トランザクション内でも同様です。複合キーはすべてのカラムが一致した場合にのみ衝突します。
order_itemsに対しては(1, 1)が拒否されました。 - UNIQUE:単一カラムの
UNIQUEは強制され、SQL 標準のとおり NULL は対象外です。 - NOT NULL:NULL の
nameはschema mismatch: column "name" is NOT NULL but got NULLで拒否されます。 - VARCHAR(n):長さはバイトではなく文字数で数えます。47 文字のトルコ語の名前は 40 文字の上限を超えます。
- 整数の幅:これは微妙な点です。エンジンはすべての整数を 64 ビットで保存するので、
SMALLINTにしても容量は節約できません。しかし宣言された範囲外の値は黙って拡張されるのではなく拒否されるので、カラムに宣言された型はその中身について常に正しいままです。ALTER TABLE ... ALTER COLUMN ... TYPE SMALLINTはまず保存済みのすべての行でドライランを行うので、型の縮小は完全に成功するか、カラムにまったく手を付けないかのどちらかになります。 - FOREIGN KEY:子テーブルの INSERT/UPDATE は親を見つけられなければならず、親の DELETE は
ON DELETE NO ACTION、RESTRICT、CASCADE、SET NULLに従います。商品の削除は、まだ 3 件の注文明細がそれを参照していたため拒否されました。顧客の削除は 2 段階の深さまでカスケードしました。Mehmet の 2 件の注文と、その 5 件の明細が彼と一緒に消えたのです。削除前は注文 6 件、明細 11 件でしたが、削除後は 4 件と 6 件になりました。
PostgreSQL のワイヤレイヤーはこれらのエラーを適切な SQLSTATE コード(23505、23503、23502、22001、22003)にマッピングするので、ドライバーは正しい例外クラスを送出します。これは後ほど psycopg で示します。
強制されないものについても、同じくらいはっきり言っておく必要があります。CREATE UNIQUE INDEX は通常のインデックスを作成し、その UNIQUE は強制されません。複数カラムにまたがるテーブルレベルの UNIQUE は受け入れられますが、強制されません。複数カラムの FK や ON UPDATE アクションも強制されません。CHECK 制約はパース時に拒否されます。この記事を書いている途中で、もう 1 つ違いを見つけました。自己参照テーブル(従業員とその上司)では、親と子を同じ複数行 INSERT で挿入することができません。FK チェックがバッチ自体ではなく、コミット済みの状態を見るためです。PostgreSQL はステートメントの終わりにチェックするので、これを受け入れます。回避策は簡単で、親を先に、独立したステートメントで挿入することです。
クエリ:JOIN、GROUP BY、CTE、ウィンドウ関数
顧客、注文、明細をいくつか追加し(まだ注文のないブルサの Ece も含めて)、クエリに移りました。GROUP BY と HAVING を使った 5 テーブル JOIN です。
SELECT c.name, COUNT(DISTINCT o.id) AS orders, SUM(oi.qty * p.price) AS revenue
FROM customers c
JOIN orders o       ON o.customer_id = c.id
JOIN order_items oi ON oi.order_id = o.id
JOIN products p     ON p.id = oi.product_id
GROUP BY c.name
HAVING SUM(oi.qty * p.price) > 5000
ORDER BY revenue DESC;
name | orders | revenue
--------+--------+----------
Zeynep | 2 | 20752.00
Ayşe | 3 | 15401.00
Can | 1 | 6300.00
(3 rows)小数点以下 2 桁は偶然ではありません。DECIMAL は今では正確な型になっており、PostgreSQL のワイヤ上ではテキスト形式の numeric として送られます。INNER、LEFT、RIGHT、FULL、CROSS の JOIN は任意の深さまで連結できます。等価結合はハッシュ結合として、あるいは密な整数キーに対しては直接アドレス方式の配列結合として実行されます。等価でない ON 条件はネステッドループにフォールバックします。注文のない顧客を探すのは、古典的なアンチ結合です。
SELECT c.name, c.city
FROM customers c LEFT JOIN orders o ON o.customer_id = c.id
WHERE o.id IS NULL;
name | city
------+-------
Ece | Bursa
(1 row)WITH による CTE とウィンドウ関数を組み合わせます。1 つのクエリで、各顧客の注文を合計額で順位付けし、顧客ごとの累計と全体の順位を求めます。
WITH order_totals AS (
  SELECT o.id, o.customer_id, o.created_at, SUM(oi.qty * p.price) AS total
  FROM orders o
  JOIN order_items oi ON oi.order_id = o.id
  JOIN products p ON p.id = oi.product_id
  GROUP BY o.id, o.customer_id, o.created_at
)
SELECT customer_id, id AS order_id, total,
       ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY total DESC) AS rn,
       SUM(total)   OVER (PARTITION BY customer_id ORDER BY created_at) AS running,
       RANK()       OVER (ORDER BY total DESC) AS overall_rank
FROM order_totals
ORDER BY customer_id, created_at;
customer_id | order_id | total | rn | running | overall_rank
-------------+----------+----------+----+----------+--------------
1 | 1 | 2151.00 | 3 | 2151.00 | 6
1 | 2 | 7800.00 | 1 | 9951.00 | 2
1 | 11 | 5450.00 | 2 | 15401.00 | 4
3 | 4 | 16850.00 | 1 | 16850.00 | 1
3 | 10 | 3902.00 | 2 | 20752.00 | 5
4 | 5 | 6300.00 | 1 | 6300.00 | 3
(6 rows)ROW_NUMBER、RANK、DENSE_RANK、そして COUNT/SUM/AVG/MIN/MAX がウィンドウ上で動作します。ウィンドウに ORDER BY がない場合、集約はパーティション全体を対象にします。ORDER BY がある場合は累積になり、ピア行(ソートキーが等しい行)は同じ値を共有します。これが標準のデフォルトフレームです。明示的なフレーム(ROWS BETWEEN ...)はまだありません。
再帰しない CTE は、パース時に派生テーブルへと展開(desugar)されます。自己参照する CTE は anchor UNION [ALL] step という形でなければならず、エグゼキューター内で不動点反復によって実体化されます。各ステップは、CTE を前回の反復の行に束縛した状態で再実行されます。UNION はそれまでに見たすべての行に対して重複を除去するので、循環は自然に終了します。さらに暴走クエリに備えて、100 万回の反復と 1,000 万行のガードがあります。組織図の例です。
WITH RECURSIVE chain(id, depth, path) AS (
  SELECT id, 0, name FROM employees WHERE manager_id IS NULL
  UNION ALL
  SELECT e.id, c.depth + 1, c.path || ' > ' || e.name
  FROM employees e JOIN chain c ON e.manager_id = c.id
)
SELECT id, depth, path FROM chain ORDER BY path;
id | depth | path
----+-------+-----------------------------
1 | 0 | Barış
2 | 1 | Barış > Elif
4 | 2 | Barış > Elif > Deniz
6 | 3 | Barış > Elif > Deniz > Mert
5 | 2 | Barış > Elif > Selin
3 | 1 | Barış > Kerem
(6 rows)同じ仕組みで日付の系列も生成でき、再帰の中で INTERVAL の演算が機能します。
WITH RECURSIVE days(d) AS (
  SELECT TIMESTAMP '2026-10-01'
  UNION ALL
  SELECT d + INTERVAL '1 day' FROM days WHERE d < TIMESTAMP '2026-10-04'
)
SELECT d FROM days;
d
---------------------
2026-10-01 00:00:00
2026-10-02 00:00:00
2026-10-03 00:00:00
2026-10-04 00:00:00
(4 rows)LATERAL、DISTINCT ON、順序集合集約
分析で私が最もよく使う PostgreSQL のイディオム 3 つも揃っています。「各顧客の最新の注文」には 2 通りの答えがあります。1 つは DISTINCT ON で、ORDER BY に従ってキーごとに最初の行を取ります。
SELECT DISTINCT ON (customer_id) customer_id, id, created_at
FROM orders
ORDER BY customer_id, created_at DESC;
customer_id | id | created_at
-------------+----+---------------------
1 | 11 | 2026-10-09 08:00:00
3 | 10 | 2026-10-08 11:20:00
4 | 5 | 2026-10-02 12:00:00
(3 rows)もう 1 つは LATERAL です。左側の行を参照でき、左側の行ごとに再実行される派生テーブルです。LEFT JOIN LATERAL を使えば、注文がなくても Ece は結果に残ります。
SELECT c.name, last_o.id AS last_order, last_o.created_at
FROM customers c
LEFT JOIN LATERAL (
  SELECT id, created_at FROM orders o
  WHERE o.customer_id = c.id
  ORDER BY created_at DESC LIMIT 1
) last_o ON TRUE
ORDER BY c.name;
name | last_order | created_at
--------+------------+---------------------
Ayşe | 11 | 2026-10-09 08:00:00
Can | 5 | 2026-10-02 12:00:00
Ece | |
Zeynep | 10 | 2026-10-08 11:20:00
(4 rows)EF Core が CROSS APPLY / OUTER APPLY を生成する箇所では、プロバイダーはまさにこの [LEFT] JOIN LATERAL の形を出力します。RIGHT と FULL の LATERAL は拒否されます。順序集合集約としては mode() WITHIN GROUP があります。
SELECT mode() WITHIN GROUP (ORDER BY product_id) AS top_product,
       COUNT(DISTINCT order_id) AS orders
FROM order_items;
top_product | orders
-------------+--------
1 | 6
(1 row)これらに加えて、UNION/EXCEPT/INTERSECT(それぞれに ALL 形式があり、標準の優先順位に従います)、任意の深さの相関サブクエリ、EXISTS、VALUES テーブルコンストラクター、ビュー(CREATE VIEW)、CASE、COALESCE、NULLIF、LIKE、CAST、そして文字列関数と数学関数があります。
日付の演算
TIMESTAMP はエポックミリ秒なので、日付の演算は素直で予測可能です。INTERVAL リテラルはミリ秒の整数に畳み込まれ、ts ± interval も ts - ts も使えます。EXTRACT/date_part と date_trunc は UTC のカレンダー計算、ISO 週(週は月曜日に始まる)、そして PostgreSQL の曜日番号を使います。
SELECT id, created_at,
       created_at + INTERVAL '7 days'  AS due,
       date_trunc('week', created_at)  AS week,
       EXTRACT(DOW FROM created_at)    AS dow,
       (TIMESTAMP '2026-10-12' - created_at) / 86400000 AS days_ago
FROM orders ORDER BY id LIMIT 4;
id | created_at | due | week | dow | days_ago
----+---------------------+---------------------+---------------------+-----+----------
1 | 2026-09-01 10:15:00 | 2026-09-08 10:15:00 | 2026-08-31 00:00:00 | 2 | 40
2 | 2026-09-14 18:40:00 | 2026-09-21 18:40:00 | 2026-09-14 00:00:00 | 1 | 27
4 | 2026-09-20 21:30:00 | 2026-09-27 21:30:00 | 2026-09-14 00:00:00 | 0 | 21
5 | 2026-10-02 12:00:00 | 2026-10-09 12:00:00 | 2026-09-28 00:00:00 | 5 | 9
(4 rows)2 つのタイムスタンプの差はミリ秒単位なので、日数にするには 86,400,000 で割ります。1 つの制限は意図的なものです。INTERVAL は固定の単位しか受け付けず、月と年は拒否されます。「1 か月」は固定のミリ秒数ではないからです。カレンダーとして正しい月の計算には add_months(ts, n) があり、はみ出した日を月末に丸めます。EF の AddMonths/AddYears はこれに変換されます。
対話型トランザクション
トランザクションは対話型です。BEGIN は、同じ接続上で複数のリクエストにまたがって存続するトランザクションを開始します。その読み取りは自身がバッファした書き込みを見ることができ、他の接続はコミットまで何も見えません。セーブポイントで部分的なロールバックができます。
BEGIN;
UPDATE accounts SET balance = balance - 300 WHERE id = 1;
UPDATE accounts SET balance = balance + 300 WHERE id = 2;
SAVEPOINT bonus;
UPDATE accounts SET balance = balance + 1000000 WHERE id = 2;
ROLLBACK TO SAVEPOINT bonus;
SELECT id, owner, balance FROM accounts ORDER BY id;
COMMIT;
id | owner | balance
----+-------+---------
1 | Ayşe | 700.00
2 | Can | 550.00
(2 rows)100 万リラの「ボーナス」は消え、送金は残ります。コミットは 1 つのアトミックな WAL バッチであり、1 回の fsync です。ステートメントが失敗すると、トランザクションは PostgreSQL 流に「汚染」された状態になります。以降のステートメントは拒否され、COMMIT には ROLLBACK が返ります。
BEGIN;
UPDATE accounts SET balance = balance - 50 WHERE id = 1;
UPDATE 1
INSERT INTO accounts VALUES (2, 'Kopya', 0);
ERROR:  duplicate key: PRIMARY KEY value Int(2) already exists in "accounts"
SELECT 1;
ERROR:  current transaction is aborted, commands ignored until end of transaction block
COMMIT;
ROLLBACK
エンジン自体はもっと単純で、エラーの時点でトランザクションをロールバックします。PostgreSQL のセッションレイヤーがこの汚染状態をエミュレートしているのは、psycopg の with conn.transaction(): によるリカバリがそれに依存しているからです。
2 つの接続が互いにどう見えるか、そして行ロックが何をするかを示すために、psycopg 3.3 で短いスクリプトを書きました。これは素の psycopg で、接続文字列以外に OxiDB 固有のものは何もありません。
import psycopg, time

DSN = "host=127.0.0.1 port=15401 user=admin dbname=oxidb"
a = psycopg.connect(DSN)
b = psycopg.connect(DSN, autocommit=True)

a.execute("UPDATE accounts SET balance = balance + 100 WHERE id = 2")
print("A sees:", a.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])
print("B sees:", b.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])
a.commit()
print("B after A commits:", b.execute("SELECT balance FROM accounts WHERE id = 2").fetchone()[0])

a.execute("SELECT * FROM accounts WHERE id = 1 FOR UPDATE")
t = time.time()
try:
    b.execute("UPDATE accounts SET balance = 0 WHERE id = 1")
except psycopg.Error as e:
    print(f"B blocked {time.time()-t:.1f}s, then: {type(e).__name__} [{e.sqlstate}] {e}")
a.rollback()

for sql in ["INSERT INTO accounts VALUES (1, 'x', 0)",
            "INSERT INTO accounts VALUES (3, NULL, 0)",
            "SELECT * FROM nope"]:
    try:
        b.execute(sql)
    except psycopg.Error as e:
        print(f"{type(e).__name__:22} {e.sqlstate}")

cur = b.execute("SELECT owner, balance FROM accounts WHERE balance > %s ORDER BY id", (600,))
print(cur.fetchall(), [d.name + ":" + str(d.type_code) for d in cur.description])
A sees: 650.00
B sees: 550.00
B after A commits: 650.00
B blocked 5.0s, then: LockNotAvailable [55P03] lock timeout: row 1 of 'accounts' is locked by another transaction
UniqueViolation 23505
NotNullViolation 23502
UndefinedTable 42P01
[('Ayşe', Decimal('700.00')), ('Can', Decimal('650.00'))] ['owner:25', 'balance:1700']どの行も何かを物語っています。A は自分の書き込みを見られますが、B はコミットまで見られません。SELECT ... FOR UPDATE は本物の行ロックを取得し、B の書き込みは 5 秒のロックタイムアウトまで待ったあと 55P03 で失敗します。つまりデッドロックは永遠に固まるのではなくエラーになります。SQLSTATE は psycopg の適切な例外クラスにマッピングされます。%s パラメーターは拡張プロトコルを通じてサーバー側でバインドされます。そして DECIMAL カラムは OID 1700(numeric)として記述され、Python には Decimal として届きます。
並行性モデルについて正直に言っておくと、これは完全な MVCC ではありません。開いているトランザクションが書き込む行 ID と AUTO_INCREMENT の値は、各書き込みをバッファする時点でエンジンから予約され、一意性は COMMIT 時にコミット済みの状態に対して再チェックされます。トランザクションが開いている間に別の書き手があなたのキーの 1 つを取っていた場合、コミットは重複キーエラーで拒否され、そのトランザクションの内容は何も書き込まれません。トランザクションをリトライしてください。副作用が 1 つあります。PostgreSQL のシーケンスと同じく、失敗したステートメントも AUTO_INCREMENT の値を消費します。上のセッションでは、失敗した 3 回の顧客 INSERT が ID 5、6、7 を使い切りました。Ece が 8 になり、このあと OxiWire 経由で追加する顧客が 9 になるのはそのためです。
ストアドプロシージャ:SQL と Cobra
ストアドプロシージャには 2 種類あります。1 つ目はツールチェーン不要の道、SQL テキストです。カタログに保存され、アトミックに実行される、名前付きでパラメーター化された DML/SELECT のバッチです。
CREATE PROCEDURE transfer(src INT, dst INT, amount DECIMAL) AS BEGIN
  UPDATE accounts SET balance = balance - amount WHERE id = src;
  UPDATE accounts SET balance = balance + amount WHERE id = dst;
  SELECT id, owner, balance FROM accounts WHERE id IN (src, dst) ORDER BY id;
END;
CALL transfer(1, 2, 125.50);
id | owner | balance
----+-------+---------
1 | Ayşe | 574.50
2 | Can | 775.50
(2 rows)パラメーターは作成時に $N プレースホルダーに書き換えられ、SHOW PROCEDURES は保存された形を表示します:UPDATE accounts SET balance = balance - $3 WHERE id = $1; ...。トップレベルの CALL は暗黙のトランザクション内で実行されるので、どのステートメントが失敗しても呼び出し全体がロールバックされます。ただし、本体には制御フローがありません。これを見てください。
CALL transfer(1, 99, 10);
 id | owner | balance
----+-------+---------
  1 | Ayşe  |  564.50
(1 row)
口座 99 は存在しません。2 つ目の UPDATE は失敗することなく 0 行に作用し、Ayşe の 10 リラは蒸発しました。SQL テキストのプロシージャでは「口座は存在するか、残高は足りているか」を問うことができません。ADR-0014 が存在するのは、まさにそのためです。
Cobra は私が書いたスクリプト言語で、バイトコードコンパイラーとスタック VM を持っています。ADR-0014 では、ストアドプロシージャの受け渡しフォーマットとして .cobrac バイトコードを選びました。コンパイラーは Go 製の cobra ツールのままで、SQL エンジンの中には Rust で書かれたコンパクトな Cobra VM(oxidb-cobra crate)があり、これは実行だけを担います。却下した代替案は示唆に富んでいます。cgo で Go ランタイムを Rust プロセスにリンクする案(GC、シグナル処理、呼び出しごとの二重の FFI)、サイドカープロセスにする案(CALL は呼び出し元のトランザクション内で実行されなければならず、すべてのステートメントを IPC で往復させるのは遅くて壊れやすい)、そして SQL プロシージャを PL/pgSQL 風の方言に育てる案(社内にテスト済みの言語とコンパイラーがすでにあるのに、2 つ目の言語を設計することになる)です。
同じ送金処理の安全なバージョンです。
# CREATE PROCEDURE safe_transfer(src INT, dst INT, amount DECIMAL) LANGUAGE COBRA
def run(db, src, dst, amount)
    let src_rows = db.query("SELECT balance FROM accounts WHERE id = ?", [src])
    let dst_rows = db.query("SELECT balance FROM accounts WHERE id = ?", [dst])
    if len(src_rows) == 0 or len(dst_rows) == 0
        throw "unknown account"
    end
    if src_rows[0]["balance"] < amount
        throw "insufficient funds"
    end
    db.execute("UPDATE accounts SET balance = balance - ? WHERE id = ?", [amount, src])
    db.execute("UPDATE accounts SET balance = balance + ? WHERE id = ?", [amount, dst])
    print("moved", amount, "from", src, "to", dst)
    return db.query("SELECT id, owner, balance FROM accounts ORDER BY id")
end
これをポータブルなバイトコードにコンパイルし、base64 で送ります。バイトコードは 668 バイト、base64 では 892 文字です。
cobra build --portable safe_transfer.cobra
B64=$(base64 -i safe_transfer.cobrac | tr -d '\n')
psql ... -c "CREATE PROCEDURE safe_transfer(src INT, dst INT, amount DECIMAL) LANGUAGE COBRA AS '$B64';"
CALL safe_transfer(2, 1, 100);
NOTICE: moved 100.0 from 2 to 1
id | owner | balance
----+-------+---------
1 | Ayşe | 664.5
2 | Can | 675.5
(2 rows)
CALL safe_transfer(1, 99, 10);
ERROR: evaluation error: procedure "safe_transfer": line 6: uncaught throw: "unknown account"
CALL safe_transfer(2, 1, 5000);
ERROR: evaluation error: procedure "safe_transfer": line 9: uncaught throw: "insufficient funds"いくつか細かい点があります。print の出力は notices として返され、psql はそれを PostgreSQL の NOTICE として表示します。捕捉されない throw は CALL 全体をロールバックし、エラーには Cobra の行番号が含まれます。db.query と db.execute は呼び出し元のストアを通じて実行されるので、プロシージャは CALL のトランザクションに参加し、データベースのエラーは Cobra の try/catch で捕捉できます。戻り値は結果セットの形に整えられます。辞書は 1 行に、辞書のリストはテーブルに、スカラーは単一の value カラムになります。
安全性とクラスタリングも設計を形作りました。VM が外の世界にアクセスできるのは、私が登録した関数を通じてだけです。ファイルシステム、ネットワーク、プロセスへのアクセスはありません。クラスターモードでは Raft が CALL を書き込みステートメントとして複製し、すべてのノードで再実行するので、バイトコードは決定的でなければなりません。そのため組み込み関数の許可リストからは時刻、乱数、I/O、並列処理が除外されており、未知のオペコードや組み込み関数は呼び出しの途中ではなく CREATE の時点で拒否されます。捕捉できない 1 億命令の燃料(fuel)制限が、暴走するループを抑え込みます。
正直に書いておくと、このブリッジは Cobra の値に正確な 10 進数型を使っていません。SHOW PROCEDURES を見ると、amount DECIMAL パラメーターが amount DOUBLE として保存されていることがわかります。上の残高が DECIMAL の書式なしに 664.5 として返ってきているのはそのためです。Cobra のプロシージャでお金のロジックを書く前に知っておくべき点です。
ディスクファーストのストレージ、WAL、グループコミット
ここからはエンジンの内部です。これがディスク上のレイアウトで、このセクションの最後にあるクラッシュテストを終えたあとの、私のデータディレクトリの実際の状態です(抜粋)。
data/sql/
  MANIFEST                      {"version":1,"generation":11,"wal_seq":131}
  wal/live.wal
  gen.11/
    catalog.json
    customers.rdat   customers.$pk.sidx   customers.$uq2.sidx
    events.rdat      events.$pk.sidx
...- WAL(
wal/live.wal)は SQL エンジン専用のログです。ヘッダーはOXSWというマジックで始まり、各レコードは[crc32][len][seq][payload]です。リカバリは、ちぎれた末尾(クラッシュで途中で切れた書き込み)か CRC の不一致に当たるまでレコードを読みます。有効なプレフィックスとは、その時点までに読んだすべてです。 - スナップショット:チェックポイント時に、各テーブルの生きている行が
gen.N/<table>.rdatに書き出されます。ヘッダーはOXSR、レコードは[row_id][len][crc32][payload]です。スナップショットは常に丸ごと書き出される(一時ファイル、fsync、rename)ので、常に一貫したある時点のイメージになります。 - インデックス(
.sidx)は、mmap された、ソート済みの固定ストライドのエントリテーブルです。意図的に B-tree にはしていません。すべての書き手がチェックポイント時にファイルを丸ごと書き直すので、分割すべきページも、空き領域マップも、間違えやすいページレベルの並行性もありません。ルックアップは固定ストライドのテーブルに対する二分探索で、範囲スキャンは下限の探索とそこからの走査です。 - MANIFEST がコミットポイントです。チェックポイントのコミットは単一のアトミックな手順で行われます。一時ファイル、fsync、そして
MANIFESTへの rename による上書きです。rename の前にクラッシュすれば以前の MANIFEST、つまり以前の無傷な世代が有効なまま残ります。作りかけの世代はオープン時に無視され、ガベージコレクションされます。カタログとスナップショットが一緒に切り替わるので、リカバリがスナップショットとカラム数の食い違うカタログを目にすることはありません。
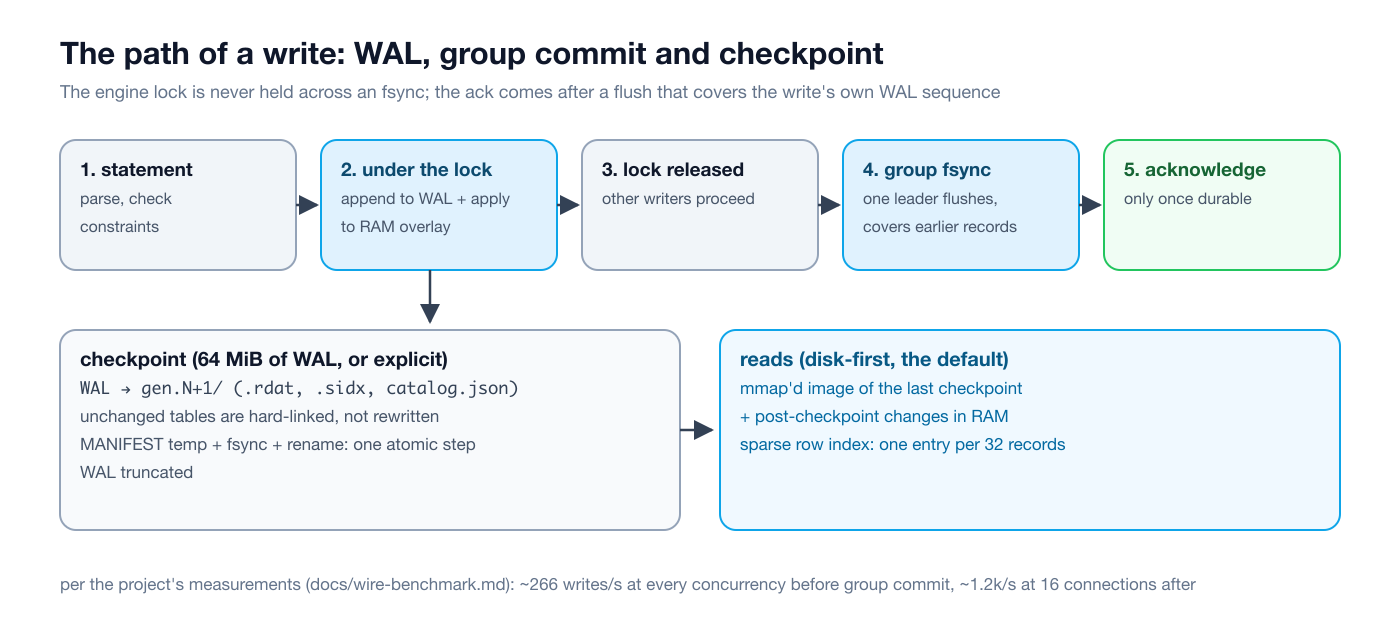
ディスクファーストモードは 0.41.33 以降デフォルトになっています。テーブルデータは最後のチェックポイントの mmap されたスナップショットから提供され、チェックポイント後の変更だけが RAM に保持されます。行、セカンダリインデックス、主キー、UNIQUE カラムはすべてマップされたファイルです。プロジェクトの計測(docs/pg-memory-benchmark.md)によると、ウォームアップ済みの 120 万行のデータベースは約 39 MB で動作します。すべてを RAM に置くレジデントモードでは、同じ行でおよそ 370 MB です。代償はスキャンで支払います。ディスクファーストではすべてのセルをデコードするので、スキャンは PostgreSQL の 0.72〜0.78 倍の速度になり、レジデントモードの約 1.0 倍を下回ります。ポイントクエリとインデックスを使うクエリはどちらのモードでも同じです。ディスク上のフォーマットはどちらでも同一なので、データベースはどちらのモードでも開けます。
メモリ面で私が最も苦労したのは行オフセットインデックスでした。各行が .rdat ファイルのどこにあるかを記録するこの構造は、以前は 1 行あたり約 33 バイトかかっており、1 億行では 3.1 GB の匿名メモリになる計算でした。私はこれを疎にしました。32 レコードごとに 1 エントリを置き、特定の行に到達するにはレコードヘッダーを少しだけ辿ります。これで 1 行あたり 0.69 バイト、1 億行で約 69 MB です。シーケンシャルな読み手はカーソルを使い、辿る必要がないので、スキャンには影響しません。さらに 2 つの細かい点があります。セカンダリインデックスはオープン時ではなく初回使用時に構築されます。そしてチェックポイントは、前の世代から変更されていないテーブルのファイルを書き直すのではなくハードリンクします。これがなかった頃は、どれほど変更が少なくても、チェックポイントのたびにデータベース全体を書き直していました。
グループコミット:並行する書き手は WAL のフラッシュを共有します。書き込みは自分のレコードを追記してエンジンロックの下で適用し、ロックを解放してから、ようやく fsync します。1 つの書き手がフラッシュの実行役に選ばれ、それが始まった時点ですでにディスク上にレコードがあった全員がそのフラッシュでカバーされます。エンジンロックが fsync をまたいで保持されることはありません。応答のルールは変わっていません。ステートメントは、自分の WAL シーケンスをカバーするフラッシュのあとでのみ呼び出し元に戻ります。新たに観測できるようになったのは、ある書き込みが適用されてからフラッシュされるまでの間に、別の接続がそれを読めるという点です。そこでクラッシュするとその書き込みは失われますが、その書き手は応答を受け取っていません。PostgreSQL にも同じ時間窓があります。プロジェクトの計測(docs/wire-benchmark.md)によると、スループットはグループコミット導入前にはどの並行度でも横ばいの約 266 書き込み/秒だったのが、導入後は 16 接続で約 1.2k/秒になりました。効果は並行する書き手が 4 つ程度のところから現れ始めます。
メタデータのみの ALTER TABLE
これは自分で計測したかったものです。psycopg で 100 万行の events テーブルを、1 万行ずつの複数行 INSERT を 100 回送ってロードし(ローカルの Mac で 4.7 秒)、\timing をオンにしてカラムを追加・削除しました。
SELECT COUNT(*) FROM events;
  count
---------
 1000000
(1 row)

Time: 13.230 ms
ALTER TABLE events ADD COLUMN region TEXT DEFAULT 'tr';
ALTER TABLE
Time: 3.275 ms
SELECT id, kind, amount, region FROM events WHERE id = 999999;
   id   |  kind  | amount | region
--------+--------+--------+--------
 999999 | refund | 1498.5 | tr
(1 row)

Time: 0.125 ms
ALTER TABLE events DROP COLUMN region;
ALTER TABLE
Time: 4.367 ms
SELECT kind, COUNT(*), SUM(amount) FROM events GROUP BY kind ORDER BY kind;
  kind  | count  |     sum
--------+--------+-------------
 refund | 333333 | 249750499.5
 sale   | 666667 | 499499500.5
(2 rows)

Time: 98.772 ms
100 万行のテーブルへのカラム追加は 3.3 ms、削除は 4.4 ms でした。これは ADD COLUMN と DROP COLUMN がメタデータのみの操作で、テーブルのサイズに関係なく O(1) だからです。カタログは物理スキーマを保存し、エグゼキューターは論理ビューを見ます。ADD はスロットを追加し、古い行は新しいカラムのデフォルト値で埋められて読み戻されます。DROP はそのカラムを dropped フラグで墓標化(tombstone)します(PostgreSQL の attisdropped と同様です)。物理的なセルは残り、読み取り時に射影から外されます。永続性は単一の WAL レコードに乗っています。本当の O(n) の書き直しは次のチェックポイントに折り込まれます。チェックポイントはどのみちすべての行を書き直すので、領域が回収されるのもそこです。RENAME COLUMN と ALTER COLUMN ... TYPE は今でも行に触れます。後者はまずすべての行でドライランを行います。
クラッシュリカバリ
最後にクラッシュです。行を 1 つ挿入し、kill -9 でサーバーを強制終了して、再び起動しました。
$ psql ... -c "INSERT INTO accounts VALUES (3, 'Kaza Testi', 42.00)"
INSERT 0 1
$ kill -9 $(pgrep oxidb-server)
$ oxidb-server   # restart, WAL replay
$ psql ... -c "SELECT * FROM accounts WHERE id = 3"
 id |   owner    | balance
----+------------+---------
  3 | Kaza Testi |   42.00
(1 row)
応答済みの書き込みは WAL から戻ってきました。再起動後、100 万行のテーブルとドキュメントエンジンが有効な状態で、プロセスはローカルの Mac で約 65 MB の RSS を示していました。
ネイティブプロトコル:OxiWire
入口は PostgreSQL のワイヤだけではありません。ネイティブの OxiWire ポート(長さプレフィックス付きの JSON、MsgPack、または OxiWire エンコーディング)では、リクエストのエンベロープに "engine": "sql" を加えるだけで済みます。Python の標準ライブラリだけを使った生のリクエストです。
import json, socket, struct

def call(sock, req):
    body = json.dumps(req).encode()
    sock.sendall(struct.pack("<I", len(body)) + body)
    n = struct.unpack("<I", sock.recv(4))[0]
    buf = b""
    while len(buf) < n:
        buf += sock.recv(n - len(buf))
    return json.loads(buf)
{"engine": "sql", "cmd": "sql", "sql": "SELECT c.name, COUNT(*) AS orders FROM customers c JOIN orders o ON o.customer_id = c.id WHERE c.city = $1 GROUP BY c.name ORDER BY c.name", "params": ["İstanbul"]}
{"ok": true, "data": [{"columns": ["name", "orders"], "types": ["TEXT", "INT"], "rows": [["Ayşe", 3], ["Can", 1]]}]}
{"engine": "sql", "cmd": "sql", "sql": "INSERT INTO customers (name, email, city) VALUES (?, ?, ?)", "params": ["Deniz", "deniz@example.com", "Bursa"]}
{"ok": true, "data": [{"affected": 1, "last_insert_id": 9}]}ステートメントごとに 1 つの結果があります。types 配列は静的にわかっているカラム型を運ぶので(ADO.NET の GetFieldType が推測しなくて済むように)、? と $N のどちらのプレースホルダーも使えます。2 つのエンジンの分離は、同じソケット上で確認できます。engine フィールドのないリクエストはドキュメントエンジンに届き、SQL テーブルとは完全に独立した customers コレクションを作成します。
{"cmd": "insert", "collection": "customers", "doc": {"name": "doc-world"}}
{"ok": true, "data": {"id": 1}}
{"cmd": "count", "collection": "customers"}
{"ok": true, "data": {"count": 1}}
この時点で SQL テーブルには 5 人の顧客(ID 1、3、4、8、9)がいて、コレクションには 1 つのドキュメントがあります。同じ名前で、別々の世界です。Python、Go、.NET、JS のクライアントはこのエンベロープを sql() メソッドの裏に隠しており、HTTP API を有効にすれば同じエンジンに POST /api/sql でアクセスできます。
PostgreSQL ワイヤプロトコル:ADR-0023
ADR-0023 が答える問いはこうです。OxiDB は自分自身のプロトコルを乱すことなく PostgreSQL v3 プロトコルを提供できるか、そして最初のバージョンの正直な境界線はどこか。コードベースにすでにあった 3 つのものが、これを安上がりにしました。リスナーはすでに独立していました(RESP、MQTT、AMQP、S3 を含めて 9 つ)。SCRAM-SHA-256 はすでにサーバー側に存在していました。そしてエンジンは、プロトコルが必要とする形をすでに備えていました。$N パラメーター、リクエスト間で保留される対話型トランザクション、ステートメントごとに 1 つの結果、静的にわかっているカラム型です。そこで oxidb-server/src/pg/ にコーデック、認証、セッション、カタログ、型、エラーが加わり、OxiWire のパスは何も変わりませんでした。
その中で説明する価値のある決定が 4 つあります。
- ポータルは Describe か Execute の、先に来た方で 1 回だけ実行される。 PostgreSQL はポータルを実行せずに記述できます。このエンジンは結果の形を、それを生成することで報告します。
DescribeにNoData(正直な「まだわからない」)で答えると psycopg が壊れました。psycopg はまさにそこからカラムのメタデータを読むからです。そこでポータルは最初に触れられた時点で実行されて出力をバッファし、Executeは行数制限を守りながらそのバッファをストリームします。目に見える違いは、エラーが 1 メッセージ早く表面化することだけです。 - セッションとカタログのステートメントはエンジンに届かない。 どのクライアントも会話を始める前に送ってくる
SET extra_float_digits = 3、version()、current_database()などはpg/catalog.rsが答えます。\dtと\lはエンジン自身のカタログから返されます。 - まず SQLSTATE、メッセージはその次。 クライアントはテキストではなくコードでリカバリするので、すべての
SqlErrorのバリアントは PostgreSQL が使うであろうコードにマッピングされます。 - pg_catalog は実行されるのではなく、応答される。 認識できるクエリの形(型カタログ、JDBC の
DatabaseMetaData呼び出し、\dt、\l、カタログテーブルの行全体の読み取り)は OxiDB 自身のスキーマから提供されます。それ以外はすべて0A000で拒否されます。空の結果を返したくなるところですが、それは間違いです。空の結果は信じられてしまうからです。これは机上の話ではありませんでした。psql の\d <table>のプローブにテーブル一覧で答えたところ、psql は期待していたカラムでつまずいて失敗しました。拒否のルールはそうして書かれたのです。
            List of tables
 Schema |    Name     | Type  | Owner
--------+-------------+-------+-------
 public | accounts    | table | admin
 public | customers   | table | admin
 public | employees   | table | admin
 public | events      | table | admin
 public | order_items | table | admin
 public | orders      | table | admin
 public | products    | table | admin
(7 rows)
ドキュメントには、実際のドライバーで検証済みのクライアントが列挙されています。psql 18、psycopg 3.3、Npgsql 8.0、pgjdbc 42.7(getTables、getColumns、getPrimaryKeys、getImportedKeys といった DatabaseMetaData 呼び出しを含む)、そしてネイティブの PostgreSQL ドライバーを使う DBeaver 25.3 です。ADR の中で私が一番気に入っている教訓は、どのドライバーが動くかについての私の予測は、実際にドライバーを動かすまで全部外れていた、ということです。Npgsql で観測された失敗(unsupported sql: function version())は、すでに処理済みのステートメントを指していました。本当の原因は、インターセプトされるステートメントとエンジンに渡るステートメントが混在したマルチステートメントのバッチでした。正確なバイト列をダンプするロギングプロキシが、それを数分で見つけました。頭で考えるだけでは見つかりませんでした。
意図的に欠けているもの:COPY、LISTEN/NOTIFY、名前付きのサーバー側カーソル(DECLARE ... CURSOR)、クエリのキャンセル、本物のスキーマ(public.users と users は同じテーブルです)、information_schema、pg_dump。また、CREATE DATABASE はこのポートではなくネイティブポートで実行します。
EF Core:サーバーと組み込み
.NET 側では、ADR-0013 が 5 つのフェーズで完全な EF Core 対応を構築しました。まず式の表現力(CASE、LIKE、EXISTS、CAST、文字列関数)、次に対話型トランザクション、次に ADO.NET プロバイダー(OxiDb.Data、Dapper がエンドツーエンドで動作)、次にマイグレーションのための DDL と型、そして最後に OxiDb.EntityFrameworkCore です。プロバイダーはマイグレーション(本物の __EFMigrationsHistory テーブルを使う Database.Migrate())、dotnet ef dbcontext scaffold によるリバースエンジニアリング、そして ExecuteUpdate/ExecuteDelete をサポートしています。README に記載されているとおり、公式の EF Core リレーショナル仕様テストスイートに、12 の Northwind スイート全体で 3832 件中 3832 件合格しています。既知のいくつかの制限は、テストクラス内の明示的なオーバーライドになっています。
私も自分で試してみました。リポジトリ内の 0.44.2 の NuGet パッケージでビルドした、小さな .NET 10 のコンソールアプリです。
using Microsoft.EntityFrameworkCore;
using OxiDb.EntityFrameworkCore;

var cs = args.Length > 0 ? $"Path={args[0]}" : "Host=127.0.0.1;Port=15400;Database=efshop";

using (var db = new Shop(cs))
{
    db.Database.EnsureCreated();
    var ada = new Author { Name = "Ada" };
    var linus = new Author { Name = "Linus" };
    db.Authors.AddRange(ada, linus);
    db.Posts.AddRange(
        new Post { Title = "SQL engine", Words = 4200, Author = ada },
        new Post { Title = "Time series", Words = 3100, Author = ada },
        new Post { Title = "Ledger", Words = 2800, Author = linus });
    db.SaveChanges();
    Console.WriteLine($"generated keys: ada={ada.Id}, linus={linus.Id}");
}

using (var db = new Shop(cs))
{
    var q = db.Authors
        .Select(a => new { a.Name, Posts = a.Posts.Count, Words = a.Posts.Sum(p => p.Words) })
        .Where(x => x.Words > 1000)
        .OrderByDescending(x => x.Words);
    Console.WriteLine(q.ToQueryString());
    foreach (var row in q) Console.WriteLine($"{row.Name,-6} posts={row.Posts} words={row.Words}");

    var n = db.Posts.Where(p => p.Words < 3000)
        .ExecuteUpdate(s => s.SetProperty(p => p.Words, p => p.Words + 500));
    Console.WriteLine($"ExecuteUpdate touched {n} row(s)");
}

public class Author { public int Id { get; set; } public string Name { get; set; } = ""; public List<Post> Posts { get; set; } = new(); }
public class Post { public int Id { get; set; } public string Title { get; set; } = ""; public int Words { get; set; } public int AuthorId { get; set; } public Author? Author { get; set; } }
public class Shop(string cs) : DbContext
{
    public DbSet<Author> Authors => Set<Author>();
    public DbSet<Post> Posts => Set<Post>();
    protected override void OnConfiguring(DbContextOptionsBuilder o) => o.UseOxiDb(cs);
}
サーバーモードでは(ネイティブポートで CREATE DATABASE efshop によりデータベースを作成したあと)次のようになります。
connection: Host=127.0.0.1;Port=15400;Database=efshop
generated keys: ada=1, linus=2
SELECT "a"."Name", (
    SELECT COUNT(*)
    FROM "Posts" AS "p1"
    WHERE "a"."Id" = "p1"."AuthorId") AS "Posts", (
    SELECT COALESCE(SUM("p2"."Words"), 0)
    FROM "Posts" AS "p2"
    WHERE "a"."Id" = "p2"."AuthorId") AS "Words"
FROM "Authors" AS "a"
WHERE (
    SELECT COALESCE(SUM("p"."Words"), 0)
    FROM "Posts" AS "p"
    WHERE "a"."Id" = "p"."AuthorId") > 1000
ORDER BY (
    SELECT COALESCE(SUM("p0"."Words"), 0)
    FROM "Posts" AS "p0"
    WHERE "a"."Id" = "p0"."AuthorId") DESC
Ada    posts=2 words=7300
Linus  posts=1 words=2800
ExecuteUpdate touched 1 row(s)
EF が生成する相関スカラーサブクエリはそのまま実行され、生成キーは RETURNING を通じて返ってきます。EF が作ったテーブルは普通の SQL テーブルなので、同じデータを psql から見ることもできます。
    Title    | Words
-------------+-------
 SQL engine  |  4200
 Time series |  3100
 Ledger      |  3300
(3 rows)組み込みモードで変わるのは接続文字列だけで、UseOxiDb("Path=./embedded-data") とすれば、EF Core のスタック全体がサーバーなしにプロセス内で、SQLite のように動作します。
connection: Path=./embedded-data
generated keys: ada=1, linus=2
Ada    posts=2 words=7300
Linus  posts=1 words=2800
ExecuteUpdate touched 0 row(s)
最後の行については触れておかなければなりません。この記事を書いている途中で、組み込みモードでは ExecuteUpdate が影響を受けた行数を 0 と報告することに気づきました。更新自体は適用されています(同じデータディレクトリをもう一度開いたところ、Linus の記事は 3300 語になっていました)。つまりこれは、組み込みパスが影響行数を報告する部分のバグです。サーバーモードは正しく報告します。次のリリースで修正します。3 つ目の道として、EF Core は PostgreSQL ポート経由で無改造の Npgsql プロバイダーでも動作します(リポジトリ内の tests/efcore-npgsql-test)。
パフォーマンス:プロジェクトの計測
以下の数値は私が計測したものではなく、プロジェクト自身のベンチマークドキュメントから取ったものです。docs/query-benchmark.md は、同じデータセット(外部キー、複合主キー、8 つのインデックスを持つ、関連し合う 5 つのテーブルにわたる 120 万行)で OxiDB と PostgreSQL を比較しています。どちらも PostgreSQL のワイヤを話すので、自作の 1 つのクライアントが両方のサーバーを駆動してすべてのセルをデコードします。そのためドライバーの違いも言語の違いもありません。PostgreSQL は ANALYZE 後の素の状態で動かし、何かを計測する前に答えが同一であることを確認しています。
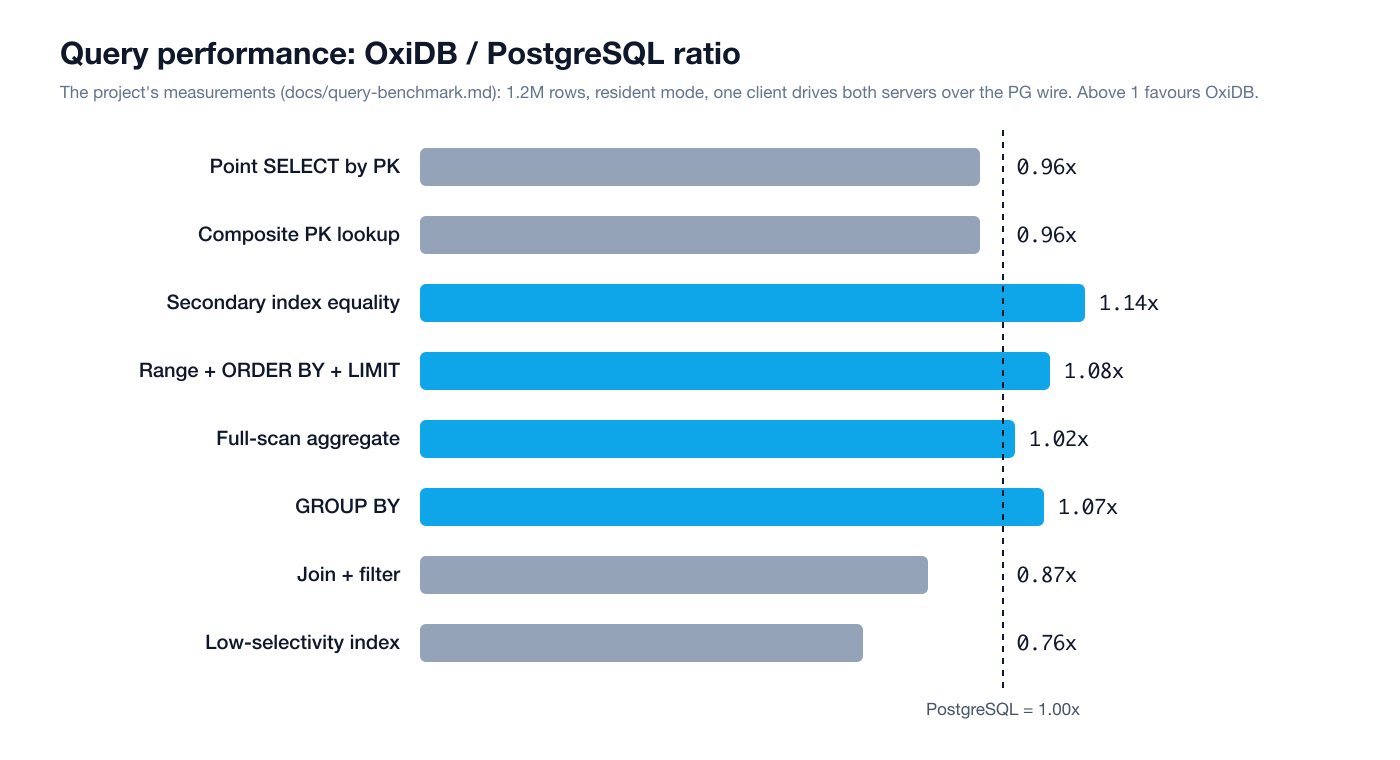
この表はレジデントモードで計測したものです。ディスクファーストモードでは、前述のとおりポイントクエリとインデックスを使うクエリは変わらず、スキャンは 0.72〜0.78 倍に下がります。私にとってそのドキュメントで最も価値があるのは「まだ負けているもの、そしてその理由」のセクションです。JOIN は 0.56 倍から 0.87 倍になりましたが、その途中で計測された失敗が 2 つありました。インデックスネステッドループのしきい値を上げると悪化し(0.29 倍)、わかりやすい BTreeSet による所属判定はさらに悪い結果でした(0.22 倍)。最終的にうまくいったのは、整数キーの範囲に対する直接アドレス方式のビットマップで、行を組み立てるより安く済むほど軽量でした。最初のストリーミング集約の試みはインデックスも素通りしてしまい、count(*) WHERE customer_id = ? を 25 µs のルックアップから 4 ms のフルスキャンに変えてしまいました。ベンチマークはそれを即座に捉えました。
docs/sql-statement-benchmark.md は、ほとんどのクライアントが使う粒度、つまりリクエストごとに 1 ステートメントでエンジンを計測し、見つかった 6 つのボトルネックを説明しています。トランザクションのコストがそのサイズに応じて増えていくこと、トランザクション内のルックアップがオーバーレイ全体を返していたこと、JOIN の駆動テーブルがインデックスを無視していたこと、などです。
制限と正直なトレードオフ
1 か所にまとめておきます。
- 両方のエンジンにまたがるトランザクションはない。 ドキュメントと SQL の書き込みは、それぞれ単独ではアトミックです(ADR-0011 は先送り)。
- 一部の制約は強制されない:
CREATE UNIQUE INDEXの一意性、複数カラムのテーブルレベルUNIQUE、複数カラムの FK、ON UPDATEアクション。CHECKは拒否され、ALTER TABLE ... ADD/DROP CONSTRAINTはありません。 - クエリの穴: 明示的なウィンドウフレーム、
GROUPING SETS/ROLLUP/CUBE、MERGE、TRUNCATEはありません。INSERT ... ON CONFLICTはパースされますが、その競合句は無視されます。この記事のためにいろいろ試していて、INSERT ... SELECTもサポートされていないことに気づきました(unsupported sql: INSERT ... SELECT)。100 万行を複数行 INSERT でロードしたのはそのためです。 - 自己参照 FK は、親と子を同じ複数行 INSERT で受け付けません。
- トランザクションモデル: 完全な MVCC ではありません。一意性はコミット時に再チェックされ、競合するコミットは拒否されます。クラスターではこの再チェックは省略されます。複製されたコミットはすでにクラスターによって合意されているからです。
ALTER TABLE、ビューとプロシージャの DDL はトランザクション内では実行できません。 - PostgreSQL ワイヤ: 任意の
pg_catalogクエリ、\d <table>、COPY、LISTEN/NOTIFY、名前付きカーソル、pg_dumpはありません。リスナーはクラスターモードでは起動しません。 - Cobra プロシージャは
DECIMALをDOUBLEとして扱います。 - ディスクファーストはスキャンでレジデントモードより約 30% 遅くなります。RAM に余裕で収まるデータに対するスキャン中心の分析であれば、
OXIDB_SQL_DISK_FIRST=0が正しい選択です。
クラスターモードでは SQL の書き込みは Raft を通じて複製されます。SQL テキストとパラメーターが Raft ログに追記され、すべてのノードで再実行されます。対話型トランザクションの単独の COMMIT は、バッファされた書き込みを 1 つのアトミックなエントリとして複製します。
OxiDB の他の部分とどう組み合わさるか
OxiDB において、SQL エンジンは二者択一の選択肢ではありません。ドキュメント、時系列、OxiMem キーバリューストア、S3、メッセージングの各機能が同じサーバーで動いている一方で、リレーショナルであるべきデータは、独自のルールのもと独自のファイルに置かれます。同じ認証(SCRAM、ロール、データベースごとの権限付与)と同じマルチデータベースモデル(ADR-0012)が両方のエンジンに適用されます。各データベースが独自の SQL エンジンを持ち、両方のポートが同じデータを見ます。そして必要なのが SQL だけなら、OXIDB_DOC=0 でドキュメントエンジンを完全にオフにすれば、小さな PostgreSQL 互換サーバーが残ります。
試してみる
OxiDB は GitHub releases からビルド済みのバイナリとしてダウンロードすることも、Docker イメージを動かすことも、Rust のワークスペースからビルドすることもできます。最短の道はこれです。
OXIDB_SQL=1 OXIDB_PG_PORT=5432 oxidb-server
psql -h 127.0.0.1 -p 5432 -U admin -d oxidb
あとは手元にある PostgreSQL クライアントをどれでも向けてみてください。何かが動かなかったら、サーバーログの [pg] refused catalog query: ... という行こそ、私に送ってほしいものです。シリーズの次の記事は時系列エンジンに移ります。