OxiDB のドキュメントエンジン:スキーマレスなコレクション、プランナー、3 フェーズコミット
OxiDB の中核をなすドキュメントエンジン。MongoDB スタイルのクエリとアグリゲーション、インデックスとプランナー、ディスクファーストのストレージ、WAL、OCC トランザクション、読み取りスナップショットを、実際のサーバーで動かした例とともに解説します。
私は OxiDB をドキュメントデータベースとして始めました。今では同じプロセスに SQL テーブル、時系列、Redis 互換のキーバリューストア、S3、MQTT、AMQP も入っていますが、そのすべての土台にあるのは私が最初に書いた部分です。スキーマレスな JSON コレクション、MongoDB スタイルのクエリ、そしてアグリゲーションパイプラインです。この記事はその中核についてのものです。有効化の方法、どんなクエリと更新を理解するのか、パイプラインには何があるのか、インデックスとプランナーがどう判断するのか、そしてその内側。ドキュメントがディスク上にどう置かれているか、WAL がいつ fsync されるか、トランザクションがコミット済みとみなされる正確な瞬間、そして読み取りスナップショットがなぜ書き込みパスに手を付けずに済むのか。ここに載せている出力はすべて、Apple M4 Mac 上のローカルの OxiDB 0.44.2 サーバーに対して私自身が実行したものです。作り話の数字はありません。
このシリーズでは、エンジンごとに 1 本の記事を割いています。全文検索とベクトル検索、そして地理空間とグラフのステージもドキュメントエンジンの上で動きますが、それぞれ独自の記事があります:全文検索とベクトル検索、地理空間クエリとグラフクエリ。
ドキュメントエンジンは何のためにあるのか
ドキュメントエンジンは、データの形が時間とともに変わっていくアプリケーションのためのものです。商品カタログでは、ある商品には specs.switch フィールドがあり、別の商品には reviews 配列があります。注文ドキュメントは今日は 5 つのフィールドを持ち、半年後には 7 つになります。リレーショナルなテーブルでは、そのそれぞれがマイグレーションになります。ここでは、コレクションは最初の挿入時に作られ、各ドキュメントは自分のフィールドを持ち歩きます。
OxiDB ではドキュメントエンジンがデフォルトで有効です。他に何も有効にせずにサーバーを起動すれば、手元にあるのはこれだけです。SQL エンジンは独自のファイルを持つ別のエンジンなので(SQL エンジンの記事)、コレクション名とテーブル名が衝突することは決してありません。
動かしてみる
バイナリ 1 つ、設定は不要です。
OXIDB_ADDR=127.0.0.1:15100 \
OXIDB_DATA=./data \
OXIDB_HTTP_PORT=15106 \
OXIDB_WS_PORT=15107 \
./oxidb-server --verbose
起動時に、サーバーは何をしているかを教えてくれます。
[verbose] opening database at ./data/oxidb
[verbose] blob store opened
[verbose] FTS index loaded
TTL eviction: enabled (interval=1000ms)
oxidb-server listening on 127.0.0.1:15100 (pool_size=4, data_dir=./data, idle_timeout=0s)
REST HTTP API listening on 0.0.0.0:15106
WebSocket API listening on 0.0.0.0:15107
この抜粋からは 1 行省きました。サーバーは「lazy sync」が無効であること、つまりすべてのコミットが fsync される(strict モード)ことも告知します。
ネイティブのワイヤプロトコルはシンプルです。4 バイトのリトルエンディアンの長さ、続いて JSON オブジェクト。すべてのリクエストには cmd フィールドがあり、すべてのレスポンスは {"ok": true, "data": ...} か {"ok": false, "error": "..."} です。この記事の例はすべて、ライブラリ不要のこの小さな Python クライアントで実行しました。
import socket, struct, json

class Ox:
    def __init__(self, port=15100):
        self.s = socket.create_connection(("127.0.0.1", port))

    def __call__(self, req):
        b = json.dumps(req).encode()
        self.s.sendall(struct.pack("<I", len(b)) + b)
        n = struct.unpack("<I", self._read(4))[0]
        return json.loads(self._read(n))

    def _read(self, n):
        d = b""
        while len(d) < n:
            d += self.s.recv(n - len(d))
        return d
Python、Go、.NET、JS/TS、Java、Julia、Swift 向けの既製クライアントがあり、さらに OxiWire(コンパクトなバイナリフレーミング)、REST、WebSocket もあります。どれも同じ形のリクエストを話します。
データモデル:スキーマレスなコレクション
挿入する前にコレクションを作成する必要はありません。
> {"cmd": "insert", "collection": "products", "doc": {"sku": "KB-01", "name": "Mechanical keyboard", "price": 89, "tags": ["usb", "rgb"], "stock": {"ist": 12, "ank": 0}, "specs": {"switch": "brown", "layout": "TR-Q"}}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "insert_many", "collection": "products", "docs": [{"sku": "MS-02", ...}, {"sku": "MN-27", ...}, {"sku": "CB-10", ...}, {"sku": "HD-05", ...}]}
< {"ok": true, "data": [2, 3, 4, 5]}
(2 つ目のリクエストの ... は私が省略したものです。ドキュメントの全体は、後のクエリ出力に出てきます。)
すべてのドキュメントには 2 つのシステムフィールドが付きます。_id はコレクション内で増加していく整数で、_version は書き込みのたびに 1 ずつ増えます。_version は単なる参考情報ではありません。楽観的トランザクションの検証全体がこれに依存しており、それについては後で触れます。ネストしたフィールドには、クエリでも更新でもドット記法(stock.ank、specs.switch)でアクセスします。
ディスク上では、ドキュメントは JSON テキストではなくバイナリの JSONB 形式で保存されます。これにより、ドキュメント全体をデコードしなくてもトップレベルのフィールドを 1 つだけ読み取れます。プランナーとインデックスはこれに頼っています。
クエリ
クエリ言語は意図的に MongoDB に近づけてあります:$eq $ne $gt $gte $lt $lte $in $nin $exists $regex $elemMatch $all $size $not $type $mod $and $or $nor $expr。また find は sort、skip、limit も受け付けます。
> {"cmd": "find", "collection": "products", "query": {"stock.ank": {"$gt": 0}, "discontinued": {"$exists": false}}, "sort": {"price": 1}, "limit": 2}
< {"ok": true, "data": [{"sku": "CB-10", "name": "USB-C cable", "price": 9, "tags": ["usb-c"], "stock": {"ist": 200, "ank": 120}, "_id": 4, "_version": 1}, {"sku": "MS-02", "name": "Wireless mouse", "price": 29, "tags": ["bluetooth"], "stock": {"ist": 40, "ank": 15}, "_id": 2, "_version": 1}]}
配列内のオブジェクトには $elemMatch、パターンには $regex、同じドキュメントの 2 つのフィールドを比較するには $expr を使います。
> {"cmd": "find", "collection": "products", "query": {"reviews": {"$elemMatch": {"stars": {"$gte": 5}}}}}
< {"ok": true, "data": [{"sku": "MN-27", "name": "27 inch monitor", "price": 249, "tags": ["usb-c", "hdr"], "stock": {"ist": 3, "ank": 7}, "reviews": [{"by": "ayse", "stars": 5}, {"by": "mert", "stars": 3}], "_id": 3, "_version": 1}]}
> {"cmd": "find", "collection": "products", "query": {"$or": [{"name": {"$regex": "^usb", "$options": "i"}}, {"tags": {"$all": ["usb", "bluetooth"]}}]}}
< {"ok": true, "data": [{"sku": "CB-10", ...}, {"sku": "HD-05", ...}]}
> {"cmd": "find", "collection": "products", "query": {"$expr": {"$gt": ["$stock.ank", "$stock.ist"]}}}
< {"ok": true, "data": [{"sku": "MN-27", "name": "27 inch monitor", ...}]}
これらの例を準備している途中で、MongoDB から来た人なら誰でも驚くであろう違いに出くわしました。黙っているよりは書いておきたいと思います。MongoDB では {"tags": "usb"} は、tags 配列に "usb" を含むすべてのドキュメントにマッチします。OxiDB 0.44.2 では、スカラーの等価比較はフィールドの値全体と比較し、配列の中までは見ません。
> {"cmd": "count", "collection": "products", "query": {"tags": "usb"}}
< {"ok": true, "data": {"count": 0}}
> {"cmd": "count", "collection": "products", "query": {"tags": {"$all": ["usb"]}}}
< {"ok": true, "data": {"count": 2}}
配列内の要素を探すには $all か $elemMatch を使ってください。コード上(src/query.rs、eval_field_op)では、これは意図的な分岐ではなく、配列のセマンティクスがまだ等価比較にまで及んでいないだけです。私の TODO リストに入っています。
更新
更新演算子:$set $unset $inc $mul $min $max $rename $currentDate、そして配列用に $push($each と $slice 付き)$pull $addToSet $pop。1 つのリクエストに複数の演算子を入れることができ、1 つのドキュメントへの更新はアトミックです。
> {"cmd": "update_one", "collection": "products", "query": {"sku": "KB-01"}, "update": {"$inc": {"stock.ank": 5}, "$push": {"tags": "hot-swap"}, "$set": {"specs.switch": "red"}, "$currentDate": {"updated_at": true}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "update", "collection": "products", "query": {"tags": {"$all": ["usb-c"]}}, "update": {"$mul": {"price": 0.9}, "$addToSet": {"tags": "sale"}}}
< {"ok": true, "data": {"modified": 2}}
> {"cmd": "update_one", "collection": "products", "query": {"sku": "HD-05"}, "update": {"$rename": {"discontinued": "archived"}, "$pull": {"tags": "usb"}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "find", "collection": "products", "query": {"sku": {"$in": ["KB-01", "MN-27", "HD-05"]}}, "sort": {"sku": 1}}
< {"ok": true, "data": [
    {"sku": "HD-05", "name": "Headset", "price": 59, "tags": ["bluetooth"], "_version": 2, "_id": 5, "archived": true},
    {"sku": "KB-01", "name": "Mechanical keyboard", "price": 89, "tags": ["usb", "rgb", "hot-swap"], "stock": {"ist": 12, "ank": 5}, "specs": {"switch": "red", "layout": "TR-Q"}, "_id": 1, "_version": 2, "updated_at": "2026-10-11T21:34:50.373050+00:00"},
    {"sku": "MN-27", "name": "27 inch monitor", "price": 224.1, "tags": ["usb-c", "hdr", "sale"], ..., "_id": 3, "_version": 2}]}
カウンターのような単一のホットなドキュメントには find_and_modify があります。どのトランザクションの外でもアトミックに更新し、新しいドキュメントを返します。
> {"cmd": "find_and_modify", "collection": "counters", "query": {"_name": "invoice"}, "update": {"$inc": {"seq": 1}}}
< {"ok": true, "data": {"_name": "invoice", "seq": 1001, "_id": 1, "_version": 2}}
アグリゲーションパイプライン
もっと大きなデータでパイプラインを見せるために、500 人の顧客と 20,000 件の注文をロードしました。注文には order_no、customer("c1" から "c500")、status(paid、shipped、cancelled)、amount、items、created(2026 年前半の ISO 日付)があります。1 回の insert_many 呼び出しで 5,000 ドキュメントを運び、20,000 件すべてのロードにかかったのは 0.17 秒でした。
サポートしているステージ:$match $group $sort $skip $limit $project $count $unwind $addFields $lookup $facet $replaceRoot $out $setWindowFields $dateHistogram $ohlcv $densify $fill、さらに $geoNear、$graphLookup、$shortestPath があり、これらは地理空間とグラフの記事で扱っています。$group のアキュムレーター:$sum $avg $min $max $count $first $last $push $addToSet $percentile。
$group と $lookup
最も多く支払った 3 人を、customers コレクションと結合して求めます。
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"status": "paid"}},
    {"$group": {"_id": "$customer", "spent": {"$sum": "$amount"}, "orders": {"$sum": 1}}},
    {"$sort": {"spent": -1}}, {"$limit": 3},
    {"$lookup": {"from": "customers", "localField": "_id", "foreignField": "code", "as": "c"}},
    {"$unwind": "$c"},
    {"$project": {"_id": 0, "customer": "$_id", "name": "$c.name", "region": "$c.region", "spent": 1, "orders": 1}}]}
< {"ok": true, "data": [{"customer": "c77", "name": "Customer 77", "region": "Izmir", "spent": 10331, "orders": 39}, {"customer": "c57", "name": "Customer 57", "region": "Antalya", "spent": 10303, "orders": 35}, {"customer": "c497", "name": "Customer 497", "region": "Istanbul", "spent": 10279, "orders": 34}]}
$lookup は外部コレクションに対して通常の find を実行するので、foreignField にインデックスがあれば(ここでは customers.code のユニークインデックス)、各結合はインデックスルックアップになります。複数フィールドでの結合は、localFields と foreignFields の配列で行えます。
$facet
$facet は同じ入力に対して複数の独立したサブパイプラインを 1 回のパスで実行するので、ダッシュボードの 3 つのタイルが 3 回のスキャンではなく 1 つのクエリから得られます。
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"created": {"$gte": "2026-06-01", "$lt": "2026-07-01"}}},
    {"$facet": {
      "byStatus": [{"$group": {"_id": "$status", "n": {"$sum": 1}}}, {"$sort": {"n": -1}}],
      "bigTicket": [{"$match": {"amount": {"$gte": 495}}}, {"$count": "n"}],
      "avgBasket": [{"$group": {"_id": null, "avgItems": {"$avg": "$items"}, "maxAmount": {"$max": "$amount"}}}]}}]}
< {"ok": true, "data": [{"byStatus": [{"_id": "paid", "n": 1935}, {"_id": "shipped", "n": 945}, {"_id": "cancelled", "n": 345}], "bigTicket": [{"n": 40}], "avgBasket": [{"_id": null, "avgItems": 3.494263565891473, "maxAmount": 500}]}]}
サブパイプラインは共有のインメモリ集合の上で動くので、その中では $facet と $out は使えません(MongoDB にも同じルールがあります)。また、ここでの日付の比較は単純な文字列比較ではない点にも注意してください。インデックスは ISO 8601 らしく見える文字列をエポックミリ秒として保存するので、範囲クエリは時系列順に動作します。
$setWindowFields
ウィンドウ関数は、$group のように行を畳み込むことなく、隣接するドキュメントから値を計算します。ある顧客の最初の 5 件の注文について、累計、直近 3 件の注文の平均、そして 1 つ前の金額を求めます。
> {"cmd": "aggregate", "collection": "orders", "pipeline": [
    {"$match": {"customer": "c42"}}, {"$sort": {"created": 1}}, {"$limit": 5},
    {"$setWindowFields": {"partitionBy": "$customer", "sortBy": {"created": 1}, "output": {
       "running": {"$sum": "$amount", "window": {"documents": ["unbounded", "current"]}},
       "avg3": {"$avg": "$amount", "window": {"documents": [-2, 0]}},
       "prev": {"$shift": {"output": "$amount", "by": -1, "default": 0}}}}},
    {"$project": {"_id": 0, "created": 1, "amount": 1, "running": 1, "avg3": 1, "prev": 1}}]}
< {"ok": true, "data": [
    {"created": "2026-01-10T02:27:44Z", "amount": 443, "running": 443, "avg3": 443, "prev": 0},
    {"created": "2026-01-15T13:47:23Z", "amount": 421, "running": 864, "avg3": 432, "prev": 443},
    {"created": "2026-01-17T22:53:17Z", "amount": 464, "running": 1328, "avg3": 442.6666666666667, "prev": 421},
    {"created": "2026-02-06T17:02:43Z", "amount": 217, "running": 1545, "avg3": 367.3333333333333, "prev": 464},
    {"created": "2026-02-06T20:34:44Z", "amount": 313, "running": 1858, "avg3": 331.3333333333333, "prev": 217}]}
ドキュメントのウィンドウのほかに range ウィンドウもあります。window: {"range": [-5, 0], "unit": "minute"} は直近 5 件のドキュメントではなく、直近 5 分間を意味します。$rank、$denseRank、$documentNumber もサポートしています。
時間軸を持つデータ:$dateHistogram、$ohlcv、$densify、$fill
この 4 つのステージは、別途時系列エンジンを使わなくてもドキュメントを時間軸で分析できるように追加したものです。(保持期間付きの本格的な圧縮系列には時系列エンジンがあります。)
$dateHistogram はドキュメントをカレンダー上の間隔ごとにバケットに分けます。min_doc_count: 0 を指定すると空のバケットをゼロで埋めるので、チャートに欠けた日ができません。
> {"cmd": "aggregate", "collection": "logins", "pipeline": [{"$dateHistogram": {"field": "at", "interval": "1d", "min_doc_count": 0}}, {"$sort": {"_id": 1}}]}
< {"ok": true, "data": [{"_id": "2026-10-01T00:00:00Z", "count": 2}, {"_id": "2026-10-02T00:00:00Z", "count": 1}, {"_id": "2026-10-03T00:00:00Z", "count": 0}, {"_id": "2026-10-04T00:00:00Z", "count": 0}, {"_id": "2026-10-05T00:00:00Z", "count": 3}]}
$ohlcv は約定ティックをローソク足に変えます。入力を自分で時刻順にソートし、symbol で銘柄ごとにパーティション分割し、fill: "previous" を指定すると、取引のない 1 分間に前の終値を引き継いだフラットなローソク足を置きます。
> {"cmd": "aggregate", "collection": "ticks", "pipeline": [
    {"$ohlcv": {"time": "ts", "interval": "1m", "price": "price", "volume": "qty", "symbol": "sym", "fill": "previous"}},
    {"$project": {"_id": 0, "time": 1, "open": 1, "high": 1, "low": 1, "close": 1, "volume": 1, "count": 1}}]}
< {"ok": true, "data": [
    {"time": "2026-10-12T09:00:00Z", "open": 10.0, "high": 10.4, "low": 10.0, "close": 10.4, "volume": 150.0, "count": 2},
    {"time": "2026-10-12T09:01:00Z", "open": 10.2, "high": 10.9, "low": 10.2, "close": 10.9, "volume": 90.0, "count": 2},
    {"time": "2026-10-12T09:02:00Z", "open": 10.9, "high": 10.9, "low": 10.9, "close": 10.9, "volume": 0.0, "count": 0},
    {"time": "2026-10-12T09:03:00Z", "open": 10.7, "high": 10.7, "low": 10.7, "close": 10.7, "volume": 40.0, "count": 1}]}
$densify は欠けているステップに対して合成ドキュメントを生成し、$fill はそれを埋めます。方法は locf(最後の値を前方に引き継ぐ)、linear(補間)、または定数です。2 つの部屋があるセンサーの例です。
> {"cmd": "aggregate", "collection": "sensor", "pipeline": [
    {"$densify": {"field": "t", "partitionByFields": ["room"], "range": {"step": 1, "bounds": "partition"}}},
    {"$fill": {"sortBy": {"t": 1}, "partitionBy": "$room", "output": {"temp": {"method": "linear"}}}},
    {"$sort": {"room": 1, "t": 1}}, {"$project": {"_id": 0, "room": 1, "t": 1, "temp": 1}}]}
< {"ok": true, "data": [
    {"room": "depo", "t": 0, "temp": 12.0}, {"room": "depo", "t": 1, "temp": 12.333333333333334},
    {"room": "depo", "t": 2, "temp": 12.666666666666666}, {"room": "depo", "t": 3, "temp": 13.0},
    {"room": "lab", "t": 0, "temp": 20.0}, {"room": "lab", "t": 1, "temp": 21.0},
    {"room": "lab", "t": 2, "temp": 22.166666666666668}, {"room": "lab", "t": 3, "temp": 23.333333333333332},
{"room": "lab", "t": 4, "temp": 24.5}]}ここで私は自分自身の設計につまずきました。書き留めておく価値があります。最初の試みでは、$fill に $densify が受け付けるのと同じ "partitionByFields": ["room"] を渡しました。$fill はそのキーを知らず、"partitionBy": "$room" を期待しており、しかも知らないキーを黙って無視します。その結果、倉庫(depo)の欠損がラボの温度で埋められてしまいました(depo, t=1, temp=21.0)。パーティションキーの異なる 2 つのステージと、エラーにならない未知のキー。これは直すべき粗い部分です。
これらのステージには予算があります。$densify や $ohlcv が設定された数を超えるドキュメントを生成しそうになると、結果を黙って切り詰めるのではなくエラーで失敗します。これらの予算は、$setWindowFields の値の予算とともに、0.44.2 の堅牢化の過程で導入されました。
インデックスとプランナー
インデックスの種類
- フィールドインデックス(
create_index):等価、範囲、$in、ソート、カウント。 - ユニークインデックス(
create_unique_index):違反をエラーとして拒否します。 - 複合インデックス(
create_composite_index):プレフィックススキャンとカバードアグリゲーション。 - TTL インデックス(
create_ttl_index):期限切れのドキュメントをバックグラウンドで削除します。 - 全文インデックスとベクトルインデックス:専用の記事で。
インデックスは作成されるとすぐに既存データに対してバックフィルされます。ユニークと TTL の動作です。
> {"cmd": "create_unique_index", "collection": "customers", "field": "code"}
< {"ok": true, "data": "unique index created"}
> {"cmd": "insert", "collection": "customers", "doc": {"code": "c42", "name": "Duplicate"}}
< {"ok": false, "error": "unique constraint violated: field 'code' value already exists"}

> {"cmd": "create_ttl_index", "collection": "sessions", "field": "created_at", "expireAfterSeconds": 2}
< {"ok": true, "data": "ttl index created"}
> {"cmd": "insert", "collection": "sessions", "doc": {"user": "ayse", "created_at": "2026-10-11T21:35:53Z"}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "count", "collection": "sessions"}
< {"ok": true, "data": {"count": 1}}
# 4.5 seconds later
> {"cmd": "count", "collection": "sessions"}
< {"ok": true, "data": {"count": 0}}
TTL のスイープは 1 秒に 1 回実行されます。ログの保持期間も同じ仕組みを使っています(ログとアラートの記事)。
explain
プランナーが何をしているかを見るには explain があります。find、count、aggregate を包み込み、プランを報告し、実際にクエリを実行して時間を計ります。プランは本物のクエリパスが呼ぶのと同じ関数で計算されるので、explain の言うこととエンジンのすることが食い違うことはありません。インデックスなしの場合です。
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "status": "paid"}}}
< {"ok": true, "data": {"strategy": "COLLSCAN", "index_used": null, "collection_docs": 20000, "candidates": null, "examined": 20000, "returned": 18, "post_filter": true, "post_filter_ops": [], "sort": "none", "duration_ms": 4.715}}customer、status、created にフィールドインデックスを、[status, amount] に複合インデックスを作成したあとです。
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "status": "paid"}}}
< {"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": ["customer", "status"], "collection_docs": 20000, "candidates": 18, "examined": 18, "returned": 18, "post_filter": false, "post_filter_ops": [], "sort": "none", "duration_ms": 0.544}}
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"customer": "c42", "amount": {"$gt": 400}, "status": {"$ne": "cancelled"}}}}
< {"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": ["customer"], "collection_docs": 20000, "candidates": 34, "examined": 34, "returned": 11, "post_filter": true, "post_filter_ops": ["$ne"], "sort": "none", "duration_ms": 0.015}}
post_filter_ops は、インデックスでは処理できない演算子を列挙します。$ne はそのフィールドを持たないドキュメントも含めなければならないので、インデックスからは答えられません。プランナーは customer インデックスで候補を 34 件に絞り込み、その 34 件に対して $ne を評価します。
選択性とインデックスの交差
プランナーはインデックスそのものからコストを見積もります。等価ならキーの件数、範囲なら範囲内の件数、$in なら合計です。$and にインデックス付きの条件が複数ある場合、最も選択性の高いもの(返すドキュメントが最も少ないもの)を駆動側として選び、それを遅延的に走査しながら、他のインデックス付き条件の集合と交差させます。
これを計測していて、予想していなかったことに気づきました。交差では他の条件の集合が先に実体化されますが、status = paid は約 12,000 ドキュメントあるので、交差が高くつくのです。
{'customer': 'c42'}                       INDEX_SCAN ['customer']            0.007 ms
{'customer': 'c42', 'status': 'paid'}     INDEX_SCAN ['customer', 'status']  0.554 ms
{'customer': 'c42', 'items': {'$gte': 5}} INDEX_SCAN ['customer']            0.005 ms
(15 回の実行の中央値。)選択性の低いフィールドのインデックスが、このクエリを遅くしています。34 件の候補を 1 つずつフィルタリングする方が、12,000 個の ID の集合を構築するよりはるかに安上がりです。3 つ目のクエリは items 条件にインデックスがなくポストフィルターに回りますが、これが最速です。駆動側の候補数が少ないときは交差を省略する、というルールの方が良いでしょう。これも私の TODO リストに入っています。それまでの実用的なアドバイスとしては、カーディナリティの低いフィールド(ステータス、フラグ)には単独のインデックスよりも複合インデックスを選ぶことです。
B-tree からのソート、インデックスのみのカウント、カバードな $group
プランナーには 3 つのショートカットがあります。
- インデックスからのソート。 ソートフィールドにインデックスがあれば、エンジンは結果をソートする代わりに B-tree を順に走査し、
limitが埋まった時点で止まります。フィルター自身のインデックスの方が走査より安ければ、プランナーは走査を取りやめます。explain も同じ関数を通じて同じ問いを立てます。 - インデックスのみのカウント。 インデックス付きの等価条件であれば、
countはドキュメントに触れずにインデックスから件数を読み取ります。 - カバードな
$group。[$match?] → $groupというパイプラインで、グループキーとすべての$sum/$avg/$min/$maxのフィールドが 1 つの複合インデックスにある場合、答えはその B-tree の走査から得られます。各エントリはすでに値のタプルとそのドキュメント数を持っているので、sum += value × countとなります。ドキュメントは 1 つも読み込まれず、デコードもされません。
> {"cmd": "explain", "inner": {"cmd": "find", "collection": "orders", "query": {"status": "paid"}, "sort": {"created": -1}, "limit": 10}}
< {"ok": true, "data": {"strategy": "INDEX_SORT", "index_used": "created", "collection_docs": 20000, "candidates": 11949, "examined": 20000, "returned": 10, "post_filter": false, "post_filter_ops": [], "sort": "index-backed", "duration_ms": 0.015}}
> {"cmd": "explain", "inner": {"cmd": "count", "collection": "orders", "query": {"status": "cancelled"}}}
< {"ok": true, "data": {"strategy": "INDEX_ONLY_COUNT", "index_only": true, "post_filter_ops": [], "count": 2037, "duration_ms": 0.0}}(INDEX_SORT の場合、examined フィールドは最悪ケースを報告します。走査は limit が埋まった時点で早めに止まります。)
同じ 4 つのクエリを、インデックスなしとありで比べたものです。
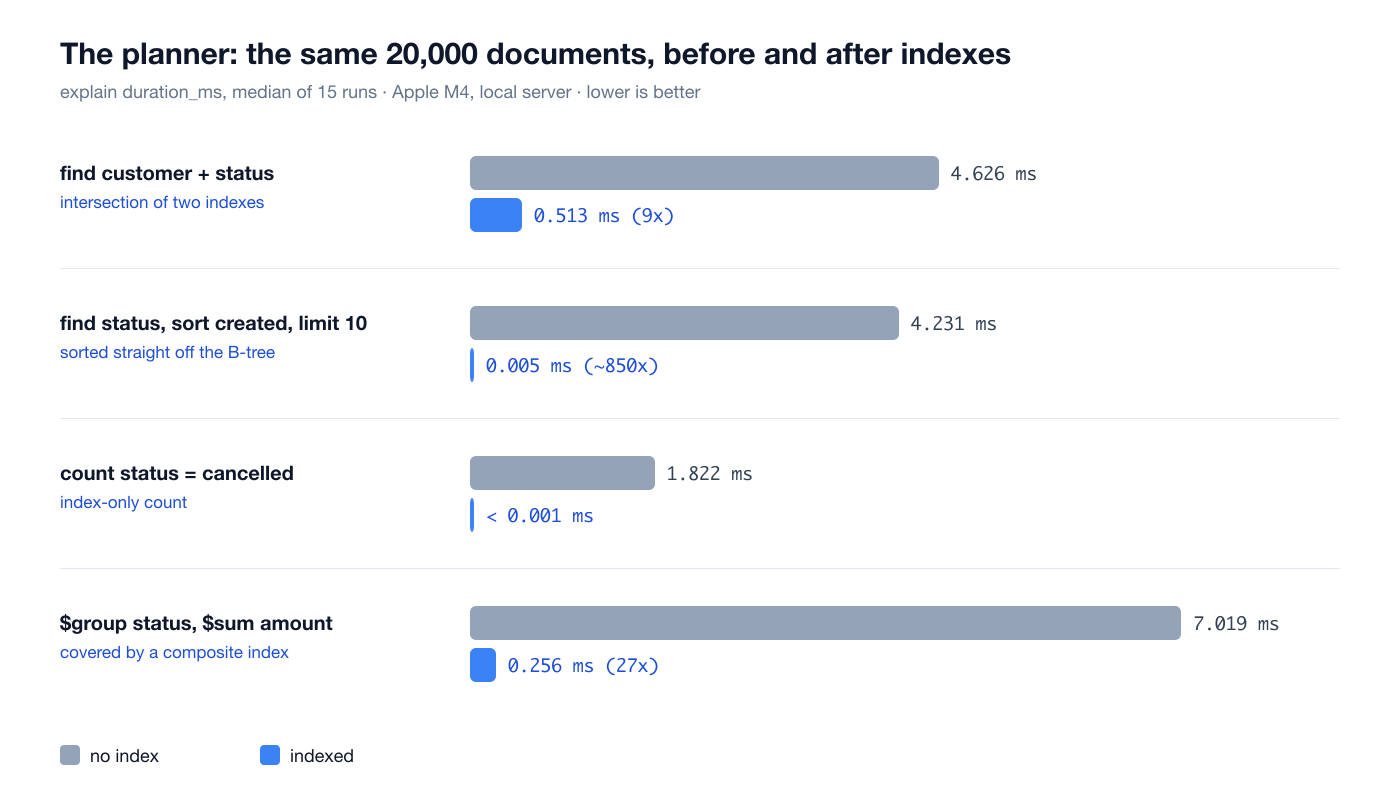
カバードな $group には注意点が 1 つあります。インデックスされた値が日付に変換された文字列や、配列やオブジェクトをシリアライズしたものである場合、エンジンは元の値を再現できないため、通常のパスにフォールバックします。これはあくまでショートカットであり、答えを変えることは決してありません。
ストレージフォーマット
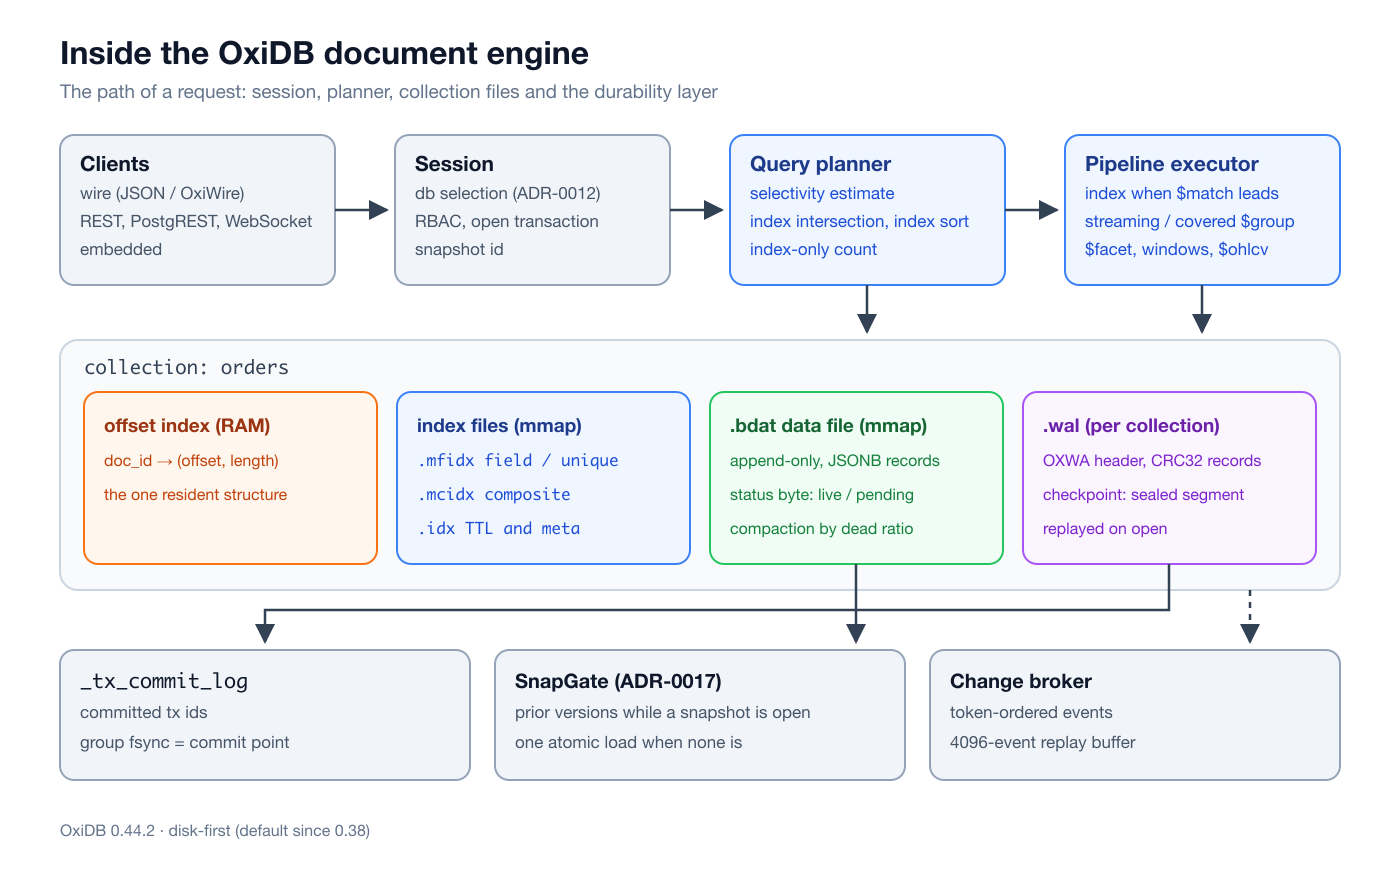
数か月前まで、OxiDB は実のところディスク永続化付きのインメモリデータベースでした。すべてのドキュメントのバイト列が RAM に置かれ、.btree ファイルは定期的なスナップショットにすぎませんでした。100 万ドキュメントでの比較では、メモリはデータに比例して増えていきました。私は ADR-0009 の「ディスクファースト」モードでこれを変え、0.38 以降はそれがデフォルトになっています。
.bdatデータファイル。 追記専用で、mmap を通じて読み取ります。各レコードはステータスバイトと長さで始まります。更新は新しいレコードを追記し、古いレコードを死んだものとしてマークします。- オフセットインデックス。 RAM に残る唯一の構造で、
doc_id → (offset, length)、ドキュメントあたり数十バイトです。ADR-0018 はこれをさらに縮める方法を検討しており、1 億ドキュメントでは数 GB の下限になることを率直に認めています。 - インデックスファイル。 フィールドインデックスは
.mfidx、複合インデックスは.mcidxとして、小さなインメモリの書き込みオーバーレイの背後で mmap を通じて開かれます。起動時には再構築されるのではなく、マップされます。 - コンパクション。 死んだ領域がファイルの半分以上になり、かつファイルが 4 MiB 以上になると、メンテナンススレッドが生きているレコードを新しいファイルに書き出し、アトミックに差し替えます。インデックスは
doc_idをキーにしているので、何も再インデックスする必要はありません。 - 圧縮はオプトイン。 プロジェクト自身の 100 万ドキュメントでの計測では、レコードごとの zstd はわずかなディスク節約と引き換えにアグリゲーションとインデックス構築を約 4 倍遅くしたため、0.38.9 以降のデフォルトは非圧縮です。
OXIDB_DISK_COMPRESSEDで有効にできます。
コレクションごとのオプションは <name>.bopts に書き込まれるので、コレクションのディスクフォーマットは永続的になり、環境変数に左右されなくなります。私のテストデータベースのディレクトリは次のようになっていました。
$ ls -la data/oxidb | awk '{print $5, $9}'
3313100  orders.bdat
130      orders.bopts
659712   orders.created.mfidx
174430   orders.customer.mfidx
160131   orders.status.mfidx
226177   orders.status_amount.mcidx
347      orders.idx
3713108  orders.wal
0        orders.worm
8        _tx_commit_log
...
$ cat data/oxidb/accounts.bopts
{
  "disk_first": true,
  "compress": false,
  "auto_compact": true,
  "compact_min_bytes": 4194304,
  "compact_dead_ratio": 0.5
}(.worm ファイルはドキュメントレベルの不変性ロックを保持していますが、この記事の範囲外です。)
WAL と永続性
すべてのコレクションは独自の .wal ファイルを持っています。ファイルは OXWA というマジックバイトとバージョンで始まり、そのあとに [crc32][length][payload] という形のレコードが続きます。ペイロードの最初のバイトが操作(insert、update、delete)で、その後に tx_id、doc_id、ドキュメントの JSONB バイト列が続きます。ポイントインタイムリカバリを有効にすると、レコードにはグローバルシーケンス番号(GSN)と壁時計の時刻も載ります。リカバリ中、CRC が一致しないレコードや書きかけの最後のレコードは、ちぎれた末尾として扱われ、読み取りはそこで止まります。xxd で見てみます。
$ xxd data/oxidb/accounts.wal | head -3
00000000: 4f58 5741 0100 0000 c0e1 8f1e 5600 0000  OXWA........V...
00000010: 0100 0000 0000 0000 0001 0000 0000 0000  ................
00000020: 0040 0000 0410 0000 0310 0000 0810 0000  .@..............
デフォルトのモードは strict です。すべてのコミットは、クライアントに成功を伝える前に fsync されます。チェックポイントはオンラインで実行され、WAL を切り詰めるのではなく封印します。ライブのファイルはセグメントに rename され、新しい WAL が始まるので、チェックポイントが書き手と競合することはありません。
私も自分で試してみました。あるトランザクションが 2 つのコレクションに書き込み、続いて自動コミットの書き込みが 1 つあり、そのあと kill -9 でサーバーを、シャットダウンの機会を与えずに強制終了して、再び起動しました。
$ python3 crash.py write
> {"cmd": "begin_tx"}
< {"ok": true, "data": {"tx_id": 7}}
> {"cmd": "insert", "collection": "ledger", "doc": {"entry": "debit", "account": "alice", "amount": 250}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "insert", "collection": "ledger_audit", "doc": {"entry": "credit", "account": "bob", "amount": 250}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
> {"cmd": "insert", "collection": "ledger", "doc": {"entry": "note", "text": "auto-commit write"}}
< {"ok": true, "data": {"id": 2}}
$ kill -9 $(cat server.pid)   # immediately, no shutdown
$ ./start.sh
$ python3 crash.py read
> {"cmd": "find", "collection": "ledger", "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 1, "account": "alice", "amount": 250, "entry": "debit"}, {"_id": 2, "_version": 1, "entry": "note", "text": "auto-commit write"}]}
> {"cmd": "find", "collection": "ledger_audit", "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 1, "account": "bob", "amount": 250, "entry": "credit"}]}
1 回の kill では何も証明できないことはわかっています。本当の保証はリポジトリのクラッシュテストにあります。特定のバイトオフセットでの kill マトリクス、コミットの途中でプロセスを kill してお金が保存されていることを確認する Jepsen 風の銀行テスト、そして fsync の障害注入で、すべて cargo test -- --ignored で実行します。正直に言うと、これらのテストには何度も私の誤りを証明されてきました。0.40 では、2 つのコレクションにまたがるトランザクションがクラッシュ後に半分だけ適用された状態で戻ってくるというバグを見つけました。ディスクファーストモードでは、コミットマークが永続化される前にレコードがデータファイルに届いてしまい、オープン時の再構築がそれを生きているものと見なしていたのです。0.44.2 では、ストレージの監査によって、応答済みの書き込みが失われうるリカバリパスがさらに 5 つ見つかり、塞がれました。以下で説明する「保留レコード」の仕組みが存在するのは、そうした経緯があるからです。
トランザクション:OCC と 3 フェーズコミット
トランザクションは複数のドキュメントと複数のコレクションにまたがることができます。モデルは楽観的並行性制御(OCC)です。begin_tx のあと、その接続上の書き込みはサーバー上でバッファされ("buffered")、読み取ったすべてのドキュメントは、その時点の _version とともに読み取りセットに記録されます。コミット時に読み取りセットが検証されます。
> {"cmd": "begin_tx"}
< {"ok": true, "data": {"tx_id": 1}}
> {"cmd": "update", "collection": "accounts", "query": {"name": "alice"}, "update": {"$inc": {"balance": -30}}}
< {"ok": true, "data": "buffered"}
> {"cmd": "update", "collection": "accounts", "query": {"name": "bob"}, "update": {"$inc": {"balance": 30}}}
< {"ok": true, "data": "buffered"}
# from another connection, before the commit:
> {"cmd": "find", "collection": "accounts", "query": {}}
< {"ok": true, "data": [{"name": "alice", "balance": 100, "_id": 1, "_version": 1}, {"name": "bob", "balance": 50, "_id": 2, "_version": 1}]}
> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
# after the commit:
< {"ok": true, "data": [{"name": "alice", "balance": 70, "_id": 1, "_version": 2}, {"name": "bob", "balance": 80, "_id": 2, "_version": 2}]}
2 つのトランザクションが同じドキュメントを読み書きした場合、2 番目にコミットする方が競合を知らされます。
A> {"cmd": "begin_tx"}                     B> {"cmd": "begin_tx"}
A> find alice  → balance 70, _version 2    B> find alice → balance 70, _version 2
A> update alice $inc -50  → "buffered"     B> update alice $inc -60 → "buffered"
A> {"cmd": "commit_tx"}
< {"ok": true, "data": "committed"}
B> {"cmd": "commit_tx"}
< {"ok": false, "error": "transaction conflict on 'accounts' doc 1: expected version 2, found 3"}
(このブロックは、2 つの接続にまたがる順序を示すために実際の出力を要約したものです。エラーメッセージはサーバーのものをそのまま載せています。)
コミットの内部です。
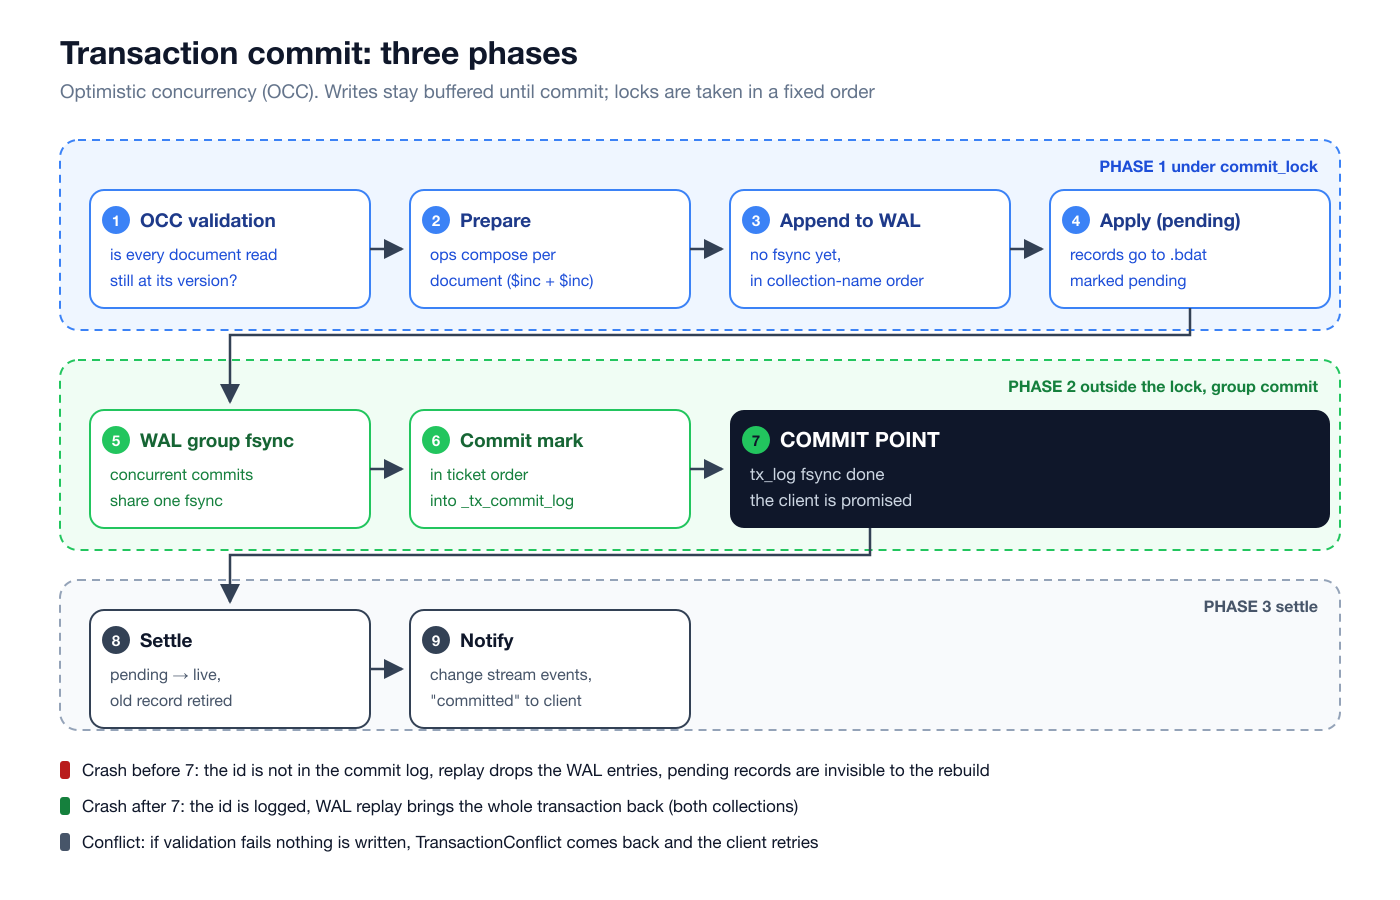
フェーズ 1 はエンジンの commit_lock の下で実行されます。読み取りセットが検証されます。書き込みが準備され、1 つのドキュメントに対する連続した操作($inc -2 のあとに $inc +1)は合成されます。レコードは fsync なしで各コレクションの WAL に追記され、その後データファイルに「保留(pending)」として適用されます。このフェーズのすべてはメモリ上の処理とバッファされたファイル追記です。
フェーズ 2 はロックの外で実行されます。WAL は fsync されますが、sync_shared を通じて行われるので、同時にコミットするトランザクションは 1 回の物理的な fsync を共有します(グループコミット)。続いてトランザクション ID がチケット順に _tx_commit_log に書き込まれ、そのファイルの fsync が完了します。まさにそこがコミットポイントです。チケット順であることによって、あるコミットが、その書き込みを読んだ可能性のある別のコミットより先に永続化されることはないと保証されます。
フェーズ 3 では、保留レコードが生きている状態に切り替えられ、それによって置き換えられたレコードは死んだものとしてマークされます。その後、変更イベントが発行され、クライアントは "committed" を受け取ります。
リカバリはこの順序を逆向きに利用します。コミットログにない tx_id の WAL エントリはリプレイ時に破棄され、保留レコードは再構築からは見えません。ログにある ID のエントリは完全に復元されます。2 つのコレクションにまたがるトランザクションは、両方に存在するか、どちらにも存在しないかのどちらかです。
デッドロックが起こりえない理由。 トランザクションのコレクションは BTreeSet に保持され、ロックは常に同じ順序で取得されます。まず commit_lock、次にコレクションのバリアを名前順に。直接の(トランザクションでない)書き込みも同じ順序を使います。待ちの循環が形成されえないので、デッドロックは構造的に不可能です。
ホットなドキュメントには find_for_update。 激しく競合するドキュメント(たとえば共有の手数料口座)では、OCC がリトライの嵐に変わることがあります。find_for_update はマッチしたドキュメントをコミットかロールバックまで悲観的にロックし、他の呼び出しは待ち行列に並びます。
A> {"cmd": "find_for_update", "collection": "accounts", "query": {"name": "bob"}}
< {"ok": true, "data": [{"name": "bob", "balance": 80, "_id": 2, "_version": 2}]}
B> {"cmd": "find_for_update", "collection": "accounts", "query": {"name": "bob"}, "lock_timeout_ms": 300}
< {"ok": false, "error": "lock timeout on 'accounts' doc 2: held by another transaction"}
# waited 305 ms
これらのロックが排除するのは他の for_update 呼び出しだけで、正しさの最後の砦は依然として OCC の検証です。放棄されたトランザクションは OXIDB_TX_MAX_IDLE_SECS(デフォルト 300 秒)を過ぎるとロールバックされるので、姿を消したクライアントがサーバーにロックを残すことはできず、遅れて届いたリクエストには「not found」ではなく TransactionExpired が返されます。
保証そのもの。 docs/isolation.md には、テストで固定された異常のスコアカードがあります。要約すると、コミットされたトランザクションは、読み書きしたドキュメントに関して直列化可能です。ダーティリード、ダーティライト、更新の消失、アイテムの読み取りに対する write skew は防がれます。2 つの穴は意図的に残してあります。1 つ目はファントムです。読み取りセットが保持するのは返されたドキュメントであって、クエリの述語ではありません。2 つ目は、トランザクションでない読み手が、コミットの適用途中の状態を半分だけ見てしまう可能性があることです。トランザクションの中では、自分がバッファした書き込みをコミット前に読むことはできません。書き込んだ値は自分で計算してください。「オープンな注文は最大 N 件」のような述語制約に対して推奨されるパターンは、その制約をカウンタードキュメントに移し、すべての書き手がそれを読んで更新するようにすることです。そうすれば OCC がそこで直列化します。同じファイルには、request_id のユニークインデックスの上に構築された exactly-once のパターンも説明されています。受領記録を同じトランザクション内で書き込み、リトライはユニーク違反に当たって「適用済み」になります。
書き込みスループット
すべてのコミットが fsync される場合、スループットは実質的に fsync のスループットです。macOS では、Rust の sync_data は F_FULLFSYNC を使います。これは実際にドライブをフラッシュするもので、ミリ秒単位の時間がかかります。3 つの書き込みパターンを、1、4、16 の並行接続で計測しました。
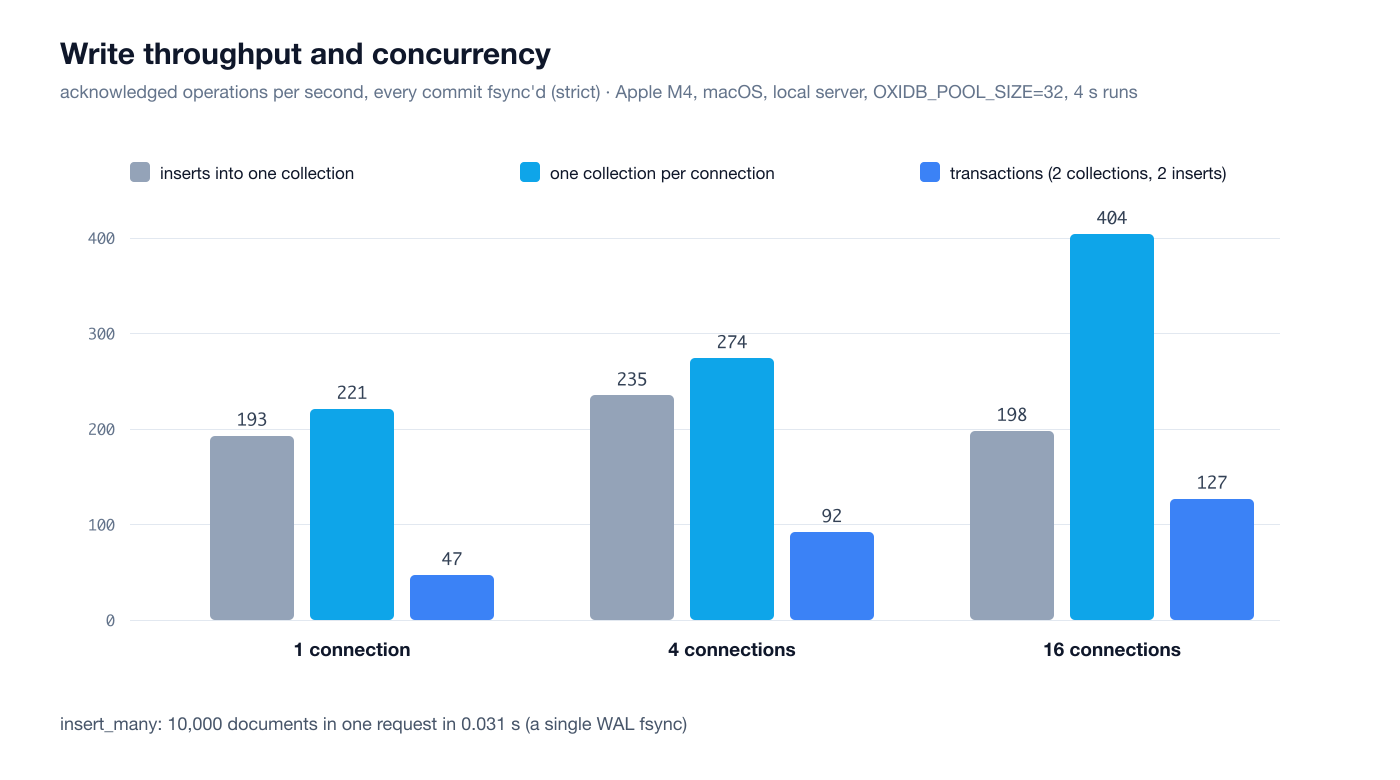
結果は示唆に富んでいます。同じコレクションへの単発の自動コミット挿入は、接続数に応じてスケールしません(193、235、198 ops/s)。そのパスはコレクションごとに fsync を直列に行うからです。各接続が自分専用のコレクションに書き込む場合は、404/s まで伸びます。トランザクションはグループコミットのおかげで 47 から 127 tx/s になります。各トランザクションは 4 往復で、2 つのコレクションにそれぞれ 1 件ずつ挿入します。バッチ書き込みは別格です。10,000 ドキュメントの insert_many は、1 回の WAL fsync を共有するので 0.031 秒で終わりました。実用的な教訓は、重い書き込みはバッチにするか、トランザクションにまとめることです。1 つのコレクションへの、単発で並行かつ厳密に永続的な書き込みは、このエンジンの最も弱い部分です。
MVCC-lite:読み取りスナップショット(ADR-0017)
OCC には意図的な穴がありました。トランザクションでない読み手が、あるコミットが適用されている最中に、ドキュメント A はコミット後の状態で、ドキュメント B はコミット前の状態で見てしまう可能性があったのです。残高の合計を出すレポートが、どの瞬間にも真ではなかった合計を出してしまうことがありえました。ADR-0017 は、これを読み取りパスだけで修正します。書き込みパス(OCC、find_for_update、グループコミット)には手を付けません。
仕組みはこうです。スナップショットが開いている間、書き手は自分が置き換えるバイト列をインメモリのバージョンマップに追加して先に進みます。書き手が待つことは決してありません。スナップショットが開いていないとき(これがデフォルトです)、コストは書き込みごとに 1 回のアトミックなロードだけです。スナップショットは commit_lock.write() の下で始まり、すべての論理的な書き込みは commit_lock.read() の下で記録されるので、「スナップショットの開始後に見えるようになったすべての変更」にはきれいな境界があります。aggregate はデフォルトでスナップショット一貫性を持ち、明示的なスナップショット API を使えば複数のクエリを同じ瞬間に固定できます。
> {"cmd": "snapshot_begin"}
< {"ok": true, "data": {"snap": 1000}}
# another connection:
> {"cmd": "update", "collection": "accounts", "query": {"name": "alice"}, "update": {"$set": {"balance": 0}}}
< {"ok": true, "data": {"modified": 1}}
> {"cmd": "insert", "collection": "accounts", "doc": {"name": "carol", "balance": 500}}
< {"ok": true, "data": {"id": 3}}
# the first connection:
> {"cmd": "find", "collection": "accounts", "query": {}}
< {"ok": true, "data": [{"name": "alice", "balance": 0, "_id": 1, "_version": 4}, {"name": "bob", "balance": 85, "_id": 2, "_version": 3}, {"name": "carol", "balance": 500, "_id": 3, "_version": 1}]}
> {"cmd": "snapshot_find", "collection": "accounts", "snap": 1000, "query": {}}
< {"ok": true, "data": [{"_id": 1, "_version": 3, "balance": 20, "name": "alice"}, {"name": "bob", "balance": 85, "_id": 2, "_version": 3}]}
> {"cmd": "snapshot_aggregate", "collection": "accounts", "snap": 1000, "pipeline": [{"$group": {"_id": null, "total": {"$sum": "$balance"}}}]}
< {"ok": true, "data": [{"_id": null, "total": 105}]}
> {"cmd": "aggregate", "collection": "accounts", "pipeline": [{"$group": {"_id": null, "total": {"$sum": "$balance"}}}]}
< {"ok": true, "data": [{"_id": null, "total": 585}]}
> {"cmd": "snapshot_end", "snap": 1000}
< {"ok": true, "data": "snapshot closed"}
スナップショットの中では Alice の更新は巻き戻され、Carol は存在しません。スナップショットは OXIDB_SNAPSHOT_MAX_SECS(デフォルト 300)を過ぎると期限切れになります。永遠に開きっぱなしのスナップショットは定義上、肥大化(bloat)のバグであり、この上限によって、書き手を止めるのではなく読み手に対する SnapshotExpired エラーに変わります。
完全な MVCC を作らなかった理由は ADR に書いてあります。完全な MVCC は OCC を補完するものではなく、置き換えるものです。vacuum 級の肥大化の問題を持ち込み、インデックスのバージョン管理の代償を、スナップショットが有効な間だけでなくあらゆる場所で払わせます。このエンジンの最も価値ある特性は、その保証がクラッシュテストで網羅的に検証できるほど小さいことであり、私はそれを守りたかったのです。
チェンジストリームとリアルタイム
watch コマンドは、接続をチェンジストリームに変えます。オプションで 1 つのコレクションに限定することもできます。すべてのイベントは増加していく token を持ちます。挿入と更新は新しいドキュメントを、削除は古いドキュメントを運び、トランザクションからのイベントはその tx_id も運びます。
W< {"event":"change","data":{"token":1,"operation":"update","collection":"accounts","doc_id":1,"document":{"name":"alice","balance":70,"_id":1,"_version":2},"tx_id":1}}
W< {"event":"change","data":{"token":2,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":80,"_id":2,"_version":2},"tx_id":1}}
W< {"event":"change","data":{"token":3,"operation":"update","collection":"accounts","doc_id":1,"document":{"name":"alice","balance":20,"_id":1,"_version":3},"tx_id":2}}
W< {"event":"change","data":{"token":4,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":85,"_id":2,"_version":3},"tx_id":5}}
競合したトランザクション(tx 3)とロールバックされたトランザクション(tx 4)がストリームに現れることはありません。これはイベントがコミットポイントのあとに発行されることから導かれます。接続が切れた場合は、resume_after で中断したところから再開できます。サーバーは直近の 4096 件のイベントをリプレイバッファ(OXIDB_CHANGE_REPLAY_EVENTS)に保持しています。
> {"cmd": "watch", "collection": "accounts", "resume_after": 3}
< {"ok": true, "data": "watching"}
W< {"event":"change","data":{"token":4,"operation":"update","collection":"accounts","doc_id":2,"document":{"name":"bob","balance":85,"_id":2,"_version":3},"tx_id":5}}
同じストリームは WebSocket(OXIDB_WS_PORT、{"cmd": "subscribe", "id": "sub1", "collection": ..., "query": ...})でも利用でき、JWT 認証と、ドキュメントごとに評価される行レベルセキュリティのルールが適用されます。
REST と PostgREST
HTTP の入口は 2 つあります。1 つ目はプレーンな JSON の REST API です。
$ curl -s -X POST localhost:15106/api/products/documents -H "Content-Type: application/json" -d '{"doc":{"sku":"SP-01","name":"Speaker","price":120,"tags":["bluetooth"]}}'
{"id":6}
$ curl -s -X POST localhost:15106/api/orders/aggregate -H "Content-Type: application/json" -d '{"pipeline":[{"$match":{"customer":"c42"}},{"$group":{"_id":"$status","n":{"$sum":1}}},{"$sort":{"n":-1}}]}'
[{"_id":"paid","n":18},{"_id":"shipped","n":9},{"_id":"cancelled","n":7}]
2 つ目は PostgREST 互換の入口です(ADR-0019)。/rest/v1/{table} は PostgREST の URL 文法を話すので、@supabase/postgrest-js のようなクライアントが無改造で動作し、同じ URL でドキュメントコレクション、SQL テーブル、時系列のいずれにもアクセスできます。
$ curl -s "localhost:15106/rest/v1/orders?customer=eq.c42&status=eq.paid&select=order_no,amount,created&order=amount.desc&limit=3"
[{"order_no":7782,"amount":456,"created":"2026-03-14T02:27:01Z"},{"order_no":1028,"amount":444,"created":"2026-04-28T19:05:23Z"},{"order_no":15018,"amount":443,"created":"2026-01-10T02:27:44Z"}]
$ curl -s "localhost:15106/rest/v1/products?or=(price.lt.20,price.gt.200)&select=sku,price"
[{"sku":"MN-27","price":224.1},{"sku":"CB-10","price":8.1}]
OXIDB_JWT_SECRET がなければ REST API は認証なしで開放されており、サーバーは起動時にそれについての警告を出します。本番環境では JWT かプライベートネットワークが必要です。
複数のデータベース(ADR-0012)
1 つのプロセスで複数のデータベースをホストでき、それぞれが独自のディレクトリ(data/oxidb、data/tenant_a、...)に置かれます。1 つのデータベースはドキュメントの名前空間と SQL の名前空間の両方をカバーし、同じ名前でアクセスします。すべてのリクエストは db フィールドを持つことができ、あるいはセッションを use_db で切り替えることもできます。
> {"cmd": "create_database", "name": "tenant_a"}
< {"ok": true, "data": "database 'tenant_a' created"}
> {"cmd": "insert", "collection": "orders", "db": "tenant_a", "doc": {"order_no": 1, "amount": 42}}
< {"ok": true, "data": {"id": 1}}
> {"cmd": "list_databases"}
< {"ok": true, "data": ["oxidb", "postgres", "tenant_a"]}
> {"cmd": "use_db", "name": "tenant_a"}
< {"ok": true, "data": "switched to database 'tenant_a'"}
> {"cmd": "count", "collection": "orders"}
< {"ok": true, "data": {"count": 1}}
> {"cmd": "use_db", "name": "oxidb"}
< {"ok": true, "data": "switched to database 'oxidb'"}
> {"cmd": "count", "collection": "orders"}
< {"ok": true, "data": {"count": 20000}}
postgres は、PostgreSQL ワイヤのクライアント向けのデフォルトデータベースのエイリアスです。セッションの開いているトランザクションは開始したデータベースに束縛され、別のデータベースへのリクエストはコミットまで拒否されます。Raft レプリケーションはデータベースの DDL とスコープ付きの書き込みも運びます。データベースをまたぐクエリやトランザクションは、意図的に範囲外としています。
Blob
ドキュメントエンジンは小さなオブジェクトストアも備えています。バケット、キー、コンテンツタイプ、メタデータ。請求書、添付ファイル、小さなファイルに向いています。
> {"cmd": "put_object", "bucket": "invoices", "key": "2026/10/INV-1001.txt", "data": "SW52b2ljZSAxMDAxOiAzIHgga2V5Ym9hcmQ=", "content_type": "text/plain", "metadata": {"customer": "c42"}}
< {"ok": true, "data": {"key": "2026/10/INV-1001.txt", "bucket": "invoices", "size": 26, "content_type": "text/plain", "etag": "2d01298f4acb19ac183c86e3fbe43e3d", "created_at": "2026-10-11T21:36:35Z", "metadata": {"customer": "c42"}, "stored_size": 26, "format_version": 1}}
Blob 内のテキスト(PDF、DOCX、HTML など)は全文検索に取り込むこともできます。本物の S3 クライアントと話す入口は別の話題です:S3 オブジェクトストレージの記事。
制限と正直なトレードオフ
- 1.0 以前。 ディスクフォーマット、ワイヤプロトコル、クエリ言語は、リリース間でマイグレーション手段なしに変わる可能性があります。バージョンを固定し、アップグレード時にはダンプしてリロードしてください。
- 配列の等価比較は MongoDB と同じではない。
{"tags": "usb"}は配列の中を見ません。$allか$elemMatchを使ってください。 - ファントムと述語制約。 トランザクションが直列化可能なのは読み取ったドキュメントに対してであり、述語に対してではありません。素の
find/countは read-committed です。一貫したビューが必要ならaggregateか明示的なスナップショットを使ってください。 - トランザクション内で自分の書き込みを読むことはできない。 書き込みはコミット時に合成されます。
- 1 つのコレクションへの単発で並行かつ厳密な書き込みはスケールしない。 バッチにするか、トランザクションにまとめてください。
- 選択性の低いインデックスとのインデックス交差は高くつく。 カーディナリティの低いフィールドには複合インデックスを選んでください。
- 常駐メモリの下限がある。 オフセットインデックスはドキュメント数に応じて増え、大きな結果セットは依然としてメモリ上で実体化されます。結果フレームのストリーミングは ADR-0026 で設計されています。
$fillと$densifyは異なるパーティションキーを受け付け、未知のキーは黙って無視されます。
OxiDB の他の部分とどう組み合わさるか
ドキュメントエンジンは、OxiDB の残りの部分が立っている地盤です。WAL、コミットログ、暗号化、バックアップ、ポイントインタイムリカバリはその仕組みを使っています。ログ取り込み用のコレクションと、その TTL ベースの保持期間も、ドキュメントエンジンのコレクションです。全文インデックスとベクトルインデックス、地理空間とグラフのステージは、そのパイプラインの中で動きます。SQL エンジンと時系列エンジンは、意図的に別々のファイルを持つ別々のエンジンですが、同じプロセスの中で、同じセキュリティモデルと同じデータベースセレクターのもと、すべて 1 つのバイナリに収まって暮らしています。
試してみる
バイナリは GitHub releases にあります:github.com/parisxmas/OxiDB/releases(macOS arm64/x86_64、Linux x86_64/arm64、Windows)。ダウンロードして展開し、実行します。
tar xzf oxidb-server-*.tar.gz
./oxidb-server
Docker なら docker compose up -d で十分です。デフォルトでは 127.0.0.1:4444 で待ち受け、./oxidb_data/ に書き込みます。この記事のリクエストは、上の短い Python クライアントでそのまま試せます。シリーズの次の記事は全文検索とベクトル検索で、まさにこれらのコレクションの上で動きます。