fastroute:KiCad 向けの高速なオープンソース PCB オートルーター(Freerouting を Rust に移植する)
Freerouting を Rust に忠実に移植しました。Java とバイト単位で同一の結果、5 倍の速度と大幅に少ないメモリ、長年のバグ修正、ライブビュー、長さ合わせ、差動ペア、インピーダンス制御、KiCad プラグイン。測定値と画面は実際の実行から。
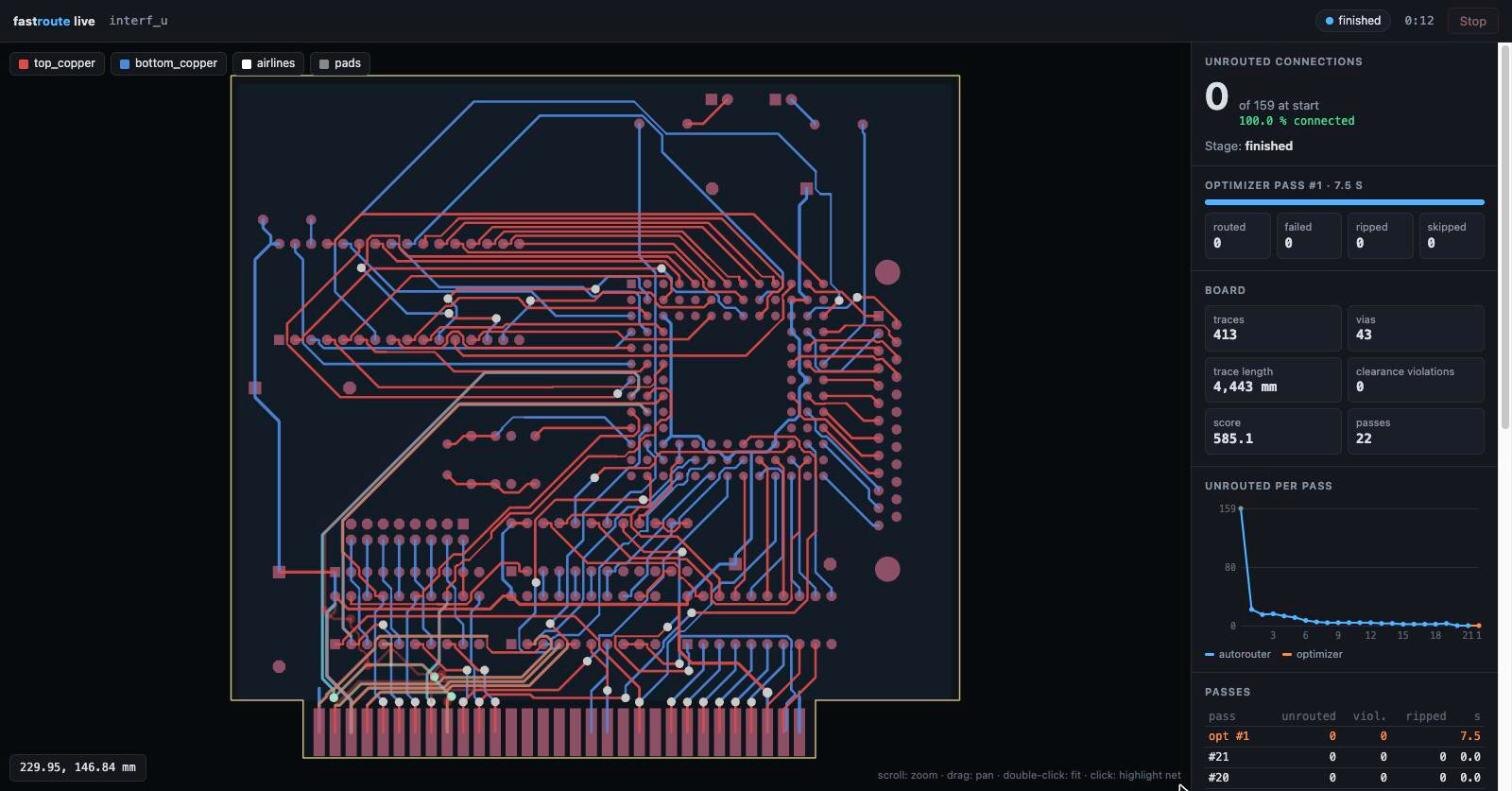
プリント基板(PCB)の設計でいちばん時間がかかるのは、たいてい配線です。数百本の接続を、互いに決められた距離より近づかず、ビアで層を移りながら走る銅箔パターンに変えていく作業です。KiCad ユーザーが長年頼ってきたオープンソースのツールが、Java で書かれたオートルーター Freerouting です。fastroute は Freerouting を Rust に移植したものです。アルゴリズムも、入出力(Specctra .dsn → .ses)も、コマンドラインも同じです。ただし Java は不要で、数倍速く、メモリ使用量はほんの一部で済みます。
この記事では、プロジェクトを最初から最後まで見ていきます。なぜ、どうやって移植したのか、Java と「バイト単位で同一」の結果を出すとはどういうことか、結果を変えない高速化、修正したバグ、そして Freerouting にはない新機能(長さ合わせ、差動ペア、インピーダンス制御、ライブビュー)です。ライブビューのスクリーンショットは、自分のマシンでプロジェクトを実行して撮りました。どの測定値が私のもので、どれがプロジェクトのドキュメントからのものかは、その都度明記しています。
プロジェクトサイト:fastroute.baltavista.com · ソースコード:github.com/parisxmas/fastroute。(似た名前に注意してください。OpenROAD で使われている IC 設計用のグローバルルーター FastRoute とは無関係です。)
なぜ Freerouting を書き直すのか
Freerouting は良いルーターです。そのアルゴリズムは長年かけて成熟し、多くの実際の基板で試されてきました。しかし使っているうちに、3 つの点が繰り返し気になりました。
- Java。 KiCad プラグインを使うには別途 Java ランタイムが必要です。インストール、バージョンの不一致、そして大きな基板ではギガバイト単位のメモリ。
- 速度。 中規模の基板で数分、大きな基板では数時間かかることもあります。
- バグ。 コードを読んでいくと、結果に直接影響し、何年も放置されてきたバグが見つかりました。たとえば、オートルーターが自分で停止したときにはオプティマイザーがまったく実行されません。停止リクエストがセットされたまま残り、オプティマイザーの候補がすべて「停止済み」として失敗してしまうからです。
新しいルーターを一から書く代わりに、私は Freerouting を忠実に移植する道を選びました。最大の利点は、測定できることです。「移植は正しいか?」という問いに明確な答えがあります。同じ基板を同じ設定で与えたときに Java と同じ出力を出せば、それは正しいのです。高速化や改良は、その確かな土台の上にだけ積み上げました。
プロジェクトの構成
fastroute は Cargo ワークスペースです。Rust が約 70,000 行、それに KiCad プラグイン用の Python が約 2,400 行あります。
| Crate | 内容 |
|---|---|
fr-dsn | Specctra の S 式リーダーと型付き DSN モデル |
fr-geom | 平面幾何(Java の geometry.planar パッケージに相当) |
fr-jcompat | ルーターが依存する Java ライブラリの挙動をビット単位で正確にエミュレート |
fr-settings | ルーター設定、デフォルト値、コマンドラインと DSN からの設定ソース |
fr-engine | 基板モデル、探索木、オートルーター、pull-tight/shove/オプティマイザー、DRC、スコアリング、パイプライン |
fr-io | DSN → 基板ローダー、ロード後の処理、SES のライターとリーダー |
fastroute | コマンドラインツールとライブビューサーバー |
移植はユニット単位でボトムアップに進めました。まず Java 互換レイヤー、データ構造、ルール、ライブラリ。次に基板アイテムと探索木(Java で約 13,000 行)、DRC とスコアリング、最適化とルーティングボード、オートルーティングのコア(拡張ルーム、迷路探索、経路探索)、そして最後にパイプラインです。最初のコミットは 9 月 27 日で、82 コミット後の 10 月 7 日にバージョン 0.1.13 をリリースしました。
「バイト単位で同一」とはどういうことか
--parity モードでは、fastroute は Freerouting の決定論的モード(シングルスレッドのオプティマイザー、回数ベースの時間制限)が書き出すものとバイト単位で同一の SES ファイルを生成します。この主張を書く前に、自分で試してみました。KiCad のデモにある interf_u 基板を、Apple M4 上の fastroute 0.1.13 で --parity モードを使って配線し、その出力をプロジェクトに保存されている Java のリファレンス出力と比較しました。
$ fastroute -de interf_u.dsn -do interf.ses --parity
...
   12.563 INFO  routing finished in 12.55 s

$ cmp reference/parity-baseline/interf_u.ses interf.ses && echo IDENTICAL
IDENTICAL
$ shasum -a 256 reference/parity-baseline/interf_u.ses interf.ses
2e174236513ccab65daa…  reference/parity-baseline/interf_u.ses
2e174236513ccab65daa…  interf.ses
ここに到達するには、アルゴリズムを正しく移植するだけでは到底足りません。ルーターの結果は、Java 標準ライブラリのごく細かな挙動に依存しているからです。たとえば次のようなものです。
- 乱数。 オプティマイザーや順序のシャッフルには
java.util.RandomとCollections.shuffleが使われています。同じ順序を再現するには、48 ビットの線形合同法生成器と、nextInt(bound)のオーバーフローに基づく棄却ループを正確にコピーする必要があります。 - 推移的でないコンパレーター。 いくつかの箇所で、Java の
TreeMapが数学的には推移的でないコンパレーターとともに使われています。この場合、結果は木の赤黒構造に依存するため、TreeMapを同じバランシング規則で独自に書き直しました。 - ハッシュの順序。
HashMap<Integer, …>の反復順序が結果に影響する箇所がちょうど 1 つあります。そこでは Java の反復順序をエミュレートしています。 - 浮動小数点。 演算順序を保ち、
mul_add(融合積和演算)は使いません。スコアは Java と同じキャストでf32で計算します。DoubleStream.sumの補償付き加算と、三角関数には fdlibm(libm)を使っています。 - 文字列比較。
String.compareToは UTF-16 のコードユニット単位で動作します。 - 探索木の形。 一部の幾何クエリは自分で木をたどり、進みながらクエリ範囲を縮めていきます。訪問順序によって生成されるルームが変わるため、Rust の
MinAreaTreeは Java の木の形を正確に再現しています。
以下は fr-jcompat にある java.util.Random の移植の一部です。整数オーバーフローに頼る Java の棄却条件を、Rust では wrapping_sub と wrapping_add で明示的に書いています。
/// `protected int next(int bits)`, `1 <= bits <= 32`.
#[inline]
pub fn next(&mut self, bits: u32) -> i32 {
    debug_assert!((1..=32).contains(&bits));
    self.seed = self.seed.wrapping_mul(Self::MULTIPLIER).wrapping_add(Self::ADDEND) & Self::MASK;
    // (int) (nextseed >>> (48 - bits))
    ((self.seed as u64) >> (48 - bits)) as i32
}

/// `Random.nextInt(int bound)`. Panics if `bound <= 0` (Java throws `IllegalArgumentException`).
pub fn next_int_bound(&mut self, bound: i32) -> i32 {
    assert!(bound > 0, "bound must be positive");
    let mut r = self.next(31);
    let m = bound - 1;
    if (bound & m) == 0 {
        // power of two
        r = ((bound as i64 * r as i64) >> 31) as i32;
    } else {
        let mut u = r;
        loop {
            r = u % bound;
            // Java relies on int overflow to reject values from the incomplete last range.
            if u.wrapping_sub(r).wrapping_add(m) >= 0 {
                break;
            }
            u = self.next(31);
        }
    }
    r
}
正しさはレイヤーごとに確認しました。ロード後の基板の正規化ダンプ、ビット単位で正確な統計、接続ごとのトレースマーカー、パスごとのハッシュとスコア、そして最後に SES の差分です。最初の大きなマイルストーンは、ルーティングをオフにして書き出した「未配線」の SES が、20 枚のベンチマーク基板すべてで Java と同一になったことでした。DSN リーダーは 2,470 個のサンプルファイルでもテストしました。続いてフルパイプラインです。--parity モードでは、20 枚中 20 枚の基板が Java とバイト単位で同一になります。
意図的に移植しなかった唯一のものは、Java の DSN リーダーのバグです。サンプルファイルのうち 12 個で、JFlex スキャナーが名前から非 ASCII 文字を落としたり、一部の引用符付き文字列で同期を失ったり、ピン名の 1 文字を次のピンにずらしたりします。fastroute はこれらを正しく読むため、それらの基板は Java と比較できません。
ライブビュー
Freerouting にない最初の機能は、基板が配線されていく様子をブラウザで見られることです。--live を付けると、fastroute はインターネット不要のローカルページを開きます。配線が現れては引き剥がされる様子、残りの接続(エアライン)、各パスの進捗、パスごとの未配線数のグラフ、クリアランス違反、スコア、ログがすべて表示されます。ズーム、レイヤーの切り替え、ネットのハイライト、そして最良の結果を保持したまま止める「Stop」ボタンもあります。ライブビューの有無で結果は変わりません。
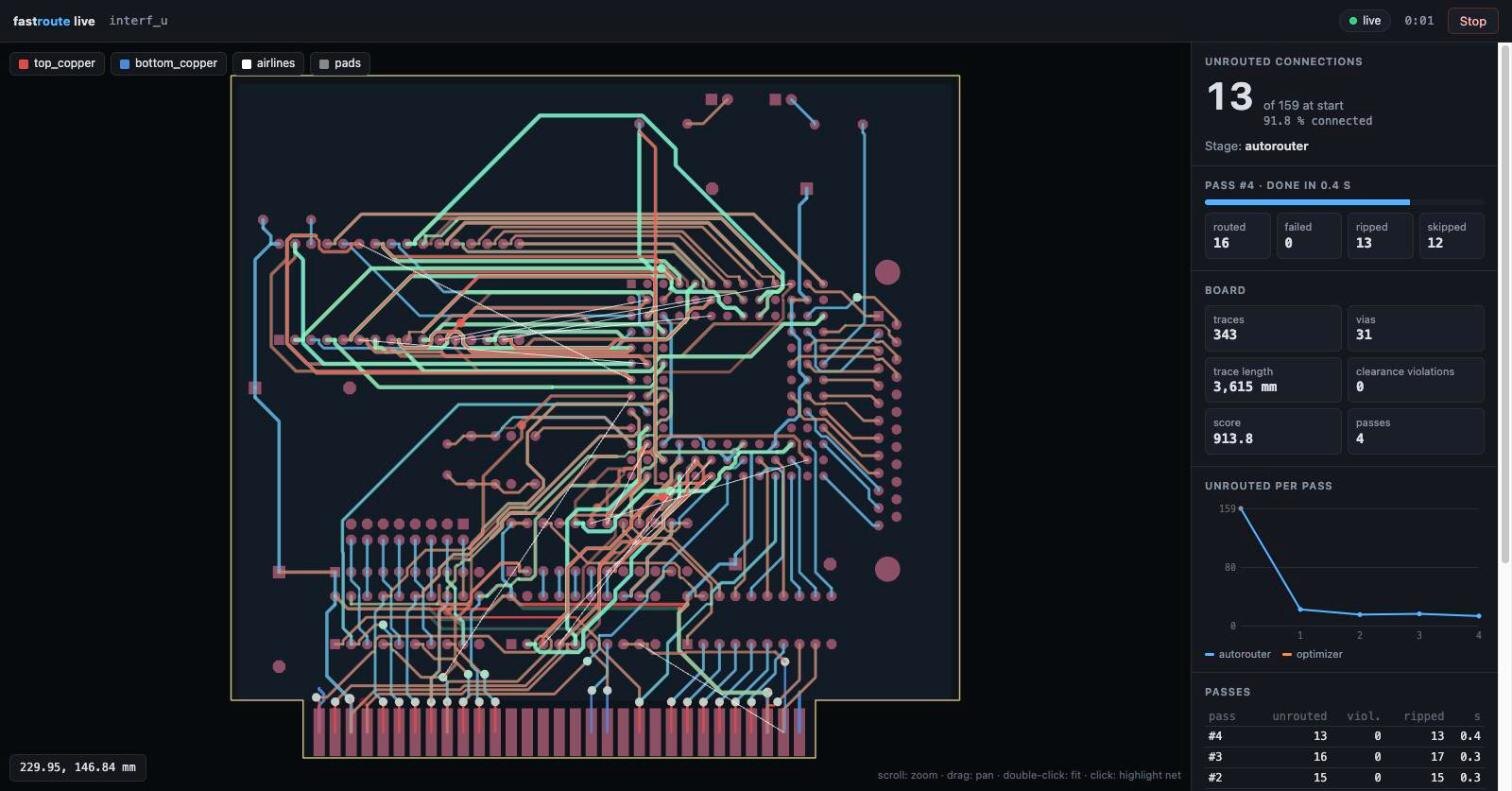
上の画面は interf_u 基板のパス 4 のものです。緑の配線はそのパスで配置されたもの、白い線はまだ配線されていない接続です。右のグラフが示すように、基板は 159 本の接続から始まり、最初のパスで 20 本を下回ります。カバー画像の最終状態では、159 本すべての接続が違反なしで配線されています。
もっと難しい例として、6 層の CM5_MINIMA_3 基板(Raspberry Pi Compute Module 5 用のキャリアボード)を実行してみました。この基板は完全には配線できません。残った接続に対して、fastroute はマルチスタートの段階で、異なる順序でルーターを並列に再実行します。
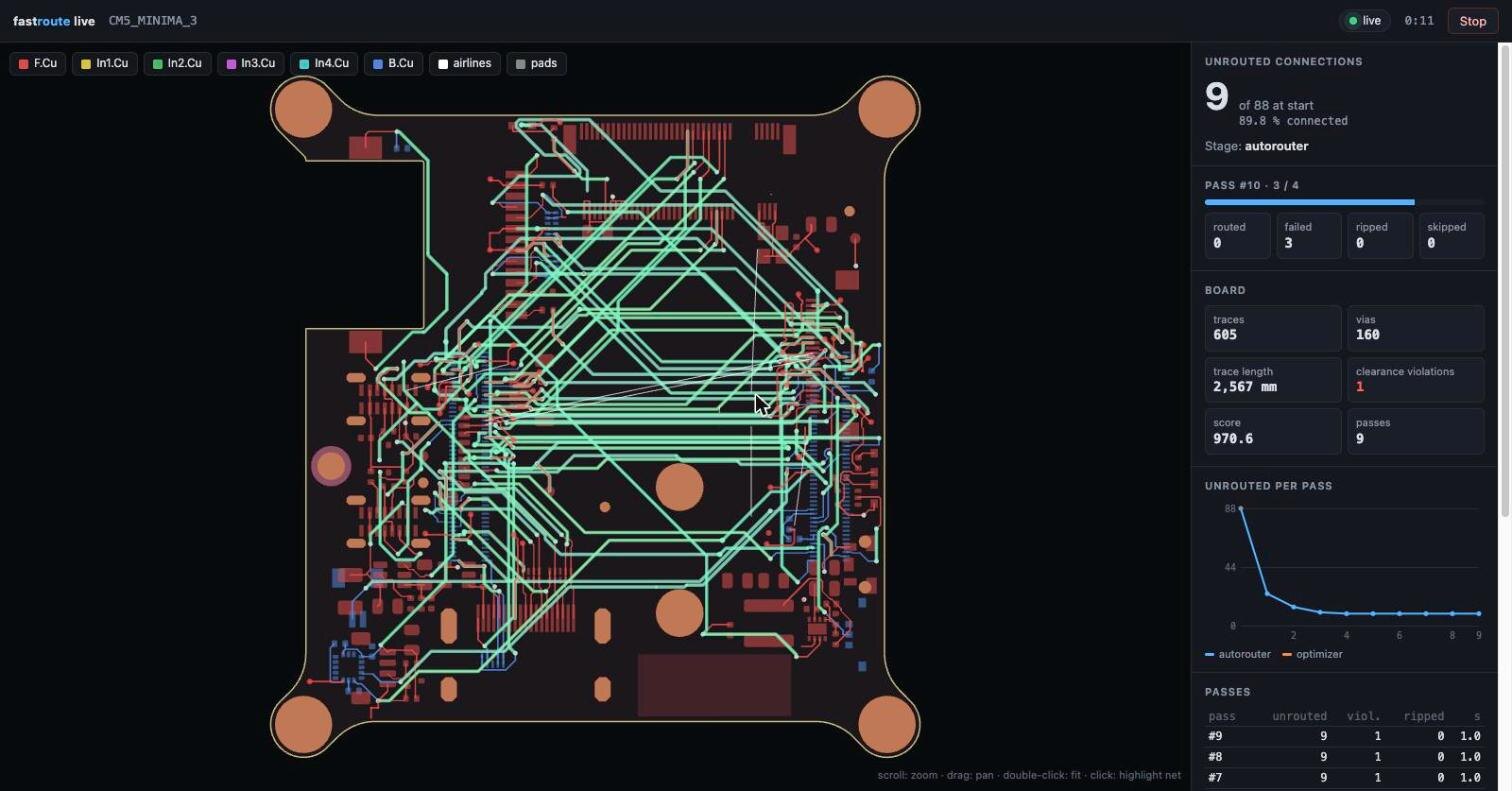
私のマシンでは 41 秒で完了し、88 本中 7 本の接続が残りました。これはプロジェクトのドキュメントにある「CM5:未配線 8 → 7」という改善とぴったり一致します。残った 1 件の違反は、ロードした設計内の 2 つの固定アイテム間に元から存在していたものです。
結果を変えずに高速化する
移植が正しく動くようになってから、高速化に取りかかりました。ルールは単純です。どのステップも結果を変えてはならない。 ステップごとに、すべてのテスト、10 枚の基板でのフルパイプライン、そして並列オプティマイザーが 1 スレッドでも 8 スレッドでも同じ結果を出すことを確認しました。FASTROUTE_VERIFY_CACHES=1 を付けると、メモ化やインデックス化されたすべての結果を従来の方法でも計算して比較します。主なものは次の通りです。
- 接触リストのメモ化。 アイテムリポジトリと探索木の内容の「エポック」をキーにキャッシュします。CM5:22.7 → 13.7 秒、ファンアウトの段階だけで 18.9 → 1.8 秒。
- 探索木のレイヤーマスク。 各リーフは自分のレイヤーのビットを、内部ノードはその和集合を持ちます。ほかのレイヤーに関心のないクエリは、部分木をまるごとスキップします。CM5:13.4 → 10.5 秒。
- 二次空間インデックス。 リーフの範囲に対してレイヤーごとの階層グリッドを持ちます。Java のソート済みの結果は正確に保たれます。
- 幾何演算でのコピー不要な交差判定、shove チェックにおける O(n²) の解消、そして mimalloc アロケーター。
- 並列オプティマイザーのストリーミング: 候補は順番にスレッドへ配られ、結果は厳密に候補の順序で消費されるため、結果はスレッド数に依存しません。
- プロファイルガイド最適化(PGO): 自前の基板で学習させたビルドで、さらに 13–18 % 高速化。
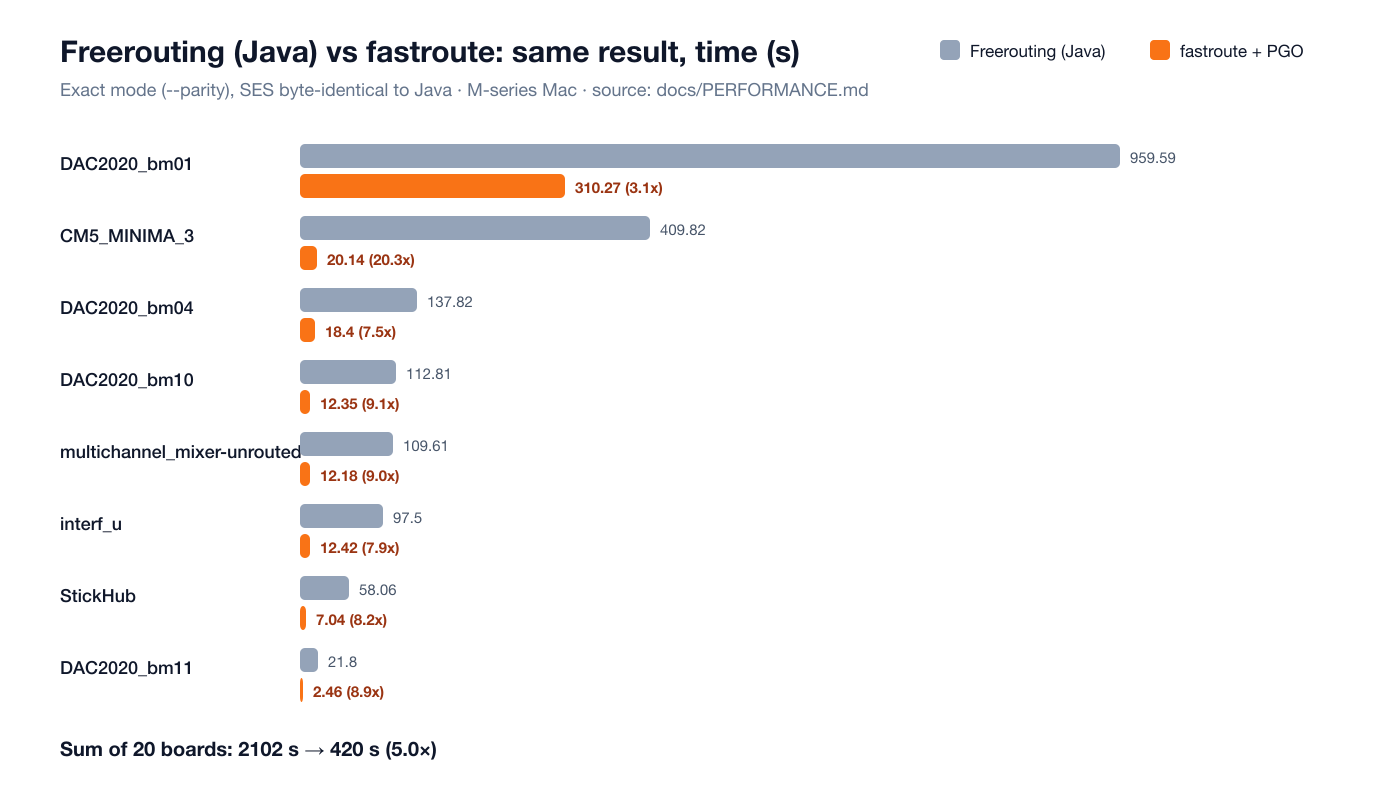
プロジェクト自身の測定(M シリーズの Mac、厳密モード、JVM の起動時間を含む)では、20 枚の基板の合計が 2,102 秒から 420 秒になり、約 5 倍です。基板ごとの高速化は 3 倍から 60 倍の範囲です。interf_u についての私自身の測定は次の通りです。
| 時間 | ピークメモリ | 結果 | |
|---|---|---|---|
| Freerouting(Java)、プロジェクト内のリファレンス | 97.5 秒 | 1,417 MB | 未配線 0、違反 0 |
fastroute 0.1.13、--parity | 12.6 秒 | 166 MB | SES が Java とバイト単位で同一 |
| fastroute 0.1.13、デフォルト(並列) | 3.3 秒 | 449 MB | 未配線 0、違反 0 |
デフォルトモードでは、オプティマイザーを並列に実行します。その結果は Java と同一ではありませんが、スレッド数にかかわらず決定論的です。並列モードのメモリにも個別に手を入れました。以前は基板のコピーが 37 MB のディープコピーでした。アイテムと木のノードを、書き込み時にコピーされる 64 個単位のチャンク(CowVec)に分割し、今ではコピーのコストは 1–3 MB です。874 部品、6 層のテスト基板では、ピークメモリが 2,593 MB から 1,103 MB に減りました。
修正したバグ
忠実な移植の嬉しい副作用は、Java コードのバグがはっきりと見えるようになることです。これらはデフォルトで修正されています(--parity は Freerouting の挙動を正確に保ちます)。そのいくつかを挙げます。
| Freerouting では | fastroute では |
|---|---|
| オートルーターが自分で停止すると停止リクエストがセットされたまま残り、オプティマイザーの候補がすべて失敗して、オプティマイザーが事実上まったく実行されない | オプティマイザーの前に、ルーター自身による停止を取り消す |
| 停滞ルールでオートルーターが止まると最後のテール除去がスキップされ、使われないファンアウトのエスケープ(ビア + スタブ)が基板に残る | どの場合でもテールを除去する |
| オプティマイザーのスコアが 0 でクランプされるため、スコアが 0 未満の基板(例:DAC2020_bm01)ではどの候補も採用されない | クランプしないスコアで比較する(bm01:−182 → 107) |
| 自ネットのプレーン層へのビアで終わる接続が拒否される | そのような接続を受け入れる(4 層の ESP32-S3 基板で未配線 24 → 0) |
| 2 回目以降の失敗では、失敗した接続が毎回ネット全体を引き剥がし、大きなネット(GND、3V3)が振動する | ネットの引き剥がしは 1 回だけ |
| 基板の縁上または外側にパッドを持つネットの配線は外形を完全に無視し、基板の外を走ることがある | 外形の外側はキープアウトとし、そのパッドのすぐ周りだけを例外にする |
| DSN レキサーが非 ASCII 文字を落とし、一部の引用符付き文字列で同期を失う | 正しくパースする |
より良いルーター
バグ以外にも、ルーティングと最適化を改良しました。
- オートルーティングパスの並列化。 Freerouting は 1 つのパス内の接続を 1 本ずつ順に配線します。fastroute はスレッドごとに同時に最大 2 本の接続を扱い、それぞれその接続の開始時点での基板のコピー上で作業し、結果を開始順にコミットします。874 部品のテスト基板では、8 スレッドでルーティング段階が 1,413 秒から 508 秒になりました。
- マルチスタート(
--multi-start)。 接続が残った場合、順序をシャッフルしてルーターを並列に再実行し、最良の結果を残します(bm05:未配線 7 → 2、StickHub:3 → 1)。 - 悪いパスの取り消し。 それまでの最良のパスよりはるかに悪い結果で終わったパスは取り消します。Java は悪いほうの基板からそのまま続けていました。
- 部分的に配線された基板でのオプティマイザー(Freerouting は接続が 1 本でも残っているとオプティマイザーをスキップします)と、パスごとに最良の候補 1 つだけでなく、改善をもたらすほかの候補も適用する貪欲なパス。
- チェックポイントと時間制限。 セッションファイルには常にその時点での最良の基板が保存されます。
--max-time、Ctrl+C、SIGTERM で実行を止めても結果は残ります。 - 診断。
--reportは、未配線の接続と違反をすべて含む JSON サマリーを書き出します。--diagnoseは未配線の各接続を単独でもう一度配線し、原因を分類します。ほかの配線が邪魔をしているのか(混雑)、それとも幾何形状やルールのせいなのか(ブロック)。
長さ合わせ
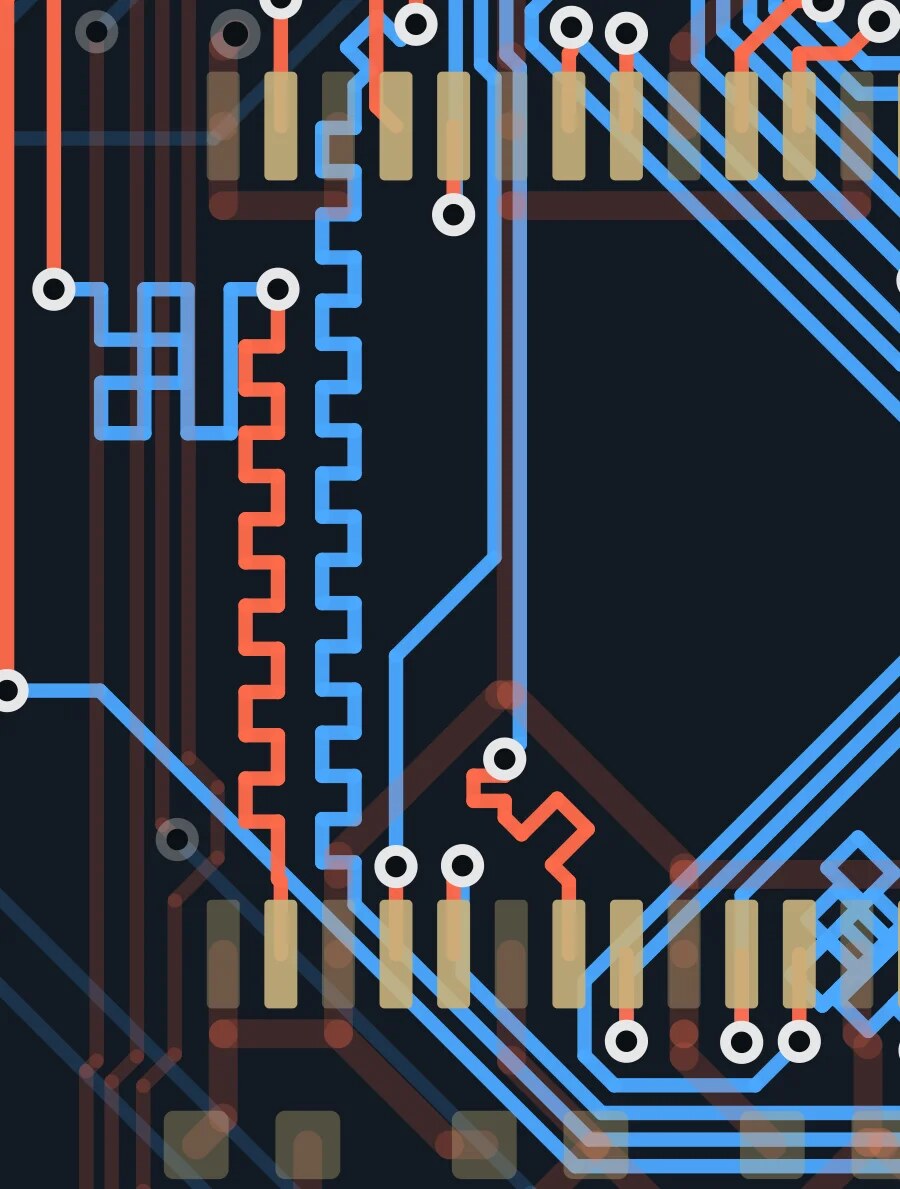
Freerouting には長さ合わせがありません。fastroute は配線と最適化の後で、ネットのグループ(たとえばメモリバス)の長さを揃えられます。目標はグループ内で最も長いネットか、指定した長さです。短いほうのネットの最も長い直線セグメントに、サーペンタインのミアンダを追加します。ミアンダはそれぞれ基板のコピー上で試し、少し太めのプローブ配線でクリアランス違反がない場合にだけ残すので、KiCad の DRC でも結果はクリーンなままです。KiCad と同じく、ビアが貫通するスタックアップの高さも長さに加算します。
差動ペア
Freerouting はペアの 2 本のネットを独立に配線するので、並んで走ることはめったにありません。--pairs を付けると、fastroute は空の基板上でまずペアを配線し、一方のネットがペアギャップを保ってもう一方に沿うようにします。リードネットの配線をつなげて横方向にオフセットし、オフセットした経路を 0.2 mm 単位でクリアランスチェックし、空いている部分をフォロワーの配線にし、迷路ルーターでそれらをピンにつなぎます。この変更は、接続が 1 本も失われず、「結合長 − 0.5 × 長さの差」というスコアが改善する場合にだけ残します。最後に、2 本の長さが許容範囲内に収まるまで、短いほうのネットにミアンダを追加します。
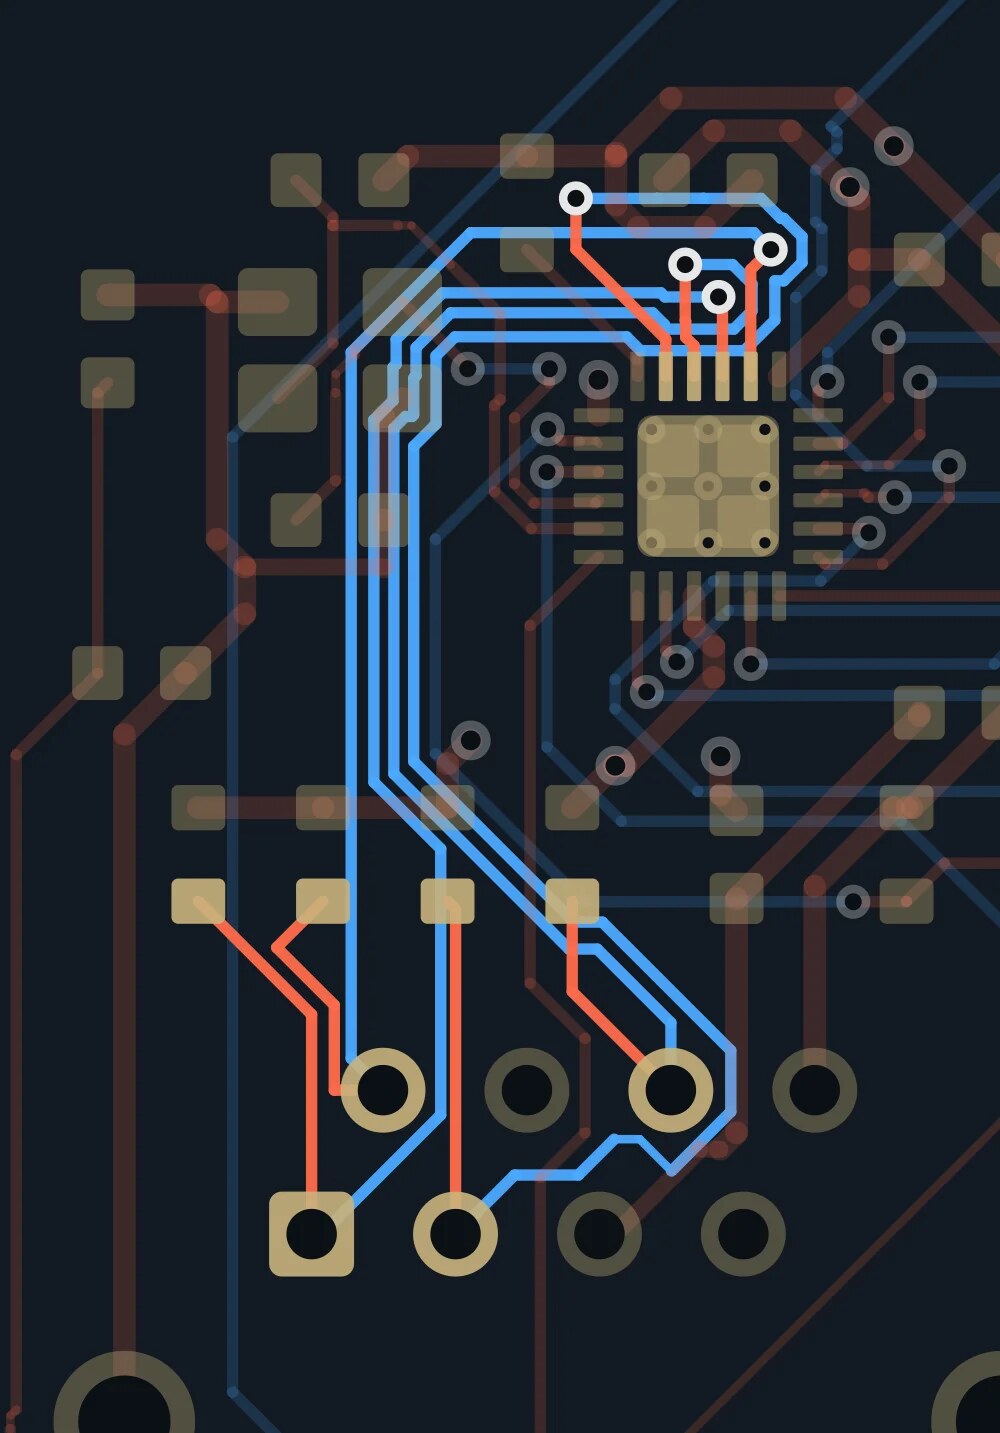
プロジェクトの STM32H7 テスト基板(4 層、USB と 2 組の Ethernet ペア)では、ペア内のスキューが 1.8 / 2.7 / 14.5 mm から 0.1 / 0.25 / 0.25 mm になり、未配線の接続も KiCad の DRC エラーも残りませんでした。
インピーダンス制御
Freerouting はネットクラスとレイヤーごとに 1 つの配線幅しか持たず、インピーダンスについては何も知りません。fastroute の KiCad プラグインにある impedance_cli.py は、基板のスタックアップから配線幅を計算します。外層はマイクロストリップ(Hammerstad–Jensen に Wadell の厚み補正)、内層はストリップライン(Wheeler)として計算し、差動ペアには IPC-2141 の結合項を加えます。幅は KiCad の DRC がチェックする .kicad_dru のルールに書き込まれます。ルーターは、そうしたクラスについては、幅を崩してしまうピンでのネックダウンをオフにします。テスト基板では、50 Ω クラスの 30 件の幅エラーがゼロになりました。
KiCad プラグイン
プラグインは基板をエクスポートし、KiCad の Specctra エクスポートの抜けを補い、ルーターを実行して結果をインポートします。これには、最初に思ったよりはるかに多くの細かい作業が必要です。
.kicad_druのルールを引き継ぎます。クラス間のクリアランス、レイヤーごとのトラック幅、長さとスキューのルール、差動ペアのギャップ、さらに最小トラック幅と銅箔から基板端までのクリアランスもです。- KiCad はすべてのゾーンをプレーンとして、すべてのルールエリアをキープアウトとしてエクスポートします。プラグインはこれを修正し、配線後にゾーンを再充填します。何も禁止していないルールエリアがチャネル全体を塞いでいたため、multichannel_mixer デモでは Freerouting が 160 本の接続を未配線のまま残していましたが、プラグインを使うとゼロになります。
- 銅箔上のテキスト、穴のクリアランスルール、ネットのないパッドのローカルクリアランスはキープアウトになり、ゾーンのステッチングビアは保持されます。
- 結果は KiCad 自身の DRC でチェックします。KiCad のデモで一から再配線した結果は次の通りです。
| 基板 | 素の Freerouting フロー(未接続 / 違反) | fastroute プラグイン(未接続 / 違反) |
|---|---|---|
| complex_hierarchy | 83 / 3 | 0 / 0 (0.7 s) |
| interf_u | 8 / 346 | 0 / 2 (5.6 s) |
| pic_programmer | 0 / 118 | 0 / 0 (0.7 s) |
| ecc83-pp | 0 / 6 | 0 / 0 (0.3 s) |
| sonde xilinx | 1 / 122 | 0 / 36 (0.4 s) |
残った違反(基板端に近いパッド、サーマルスポーク)は、元の設計にも存在するものです。
fastroute で配線した基板
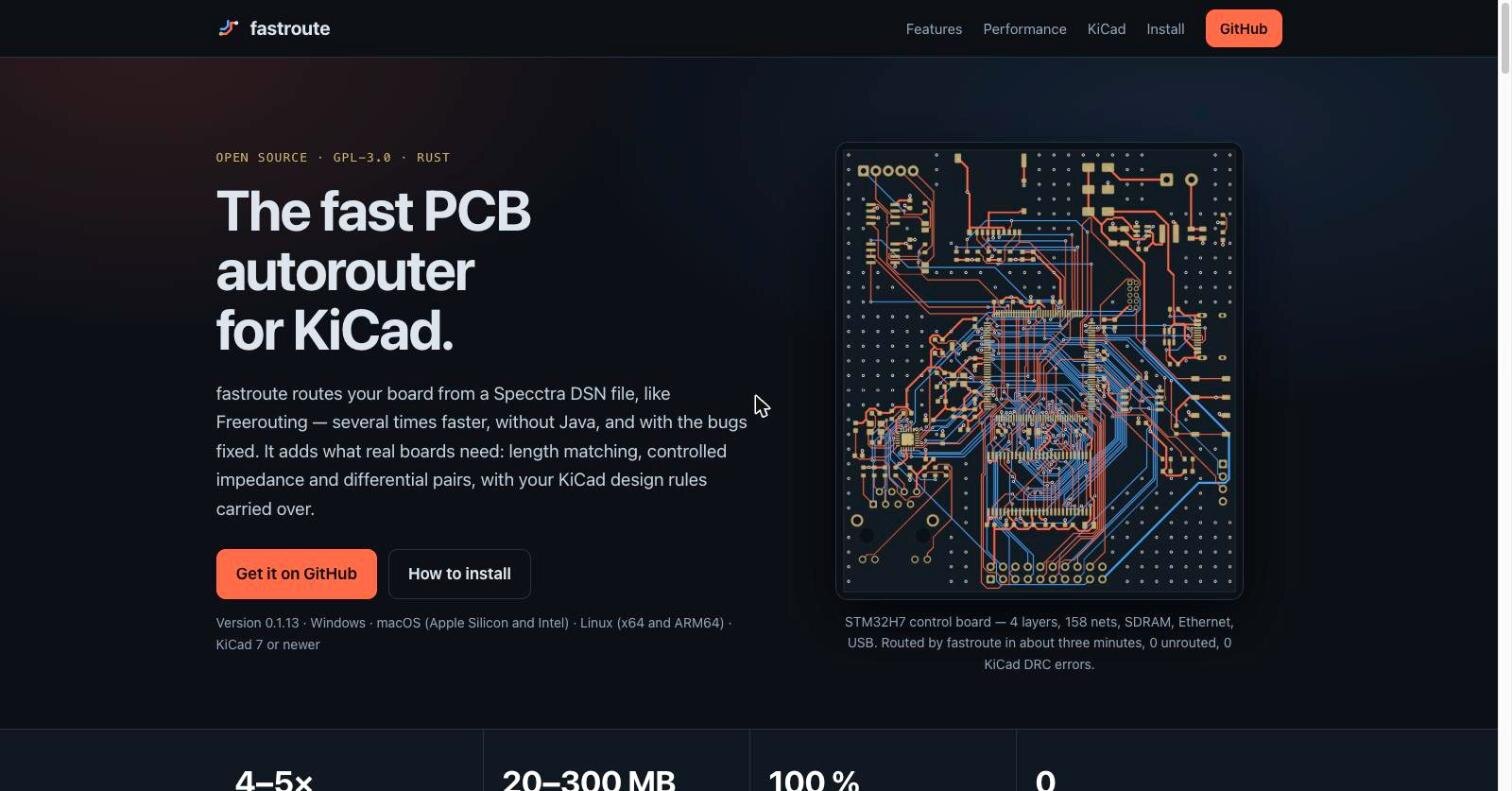
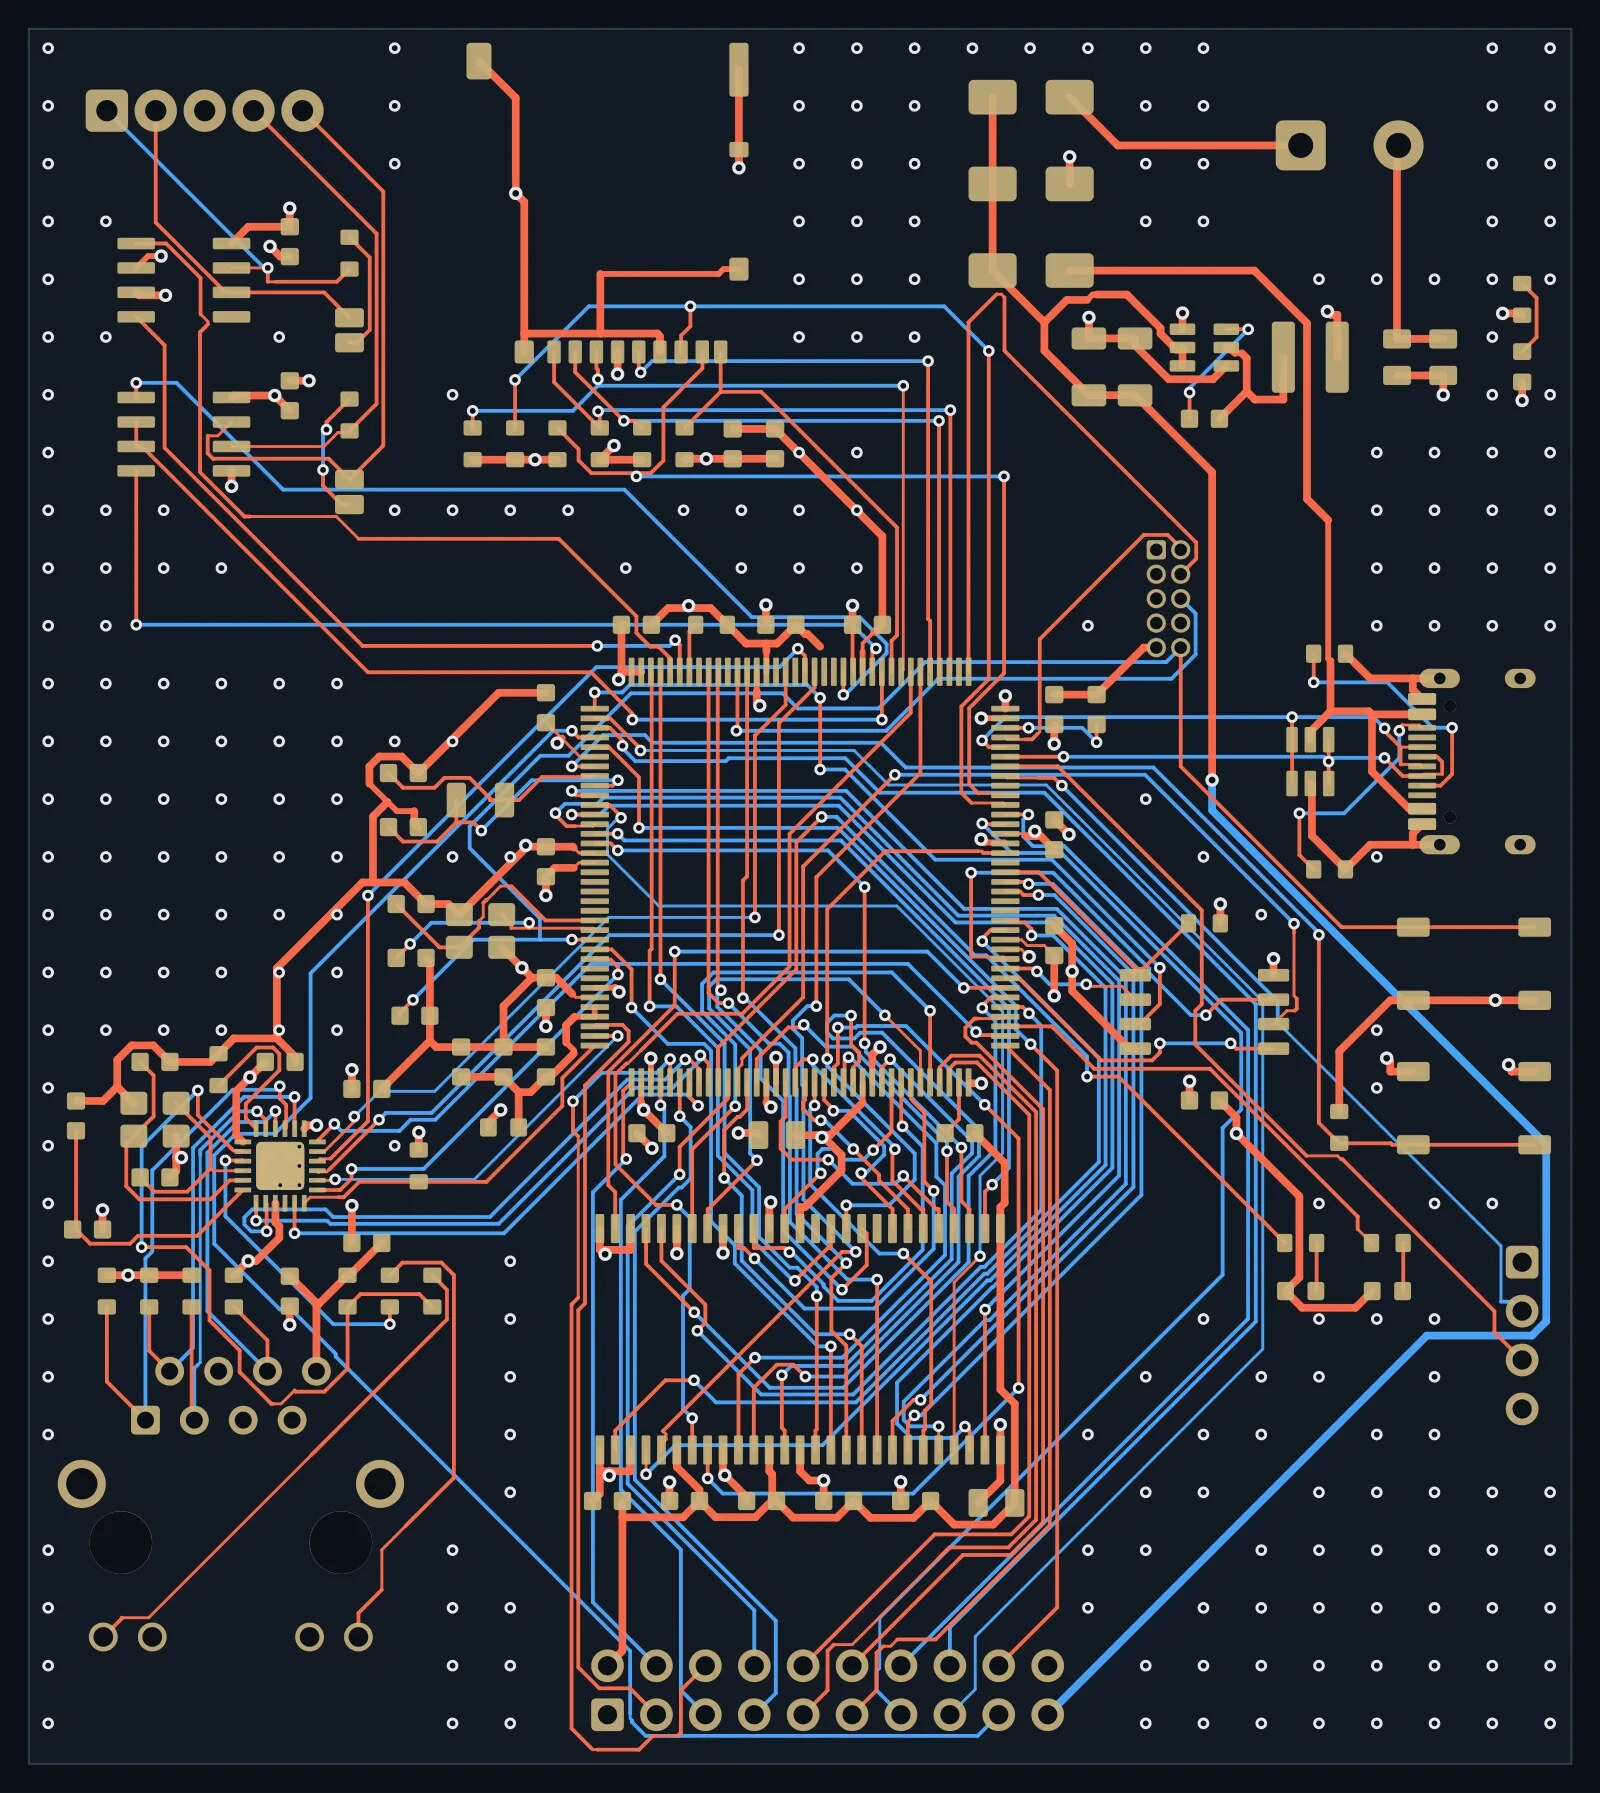
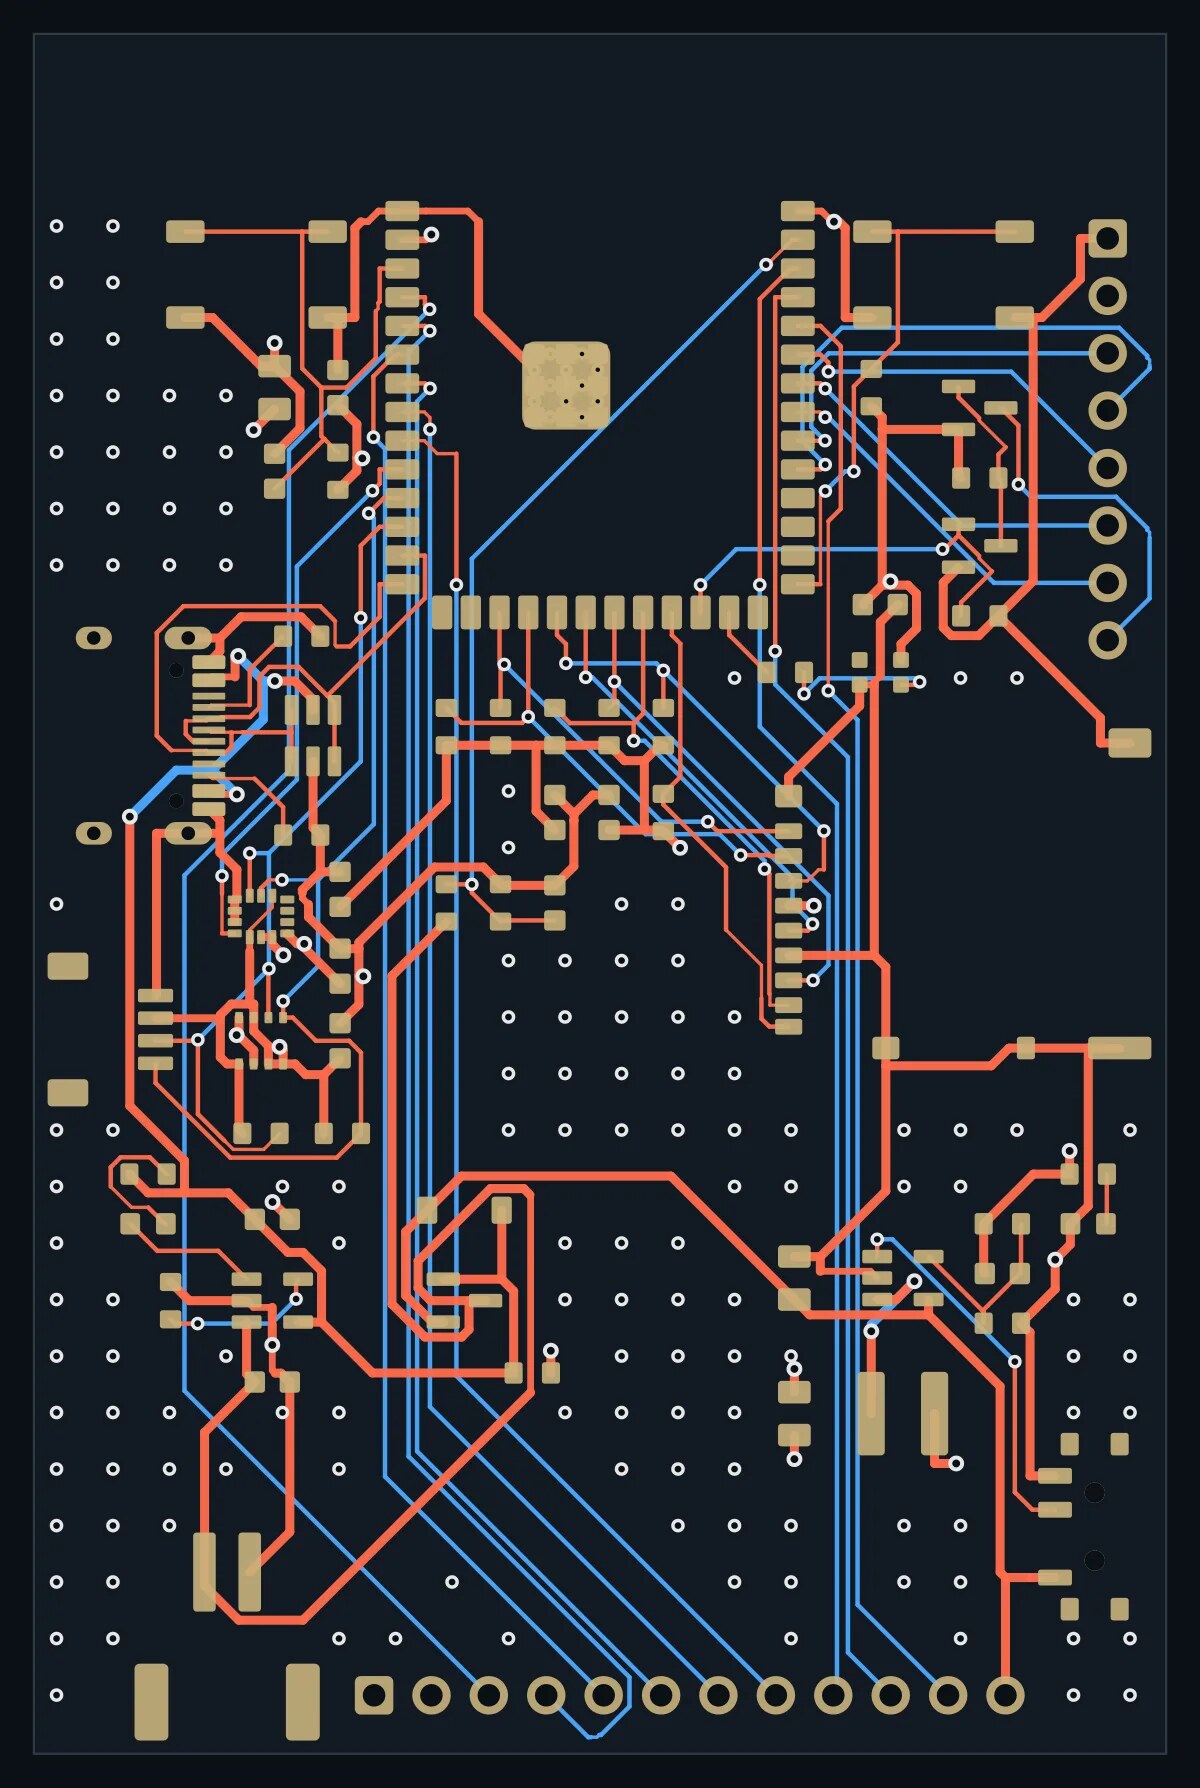
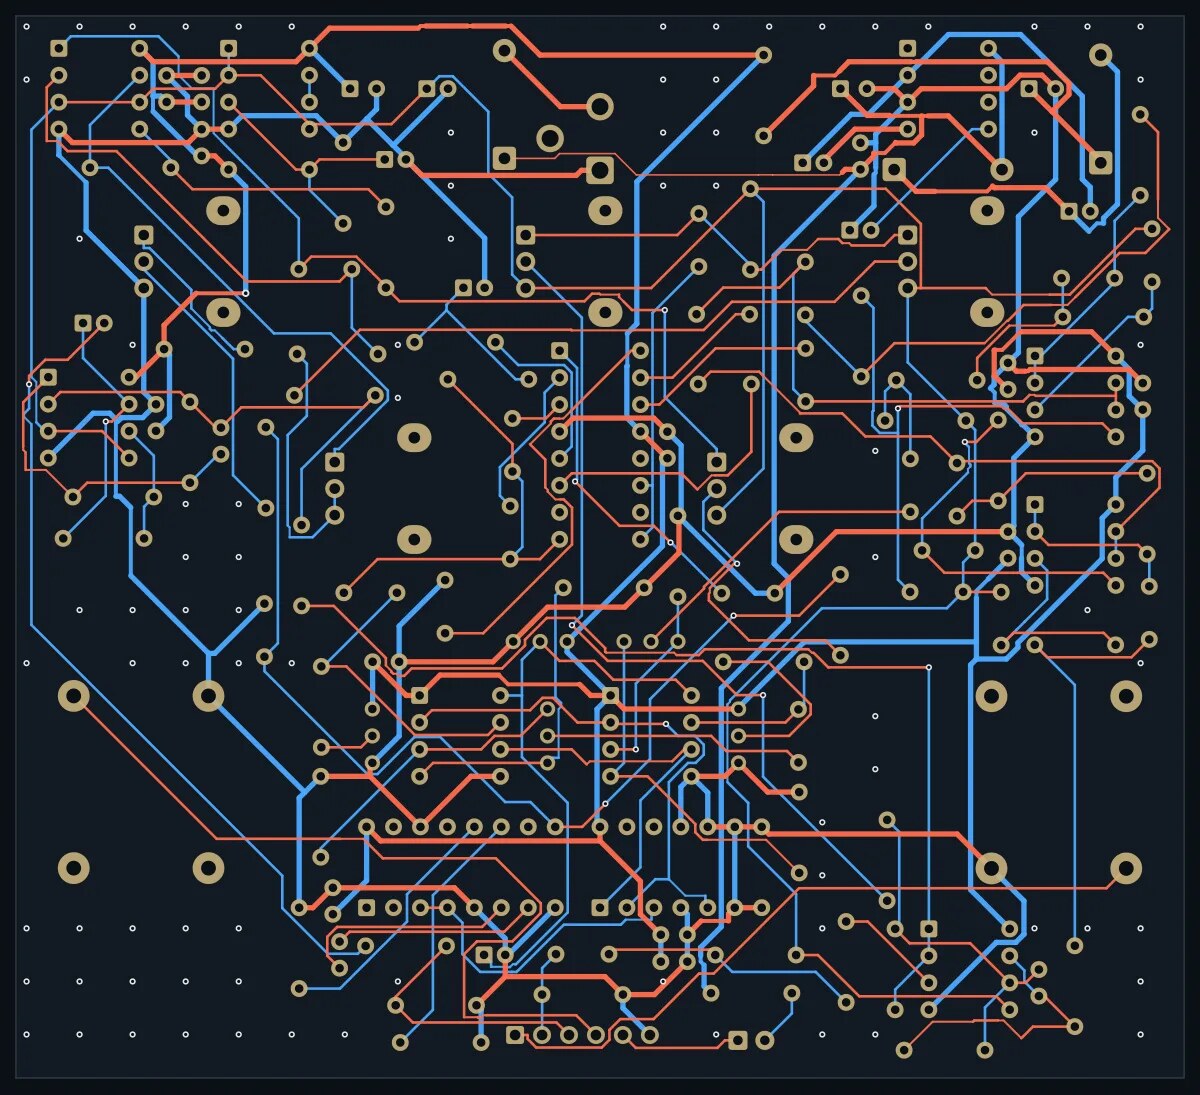
サイトにある例の基板は、すべて fastroute で配線したものです。STM32H7 制御基板(4 層、158 ネット、SDRAM、Ethernet、USB)は約 3 分で配線でき、未配線の接続も KiCad の DRC エラーもゼロでした。
インストール
KiCad 7 以降向けのプラグインパッケージは、GitHub のリリースページにあります。KiCad のプラグイン&コンテンツマネージャーの「ファイルからインストール」でインストールできます。Windows、macOS(Apple Silicon と Intel)、Linux(x64 と ARM64)のバイナリがパッケージに含まれていて、Java は不要です。fastroute はコマンドラインから単体でも、任意の Specctra DSN ファイルに対して実行できます。
# route, write the result to board.ses
fastroute -de board.dsn -do board.ses

# stop after 10 minutes, keep the best result
fastroute -de board.dsn -do board.ses --max-time=600

# watch it route in the browser
fastroute -de board.dsn -do board.ses --live

# exactly Freerouting's result
fastroute -de board.dsn -do board.ses --parity
Freerouting のオプション(-mp、--router.*)はこれまで通り使えます。ソースからビルドするには cargo build --release -p fastroute で十分です。scripts/build-pgo.sh を使うと、約 15 % 速いビルドができます。
まとめ
fastroute で改めて実感したことがあります。大きなソフトウェアを移植するとき、いちばん価値のある道具は、正しさを測る明確な基準です。「Java とバイト単位で同一」という目標は作業を難しくしました。Java の乱数生成器から TreeMap のバランシング規則まで、あらゆるものをエミュレートしなければなりませんでした。しかしその目標のおかげで、高速化のたびに結果が壊れていないことを証明でき、見つかったバグを「移植のバグか、それとも Freerouting 自身のバグか」と切り分けることができました。こうして生まれたのが、同じ基板を Java なしで、はるかに少ないメモリで 5 倍速く配線し、さらに実際の基板に必要な機能を加えたツールです。
fastroute は GPL-3.0-or-later のフリーソフトウェアで、Freerouting の派生物です。ルーティングアルゴリズムの功績は Freerouting の作者たちにあります。私は空き時間に開発しています。役に立ったら、GitHub Sponsors や Open Collective で支援していただけると嬉しいです。問題が再現する基板を添えたバグ報告も同じくらい歓迎します(.dsn ファイルがあれば十分です)。ご質問は X または LinkedIn でお気軽にどうぞ。