OxiDB の全文検索とベクトル検索
OxiDB の検索レイヤー:BM25 ランキング、18 言語の Snowball ステミングとトルコ語の例、ハイライト付きスニペット、PDF/DOCX/XLSX 内の検索、mmap される転置インデックス、HNSW による k-NN と実測の recall。
ドキュメントを OxiDB に入れたら、フィールドの等値比較以外の方法でも見つけたくなります。中に含まれる単語で探したり、意味の似ている別のドキュメントを探したりです。私はそのために別途 Elasticsearch クラスタやベクトルデータベースを用意する必要があるのは嫌だったので、両方を同じプロセスに組み込みました。OxiDB の全文検索には、BM25 によるランキング、Snowball によるステミング、<mark> でハイライトされたスニペット、PDF・DOCX・XLSX からのテキスト抽出があります。ベクトル検索は cosine、ユークリッド距離、内積による k-NN を行い、小さなコレクションでは厳密にスキャンし、大きなコレクションでは HNSW に切り替えます。この記事では、両方の使い方、内部の仕組み、そして足りないところを、実際のセッションを使って順に見ていきます。ここに示す出力はすべて、この記事のために自分のマシン(Apple M4、ローカル)で動かした OxiDB 0.44.2 サーバーから得たものです。
これはシリーズの 2 本目の記事です。ドキュメントモデル、クエリ言語、インデックスの種類はドキュメントエンジンの記事で扱っているので、ここではその上に構築された検索レイヤーに焦点を当てます。
2 種類の検索、一つのプロセス
OxiDB で「検索」と言うと、二つの異なるものを指します。
| 全文検索 | ベクトル検索 | |
|---|---|---|
| 見つけるもの | クエリの単語(語幹に還元したもの)を含むドキュメント | クエリベクトルに最も近い k 個のベクトル |
| インデックス | create_text_index(コレクション)、自動(blob/ファイル) | create_vector_index |
| ランキング | BM25(_score) | 距離(_distance)と 0-1 の類似度(_similarity) |
| コマンド | text_search、search | vector_search |
| ディスク上 | .mtidx(mmap される転置インデックス) | 0.44.2 では永続化されない(後述) |
全文検索自体にも二つの顔があります。コレクションのドキュメントでは、create_text_index で選んだ文字列フィールドがインデックス化され、text_search で検索されます。blob ストア(S3 互換のオブジェクトストア)に置いたファイルは、コンテンツタイプに応じてテキストに変換され、別のグローバルインデックスに入り、search で検索されます。どちらも同じトークナイザと同じ BM25 のコードを使います。
検索を有効にするフラグはありません。ドキュメントエンジンが動いていれば(デフォルト)、検索コマンドが使えます。言語と BM25 の設定は環境変数です。この記事のために、トルコ語のステミングを使うサーバーと英語を使うサーバーの 2 台を動かしました。
OXIDB_ADDR=127.0.0.1:15200 OXIDB_DATA=./data-tr OXIDB_FTS_LANG=tr \
OXIDB_S3_PORT=15210 OXIDB_HTTP_PORT=15220 ./oxidb-server
起動時に、サーバーは設定を 1 行で表示します。
FTS: lang=turkish k1=1.2 b=0.75 (BM25)コレクションでの全文検索
インデックスの作成
トルコ語のドキュメントをいくつか挿入し、二つのフィールドにまたがるテキストインデックスを作りました。ネイティブプロトコルは長さプレフィックス付きの JSON で、以下のリクエストはそれを通して送ったもの、レスポンスはサーバーが返したそのままです。
{"cmd": "insert_many", "collection": "yazilar", "docs": [
  {"baslik": "Kütüphanedeki eski kitaplar", "metin": "Kütüphanedeki eski kitaplar yeniden düzenlendi, raflar alfabetik sıraya kondu."},
  {"baslik": "Bir romana dönüş", "metin": "Bu kitabı okumadan önce yazarın ilk romanına bakmanızı öneririm."},
  {"baslik": "Haritada edebiyat", "metin": "Kitaplarda geçen yer adlarını tek tek haritaya döktüm."},
  {"baslik": "Rust ile veritabanı yazmak", "metin": "Kendi veritabanımı yazarken tuttuğum notlar: sayfa yapısı, WAL ve indeksler."},
  {"baslik": "Kahve demlemenin altı yolu", "metin": "French press, V60 ve moka pot ile kahve demlemek üzerine kısa bir rehber."},
  {"baslik": "Çocuklar için masallar", "metin": "Çocuklar için resimli masal kitapları seçerken dikkat ettiğim şeyler."},
  {"baslik": "Veritabanlarında indeks seçimi", "metin": "Veritabanlarında hangi alana indeks koymalı? Seçicilik ve sorgu planı."},
  {"baslik": "Kitapçıda bir öğleden sonra", "metin": "Sahaftan aldığım kitapların listesi ve kısa notlarım."}
]}
{"cmd": "create_text_index", "collection": "yazilar", "fields": ["baslik", "metin"]}
{"cmd": "list_indexes", "collection": "yazilar"}
{"ok": true, "data": [1, 2, 3, 4, 5, 6, 7, 8]}
{"ok": true, "data": "text index created"}
{"ok": true, "data": [{"name": "_text", "index_type": "text", "fields": ["baslik", "metin"], "unique": false}]}既存のドキュメントは、インデックスの作成時にバックフィルされます。テキストインデックスはコレクションごとに一つで、名前は常に _text です。複数のフィールドにまたがることができ、フィールドパスにはドット記法(meta.summary)が使えます。文字列の配列も読み取られ、数値やその他の型はスキップされます。
トルコ語のステミング
最初に確かめたかったのは、トルコ語の接尾辞で検索が壊れないことです。トルコ語は膠着語で、「kitap」(本)は「kitaplar」(本〔複数〕)、「kitaplarda」(本の中で)、「kitabı」(その本を。対格で、p が b に軟音化)になります。どれで検索しても、ほかの形が見つかるべきです。
== kitap ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
0.5500  _id=8  Kitapçıda bir öğleden sonra
0.5276  _id=2  Bir romana dönüş
0.5069  _id=3  Haritada edebiyat
0.5069  _id=6  Çocuklar için masallar

== kitaplar ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
...
== kitaplarda ==
0.6557  _id=1  Kütüphanedeki eski kitaplar
...
三つのクエリはすべて、同じ 5 件のドキュメントをまったく同じスコアで返します。同じ語幹に還元されるからです。「kitabı」の b/p の軟音化は、Snowball のトルコ語ルールが処理します。同じ実験を短くまとめた実行結果:
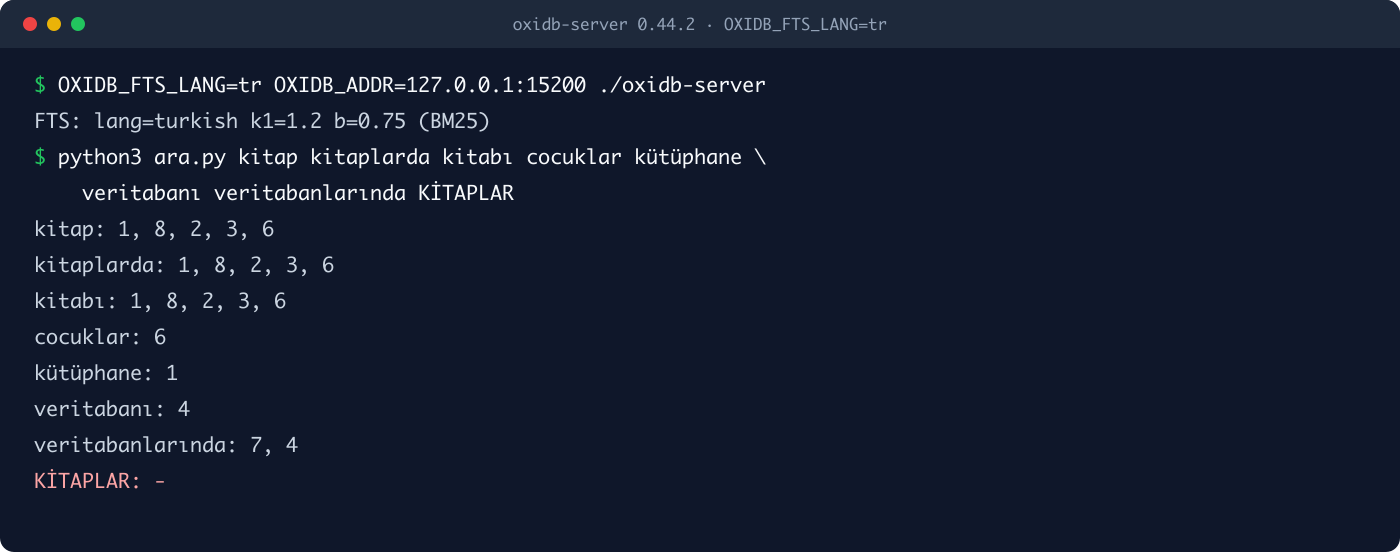
ドキュメント番号は次のとおりです。1「eski kitaplar」、2「Bu kitabı」、3「Kitaplarda geçen」、6「masal kitapları」、8「kitapların listesi」、4「veritabanı, veritabanımı」(データベース、私のデータベース)、7「Veritabanlarında」(データベースにおいて)。
目立つ点が二つあります。トルコ語の文字を使わずに cocuklar と打っても「Çocuklar」(子どもたち)が見つかります。トークナイザがステミングの前にアクセントを取り除くからです(ç→c、ş→s、ğ→g、ı→i、ö→o、ü→u)。トルコ語キーボードを持たないユーザーにとってはうれしい副作用です。同じセッションは、この選択のコストも示しています。これについては制限事項のところで改めて触れます。
クエリの解釈
text_search はクエリの語を OR で結合します。どれか一つの語に一致するドキュメントは結果に含まれ、より多くの語に一致するドキュメントほどスコアが高くなります。eski kitaplar(「古い本」)で検索すると、「eski」を含む唯一のドキュメントが一番上に来て、「kitap」だけを含むものがその後に並びます。
== eski kitaplar == 1:3.041; 8:0.550; 2:0.528; 3:0.507; 6:0.507引用符によるフレーズ検索、AND/NOT 演算子、フィールドごとのブーストはありません。意図的にシンプルにしています。クエリはドキュメントと同じトークナイザを通り、語ごとの寄与が合計されます。同点は _id で決まります。これは後から追加したもので、同点がハッシュマップの反復順で出てきていたころは、ページネーションが実行のたびに違うページを返していました。
ハイライトされたスニペット:<mark>
highlight を渡すと、各結果は、インデックス化された各文字列フィールドから取った <mark> タグ付きの短いスニペットを持つようになります。同じトークナイザを使うので、kitaplar のクエリで kitabı もマークされます。今回は素の curl で REST インターフェースを使いました。
curl -s -X POST http://127.0.0.1:15220/api/yazilar/text_search \
  -H 'Content-Type: application/json' \
  -d '{"query":"çocuk kitapları","limit":2,"highlight":{"snippet_chars":50,"max_snippets":1}}'
[
{
"_id": 6,
"_version": 1,
"baslik": "Çocuklar için masallar",
"metin": "Çocuklar için resimli masal kitapları seçerken dikkat ettiğim şeyler.",
"_score": 3.0199245077882484,
"_highlights": {
"baslik": ["<mark>Çocuklar</mark> için masallar"],
"metin": ["<mark>Çocuklar</mark> için resimli masal <mark>kitapları</mark> seçerken dikkat ettiği"]
}
},
{
"_id": 1,
"_version": 1,
"baslik": "Kütüphanedeki eski kitaplar",
"metin": "Kütüphanedeki eski kitaplar yeniden düzenlendi, raflar alfabetik sıraya kondu.",
"_score": 0.6557111258304198,
"_highlights": {
"baslik": ["Kütüphanedeki eski <mark>kitaplar</mark>"],
"metin": ["Kütüphanedeki eski <mark>kitaplar</mark> yeniden düzenlendi, raf"]
}
}
]highlight: true ならデフォルト(80 文字、最大 3 スニペット)が使われ、オブジェクトを渡せば snippet_chars と max_snippets を指定できます。スニペットは一致の密度順に並びます。切り取り位置は UTF-8 の文字境界にそろえます。Rust の文字列をトルコ語の文字の途中で切ると panic になるので、これはトルコ語のテキストで特にテストしています。タグはライブラリのレベルで変更でき(highlight_with_tags)、サーバーは <mark> を使います。ハイライトはすべての結果のテキストを再トークン化するのでタダではありません。リクエストされたときだけ行い、フィールドごとに先頭の最大 256 KB だけをスキャンします(OXIDB_FTS_MAX_HIGHLIGHT_BYTES)。
更新と削除はすぐに反映される
コレクションのテキストインデックスは書き込み経路の中で更新されるので、update が返った瞬間から、検索は新しいテキストを見ます。
text_search 'moka' -> 5:1.595
>>> {"cmd": "update", "collection": "yazilar", "query": {"_id": 5}, "update": {"$set": {"metin": "Moka pot ile kahve: bir kitaptan öğrendiğim üç püf noktası."}}}
{"ok": true, "data": {"modified": 1}}
text_search 'moka' -> 5:1.210
text_search 'kitap' -> 1:0.430, 8:0.361, 2:0.346, 3:0.332, 6:0.332, 5:0.307
>>> {"cmd": "delete", "collection": "yazilar", "query": {"_id": 5}}
{"ok": true, "data": {"deleted": 1}}
text_search 'moka' ->
ドキュメント 5 が「kitaptan」(「本から」)を含むようになると、kitap の結果に加わり、ほかのすべてのドキュメントのスコアが下がりました。この語を含むドキュメントが増えたので、IDF が下がったのです。削除後、moka は何も返しません。
BM25:スコアはどこから来るのか
最初のバージョンは TF-IDF を使っていました。これには二つ問題がありました。長いドキュメントが長いというだけで勝ってしまうこと、そして単語を 10 回繰り返したドキュメントが 10 倍のスコアを得てしまうことです。0.25.9 で、Lucene/Elasticsearch のデフォルトである k1 = 1.2 と b = 0.75 を使う BM25 に切り替えました。
ある語がドキュメントのスコアに寄与する量:
idf   = ln( (N - df + 0.5) / (df + 0.5) + 1 )
norm  = 1 - b + b * (dl / avgdl)
score = idf * tf * (k1 + 1) / (tf + k1 * norm)
N はドキュメント数、df はその語を含むドキュメントの数、tf はこのドキュメントでの語の出現頻度、dl はドキュメントのトークン数、avgdl はコーパス全体の平均です。複数語のクエリでは寄与が足し合わされます。
挙動を見るために、英語サーバーにわざと三つのドキュメントを用意しました。「raft」に 2 回触れる 8 トークンのメモ、1 回だけ触れる 54 トークンのテキスト、それを 13 回繰り返す 35 トークンのドキュメントです。
== raft ==
1.8004  _id=3  Raft raft raft
1.5453  _id=1  Raft in five minutes
0.5291  _id=2  Notes from a long week of operations
13 回の繰り返しは、2 回よりも 16% 多いスコアしか得られません。これが k1 による飽和です。Python で式からスコアを計算し直したところ(N=8、avgdl=18.5、df=3、idf=0.9445)、小数第 4 位まで一致しました。1.5453、0.5291、1.8004 です。
次に OXIDB_FTS_B=0 でサーバーを再起動し、長さの正規化をオフにしました。
FTS: lang=english k1=1.2 b=0 (BM25)
== raft (b=0) ==
1.9022  _id=3  Raft raft raft
1.2986  _id=1  Raft in five minutes
0.9445  _id=2  Notes from a long week of operations
長いドキュメントは 0.53 から 0.94 に上がり、短いメモは 1.55 から 1.30 に下がりました。再インデックスは不要でした。k1 と b はクエリ時に適用され、インデックスが保存しているのは tf、dl、総トークン数だけだからです。
設定
FTS の設定はすべてプロセス起動時に一度だけ読み込まれてキャッシュされる(OnceLock)ので、変更するには再起動が必要です。
| 変数 | デフォルト | 何をするか |
|---|---|---|
OXIDB_FTS_LANG | english | Snowball の言語:tr、de、fr、es、it、pt、ru、nl、da、fi、hu、no、ro、el、ar、sv、ta、en(18 言語) |
OXIDB_FTS_K1 | 1.2 | 語の出現頻度の飽和(> 0) |
OXIDB_FTS_B | 0.75 | 長さの正規化(0 から 1) |
OXIDB_FTS_SCORE_CAP | 200000 | 1 回の検索でスコアリングする異なるドキュメントの最大数。0 = 無制限 |
OXIDB_FTS_MAX_EXTRACT_BYTES | 4 MB | 1 ファイルから抽出するテキストの最大量。0 = 上限なし |
OXIDB_FTS_MAX_HIGHLIGHT_BYTES | 256 KB | ハイライトがスキャンするテキストの最大量 |
OXIDB_FTS_WORKERS | 1 | ファイルをインデックス化するワーカースレッド数 |
OXIDB_FTS_FLUSH_INTERVAL_MS | 1000 | blob インデックスをディスクに書き出す間隔 |
OXIDB_OCR_LANGS | eng | Tesseract の言語。例:eng+tur(ocr フィーチャー有効時のみ) |
OXIDB_OCR_PREPROCESS | オン | OCR 前のグレースケール化、2 倍拡大、大津の二値化 |
注意点が一つあります。インデックスはステミング済みの語を保存しています。既存データに対して OXIDB_FTS_LANG を変更すると、クエリは新しい言語でステミングされる一方、インデックスには古い言語の語幹が入ったままになります。言語を変えたら、drop_index で _text を削除してインデックスを作り直してください。
ファイルの中を検索する
ファイルが blob ストアに書き込まれると(ネイティブの put_object でも S3 の PUT でも)、サーバーはそれを FTS キューに入れます。ワーカースレッドがファイルを読み、コンテンツタイプに応じてテキストを抽出し、グローバルインデックスに追加します。対応しているタイプ:
| コンテンツタイプ | 方法 |
|---|---|
text/* | そのまま |
text/html、text/xml、application/xml | タグを除去 |
application/json | すべての文字列値を再帰的に収集 |
application/pdf | pdf_extract |
| DOCX | word/document.xml 内のテキスト |
| XLSX | xl/sharedStrings.xml 内のセルのテキスト |
image/png、jpeg、tiff、bmp | Tesseract による OCR。--features ocr でビルドした場合のみ |
六つのファイルで試しました。HTML の会議メモ、XML の商品カタログ、JSON の設定ファイル、macOS の textutil で作った DOCX の契約書草案、XLSX の在庫リスト、cupsfilter で作った PDF の請求書で、内容はすべてトルコ語です。5 つはネイティブプロトコルで入れ、PDF はクライアントライブラリを一切使わず、素の curl で S3 インターフェースから入れました。
curl -s -i -X PUT --data-binary @fatura.pdf -H "Content-Type: application/pdf" \
  http://127.0.0.1:15210/belgeler/fatura.pdf
HTTP/1.1 200 OK
Server: OxiDB-S3
ETag: "a249de4c7ae443472e09ffd73baf6b86"(ここでは S3 の認証をオフにしていたので、署名のない PUT が受け付けられています。S3 側については S3 の記事で詳しく扱っています。)
インデックス化は非同期なので、何が起きたかは fts_status で分かります。キューの深さ、各ワーカーが何をしているか、最近のジョブがどう終わったかです。
{"cmd": "fts_status"}
queue_depth: 0, workers: [{"id": 0, "current": null}]
toplanti.html  indexed  0 ms
katalog.xml    indexed  0 ms
ayarlar.json   indexed  0 ms
sozlesme.docx  indexed  0 ms
stok.xlsx      skipped  "no extractor for content type"
fatura.pdf     indexed  3 ms
(レスポンスは JSON ですが、読みやすいように行に平たくしています。)XLSX はスキップされており、その理由が興味深いものでした。私はこれを Python の openpyxl で作ったのですが、openpyxl はセルのテキストを sharedStrings.xml ではなくインラインで書き込みます。そして OxiDB の抽出器は sharedStrings.xml しか読みません。Excel 自身が保存したファイルは共有文字列テーブルを使うので、実際のファイルの大半は問題ありませんが、ここでの「no extractor for content type」というメッセージは誤解を招きます。抽出器はあり、単にテキストが見つからなかっただけだからです。同じ表を共有文字列テーブル付きでパッケージし直し、S3 経由で同じキーにもう一度アップロードすると、インデックス化されました。上書きすると、古いエントリはインデックスから削除され、新しいエントリが追加されます。
検索:
== kitap ==      ayarlar.json:0.822; stok.xlsx:0.757; toplanti.html:0.612
== depozito ==   sozlesme.docx:1.426
== kahve ==      katalog.xml:1.221; stok.xlsx:1.124
== tedarikçi ==  stok.xlsx:1.682
== faturası ==   fatura.pdf:1.109
search もハイライトに対応していますが、こちらはコストが高めです。インデックスはテキストを保存していないので、ヒットしたファイルごとにファイルを読み直し、テキストを抽出し直します。そのため、リクエストされたときだけ行います。
{"cmd": "search", "query": "kitaplar", "bucket": "belgeler", "limit": 5,
 "highlight": {"snippet_chars": 70, "max_snippets": 1}}
{"ok": true, "data": [
{"bucket": "belgeler", "key": "ayarlar.json", "score": 1.0502388364929411,
"highlights": ["OxiDB demo <mark>Kitap</mark> arşivi için arama ayarları tr e"]},
{"bucket": "belgeler", "key": "toplanti.html", "score": 0.7880432878539266,
"highlights": ["in indeksleme kuyruğu konuşuldu. <mark>Kitapların</mark> PDF sürümleri de aranabilir olac"]}
]}悪意のあるファイルへの防御
テキスト抽出とは、信頼できない入力をパースすることです。DOCX と XLSX は zip アーカイブで、100 KB のアップロードが数ギガバイトに膨らむこともあります。そこで zip のリーダーは、4 MB のテキスト上限の 4 倍に達したところで読み出しをやめ(Read::take)、zip 爆弾が完全に展開されることはありません。PDF ではこれができません。pdf_extract は自分でメモリを管理しているからです。出力を後から切り詰めることはできても、ライブラリ内部のメモリを外から制限することはできず、コードにもそうはっきり書いてあります。抽出器は不正な入力で panic することがあるので、すべてのジョブは catch_unwind の中で実行します。ワーカーが一つしかない構成では、かつては一回の panic で、プロセスが終わるまでファイルのインデックス化が黙って止まっていました。
OCR
画像からのテキスト抽出は、Tesseract と Leptonica のシステムライブラリが必要なので ocr フィーチャーの後ろにあります。画像はまずグレースケールに変換され、2 倍に拡大され、大津の方法で二値化されます。スマートフォンで撮った書類の写真では、これが大きな違いを生みます。リポジトリの Dockerfile はサーバーを --features cluster,ocr でビルドします。私が使ったビルド済みの macOS バイナリには OCR が入っておらず、PNG をアップロードすると、fts_status は正直に skipped: no extractor for content type と報告しました。
内部:転置インデックスの保存方法
トークナイザ
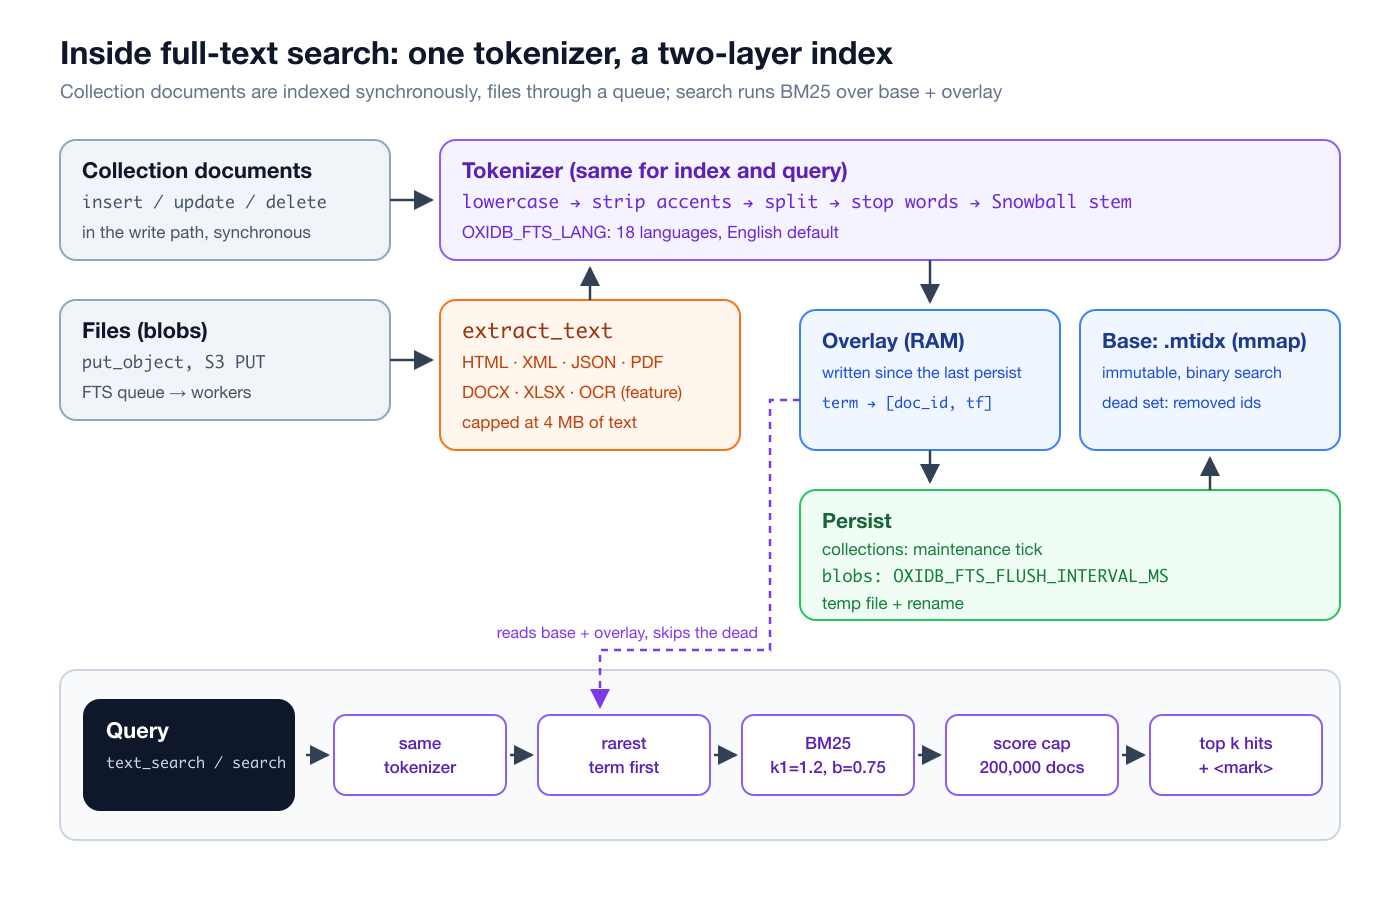
インデックス化とクエリは同じ関数を通ります。小文字化し、アクセントを取り除き、英数字以外の文字で分割し、1 文字の断片とストップワードを捨て、Snowball でステミングします。ストップワードのリストは英語とトルコ語のリストの和集合で、言語設定にかかわらず常に適用されます。
コレクションのインデックス:オーバーレイと mmap されたベース
最初のバージョンでは、コレクションのテキストインデックスは完全に RAM 上にあり、オープンのたびにコレクションをスキャンして再構築していました。プロジェクト自身の測定(examples/fts_mem_bench.rs、それぞれ約 120 バイトのテキストを持つ 100 万ドキュメント)によると、ドキュメント自体が 38 MB なのに対し、このインデックスは 1015 MB を占めていました。まず語を Arc<str> でインターンして 785 MB まで減らし、次にインデックスにディスク上の形式を与えました。
現在のモデルは、フィールドインデックスの .mfidx モデルをポスティングに適用したものです。
- ベース(
<collection>.mtidx):mmap で開かれるイミュータブルなファイル。ヘッダー(OXTIマジック、バージョン、フィールド、総トークン数)、固定ストライドのドキュメントテーブル(doc_id u64, dl u32)、ポスティング(それぞれ 12 バイト:doc_id u64, freq u32)、バイト順にソートされた語のテーブル、語の文字列からなります。ドキュメントの検索も語の検索も、mmap 上で直接行う二分探索です。 - オーバーレイ:最後の永続化以降に書き込まれたドキュメントのための、RAM 上の小さなインデックス。
- デッドセット:ベースは編集できないので、削除されたドキュメントや再インデックスされたドキュメントの ID はセットに入れられ、検索はそれらのベース上のポスティングをスキップします。Lucene の削除済みドキュメントのビットマップと同じ考え方です。
私が実行したときのファイルの先頭バイト:
00000000: 4f58 5449 0100 0000 0200 0500 7469 746c  OXTI........titl
00000010: 6504 0062 6f64 7994 0000 0000 0000 0008 e..body.........永続化は、ドキュメントのスナップショットが取られる定期メンテナンスのタイミングで行われます。ベースとオーバーレイがマージされ、デッドなものが捨てられ、新しいファイルが書き出されます。書き込みは語ごとにストリーミングされます。ファイル内でポスティングは語のテーブルより前にあるので、各語のポスティングはそのままディスクに追記され、メモリで待つのは語彙サイズの語のテーブルだけです。ファイルは一時的な名前で書かれ、rename で所定の位置に移されるので、クラッシュしても以前のファイルが有効なまま残ります。オープン時にファイルがない、短い、または壊れている場合は、コレクションをスキャンしてインデックスを再構築します。クラッシュリカバリで WAL のエントリがリプレイされた場合も同じ再構築が行われます。ディスク上のインデックスはクラッシュ前に書かれたもので、復旧したレコードを知らないからです。
この変更後のプロジェクトの測定では、100 万ドキュメントで常駐インデックスは 0 MB(mmap)、20 万ドキュメントごとに永続化した場合の構築時のピークは 265 MB、よくある語での検索のピークは 7.3 MB で、所要時間は 35 ms です。
私のマシンでは、もっと小さなテストを行いました。それぞれランダムな 12 単語からなる 200,000 ドキュメントで、「coffee」がその半分に、「curtain」が 5% に、「emerald」が 0.1% に含まれています。(このサーバーは前の実験の b=0 のまま動いていましたが、所要時間には影響しません。)
N=200000: insert 2.1s, create_text_index 4.06s
'emerald'          hits(top10)=10  p50=0.11 ms  p95=0.20 ms
'curtain'          hits(top10)=10  p50=1.25 ms  p95=2.42 ms
'coffee'           hits(top10)=10  p50=8.80 ms  p95=11.22 ms
'coffee emerald'   hits(top10)=10  p50=8.81 ms  p95=10.73 ms
時間には Python クライアントの往復時間が含まれています。.mtidx ファイルは 33 MB になりました(12 バイトのポスティングが約 270 万個)。
スコア上限がある理由
term-at-a-time 方式の BM25 は、limit が適用される前に、一致するすべてのドキュメントについてスコアのエントリを保持します。50 万ドキュメントに出現する語なら、1 回の検索でそれだけのエントリになります。プロジェクトの測定では、50 万件の一致で 1 クエリあたり 25 MB、100 万件で 51 MB でした。これに同時検索の数が掛け合わされると OOM になります。今では、1 回の検索でスコアリングする異なるドキュメントは最大 200,000 件です。これを安全にしているのは処理の順序です。語は最も珍しいものから最もありふれたものへの順で処理されるので、珍しく情報量の多い語に一致するドキュメントはすべて予算が埋まる前にスコアリングされ、上限が切り捨てるのは、最もありふれた(最も情報量の少ない)語のリストの末尾です。上限に達した後も、すでにスコアリングされたドキュメントには加算が続きますが、新しいドキュメントは受け入れられません。
blob インデックスとバッチ書き込み
ファイルのインデックスも同じモデル(_fts/index.mtidx)を使いますが、違いが二つあります。ドキュメントは (bucket, key) で名前が付けられるので、ポスティングは 4 バイトの序数を持ち(ポスティングあたり 8 バイト)、各ドキュメントはバケットごとのクォータ計算のために、抽出したテキストのバイトサイズを記録します。最初のバージョンでは、インデックスは単一の index.json で、ドキュメントを一つ追加するたびにファイル全体を書き直していました。一括取り込みでは N² 回のディスク書き込みです。今では、ワーカーはインデックスをダーティとしてマークするだけで、バックグラウンドのフラッシャーが OXIDB_FTS_FLUSH_INTERVAL_MS(デフォルト 1 秒)あたり最大一回だけ書き出します。古い index.json は最初のオープン時に mmap 形式に移行されて削除され、壊れたものは隔離されてインデックスは空から始まります。FTS は派生データであり、起動を妨げてはいけないからです。
ここには一貫性のトレードオフがあります。コレクションのインデックスは書き込み時点で最新ですが、blob インデックスはキューがはけるまで数ミリ秒遅れます。put_object の直後の search は、まだ新しいファイルを見ていないかもしれません。fts_status はまさにそのためにあります。
ベクトル検索
ベクトル検索は、埋め込みをドキュメントの隣に保存し、「このクエリに意味的に最も近いドキュメントはどれか」と問うためのものです。OxiDB は埋め込みを生成しません。ベクトルは(モデルを使って)自分で計算し、数値の配列としてドキュメントのフィールドに保存します。
インデックスとクエリ
この記事では埋め込みモデルは使いませんでした。仕組みを示すために、手書きの 4 次元ベクトルを使っています。各次元は「データベース」「検索」「コーヒー」「本」を表します。
{"cmd": "insert_many", "collection": "articles", "docs": [
  {"title": "B-tree page splits explained",       "emb": [0.9, 0.2, 0.0, 0.1]},
  {"title": "Building an inverted index",         "emb": [0.6, 0.9, 0.0, 0.1]},
  {"title": "BM25 by hand",                       "emb": [0.3, 1.0, 0.0, 0.2]},
  {"title": "HNSW graphs for embeddings",         "emb": [0.5, 0.8, 0.0, 0.0]},
  {"title": "Pour-over coffee ratios",            "emb": [0.0, 0.0, 1.0, 0.1]},
  {"title": "Coffee shops with good bookshelves", "emb": [0.0, 0.1, 0.7, 0.7]},
  {"title": "Second-hand books in Istanbul",      "emb": [0.0, 0.1, 0.1, 1.0]},
  {"title": "Reading list: database internals",   "emb": [0.8, 0.3, 0.0, 0.8]}
]}
{"cmd": "create_vector_index", "collection": "articles", "field": "emb", "dimension": 4, "metric": "cosine"}
{"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": [0.7, 0.7, 0.0, 0.0], "limit": 3}
{"ok": true, "data": [
{"title": "Building an inverted index", "emb": [0.6, 0.9, 0.0, 0.1], "_id": 2, "_version": 1,
"_similarity": 0.9882084, "_distance": 0.023583233},
{"title": "HNSW graphs for embeddings", "emb": [0.5, 0.8, 0.0, 0.0], "_id": 4, "_version": 1,
"_similarity": 0.9871956, "_distance": 0.025608778},
{"title": "BM25 by hand", "emb": [0.3, 1.0, 0.0, 0.2], "_id": 3, "_version": 1,
"_similarity": 0.9323735, "_distance": 0.1352529}
]}「コーヒーと一緒に読む本」のようなクエリベクトル([0, 0, 0.6, 0.8])は、まったく別の隅に着地します。
sim=0.9925  dist=0.0151  Coffee shops with good bookshelves
sim=0.9258  dist=0.1485  Second-hand books in Istanbul
sim=0.8383  dist=0.3234  Pour-over coffee ratios
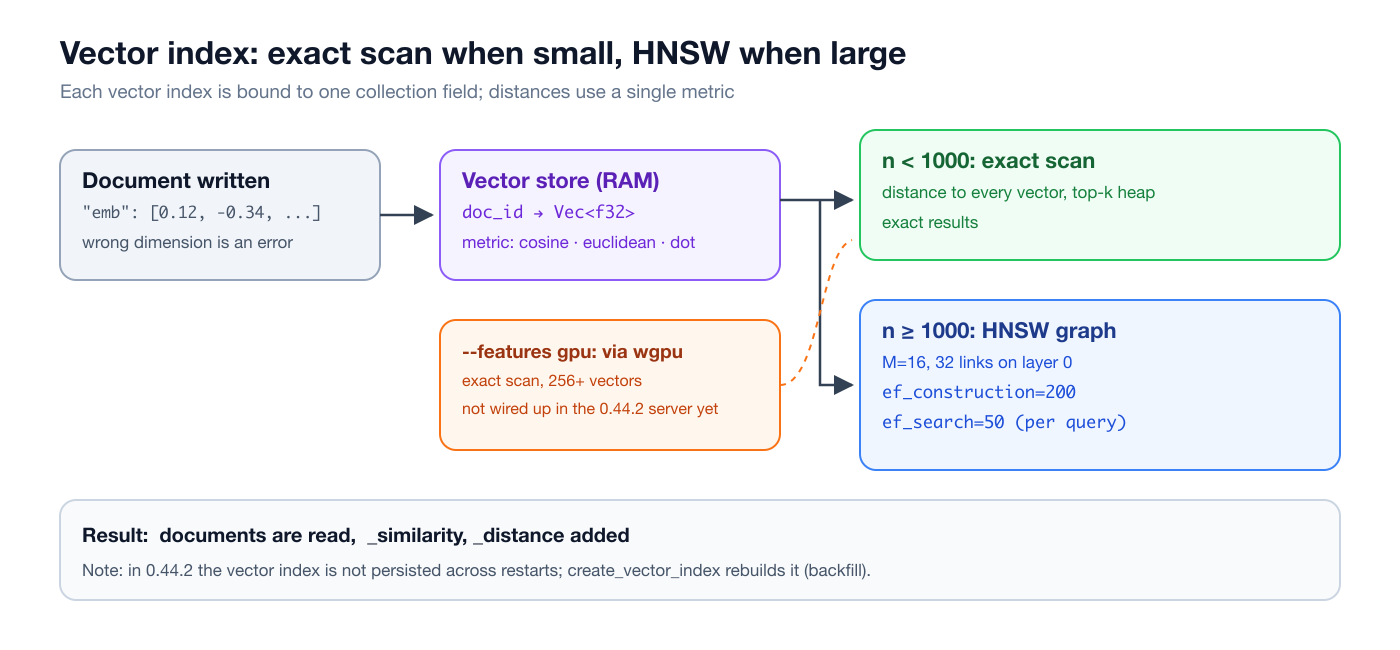
sim=0.7734 dist=0.4532 Reading list: database internalsルールはシンプルです。各ベクトルインデックスは一つのフィールドに結び付けられ(ドット記法も使えます)、コレクションは異なるフィールドに複数のベクトルインデックスを持てます。既存のドキュメントはインデックスの作成時にバックフィルされます。次元の合わないベクトルはエラーになり、フィールドを持たないドキュメントは黙ってスキップされます。結果はドキュメント全体として返り、_distance(小さいほど良い)と _similarity(0 から 1、大きいほど良い)が追加されます。
三つのメトリクス、三つの異なる答え
メトリクスの選択は、結果を本当に変えます。それを示すために、同じ 4 点を三つのフィールドに入れ、それぞれに異なるメトリクスでインデックスを張り、[1, 1] でクエリしました。B は A と同じ方向を向いていますが、長さが 5 倍です。
query = [1.0, 1.0]
-- cosine
   A [1.0, 1.0]   distance=-1.19209e-07 similarity=1.0000
   B [5.0, 5.0]   distance=0           similarity=1.0000
   C [1.2, 0.8]   distance=0.0194193   similarity=0.9903
   D [-1.0, 2.0]  distance=0.683772    similarity=0.6581
-- euclidean
   A [1.0, 1.0]   distance=0           similarity=1.0000
   C [1.2, 0.8]   distance=0.282843    similarity=0.7795
   D [-1.0, 2.0]  distance=2.23607     similarity=0.3090
   B [5.0, 5.0]   distance=5.65685     similarity=0.1502
-- dot_product
   B [5.0, 5.0]   distance=-10         similarity=0.0000
   A [1.0, 1.0]   distance=-2          similarity=0.1192
   C [1.2, 0.8]   distance=-2          similarity=0.1192
D [-1.0, 2.0] distance=-1 similarity=0.2689- cosine(
1 - cos)は方向だけを見ます。A と B は同点です。これがデフォルトで、テキストの埋め込みには正しい選択です。A の-1.19e-07は浮動小数点の丸めです。 - euclidean は実際の距離を見ます。B は最下位に落ちます。
- dot_product(
-a·b)は大きさを評価します。B が 1 位に来ます。正規化されたベクトルでは cosine と同じ順序になり、より安価です。
この表を準備しているときにバグを見つけました。内積では順位は正しいのですが、_similarity が反転しています。最も一致している B の類似度が 0.0000 で、最も一致していない D が 0.2689 です。コードのコメントには「sigmoid(dot)」とありますが、計算しているのは 1 / (1 + e^(-distance)) で、distance はすでに -dot なので、これは sigmoid(-dot) になります。docs/vector-search.md にはさらに別の式((1 + d) / 2)が書かれています。私が修正するまでは、内積では _distance を使ってください。list_indexes はメトリクスを dotproduct と表示します。リクエストは dot_product と dotproduct の両方を受け付け、認識できないメトリクス名は黙って cosine にフォールバックします。
厳密スキャンか HNSW か
インデックスのベクトルが 1000 個未満の間は、各クエリがすべてのベクトルとの距離を計算し、最も近い k 個をヒープに保持します。結果は厳密です。1000 個に達すると HNSW(Hierarchical Navigable Small World)グラフが構築され、以降の挿入はそこにインクリメンタルに入ります。パラメータは、リンク数 M = 16(レイヤー 0 では 32)、ef_construction = 200 で、ef_search はデフォルトが 50 でリクエストごとに設定できます。ノードを削除すると隣接ノードからのリンクが切られ、ノードの 20% 超が削除されるとグラフが再構築され、数が 500 を下回るとグラフは破棄されて検索は厳密スキャンに戻ります。
ドキュメントには、HNSW について「>95% recall」とあります。私はそれを測ってみたくなりました。50 個の中心の周りにクラスタ化した合成ベクトル(一様なノイズよりも本物の埋め込みに近い)を生成し、200 個のクエリについて numpy で厳密な cosine の結果を計算し、OxiDB が返した上位 10 件と比較しました。
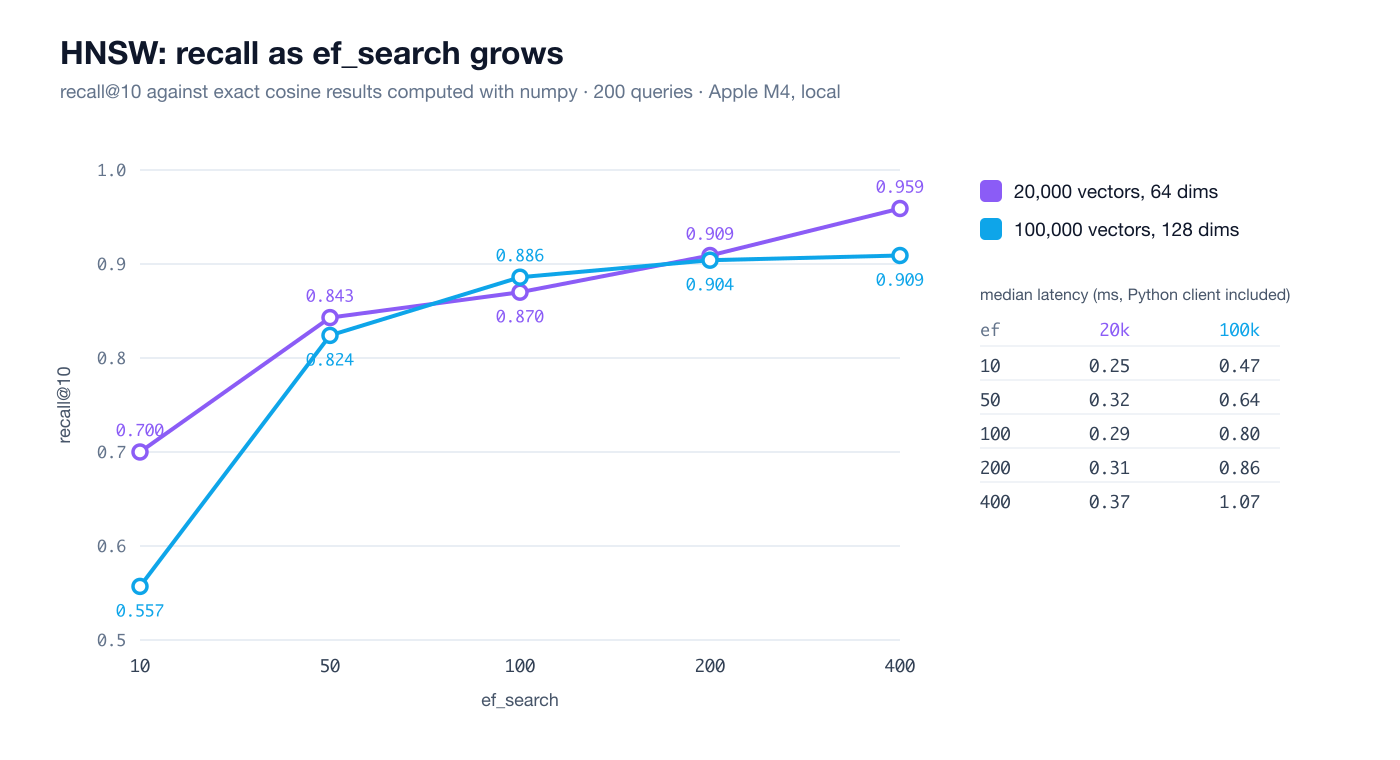
N=20000 D=64: insert 1.03s, create_vector_index 2.28s
ef_search=10   recall@10=0.700  latency p50=0.25 ms  p95=0.35 ms
ef_search=50   recall@10=0.843  latency p50=0.32 ms  p95=0.65 ms
ef_search=100  recall@10=0.870  latency p50=0.29 ms  p95=0.40 ms
ef_search=200  recall@10=0.909  latency p50=0.31 ms  p95=0.39 ms
ef_search=400  recall@10=0.959  latency p50=0.37 ms  p95=0.51 ms

N=100000 D=128: insert 9.92s, create_vector_index 34.45s
ef_search=10   recall@10=0.557  latency p50=0.47 ms  p95=0.54 ms
ef_search=50   recall@10=0.824  latency p50=0.64 ms  p95=0.74 ms
ef_search=100  recall@10=0.886  latency p50=0.80 ms  p95=1.11 ms
ef_search=200  recall@10=0.904  latency p50=0.86 ms  p95=0.97 ms
ef_search=400  recall@10=0.909  latency p50=1.07 ms  p95=1.31 ms
正直な結果を言うと、このデータでは、デフォルトの ef_search=50 で得られる recall は 95% ではなく 82-84% です。20k ベクトルでは ef_search=400 で 96% に達しますが、100k では 91% 前後で頭打ちになります。つまり、そこでの限界は探索の幅ではなくグラフの品質だということです。レイテンシはどちらの場合も 1 ミリ秒前後にとどまります(Python クライアントの往復を含む)。実践的なアドバイスとしては、recall が重要なら ef_search に 200-400 を渡してください。厳密な結果が必要な場合、現時点では 1000 ベクトルを超えると厳密スキャンを強制する方法はありません。その閾値はハードコードされています。900 ベクトルでの対照実験では、予想どおりどの ef_search でも recall は 1.000 でした。
GPU
--features gpu でビルドすると、src/gpu.rs が wgpu を通して WGSL のコンピュートシェーダを実行します。cosine、ユークリッド距離、内積の三つのエントリポイントがあり、ワークグループは 256、保存されたベクトルごとに GPU スレッドが一つずつクエリとの距離を計算し、上位 k 個は CPU が選びます。macOS では Metal、Linux では Vulkan、Windows では DX12 です。設計上は、256 個以上のベクトルの厳密スキャンを GPU に任せます。
ところが、この記事のためにコードを読んでいて気づいたのですが、0.44.2 のサーバーは起動時に GPU を初期化して「GPU compute: enabled」と表示し、ハンドルをエンジンに渡すものの、エンジンはそれをコレクションのベクトルインデックスに決して渡していません(VectorIndex::set_gpu はどこからも呼ばれていません)。つまり、このリリースでは GPU の経路は事実上使われていません。いずれにせよ私が使ったバイナリは GPU フィーチャーなしでビルドされていたので、GPU では何も測定していません。この配線を仕上げることは私の TODO リストに入っています。
永続化:ベクトルインデックスは再起動で失われる
docs/vector-search.md には、インデックスは .vidx ファイルに保存され、起動時に復元されるとあります。これは古い Collection エンジンについては正しい記述です。サーバーが現在使っている B-tree コレクションでは、ベクトルインデックスはインデックスのメタデータにもディスクにも書き込まれません。サーバーを再起動した後:
>>> {"cmd": "list_indexes", "collection": "articles"}
{"ok": true, "data": []}
>>> {"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": [0.7, 0.7, 0, 0], "limit": 2}
{"ok": false, "error": "invalid query: no vector index on field 'emb'; create one with create_vector_index"}
同じ再起動の後、テキストインデックスは .mtidx から即座に戻り、スコアもまったく同じでした。ベクトルはドキュメントの中にあるのでデータは失われません。create_vector_index は冪等で、そこから再構築します。ただ、100k × 128 次元ではそれに 34 秒かかります。アプリケーションの起動時に create_vector_index を呼ぶのが、現時点での実践的な答えです。私は ADR-0003 で、ベクトル検索を 1.0 の安定性の約束の対象外とし、「API とディスク上の形式は変わる可能性がある」と明記しました。この穴は、その決定の具体的な一面です。
ハイブリッドな使い方
キーワード検索とセマンティック検索は、得意なことが違います。BM25 は珍しい固有名詞、製品コード、正確な単語を取りこぼしません。ベクトル検索は類義語や「こういう感じのもの」という問いを捉えます。OxiDB にはこれらを組み合わせる単一のコマンドはありませんが、どちらも同じ _id で同じドキュメントを返すので、クライアント側で融合するのは簡単です。最も頑健な方法は Reciprocal Rank Fusion(RRF)で、スコアのスケールを無視して順位だけを組み合わせます。私が使ったコード:
def hybrid(text, vec, k=5, rrf_k=60):
    t = o.req({"cmd": "text_search", "collection": "articles", "query": text, "limit": 20})["data"]
    v = o.req({"cmd": "vector_search", "collection": "articles", "field": "emb", "vector": vec, "limit": 20})["data"]
    fused, title = {}, {}
    for rank, d in enumerate(t, 1):
        fused[d["_id"]] = fused.get(d["_id"], 0) + 1 / (rrf_k + rank); title[d["_id"]] = d["title"]
    for rank, d in enumerate(v, 1):
        fused[d["_id"]] = fused.get(d["_id"], 0) + 1 / (rrf_k + rank); title[d["_id"]] = d["title"]
    ...

hybrid("coffee", [0.0, 0.1, 0.1, 1.0])
同じ articles コレクションの title にテキストインデックスを追加し、「coffee」という単語と「本」を指すベクトルを一緒に投げてみました。
text   : [('Pour-over coffee ratios', 1.281), ('Coffee shops with good bookshelves', 1.281)]
vector : [('Second-hand books in Istanbul', 1.0), ('Coffee shops with good bookshelves', 0.888), ('Reading list: database internals', 0.851), ('BM25 by hand', 0.64)]
RRF    :
  1. 0.03226  Coffee shops with good bookshelves
  2. 0.03178  Pour-over coffee ratios
  3. 0.01639  Second-hand books in Istanbul
  4. 0.01587  Reading list: database internals
  5. 0.01562  BM25 by hand
「Coffee shops with good bookshelves」は両方のリストに現れ、どちらでも 1 位ではなかったのに、トップに来ています。私が使っているほかのパターン:
- 候補を生成して再ランキング:
text_searchで 100 件の候補を取り、返ってきたドキュメント内の埋め込みとの cosine でクライアント側で並べ直します。ベクトルインデックスはまったく不要です。 - フィルタ付きベクトル検索:
vector_searchもtext_searchもフィルタを受け付けません。多めに取ってきて(limit: 100)クライアント側でフィールドの条件を適用するか、先にfindで許可された_idを取ってきて積集合を取ります。 - ファイルとドキュメント:PDF は blob ストアに置いて
searchで見つけ、各ファイルのメタデータと埋め込みはコレクションに置きます。
ベクトル検索は、モデルが生成した埋め込みから「どのアイテムがこれに似ているか」に答えます。「これを買った人はほかに何を買ったか」は別の問いで、モデルを一切使わず、観測された行動から答えます。そのために別のエンジンを作っており、レコメンドエンジンの記事で扱っています。
制限事項とトレードオフ
Snowball はルールベースで、トルコ語のような膠着語では完璧ではありません。この記事の実験で見たこと:
veritabanıとveritabanlarındaは異なる語幹に還元されます。veritabanıの検索では「Veritabanlarında indeks seçimi」のドキュメントが見つからず、一方でveritabanlarındaではveritabanımıを含むドキュメントが見つかりました。fatura(請求書)では PDF 内の「faturası」が見つからず、faturasıでは見つかりました。demleme(抽出、淹れること)でもdemlemekやdemlemeninは見つかりませんでした。- アクセントはステミングの前に取り除かれます。これは ASCII のクエリには役立ちますが、トルコ語のステマーは
ıとşの代わりにiとsを見ることになり、上の取りこぼしの一部はこれで説明できるかもしれません。 KİTAPLARでは何も見つかりませんでした。Rust のto_lowercaseは、トルコ語の大文字İをiと結合用ドット(U+0307)に変換します。結合用ドットは英数字ではないので、単語が「ki」と「taplar」に分かれてしまいます。これはバグで、修正する予定です。それまでは、クライアント側でトルコ語のルールに従ってクエリを小文字化してください。- ストップワードのリストは英語とトルコ語を合わせたもので、常に適用されます。トルコ語のインデックスで
not(トルコ語で「メモ」)を検索しても何も返りません。「not」は英語のストップワードだからです。
ほかにも、フレーズ検索、あいまい一致、フィールドのブーストはありません。言語はコレクションごとではなくプロセス全体で一つです。blob インデックスは数ミリ秒遅れます。ベクトルインデックスは RAM 上にあり、再起動後に再構築する必要があります。HNSW の recall はデフォルト設定で 95% を下回ります。vector_search はフィルタを受け付けず、Python クライアントの vector_search メソッドはまだ ef_search を渡しません(生のリクエストなら渡せます)。
その見返りとして得られるのは、バイナリ一つ、データのコピー一つ、ドキュメントと一緒に更新されるテキストインデックス、RAM を膨らませないディスクベースのポスティング、そして PDF を curl で S3 に入れて 1 秒以内にその中を検索できることです。ネイティブプロトコルに加えて、コマンドは REST(POST /api/{collection}/text_search。ここでは行レベルの読み取りルールも適用されます)や MCP サーバーのツールとしても使えます。リポジトリには、ドラッグ&ドロップでのアップロード、ドキュメントビューア、ハイライトされた結果を備えた小さな検索 UI が examples/fts-load-tests に、別のデモが examples/fts-demo にあります。
試してみる
ビルド済みのバイナリとリリースノートは GitHub releases ページにあります。Docker イメージは OCR 対応でビルドされています。トルコ語の検索に必要なのはこれだけです。
OXIDB_FTS_LANG=tr ./oxidb-serverあとはコレクションに create_text_index を張り、バケットに PDF をいくつか入れ、text_search と search を使うだけです。埋め込みがあれば create_vector_index でドキュメントの隣に置けますが、再起動後にはその呼び出しを繰り返すのを忘れないでください。シリーズの次の記事では、同じドキュメントに対する地理空間クエリとグラフ探索を扱います:地理空間とグラフのクエリ。