OxiDB のレコメンドエンジン:リアルタイムの共起カウンターと LLR
OxiDB の 4 番目のエンジン oxidb-rec は、バスケットを届いた瞬間にカウンターに変え、「これを買った人はこれも買った」を Dunning の LLR でスコアリングします。時間バケット、LLR の手計算、ディスクレイアウト、1.2 万件の注文での実験。
「この商品を買った人はこんな商品も買っています」は、ショップがデータベースに投げかける最もよくある質問の一つです。そしてこれまで、ほぼすべてのデータベースはこの質問に同じ答え方をしてきました。つまり、まったく答えてこなかったのです。アプリケーションが注文明細を自己結合し、ペアをスコアリングし、その結果をどこかに書き込みます。たいていは夜間バッチジョブで行うので、リストはできた瞬間にもう古くなっています。OxiDB の 4 番目のエンジン oxidb-rec は、まさにこの隙間を埋めるために存在します。これはリアルタイムのアイテム間(item-to-item)レコメンドエンジンで、届いたバスケットをその場でカウンターに変換し、リクエスト時にレコメンドを計算し、Dunning の対数尤度比(LLR)でスコアリングします。この記事では、エンジンを内側から順に見ていきます。データモデル、時間バケット、LLR がデフォルトである理由(手計算の例付き)、ディスク上のレイアウト、ワイヤプロトコル、そして制限事項です。すべての例は、私が実際の OxiDB サーバーに読み込んだ 12,003 件の注文からなる架空の書店データセットから取ったもので、示している数値はすべてそのセッションのものです。
なぜ専用のエンジンなのか?
その理由は ADR-0025 に書かれており、核心は一文に収まります。この仕事はクエリの形をしているのではなく、インデックスの形をしている、ということです。
- 単位はバスケットです。 ドキュメントでも行でもなく集合であり、その意味は、各メンバーの隣にほかのどのアイテムが並んでいるかにすべてが宿っています。
- 更新はペアカウントのインクリメントです。 |B| 個のアイテムを持つバスケットに対しておよそ |B|²/2 回のインクリメントで、カタログのサイズには依存しません。プランナーを必要とする要素はどこにもありません。
- 読み取りは一つの疎な行に対する部分ソートです。 ドキュメントエンジンでは、これをコレクションのフルスキャンとしてしか表現できません。
- スコアリングはドメインの数学です。 正解は一つで不正解はたくさんあり、呼び出し側に任せると、すべての呼び出し側が同じように間違えます(その様子は後で示します)。
これを無理やりドキュメントエンジンに押し込むと、N×N 行列をドキュメントとして保存することになり、アイテム数 10k なら大半がゼロのセルが 1 億個になります。SQL エンジンに押し込めば、私たちが逃れようとしている夜間バッチジョブそのものになります。
最初に二つ補足しておきます。これはベクトル検索ではありません。OxiDB にはすでに HNSW ベクトルインデックスがあり(全文検索とベクトル検索の記事)、誰かが計算した埋め込みから「これに似ているものは何か」に答えます。oxidb-rec は、観測された行動から「これと一緒に実際に買われているものは何か」に答えます。モデルも埋め込みも学習もなく、最初の注文から正しく動きます。またグラフクエリでもありません。(customer)-[bought]->(item) では、ベストセラーから 2 ホップで数百万のパスになります(地理空間とグラフの記事。グラフが真価を発揮するのは疎な近傍です)。これは密な近傍に対する集約であり、それに適した構造は隣接カウンターです。
アルゴリズム自体は新しいものではありません。Amazon のアイテム間協調フィルタリング(Linden、Smith、York、2003 年)に Dunning の LLR(1993 年)を組み合わせたもので、Apache Mahout の ItemSimilarityJob が使っている組み合わせです。本番環境では、たいてい Spark、インジケーター行列、Elasticsearch からなるパイプラインになります。それらすべてに共通しているのは、注文とレコメンドの間にリフレッシュのサイクルがあることです。私がこれをエンジンとして作ったのは、その数学をもう一度書くためではなく、そのサイクルを消すためです。
有効化と設定
エンジンはデフォルトでオフになっており、TSDB エンジンや SQL エンジンと同じパターンに従います。環境変数一つで有効になり、専用のファイル、専用の WAL、専用のリカバリを持ち、ほかのエンジンと共有するのはプロセス、ポート、認証、RBAC だけです。
| 変数 | デフォルト | 意味 |
|---|---|---|
OXIDB_REC | オフ | 1/true/yes/on でエンジンを有効化 |
OXIDB_REC_DATA | ${OXIDB_DATA}/rec | デフォルトデータベースのディレクトリ(ほかのデータベースは ${OXIDB_DATA}/<db>/rec に置かれる) |
OXIDB_REC_BUCKET_SECS | 2592000(30 日) | 時間バケット一つ分の幅。ウィンドウはその 8 個分 |
OXIDB_REC_MAX_BASKET | 50 | これより大きいバスケットはカウントされず、baskets_skipped として報告される |
OXIDB_REC_CHECKPOINT_BYTES | 8 MiB | WAL がこのサイズを超えたら自動チェックポイント(0 = 手動のみ) |
この記事のために、私は次のようにサーバーを起動しました。データセットが週単位なのでバケット幅を 1 週間(604800 秒)にし、チェックポイントが実際に発生するように閾値を 256 KiB まで下げています。
OXIDB_ADDR=127.0.0.1:16100 \
OXIDB_DATA=./data \
OXIDB_REC=1 OXIDB_SQL=1 \
OXIDB_REC_BUCKET_SECS=604800 \
OXIDB_REC_CHECKPOINT_BYTES=262144 \
./oxidb-server
エンジンは遅延オープンされます。ディレクトリは最初の rec リクエストで作られ、ログには次のように表示されます。
[oxidb] recommendation engine enabled (default db at ./data/rec)OXIDB_REC がなければ、はっきりとそう返ってきます。
{"ok": false, "error": "recommendation engine is not enabled (set OXIDB_REC=1)"}ワイヤプロトコル:一つのコマンド、五つの操作
OxiDB のネイティブプロトコルは、TCP 上の長さプレフィックス付き JSON です。4 バイトのリトルエンディアンの長さに JSON 本体が続きます。レコメンドエンジン宛てのリクエストは "engine": "rec"(または予約済みの "cmd": "rec")を持ち、op フィールドで操作を選びます。ルーティングはハンドラ内の SQL や TSDB と同じ分岐点にあります。engine フィールドを持たないリクエストは、これまでどおりバイト単位で同じドキュメント経路を通ります。
| op | 何をするか | 権限 |
|---|---|---|
track | 一つのバスケットをモデルに取り込む(バスケット ID について冪等) | write |
related | 一つのアイテムと最も関連の強いアイテム | read |
for_basket | ある集合と最も関連の強いアイテム(カートページ) | read |
stats | モデル、アイテム、ペア、バスケット、スキップされたバスケット、メモリ見積もり | read |
checkpoint | WAL を新しいスナップショット世代に畳み込む | write |
クエリパラメータは次のとおりです。scoring(デフォルトは llr。ほかに cosine、jaccard、lift、count)、half_life(バケット単位、デフォルト 2、0 = 減衰なし)、min_support(デフォルト 1)、limit(デフォルト 10)。ts はすべてのリクエストで省略可能なエポック秒で、指定しなければサーバーの壁時計が使われます。エンジン自体は時計を持たず、「現在」はブリッジで入ってきます。これにより、テストと WAL のリプレイが決定的に保たれます。
例を動かすには、15 行ほどの素朴な Python クライアントで十分です。
import json, socket, struct

class Oxi:
    def __init__(self, port=16100):
        self.s = socket.create_connection(("127.0.0.1", port))
    def call(self, req):
        b = json.dumps(req).encode()
        self.s.sendall(struct.pack("<I", len(b)) + b)
        n = struct.unpack("<I", self._read(4))[0]
        return json.loads(self._read(n))
    def _read(self, n):
        buf = b""
        while len(buf) < n:
            buf += self.s.recv(n - len(buf))
        return buf
    def rec(self, **kw):
        return self.call({"engine": "rec", "cmd": "rec", **kw})
データセット:ある書店の 8 週間
現実的なテストのために、週 1,500 件の注文がある架空のオンライン書店の 8 週間分を生成し(シード固定、再現可能なスクリプト)、いくつかの関連をわざと仕込みました。
- シリーズ:
duneを買う人のおよそ半分はdune-messiahも買い、一部はchildren-of-duneも買います。the-hobbit→lotr-fellowship→two-towers→return-of-the-kingという連鎖、rust-book→rust-atomics/zero-to-production、sapiens→homo-deus→21-lessonsなどもあります。 - テーマ: SF、ファンタジー、プログラミング、歴史、料理、児童書。同じテーマの本どうしには、弱いながらも本物の関連があります。
- 内容に関係ないベストセラー:
bookmark-setは全注文の 3 分の 1 以上に追加され、gift-wrapとreading-lightはそれより低い割合で追加されます。何と一緒に追加されるかはまったく関係ありません。 - 時間とともに変わる関連:
the-martianは最初の 6 週間はartemisと一緒に買われ、最後の 2 週間は新刊のproject-hail-maryと一緒に買われます。 - 偶然の一致: カタログのほかのどこにも現れない
haiku-anthologyとknitting-patternsが、一つの注文で一緒に買われています。dune-tarot-deckは 2 回買われ、2 回ともduneと一緒でした。 - ロングテール: Zipf 分布に従う 400 タイトル(
title-001...title-400)。
結果は 12,003 件の注文、448 種類のアイテム、バスケットあたり平均 3.2 アイテムです。これらを時系列順に、一つの接続で、逐次的な track 呼び出しとして送りました。
for r in rows:
    o.rec(op="track", model="purchase", basket_id=r["basket_id"],
          items=r["items"], ts=r["ts"])
12003 track calls, 12003 counted, 0.35 s, 34173 baskets/sこれは Apple M4 Mac 上で、ローカル接続を使い、マシンが静かなときに測定したものです。マシン上のほかのプロセスが重い fsync 処理をしている最中に同じ読み込みを繰り返すと 9 から 15 秒かかり、sample を見るとほぼすべての時間が write() システムコールの中でした。track は毎回 WAL に 1 行書いて OS にフラッシュするので、取り込み速度はディスクの競合に敏感です。エンジン自身の処理は軽いものです。
その後の stats:
{
 "catalogue_items": 448,
 "bucket_secs": 604800,
 "buckets": 8,
 "generation": 5,
 "wal_bytes": 73966,
 "models": {
  "purchase": {
   "items": 448,
   "pairs": 19362,
   "baskets": 12003,
   "baskets_skipped": 0,
   "saturated_counters": 0,
   "approx_bytes": 1776848
  }
 }
}
generation: 5 は、読み込み中に 256 KiB の閾値で自動チェックポイントが 5 回発生したことを意味します。pairs: 19362 はペアの行を両方向で数えたもの(異なるペアは 9,681 個)で、approx_bytes はカウンターマップのメモリの大まかな見積もりで、約 1.8 MB です。
最初のレコメンド:生のカウントと LLR の比較
では本題の質問です。dune を買う人には何を勧めるべきでしょうか? まず生の共起回数(scoring: "count")で、次にデフォルトの LLR で見てみます。比較をきれいにするため、half_life: 0 で減衰をオフにしました。
{"engine": "rec", "cmd": "rec", "op": "related", "model": "purchase",
 "item": "dune", "scoring": "count", "half_life": 0, "limit": 6, "ts": 1771459199}
{"ok": true, "data": {"recommendations": [
{"item": "dune-messiah", "score": 440.0},
{"item": "children-of-dune", "score": 396.0},
{"item": "bookmark-set", "score": 250.0},
{"item": "foundation", "score": 144.0},
{"item": "snow-crash", "score": 143.0},
{"item": "hyperion", "score": 136.0}]}}同じリクエストを "scoring": "llr" で投げた場合:
{"ok": true, "data": {"recommendations": [
  {"item": "dune-messiah", "score": 2835.72581039503},
  {"item": "children-of-dune", "score": 2510.829224631947},
  {"item": "snow-crash", "score": 209.64968031286844},
  {"item": "foundation", "score": 202.3380715753883},
  {"item": "hyperion", "score": 173.2231380022422},
  {"item": "neuromancer", "score": 164.29420415742788}]}}
生のカウントでは bookmark-set が 3 位で、250 件の注文で dune と一緒に現れています。LLR のリストにはまったく出てきません。代わりに同じテーマの SF が入っています。しおりセットは 4,491 件、つまり 3 件に 1 件の注文に入っています。dune の注文の 3 分の 1 にも入っているのは関連ではなく、ベースレートです。生のカウントではこの違いが分からないので、ベストセラーがどのリストにも入り込みます。同じパターンはほかの本でも繰り返されます。
the-hobbit  count: lotr-fellowship 472, bookmark-set 290, two-towers 283, ...
the-hobbit  llr:   lotr-fellowship 2808.7, two-towers 1597.1, return-of-the-king 1025.1, ...
rust-book   count: rust-atomics 238, zero-to-production 188, bookmark-set 154, ...
rust-book   llr:   rust-atomics 1704.7, zero-to-production 1316.8, ddia 338.5, database-internals 312.6, ...
the-hobbit では、LLR が三部作全体を並べるのに対し、生のカウントはしおりセットを間に割り込ませます。二、三の例にとどまらず確かめるため、27 冊それぞれについて bookmark-set が何位に来るかを調べました。
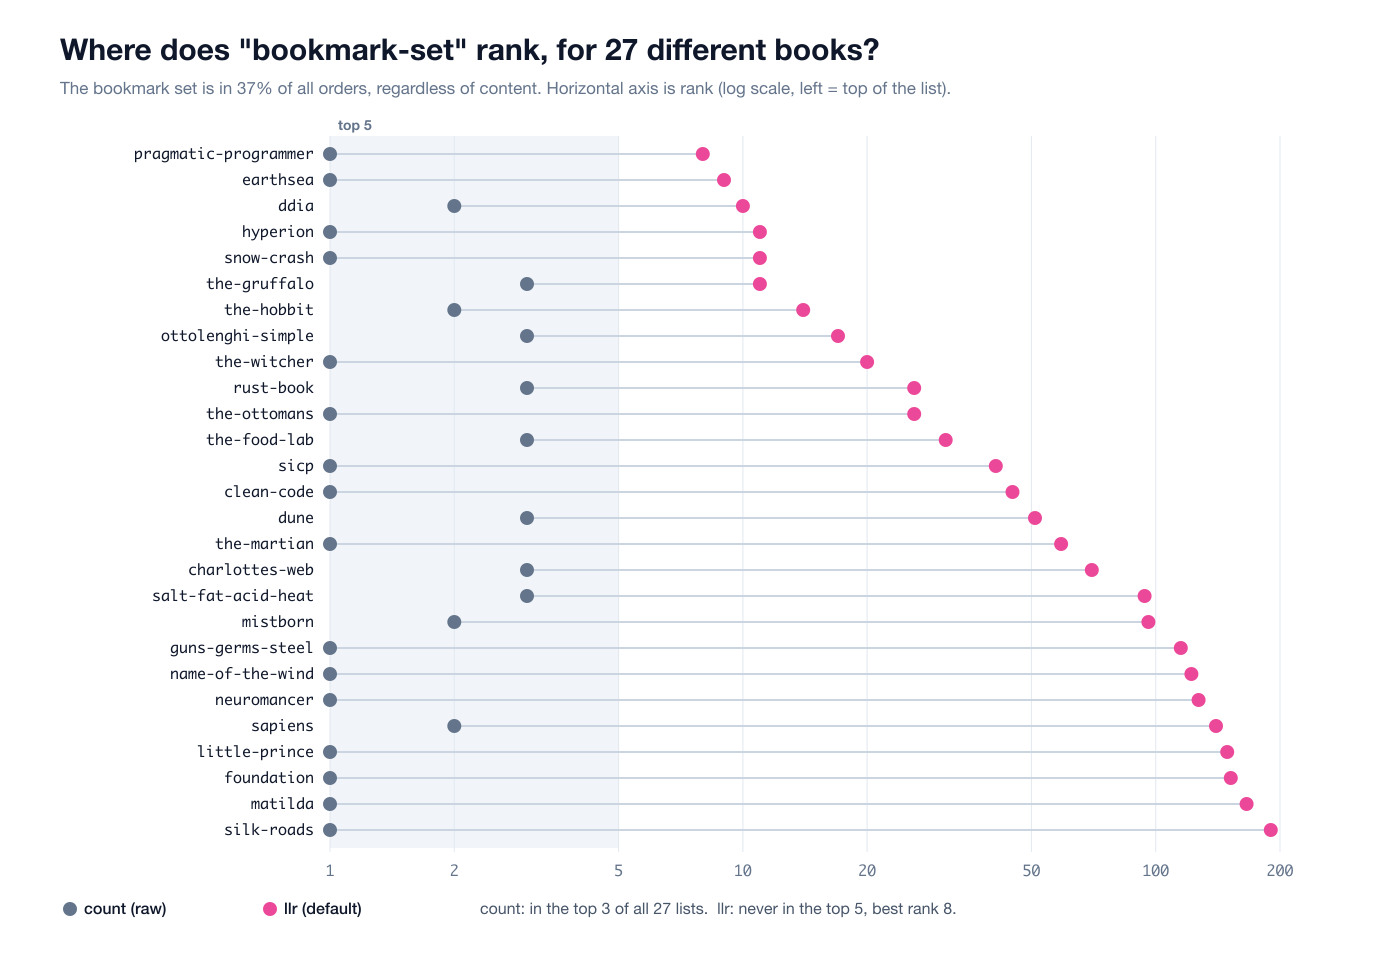
生のカウントでは、しおりセットは 27 のリストのうち 16 で 1 位、すべてのリストで上位 3 位以内に入っています。LLR では一度も上位 5 位に入らず、最高順位は 8 位で、8 つのリストでは 100 位より下です。すべての商品ページに「この商品を買った人はしおりも買っています」と書くショップは、技術的には正しくても、まったく役に立ちません。
LLR の仕組み:2×2 の表と手計算
LLR が問うのは、ベースレートを踏まえたうえで、この共起にどれだけ驚くべきか、ということです。候補ペア (x, y) ごとに 2×2 の分割表を作ります。
| y あり | y なし | |
|---|---|---|
| x あり | k11 = co(x,y) | k12 = n(x) - co |
| x なし | k21 = n(y) - co | k22 = N - n(x) - n(y) + co |
N はバスケットの総数、n(x) は x を含むバスケットの数、co(x,y) は両方を含むバスケットの数です。Dunning の G² 統計量は、観測された表と、x と y が独立だった場合に期待される表とを比較します。期待セルは行の合計 × 列の合計 ÷ N で、次のようになります。
G² = 2 · Σ O · ln(O / E) (over the four cells, a term is 0 when O = 0)エンジンは同じものを、等価なエントロピー形式で計算します。
fn xlogx(x: f64) -> f64 { if x <= 0.0 { 0.0 } else { x * x.ln() } }
fn entropy2(a: f64, b: f64) -> f64 { xlogx(a + b) - xlogx(a) - xlogx(b) }

pub fn llr(co: f64, n_x: f64, n_y: f64, total: f64) -> f64 {
    let k11 = co;
    let k12 = (n_x - co).max(0.0);
    let k21 = (n_y - co).max(0.0);
    let k22 = (total - n_x - n_y + co).max(0.0);
    let row_e = entropy2(k11 + k12, k21 + k22);
    let col_e = entropy2(k11 + k21, k12 + k22);
    let cell_e = entropy4(k11, k12, k21, k22);
    (2.0 * (row_e + col_e - cell_e)).max(0.0)
}
減衰を適用するとカウントが小数になるため、最初から最後まで f64 で計算します。また、独立に近いところでは浮動小数点誤差で結果がわずかに負になりうるため、結果はゼロでクランプしています。
データセットから二つのペアを手計算してみましょう。生の数値は、データファイルから Python で別途数えました。N = 12,003、dune は 707 個のバスケットに、dune-messiah は 440 個(そのすべてが dune も含む)に、bookmark-set は 4,491 個に入っており、そのうち 250 個が dune を含みます。
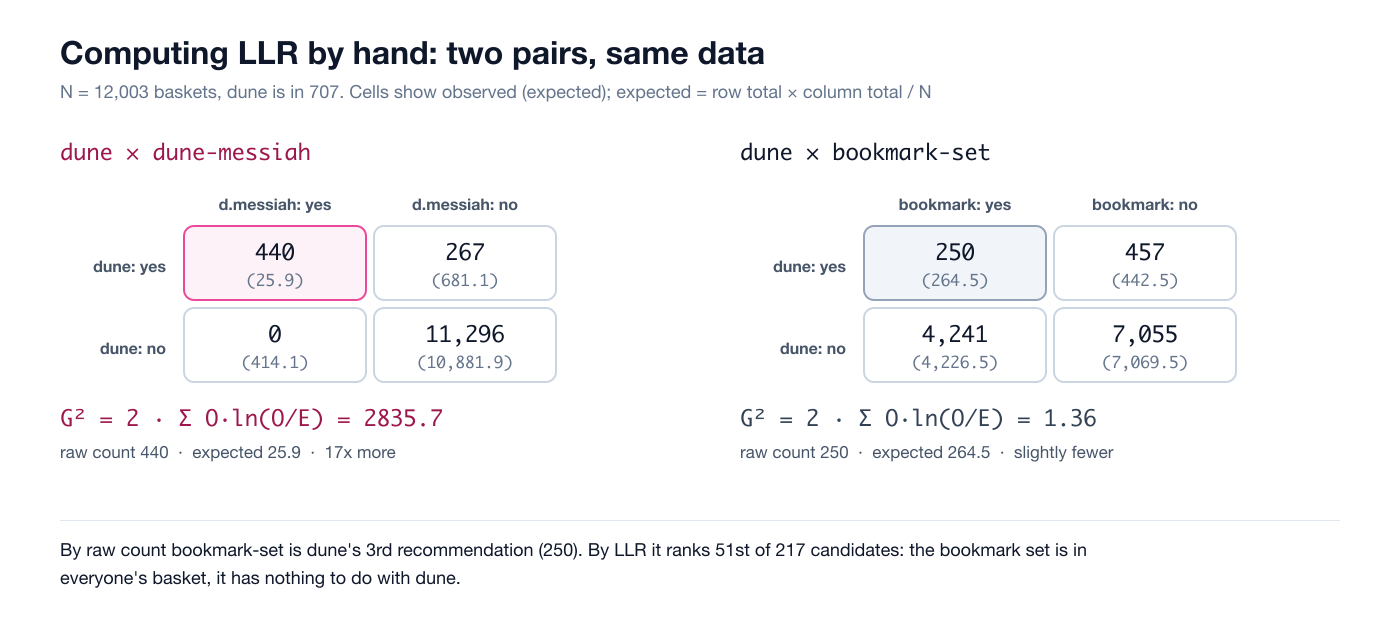
dune × dune-messiah。 独立だった場合の共起の期待値は 707 × 440 / 12,003 = 25.9 で、観測値は 440、つまり 17 倍です。四つの項は次のとおりです。440·ln(440/25.9) = 1246.03、267·ln(267/681.1) = -250.03、k21 = 0 なのでその項は 0、11,296·ln(11,296/10,881.9) = 421.86。合計は 1417.86 で、その 2 倍が 2835.7 です。
dune × bookmark-set。 共起の期待値は 707 × 4,491 / 12,003 = 264.5、観測値は 250 で、期待値よりわずかに少ないです。各項は -14.12、14.76、14.55、-14.51 で、合計は 0.68、その 2 倍が 1.36 です。
これをサーバーが返した値と比べてみました。dune-messiah は 2835.72581039503、bookmark-set は 1.3646498105954379 です。私が Python で独立に計算した値と完全に一致しました。生のカウントでは 440 対 250 で同じくらいの水準ですが、LLR では 2835 対 1.4 で、まったく関係がありません。LLR のリストで bookmark-set は 217 候補中 51 位です。
cosine と lift の落とし穴
エンジンは五つのスコアリングモードすべてに対応しており、カウンターは生の値のまま保存されているので、モードの切り替えは再構築ではなくパラメータ一つで済みます。おかげで、ほかのモードがどこで破綻するかを同じデータで簡単に確かめられます。
cosine は co / sqrt(n(x)·n(y)) です。仕込んでおいた偶然の一致を見てみましょう。haiku-anthology と knitting-patterns は、カタログ全体でそれぞれ 1 回ずつ、同じ注文の中にだけ現れます。
{"op": "related", "model": "purchase", "item": "haiku-anthology", "scoring": "cosine", "half_life": 0}
{"ok": true, "data": {"recommendations": [
  {"item": "knitting-patterns", "score": 1.0},
  {"item": "bookmark-set", "score": 0.014922049367861507}]}}
1.0 は cosine が出せる最高のスコアです。比較のために言うと、このショップで最も強い本物の関連である dune → dune-messiah は、cosine では 0.789 です。つまり cosine は、分母が分子と同じくらい小さいというだけの理由で、たった一度の偶然を、440 件の注文に裏付けられたシリーズの関係よりも「関連が強い」と見なすのです。LLR は同じ偶然に 20.8 を与えます。dune-messiah の 2835 より 2 桁小さい値です。ちょうどゼロにならないのは、期待値 0.00008 に対して 1 回の観測があるのは、統計的には何かではあるからです。それを完全に落とすために min_support があります。
{"op": "related", "model": "purchase", "item": "haiku-anthology", "half_life": 0, "min_support": 2}
{"ok": true, "data": {"recommendations": []}}
lift は co·N / (n(x)·n(y)) です。dune に対する lift のリストの上位 3 件:
{"item": "children-of-dune", "score": 16.97736916548798},
{"item": "dune-messiah", "score": 16.97736916548798},
{"item": "dune-tarot-deck", "score": 16.97736916548798}
3 件とも同点です。3 件とも必ず dune と一緒に買われていたからです。lift はそれが 440 回なのか 2 回なのかを気にしないので、dune-tarot-deck(全部で 2 回しか売れていない)が続編と並んでしまいます。LLR では dune-tarot-deck は 11.3 で 10 位です。証拠はあるものの、多くはありません。このデータセットでは、Jaccard は LLR に近い順位を出しました。ADR での実データによる検証でも、cosine はヘッドのアイテムでは LLR とおおむね一致し、件数の少ないアイテムで食い違いました。違いが現れるのはまさに証拠が薄いところであり、レコメンドリストの大部分はそこに住んでいます。
カートページ:for_basket
単一のアイテムからのレコメンドは、役に立つ形としては最も弱いものです。コンバージョンが起こるのはカートページであり、そのために for_basket は v1 に含まれています。各候補のスコアはバスケットのメンバー全体で合計され、バスケット自身のアイテムと exclude リストは決して現れません。
{"op": "for_basket", "model": "purchase", "items": ["dune", "rust-book"],
 "exclude": ["dune-messiah"], "limit": 6, "ts": 1771459199}
{"ok": true, "data": {"recommendations": [
{"item": "children-of-dune", "score": 1006.2434574795043},
{"item": "rust-atomics", "score": 719.6690210232482},
{"item": "zero-to-production", "score": 509.19681360899995},
{"item": "ddia", "score": 129.83592528033478},
{"item": "database-internals", "score": 107.594666573641},
{"item": "clean-code", "score": 102.12004133801383}]}}dune-messiah は除外しました(顧客がすでに持っているとしましょう)。リストは両方の関心に応えています。ここでは half_life を渡していないのでデフォルトの 2 バケットの減衰が適用されており、それが related の例よりスコアが低い理由です。
未知のアイテムについて尋ねると、エンジンは空のリストを返します。
{"op": "related", "model": "purchase", "item": "no-such-book"}
{"ok": true, "data": {"recommendations": []}}
これは意図的なものです。証拠を持たないエンジンが、「証拠がありません」を「これがおすすめです」に偽装すべきではありません。ベストセラーのようなフォールバックが欲しければ、それを選ぶのはアプリケーションです。
エンジンの内部:書き込み経路と読み取り経路
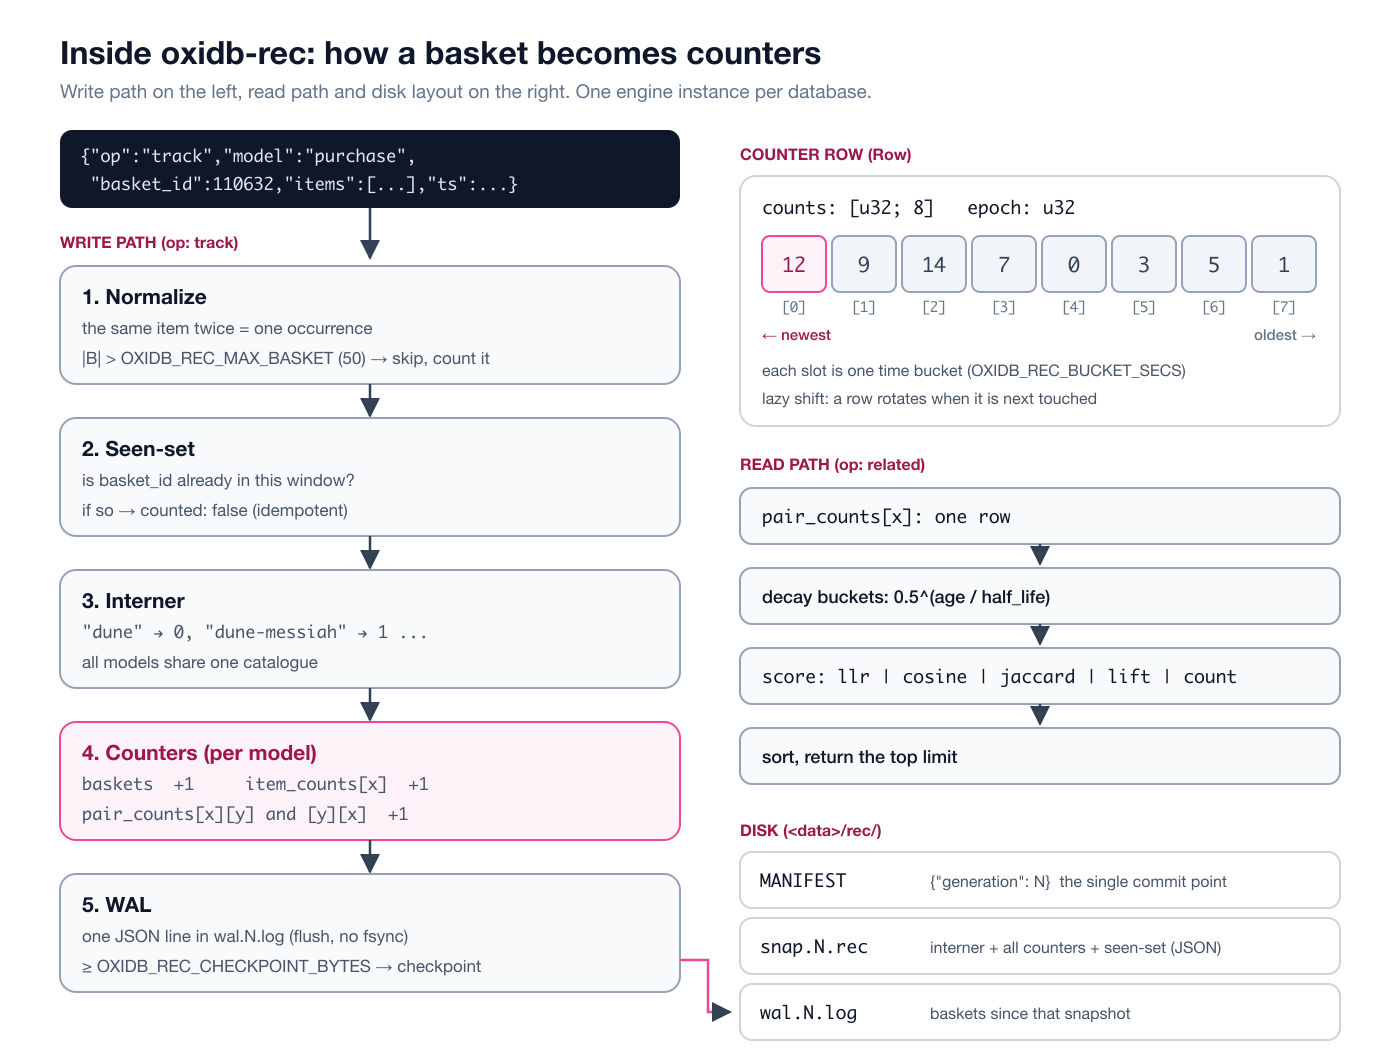
ここまではエンジンを外側から使ってきました。ここからの節は内部についてです。下の図は、track リクエストがどのようにカウンターになり、related リクエストがどのようにスコア付きリストになり、ディスク上に何があるのかを一目で示しています。
時間:8 個のバケット、遅延シフト、half_life
カウンターは単一の数値ではなく、時間バケットに分割されています。各行は固定サイズの配列です。
pub struct Row {
    pub counts: [u32; BUCKETS],   // BUCKETS = 8
    pub epoch: u32,               // the period counts[0] belongs to
}
期間は単純に ts / bucket_secs です。デフォルトの 30 日バケットならウィンドウは 240 日、私の週単位の設定なら 8 週間です。Vec ではなく [u32; 8] にしているのは意図的です。数百万ペアの規模では、Vec の 24 バイトのヘッダーだけで、それが指すカウントより大きくなってしまいます。1 行は 36 バイトです。
最も興味深い設計上の決定は、シフトが遅延で行われることです。新しい期間が始まったときにマップ全体をスキャンしてすべてのカウンターを 1 スロットずらすのではなく、各行が自分の epoch を持ち、次に触れられたとき(書き込みでも読み取りでも)に、遅れている期間の数だけシフトされます。1 行あたり O(8) の配列ローテーションです。ADR の初稿では、シフトは期間の境界で即座に行われていました。これは書き込みロックの下でのフルスキャンです。デフォルト幅なら月に一度ですが、数百万ペアの規模では、たまたま居合わせたリクエストが数秒の停止を背負うことになっていたでしょう。遅延シフトはその停止を完全になくし、コストは行アクセスごとの u32 の比較一回です。誰も触れない行は古いままですが、チェックポイントがいずれにせよそれらを走査し、すべてゼロまで減衰した行は書き出しません。チェックポイントはガベージコレクタも兼ねているのです。
ウィンドウの動きを見るため、同じクエリを未来の ts 値で投げてみました。現在、4 週間後、8 週間後です。
ts = now          → dune-messiah 440, children-of-dune 396
ts = +4 weeks     → dune-messiah 228, children-of-dune 201
ts = +8 weeks     → []
4 週間後には最初の 4 週間分のバケットがウィンドウから外れ、8 週間後には何も残りません。削除もスイープもなく、期間の算術だけです。
読み取り側では、バケットは指数的な半減期で重み付けされます。age 期間前のバケットには 0.5^(age / half_life) が掛けられます。half_life はクエリパラメータなので、「今まさに一緒に伸びている」は別のパイプラインではなくクエリ一つで済みます。データセットの the-martian で見てみましょう。
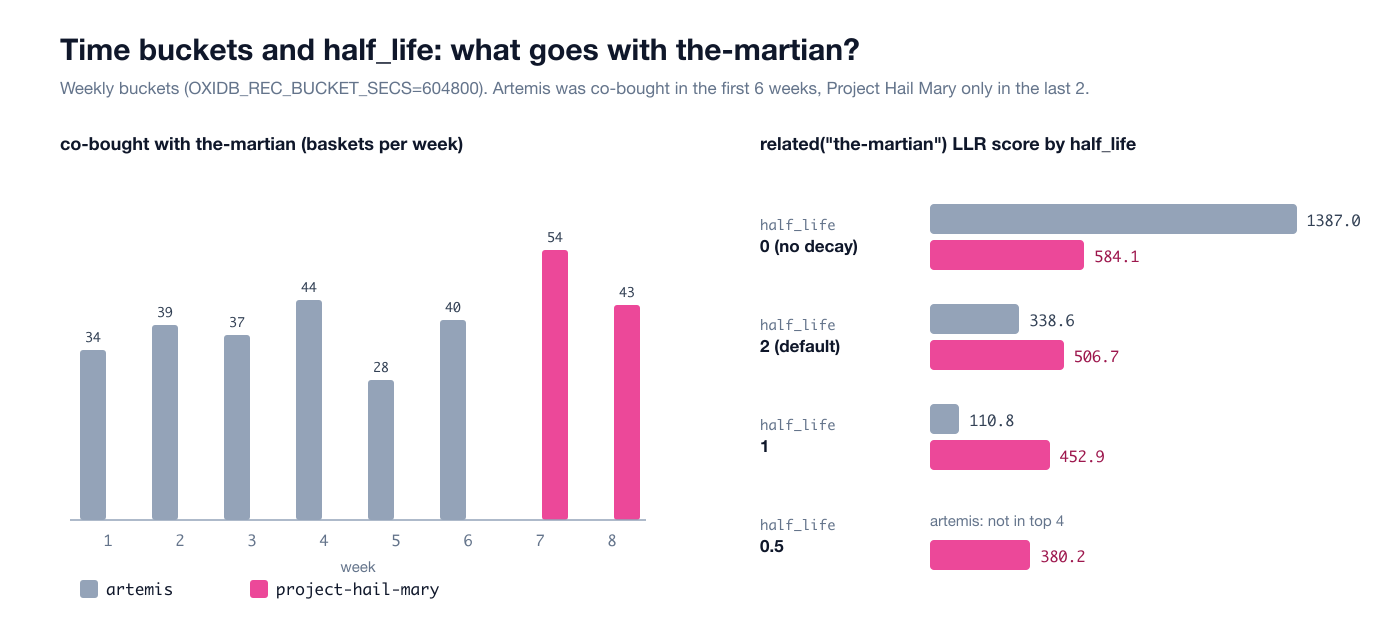
half_life 0   → artemis 1387.0, project-hail-mary 584.1, snow-crash 207.7, hyperion 168.1
half_life 2   → project-hail-mary 506.7, artemis 338.6, snow-crash 84.4
half_life 1   → project-hail-mary 452.9, artemis 110.8, snow-crash 54.8, hyperion 44.5
half_life 0.5 → project-hail-mary 380.2, snow-crash 39.8, children-of-dune 33.6, hyperion 29.4
減衰なしでは、6 週間分の artemis の履歴が勝ちます。デフォルトの half_life: 2 では、直近 2 週間の新刊が前に出ますが、artemis もリストに残ります。半バケットにすると artemis は上位 4 件から完全に消えますが、その代償はノイズです(the-martian に対して children-of-dune が出てくる)。実効的なサンプルが直近の数週間に縮むからです。適切な half_life はドメイン次第で、ファッションなら短く、B2B なら長くなります。どの場合も再構築は不要です。
カウンターとメモリレイアウト
各モデル(purchase、view、cart のような名前付きのイベント空間)は次のものを持ちます。
pub struct Model {
    baskets: Row,                                  // total baskets per period
    item_counts: HashMap<u32, Row>,                // baskets containing x
    pair_counts: HashMap<u32, HashMap<u32, Row>>,  // baskets containing x and y
    seen: [HashSet<u64>; BUCKETS],                 // basket ids seen per period
    seen_epoch: u32,
    baskets_total: u64, baskets_skipped: u64, saturated: u64,
}アイテムは文字列として届き、u32 にインターンされます。インターナはデータベースごとに一つで、すべてのモデルが共有します。カタログは同じカタログだからです。閲覧と購入はベースレートの異なる別々のシグナルなので、別々のモデルで数え、決して混ぜません。
ペアの行は両方向に保存されます。これでカウンターのメモリは 2 倍になりますが、ホットパスである related(x) が一回の行ルックアップになります。代替案(x < y の順序だけで保存)はメモリを半分にする代わりに、すべてのクエリをスキャンに変えてしまいます。ADR では、およそ distinct_pairs × 2 × 36 bytes にマップのオーバーヘッドを加えた量を見積もっており、異なるペアが 100 万個なら約 72 MB です。メモリは注文数ではなくカタログの多様性に比例して増えるので、stats はそれを approx_bytes として最初から報告しています。
カウンターは u32 のオーバーフロー時に折り返さずに飽和し、飽和が起きれば stats が saturated_counters として報告します。上限に張り付いたカウントはスコアを歪めますが、折り返したカウントはスコアを反転させてしまいます。
二つの取り込みガードと冪等性
バスケットサイズの上限(デフォルト 50)。500 行の注文は 125,000 回のインクリメントになり、ほぼ必ず一括インポートかテスト用のフィクスチャです。好みのシグナルはないのに、カウンターを支配してしまいます。上限を超えたバスケットは黙って捨てられるのではなく、数として記録されます。
{"op": "track", "model": "purchase", "basket_id": 900001, "items": ["title-001", "...60 items..."]}
{"ok": true, "data": {"counted": false}}その後、stats には "baskets_skipped": 1 と表示されます。
バスケット内の重複は 1 回の出現として数えます。重複排除はサイズチェックの前に行われるので、異なるアイテムが 40 個の 60 行の注文は上限内です。
{"op": "track", "model": "view", "basket_id": 1, "items": ["dune", "dune", "dune-messiah"]}
{"ok": true, "data": {"counted": true}}
{"op": "related", "model": "view", "item": "dune", "scoring": "count"}
{"ok": true, "data": {"recommendations": [{"item": "dune-messiah", "score": 1.0}]}}
冪等性。 track はバスケット ID について冪等です。同じ注文を 2 回送っても 1 回しか数えられません。データセットの最後の注文を再送してみました。
{"op": "track", "model": "purchase", "basket_id": 111237, "items": ["title-007"], "ts": 1771458725}
{"ok": true, "data": {"counted": false}}
これを支える既出セット(seen-set)も、ほかのすべてと同じくバケット化されています。バスケット ID は期間ごとに保持され、期間がウィンドウから外れるとその ID も一緒に外れます。したがって冪等性のウィンドウはカウントのウィンドウと等しく、セットはモデルの寿命全体にわたって増え続けるのではなく、ウィンドウ一つ分のバスケットで上限が決まります。上限のない既出セットは、このエンジン自身の「常駐インデックスの失敗」になっていたでしょう。
ディスク上:MANIFEST、スナップショット、WAL
各データベースの rec/ ディレクトリには 3 種類のファイルがあり、TSDB エンジンと同じ規律に従っています(時系列の記事)。
MANIFEST        {"generation": N}: the authoritative generation
snap.N.rec      interner + all model counters + seen-set
wal.N.log       baskets ingested since that snapshot, one JSON per line
読み込み後のディレクトリ:
-rw-r--r--  16       MANIFEST
-rw-r--r--  1008926  snap.5.rec
-rw-r--r--  73966    wal.5.log
WAL レコードは、クライアントが送ったバスケットそのものです。
{"model":"purchase","basket_id":110632,"items":["21-lessons","bookmark-set","homo-deus","sapiens","silk-roads","the-ottomans","title-007","title-041"],"ts_secs":1771203773}チェックポイントは snap.N+1 を一時ファイルに書き、fsync してからリネームし、新しい WAL を開き、それから MANIFEST をアトミックにリネームします。このリネームが唯一のコミットポイントです。 その前にクラッシュすれば N から復旧し、その後なら古い世代は削除されます。オープン時には、MANIFEST が指していない snap.* と wal.* ファイルが掃除されます。そうしなければ、クラッシュのたびに孤立したペアが残ってしまいます。
リカバリはスナップショットの読み込みと WAL のリプレイで、ここで冪等性が二度目の見返りをもたらします。既出セットはスナップショットの中にあるので、スナップショットがすでに含んでいるレコードをリプレイしても何も起きません。WAL にはコミットレコードも切り詰めの規律も必要ありません。途中で切れた最後の行(追記中のクラッシュ)はエラーとして扱わずにスキップします。そのレコードは永続化済みとして応答されたことが一度もないからです。サーバーを停止して再起動すると、stats はまったく同じ値に戻り、related("dune") も同じスコアを返しました。
手動チェックポイントとディスク使用量:
{"engine": "rec", "cmd": "rec", "op": "checkpoint", "ts": 1771459199}
{"ok": true, "data": {"ok": true}}
{"cmd": "disk_usage"}
{"ok": true, "data": {"path": ".../data", "total_bytes": 1075232, "engines": {"documents": 260, "documents_mmap": 260, "sql": 0, "tsdb": 0, "rec": 1074972, "blobs": 0, "oximem": 0, "messaging": 0, "fts": 0, "pitr_archive": 0, "system": 0}}}
もう一つガードがあります。バケット幅はスナップショットに保存され、オープン時にチェックされます。期間は ts / bucket_secs なので、異なる幅で開くと、すべてのカウンターの期間が黙って解釈し直されてしまいます。週単位のバケットで書いたディレクトリを OXIDB_REC_BUCKET_SECS=86400 で開こうとすると、エンジンは拒否しました(メッセージの末尾は省略しています)。
failed to open rec engine for database "oxidb": bucket_secs mismatch: snapshot has 604800, config wants 86400 ...耐久性についてはっきりさせておくと、WAL は毎レコード OS にフラッシュされますが、fsync はされません。プロセスのクラッシュに対しては安全ですが、電源断の場合は最後のチェックポイント以降のバスケットが失われる可能性があります。自動チェックポイント(OXIDB_REC_CHECKPOINT_BYTES)がリプレイ時間の上限を決めます。レコメンドのカウンターにとって、これは v1 の意図的なトレードオフです。数秒分の注文が欠けても、どのリストを見ても分かりません。
パフォーマンス
同じく Apple M4 Mac、ローカル接続、単一接続の Python クライアントで、それぞれ 2,000 回繰り返しました。
related x2000: 36 us per call (round trip)
for_basket x2000: 48 us per call (round trip)
ping x2000: 13 us per call
空の ping が 13 µs なので、単一アイテムの related クエリのサーバー側コストは約 20 µs です。217 候補の行をスコアリングし、ソートし、JSON にシリアライズする時間です。3 アイテムの for_basket は 48 µs かかります。これは私の小さなデータセットでの数値で、行の長さは候補数に比例して伸びます。プロジェクトの ADR にある実データでの検証(UCI Online Retail、541k 行の注文明細)は、速度ではなく、スコアリングモードごとのリストの品質を比較しています。
SQL とストアドプロシージャからのアクセス
エンジンにはもう一つの入り口があります。LANGUAGE COBRA のストアドプロシージャ内の db.rec_* メソッドです(SQL エンジンの記事)。これらはワイヤと同じディスパッチ関数を通るので、プロシージャでもクライアントでも同じ検証と同じ答えが得られます。カートページのレコメンドをプロシージャで包んでみました。
# CREATE PROCEDURE cart_recs(a TEXT, b TEXT) LANGUAGE COBRA
def run(db, a, b)
    let out = db.rec_for_basket({"model": "purchase", "items": [a, b], "limit": 3, "ts": 1771459199})
    return out["recommendations"]
end
cobra build --portable でコンパイルし、CREATE PROCEDURE ... LANGUAGE COBRA AS '...' で base64 として読み込んだ後:
{"engine": "sql", "cmd": "sql", "sql": "CALL cart_recs('the-hobbit', 'sapiens')"}
{"ok": true, "data": [{"columns": ["item", "score"], "types": [null, null],
  "rows": [["lotr-fellowship", 1130.2998390605499], ["homo-deus", 742.2844136386848], ["two-towers", 664.9649628103361]]}]}
レコメンドが SQL の行として返ってきます。注文テーブルに書き込むのと同じプロシージャで、db.rec_track を使ってバスケットをレコメンドエンジンに渡すこともできます。
制限事項と正直なメモ
クラスタ内ではレプリケートされません。 Raft クラスタでは track は書き込みですが、Raft 経由ではレプリケートされません。この穴は TSDB と同じです。各ノードは自分が受け取ったバスケットだけを蓄積するので、related の答えはノードごとに異なりえます。ADR はこれを発見ではなく決定として記録しています。修正を安く済ませる二つの性質はすでに揃っています。track は冪等(at-least-once 配信で十分)であり、状態は可換なカウンター(どんな順序で届いてもレプリカは収束する)です。
パーソナライゼーションではありません。 共起が答えるのは「これと何が合うか」であり、「この人が次に何を見るべきか」ではありません。
LLR は両側です。 G² は「期待より多い」と「期待より少ない」を区別せず、エンジンの実装には符号のチェックがありません。私のデータセットでは、pragmatic-programmer に対して bookmark-set が 8 位に来ました。共起は 139、独立の場合の期待値は 164.3 です。関連は実際には負なのに、スコアは小さいながらも正(6.59)になっています。スコアが小さいままなので短いリストには出てきませんが、長いリストの末尾には現れることがあります。
ADR と v1 の違い。 ADR ではスナップショットをバイナリ形式として説明していますが、v1 の snap.N.rec は JSON です(私の 1 MB のスナップショットは読める JSON ファイルでした)。ADR で触れられている fallback: "popular" パラメータと、backup/restore/retention の各操作は、このバージョンのワイヤには出ていません。ブリッジが知っているのは track、related、for_basket、stats、checkpoint です。未知の操作は明確なエラーで拒否されます。
{"engine": "rec", "cmd": "rec", "op": "retention"}
{"ok": false, "error": "unknown rec op: \"retention\" (track, related, for_basket, stats, checkpoint)"}
この記事を書いている最中に見つけたバグ:遅れて届くバスケット。 うっかり読み込みスクリプトを 2 回実行してしまったところ、2 回目でも 12,003 個のバスケットがすべて再び counted: true で返ってきました。原因はこうです。Row::roll_to と既出セットのシフトは、新しい期間が現在の epoch 以上であることを前提にしています。これを守っているのは debug_assert! だけで、リリースビルドでは now - epoch の引き算が u32 としてアンダーフローして巨大な数になり、「ウィンドウ全体が遅れている」と解釈されます。つまり、ts がモデルの現在の期間より古いバスケットが一つ来るだけで、既出セット全体がクリアされ、そのバスケットが触れた行(バスケット総数の行を含む)がゼロになり、それらの epoch が過去に巻き戻されます。きれいなサーバーでの小さな再現:
before: {"recommendations": [{"item": "coffee", "score": 30.431653267886233}]}
late basket: {'counted': True}
after:  {"recommendations": []}
ここでは 40 個のバスケットが今週に入っていて、前週の ts を持つバスケットが一つだけ届きました。その後、milk に対する LLR のリストは空になりました。N が事実上 1 に落ちたからです。同じセッションで、すでに数えたバスケット ID を再送すると counted: true が返ってきました。時系列順に届くデータ(たとえば ts を省略してサーバーの時計に頼るライブのショップ)ではこれは決して起こらず、上に示した結果はすべて時系列順に読み込んだデータによるものです。しかし、過去の注文を順不同でインポートしたり、時計の異なる複数のソースから書き込んだりするのは、現時点では安全ではありません。正しい修正は、遅れたイベントがまだウィンドウ内なら正しいスロット(counts[epoch - now])に加算し、そうでなければ捨て、epoch を決して過去に戻さないことです。これが次のリリースで最初にやることです。それまでは、過去のデータは ts でソートしてから読み込むことをおすすめします。
OxiDB のほかの部分との関係
oxidb-rec は OxiDB の 4 番目のエンジンで、ADR-0010 が 2 番目のエンジンのために定めたパターンに寸分違わず従っています。専用の crate(oxidb ドキュメント crate にも oxidb-sql にも依存しないので、単体で組み込める)、専用のファイル、専用の WAL、追加的な engine 識別子です。マルチデータベース対応はほかのエンジンと同じで、データベースごとに専用のエンジンインスタンスがあり、drop_database はそれも削除します。RBAC では、read ロールは related、for_basket、stats を実行でき、track と checkpoint には write 権限が必要です。エンジン間トランザクションには参加しません。注文より数秒遅れているレコメンドカウンターは誰にも観測できない不整合であり、ここでエンジン間のアトミック性にコストを払っても何も得られません。
実際の構成はこうなります。注文をドキュメントエンジンや SQL エンジンに書き込むコードが、同じ接続で track を送ります。次の商品ページのリクエストは、もう新しい注文を反映しています。リフレッシュするものも、実行し忘れるスケジュールジョブも、説明すべき遅延もありません。私がこれを夜間ジョブではなくエンジンとして作った理由は、これに尽きます。
試してみる
ビルド済みの OxiDB リリースは、Docker イメージや単一ファイルのサーバーバイナリと一緒に GitHub releases ページにあります。レコメンドエンジンに必要なのは OXIDB_REC=1 だけです。自分の注文履歴を時系列順に track で送り、いくつかの商品について scoring: "count" と scoring: "llr" のリストを並べてみてください。違いはたいてい最初の商品ページで分かります。