OxiDB の地理空間クエリとグラフクエリ:geohash インデックス、$near、$graphLookup、$shortestPath
OxiDB のドキュメントエンジンに地理空間クエリとグラフステージを組み込んだ方法を、イスタンブールの実在の場所と小さな航空路線網で紹介します。寛大だが決して間違えない geohash インデックス、BFS、遅延ダイクストラ法。
OxiDB のドキュメントエンジンにできるのは、「このフィールドがこの値に等しいドキュメントをください」だけではありません。たいてい別のシステムに回されてしまう種類の質問が 2 つあります。「自分に一番近いのはどれか」と「ここからあそこへはどう行けばいいか」です。前者には PostGIS や Redis GEO が、後者には Neo4j のようなグラフデータベースが使われがちです。私はその両方を、クエリ言語と集計パイプラインの自然な一部として OxiDB の中に入れました。この記事では、地理空間の側($geoWithin、$near、$geoNear、geohash インデックス)とグラフの側($graphLookup、$shortestPath)を取り上げます。例にはすべてイスタンブールの実在の場所とトルコの実在の空港を使い、ここに載せたレスポンスはすべて、執筆中にローカルで動かした OxiDB 0.44.2 サーバーから返ってきたものです。
このシリーズの最初の記事ではドキュメントエンジンを取り上げました。ここで紹介するものはすべてその上で動きます。同じコレクション、同じインデックス、同じワイヤープロトコルです。別のサービスもプラグインもありません。
なぜデータベースの中なのか
配達アプリを思い浮かべてください。配達員の位置はコレクションに入っています。「顧客から 2 km 以内にいる待機中の配達員」という条件は、位置のフィルターと通常のフィールドのフィルター(status: "idle")を組み合わせたものです。位置を Redis に、ステータスをメインのデータベースに置いていると、2 つのシステムの結果をアプリケーションコードで突き合わせることになり、整合性は自分で面倒を見なければなりません。グラフも同じです。「友達の友達」を聞くためだけにデータを 2 つ目のデータベースにコピーすれば、永遠に同期し続けなければならないパイプラインを抱えることになります。
OxiDB では、位置は単なるドキュメントのフィールドであり、グラフは単なるドキュメント間の参照です。クエリ言語は両方を理解し、インデックスは両方に効きます。代償として、専用の GIS やグラフデータベースが提供するすべてが手に入るわけではありません。以下では、できることと、同じくらい意識的に、できないことを挙げていきます。
有効化:何もする必要はありません
地理空間クエリとグラフクエリはドキュメントエンジンの一部であり、ドキュメントエンジンはデフォルトで有効です。追加の環境変数はありません。今回のテストでは、自分用のポートと専用のデータディレクトリでサーバーを起動しました。
OXIDB_ADDR=127.0.0.1:15300 OXIDB_DATA=./data ./oxidb-serverワイヤープロトコルは長さプレフィックス付きの JSON です。4 バイトのリトルエンディアンの長さに、{"cmd": ...} 形式の JSON ドキュメントが続きます。以下のリクエストはすべてこの方法で送り、レスポンスはサーバーが返したとおりに示しています(読みやすさのために、何か所かでフィールドを削ったり $project で絞ったりしています)。コレクション名とフィールド名はトルコ語です。実際に動かしたデータがこれだからです。yerler は「場所」、konum は「位置」、ad は「名前」、tur は「種類」という意味です。
地理空間のデータモデル:点
OxiDB の地理機能は、意図的に 点 を中心に作られています。位置フィールドは次の 3 つの形のいずれかで書けます。
| 形 | 例 |
|---|---|
| GeoJSON Point | {"type": "Point", "coordinates": [28.9802, 41.0086]} |
[lon, lat] 配列 | [28.9741, 41.0256] |
{lat, lon} オブジェクト | {"lat": 41.0370, "lon": 28.9850}(または lng) |
順序は常に GeoJSON と同じで、経度が先、緯度が後 です。オブジェクト形式ではキーに名前があるので、順序は関係ありません。経度は -180..180、緯度は -90..90 の範囲でなければならず、その範囲外のものや数値でないものは、単に点とは見なされません。位置がない、あるいは無効な位置を持つドキュメントは地理述語に一致することはありませんが、エラーにもなりません。スキーマレスなコレクションではこれが望ましい挙動です。座標のないカフェもコレクションに置いておけて、ただ「近くの場所」には決して現れないだけです。
これを示すために、イスタンブールの 14 か所と、位置を持たないカフェ 1 軒を挿入しました。3 つの形をわざと混ぜています。
{"cmd": "insert_many", "collection": "yerler", "docs": [
  {"ad": "Ayasofya", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9802, 41.0086]}},
  {"ad": "Topkapı Sarayı", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9834, 41.0115]}},
  {"ad": "Kapalıçarşı", "tur": "carsi", "konum": [28.968, 41.0107]},
  {"ad": "Galata Kulesi", "tur": "kule", "konum": [28.9741, 41.0256]},
  {"ad": "Taksim Meydanı", "tur": "meydan", "konum": {"lat": 41.037, "lon": 28.985}},
  {"ad": "Dolmabahçe Sarayı", "tur": "muze", "konum": {"lat": 41.0392, "lon": 29.0005}},
  {"ad": "Kız Kulesi", "tur": "kule", "konum": [29.0041, 41.0211]},
  {"ad": "Kadıköy İskelesi", "tur": "iskele", "konum": {"lat": 40.9926, "lng": 29.0221}},
  {"ad": "Çamlıca Kulesi", "tur": "kule", "konum": [29.0697, 41.027]},
  {"ad": "Rumeli Hisarı", "tur": "muze", "konum": [29.0561, 41.0848]},
  {"ad": "Anadolu Hisarı", "tur": "muze", "konum": [29.0669, 41.0822]},
  {"ad": "Büyükada", "tur": "ada", "konum": [29.12, 40.858]},
  {"ad": "Sabiha Gökçen Havalimanı", "tur": "havalimani", "konum": [29.3092, 40.8986]},
  {"ad": "İstanbul Havalimanı", "tur": "havalimani", "konum": [28.7519, 41.2753]},
  {"ad": "Konumsuz Kafe", "tur": "kafe"}
]}
{"ok": true, "data": [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]}(Ayasofya はアヤソフィア、Topkapı Sarayı はトプカプ宮殿、Kapalıçarşı はグランドバザール、Kız Kulesi は乙女の塔、Kadıköy İskelesi はカドゥキョイのフェリー乗り場です。)
地理インデックスの作成はコマンド 1 つです。
{"cmd": "create_geo_index", "collection": "yerler", "field": "konum"}
{"ok": true, "data": "geo index created"}

{"cmd": "list_indexes", "collection": "yerler"}
{"ok": true, "data": [{"name": "_geo_konum", "index_type": "geo", "fields": ["konum"], "unique": false}]}
地理クエリはすべてインデックスなしでも(フルスキャンで)動きます。インデックスは処理を速くするだけで、答えを変えることは決してありません。この一文がこの記事の核心です。なぜそう言えるのかはすぐ後で説明します。
$geoWithin:領域の内側にあるもの
$centerSphere:球面上の円
$centerSphere は中心と、ラジアン 単位の半径を受け取ります。これは MongoDB の定義で、メートルをラジアンに変換するには地球の半径で割ります。OxiDB は MongoDB がドキュメントに記載しているのと同じ平均地球半径、6,371,008.8 メートルを使います。アヤソフィアの周囲 2 km なら 2000 / 6371008.8 = 0.000313922... ラジアンです。
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoWithin": {"$centerSphere": [[28.9802, 41.0086], 0.00031392202754452326]}}}}
{"ok": true, "data": [
{"ad": "Ayasofya", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9802, 41.0086]}, "_id": 1, "_version": 1},
{"ad": "Topkapı Sarayı", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9834, 41.0115]}, "_id": 2, "_version": 1},
{"ad": "Kapalıçarşı", "tur": "carsi", "konum": [28.968, 41.0107], "_id": 3, "_version": 1},
{"ad": "Galata Kulesi", "tur": "kule", "konum": [28.9741, 41.0256], "_id": 4, "_version": 1}
]}ガラタ塔はアヤソフィアから 1,958 メートル(この数値はすぐ後で $geoNear から得られます)で、2 km の円のぎりぎり内側です。距離は常に大円(haversine)距離で、平面上のピタゴラスは使いません。
$box:経度・緯度の長方形
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoWithin": {"$box": [[28.96, 41.0], [29.01, 41.03]]}}}}
このボックスでは、アヤソフィア、トプカプ、グランドバザール、ガラタ塔、乙女の塔(5 件のドキュメント)が返りました。角は [min, max] でなければなりません。ボックスは日付変更線(経度 180)をまたいで折り返しません。もし折り返すとしたら意図が曖昧になってしまうので、角を入れ替えるとエラーになります(後述のエラーの節を参照)。
$geometry Polygon と $geoIntersects
最初のバージョンの後で、GeoJSON Polygon にも対応しました。外周のリングと、任意の穴です。包含判定は経度・緯度の平面上でのレイキャスティングで行います。歴史的半島を大まかに囲むポリゴンでの例です。
{"cmd": "find", "collection": "yerler", "query": {"konum": {"$geoWithin": {"$geometry":
  {"type": "Polygon", "coordinates": [[[28.92, 40.993], [28.985, 41.0], [28.99, 41.015],
     [28.97, 41.02], [28.94, 41.03], [28.923, 41.025], [28.92, 40.993]]]}}}}}
結果にはアヤソフィア、トプカプ宮殿、グランドバザールが含まれますが、金角湾の向こう側にあるガラタ塔は含まれません。ポリゴンを平面上で評価するのは意識的な選択です。ジオフェンス程度の大きさの領域(地区、建設現場、港)では平面と球面の差は測定できないほど小さく、計算ははるかに単純で高速です。
$geoIntersects もあります。コレクションには点しか格納されないので、「点が領域と交差する」と「点が領域の内側にある」は同じことであり、両者は 1 つの評価器を共有しています。Point のジオメトリは半径ゼロの円に縮退します。
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoIntersects": {"$geometry": {"type": "Point", "coordinates": [29.0041, 41.0211]}}}}}
{"ok": true, "data": [{"ad": "Kız Kulesi", "tur": "kule", "konum": [29.0041, 41.0211], "_id": 7, "_version": 1}]}$near と $nearSphere:近い順に
$near は 2 つのことを同時に行います。任意の距離の上下限でフィルタリングし、結果を 近い順に 並べます。距離の単位はメートルです。ガラタ塔から 3 km 以内です。
{"cmd": "find", "collection": "yerler", "query": {"konum": {"$near": {
  "$geometry": {"type": "Point", "coordinates": [28.9741, 41.0256]}, "$maxDistance": 3000}}}}
返ってきた順序は、ガラタ塔、タクスィム広場、グランドバザール、トプカプ宮殿、アヤソフィア、乙女の塔、ドルマバフチェ宮殿でした。7 件のドキュメントが、近いものから遠いものへと並んでいます。
$nearSphere は $near の完全なエイリアスです。レガシー形式も使えます。点を直接渡し、$maxDistance と $minDistance を演算子の隣に置きます。カドゥキョイのフェリー乗り場から 1 km 以上 6 km 以内の場所です。
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$nearSphere": [29.0221, 40.9926], "$maxDistance": 6000, "$minDistance": 1000}}}
結果は、乙女の塔、トプカプ宮殿、アヤソフィア、グランドバザール、ガラタ塔、ドルマバフチェ宮殿、チャムルジャ塔、タクスィム広場です。乗り場そのもの(0 m)は $minDistance によって除外されています。
ここで私は意図的に MongoDB と袂を分かっています。MongoDB では、レガシー形式の $near は平面上で計算され、$maxDistance を 度 として読みます。同じクエリが 2 つの異なる単位で 2 つの異なる意味を持つわけで、これは気づかないうちに測り間違えるための処方箋です。OxiDB ではどちらの形式もメートルを使い、どちらも球面上で計算します。MongoDB のコードを移植しているなら違いにはなりますが、気づかない違いではありません。度のつもりで 0.01 と書けば 1 センチメートルの円になるので、すぐに気づきます。
$near は距離の上限なしでも動き、他のフィルターとも組み合わせられます。アヤソフィアに最も近い塔は次のとおりです。
{"cmd": "find", "collection": "yerler", "query": {"tur": "kule",
  "konum": {"$near": {"$geometry": {"type": "Point", "coordinates": [28.9802, 41.0086]}}}}}
順序は、ガラタ塔、乙女の塔、チャムルジャ塔です。
並べ替えのルールは MongoDB と同じです。$near が並べ替えるのは、呼び出し側が明示的な sort を指定しなかったときだけです。指定すれば、そちらが優先されます。"sort": {"ad": 1}, "limit": 3 を追加すると、Anadolu Hisarı、Ayasofya、Büyükada が返りました。アルファベット順です。
$geoNear:距離も返してほしい
$near は並べ替えますが、距離は返しません。アプリで「1.2 km 先」と表示したいなら、クライアント側で自前の haversine を使って距離を計算し直すか、$geoNear ステージを使うかのどちらかです。
{"cmd": "aggregate", "collection": "yerler", "pipeline": [
  {"$geoNear": {"near": {"type": "Point", "coordinates": [28.9802, 41.0086]},
                "key": "konum", "distanceField": "mesafe_m", "maxDistance": 5000}},
  {"$project": {"_id": 0, "ad": 1, "mesafe_m": 1}}
]}
{"ok": true, "data": [
{"ad": "Ayasofya", "mesafe_m": 0.0},
{"ad": "Topkapı Sarayı", "mesafe_m": 419.6165187010312},
{"ad": "Kapalıçarşı", "mesafe_m": 1049.969147589969},
{"ad": "Galata Kulesi", "mesafe_m": 1958.3701941280722},
{"ad": "Kız Kulesi", "mesafe_m": 2439.8565175620315},
{"ad": "Taksim Meydanı", "mesafe_m": 3183.509891312274},
{"ad": "Dolmabahçe Sarayı", "mesafe_m": 3804.936857196773},
{"ad": "Kadıköy İskelesi", "mesafe_m": 3940.690888137602}
]}key と distanceField は必須です。どのフィールドに点が入っているかを私が推測することはしません。query でフィルターを追加でき、distanceMultiplier で単位を変換できます。アヤソフィアから 2 つの空港までの距離をキロメートルで求めます。
{"cmd": "aggregate", "collection": "yerler", "pipeline": [
  {"$geoNear": {"near": [28.9802, 41.0086], "key": "konum", "distanceField": "km",
                "distanceMultiplier": 0.001, "query": {"tur": "havalimani"}}},
  {"$project": {"_id": 0, "ad": 1, "km": 1}}
]}
{"ok": true, "data": [
{"ad": "Sabiha Gökçen Havalimanı", "km": 30.215465616237612},
{"ad": "İstanbul Havalimanı", "km": 35.28374942949766}
]}内部的には、$geoNear は 2 つのステージに分割されます。合成された先頭の $match(等価な $near 述語にあなたの query を加えたもの)と、距離を書き込んで並べ替えるステージです。こうすることで、地理インデックス、候補の積集合、プッシュダウンが、二重に実装することなく $geoNear にもそのまま効きます。spherical は受け付けますが無視します。このエンジンは常に球面で計算するからです。
同じ種類のクエリを公式の Python クライアントからも実行しました。クライアントにはまだ create_geo_index のヘルパーがないので、生のコマンドを送っています。
from oxidb import OxiDbClient

with OxiDbClient("127.0.0.1", 15300) as db:
    # The Python client has no create_geo_index helper yet; send the raw command
    db._checked({"cmd": "create_geo_index", "collection": "yerler", "field": "konum"})
    yakin = db.aggregate("yerler", [
        {"$geoNear": {"near": [29.0221, 40.9926], "key": "konum",
                      "distanceField": "m", "maxDistance": 4000}},
        {"$project": {"_id": 0, "ad": 1, "m": 1}},
    ])
    for d in yakin:
        print(f'{d["ad"]:<20} {d["m"]:>7.0f} m')
Kadıköy İskelesi 0 m
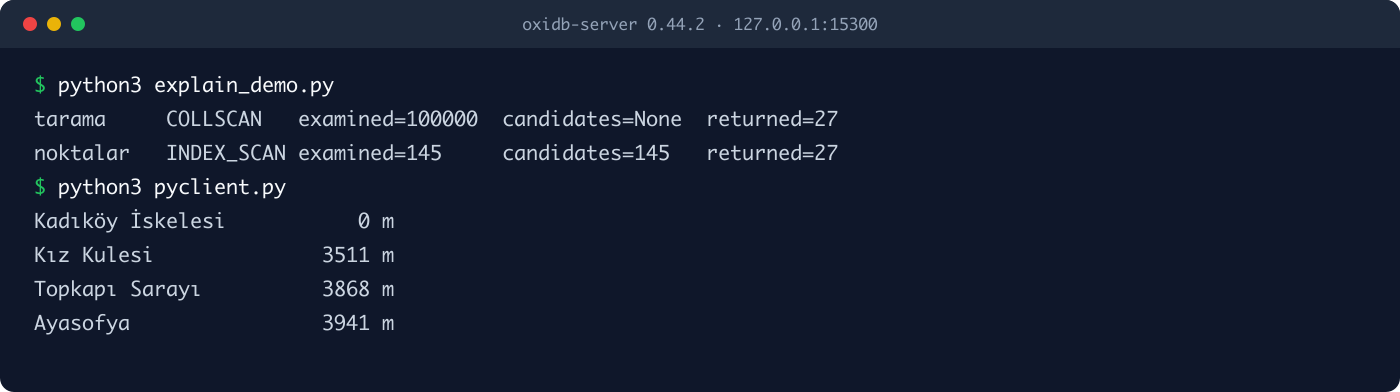
Kız Kulesi 3511 m
Topkapı Sarayı 3868 m
Ayasofya 3941 m正しく答えられない形は拒否する
地理コードで最も犯しやすい間違いは、ある形に「おおよそ」で答えて、それを誰にも言わないことです。OxiDB のルールはシンプルです。正しく答えられないクエリは、名指しで拒否します。間違った結果リストはエラーメッセージよりはるかに高くつきます。誰もそれに気づかないからです。
{"konum": {"$geoWithin": {"$center": [[28.98, 41.0], 0.02]}}}invalid query: $geoWithin $center is not supported - use $centerSphere (spherical), $box, or $geometry PolygonMongoDB の $center は、半径を度で指定する平面上の円です。緯度 41 度では経度 1 度が約 84 km、緯度 1 度が約 111 km なので、この「円」は実際には楕円です。黙って $centerSphere として扱うのも、平面上で計算するのも、どちらも誤った期待を抱かせることになります。レガシーの $polygon も同じ理由で拒否されます。
invalid query: $geoWithin $polygon is not supported - use $centerSphere (spherical), $box, or $geometry Polygon経度で 180 度を超えるポリゴンも拒否されます。リングが地球の半分を包むようになると、平面上ではどちら側が「内側」なのかが曖昧になるからです。
{"konum": {"$geoWithin": {"$geometry": {"type": "Polygon",
  "coordinates": [[[-100, 0], [100, 0], [100, 10], [-100, 10], [-100, 0]]]}}}}
invalid query: Polygon spanning more than 180° of longitude is ambiguous - split it at the antimeridianその他の拒否の例です。どれもサーバーからの実際のレスポンスです。
swapped $box corners:  invalid query: $box corners must be [min, max] (no antimeridian wrap)
3-element point:       invalid query: expected a point ([lon, lat], GeoJSON Point, or {lon, lat}), got [41.0,28.9,1]
negative distance:     invalid query: $maxDistance must be a non-negative number of meters
LineString region:     invalid query: $geoWithin $geometry supports Polygon, got Some("LineString") - use $centerSphere for circles
(サーバーのエラーメッセージ中の長いダッシュは、ここでは普通のハイフンとして書きました。それ以外のテキストはサーバーが返したとおりです。)
非対称性に注目してください。ドキュメント内の壊れた点は「一致しない」になり、クエリ内の壊れた点はエラーになります。ドキュメントはスキーマレスで、散らかっていることもあります。しかしクエリを書いたのはあなたであり、そこにある間違いはおそらくバグです。
geohash インデックス:寛大だが決して間違えない
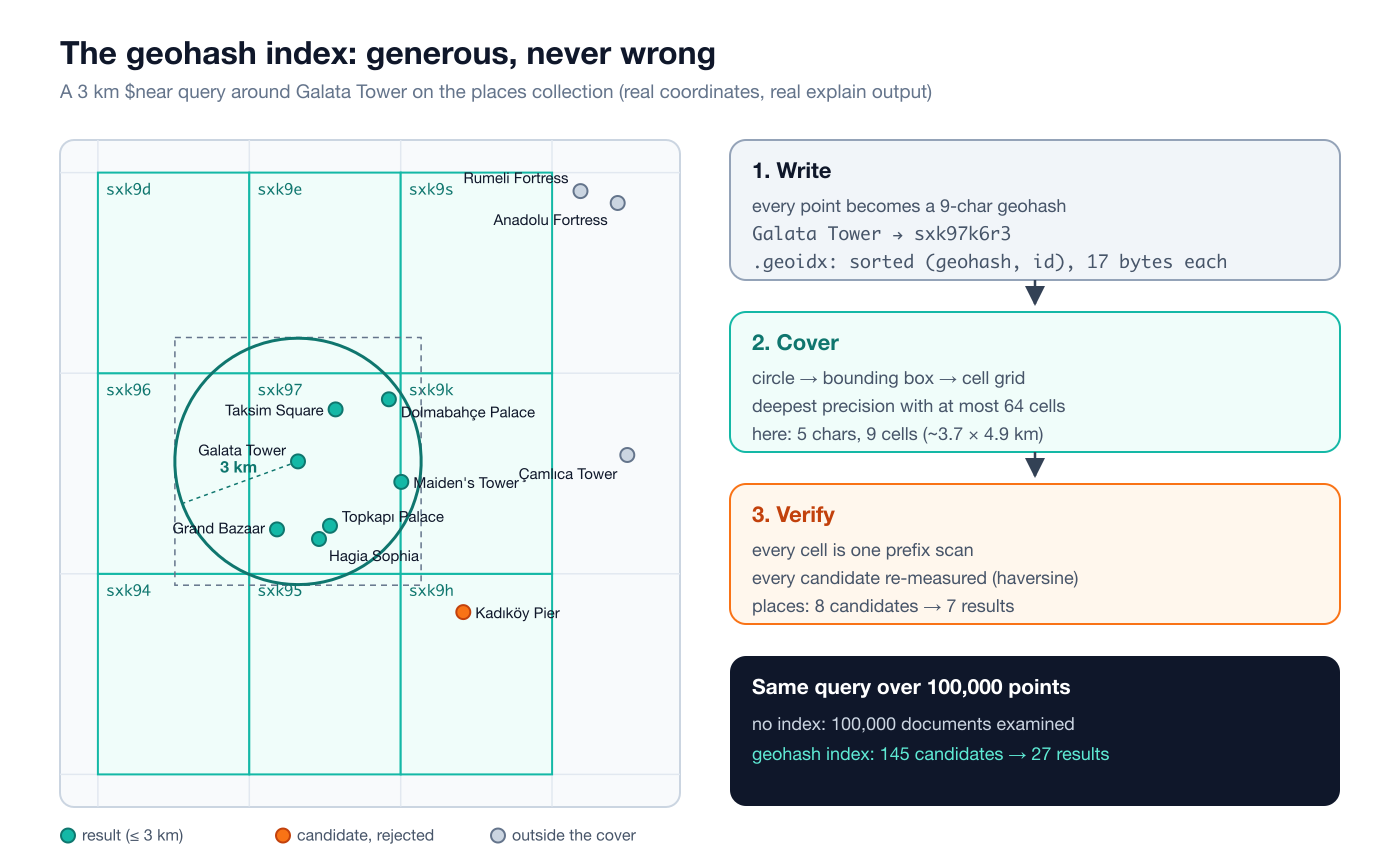
ここからは内部の話です。geohash は、世界を何度も半分に分割していくことで点を短い文字列に変換する古典的なエンコーディングです。経度と緯度のビットが交互に並べられ(ビット 0 が経度、ビット 1 が緯度、……)、5 ビットごとに 1 つの base32 文字になります。重要な性質は、共通のプレフィックスを持つ geohash は同じ長方形のセルの中にある ということです。sxk97 で始まる点はすべて sxk97 のセルの内側にあります。
書き込み側
インデックスされる各点は、固定精度の 9 文字の geohash になります。9 文字なら、セルはおよそ 4.8 m × 4.8 m です。ガラタ塔は sxk97k6r3、アヤソフィアは sxk973qsr です。インデックスは (geohash, ドキュメント ID) のペアをソートした表で、メモリ上では BTreeMap<String, BTreeSet<DocumentId>>、ディスク上では .geoidx ファイルです。
.geoidx の形式は意図的にシンプルにしています。マジックバイト OXGE、4 バイトのバージョン、8 バイトのエントリ数、そして固定幅のエントリが続きます。各エントリは 9 バイトの ASCII の geohash と、8 バイトのリトルエンディアンのドキュメント ID で、合計 17 バイトです。固定幅になるのはすべての geohash がちょうど 9 文字だからで、そのおかげでプレフィックススキャンは「下限を二分探索し、プレフィックスが一致する間は進む」という単純なものになります。私のテストサーバーでは、100,000 点のコレクションのファイルはちょうど 1,700,016 バイトでした。16 バイトのヘッダーに 100,000 × 17 を足した値です。場所のコレクションのファイルには 14 エントリがあります。位置を持たないカフェはインデックスに入っていないからです。
00000000: 4f58 4745 0100 0000 0e00 0000 0000 0000  OXGE............
00000010: 7378 6b36 7933 6271 700e 0000 0000 0000  sxk6y3bqp.......
00000020: 0073 786b 3871 7475 7831 0c00 0000 0000  .sxk8qtux1......
クエリ側:カバー
クエリが届くと、まずその形(円、ボックス、ポリゴン)をバウンディングボックスに変換します。円には少し注意が必要です。経度 1 度あたりのメートル数は緯度とともに縮むので、円が到達する 最も広い 緯度を使います。これでボックスが小さすぎることは決してなくなります。次に精度を 9 から下へ順に試し、セルのグリッドが 64 セル以内でボックスを覆える 最も深い 精度を選びます。セルを見つけるのに隣接テーブルの計算は行いません。ボックスの上にセルサイズのサンプル点のグリッドを敷き、それぞれを geohash にします。これで geohash の隣接計算によく知られた落とし穴を完全に回避できます。
ガラタ塔の周囲 3 km では、結果は精度 5 の 9 セル、sxk94, sxk95, sxk96, sxk97, sxk9d, sxk9e, sxk9h, sxk9k, sxk9s です。精度 6 なら 88 セルが必要になり、64 の上限を超えてしまいます。各セルがインデックスに対する 1 回のプレフィックススキャンになります。
検証:インデックスは候補を挙げるだけ
ここが設計の最も重要な部分です。インデックスは候補を挙げるだけです。 セルから得られた候補はすべて、ドキュメントそのものに対して本来の述語(haversine 距離、ボックス判定、ポリゴン判定)で再チェックされます。カバーは寛大で、余分な候補を持ち込むことがあっても構いません。それが間違いになることは決してありません。最終的な判断を下すのはインデックスではなく、ドキュメントだからです。
explain で確認できます。
{"cmd": "explain", "inner": {"cmd": "find", "collection": "yerler", "query": {"konum": {"$near": {
  "$geometry": {"type": "Point", "coordinates": [28.9741, 41.0256]}, "$maxDistance": 3000}}}}}
{"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": "(range/in conditions)", "collection_docs": 15,
"candidates": 8, "examined": 8, "returned": 7, "post_filter": true, "post_filter_ops": [], "sort": "none",
"duration_ms": 0.005}}候補 8 件、結果 7 件です。却下された候補はカドゥキョイのフェリー乗り場です。カバー内のセル sxk9h にありますが、ガラタ塔から 3 km 以上離れています。インデックスが候補に挙げ、検証が外したわけです。
この「インデックスはヒントであって真実ではない」という約束は、ディスクモードではさらに重要になります。0.38 以降のデフォルトであるディスクファーストのコレクションでは、インデックスは 2 層になっています。mmap で開かれるソート済みの .geoidx ベースと、前回の永続化以降の書き込みを持つ小さなインメモリのオーバーレイです。ドキュメントが移動したり削除されたりすると、古いベースのエントリは dead セットに入ります。クエリはそれをスキップし、次の永続化のタイミングでベースとオーバーレイがマージされて新しいファイルになり、古いファイルをアトミックに置き換えます。仮に古いエントリが何らかの形ですり抜けたとしても、そのドキュメントは検証で落ちるので、結果はやはり正しいままです。正常にシャットダウンした後なら、オープンは一瞬です。ドキュメントのスキャンはなく、mmap するだけです。オープン時にはファイルもチェックされます。マジックやバージョンが違ったり、ファイルが途中で切れていたりすれば拒否され、インデックスはドキュメントから再構築されます。クラッシュリカバリの後も再構築されます。RAM 上のコレクション(OXIDB_DISK_FIRST=0 で起動したもの)はインデックスの定義だけを永続化し、オープン時に 1 回のドキュメントスキャンでインデックスを再構築します。
サーバーを再起動して、インデックスが残っていて同じプランを生成すること(同じ 145 件の候補、同じ 27 件の結果)を確認しました。インデックスが更新に追従することも確認しました。$set でトプカプ宮殿をアンカラの座標に移動するとアヤソフィア周辺 1.5 km のクエリから外れ、元に戻すと再び現れました。
どれくらい効くのか
マルマラ地方(経度 26 から 31、緯度 39.5 から 42)にランダムな点を 100,000 個挿入し、同じデータに対して同じクエリをインデックスありとなしで実行しました。Apple M4 の Mac でローカルサーバーに対して計測しています。
| クエリ(100,000 点) | インデックスなし | geohash インデックス |
|---|---|---|
ガラタ周辺 3 km の $near:調べたドキュメント数 | 100,000 | 候補 145 件 |
| 結果 | 27 | 27 |
| クライアントから計測した時間の中央値(20 回) | 40.9 ms | 0.084 ms |
アヤソフィア周辺 10 km の $geoWithin:調べたドキュメント数 | 100,000 | 候補 527 件 |
| 結果 | 270 | 270 |
| クライアントから計測した時間の中央値(20 回) | 34.0 ms | 0.224 ms |
時間は Python から TCP 経由で、JSON のデコードも含めて計測しました。本当に重要なのは「結果」の行です。インデックスがあってもなくても答えは同じです。これこそがプロジェクトのテスト(tests/geo_queries.rs)が確認していることです。インデックスを使ったクエリは、挿入、更新、削除、再オープンを通じて、インデックスなしのスキャンと同じ結果を返さなければなりません。
カバーには下限もあります。形が大きすぎて、最も粗い精度でも 64 セルで覆えない場合(たとえば地球の半分)、カバーは「制限なし」を返し、クエリはフルスキャンにフォールバックします。距離の上限のない $near も同じです。すべてのドキュメントが候補になり、それから全件が並べ替えられます。遅いですが、正直なプランです。
グラフクエリ
地理の側が「どこに?」に答えるなら、グラフの側は「何とつながっている?」に答えます。OxiDB には独立したグラフのデータモデルはありません。ノードは通常のドキュメントで、エッジはドキュメント内の参照フィールド(たとえば ID の配列)か、別のエッジコレクション内のドキュメントです。これを 2 つのステージでカバーします。$graphLookup(到達可能性、BFS)と $shortestPath(最短経路、ダイクストラ法)です。
例として、小さな航空路線網を作りました。トルコの 11 の空港と 22 の路線です。空港の座標は実在のもので、エッジの重みはその座標から計算した大円距離(km)です。路線自体は実際の時刻表ではなく、私が選んだ例としてのネットワークにすぎません。
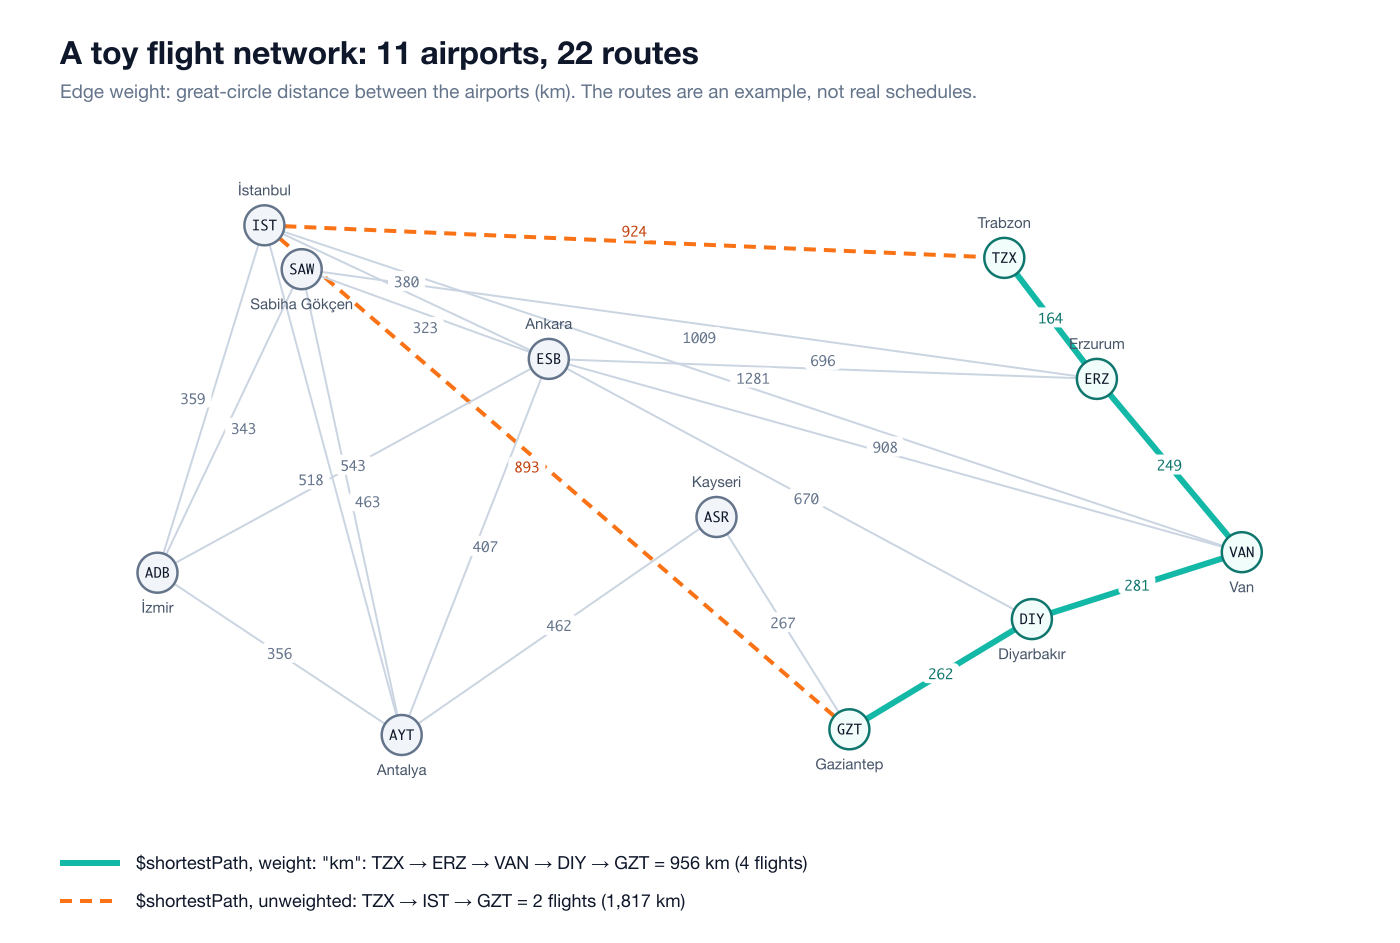
コレクションは 2 つあります。havalimanlari(「空港」)はノードを保持し、それぞれが隣接する空港のコードを配列(baglanti、「接続」)で持っています。ucuslar(「フライト」)はエッジコレクションです。
{"cmd": "find_one", "collection": "havalimanlari", "query": {"kod": "VAN"}}
{"ok": true, "data": {"kod": "VAN", "ad": "Van Ferit Melen", "konum": [43.3323, 38.4682],
  "baglanti": ["DIY", "ERZ", "ESB", "IST"], "_id": 8, "_version": 1}}
{"from": "TZX", "to": "ERZ", "km": 164}
{"from": "ERZ", "to": "VAN", "km": 249}
{"from": "IST", "to": "TZX", "km": 924}接続に使うフィールド、havalimanlari.kod、ucuslar.from、ucuslar.to には通常のインデックスを張りました。それがなぜ重要なのかはすぐにわかります。
$graphLookup:幅優先探索
$graphLookup は MongoDB と同じステージです。startWith の値から出発し、connectToField がそれに等しいドキュメントを見つけ、次にそれらの connectFromField の値から探索を続けます。「ヴァンから乗り継ぎ 1 回以内でどこへ飛べるか?」(aktarma は「乗り継ぎ」という意味です)。
{"cmd": "aggregate", "collection": "havalimanlari", "pipeline": [
  {"$match": {"kod": "VAN"}},
  {"$graphLookup": {"from": "havalimanlari", "startWith": "$baglanti",
     "connectFromField": "baglanti", "connectToField": "kod",
     "as": "erisilen", "depthField": "aktarma", "maxDepth": 1}},
  {"$unwind": "$erisilen"},
  {"$project": {"_id": 0, "kod": "$erisilen.kod", "aktarma": "$erisilen.aktarma"}},
  {"$sort": {"aktarma": 1, "kod": 1}}
]}
{"ok": true, "data": [
{"kod": "DIY", "aktarma": 0}, {"kod": "ERZ", "aktarma": 0}, {"kod": "ESB", "aktarma": 0}, {"kod": "IST", "aktarma": 0},
{"kod": "ADB", "aktarma": 1}, {"kod": "AYT", "aktarma": 1}, {"kod": "GZT", "aktarma": 1},
{"kod": "SAW", "aktarma": 1}, {"kod": "TZX", "aktarma": 1}, {"kod": "VAN", "aktarma": 1}
]}maxDepth: 0 なら直行便(DIY、ERZ、ESB、IST)だけが返ります。maxDepth を指定しなければ、新しいものが見つからなくなるまで探索が続き、11 件のドキュメントが返ります。カイセリ(ASR)はラウンド 2 で現れます。VAN 自体がラウンド 1 に現れていることに注意してください。ヴァンからアンカラへ飛んで戻ってこられるので、VAN は実際に到達可能なのです。MongoDB も同じ挙動です。出発地のドキュメントが不要なら、後でフィルターして除いてください。
内部:ラウンドごとに $in を 1 回
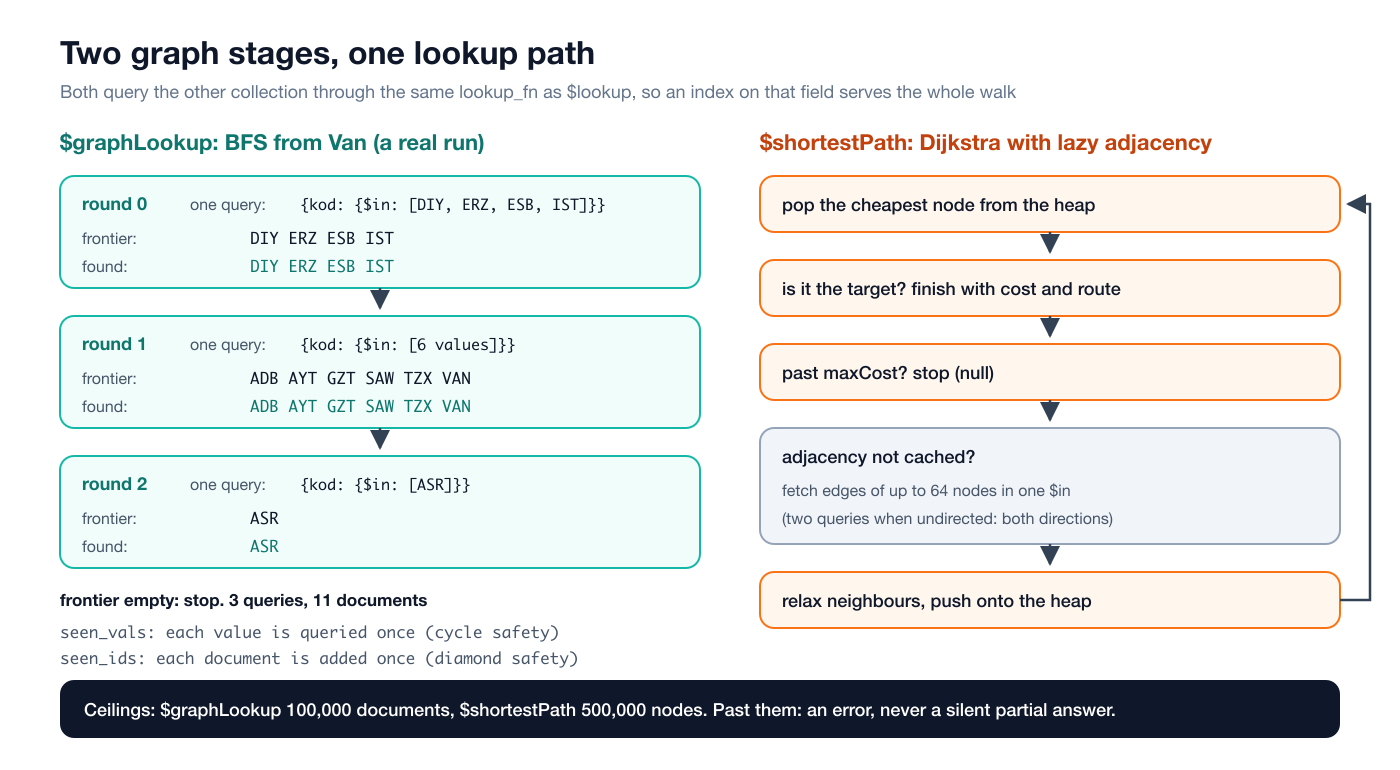
$graphLookup の最も重要な性質は、BFS の各ラウンドが 1 回のクエリ であることです。あるラウンドのフロンティアの値はすべて、1 つの {connectToField: {$in: [...]}} クエリにまとめられます(restrictSearchWithMatch が指定されていれば $and で包まれます)。このクエリは $lookup が使うのと同じ lookup_fn を通るので、connectToField に張った通常のインデックスが探索全体に効きます。ヴァンの例では、探索全体がクエリ 3 回で済みます。ラウンド 0 で 4 つの値、ラウンド 1 で 6 つ、ラウンド 2 で 1 つです。ラウンド 3 ではフロンティアが空になり、探索は止まります。ノードごとに 1 回クエリを発行する素朴な実装なら、同じ仕事に 11 回のクエリを送っていたでしょう。大きなグラフでは、この差は数千回の単位になります。
循環に対する安全性は 2 つの別々の集合から来ており、それぞれに固有の役割があります。
seen_vals:すでにクエリした接続の 値。1 つの値がクエリされるのは最大 1 回です。この集合がなければ、循環(A が B をフォローし、B が C をフォローし、C が A をフォローする)が永遠に再クエリされてしまいます。seen_ids:すでに集めたドキュメントの ID。1 つのドキュメントが結果に現れるのは最大 1 回です。この集合がなければ、ひし形(A→B→D と A→C→D)で D が 2 回返されてしまいます。
小さなフォローグラフで試しました。ayşe は mehmet をフォローし、mehmet は zeynep をフォローし、zeynep は ayşe と can の両方をフォローしています。循環があります。
{"cmd": "aggregate", "collection": "takip", "pipeline": [
  {"$match": {"kisi": "ayse"}},
  {"$graphLookup": {"from": "takip", "startWith": "$takip", "connectFromField": "takip",
     "connectToField": "kisi", "as": "ag", "depthField": "d"}},
  {"$unwind": "$ag"},
  {"$project": {"_id": 0, "kisi": "$ag.kisi", "d": "$ag.d"}}
]}
{"ok": true, "data": [{"kisi": "mehmet", "d": 0}, {"kisi": "zeynep", "d": 1}, {"kisi": "can", "d": 2}, {"kisi": "ayse", "d": 2}]}探索は終了し、全員が 1 回ずつ現れます。
枝刈り:restrictSearchWithMatch
restrictSearchWithMatch は最後ではなく、探索の 途中で 適用されます。フィルターに合格しないドキュメントは結果から除かれるだけでなく、探索がその先へ進むための扉でもなくなります。「イスタンブールやアンカラで乗り継がずに、トラブゾンからどこへ行けるか?」。
{"$graphLookup": {"from": "havalimanlari", "startWith": "$baglanti",
   "connectFromField": "baglanti", "connectToField": "kod", "as": "erisilen", "depthField": "aktarma",
   "restrictSearchWithMatch": {"kod": {"$nin": ["IST", "SAW", "ESB"]}}}}
{"ok": true, "data": [
{"kod": "ERZ", "aktarma": 0}, {"kod": "TZX", "aktarma": 1}, {"kod": "VAN", "aktarma": 1},
{"kod": "DIY", "aktarma": 2}, {"kod": "GZT", "aktarma": 3}, {"kod": "ASR", "aktarma": 4},
{"kod": "AYT", "aktarma": 5}, {"kod": "ADB", "aktarma": 6}
]}エルズルム経由で東へ、それから南へ進むしかなく、イズミルには 6 回の乗り継ぎの後に到達します。フィルターはステージを構築するときに 1 回だけパースされるので、壊れたフィルターは探索の最初のラウンドではなく、パイプラインの構築時に失敗します。maxDepth も同じで、-1 を渡すとすぐに invalid pipeline: $graphLookup maxDepth must be a non-negative integer が返ります。
実用上の注意を 1 つ。startWith と connectFromField は配列でも構いません(各要素がそれぞれ独立した値としてフロンティアに入ります)が、connectToField での照合は等価比較です。対象のドキュメントでは、connectToField にはスカラー値を持たせるべきです。私が隣接リストを baglanti 配列に、照合されるフィールドをスカラーの kod にしたのはそのためです。
声高にエラーを出す上限
グラフは予想よりはるかに大きくなることがあります。ソーシャルネットワークでは、「フォロワーのフォロワー」は 2 ホップで数百万に達することがあります。$graphLookup には、入力ドキュメント 1 件あたり 100,000 ドキュメントという上限があります。それを超えると 黙って部分的な結果を返すことはせず、エラーを返します。部分的な答えとは、正しそうに見える間違った答えだからです。
試すために、フォロワーが 100,001 人いるアカウントを 1 つ作りました。
{"cmd": "aggregate", "collection": "yildiz", "pipeline": [
  {"$match": {"kullanici": "merkez"}},
  {"$graphLookup": {"from": "yildiz", "startWith": "$kullanici", "connectFromField": "kullanici",
     "connectToField": "takip", "as": "takipciler"}},
  {"$project": {"_id": 0, "n": {"$size": "$takipciler"}}}
]}
invalid pipeline: $graphLookup found more than 100000 documents for one input document - narrow the traversal with maxDepth or restrictSearchWithMatch(実際のメッセージには、ソースコードの行継続の名残で余分な空白が入っています。ここでは単一の空白にまとめました。小さな見た目上の欠点です。)エラーは約 156 ms で返ってきました。メモリ不足になるよりずっと前に上限が効くわけです。同じクエリに restrictSearchWithMatch: {"kullanici": {"$in": ["u1", "u2", "u3"]}} を加えると、{"n": 3} が返りました。
$shortestPath:エッジコレクション上のダイクストラ法
$shortestPath は MongoDB のステージではありません。意図的にグラフデータベースの領域へ踏み込む追加機能です。各入力ドキュメントについて source と target の式を評価し、from コレクション内のエッジに対してダイクストラ法を実行します。各エッジは {edgeFrom: node, edgeTo: node, weight: number} 形式のドキュメントです。
まずは重みなし、つまりフライトの回数を最小化する場合です。トラブゾンからガズィアンテプへ(rota は「ルート」、maliyet は「コスト」です)。
{"$shortestPath": {"from": "ucuslar", "source": "$kod", "target": "GZT",
   "edgeFrom": "from", "edgeTo": "to", "undirected": true, "as": "rota", "costField": "maliyet"}}
{"ok": true, "data": [{"kod": "TZX", "maliyet": 2.0, "rota": [
{"from": "IST", "to": "TZX", "km": 924}, {"from": "IST", "to": "GZT", "km": 893}]}]}フライトは 2 回ですが、イスタンブール経由で 1,817 km です。次に weight: "km" を加えます。
{"$shortestPath": {"from": "ucuslar", "source": "$kod", "target": "GZT",
   "edgeFrom": "from", "edgeTo": "to", "undirected": true, "as": "rota", "costField": "maliyet",
   "weight": "km"}}
{"ok": true, "data": [{"kod": "TZX", "maliyet": 956.0, "rota": [
{"from": "TZX", "to": "ERZ", "km": 164}, {"from": "ERZ", "to": "VAN", "km": 249},
{"from": "DIY", "to": "VAN", "km": 281}, {"from": "GZT", "to": "DIY", "km": 262}]}]}フライトは 4 回ですが、距離はわずか 956 km です。トラブゾン、エルズルム、ヴァン、ディヤルバクル、ガズィアンテプ。rota 配列は、出発地から目的地までのエッジのドキュメントを順番に並べたものです。undirected: true ではエッジをどちらの向きにも使えますが、ドキュメントは 格納されたとおりに 返ってきます。ルートは VAN から DIY へと使ったのに、{"from": "DIY", "to": "VAN"} のエッジがこう見えるのはそのためです。向きは並びの順序から読み取ってください。
その他のパラメーターです。
restrictSearchWithMatch:エッジに適用されるフィルターです。イズミルからヴァンへの最短ルートはアンカラ経由の 1,451 km(ADB、ESB、VAN)です。{"from": {"$nin": ["ESB"]}, "to": {"$nin": ["ESB"]}}でアンカラのエッジを除外すると、サビハ・ギョクチェンとエルズルム経由の 1,601 km になります。maxCost:コストがこの値を超えると探索を止めます。同じイズミルからヴァンへのクエリにmaxCost: 1200を付けると、{"maliyet": null, "rota": []}が返りました。ヒープは常に最もコストの低いノードを返すので、ヒープの先頭が上限を超えたなら他のすべても超えています。止めても安全です。undirectedを指定しない場合(デフォルトはfalse)、エッジは格納された向きにしか使えません。私のネットワークにはトラブゾンからガズィアンテプへの有向パスがないので、答えはmaliyet: nullになります。- 出発地と目的地が同じ場合は「到達不能」ではなく、長さゼロのパスです。
ISTからISTはmaliyet: 0.0、rota: []になります。
内部:遅延隣接リスト
ダイクストラ法そのものは教科書どおりで、確定の順序が損なわれることは決してありません。ヒープは常に、未確定のノードの中で最もコストの低いものを返します。バッチ化されているのはデータの取得です。最もコストの低いノードの隣接リストがまだキャッシュされていなければ、隣接リストをまだ取得していない他のヒープ上のノード最大 63 個とまとめられ、それらのエッジがすべて 1 回の $in クエリ で返ってきます(undirected のときは向きごとに 1 回ずつで 2 回)。このクエリも $lookup や $graphLookup と同じ lookup_fn を通るので、edgeFrom と edgeTo のインデックスが探索に効きます。一度取得した隣接リストはキャッシュに残ります。
キーワードは「遅延」です。エッジコレクションが丸ごとメモリに読み込まれることは決してありません。取得されるのは、探索が実際に触れたノードの隣接リストだけです。目的地が近ければ、数百万のエッジを持つエッジコレクションであっても、数回のクエリで済みます。
ダイクストラ法の正しさは重みが非負であることに依存しており、それを黙って仮定するのではなく、チェックしています。
invalid pipeline: $shortestPath: negative or non-finite weight -2 - Dijkstra requires non-negative weights数値の重みを持たないエッジもエラーになります。
invalid pipeline: $shortestPath: edge has no numeric 'ucret' weight: {"from":"TZX","to":"ERZ","km":164,"_id":21,"_version":1}負の maxCost も同様です($shortestPath maxCost must be a non-negative number)。そして $graphLookup と同じく上限があり、確定済みノード 500,000 個です。それを超えるとやはりエラーになり、メッセージにはどうすればよいかが書かれています。maxCost か restrictSearchWithMatch で探索を制限してください、と。これを個別に発生させるために 500,000 ノードのグラフを作ることはしませんでした。値はソースコード(MAX_SETTLED)にあります。
制限と正直なトレードオフ
- 点のみです。 ドキュメントに線(LineString)やポリゴンを格納して「この道路はこの領域を横切るか?」と聞くことはできません。ポリゴンはクエリ側にはありますが、データ側にはありません。これは v1 の意識的なスコープです。位置データのほとんどは点(ユーザー、車両、店舗、センサー)だからです。
- ポリゴンは平面で計算します。 ジオフェンスの規模では正しいですが、大陸規模では正しくありません。経度で 180 度より広いポリゴンは拒否され、
$boxは日付変更線をまたいで折り返しません。 - インデックスを使う地理述語はクエリごとに 1 つです。 クエリに複数の地理述語がある場合、最初のものが候補を生成し、残りは検証の段階でチェックされます。ただし通常のインデックスとの組み合わせはうまく動きます。
turにもインデックスを張った後、{"tur": "kule", "konum": {"$near": ... 3 km}}の explain では候補が 2 件と表示されました。2 つのインデックスの候補集合の積がとられたのです。 - 上限のない
$nearはフルスキャンを意味します。$maxDistanceがなければインデックスはカバーを計算できず、すべてのドキュメントが候補になってから並べ替えられます。大きなコレクションでは必ず距離の上限を指定するか、limitと組み合わせて使ってください。 $nearはメモリ上で並べ替えます。 並べ替えは候補集合を検証した後、メモリ上で行われます。カバーが小さければ無視できますが、上限のないクエリではそうはいきません。- グラフステージは入力ドキュメントごとに実行されます。 1,000 件のドキュメントを返す
$matchの後に$graphLookupを置けば、1,000 回の別々の BFS になります。先に絞り込んでください。 $shortestPathには非負の重みが必要です。 負のエッジのためのベルマン-フォード法はなく、エラーになります。- 最短経路は 1 つです。 複数のパスが同点の場合は 1 つが返されます。k 最短経路や全経路の列挙はありません。
OxiDB の他の部分との関係
地理クエリとグラフクエリは独立したエンジンではなく、ドキュメントエンジンのクエリ言語の一部です。そのため、他のすべての機能と自然に組み合わせられます。同じパイプラインの中で、$geoNear の後に $group、$graphLookup の後に $lookup を置けます。位置は結局のところ通常のフィールドであり、更新、削除、インデックスの保守は、ドキュメントエンジンの他の部分と同じ経路をたどります。
同じエンジンは WebAssembly にもコンパイルできます。地理グローブのデモがまさにそれを実際に動かしているものです。GeoNames の居住地データがブラウザのタブ内の OxiDB に読み込まれ、地球儀をクリックすると本物の $near が実行され、スライダーをドラッグすると $centerSphere を使った $geoWithin が実行されます。ルートモードでは、2 回のクリックを $near で道路グラフにスナップし、$shortestPath(ダイクストラ法)を 1 つの集計としてタブ内で実行します。サーバーはありません。
Redis で話したい方には、OxiMem 側に GEOADD、GEOSEARCH、GEODIST といった RESP の GEO コマンドがあります。そちらでは Redis 自身の設計(GEO キーは 52 ビットの geohash をスコアとするソート済みセット)に従いました。タイムスタンプ付きのデータについては時系列エンジンを、クエリを SQL で書きたい場合は SQL エンジンをご覧ください。類似度グラフなどはレコメンドエンジンの記事のテーマです。
試してみる
OxiDB は単一のバイナリです。いちばん簡単なのは、GitHub のリリースページから自分のプラットフォーム向けのビルドを入手するか、Docker イメージを使う方法です。サーバーを起動し、create_geo_index で位置フィールドにインデックスを張り、上のクエリを試してみてください。グラフには一切のセットアップが不要です。あなたのドキュメントはすでにノードであり、参照はすでにエッジです。ただし接続に使うフィールドにはインデックスを張るのを忘れないでください。$graphLookup と $shortestPath の速度は、ほぼ完全にそこにかかっています。
これからも、この記事で示したルールを守っていきます。クエリに正しく答えられないときは、おおよその答えではなく、明確なエラーを返します。