OxiDB Ledger エンジン:注文と fill のジャーナルのための固定幅ストリーム
取引所のジャーナル向けに書いた oxidb-ledger crate を紹介します。40 バイトの固定レコード、エンジンが割り当てるシーケンス、mmap されたセグメント、ファイル削除によるリテンション、ストリームごとの fsync。実測値と見つけた 2 つのバグも載せています。
このシリーズでここまで紹介してきたエンジンは、どれも稼働中のサーバーの中で、ポート番号の向こう側に住んでいました。今回のエンジンは違います。oxidb-ledger は OxiDB リポジトリの中に自前のテストとともに置かれている若い crate ですが、まだワークスペースには追加されておらず、どこからも呼ばれていません。0.44.2 のサーバーには、これを有効にする環境変数もワイヤコマンドもありません。それでも 1 本の記事を割いたのは、OxiDB を取引所の裏側に置くという取り組みの中で最も興味深い設計判断がここに詰まっているからです。そしてエンジン自体は小さく、3 つのファイル、約 1650 行の Rust です。以下では、なぜ独立したエンジンが欲しかったのか、レコードがバイト単位でどう配置されるのか、そしてセグメント、リテンション、fsync、読み取りパスがどう動くのかを説明します。サーバーが公開していないので、すべての例は、crate のソースファイルを変更せずにマウントする小さな Rust プロジェクトを通して、私自身のマシンで実行しました。出力はすべて本物です。その過程で 2 つのバグを見つけたので、終盤で何も隠さずに取り上げます。
なぜ独立したエンジンなのか
OxiDB を暗号資産や証券の取引所のデータレイヤーとして位置づけたとき、docs/exchange-readiness.md は最初に線を引きました。マッチングエンジンはデータベースの仕事ではない、ということです。実際の取引所は、シングルスレッドのインメモリのイベントループ(LMAX モデル)で注文をマッチングします。OxiDB はその背後にある、永続的で一貫性のあるレイヤーです。注文、約定、ジャーナルの永続化、残高台帳、マーケットデータ、そして冪等なリクエスト処理を担います。
現在、このレイヤーはドキュメントエンジンとそのトランザクションの上に作られています。リポジトリにある tests/live-exchange の例は、10 個のトレーダープロセスと銘柄ごとに 1 つのマッチャーで、本物の取引所を動かします。各 fill(注文のうち、実際に他の注文と約定した部分)は 1 つのアトミックなトランザクションで決済されます。2 人のユーザーの間で USD と資産を移動し、約定を insert し、複式簿記のジャーナルを書き、銘柄の価格を最後の約定値に設定します。その後の検証ステップで、お金が生み出されていないこと、ジャーナルの貸借が一致していること、そしてすべての残高をジャーナルから再構築できることを確認します。README によると、この構成はラップトップ上の lazy-sync モードで毎秒約 150 件の約定を処理します。
残高台帳にとっては、これが正しい道具です。送金は複数のドキュメントをまとめて変更し、分離性を必要とします。しかし取引所はほかに 2 つの記録を持っており、それらの形はまったく異なります。
- 注文ジャーナル: 受け付けたすべての注文の、変更不可能な記録です。確認応答(アクノリッジ)が意味を持つのは、この記録がディスク上にある場合だけです。
- fill ジャーナル: すべてのマッチの記録です。誰が誰と、いくらで、どれだけの量を取引したか。
この 2 つの共通点は、追記専用で決して更新されず、その形は場立ちの時代から変わっておらず、順序は神聖で、古い部分はしばらくすると一括で捨てられる、ということです。このワークロードを汎用の構造(B-tree、ドキュメントストア、SQL テーブル)に載せると、3 つのコストを払うことになります。
- 追記のコストが履歴とともに増える。 B-tree への insert は、履歴全体にまたがる構造を最新に保つことを意味します。
- すべてのレコードがエンコードされる。 ドキュメントや行のエンコーディング、フィールド名、長さプレフィックス、レコードごとのアロケーション。
- リテンションがスキャンと書き換えになる。 「1 か月分を削除する」とは、その月のすべての行を見つけて削除し、インデックスを更新することを意味します。
oxidb-ledger は、この 3 つすべてを設計によって取り除くために書かれました。crate の説明文は 1 行でこう言っています。「append-only fixed-width streams with segment retention, for order and fill journals」(注文と fill のジャーナルのための、セグメント単位のリテンションを備えた追記専用の固定幅ストリーム)。
現状:コードにはあるが、サーバーにはない
シリーズの他の記事と違うので、最初にはっきりさせておきます。
- この crate は 2026 年 9 月 7 日付の単一のコミットで入りました。コミットメッセージは明快です。「A new crate, not yet in the workspace and not referenced by anything.」(新しい crate。まだワークスペースに入っておらず、何からも参照されていない。)
oxidb-ledger/srcにはschema.rs、segment.rs、log.rsがありますが、lib.rsはありません。ルートのCargo.tomlはこれをメンバーとして列挙しておらず、oxidb-serverも依存していません。- 0.44.2 のサーバーバイナリには「ledger」という単語が一度も現れません(
strings oxidb-server | grep -ci ledgerは 0 を出力します)。ワイヤプロトコル、REST、PostgreSQL 互換ポートのどれも、これを公開していません。
とはいえ、ソースのコメントを見ると向かう先はわかります。フィールド種別の判別値は「ワイヤエンコーディング」として定義されており、スキーマは「これらのバイトとしてソケットを越える」と書かれ、verify は「verify コマンドが実行するもの」と説明されています。目指しているのは、クライアントが書き込まれるのとまったく同じバイト列でレコードをソケット越しに送るワイヤインターフェースです。そのインターフェースはまだ書かれていません。
そこで私は、リポジトリのファイルに手を触れずに、別の Cargo プロジェクトからエンジンをモジュールとしてマウントしました。
// harness/src/lib.rs
// oxidb-ledger ships three modules and no lib.rs yet. This mounts the repo's
// files unchanged as modules of one library, so crate::schema and
// crate::segment resolve as they would in the real crate.
#[path = "../OxiDB/oxidb-ledger/src/schema.rs"]
pub mod schema;
#[path = "../OxiDB/oxidb-ledger/src/segment.rs"]
pub mod segment;
#[path = "../OxiDB/oxidb-ledger/src/log.rs"]
pub mod log;
依存関係は crate 自身の Cargo.toml と同じで、crc32fast、memmap2、そしてテスト用の tempfile です。この構成では crate 自身のユニットテストも実行でき、その結果については後で触れます。
データモデル:ストリーム、レコード、シーケンス
このエンジンにある概念は 1 つだけ、ストリーム です。ストリームは名前付きのレコードの列で、ルートの下に自分のディレクトリを持ち、スキーマは作成された瞬間に固定されます。取引所なら orders と fills という 2 つのストリームを思い浮かべてください。
固定幅、固定レイアウト
このエンジンのすべてのレコードは、固定幅で固定レイアウトです。これが設計全体の土台です。追記は、すでに空きのあるバッファへの copy_from_slice であり、スキャンは既知のストライドでメモリをたどっていくことです。行のエンコーディングも、フィールドごとの長さプレフィックスも、レコードごとのアロケーションもなく、書き込みパスにも読み取りパスにもパースするものが何もありません。
その代償は、ドキュメントストアが与えてくれる柔軟性です。レコードにフィールドを追加することはできず、フィールドが欠けることもできません。注文ジャーナルと fill ジャーナルにとって、これは損失ではありません。ソースにあるコメントが私は好きです。fill の形を変える取引所は、ストレージエンジンが何をしようとマイグレーションを抱えることになる、というものです。
フィールドの種別は 8 つあります。I8、U8、I16、U16、I32、U32、I64、U64 です。ストリームは seq と ts に加えて最大 16 個のフィールドを宣言できます。これはストレージの制限ではなくクエリの制限です。述語は固定長の配列に保持され、その評価でアロケーションが発生しないようにするためです。レコードの幅は最大 4 KiB です。この上限は、ソケットから届いたスキーマが際限のないサイズのセグメントを要求するのを防ぎます。
2 つの必須フィールド
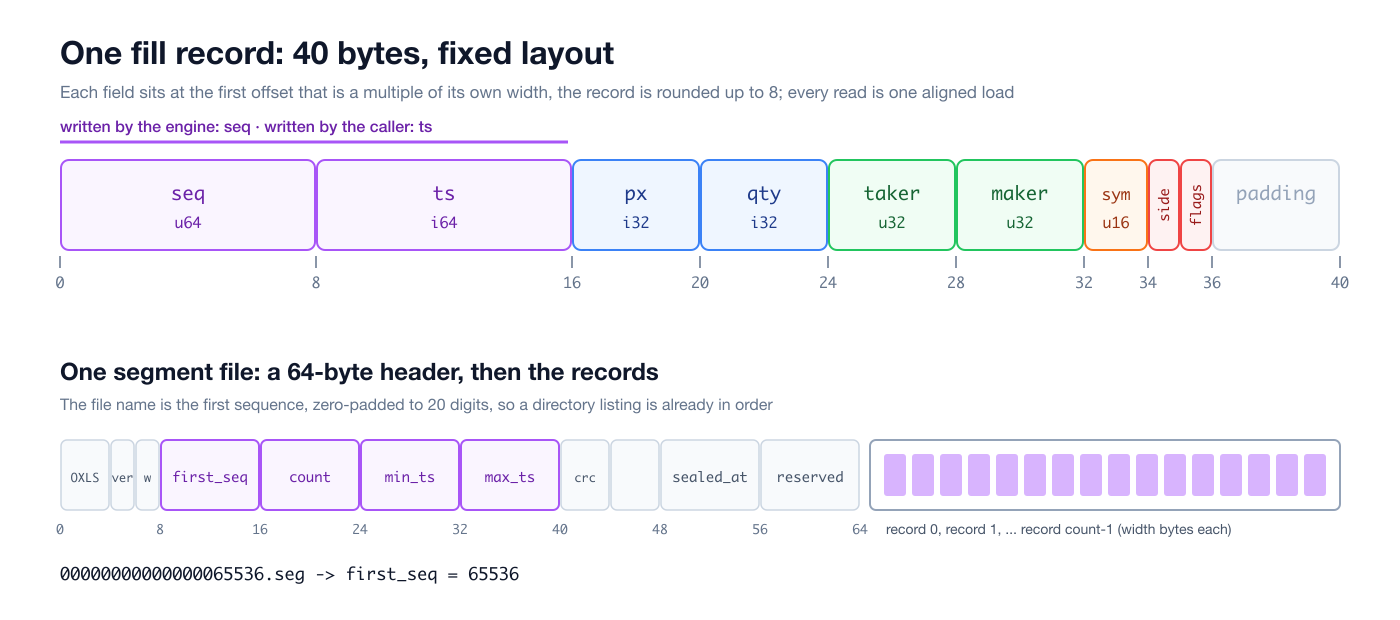
すべてのレコードは u64 のシーケンス(seq、オフセット 0)と i64 のタイムスタンプ(ts、オフセット 8)で始まります。これらは宣言されるものではなく、エンジンが予約しています。役割分担は次のとおりです。
- シーケンスを割り当てるのはエンジンであり、呼び出し側では決してない。 シーケンスは取引所自身による順序の表明です。「この fill はあの fill より前に起きた」。自分でシーケンスを選べるクライアントには、その表明の責任を負わせられません。シーケンスはストリーム内で密かつ単調増加なので、欠番はレコードの喪失を意味し、許容するよりも報告すべきものです。
- タイムスタンプは呼び出し側が渡す。 それを知っているのは呼び出し側だけだからです。市場は fill を、マッチしたマイクロ秒の時刻で刻印します。それはバッチがエンジンに届くよりも前の時刻であり、テープを分析する人が本当に欲しい数字です。
すべては i64 として読まれる
フィールドは宣言された幅で保存されますが、読み出し時には符号拡張またはゼロ拡張されて i64 になります。どちらにしてもロードは 1 回で、述語、集計、射影がすべて 8 つの型ではなく 1 つの型で動くことになります。代償は、i64::MAX を超える u64 が負の値として読まれることですが、台帳にそんなフィールドはありません。
書き込み時には、収まらない値は切り詰められるのではなく 拒否 されます。これは SQL エンジンが宣言された整数幅について行っているのと同じ選択で、理由も同じです。黙ってラップアラウンドした口座番号は、正しい答えのように見える間違った答えだからです。
パッキングのルールと 2 つの組み込みの形
seq と ts の後、各フィールドは自分の幅の倍数である次のオフセットに置かれ、レコードは 8 の倍数に切り上げられます。すべての読み出しは 1 回のアラインされたロードであり、レコードの配列もアラインされたままです。幅の大きいフィールドから先に宣言すれば、パディングは一切無駄になりません。
crate には shapes::fill() と shapes::order() の 2 つの形が同梱されています。fill は px(価格、i32)、qty(i32)、taker と maker(2 つの当事者、u32)、sym(銘柄、u16)、side(u8)、flags(u8)です。
私の実行でのスキーマの Debug 出力です。
== layout
fill  Schema(40 B, px@16:I32, qty@20:I32, taker@24:U32, maker@28:U32, sym@32:U16, side@34:U8, flags@35:U8)
order Schema(40 B, px@16:I32, qty@20:I32, account@24:U32, client@28:U32, order@32:U32, sym@36:U16, kind@38:U8, side@39:U8)
fill は 40 バイトなので、100 万件の fill は 40 MB です。注文レコードも 40 バイトになります。これについては後で触れます。crate 自身のテストは 48 を期待しているからです。
価格が i32 なのは意図的です。価格は整数のティックとして保存されます(私の例では 1/100 単位なので、6412350 は 64123.50 です)。お金を決して浮動小数点で持たないことは、帳簿をつけるあらゆるものの第一のルールです。
使い方:Rust API
ワイヤインターフェースがないので、現時点でエンジンを使う唯一の方法は Rust API です。ストリームの作成:
use ledger_harness::log::{Durability, Stream, DEFAULT_CAPACITY};
use ledger_harness::schema::{Schema, shapes};

let s = shapes::fill();
let mut st = Stream::create(root, "fills", s, DEFAULT_CAPACITY, Durability::Commit)?;
追記には、呼び出し側がすでにレイアウトした n * width バイトのバッファを渡します。エンジンは割り当てたシーケンスを各レコードの先頭 8 バイトに書き込み、それ以外には手を触れず、最初のシーケンスと件数を返します。
let w = s.width();
let mut buf = vec![0u8; 3 * w];
for (i, r) in buf.chunks_exact_mut(w).enumerate() {
    Schema::put_ts(r, t0 + i as i64 * 250);   // the caller's timestamp
    s.set(r, 0, 6_412_350)?;                  // px
    s.set(r, 1, 15)?;                         // qty
}
let (first_seq, count) = st.append(&mut buf)?;
小さな例で境界が見えるように、デモはセグメント容量を 4 レコードに減らして実行しました。
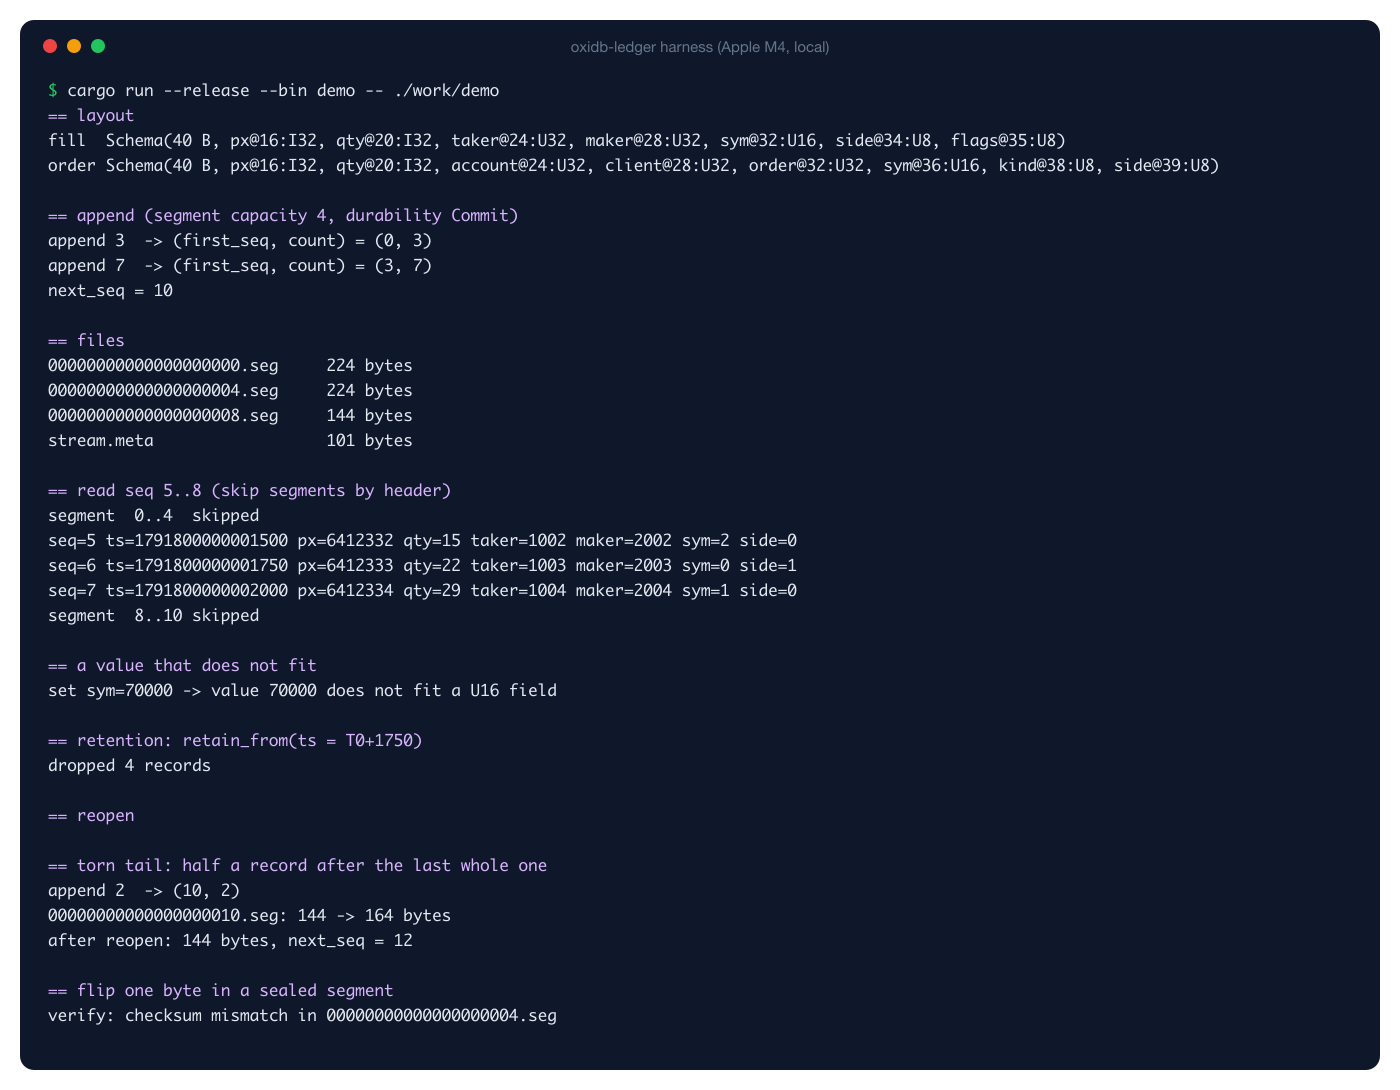
最初の 2 回の追記は (0, 3) と (3, 7) を返します。番号を配るのはエンジンで、前回の続きから進みます。7 件の 2 つ目のバッチは 4 レコードの境界を 2 回越えますが、拒否されるのではなく分割されます。
== append (segment capacity 4, durability Commit)
append 3  -> (first_seq, count) = (0, 3)
append 7  -> (first_seq, count) = (3, 7)
next_seq = 10
Stats { records: 10, segments: 3, bytes: 592, first_seq: 0, next_seq: 10, min_ts: 1791800000000000, max_ts: 1791800000002500, appended: 10, dropped: 0 }

== files
00000000000000000000.seg     224 bytes
00000000000000000004.seg     224 bytes
00000000000000000008.seg     144 bytes
stream.meta                  101 bytes
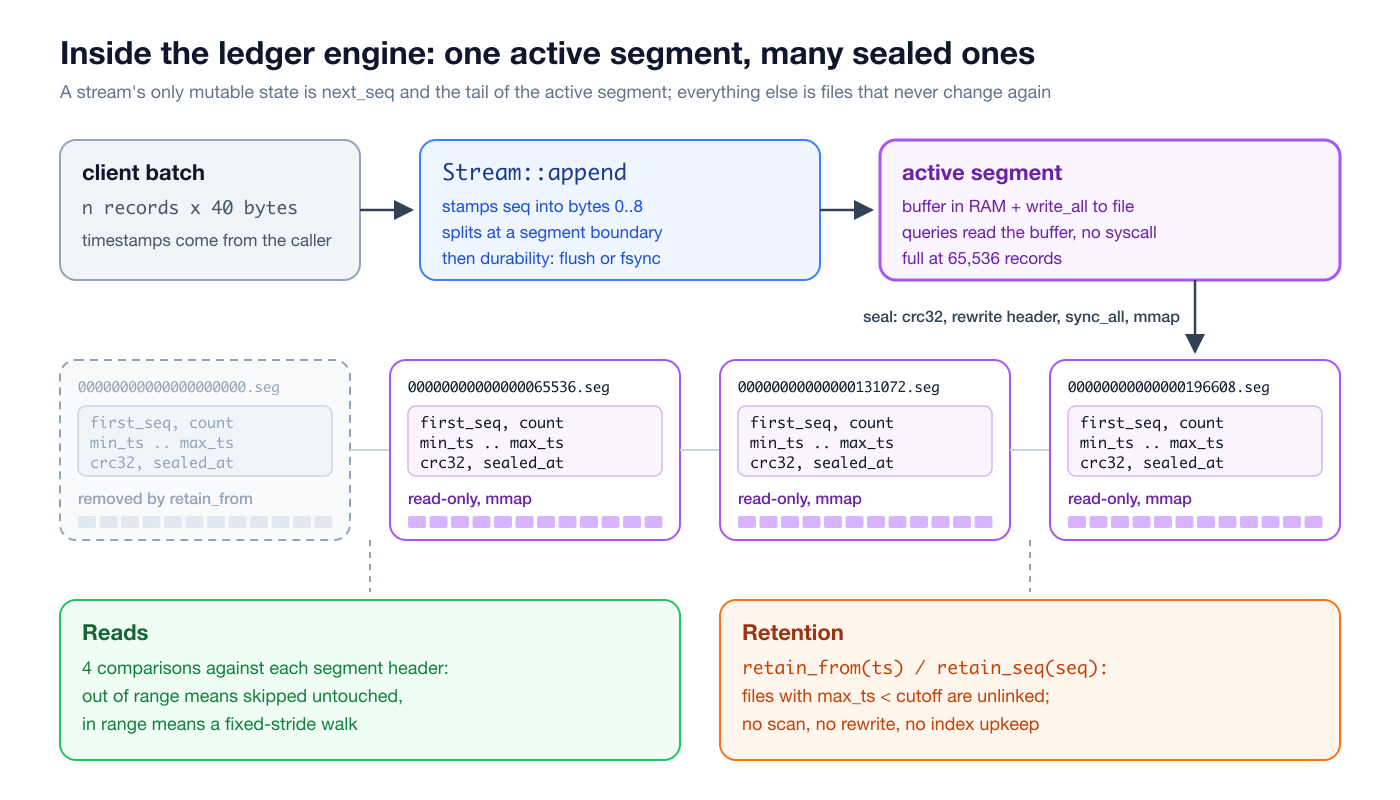
レコードは 2 つのセグメントにまたがってはいけないので、append はバッチを、それを入れるセグメントの数だけの断片に切り分けます。セグメントより小さいバッチなら 1 つ、たまたま境界をまたぐバッチなら 2 つです。
そして、収まらない値の拒否は本当に起きます。
== a value that does not fit
set sym=70000 -> value 70000 does not fit a U16 field
セグメント:安いものすべての単位
セグメントは 1 つのファイルで、ヘッダーの後に固定幅のレコードが続きます。前から後ろへ一度だけ書かれ、決して変更されません。レコード数が上限に達すると シール されます。ヘッダーが完成し、ファイルが sync され、マップされます。それ以降は、エンジンが知らないうちにカーネルがページインやページアウトできる読み取り専用のバイト列です。
ファイル名とヘッダー
セグメントのファイル名は、それが始まるシーケンスを 20 桁にゼロ埋めしたものなので、誰も何もパースせずにディレクトリが順番に並びます。ヘッダーは 64 バイトです。
| オフセット | フィールド | 意味 |
|---|---|---|
| 0 | magic OXLS | OxiDB ledger segment |
| 4 | version | 現在は 1 |
| 6 | width | レコード幅 |
| 8 | first_seq | 最初のレコードのシーケンス |
| 16 | count | レコード数(シールされるまで 0) |
| 24 | min_ts | 観測された最小のタイムスタンプ |
| 32 | max_ts | 観測された最大のタイムスタンプ |
| 40 | crc | レコードのバイト列の CRC32 |
| 48 | sealed_at | シール時の壁時計時刻(ms) |
デモのディレクトリにあるセグメントの先頭 104 バイトを xxd で見たものです。
00000000: 4f58 4c53 0100 2800 0800 0000 0000 0000  OXLS..(.........
00000010: 0200 0000 0000 0000 ca38 82f2 a15d 0600  .........8...]..
00000020: c439 82f2 a15d 0600 a64c ef3c 0000 0000  .9...]...L.<....
00000030: 8a27 eb2c a101 0000 0000 0000 0000 0000  .'.,............
00000040: 0800 0000 0000 0000 ca38 82f2 a15d 0600  .........8...]..
00000050: 2fd8 6100 2400 0000 ed03 0000 d507 0000  /.a.$...........
00000060: 0200 0100 0000 0000 ........OXLS、version 1、width 0x28 = 40、first_seq 8、count 2、続いて min_ts、max_ts、CRC、sealed_at です。64 バイト目から最初のレコードが始まります。seq 8、ts、価格 0x61d82f = 6412335、数量 0x24 = 36、taker 1005、maker 2005、sym 2、side 1。パーサーはありません。パースするものが何もないからです。
sealed_at には固有の存在理由があります。レコードの古さによるリテンションには max_ts を使いますが、sealed_at は書き込みの古さによるリテンションのためのものです。それは別の問いであり、レコード自身のタイムスタンプが信用できないときにオペレーターが問うものです。
アクティブセグメント
書き込み中のセグメントはファイルに書かれ、同時にメモリ上にも保持されます。この 2 つは別々の問いに答えます。ファイルは生き残るものであり、バッファはクエリがシステムコールなしで読むものです。デフォルトの容量である 40 バイトのレコード 65,536 件では、このバッファは 2.6 MB で、エンジンがストリームごとに保持するメモリのうち、マップされたファイルでないものはこれだけです。
ソースはこのデフォルト値を説明しています。2.6 MB のファイルは、細かい粒度のリテンションができるほど小さく(直近 1 分を残したいオペレーターは、直近 1 時間ではなく直近 1 分を得られます)、かつ追記が本当の仕事をする唯一の場所であるシールが、毎秒 35,000 レコードのとき絶え間なくではなく 1 秒に 2 回起きる程度には大きい、というものです。
追記のコストが一定であり続ける理由
ストリームの可変な状態のすべては、next_seq とアクティブセグメントの末尾だけです。それ以外はすべて、二度と変わらないファイルです。履歴全体にまたがって最新に保つべき構造はありません。コードで見ると、追記は次のことを行います。シーケンスを刻印し、extend_from_slice を 1 回、write_all を 1 回、まだ L1 で温かいバイト列をもう一度なめて最小と最大のタイムスタンプを追跡し、耐久性の設定に応じて flush か fsync を行います。そのどれも、それ以前にいくつのセグメントがあったかを見ません。
これも測定しようとしたのですが、結果については正直に述べる必要があります。詳細は後のパフォーマンスのセクションにあります。
オープン
ストリームを開き直すとき、シール済みセグメントのレコードは 1 件も読みません。64 バイトのヘッダーをそれぞれ読み、残りをマップし、最後のシールされていないセグメントだけをリプレイします。153 セグメントに 1000 万レコードを持つストリームは、私のマシンで約 25 ms で開きました。
耐久性:ストリームごとの 3 つの設定
耐久性はストリームごとに選びます。2 つのジャーナルが求める答えが違うからです。
| 設定 | 意味 |
|---|---|
Durability::Os | バイト列を OS に渡して先へ進みます。プロセスがクラッシュしても何も失いませんが、マシンがクラッシュするとページキャッシュがまだ書いていなかった分を失います。 |
Durability::Sealed | セグメントがシールされるときにディスクに届き、それより頻繁には届きません。ウィンドウは 1 セグメントです。 |
Durability::Commit | append が戻る前にディスクに届きます。確認応答が待つのはこれです。 |
ソースにある理由付けはこうです。fill ジャーナルは停電で最後の数ミリ秒を失っても構いません。fill はワイヤ上にも、ブラウザにも、時系列にもあるからです。注文ジャーナルはそうはいきません。その存在意義はすべて、確認応答が「注文は生き残る」を意味することにあり、それが真であるのは、確認応答が出ていく前に書き込みがディスクに届いた場合だけです。
これは OxiDB の他の部分と同じ姿勢で、OxiDB はデフォルトですべてのコミットで WAL とコミットログを fsync します(ドキュメントエンジンの記事 を参照)。シールは常に sync_all で終わるので、シール済みセグメントは設定にかかわらずディスク上にあります。
私が測定したもの(Apple M4 Mac、内蔵 SSD、macOS、各構成を 3 秒間、またはレコード数の上限まで):
Os      batch     1:    1443154 records in   3.00 s =      481051 rec/s,       2.1 us/append call
Os      batch    16:    4000000 records in   1.99 s =     2014745 rec/s,       7.9 us/append call
Os      batch   256:    4000000 records in   1.49 s =     2683801 rec/s,      95.4 us/append call
Os      batch  4096:    4001792 records in   0.62 s =     6440016 rec/s,     636.0 us/append call
Sealed  batch     1:    1481627 records in   3.00 s =      493876 rec/s,       2.0 us/append call
Sealed  batch    16:    4000000 records in   1.72 s =     2320832 rec/s,       6.9 us/append call
Sealed  batch   256:    4000000 records in   1.12 s =     3571360 rec/s,      71.7 us/append call
Sealed  batch  4096:    4001792 records in   0.69 s =     5761754 rec/s,     710.9 us/append call
Commit  batch     1:        733 records in   3.00 s =         244 rec/s,    4094.0 us/append call
Commit  batch    16:      11648 records in   3.00 s =        3881 rec/s,    4123.0 us/append call
Commit  batch   256:     161024 records in   3.00 s =       53622 rec/s,    4774.2 us/append call
Commit  batch  4096:     401408 records in   0.52 s =      770586 rec/s,    5315.4 us/append call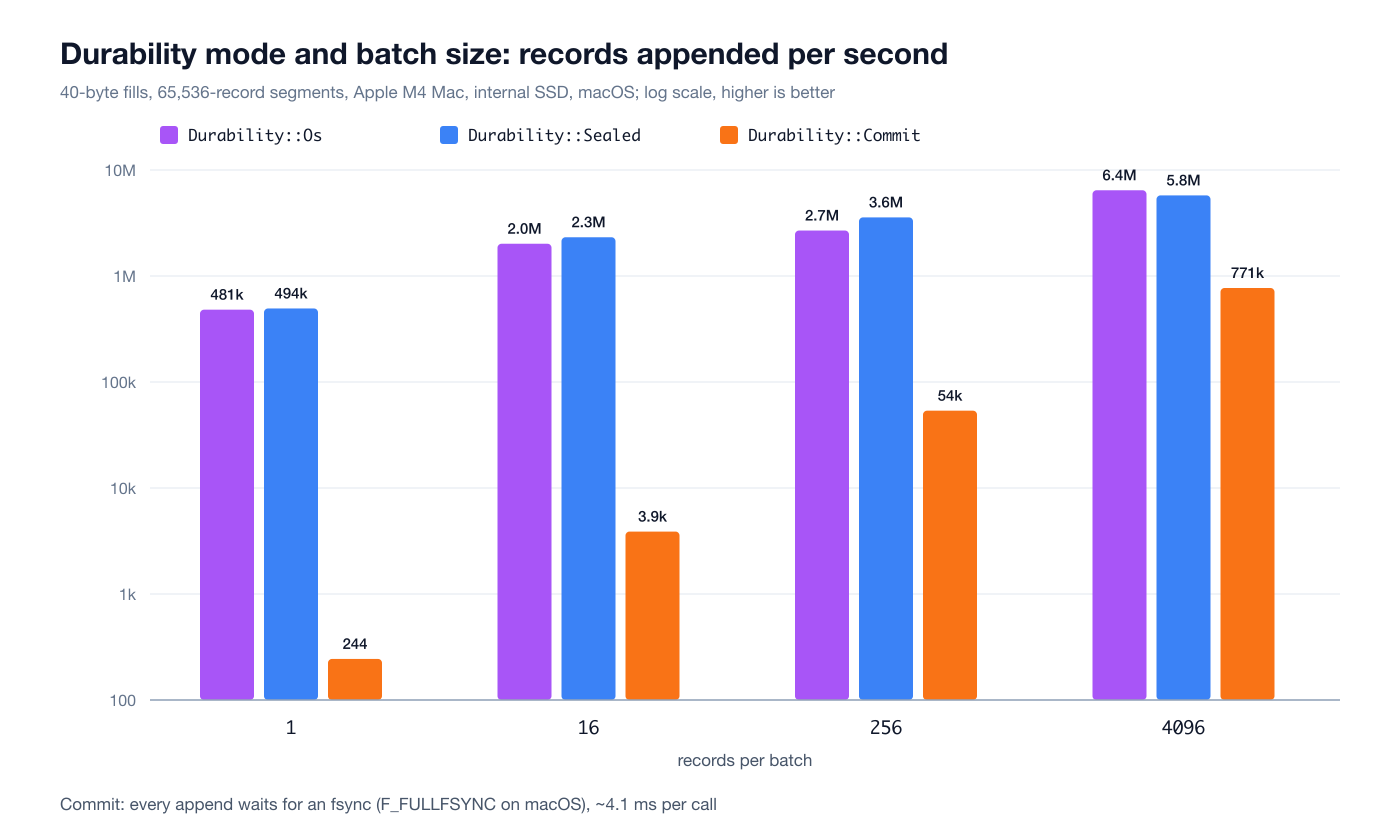
話ははっきりしています。
Commitモードでは 1 回の呼び出しに約 4.1 ms かかります。これはエンジンではなくF_FULLFSYNCです。Rust のsync_dataは macOS で、ドライブに自身の書き込みキャッシュをフラッシュさせるためにこれを使います。1 バッチ 1 レコードだと、毎秒 244 レコードになります。- 同じ fsync をより多くのレコードに分散させると、すべてが変わります。4096 レコードのバッチなら
Commitは毎秒 77 万レコードに達します。これは最も純粋な形のグループコミットであり、ワイヤインターフェースがクライアントがバッチでバイト列を送ることを前提に設計されている理由でもあります。 OsとSealedは 1 回の呼び出しあたりマイクロ秒単位のコストです。この 2 つがほぼ同じ結果になる理由については、「見つけたもの」のセクションで戻ってきます。
読み取り:シーケンス、時刻、フルスキャン
crate にはまだクエリ言語も述語評価器もありません。スキーマファイルにある 16 フィールドの制限は、そのために予約されています。現在あるのは読み取りの土台です。segments() はすべてのセグメントを、古い順に、ヘッダーとそれが記述するバイト列の組として返します。何もコピーされず、何もデコードされません。シール済みセグメントではバイト列は mmap そのもので、アクティブセグメントではメモリ上のバッファです。
セグメントを読む価値があるかどうかの判断は、ヘッダーに対する 4 回の比較です。
pub fn holds_seq(&self, from: u64, to: u64) -> bool {
    self.count > 0 && self.first_seq < to && self.end_seq() > from
}
pub fn holds_ts(&self, from: i64, to: i64) -> bool {
    self.count > 0 && self.min_ts < to && self.max_ts >= from
}範囲はどこでも半開区間です。holds_ts は最初と最後のレコードではなく、観測された最小と最大のタイムスタンプを使うので、レコードが順不同で届いたセグメントでも正しく答えます。
デモでは、シーケンス 5..8 を読むと、最初と最後のセグメントはヘッダーだけでスキップされます。
== read seq 5..8 (skip segments by header)
segment  0..4  skipped
seq=5 ts=1791800000001500 px=6412332 qty=15 taker=1002 maker=2002 sym=2 side=0
seq=6 ts=1791800000001750 px=6412333 qty=22 taker=1003 maker=2003 sym=0 side=1
seq=7 ts=1791800000002000 px=6412334 qty=29 taker=1004 maker=2004 sym=1 side=0
segment  8..10 skipped
シーケンスは密なので、セグメント内で 1 件のレコードを見つけるのに探索すら要りません。それは (seq - first_seq) * width の位置にあります。1000 万レコードのストリームからシーケンスで 1 件を読むのにかかった時間は 2.1 マイクロ秒でした。
== one record by sequence
seq 7654321 ts 1791807654321000 px 6412331 qty 48 in 2.1 us
時刻の範囲も同じように動きます。市場時間で約 2.8 時間にわたる 1000 万件の fill から 1 分間を求めると、153 セグメントのうち 151 個がヘッダーだけでスキップされました。
== one minute out of ~2.8 hours, by timestamp
60000 records, volume 1530000; segments read 2, skipped 151; 0.166 ms
そしてフルスキャンです。1000 万レコードすべてにわたる出来高加重平均価格(VWAP)を求めます。レコードは固定のストライドでたどられ、各フィールドは 1 回のロードです。
== full scan: VWAP and volume over every record
cold-ish 10000000 records, volume 255000000, vwap 64123.4959, 48.4 ms = 207 M rec/s, 8.26 GB/s
warm     10000000 records, volume 255000000, vwap 64123.4959, 33.1 ms = 302 M rec/s, 12.09 GB/s
ページキャッシュが温まった状態で、1 スレッドで毎秒 3 億レコードです。「cold-ish(やや冷えた)」と書いたのは、ファイルが書かれた直後でほとんどがまだキャッシュに残っていたからです。本当に冷えた状態でディスクから読めば、もっと遅くなるでしょう。
リテンション:ファイルを削除する
リテンションは、ほとんど何もしないので、このエンジンで私が一番気に入っている部分です。retain_from(cutoff) は、max_ts がカットオフより小さいシール済みセグメントをすべて削除します。スキャンも書き換えもインデックスのメンテナンスもなく、セグメントごとに remove_file を 1 回呼ぶだけです。retain_seq(cutoff) は同じことをシーケンスで行います。「直近 N 分」ではなく「直近 N レコード」を残したい呼び出し側のためのものです。
いくつかの詳細が重要です。
- 判定に使うのは各セグメント自身の
max_tsであり、位置ではありません。時計が後ろに戻ったストリームでも、捨てるべきものをきっちり捨てます。 - アクティブセグメントは、そのレコードがどれだけ古くても決して触られません。まだ書き込み中だからです。静かになったストリームは、何か別のものが届いてシールされるまで、最後の部分的なセグメントを保持します。
- リテンションは履歴を削除しますが、番号を振り直しはしません。
next_seqはそのまま進み、first_seqが繰り上がります。
デモ:
== retention: retain_from(ts = T0+1750)
dropped 4 records
Stats { records: 6, segments: 2, bytes: 368, first_seq: 4, next_seq: 10, min_ts: 1791800000001250, max_ts: 1791800000002500, appended: 10, dropped: 4 }

== reopen
Stats { records: 6, segments: 2, bytes: 368, first_seq: 4, next_seq: 10, min_ts: 1791800000001250, max_ts: 1791800000002500, appended: 10, dropped: 4 }
durability = Commit, verify failures = 0
カットオフは T0+1750 ですが、消えたのは 4 レコードだけであることに注意してください。リテンションはセグメント単位で動きます。4..8 のセグメントの max_ts はカットオフより大きいので、1250 のレコードも残ります。保証は「少なくともこれだけは残す」であって、「ちょうどこれだけを削除する」ではありません。
規模を大きくすると、1000 万レコードのストリームの前半を捨てるのにかかった時間は、3 回の実行で 54 から 127 ms でした。
== retention: drop the first half by time
dropped 4980736 records in 54.25 ms
Stats { records: 5019264, segments: 77, bytes: 200775488, first_seq: 4980736, next_seq: 10000000, ...
ソースのコメントによると、このエンジンを書くきっかけの 1 つは、SQL エンジンで 300 万行に対する DELETE が 8.7 秒かかり、ブロックしたことでした。これは今では再現できません。SQL エンジンの DML パスはその後書き直されているからです(0.44.2 の直前の「DML is one scan, ids only」)。比較のため、0.44.2 のサーバーが実際に公開している 2 つのエンジン(ポート 16000、OXIDB_SQL=1、デフォルトの完全な耐久性)に同じ fill を読み込み、同じリテンションの問いを投げました。Python クライアントで、100 万レコードです。
db.sql("CREATE TABLE fills (seq BIGINT PRIMARY KEY, ts BIGINT, px INTEGER, qty INTEGER, "
       "taker INTEGER, maker INTEGER, sym INTEGER, side INTEGER)")
# 1000-row INSERTs, each inside BEGIN/COMMIT ...
db.sql(f"DELETE FROM fills WHERE ts < {cut}")

# document engine: insert_many in thousands, with an index on ts
db.create_index("fills", "ts")
db.delete("fills", {"ts": {"$lt": cut}})
ping: pong
sql insert 1000000 rows (1000/stmt): 11.15 s = 89660 rows/s
sql count: [[1000000]]
sql DELETE WHERE ts < cutoff: {'affected': 500000} in 381 ms
doc insert_many 1000000 docs (1000/call): 10.15 s = 98511 docs/s
doc delete ts < cutoff: {'deleted': 500000} in 2011 ms
doc count: 500000| 方法 | 削除したレコード数 | 時間 |
|---|---|---|
SQL エンジン、DELETE WHERE ts < ... | 500,000 | 381 ms |
ドキュメントエンジン、delete {ts: {$lt: ...}} | 500,000 | 2011 ms |
Ledger、retain_from(76 ファイル) | 4,980,736 | 54 - 127 ms |
これは競争ではなく、競争として読むべきでもありません。SQL エンジンとドキュメントエンジンは各行を見つけてその削除を永続的にログに記録し、インデックスを更新し、並行する読み手に一貫したビューを提供します。またサーバーの数字にはネットワークと JSON のパスが含まれています。本当の違いはコストの形です。SQL エンジンとドキュメントエンジンでは、リテンションは削除する行の数に比例します。ledger ではファイルの数に比例します。レコードが 10 倍になっても削除が 10 倍長くなるわけではなく、unlink の呼び出しが 10 倍になるだけです。
クラッシュリカバリと整合性
途切れた末尾
アクティブセグメントが作成されるとき、ヘッダーはレコード数ゼロで書かれ、シール時にだけ書き直されます。そのため、プロセスが死んだときに追記中だったファイルは、カウントがゼロであることで見分けられ、信用されるのではなくリプレイされます。書き込みの途中で死んだプロセスは、末尾に部分的なレコードを残します。この末尾はエラーでも破損でもなく、起きなかった書き込みです。切り詰められて取り除かれ、セグメントは最後の完全なレコードから続きます。ドキュメントエンジンの WAL が途切れた末尾に施すのと同じ扱いです。
デモでは、アクティブセグメントに 20 バイトのゴミ(レコード半分)を追記してから開き直しました。
== torn tail: half a record after the last whole one
append 2  -> (10, 2)
00000000000000000010.seg: 144 -> 164 bytes
after reopen: 144 bytes, next_seq = 12
ファイルは 144 バイトまで切り戻され、2 つの完全なレコードは生き残り、next_seq は 12 です。
CRC32
シール済みセグメントはすべて、ヘッダーにレコードのバイト列の CRC32 を持っています。これはどのホットパスにもありません。verify() は、オペレーターやクラッシュテストが実行するものです。シール済みセグメントの 1 ビットを反転させると検出されます。
== flip one byte in a sealed segment
verify: checksum mismatch in 00000000000000000004.seg
パフォーマンス:測れたものと測れなかったもの
すべての数字は、24 GB の RAM、内蔵 SSD を備えた Apple M4 Mac、macOS でのものです。シングルスレッド、40 バイトの fill、Durability::Os、1024 レコードのバッチです。
| 測定項目 | 結果 |
|---|---|
| 1000 万件の fill の追記(3 回) | 2.29 / 2.60 / 4.03 s、つまり毎秒 250 万から 440 万レコード(99 から 175 MB/s) |
| 153 セグメントのストリームのオープン | 25 - 26 ms |
| 1000 万レコードに対する VWAP スキャン | 温まった状態で 33 ms(毎秒約 3 億レコード) |
| 2.8 時間のうち 1 分間、時刻で | 0.17 ms、153 セグメント中 151 個をスキップ |
| シーケンスで 1 レコード | 2.1 µs |
| リテンションで前半を削除 | 54 - 127 ms、498 万レコード |
ここからが正直に述べなければならない部分です。ソースにある主張は、背後に 1 億レコードを抱えたストリームも、1 万レコードのストリームとまったく同じ速度で追記できる、というものです。コードのレベルではそれは真です。追記のどのステップも履歴の大きさを見ません。しかし、私のマシンではこれをきれいに測定できませんでした。1000 万件の実行では、100 万件ごとの速度が毎秒 140 万から 1040 万レコードまでばらつき、後半の 100 万件ほど遅くなる傾向がありました。これを切り分けるために別の実験を行いました。0、300 万、600 万、900 万レコードの履歴を書き、sync し、一呼吸おき、ストリームを開き直してさらに 100 万件を追記します。同じ構成での結果は毎秒 16.6 万から 1060 万レコードまでばらつきました。空のストリームの方が平均では速かったものの、どのケースでもばらつきが大きすぎて、差を履歴のせいにすることはできませんでした。これらの実行の間、ディスクの空きは約 2 GB しかなく、その使用率での APFS と SSD の振る舞いが、エンジンの仕事をかき消してしまいます。ですから「履歴は追記のコストに影響しない」は、私の測定結果としてではなく、設計上の性質として読んでください。Linux で、空のディスクで、perf で CPU 側を切り分けてやり直すのが、私の TODO リストに載っています。
見つけたもの:2 つのバグと 1 つの抜け
この記事の準備で、私は初めてこの crate を本格的に動かし、3 つのことが出てきました。どれも、ワークスペースに入っていないという事実がすでに語っていることを裏付けています。このエンジンはまだ完成していません。
1. テストが間違っている。 crate の 19 個のテストのうち 18 個は通ります。残りの 1 つは an_order_is_forty_eight_bytes です。
test schema::tests::an_order_is_forty_eight_bytes ... FAILED
assertion `left == right` failed
  left: 40
 right: 48
test result: FAILED. 18 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.05s
コードは正しく、テストが間違っています。order の形は、予約された 16 バイト、4 バイトのフィールド 5 つ(20)、u16 1 つ(2)、u8 2 つ(2)で、合計 40、8 の倍数なのでパディングはありません。テストは 48 を期待しています。パッキングのルールは動いており、期待値の計算が間違っていたのです。
2. Os と Sealed が同じことをしている。 ドキュメント上の違いは、Sealed はセグメントがシールされるときにだけディスクに届く、というものです。しかしシールはどのモードでも sync_all を呼び、append は Commit 以外のすべてのモードで flush を呼ぶだけです(そして std::fs::File に対する flush はそもそも何もしません)。結果として、現状では Durability::Os もシール時にディスクに届き、2 つのモードはまったく同じです。上のグラフに見える違いは測定ノイズです。Os は約束より耐久性が高いのでデータ喪失のバグではありませんが、2 つの設定があるならそれぞれ違う振る舞いをすべきです。Os がシール時の fsync を省くか、2 つを 1 つにまとめるかのどちらかです。
3. シールの途中にあるクラッシュのウィンドウ。 これが本物のバグです。roll() は先に次のセグメントファイルを作成し、その後で古いセグメントをシールします(ヘッダーにレコード数を書き込みます)。この 2 つの間にプロセスが死ぬと、ディスクには、レコードは完全だがヘッダーのカウントがまだゼロの古いセグメントと、空の新しいセグメントが残ります。open() はカウントがゼロのファイルを「位置にかかわらずリプレイする」と印を付けますが、その後それを active 変数に割り当て、次のファイル(空の新しいセグメント)が同じ変数を上書きしてしまいます。古いセグメントのレコードは、シール済みのリストにもアクティブセグメントにも入らなくなります。Commit モードで 6 レコードを追記し、その後セグメント 0 のヘッダーのカウントをシール前の値であるゼロに戻すことで、これを再現しました。
append 6 -> (0, 6)
before: Stats { records: 6, segments: 2, bytes: 368, first_seq: 0, next_seq: 6, min_ts: 1000, max_ts: 1005, appended: 6, dropped: 0 }
after:  Stats { records: 2, segments: 1, bytes: 144, first_seq: 4, next_seq: 6, min_ts: 1004, max_ts: 1005, appended: 6, dropped: 0 }
segment 0 still on disk: 224 bytes
fsync され、確認応答された 4 つのレコードが、開き直すと見えなくなります。ファイルはまだディスク上にあるので、データが物理的に消えたわけではありませんが、エンジンはもうそれを読みません。ウィンドウは狭い(2 つのファイル操作の間)ものの、そこはまさに耐久性の約束が意味を持つべき場所です。修正は単純です。最後のファイルではないカウントゼロのファイルは、ファイル長からレコード数を数え、その場でシールすべきです。これは、私が最近 OxiDB の別の場所で潰したバグと同じ系統に属します。0.44.2 の直前の「five acknowledged-write losses in recovery」コミットは、ドキュメントエンジンのリカバリで確認応答済みの書き込みが失われ得る 5 つの経路を塞ぎました。その 1 つが「a zero-record torn tail swallowed every later append」(レコード数ゼロの途切れた末尾が、それ以降のすべての追記を飲み込んでいた)でした。
お金の正しさ:関連する CHANGELOG の記録
ledger エンジンはまだ稼働していませんが、取引所が OxiDB にデータを託せるようになるまでに直さなければならなかったことの大半はドキュメントエンジンにあり、CHANGELOG に記録されています。このエンジンを設計している間、私の頭にあった参照点は次のとおりです。
- v0.34.0、同じドキュメントへの 2 回の書き込み: トランザクション内で 1 つのドキュメントへの 2 回の書き込みが互いを見ておらず、
$inc -2の後に$inc +1を行うと、-1 ではなく +1 になっていました。CHANGELOG 自身の言葉では、それは「台帳でお金を生み出す」ことでした。今では書き込みは合成され、find_for_update(SELECT ... FOR UPDATE)が追加されました。 - fsyncgate: グループコミットで、トランザクションはメモリ上で書き込みを適用し、その後で WAL を fsync していました。fsync が失敗したとき、コミットは正しくエラーを返していましたが、拒否された書き込みが次のチェックポイントに漏れ出していました。「API が失敗を報告したのにお金が動いた」のです。今では WAL の fsync が失敗するとメモリ上の状態が汚染扱いになり、リカバリは確認応答済みのトランザクションだけをリプレイします。
- v0.40.0、半分だけ適用された複数コレクションのトランザクション: 2 つのコレクションにまたがるトランザクションが、クラッシュ後に半分だけ適用された状態で復元されることがありました。Jepsen スタイルの銀行テスト、複数コレクションの原子性の訓練、exactly-once テストのすべてが、この 1 つのバグで失敗していました。
- 取引所対応状況の表: Raft リーダーのフェイルオーバーをまたいだシーケンスと約定 ID の単調性(
raft_sequence_monotonic)、リトライ下での exactly-once な適用(exactly_once)、注文の fill が 5 つのコレクションにまたがってオールオアナッシングであること(multi_collection_crash)。
ledger のルール、「シーケンスはエンジンが割り当てる」と「確認応答はディスク上にあることを意味する」は、これらの教訓から直接導かれています。上の 3 つ目の発見は、同じ規律がこの新しい crate にはまだ完全には適用されていないことを示しています。
制限とトレードオフ
- サーバーには入っていない。 ワイヤコマンドも、クライアントライブラリも、REST エンドポイントもありません。現時点では Rust から組み込みでしか使えず、それにも自分で
lib.rsを書く必要があります。 - クエリ層がない。 述語評価器、射影、集計の API は書かれていません。現時点では自分で
segments()をたどります。 - 固定スキーマ。 フィールドの追加、削除、拡幅は新しいストリームを意味します。テキストや可変長のフィールドはありません(フィールド名ですら 12 バイトです)。
- すべてが
i64。i64::MAXを超えるu64の値は負として読まれます。 - リテンションはセグメント単位。 カットオフより古いレコードの一部が最大 1 セグメント分生き残ることがあります。静かなストリームのアクティブセグメントは決して削除されません。
- 単一ライター。
appendは&mut selfを取ります。並行性のモデル(ストリームごとに 1 つのライター、多数のリーダー)はワイヤ層とともに設計される予定です。 - レプリケーションなし。 Raft クラスタにはつながっておらず、ドキュメントエンジンが持つレプリケーションとシーケンスの保証はここにはまだありません。
- 上で述べた クラッシュのウィンドウ と
Os/Sealedが同じであること は未解決です。
OxiDB の他の部分との関係
私はその位置づけをこう見ています。残高台帳と複式簿記のジャーナルは、分離性が必要なので、トランザクションとともにドキュメントエンジンに残ります(ドキュメントエンジン)。注文と fill のジャーナルは、順序、耐久性、リテンションが必要なので ledger に行きます。ローソク足とマーケットデータは 時系列エンジン に、レポーティングは SQL エンジン に置かれ、fill のイベントは MQTT と AMQP でファンアウトされます。ソースのコメントも同じことを言っています。fill は「ワイヤ上にも、ブラウザにも、時系列にもある」ので、fill ジャーナルは Commit を望まないかもしれない、と。
時系列エンジンとの類似は明らかですが、目標は異なります。時系列エンジンは柔軟なタグと圧縮を中心に作られています。ledger は、エンジンが割り当てる密なシーケンス、ゼロエンコーディング、そして確認応答を意味する fsync を中心に作られています。
次にやること、そして試し方
まず、この記事で明らかになった 3 つのこと、つまりテスト、Os モード、シールのウィンドウを直します。次に crate をワークスペースに入れ、lib.rs とクエリ層を与え、そして何より重要なワイヤインターフェースを作ります。クライアントがディスクに書かれるのとまったく同じバイト列でレコードを送り、パースを伴わない追記コマンドです。その後、ledger はこのシリーズの他のエンジンと同じように、環境変数で有効にできるようになります。
それまでの間、今動いている OxiDB を試すなら、GitHub releases ページに macOS(arm64/x86_64)、Linux(x86_64/arm64)、Windows 用のバイナリがあり、リポジトリで docker compose up -d を実行すれば Docker で立ち上がります。ledger crate はソースの oxidb-ledger/ の下にあります。上の #[path] のトリックを使えば、自分のプロジェクトにマウントして 5 分でテストを実行できます。シリーズの最後の記事では レコメンデーションエンジン を扱います。