Rill:ガベージコレクタのない Go スタイルの並行関数型言語(基本から Web サーバーまで)
Rill を最初から最後までめぐる長いツアー。代数的データ型、Result と ?、末尾再帰、strand とチャネル、select によるタイムアウト、GC なしのメモリ管理、そして Rill で書いたこのブログのサーバー。コード例はすべて実行済みで、出力は本物です。
ここ数年、ある問いが何度も頭に浮かんできました。Haskell や OCaml の型システム、Go の並行性モデル、そして C の出力に近い速度を、仮想マシンもガベージコレクタも挟まずに 1 つの言語にまとめることはできるだろうか、という問いです。Rill は、その答えを探すために私が書いた言語です。いまあなたが読んでいるこのページも、Rill で書いた HTTP サーバーが配信しています。
長いツアーになります。言語の基本から始めて、代数的データ型、? によるエラーの伝播、実は末尾再帰であるループ、strand とチャネルによる並行性、ガベージコレクタなしのメモリ管理を経て、最後にこのブログを支えるサーバーまで進みます。この記事のコード例はすべて、書く前にコンパイルして実行しました。出力は本物の出力です。(プログラム内の文字列がトルコ語なのは、私が実際に実行したプログラムそのままだからです。)
Rill とは何か、何ではないか
Rill は正格評価で静的型付けの関数型言語です。LLVM を通じて直接ネイティブコードにコンパイルされます。いくつかの中心的な設計判断が、この言語の性格を形作っています。
- どこでも型推論。 型注釈は任意です。ジェネリクス、トレイト、そして「この型は順序付け可能でなければならない」といった制約は、コンパイラが推論してチェックします。
- 代数的データ型とパターンマッチ。 ネストしたパターン、ガード、そして書き忘れたケースを名指しで教えてくれる網羅性チェッカー。
- ガベージコレクタなし。 メモリはコンパイル時に挿入される参照カウント(Perceus 方式)で管理されます。値は死んだ瞬間に解放され、停止時間はありません。
- Go の並行性モデル。 グリーンスレッド上の
spawnと型付きチャネル。Rill ではこれを strand と呼びます(Go の goroutine に相当します)。 - LLVM -O3 によるネイティブコード。 ジェネリクスは単相化され、何もボックス化されず、トレイト呼び出しはコンパイル時に解決されます。「Hello world」は 33 KB です。
- 唯一の正規構文。
rill fmtは、どんなプログラムにもただ 1 つの書き方を与えます。
Rill に「ない」ものも同じくらい意図的です。可変変数、例外、null、暗黙の型変換、継承はありません。変化するのはストレージの一部だけです。バッファ(Buf)の要素と Map のエントリです。それでさえ、変わるのは束縛ではなく、名前が指しているストレージのほうです。
最初の一歩:インストールと「hello」
コンパイラは Rust で書かれていて、LLVM 21 が必要です。
brew install llvm@21
cargo build --release
./target/release/rill run examples/hello.rill
./target/release/rill build main.rill -o main && ./main
ツールチェーン全体が 1 つのバイナリに収まっています。build、run、check、test、fmt、repl、doc、explain、そして言語サーバー(rill lsp)です。エディターでカーソル下の名前の型が見られることは、すべてを推論する言語においてシグネチャが明示される唯一の場面です。
代数的データ型とパターンマッチ
Rill では、データ型はそのコンストラクタの一覧です。次の例では 3 つの図形を定義し、それぞれの面積を計算します。三角形にはヘロンの公式を使い、平方根には C の数学ライブラリを直接呼び出します。
type Shape
  Circle(r: Float)
  Rect(w: Float, h: Float)
  Triangle(a: Float, b: Float, c: Float)

fn area(s) = match s
  Circle(r) -> 3.14159 * r * r
  Rect(w, h) -> w * h
  Triangle(a, b, c) ->
    p = (a + b + c) / 2.0
    sqrt(p * (p - a) * (p - b) * (p - c))

fn describe(s) = match s
  Circle(r) if r > 10.0 -> "büyük bir daire"
  Circle(_) -> "bir daire"
  Rect(w, h) if w == h -> "bir kare"
  Rect(_, _) -> "bir dikdörtgen"
  Triangle(_, _, _) -> "bir üçgen"

extern "m" fn sqrt(x: Float) -> Float

fn main() =
  shapes = Cons(Circle(1.0), Cons(Rect(2.0, 2.0), Cons(Triangle(3.0, 4.0, 5.0), Cons(Circle(12.0), Nil))))
  each(shapes, \s -> println(describe(s) + ": " + float_to_str(area(s))))
  println(fold(map(shapes, area), 0.0, \acc, a -> acc + a))
出力:
bir daire: 3.14159
bir kare: 4
bir üçgen: 6
büyük bir daire: 452.38895999999994
465.53054999999995
いくつか注目すべき点があります。
- 型は 1 つも書いていません(コンストラクタのフィールドを除く)。
areaがShape -> Floatであることは、コンパイラが自分で導き出します。 describeのifガードは何もカバーしません。Circle(r) if r > 10.0の行は、それだけでは円をカバーしたことになりません。その下のCircle(_)の行を消すと、コンパイラは欠けているCircle(_)のケースを名指しします。ガード付きのアームがケースを「隠す」ことはできないのです。extern "m" fn sqrt(...)の行は、C のlibmから関数を直接リンクします。間にラッパー層はありません。- 浮動小数点数は、読み戻したときに正確に同じ値になる最短の形で表示されます。
452.38895999999994は計算された数値そのものです。
コンストラクタが 1 つだけの型のフィールドは、ドット(p.x)で読めます。コンストラクタが複数ある型には match でしか答えられません。そのフィールドが存在しない可能性があるからです。レコードを変更する代わりに、新しいレコードを作ります。{ p | health = p.health - 35 } は「p が持つすべて、ただしこれらを除く」と読みます。
エラーは値である:Result と ?
Rill には例外がありません。失敗しうる関数はその型でそう宣言し、呼び出し側はそれを忘れることができません。以前はこれにコストがありました。呼び出しごとに match が必要で、その 3 行のうち 2 行は毎回同じだったのです。? 演算子はまさにその 2 行です。Ok の中の値、そうでなければ関数全体の Err。
小さな設定ファイルリーダーを書いてみましょう。
type Config
  Config(host: Str, port: Int)

fn field(text, key) =
  found = find(lines(text), \l -> starts_with(l, key + "="))
  match found
    Some(l) -> Ok(str_sub(l, str_len(key) + 1, str_len(l)))
    None -> Err("eksik alan: " + key)

fn number(s) =
  n = str_to_int(s)
  if n > 0 && n < 65536 then Ok(n) else Err("geçersiz port: " + s)

fn parse_config(text) =
  host = field(text, "host")?
  port = number(field(text, "port")?)?
  Ok(Config(host, port))

fn main() =
  println(parse_config("host=127.0.0.1\nport=8080"))
  println(parse_config("host=127.0.0.1"))
  println(parse_config("host=x\nport=99999"))
Ok(Config(127.0.0.1, 8080))
Err(eksik alan: port)
Err(geçersiz port: 99999)? は実行時に何も追加しません。コンパイラはブロックの残りを Ok のアームに変え、手で書いたであろう match を生成します。? の後の末尾呼び出しは、依然として末尾呼び出しです。各レイヤーが独自のエラー型を持ち、関数のエラー型が直和型として定義されている場合(Io(IoErr) と Parse(ParseErr) を持つ type AppErr など)、? は下位レイヤーのエラーを対応するコンストラクタで包んで外に運びます。型が宣言しない限り、何も暗黙に変換されることはありません。
ループはない、それでもループはある
Rill には古典的な while ループがありません。その代わりにあるのが末尾再帰で、これはヒントではなく約束です。Rill の関数は LLVM の末尾呼び出し保証付きの呼び出し規約でコンパイルされ、呼び出しには musttail が付けられます。オプティマイザーがこの保証を取り消すことはできません。互いに末尾位置で呼び合う複数の関数として書いたループでさえ、一定のスタックで動きます。
fn sum_to(n) =
  fn go(i, acc) = if i > n then acc else go(i + 1, acc + i)
  go(1, 0)

fn main() =
  println(sum_to(100000000))
  squares = buf_int(10)
  for i in 0..10
    squares[i] = i * i
  total = for i in 0..10 with acc = 0
    acc + squares[i]
  println(total)
  println(range(1, 20) |> filter(\x -> x % 3 == 0) |> map(\x -> x * x) |> sum)
  words = split("rill ile yaz rill ile derle rill ile çalıştır", " ")
  counts = map_new()
  each(words, \w -> map_set(counts, w, map_or(counts, w, 0) + 1))
  println(sort_by(map_items(counts), fst))
5000000050000000
285
819
Cons((derle, 1), Cons((ile, 3), Cons((rill, 3), Cons((yaz, 1), Cons((çalıştır, 1), Nil)))))この小さなプログラムには 4 つのアイデアが入っています。
- ローカル関数はクロージャではなくループです。
goは外側の関数のnを参照します。コンパイラはそれをトップレベルに持ち上げ、nを引数として渡します。何もアロケートされず、1 億ステップが一定のスタックで実行されます。 for ... withは運んでいるものを返します。 本体の値が次のaccになります。本体にacc = acc + v[i]と書くと拒否され、エラーはwithを使うよう教えてくれます。そうしないと、ループは毎回の反復結果を捨ててしまうからです。- パイプラインは 1 つのループになります。 要素が数値で、関数がラムダとして書かれている場合、
range |> filter |> map |> sumのチェーンはリストを一切含まない 1 つのループとして生成されます。 Map(k, v)はハッシュテーブルです。 構造的等価性を持つものなら何でもキーにできます。ハッシュ関数はコンパイラが型から書きます。キーが存在しない可能性があるので、m[k]はOptionを返します。テーブルの順序はテーブルのものです。順序が必要なときはsort_byで明示的に求めます。
並行性:strand とチャネル
Rill は Go のモデルを使います。多数の軽量スレッドがランデブーチャネルで会話するモデルです。strand は本当に安価です。100,000 個の strand で約 53 MB、起動はマイクロ秒単位です。秘密は copy-on-block のスタックモデルにあります。待機中の strand のコストは約 300 バイトです。
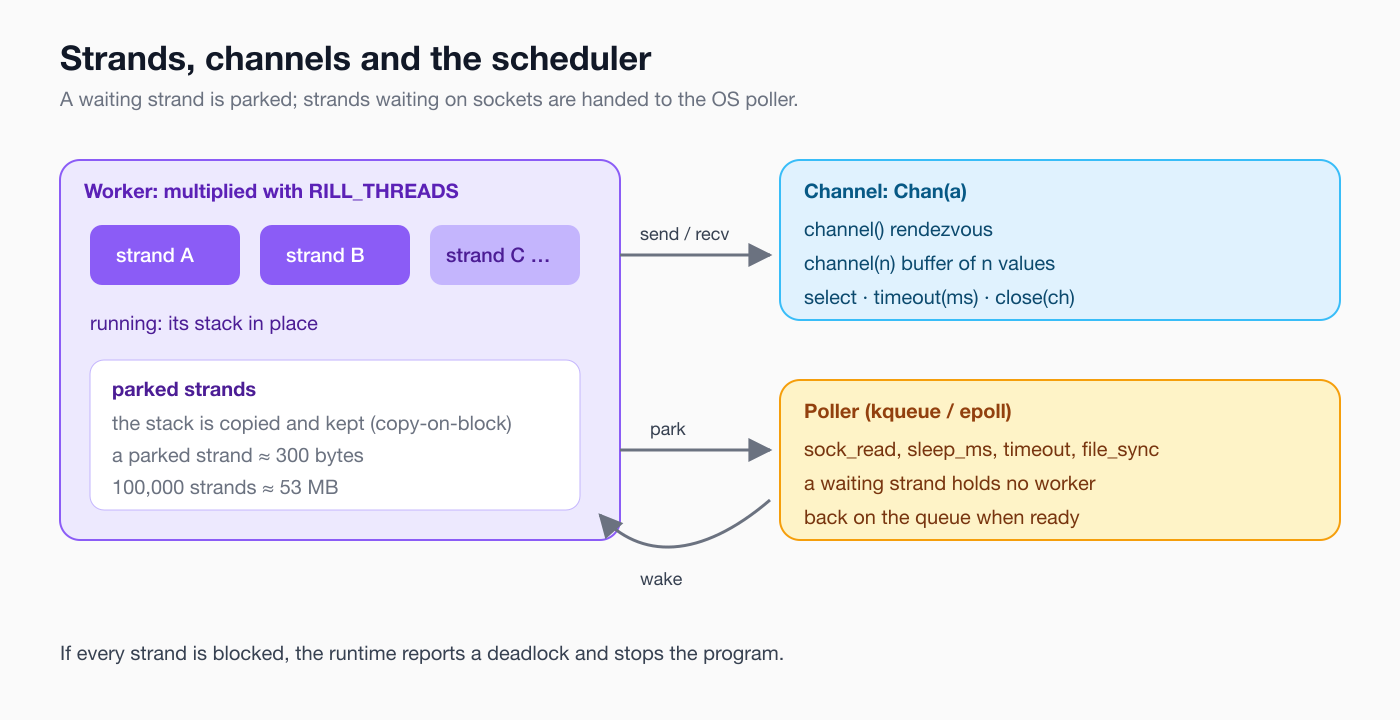
まずワーカープールを書いてみましょう。4 つのワーカー strand がジョブチャネルを待ち受けます。それぞれ受け取った n のフィボナッチ数を計算し、結果をタプルとして送り返します。
fn fib(n) = if n < 2 then n else fib(n - 1) + fib(n - 2)

fn worker(id, jobs, results) =
  n = recv(jobs)
  send(results, (id, n, fib(n)))
  worker(id, jobs, results)

fn collect(results, k, acc) =
  if k == 0 then acc else collect(results, k - 1, Cons(recv(results), acc))

fn main() =
  jobs = channel(16)
  results = channel(16)
  for id in 0..4
    spawn worker(id, jobs, results)
  for n in 25..33
    send(jobs, n)
  got = sort_by(collect(results, 8, Nil), job_of)
  each(got, report)

fn job_of(t) =
  (_, n, _) = t
  n

fn report(t) =
  (id, n, f) = t
  println("fib(" + int_to_str(n) + ") = " + int_to_str(f) + "  [işçi " + int_to_str(id) + "]")
fib(25) = 75025 [işçi 0]
fib(26) = 121393 [işçi 0]
fib(27) = 196418 [işçi 0]
fib(28) = 317811 [işçi 0]
fib(29) = 514229 [işçi 0]
fib(30) = 832040 [işçi 0]
fib(31) = 1346269 [işçi 1]
fib(32) = 2178309 [işçi 1]ワーカー 0 がほとんどのジョブをこなしているのはバグではありません。デフォルトのビルドではワーカースレッドが 1 つしかなく、strand はその上で順番に動きます。worker が自分自身を永遠に呼び続けることも問題ではありません。末尾呼び出しなので、スタックは伸びません。
本当の並列処理には、プログラムを --parallel 付きでビルドし、ワーカー数を RILL_THREADS で指定します。同じプールに 8 つの同じ大きさのジョブ(8 × fib(35))を与え、M4 で 11 回実行した中央値を取りました。時間にはプロセスの起動も含まれます。
| ビルド | 時間(中央値) |
|---|---|
rill build(ワーカー 1 つ) | 131 ms |
rill build --parallel、RILL_THREADS=8 | 53 ms |
1 行も変えずに、コードは約 2.5 倍速くなりました。1 つ注意点があります。--parallel ビルドでは、strand 間で共有されるストレージ(Map、Buf)にロックがありません。コンパイラは、意図的に共有する値を apart(x) でマークするよう求めます。これは「これらには別々に書き込みます」というあなたの約束です。
タイムアウト:select と timeout
サービスを待つとき、永遠に待ちたくはありません。select は複数のチャネルを同時に待ち、最初に準備ができたもののアームを実行します。timeout(ms) のアームは、その時間何も起きなかったときに準備完了になります。
fn slow(ch, ms, v) =
  sleep_ms(ms)
  send(ch, v)

fn ask(ch, ms) =
  r = select
    v = recv(ch) -> "yanıt geldi: " + v
    timeout(ms) -> "zaman aşımı (" + int_to_str(ms) + " ms)"
  r

fn main() =
  fast = channel()
  spawn slow(fast, 10, "hızlı servis")
  println(ask(fast, 100))
  lazy = channel()
  spawn slow(lazy, 500, "yavaş servis")
  println(ask(lazy, 100))
yanıt geldi: hızlı servis
zaman aşımı (100 ms)ここには重要なエンジニアリング上の工夫があります。timeout のアームは strand もチャネルも消費しません。ポーラーの中でチャネルと並んで待機し、待っている間のコストはゼロです。以前は、タイムアウトが必要な select はどれも、自分専用の時計として strand とチャネルを 1 つずつ使っていました。処理中のすべてのリクエストに期限を設けるサーバーにとって、それはリクエストごとに strand が 1 つ必要ということでした。
同じ仕組みでプログラムを止めることもできます。close(ch) はチャネルを待っている全員を 1 回のブロードキャストで起こし、wait_signal() はプログラムが停止すべきことを知る手段です。すべての strand がブロックされると、ランタイムは黙ってハングする代わりにデッドロックを報告してプログラムを停止します。
100,000 個の strand のリング
並行性モデルの古典的なストレステストです。100,000 個の strand をチャネルでリング状につなぎます。各 strand は受け取った数に 1 を足して次に渡します。
fn relay(inp, out) =
  v = recv(inp)
  send(out, v + 1)

fn build(first, prev, k) =
  if k == 0 then prev
  else
    next = channel()
    spawn relay(prev, next)
    build(first, next, k - 1)

fn main() =
  t0 = now_nanos()
  first = channel()
  last = build(first, first, 100000)
  send(first, 0)
  println(recv(last))
  println(int_to_str((now_nanos() - t0) / 1000000) + " ms")
100000
10 ms100,000 個の strand と 100,000 個のチャネルを作り、メッセージをリングを一周させるのにかかった時間は、私のマシンで 8〜17 ms、プロセスのピークは 68 MB でした。Rill リポジトリにある比較測定(Apple M4、25 回実行の中央値、3 言語で出力が同一であることを確認済み)は次の通りです。
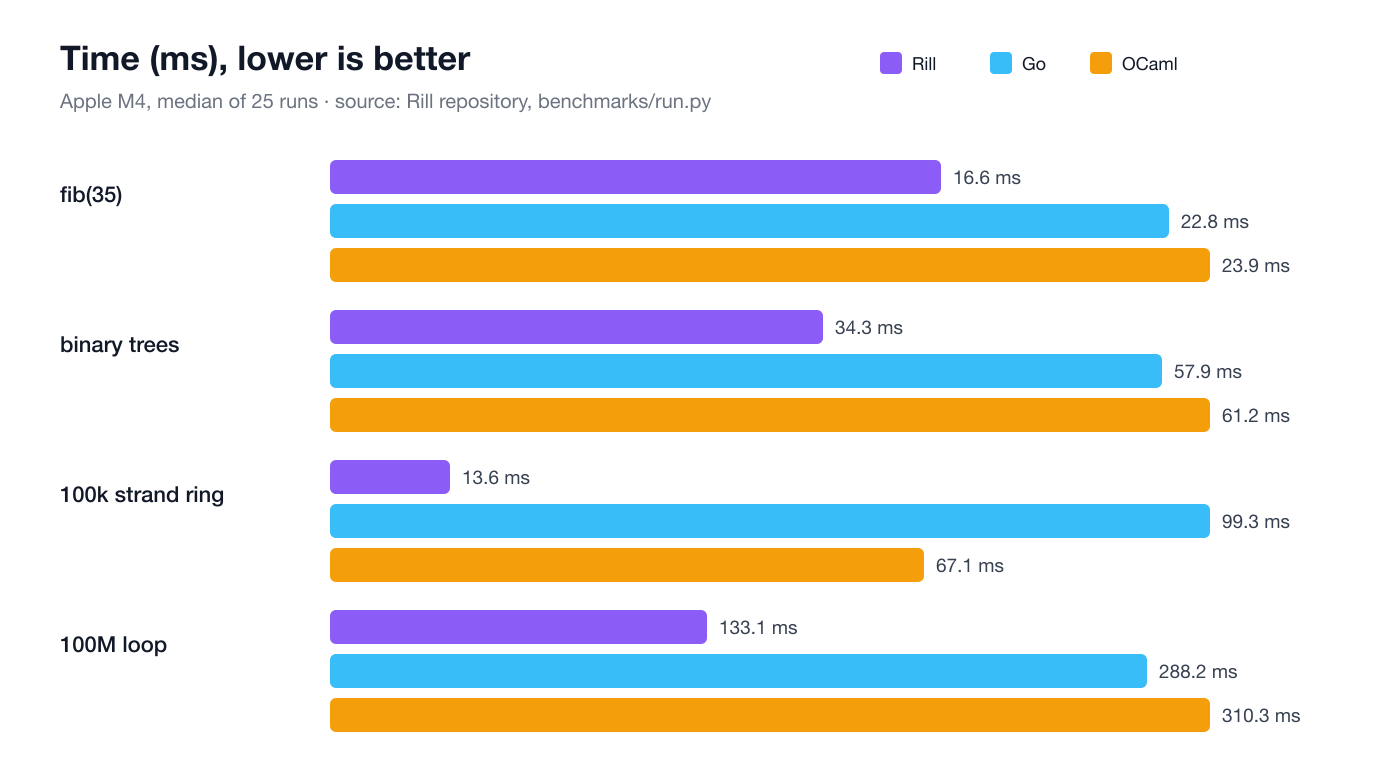
計算の速さは LLVM によるものです。アロケーションの結果(二分木)は、プールアロケーターを使う参照カウントと、決してアロケートしない引数なしコンストラクタによるものです。並行性の結果は copy-on-block のスタックモデルによるものです。3 言語の中で、Rill はピークメモリとバイナリサイズでも最小です。Go の 2.1 MB、OCaml の約 1 MB に対して 32–34 KB です。
ガベージコレクタなしのメモリ
ここが Rill でいちばん好きな部分です。コンパイラは所有権のルールに従って、参照カウントの操作を自分で挿入します(Perceus 方式)。メモリは最後の参照が死んだ瞬間に、決定論的に、停止時間なしで解放されます。Nil や None のような引数なしのコンストラクタは静的なシングルトンで、決してアロケートしません。
本当に素晴らしいのは再利用です。match がボックスを分解し、ほかに名前でそれに到達できるものがない場合、同じ形の次のコンストラクタは新しいボックスではなく、そのボックスの中に作られます。だから map、filter、reverse、split は何もアロケートせずにリストをたどれるのです。それぞれ、読んだリンクの上にそのままリンクを書き込んでいきます。
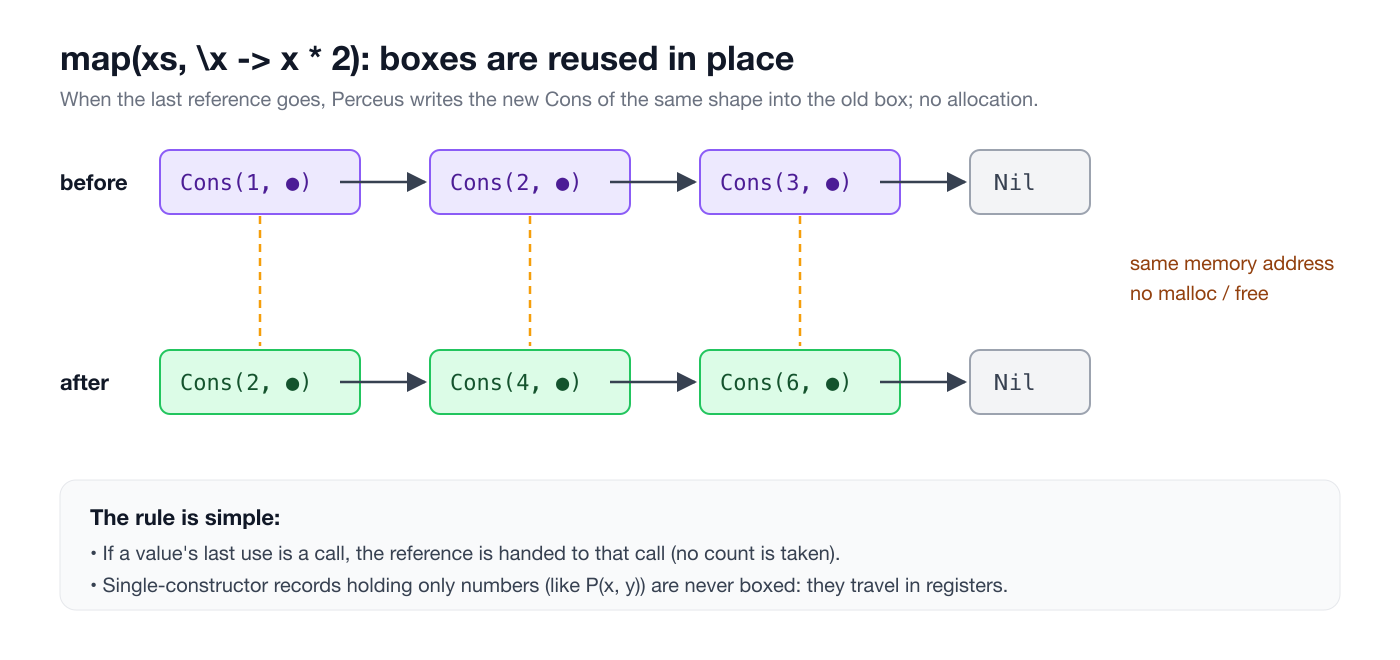
こうした判断はソースからは見えませんが、推測する必要はありません。rill explain はコード生成器自身のレポートです。
type Point
  P(x: Float, y: Float)

fn total(xs, acc) = match xs
  Nil -> acc
  Cons(x, rest) -> total(rest, acc + x)

fn main() =
  xs = Cons(1, Cons(2, Cons(3, Nil)))
  doubled = map(xs, \x -> x * 2)
  println(total(doubled, 0))
  p = P(1.0, 2.0)
  println(p.x + p.y)
  println(range(1, 1000) |> filter(\x -> x % 7 == 0) |> map(\x -> x * x) |> sum)
$ rill explain explain.rill
fn total(xs, acc) # line 4
`xs` is borrowed: never kept or given away here, so the caller's reference is enough
line 6: `rest` is passed to the tail call borrowed: the callee never keeps it
fn main() # line 8
line 9: `Cons(..)` allocates a box with 2 field(s)
line 10: `map` walks the list in place, writing each link over the one it read
line 12: `P(..)` is a flat value: in registers, no box and no count
line 14: this pipeline is one loop: no list is builtレポートは行ごとに読めます。
totalはリストを借用します。何も保持しないので、呼び出し側の参照で十分であり、カウントには一切触れません。mapはリストをその場でたどります。doubledのために新しいセルはアロケートされません。P(1.0, 2.0)はフラットな値です。数値だけを持つ単一コンストラクタのレコードは決してボックス化されず、レジスタで運ばれます。(q, r) = divmod(a, b)のコストは、C で 2 つの数値を返すのと同じです。- パイプラインは1 つのループで、途中でリストは作られません。
参照カウントの唯一の既知の弱点は循環です。自分自身を保持する値は解放できません。不変の値でできたプログラムで循環を作る唯一の方法は、ストレージの一部が、それ自身を保持するものを保持することです。Rill は、v が m を保持している場合の m[k] = v を、書いた時点で拒否します。2 つのマップが互いを保持する場合のように、コンパイル時には見えないケースについては、RILL_ALLOC_CHECK=1 で実行すると、解放されなかったブロックを作った関数を名指しするレポートが得られます。
サーバーを書くのに十分な I/O
ソケットを待っている strand は、スケジューラーが OS をポーリングしている間、待機状態になります。そのため、接続ごとに 1 つの strand を使っても、待っている間のコストはゼロです。TCP より上はすべて普通の Rill のコードです。web/http モジュールは数百行の HTTP/1.1 サーバーで、リクエストのパース、ルーティング、レスポンス、keep-alive を担います。以下は完全な Web サーバーです。
import "web/http" as h

fn route(req: h.Request) =
  p = h.path_of(req.path)
  if p == "/" then h.html_response(200, "<h1>Merhaba Rill!</h1>")
  else if p == "/selam" then h.text_response(200, "selam " + h.param(h.query_of(req.path), "ad"))
  else h.json_response(404, "{\"hata\":\"bulunamadı\"}")

fn main() = h.serve_n(18777, \req -> route(req), 10)
$ curl localhost:18777/
<h1>Merhaba Rill!</h1>
$ curl "localhost:18777/selam?ad=Bar%C4%B1%C5%9F"
selam Barış
$ curl localhost:18777/x
{"hata":"bulunamadı"}コンパイル後のバイナリは 119 KB です。serve_n はテスト用で、決まった数のリクエストに応答して停止します。本物のサーバーは serve か serve_taking を使います。ライブラリは攻撃への対策もよく考えられています。何も送ってこない接続は 15 秒後に切断され、リクエストヘッダーは 64 KB、ボディは 1 MB に制限され、Content-Length と Transfer-Encoding の両方を持つリクエスト(リクエストスマグリング)は応答せずに拒否されます。
Rill リポジトリの測定では、同じ単一ルートのサービスを Go の net/http と比較しています。
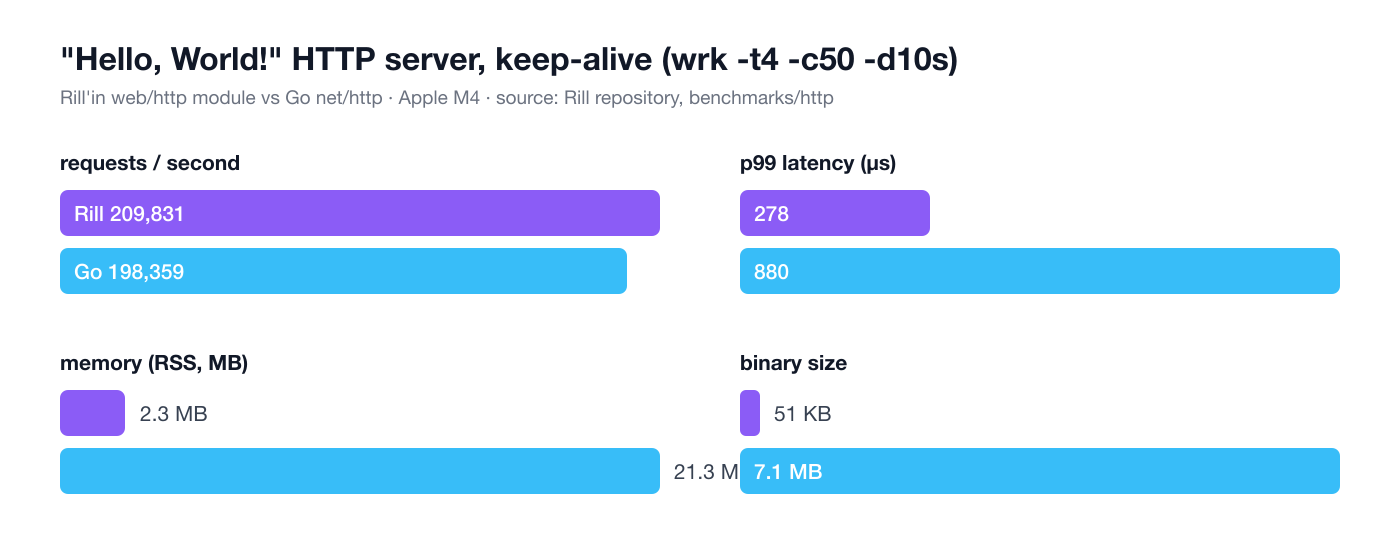
keep-alive ありでは、Rill はスループットとレイテンシの両方で上回り、メモリ使用量は約 9 分の 1 です。p99 レイテンシが 3.2 倍タイトな理由は単純です。ガベージを回収するために止まるものが何もないからです。
このブログはどう動いているのか
いま読んでいるページは、ここまでのすべての要素を組み合わせたものです。サーバーは Rill で書いた単一のバイナリ(約 600 KB)です。その後ろには OxiDB があります。ドキュメント、SQL、インメモリのキーバリュー、S3 の各エンジンを 1 つのプロセスで提供する、私自身のデータベースです。インターフェースは zap で、仮想 DOM を持たない私の細粒度リアクティブライブラリです。
| レイヤー | 技術 | 役割 |
|---|---|---|
| HTTP | Rill web/http | 接続ごとに 1 つの strand、keep-alive |
| テンプレート | tools/tmplgen | テンプレートをビルド時に Rill のコードに変換 |
| Markdown | md.rill | この記事の HTML。保存時に一度だけ生成 |
| SQL | OxiDB SQL | 記事とタグ。トランザクションと外部キー |
| NoSQL | OxiDB ドキュメント | ステミング付き全文検索と閲覧分析 |
| インメモリ | OxiMem (RESP) | セッション、カウンター、ページキャッシュ、レート制限 |
| オブジェクトストア | OxiDB S3 | この記事の画像。SigV4 署名付きリクエスト |
特に気に入っているのは、テンプレートがビルド時に Rill に変換されることです。テンプレートは実のところ関数です。静的なテキストは文字列リテラルに、タグはそれが表すコードになります。ページのレンダリングは StrBuf への追記の連続にすぎず、実行時に何もパースせず、名前を検索することもありません。
%% import "views"
%= t_card(c: Card)
<article class="card">
  <p class="meta"><time datetime="<%= c.iso %>"><%= c.date %></time> · <%= c.reading %> dk okuma</p>
  <h2><a href="/yazi/<%= c.slug %>"><%= c.title %></a></h2>
  <% if len(c.tags) > 0 %><p class="tags"><% each t in c.tags %><a href="/etiket/<%= t %>">#<%= t %></a><% end %></p><% end %>
</article>
<%= ... %> の中はすべて普通の Rill のコードで、自動的に HTML エスケープされます。学ぶべき第 2 の式言語はありません。
記事が読まれるときに起きることも、Rill の並行性モデルをよく示しています。ページはまず OxiMem のキャッシュから探されます。閲覧カウンターはすぐに OxiMem でインクリメントされ、ページに埋め込まれます。分析に使う events コレクション用のドキュメントは別の strand に渡される(spawn)ので、ページはデータベースの fsync を待ちません。データベース接続はチャネルの中のプールです。リクエストは接続を取り、使い、戻します。接続が見つからないリクエストは待ちます。これにより、サーバーはどのみち欲しかったバックプレッシャーをタダで手に入れられます。
fn make_pool(host, port, n) =
  ch = channel(n)
  fn fill(k) =
    if k <= 0 then Ok(ch)
    else
      match connect_to(host, port)
        Err(e) -> Err(e)
        Ok(fd) ->
          send(ch, fd)
          fill(k - 1)
  fill(n)

fn with_conn(pool, ask) =
  fd = recv(pool)
  res = ask(fd)
  send(pool, fd)
  res
記事の保存は、SQL エンジンでの 1 つのトランザクションです。まず行を、次にそのタグを置き換えます。ほかの記事ですでに使われているリンク名(スラッグ)は UNIQUE 制約で拒否され、その拒否がそのままユーザーに表示される応答になります。
fn save_post(fd, d: Draft) =
  now = now_iso()
  ignore(exec(fd, "BEGIN", Nil))
  saved = if d.id > 0 then update_post(fd, d, now) else insert_post(fd, d, now)
  match saved
    Err(e) ->
      ignore(exec(fd, "ROLLBACK", Nil))
      Err(e)
    Ok(id) -> match replace_tags(fd, id, d.tags)
      Err(e) ->
        ignore(exec(fd, "ROLLBACK", Nil))
        Err(e)
      Ok(_) -> match exec(fd, "COMMIT", Nil)
        Err(e) -> Err(e)
        Ok(_) ->
          reindex(fd, id)
          Ok(id)
テスト
テストとは、名前が test_ で始まり、引数を取らない関数です。rill test はファイルを一度コンパイルし、各テストを別々のプロセスで実行するので、失敗したテストがほかに影響することはありません。このブログの Markdown 変換器のテストは次のようになっています。
fn test_plain_and_slug() =
  assert_eq(md_plain("# Başlık\n\nBir **iki**, `üç`"), "Başlık Bir iki, üç")
  assert_eq(slugify("Rill ile Çalışma Zamanı: 101!"), "rill-ile-calisma-zamani-101")
$ rill test src/md.rill
ok test_blocks
ok test_plain_and_slug
2 tests: 2 passed, 0 failedドキュメントコメント内の例もテストです。4 スペースでインデントしたコメント行が例になり、期待される出力は # => の後に書きます。rill doctest がそれを実行して確認します。標準ライブラリのすべての関数にこうした例があるので、リファレンスページに書かれていることは、コードが実際に行うことそのものです。
難しかったこと、学んだこと
Rill を書く中でいちばん時間がかかったのは、一見いちばん単純に見えたテーマでした。
- 浮動小数点の加算順序。
Floatの総和をベクトルレーンに分割すると加算の順序が変わり、答えの最後のビットが変わります。Rill は+が書いた通りの意味を持つことを望むので、デフォルトではこれを行いません。並べ替えを許容する関数はfast fnで明示的にそう宣言します。そうすると内積は 5 倍速くなります。 - 末尾呼び出しの約束の限界。 この約束はマシンのレジスタを通じて果たされます。整数またはポインタの引数が 6 個を超えると、C の呼び出し規約にフォールバックします。そうした関数が互いを呼び合っているとコンパイラが警告します。解決策は、余った引数を 1 つのタプルにまとめることです。タプルは 1 つのポインタだからです。
- 文字とバイト。
#s、s[i]、s[i:j]はバイトであり、今後もそのままです。字句解析器もネットワークプロトコルもバイトを必要とします。"günaydın"は 10 バイトですが 8 文字です。文字は 1 つ上のレベル、名前でそれとわかる関数(char_count、char_take)の中にあります。 - 唯一の正規構文。
rill fmtがどんなプログラムにもただ 1 つの書き方を与えることで、言語は読むのも、差分を取るのも、生成するのも予測しやすくなります。このブログのテンプレート生成器もその恩恵を受けています。
言語の最良のテストは、それで本物の何かを書くことです。このブログは私にとって、Rill の「サーバーを書くのに十分な I/O」という主張の最初の本格的なテストでした。
まとめ
Rill は、ML ファミリーの型安全性、Go の strand とチャネルのモデル、そして C に近い性能を、ガベージコレクタなしで組み合わせる実験です。型推論のおかげで、コードはスクリプト言語並みに短く保てます。コンパイル時の参照カウントのおかげで、メモリの振る舞いは予測可能で、rill explain で目に見えます。末尾呼び出しの保証のおかげでループを関数として書くことができ、strand はとても安価なので、接続ごとに 1 つ開いても気にならなくなります。
次は、さらに多くのプラットフォーム(RISC-V と ESP32 での最初の実験はすでに動いています)、より充実した標準ライブラリ、言語サーバーの機能強化に取り組みます。ご質問や試してみた結果は、X または LinkedIn で聞かせていただけると嬉しいです。次の記事では、このブログを支えるデータベース OxiDB と、それが 4 つの異なるデータモデルを 1 つのプロセスでどう提供しているのかについて書きます。