OxiDBの時系列エンジン:Gorilla圧縮、ロールアップ、ブロック単位のリテンション
OxiDBの時系列エンジンoxidb-tsdbを徹底解説します。ビット単位のGorilla圧縮、型付きフィールド、ラインプロトコル、集約、ウォーターマーク付きの継続的ロールアップ、ロックの少ないバックアップ、そして自作センサーデータで測った実際の圧縮率です。
10個の温度センサーがあり、それぞれが1秒に1回報告する冷蔵倉庫を想像してください。1日で864,000ポイント、1年で3億1,500万ポイントになります。それらを1つずつJSONドキュメントとして保存することもでき、OxiDBのドキュメントエンジンは喜んでそうしてくれますが、どのドキュメントにも同じ測定名、同じタグ、同じフィールド名が繰り返され、1ポイントあたり100バイト以上のコストがかかります。1つのポイントが実際に持っている情報は、タイムスタンプと数値だけです。だからこそ私はOxiDBのために独立した時系列エンジンoxidb-tsdbを書きました。この記事では、その用途、有効化の方法、データモデル、ビット単位でのGorilla圧縮、クエリと集約、継続的ロールアップ、保持期間(リテンション)、バックアップを扱います。ここに示す出力はすべて、この記事のために私のマシン(Apple M4、ローカル)で動かした実際のoxidb-server 0.44.2から取ったもので、圧縮率は私が生成したセンサーデータで測定しました。
なぜ独立したエンジンなのか
時系列データには3つの決定的な特徴があります。形が決して変わらないこと:同じ測定、同じタグ、同じフィールドが永遠に続きます。タイムスタンプが規則的であること:1秒に1回書き込むコレクターは、ほぼ1000 msごとに書き込みます。値がゆっくり変化すること:温度は通常、前回の値とまったく同じか、最後の桁が違う程度です。それに加えて、データはほぼ常に追記され、クエリは個々のポイントではなく範囲や要約を問います。「直近1時間の1分ごとの平均」「今日のp95」といった具合です。
ドキュメントモデルはこれらをどれも活かせません。その柔軟性は、すべてのドキュメントにスキーマを付けることから来ているからです。カラム型ストレージはまさにその繰り返しを取り除きます。フィールド名はシリーズの識別子の中に一度だけ書かれ、値は名前のない、型の揃ったストリームになります。似た値が隣り合って並ぶことこそ、圧縮が最も好むものです。
SQLエンジンと同様に、oxidb-tsdbは独立したRustのcrateで、同じプロセスの中で動きますが、独自のディレクトリ、ファイル形式、クエリの窓口を持っています。デフォルトでは無効で、有効にするまでコストはかかりません。
有効化
環境変数ひとつで済みます。
OXIDB_ADDR=127.0.0.1:15500 \
OXIDB_DATA=./data \
OXIDB_TSDB=1 \
OXIDB_HTTP_PORT=15501 \
./oxidb-server
エンジンは遅延構築され、最初のTSDBリクエストでサーバーは次のログを出します。
[oxidb] TSDB engine enabled (default db at ./data/tsdb)OXIDB_TSDB_DATAを使うと、デフォルトデータベースのTSDBディレクトリを別の場所に移せます。SQLエンジンと同様に、これはデータベースごとです。デフォルトデータベースは$OXIDB_DATA/tsdbの下に、metricsという名前のデータベースは$OXIDB_DATA/metrics/tsdbの下に置かれます。ドキュメントエンジンを完全に無効にして(OXIDB_DOC=0)、プロセスをSQLとTSDBだけのサーバーとして動かすこともできます。
ワイヤプロトコルは、OxiDBがすべてのエンジンで使っているものと同じです。4バイトのリトルエンディアンの長さプレフィックスに続いてJSONが来ます。リクエストには"engine": "tsdb"を加え、すべてのリクエストはcmd: "tsdb"を使い、opフィールドで操作を選びます:write、write_lp、query、distance、track、stats、retention、checkpoint、rollup_add、rollup_refresh、rollups。RBACでは、Readロールはクエリしか実行できず、書き込み、リテンション、ロールアップの定義にはReadWriteが必要です。
例では、リポジトリにあるPythonクライアントの低レベルな_request呼び出しを使います。TSDB専用のヘルパーはまだありませんし、必要もありません。
from oxidb import OxiDbClient

db = OxiDbClient(host="127.0.0.1", port=15500)

def tsdb(op, **kw):
    return db._request({"engine": "tsdb", "cmd": "tsdb", "op": op, **kw})
データモデル:measurement、タグ、フィールド
これはInfluxDBのモデルです。1つのポイントは4つの部分から成ります。measurement(測定)名、0個以上のタグ(すべて文字列)、1個以上のフィールド(測定値)、そしてミリ秒単位のタイムスタンプです。
タグは識別子です。どのサイト、どの部屋、どのセンサーか。タグでフィルタリングしたりグループ化したりします。フィールドはデータです。エンジン内部ではこの区別が厳密に守られます。
1つのシリーズ = measurement × (ソート済みの)タグセット × フィールド名。
したがって、ポイントcoldroom,site=izmir,room=r1 temp=3.9,door_open=fは2つのフィールドを持ち、coldroom|room=r1,site=izmir|tempとcoldroom|room=r1,site=izmir|door_openという2つの別々のシリーズになります。タグはキーでソートされるので、同じタグセットはどの順序で書かれても同じシリーズに入ります。
型付きフィールド
フィールドには型があります:float、integer、boolean、stringです。3つの数値型はGorillaのパスを共有し、内部ではすべてf64として保存されます(整数は2^53まで正確で、booleanは0/1です)。ただし型はシリーズごとに記憶され、クエリ結果では"type"として返されます。文字列は別のパスを通り、生の(timestamp, text)ペアとして保存されます。
JSONで書き込むときは、JSONの値が型を決めます。true/falseはboolean、整数値はinteger、文字列はstring、それ以外はfloatです。1回のリクエストで2つのポイントを書き込みます。
{"engine": "tsdb", "cmd": "tsdb", "op": "write", "points": [
  {"measurement": "coldroom", "tags": {"site": "izmir", "room": "r1"},
   "fields": {"temp": 3.8, "door_open": false, "compressor_rpm": 2950, "state": "cooling"},
   "ts": 1790812800000},
  {"measurement": "coldroom", "tags": {"site": "izmir", "room": "r2"},
   "fields": {"temp": 4.1, "door_open": true, "compressor_rpm": 3010, "state": "defrost"},
   "ts": 1790812800000}]}
{"ok": true, "data": {"written": 2}}InfluxDBのラインプロトコル
メトリクスの共通語はInfluxDBのラインプロトコルです。Telegrafのようなコレクターがこれを話し、エンジンはそれを直接取り込みます。サフィックスで型を指定します:3.9はfloat、2940iはinteger、t/f/true/falseはboolean、"..."はstringです。タイムスタンプはミリ秒です(InfluxDBのデフォルトはナノ秒なので注意してください)。省略するとサーバーの現在時刻が使われます。スペースやカンマはバックスラッシュでエスケープできます(us\ midwest)。
{"engine": "tsdb", "cmd": "tsdb", "op": "write_lp",
 "lp": "coldroom,site=izmir,room=r1 temp=3.9,door_open=f,compressor_rpm=2940i,state=\"cooling\" 1790812860000\ncoldroom,site=izmir,room=r2 temp=4.4,door_open=t,compressor_rpm=3050i,state=\"defrost\" 1790812860000\ncoldroom,site=ankara,room=r1 temp=2.7,door_open=false,compressor_rpm=2800i,state=\"cooling\" 1790812860000"}
{"ok": true, "data": {"written": 3}}型が戻ってくるのを確かめるために、いくつかクエリを実行します。サイトと部屋でグループ化した最新の温度です。
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "coldroom", "field": "temp",
 "group_by": ["site", "room"], "agg": "last"}
{"ok": true, "data": [
{"tags": {"site": "ankara", "room": "r1"}, "type": "float", "points": [{"ts": 1790812860000, "value": 2.7}]},
{"tags": {"site": "izmir", "room": "r1"}, "type": "float", "points": [{"ts": 1790812800000, "value": 3.9}]},
{"tags": {"site": "izmir", "room": "r2"}, "type": "float", "points": [{"ts": 1790812800000, "value": 4.4}]}]}コンプレッサーのRPMはintegerとして、ドアはbooleanとして返ってきます。booleanの平均は、単に「ドアが開いていた時間の割合」になります。
compressor_rpm, tags={"site":"izmir"}, agg=max
{"tags": {}, "type": "integer", "points": [{"ts": 1790812800000, "value": 3050.0}]}

door_open, group_by=["room"], agg=mean
{"tags": {"room": "r1"}, "type": "boolean", "points": [{"ts": 1790812800000, "value": 0.0}]}
{"tags": {"room": "r2"}, "type": "boolean", "points": [{"ts": 1790812800000, "value": 1.0}]}

state, agg=distinct
{"tags": {}, "type": "string", "points": [{"ts": -4611686018427387904, "value": 2.0}]}これらの出力には粗削りな部分が2つあり、隠すより見せておきたいと思います。1つ目は、intervalなしのクエリでは、唯一のバケットにその中の最も古いポイントのタイムスタンプが付くことです。上の例では、lastは正しく3.9を返していますが、それを最初のポイントの時刻と組み合わせています。2つ目は、文字列のクエリパスでは、数値のパスで修正した「範囲無制限」の番兵値がまだ漏れていることです。startを渡さないと、タイムスタンプがi64::MIN/2として返ってきます。値は正しく、タイムスタンプが無意味なだけです。修正が必要な小さなバグで、startを渡せば出なくなります。
Gorilla圧縮
エンジンの心臓部はgorilla.rsです。名前は、Facebookが2015年のVLDBで発表したインメモリ時系列データベースに由来し、そのアイデアには2本の柱があります。タイムスタンプをdelta-of-deltaで、値をXORでエンコードすることです。ブロックは自己記述的です:[u32 count][i64 t0][f64 v0][bitstream]、つまり20バイトのヘッダーの後にビット単位で詰め込まれた本体が続きます。本体には、まずすべてのタイムスタンプが、次にすべての値が入ります。
タイムスタンプ:delta-of-delta
1秒に1回書き込むセンサーでは、連続する差分(delta)は1000で、差分の差分(dod)はゼロです。ゼロは0の1ビットでエンコードされます。それ以外の場合、値はzigzagエンコードされ、可変幅のバケットに入ります。
| dodの範囲 | プレフィックス | ペイロード | 合計 |
|---|---|---|---|
| 0 | 0 | なし | 1ビット |
| -64 .. 63 | 10 | 7ビット | 9ビット |
| -256 .. 255 | 110 | 9ビット | 12ビット |
| -2048 .. 2047 | 1110 | 12ビット | 16ビット |
| それ以外 | 1111 | 64ビット | 68ビット |
細かい点が1つあります。最初のdeltaは、ゼロの「前回のdelta」に対してエンコードされます。1秒間隔のシリーズでは最初のdodは1000で16ビットかかり、10秒間隔のシリーズでは10,000となって2047を超え、68ビットかかります。これはブロックごとに1回払うだけなので、問題になりません。
値:XOR
連続する2つのf64値のビットパターンをXORします。値が変わっていなければXORはゼロで、0の1ビットが書かれます。変わっていれば、XORの意味のあるウィンドウ(先頭のゼロの後、末尾のゼロの前)を保存します。前回のウィンドウが新しいXORをカバーしていれば(先頭のゼロも末尾のゼロも同じ数以上あれば)、ウィンドウの記述は省略されます:1(変化あり)、0(同じウィンドウ)、そして意味のあるビットです。そうでなければ、1、1、5ビットの先頭ゼロ数、6ビットのウィンドウ長、そしてウィンドウ自体を書きます。
ビット単位で追う実例
抽象的なままにせず、5ポイントのシリーズを手で追ってみました。タイムスタンプは0、1000、2000、3003、4000 ms(4つ目の読み取りは3 ms遅れて届きます)、値は21.5、21.5、21.75、21.5、22.0です。gorilla.rsのエンコーダーを1行ずつPythonに移植し、同じシリーズを実際のサーバーに書き込み、checkpointを実行してからblocks.43.tsbをパースし、サーバーが生成したブロックを取り出しました。
values (hex bits):
    21.5 = 4035800000000000
    21.5 = 4035800000000000
   21.75 = 4035c00000000000
    21.5 = 4035800000000000
    22.0 = 4036000000000000
trace:
   ('ts', 1000, 1000, 1000, '1110 011111010000')
   ('ts', 2000, 1000, 0, '0')
   ('ts', 3003, 1003, 3, '10 0000110')
   ('ts', 4000, 997, -6, '10 0001011')
   ('val', 21.5, '0000000000000000', '-', '0')
   ('val', 21.75, '0000400000000000', 'new lead=17 trail=46 m=1', '1 1 10001 000000 1')
   ('val', 21.5, '0000400000000000', 'reuse lead=17 trail=46', '1 0 1')
   ('val', 22.0, '0003800000000000', 'new lead=14 trail=47 m=3', '1 1 01110 000010 111')
bitstream: 69 bits -> 9 bytes; block = 20 header + 9 = 29 bytes (raw 5x16 = 80)
python block: 0500000000c4c2f4a00100000000000000803540e7d041a16e206ee0b8
server block: 0500000000c4c2f4a00100000000000000803540e7d041a16e206ee0b8 min 1790812800000 max 1790812804000 count 5
IDENTICAL: True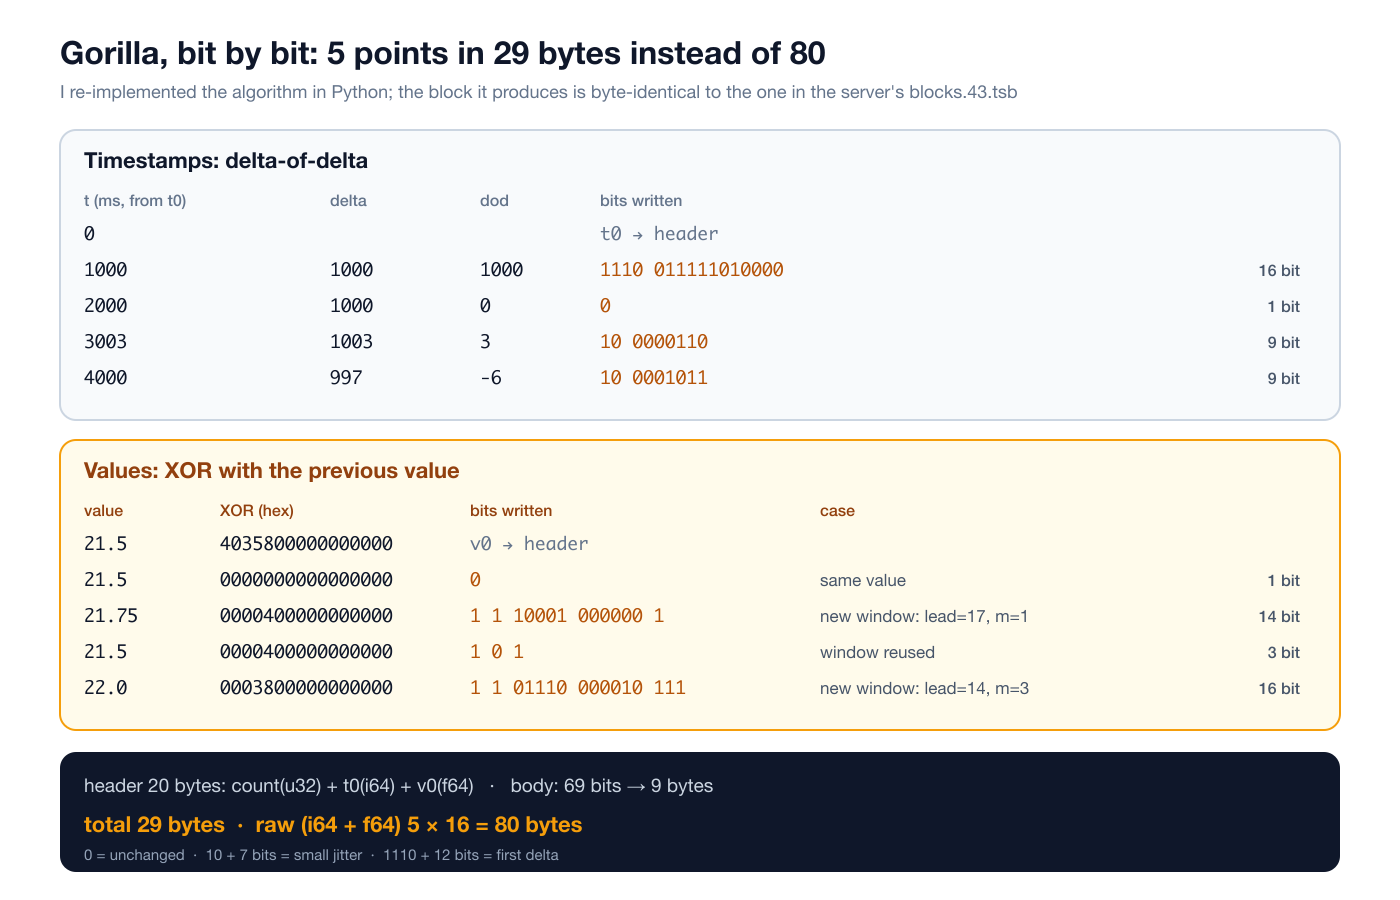
1行ずつ読んでいきます。
- 最初のdeltaは1000で、前回のdeltaは0とみなされるので、dodも1000です。これは-2048..2047のバケットに入ります:プレフィックス
1110に、1000のzigzag(2000、12ビットで011111010000)が続きます。16ビットです。 - 2つ目のポイントは時間どおりです:dodは0で、1ビットです。
- 3 msの遅延は2回払われます:まずdeltaが1003になり、dodは+3(
10+ zigzag(3)=6)。次にdeltaが997に下がり、dodは-6(10+ zigzag(-6)=11)。それぞれ9ビットです。ジッターがなぜ高くつくかは、後の測定で分かります。 - 2つ目の値は変化なし:
0の1ビットです。 - 21.75:21.5とのXORは
0000400000000000です。立っているビットは1つ:先頭ゼロ17個、末尾ゼロ46個、1ビットのウィンドウです。前回のウィンドウがないので記述が書かれます:1 1 10001 000000 1、14ビットです。 - 21.5に戻る:同じXORで、ウィンドウがカバーしているので再利用されます:
1 0 1、わずか3ビットです。 - 22.0:XORは
0003800000000000、先頭ゼロが14個に減り、古いウィンドウではカバーできなくなるので、新しいウィンドウが書かれます:16ビットです。
タイムスタンプが35ビット、値が34ビットで計69ビット、切り上げて9バイトです。ヘッダーを含めて29バイト。生のデータ(i64 + f64)なら80バイトになります。5ポイントではヘッダーが支配的ですが、本当の効果は1024ポイントのブロックで現れ、そこではヘッダーは1ポイントあたり0.16ビットにまで縮みます。
ここでは21.5、21.75、22.0のような、2進数で正確に表せる値を選びました。実際の温度センサーは3.8や3.9を送ってきますが、そのXORは0001555555555555で、49ビットのウィンドウになります。10進数の小数は2進数では無限に続く展開を持ち、それがXORを膨らませます。それが実際にどれほど効くかは、次の測定で分かります。
私のセンサーデータでの実際の圧縮率
リポジトリのブックとexamples/ratio.rsでは、長い間同じ値を保つ丸められたゲージについて、1ポイントあたり約0.28バイト(生のバイナリに対して約56倍)とされています。これはプロジェクト自身の測定です。私は都合のよいケースではなく、さまざまな形のデータを見たいと思いました。10個のセンサー、1日分、1秒に1サンプル(形ごとに864,000ポイント)のデータを生成し、ラインプロトコルで10,000行ずつのバッチで書き込み、checkpointを実行して、statsが報告する圧縮後バイト数の変化を測りました。参考として、同じデータをカラム型の生バイナリ(すべてのタイムスタンプ、次にすべての値)にしてzlibレベル6でも圧縮しました。
| データの形 | 圧縮後 | ビット/ポイント | 生バイナリ比 | gzip -6 |
|---|---|---|---|---|
| boolean のドア、変化はまれ | 238,066 B | 2.2 | 58.1x | 6.3x |
| integer の湿度 (%) | 409,529 B | 3.8 | 33.8x | 5.7x |
| 温度、float、0.1刻み | 1,142,690 B | 10.6 | 12.1x | 5.8x |
| 同じ温度、タイムスタンプに±5 msのジッター | 1,955,295 B | 18.1 | 7.1x | 5.4x |
| integer のカウンター(単調増加) | 1,933,080 B | 17.9 | 7.2x | 3.6x |
| float、全精度のノイズ | 6,150,471 B | 56.9 | 2.2x | 1.6x |
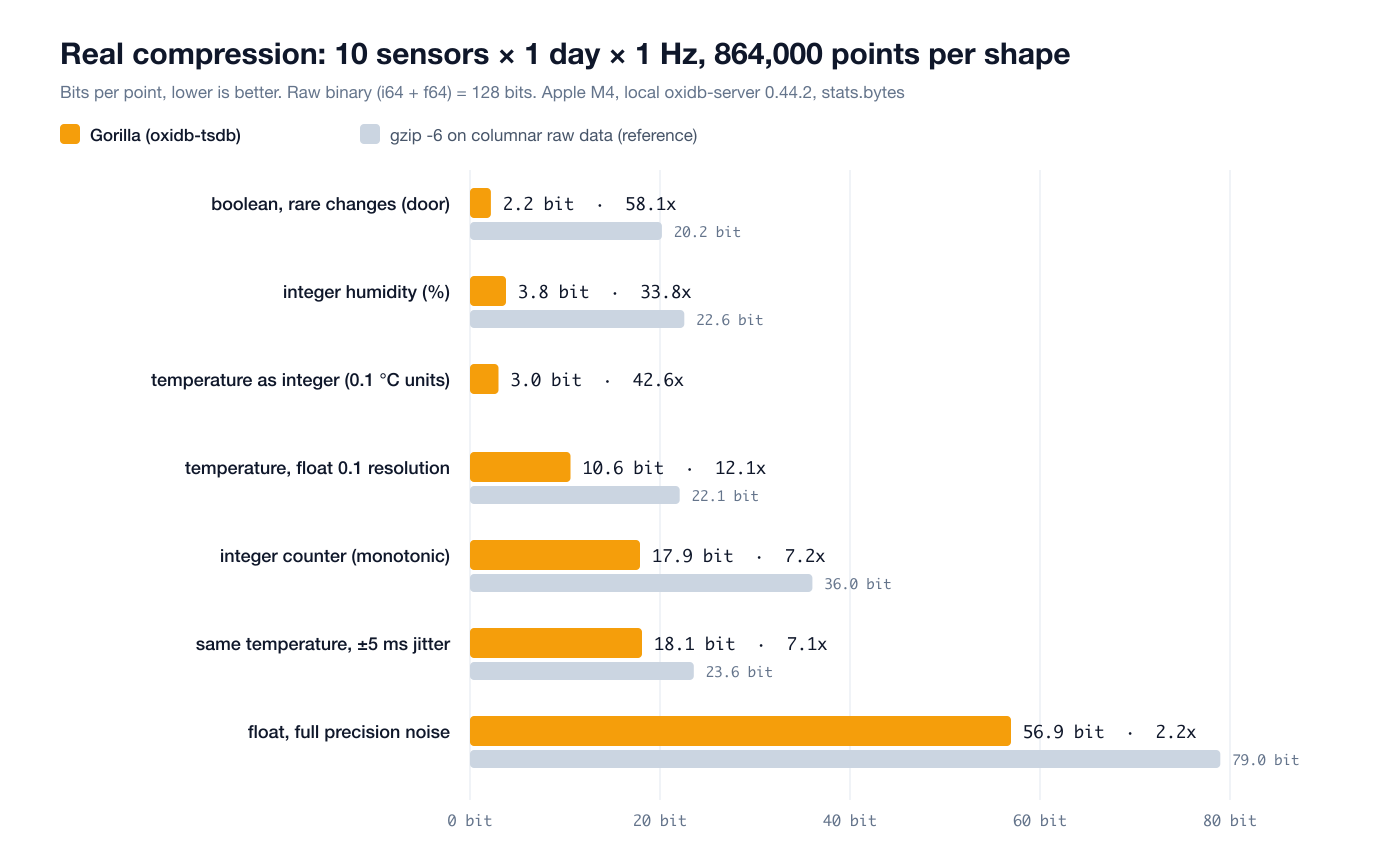
この表からいくつかの教訓が得られます。
- めったに変わらないデータはほぼタダです。 ドアセンサーは1ポイントあたり2.2ビットです。時間に1ビット、値に通常1ビット。生バイナリの58倍です。
- 10進数の浮動小数点は高くつきます。 0.1刻みの温度は1ポイントあたり10.6ビットかかります。私が生成したランダムウォークでは値はポイントの約16%で変化し、変化のたびに約49ビットのXORウィンドウが書かれます。
- 同じデータを整数で保存すると3.5倍よくなります。 これは別に試しました。同じシードから生成した同じ温度シリーズを、一方は
3.8のようなfloatで、もう一方は38iのような0.1 °C単位の整数で書き込みました。float版は1,132,370バイト(10.5ビット/ポイント、12.2倍)、整数版は324,259バイト(3.0ビット/ポイント、42.6倍)でした。整数はf64パターンの仮数部の下位ビットがゼロなので、XORのウィンドウが狭いままです。センサーの分解能が固定なら、整数単位で書き込んでください。 - タイムスタンプのジッターは値の圧縮と同じくらい重要です。 同じ温度データに±5 msのタイムスタンプのノイズを加えただけで、1ポイントあたり7.5ビット増えました。コレクターにタイムスタンプを自分のティック(たとえば秒単位)に丸めさせるだけで、大きな効果があります。
- カウンターは中間に落ち着きます。 単調増加カウンターの値はすべて異なり、桁も変わり続けるので、XORにできることは限られます。17.9ビットです。
- ノイズには奇跡は起きません。 全精度のランダムなfloatではGorillaは2.2倍止まりですが、それでもgzipには勝っています。
どのケースでも、Gorillaは汎用のgzipに勝ちます。データの性質を知っているからです。比較すると、同じポイントをJSONドキュメントにすると107〜122バイト、ラインプロトコルのテキストでは55〜70バイトでした。6つの形を合わせると5,184,000ポイント、圧縮後のデータは11.8 MBで、ディスク上のblocks.43.tsbファイルは12.2 MBでした(差は、各ブロックレコードで繰り返されるシリーズキーの分です)。
書き込み速度について一言。単一のPython接続から、10,000行のバッチで、Python自身のデータ生成も含めて、毎秒150,000〜220,000ポイントを取り込みました。これはベンチマークではなく、これらの実験中に私が目にした数値にすぎません。
内部:ブロック、アクティブバッファ、WAL
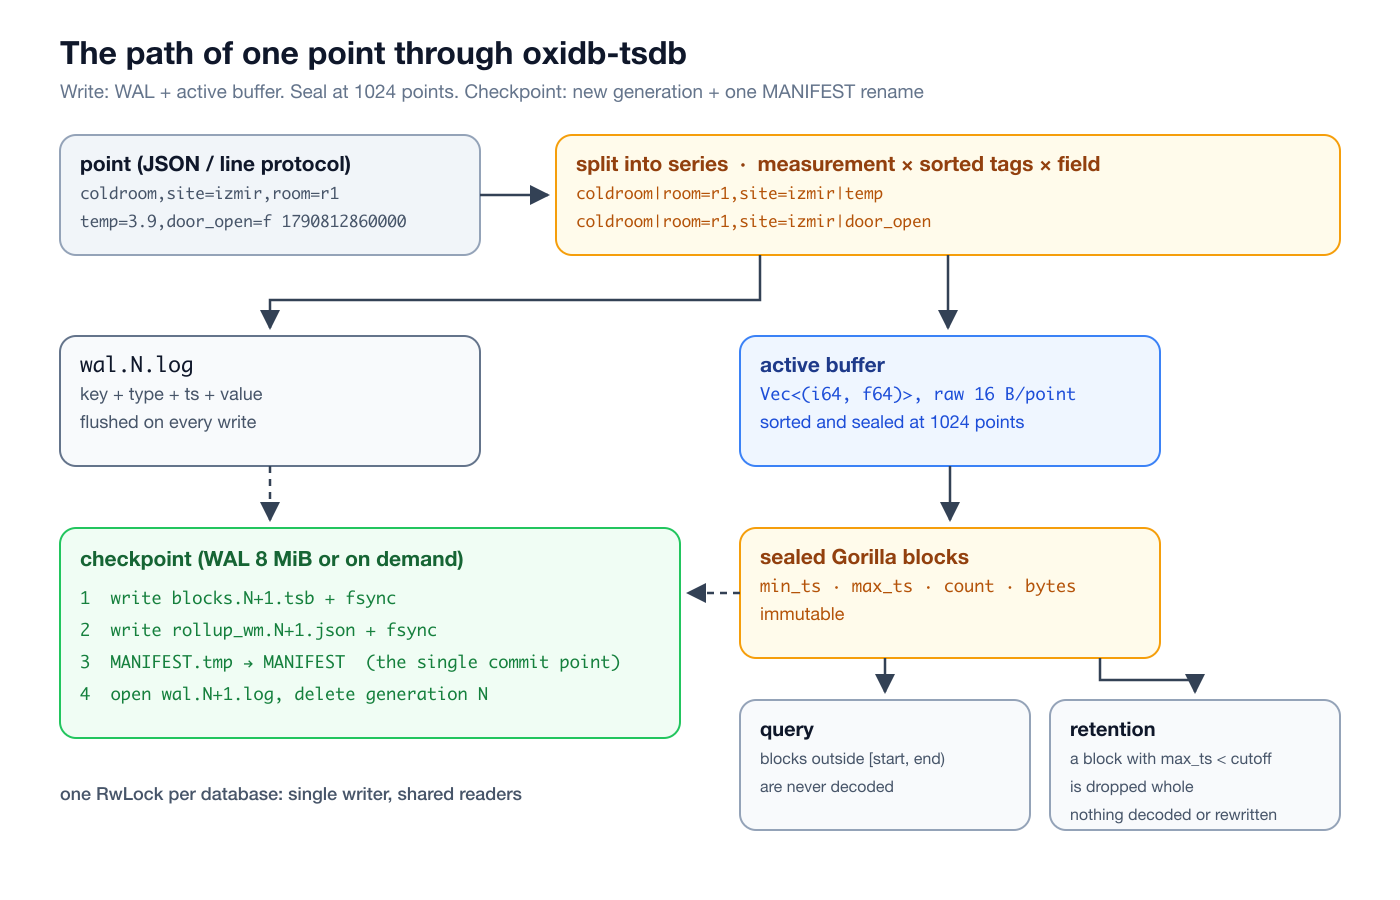
シリーズは2つの部分から成ります。封印済みブロックとアクティブバッファです。到着したポイントはまずWALに追記され、次にシリーズのバッファ(Vec<(i64, f64)>)に入れられます。バッファが1024ポイントに達すると封印されます。時刻でソートされ、Gorillaでエンコードされ、min_ts、max_ts、countを持つBlockになります。その後ブロックは決して変わりません。
ここから3つの帰結が得られます。
- クエリの枝刈り。 範囲クエリは
[start, end)と重ならないブロックをデコードしません。864,000ポイントの温度データで、1分間のウィンドウでは中央値0.19 ms、1日全体(864,000ポイントすべてをデコード)では13.1 msでした。 - リテンションはタダです。 データの期限切れは1ポイントずつの書き換えではなく、リストからブロックを丸ごと外すだけです。
- 順序の乱れた書き込みも受け付けます。 ソートは封印時にブロック内で行われます。重なり合うブロックはクエリの正しさを損なわず、枝刈りと圧縮の効率を下げるだけです。
ブロックサイズはトレードオフです。大きなブロックはよく圧縮できますが、リテンションと枝刈りの粒度が粗くなります。デフォルトの1024は妥当な中間値で、crateレベルではwith_block_pointsで変更できます。
永続性:MANIFESTが唯一のコミットポイント
ディスク上のレイアウトは次のとおりです。
<dir>/MANIFEST              {"generation": N}, the authoritative generation
<dir>/blocks.<N>.tsb        full block snapshot at checkpoint N
<dir>/wal.<N>.log           points written after N
<dir>/rollup_wm.<N>.json    rollup watermark, same generation
<dir>/rollups.json rollup rulesチェックポイントは次の順序で実行されます。アクティブバッファを封印し、blocks.<N+1>.tsbを書いてfsyncし、ウォーターマークをrollup_wm.<N+1>.jsonに書いてfsyncし、MANIFEST.tmpを書いてMANIFESTの上にアトミックにrenameし、新しいwal.<N+1>.logを開いて、世代Nのファイルを削除します。
永続性の議論全体は、この1回のrenameの前後にかかっています。renameの前にクラッシュすると、MANIFESTはNのままです。リカバリーは古いスナップショットとそのWALを読みますが、WALにはそのチェックポイント以降に書かれたすべてのポイントがまだ残っています。renameの後にクラッシュすると、リカバリーは新しいスナップショットを読み、古いWALは無視します。ポイントが二重に数えられることはありません。エンジンはWALが8 MiBを超えると自動的にチェックポイントを取り(1日分のデータを書き込んだら、私の環境では世代番号が43になりました)、checkpoint opでいつでも実行できます。SQLエンジンも同じ「世代を書き直し、1回のrenameで昇格させる」方式を使っています。
正直に言っておかなければならないことが1つあります。WALは書き込みリクエストの終わりごとにOSへflushされますが、fsyncはされません。プロセスのクラッシュでは何も失われません(後でkill -9で試しました)。書き込まれたデータはカーネルのページキャッシュにあるからです。しかし停電の場合は、最後のチェックポイント以降に書かれたポイントの一部を失う可能性があります。これはメトリクスデータのための意図的な速度のトレードオフですが、知っておくべきことです。
並行性とメモリ
各データベースのエンジンはRwLockの背後にあります。書き込みは1つずつ行われ、クエリは共有ロックの下で並行に実行されます。封印済みブロックはメモリ上にあり、Tsdb::openはスナップショット全体をロードします。したがってメモリ使用量はおおよそ圧縮後のデータサイズです。上の520万ポイントは12 MBを占めます。1 Hzのシリーズ1本の1年分は、0.1刻みのfloatなら約40 MB、整数単位なら約12 MBになります。数十億ポイントのアーカイブには向いていません。RAMに収まるホットデータとロールアップのために作られています。
クエリと集約
クエリでは、measurement、フィールド、タグのフィルター(tags、等価比較のみ)、半開区間の時間範囲[start, end)、省略可能なバケット幅(interval、ms単位)、グループ化に使うタグ(group_by)、集約(agg、デフォルトはmean)を指定します。レスポンスは常にグループのリストで、各グループはタグ、フィールドの型、ポイントを持ちます。
| 集約 | 意味 |
|---|---|
mean / avg | 平均 |
sum | 合計 |
min / max | 最小 / 最大 |
count | ポイント数 |
first / last | バケット内で最も古い / 最も新しい値 |
distinct | 異なる値の数 |
rate | 1秒あたりの変化量:(last - first) / span_s、カウンター向け |
percentile + p | p番目のパーセンタイル、線形補間(numpyのデフォルトと同じ) |
p50, p95, p99, p99.9 | percentileの省略形 |
時間でグループ化
intervalを指定すると、バケットはエポックに揃えられる(InfluxDBと同様)ので、1時間ごとのバケットはちょうど正時に来ます。1つのセンサーの最初の4時間の1時間平均です。
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "s_temp_01", "field": "temp",
 "tags": {"sensor": "s00"}, "start": 1790812800000, "end": 1790827200000,
 "interval": 3600000, "agg": "mean"}
{"ok": true, "data": [{"tags": {}, "type": "float", "points": [
{"ts": 1790812800000, "value": 2.734611111111113},
{"ts": 1790816400000, "value": 2.2817499999999957},
{"ts": 1790820000000, "value": 1.3479722222222226},
{"ts": 1790823600000, "value": 2.0618055555555315}]}]}タグと時間で同時にグループ化すると、1回のクエリでグラフの系列ごとに1本の線が得られます。10個のセンサーの6時間ごとの最大値です(出力の冒頭)。
{"tags": {"sensor": "s00"}, "type": "float", "points": [{"ts": 1790812800000, "value": 3.8}, {"ts": 1790834400000, "value": 6.0}]},
{"tags": {"sensor": "s01"}, "type": "float", "points": [{"ts": 1790812800000, "value": 5.5}, {"ts": 1790834400000, "value": 5.4}]},
{"tags": {"sensor": "s02"}, "type": "float", "points": [{"ts": 1790812800000, "value": 6.0}, {"ts": 1790834400000, "value": 5.3}]},
...tagsはシリーズをフィルタリングし、group_byは出力を分割します。両者は組み合わせられます。
パーセンタイル、rate、その他
10個のセンサーすべての1日分(864,000ポイント)に対するパーセンタイルです。値をソートする必要があるため、それぞれ約16 msかかりました。
agg=p50                 -> 3.2
agg=p95                 -> 5.7
agg=p99                 -> 5.9
agg=percentile, p=99.9 -> 6.0rateは単調増加カウンター向けです。バケットの最初と最後の値の差を、その間の時間で割ります。パケットカウンターから求めた15分バケットごとの毎秒パケット数です(毎秒40〜60パケットを生成したので、50前後が期待値です)。
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "s_counter", "field": "packets",
 "tags": {"sensor": "s03"}, "start": 1790812800000, "end": 1790816400000,
 "interval": 900000, "agg": "rate"}
{"ok": true, "data": [{"tags": {}, "type": "integer", "points": [
{"ts": 1790812800000, "value": 49.88320355951057},
{"ts": 1790813700000, "value": 49.809788654060064},
{"ts": 1790814600000, "value": 49.88987764182425},
{"ts": 1790815500000, "value": 49.77641824249166}]}]}1時間分の湿度データに対する残りの集約で、それぞれ約0.1 msです。
count    -> 3600.0
first    -> 75.0
last     -> 76.0
min      -> 73.0
sum      -> 269640.0
distinct -> 5.0rateはカウンターのリセットを知りません。バケット内でカウンターがリセットされると、負の値や低い値が見えます。Prometheusのrate()のようなリセット補正はありません。
地理的な軌跡
位置を、同じタイムスタンプで書き込んだ2つの数値フィールド(lat、lon)として保存すると、エンジンは2つの追加クエリを提供します。distance(ハバーサイン式による経路長、メートル単位)とtrack(Douglas-Peuckerで単純化した軌跡)です。イズミルでのトラックの4ポイントの軌跡です。
>>> {"op": "distance", "measurement": "truck", "tags": {"id": "t7"}}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790900060000, "value": 3423.2779930961387}]}]}

>>> {"op": "track", "measurement": "truck", "tags": {"id": "t7"}, "tolerance": 50}
<<< {"ok": true, "data": [{"tags": {"id": "t7"}, "points": [
     {"ts": 1790900000000, "lat": 38.4237, "lon": 27.1428},
     {"ts": 1790900120000, "lat": 38.4363, "lon": 27.1572},
{"ts": 1790900180000, "lat": 38.45, "lon": 27.16}]}]}一直線上にある2つ目のポイントは、50メートルの許容誤差で取り除かれました。ドキュメント側の地理クエリは、シリーズの地理空間とグラフの記事にあります。
生のTCPとPostgREST
プロトコルは単純なので、ライブラリはまったく必要ありません。同じエンジンはHTTP上でPostgRESTの文法も話します。Accept-Profile: tsdbヘッダーでリクエストがTSDBエンジンに振り分けられ、selectでフィールドを指定し、tag=eq.valueでフィルタリングし、ts=gte.とts=lt.で範囲を設定します。curlで1時間ごとの最大値を取ります。
curl -s 'http://127.0.0.1:15501/rest/v1/s_temp_01?select=temp&sensor=eq.s00&ts=gte.1790870400000&ts=lt.1790881200000&interval=3600000&agg=max' \
-H 'Accept-Profile: tsdb'[{"ts":1790870400000,"value":4.2},{"ts":1790874000000,"value":6.0},{"ts":1790877600000,"value":6.0}]書き込みはフラットなオブジェクトを受け取ります。文字列の値はタグに、数値はフィールドになります。
curl -s -i -X POST 'http://127.0.0.1:15501/rest/v1/coldroom' \
  -H 'Content-Profile: tsdb' -H 'Content-Type: application/json' \
  -d '{"ts":1790899200000,"site":"izmir","room":"r3","temp":3.6}'
HTTP/1.1 201 Createdだからこそ@supabase/postgrest-jsクライアントが.schema('tsdb')で無改造のまま動きます。PATCHとDELETEは意図的に405を返します。シリーズストアは追記専用で、データはリテンションで削除します。
継続的ロールアップとウォーターマーク
1秒ごとのデータを1年分保存するのは安上がりですが、グラフを描くたびに数百万ポイントをスキャンするのはそうではありません。標準的な答えは継続的集約です。閉じた時間バケットの要約を一度だけ計算して保存しておくのです。oxidb-tsdbでは、ロールアップのルールは「このmeasurementのすべての数値シリーズを、この幅のバケットで、これらの集約で要約せよ」と指定します。結果は<measurement>@<label>という名前の派生measurementで、フィールドは<field>_<agg>となり、元のシリーズのタグをそのまま持ちます。
>>> {"op": "rollup_add", "measurement": "s_temp_01", "label": "1m", "interval": 60000, "aggs": ["mean", "min", "max", "count"]}
<<< {"ok": true, "data": {"ok": true}}

>>> {"op": "rollups"}
<<< {"ok": true, "data": [{"measurement": "s_temp_01", "label": "1m", "interval": 60000}]}

>>> {"op": "rollup_refresh", "now": 1790899200001}
<<< {"ok": true, "data": {"written": 14400}}
    (71.67 ms)

>>> {"op": "rollup_refresh", "now": 1790899200001}
<<< {"ok": true, "data": {"written": 0}}
10個のセンサー × 1440分 = 14,400ロールアップポイントを72 msで。2回目のリフレッシュは何も書きません。最後に実体化したバケットの開始時刻が、(シリーズ, interval)のペアごとにウォーターマークとして保持されているからです。rollup_refreshは完全に閉じたバケットだけを処理します。現在の1分の半分はまだ届いていないかもしれないからです。nowを省略するとサーバーの時計を使います。私のテストデータは過去のものなので、明示的に渡しました。
要約は普通のmeasurementで、普通のクエリで読めます。
s_temp_01@1m / temp_count, agg=sum   -> 864000.0
hourly mean raw    first 3: [2.7346, 2.2817, 1.348] 1.47 ms
hourly mean rollup first 3: [2.7346, 2.2818, 1.348] 0.17 ms
1時間平均は、生データからだと1.47 ms、1分ごとのロールアップからだと0.17 msで、結果は同じでした。注意点が1つあります。1分平均の平均が正確なのは、各バケットが同じだけ埋まっているときだけです。欠損があると少しずれます。正確さが必要なら、sumとcountを実体化して比率を自分で計算してください。連鎖(1s → 1m → 1h)は勝手には起こりません。ルールを順番に定義してリフレッシュするのは呼び出し側の仕事です。ルールはrollups.jsonに書かれ、再起動を乗り越えますが、リフレッシュのトリガーはアプリケーション(あるいはスケジューラー)の仕事です。エンジンが自分で定期的に実行することはありません。
ウォーターマークはいつクラッシュセーフなのか
ウォーターマークはブロックのスナップショットと同じ世代で書かれ(rollup_wm.<N>.json)、MANIFESTのrenameによってアトミックに昇格されます。テストでは「チェックポイントの後なら、再オープンしても同じバケットを二度書くことはない」ことが保証されています。この記事のために、kill -9で2つのシナリオを試しました。
## scenario A: refresh, NO checkpoint, kill -9, restart
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 3}}
   [kill -9, restart]
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 14403}}
>>> {"op": "query", "measurement": "line_a@1m", "field": "v_mean", "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790899200000, "value": 6.0}]}]}

## scenario C: refresh + checkpoint, kill -9, restart
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 3}}
>>> {"op": "checkpoint"}
<<< {"ok": true, "data": {"ok": true}}
   [kill -9, restart]
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 0}}
>>> {"op": "query", "measurement": "line_c@1m", "field": "v_mean", "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790899200000, "value": 3.0}]}]}シナリオCは意図どおりに動きます。ウォーターマークはチェックポイントとともにディスクに届いたので、再起動後に何も書き直されませんでした。シナリオAでは穴が見つかりました。ロールアップのポイントはWALに入り、クラッシュ後に戻ってきますが、ウォーターマークが永続化されるのはチェックポイントのときだけです。再起動後、ウォーターマークは古いままだったので、同じバケットが再び書かれました(3ポイントではなく6ポイント。以前のセッションで一度もチェックポイントされていなかった14,400ポイントのロールアップも重複しました)。つまり保証は「チェックポイント済みのリフレッシュは二重に数えられない」というレベルで成り立っています。現時点での安全なパターンは単純で、rollup_refreshの直後にcheckpointを呼ぶことです。本当の修正は、ウォーターマークの更新を独自のレコードとしてWALに記録することで、私のリストに載っています。
ブロック単位のリテンション
リテンションは1つのカットオフで動きます。最新のポイントがカットオフより古いブロックが削除されます。私は意図的にカットオフをブロックの途中、12:08:20に置きました。
>>> {"op": "query", "measurement": "s_temp_01", "field": "temp", "tags": {"sensor": "s00"}, "end": 1790856500000, "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790812800000, "value": 43700.0}]}]}

>>> {"op": "retention", "cutoff": 1790856500000}
<<< {"ok": true, "data": {"removed": 2584391}}
    (0.1 ms)

>>> {"op": "query", "measurement": "s_temp_01", "field": "temp", "tags": {"sensor": "s00"}, "end": 1790856500000, "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790855808000, "value": 692.0}]}]}
258万ポイントが0.1 msで消えました。何もデコードも書き換えもされず、リストからブロックが外されただけだからです。カットオフより古いポイントが692個残りました。これらは11:56:48に始まり、カットオフを越えて続くブロックに属しています。リテンションの粒度はブロック幅に等しく、1 Hzのシリーズなら1024ポイント、約17分です。削除されたブロックは次のスナップショットに含まれないので、リテンションは追加の作業なしに永続化されます。
はっきり述べておくべき限界が2つあります。カットオフはデータベース全体に適用されます。同じ呼び出しでcoldroom measurementの真夜中のポイントも削除されました(後で実行したcountは空で返ってきました)。measurementごとに異なるリテンションが必要なら、measurementを別々のデータベースに置く必要があります。古典的な「生データは7日、ロールアップは1年」というパターンについては、現時点では穴です。また、リテンションも勝手には実行されません。定期的に呼び出すのはアプリケーションの仕事です。
ロックの少ないバックアップとリストア
バックアップは、エンジンのディレクトリの一貫した.tar.gzです。重要なのは、遅い作業(圧縮)がエンジンのロックを解放した状態で行われることです。3つのフェーズがあります。
- backup_begin(書き込みロックの下で、O(1)):WALをflushし、現在の世代を参照カウントで「ピン留め」し、WALの現在の長さを記録します。
- backup_write(ロックなし):合成したMANIFEST、その世代のブロックファイル、記録した長さまでのWALの安定したプレフィックス、ロールアップのファイルをアーカイブに書き込みます。世代ごとのWALは追記されるかローテーションされるだけなので、そのプレフィックスが変わることはありません。
- backup_end(書き込みロックの下で、O(1)):ピンを外します。バックアップ中にチェックポイントがその世代を置き換えていた場合は、ここでそのファイルを削除します。
その間も書き込みとチェックポイントは続きます。チェックポイントがピン留めされた世代のファイルを削除することはありません。測定してみました。一方の接続が単一ポイントを書き込み続け、もう一方の接続がバックアップを取ります。
backup: {'ok': True, 'data': {'path': '.../backup/lowlock.tar.gz', 'size_bytes': 9531869}} took 860 ms
during backup   writes= 1482  p50=0.050 ms  p99=4.073 ms  max=10.486 ms
outside backup  writes= 3213  p50=0.060 ms  p99=4.082 ms  max=11.223 ms
バックアップ中も書き込みのレイテンシーには影響がありません。530万ポイントのデータベースは9.5 MBにアーカイブされます。Gorillaのブロックはすでに圧縮されているので、gzipではほとんど縮みません。リストアは空のディレクトリに展開します。
{"engine": "tsdb", "cmd": "backup", "path": "/backups/tsdb-2026-10-02.tar.gz"}
{"engine": "tsdb", "cmd": "restore", "archive": "/backups/tsdb-2026-10-02.tar.gz", "target": "/restore/tsdb"}リストアしたディレクトリをOXIDB_TSDB_DATAで指定して、2つ目のサーバーをポート15510で起動しました。statsはバックアップ前の値と完全に一致しました。
{"ok": true, "data": {"series": 114, "points": 5299594, "bytes": 12382229}}リストアは動作中のエンジンを上書きしません。新しいディレクトリでエンジンを開きます。空でない展開先ディレクトリは拒否されます。
ドキュメント側の時間ステージ
OxiDBでの時系列処理はこのエンジンに限りません。ドキュメントエンジンの集約パイプラインには3つの時間ステージがあり、イベントデータがすでにドキュメントとして存在する場合は、こちらが適したツールであることが多いです。6件の取引を持つtradesコレクションで試します。
$ohlcvはティックをローソク足に変えます。fill: "previous"は空の1分を前の終値で埋めます。
{"$ohlcv": {"time": "ts", "interval": "1m", "price": "price", "volume": "qty", "symbol": "sym", "fill": "previous"}}
-> {"symbol": "ACME", "time": "2026-10-01T09:00:00Z", "open": 101.0, "high": 102.5, "low": 100.5, "close": 100.5, "volume": 6.0, "count": 3}
   {"symbol": "ACME", "time": "2026-10-01T09:01:00Z", "open": 100.0, "high": 100.0, "low": 99.5, "close": 99.5, "volume": 9.0, "count": 2}
   {"symbol": "ACME", "time": "2026-10-01T09:02:00Z", "open": 99.5, "high": 99.5, "low": 99.5, "close": 99.5, "volume": 0.0, "count": 0}
{"symbol": "ACME", "time": "2026-10-01T09:03:00Z", "open": 101.5, "high": 101.5, "low": 101.5, "close": 101.5, "volume": 2.0, "count": 1}$dateHistogramはカレンダーを考慮した時間バケットを作ります。min_doc_count: 0で空のバケットも出力します。
{"$dateHistogram": {"field": "ts", "interval": "1m", "min_doc_count": 0, "accumulators": {"volume": {"$sum": "$qty"}}}}
-> {"_id": "2026-10-01T09:00:00Z", "count": 3, "volume": 6}
   {"_id": "2026-10-01T09:01:00Z", "count": 2, "volume": 9}
   {"_id": "2026-10-01T09:02:00Z", "count": 0}
{"_id": "2026-10-01T09:03:00Z", "count": 1, "volume": 2}$setWindowFieldsは時間範囲のウィンドウをサポートします。「直近5ドキュメント」ではなく「直近2分」です。
{"$setWindowFields": {"sortBy": {"ts": 1}, "output": {"avg_2m": {"$avg": "$price", "window": {"range": [-2, 0], "unit": "minute"}}}}}
-> {"ts": "2026-10-01T09:00:05Z", "price": 101.0, "avg_2m": 101}
   {"ts": "2026-10-01T09:00:40Z", "price": 102.5, "avg_2m": 101.75}
   {"ts": "2026-10-01T09:00:55Z", "price": 100.5, "avg_2m": 101.33333333333333}
   {"ts": "2026-10-01T09:01:10Z", "price": 100.0, "avg_2m": 101}
   {"ts": "2026-10-01T09:01:30Z", "price": 99.5, "avg_2m": 100.7}
{"ts": "2026-10-01T09:03:20Z", "price": 101.5, "avg_2m": 100.5}おおまかに言えば、イベントの情報が豊富だったり、形がまちまちだったり、数が少なかったりするなら、ドキュメントとこれらのステージを使います。同じ形の数値の読み取りが数百万件あるなら、TSDBを使います。両者は一緒にうまく働きます。リポジトリのexamples/coldchainデモでは、センサーの読み取り値がMQTTで届き、数値はTSDBへ、デバイスが送ってきたままの生のイベントはドキュメントエンジンへ送られます。時系列は温度が上がっていく様子を示し、ドキュメントはその理由(door_open: true)を示します。MQTT側については、シリーズのMQTTとAMQPの記事で扱っています。
限界と正直なトレードオフ
このエンジンを使う前に知っておくべきことを1か所にまとめます。
- メモリ上で動きます。 封印済みブロックはRAMにあり、メモリ使用量はおおよそ圧縮後のデータサイズです。ホットデータとロールアップには最適ですが、何年分もの生データのアーカイブには向きません。
- タグのインデックスはありません。 クエリはデータベース内のすべてのシリーズキーを走査し、measurementとタグでフィルタリングします。数千シリーズ程度なら気づかないでしょうが、カーディナリティの高いタグ(たとえばユーザーID)は、その走査とメモリの両方を増やします。タグは有限の値の集合から取るべきです。
- タグのフィルターは等価比較のみです。 正規表現、
!=、INはありません。 - 1つのフィールドに1つの集約。 クエリは1つのフィールドを1つの集約で返します。
meanとmaxを両方取るなら2回のクエリです。 - リテンションはデータベース全体に適用され、ロールアップのリフレッシュもリテンションも自動では実行されません。
- ウォーターマークが永続化されるのはチェックポイント時です。 リフレッシュの後にはチェックポイントを取ってください。
- WALはfsyncされません。 プロセスのクラッシュには安全ですが、停電時には最後のチェックポイント以降のポイントが危険にさらされます。
- 文字列フィールドは圧縮されません。 生の
(timestamp, text)ペアとして保存されます。 - クラスターではレプリケーションされません。 Raftクラスターでは、TSDBへの書き込みはそれを受け取ったノードに留まります。ADR-0025はこれを推薦エンジンと共通の穴として明記し、両者を一緒に解消する見込みとしています。
- タイムスタンプはミリ秒です。 ナノ秒を送るInfluxDBクライアントは、タイムスタンプを変換する必要があります。
これらは未完成のプロトタイプの限界ではなく、意図的に絞った範囲の限界です。単一プロセス内のメトリクスデータで、メモリに収まり、よく圧縮され、高速にクエリできること。InfluxDBクラスターを置き換えようとはしていません。しかし、アプリケーションのメトリクスを、そのドキュメント、テーブル、キャッシュと同じバイナリに置きたいとき、2つ目のシステムを運用する手間を省いてくれます。
試してみる
ビルド済みのOxiDBリリースはGitHubのリリースページにあります。macOS(arm64/x86_64)、Linux(x86_64/arm64)、Windowsのバイナリです。リポジトリからDockerで動かすならdocker compose up -dで十分です。時系列エンジンの有効化に必要なのはOXIDB_TSDB=1だけです。この記事の測定を自分のデータで再現したいなら、1日分のデータをラインプロトコルで書き込み、checkpointの後にstatsを見るのが一番簡単です。bytesをpointsで割れば、1ポイントあたりに払っているコストが分かります。そして、センサーの分解能が固定なら、値を整数単位で書き込んでみてください。私のデータでは3.5倍の差がありました。
シリーズの次の記事は、Redisプロトコルを話すキーバリューエンジンOxiMemです(OxiMemの記事)。