El motor de series temporales de OxiDB: compresión Gorilla, rollups y retención a nivel de bloque
A fondo: oxidb-tsdb, el motor de series temporales de OxiDB: la compresión Gorilla bit a bit, campos tipados, line protocol, agregaciones, rollups continuos con marca de agua, copias de seguridad con bloqueo mínimo y tasas de compresión reales medidas con mis propios datos de sensores.
Imaginemos un almacén frigorífico con diez sensores de temperatura, cada uno informando una vez por segundo. Son 864.000 puntos al día y 315 millones al año. Se podría guardar cada uno de ellos como un documento JSON, y el motor de documentos de OxiDB lo haría encantado, pero cada documento repetiría el mismo nombre de medición, las mismas etiquetas y los mismos nombres de campo, con un coste de más de cien bytes por punto. La información que realmente transporta un punto es una marca de tiempo y un número. Por eso escribí un motor de series temporales aparte para OxiDB: oxidb-tsdb. Este artículo cubre para qué sirve, cómo activarlo, el modelo de datos, la compresión Gorilla bit a bit, las consultas y agregaciones, los rollups continuos, la retención y las copias de seguridad. Todas las salidas que se muestran aquí provienen de un oxidb-server 0.44.2 real que ejecuté para este artículo en mi propia máquina (Apple M4, en local), y las tasas de compresión se midieron sobre datos de sensores que generé.
¿Por qué un motor aparte?
Los datos de series temporales tienen tres rasgos definitorios. Su forma nunca cambia: la misma medición, las mismas etiquetas, los mismos campos, para siempre. Sus marcas de tiempo son regulares: un recolector que escribe una vez por segundo escribe aproximadamente cada 1000 ms. Sus valores cambian despacio: una temperatura suele ser idéntica a la lectura anterior o difiere en el último dígito. Además, los datos casi siempre se añaden al final, y las consultas preguntan por rangos y resúmenes, no por puntos individuales: "la media por minuto de la última hora", "el p95 de hoy".
El modelo de documentos no puede aprovechar nada de esto, porque su flexibilidad proviene de adjuntar un esquema a cada documento. El almacenamiento columnar elimina justamente esa repetición: el nombre del campo se escribe una sola vez en la identidad de la serie, y los valores se convierten en un flujo anónimo de tipo uniforme. Valores parecidos uno al lado del otro es lo que más le gusta a la compresión.
Igual que el motor SQL, oxidb-tsdb es un crate de Rust independiente que se ejecuta dentro del mismo proceso, pero tiene su propio directorio, su propio formato de archivo y su propia superficie de consulta. Está desactivado por defecto y no cuesta nada hasta que se activa.
Activarlo
Basta con una variable de entorno:
OXIDB_ADDR=127.0.0.1:15500 \
OXIDB_DATA=./data \
OXIDB_TSDB=1 \
OXIDB_HTTP_PORT=15501 \
./oxidb-server
El motor se construye de forma perezosa, y en la primera petición TSDB el servidor registra:
[oxidb] TSDB engine enabled (default db at ./data/tsdb)OXIDB_TSDB_DATA traslada a otro lugar el directorio TSDB de la base de datos por defecto. Igual que el motor SQL, funciona por base de datos: la base de datos por defecto vive en $OXIDB_DATA/tsdb, una base de datos llamada metrics en $OXIDB_DATA/metrics/tsdb. Incluso se puede desactivar por completo el motor de documentos (OXIDB_DOC=0) y ejecutar el proceso solo como servidor SQL y TSDB.
El protocolo de red es el que OxiDB usa para todos los motores: un prefijo de longitud de 4 bytes en little-endian seguido de JSON. Una petición añade "engine": "tsdb", todas las peticiones usan cmd: "tsdb" y un campo op elige la acción: write, write_lp, query, distance, track, stats, retention, checkpoint, rollup_add, rollup_refresh, rollups. En términos de RBAC, el rol Read solo puede ejecutar consultas; las escrituras, la retención y las definiciones de rollups necesitan ReadWrite.
En los ejemplos uso la llamada de bajo nivel _request del cliente Python del repositorio. Todavía no hay un helper específico para TSDB, ni hace falta:
from oxidb import OxiDbClient

db = OxiDbClient(host="127.0.0.1", port=15500)

def tsdb(op, **kw):
    return db._request({"engine": "tsdb", "cmd": "tsdb", "op": op, **kw})
El modelo de datos: mediciones, etiquetas, campos
Es el modelo de InfluxDB. Un punto tiene cuatro partes: un nombre de medición (measurement), cero o más etiquetas (tags, todas cadenas), uno o más campos (fields, los valores medidos) y una marca de tiempo en milisegundos.
Las etiquetas son identidad: qué sede, qué sala, qué sensor. Por ellas se filtra y se agrupa. Los campos son datos. Internamente el motor impone esta separación de forma estricta:
Una serie = medición × conjunto de etiquetas (ordenado) × nombre de campo.
Así, el punto coldroom,site=izmir,room=r1 temp=3.9,door_open=f lleva dos campos y se convierte en dos series separadas: coldroom|room=r1,site=izmir|temp y coldroom|room=r1,site=izmir|door_open. Las etiquetas se ordenan por clave, de modo que el mismo conjunto de etiquetas acaba en la misma serie sin importar el orden en que se escribió.
Campos tipados
Los campos tienen tipo: float, integer, boolean y string. Los tres tipos numéricos comparten la ruta de Gorilla y se almacenan todos internamente como f64 (los enteros son exactos hasta 2^53, los booleanos son 0/1), pero el tipo se recuerda por serie y se devuelve como "type" en los resultados de las consultas. Las cadenas siguen una ruta aparte, como pares (timestamp, text) sin procesar.
Al escribir JSON, el valor JSON decide el tipo: true/false es boolean, un número entero es integer, una cadena es string y cualquier otra cosa es float. Dos puntos en una sola petición:
{"engine": "tsdb", "cmd": "tsdb", "op": "write", "points": [
  {"measurement": "coldroom", "tags": {"site": "izmir", "room": "r1"},
   "fields": {"temp": 3.8, "door_open": false, "compressor_rpm": 2950, "state": "cooling"},
   "ts": 1790812800000},
  {"measurement": "coldroom", "tags": {"site": "izmir", "room": "r2"},
   "fields": {"temp": 4.1, "door_open": true, "compressor_rpm": 3010, "state": "defrost"},
   "ts": 1790812800000}]}
{"ok": true, "data": {"written": 2}}Line protocol de InfluxDB
La lingua franca de las métricas es el line protocol de InfluxDB; recolectores como Telegraf lo hablan, y el motor lo ingiere directamente. Los sufijos fijan el tipo: 3.9 float, 2940i integer, t/f/true/false boolean, "..." string. La marca de tiempo está en milisegundos (InfluxDB usa nanosegundos por defecto, así que cuidado); sin ella, se usa la hora actual del servidor. Los espacios y las comas se pueden escapar con una barra invertida (us\ midwest).
{"engine": "tsdb", "cmd": "tsdb", "op": "write_lp",
 "lp": "coldroom,site=izmir,room=r1 temp=3.9,door_open=f,compressor_rpm=2940i,state=\"cooling\" 1790812860000\ncoldroom,site=izmir,room=r2 temp=4.4,door_open=t,compressor_rpm=3050i,state=\"defrost\" 1790812860000\ncoldroom,site=ankara,room=r1 temp=2.7,door_open=false,compressor_rpm=2800i,state=\"cooling\" 1790812860000"}
{"ok": true, "data": {"written": 3}}Unas cuantas consultas para ver cómo vuelven los tipos. Última temperatura agrupada por sede y sala:
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "coldroom", "field": "temp",
 "group_by": ["site", "room"], "agg": "last"}
{"ok": true, "data": [
{"tags": {"site": "ankara", "room": "r1"}, "type": "float", "points": [{"ts": 1790812860000, "value": 2.7}]},
{"tags": {"site": "izmir", "room": "r1"}, "type": "float", "points": [{"ts": 1790812800000, "value": 3.9}]},
{"tags": {"site": "izmir", "room": "r2"}, "type": "float", "points": [{"ts": 1790812800000, "value": 4.4}]}]}Las RPM del compresor se informan como integer y la puerta como boolean, y la media de un booleano es simplemente "la fracción de tiempo que la puerta estuvo abierta":
compressor_rpm, tags={"site":"izmir"}, agg=max
{"tags": {}, "type": "integer", "points": [{"ts": 1790812800000, "value": 3050.0}]}

door_open, group_by=["room"], agg=mean
{"tags": {"room": "r1"}, "type": "boolean", "points": [{"ts": 1790812800000, "value": 0.0}]}
{"tags": {"room": "r2"}, "type": "boolean", "points": [{"ts": 1790812800000, "value": 1.0}]}

state, agg=distinct
{"tags": {}, "type": "string", "points": [{"ts": -4611686018427387904, "value": 2.0}]}
En estas salidas hay dos aristas ásperas y prefiero mostrarlas antes que esconderlas. Primero, una consulta sin interval marca su único bucket con la marca de tiempo del punto más antiguo que contiene: arriba, last devuelve correctamente 3.9, pero lo empareja con la hora del primer punto. Segundo, la ruta de consulta de cadenas todavía deja escapar el centinela de "rango no acotado" que ya corregí en la ruta numérica: si no se pasa un start, la marca de tiempo vuelve como i64::MIN/2. El valor es correcto, la marca de tiempo no tiene sentido; es un pequeño bug que hay que corregir, y pasar un start lo hace desaparecer.
La compresión Gorilla
El corazón del motor es gorilla.rs. Toma su nombre de la base de datos de series temporales en memoria que Facebook describió en VLDB en 2015, y la idea se apoya en dos pilares: codificar las marcas de tiempo como delta-of-delta y los valores como XOR. Un bloque se autodescribe: [u32 count][i64 t0][f64 v0][bitstream], una cabecera de 20 bytes seguida de un cuerpo empaquetado a nivel de bits. El cuerpo contiene primero todas las marcas de tiempo y después todos los valores.
Marcas de tiempo: delta-of-delta
Un sensor que escribe una vez por segundo tiene diferencias consecutivas (deltas) de 1000; la diferencia de las diferencias (dod) es cero. Un único bit 0 codifica el cero. En otro caso, el valor se codifica en zigzag y cae en un bucket de anchura variable:
| Rango del dod | Prefijo | Carga útil | Total |
|---|---|---|---|
| 0 | 0 | ninguna | 1 bit |
| -64 .. 63 | 10 | 7 bits | 9 bits |
| -256 .. 255 | 110 | 9 bits | 12 bits |
| -2048 .. 2047 | 1110 | 12 bits | 16 bits |
| cualquier otro | 1111 | 64 bits | 68 bits |
Una sutileza: el primer delta se codifica frente a un "delta anterior" de cero. En una serie de 1 segundo el primer dod es 1000 y cuesta 16 bits; en una serie de 10 segundos es 10.000, que supera 2047 y cuesta 68 bits. Se paga una vez por bloque, así que no importa.
Valores: XOR
Se aplica XOR a los patrones de bits de dos valores f64 consecutivos. Si el valor no cambió, el XOR es cero y se escribe un único bit 0. Si cambió, se guarda la ventana significativa del XOR (tras los ceros iniciales, antes de los ceros finales). Si la ventana anterior cubre el nuevo XOR (al menos tantos ceros iniciales y al menos tantos ceros finales), se omite la descripción de la ventana: 1 (cambió), 0 (misma ventana) y los bits significativos. En otro caso se escribe 1, 1, un recuento de ceros iniciales de 5 bits, una longitud de ventana de 6 bits y la propia ventana.
Un ejemplo práctico, bit a bit
En lugar de dejarlo en lo abstracto, seguí a mano una serie de cinco puntos. Las marcas de tiempo son 0, 1000, 2000, 3003, 4000 ms (la cuarta lectura llega 3 ms tarde) y los valores son 21.5, 21.5, 21.75, 21.5, 22.0. Porté a Python línea a línea el codificador de gorilla.rs, escribí la misma serie en el servidor real, ejecuté un checkpoint, después parseé blocks.43.tsb y extraje el bloque que había producido el servidor:
values (hex bits):
    21.5 = 4035800000000000
    21.5 = 4035800000000000
   21.75 = 4035c00000000000
    21.5 = 4035800000000000
    22.0 = 4036000000000000
trace:
   ('ts', 1000, 1000, 1000, '1110 011111010000')
   ('ts', 2000, 1000, 0, '0')
   ('ts', 3003, 1003, 3, '10 0000110')
   ('ts', 4000, 997, -6, '10 0001011')
   ('val', 21.5, '0000000000000000', '-', '0')
   ('val', 21.75, '0000400000000000', 'new lead=17 trail=46 m=1', '1 1 10001 000000 1')
   ('val', 21.5, '0000400000000000', 'reuse lead=17 trail=46', '1 0 1')
   ('val', 22.0, '0003800000000000', 'new lead=14 trail=47 m=3', '1 1 01110 000010 111')
bitstream: 69 bits -> 9 bytes; block = 20 header + 9 = 29 bytes (raw 5x16 = 80)
python block: 0500000000c4c2f4a00100000000000000803540e7d041a16e206ee0b8
server block: 0500000000c4c2f4a00100000000000000803540e7d041a16e206ee0b8 min 1790812800000 max 1790812804000 count 5
IDENTICAL: True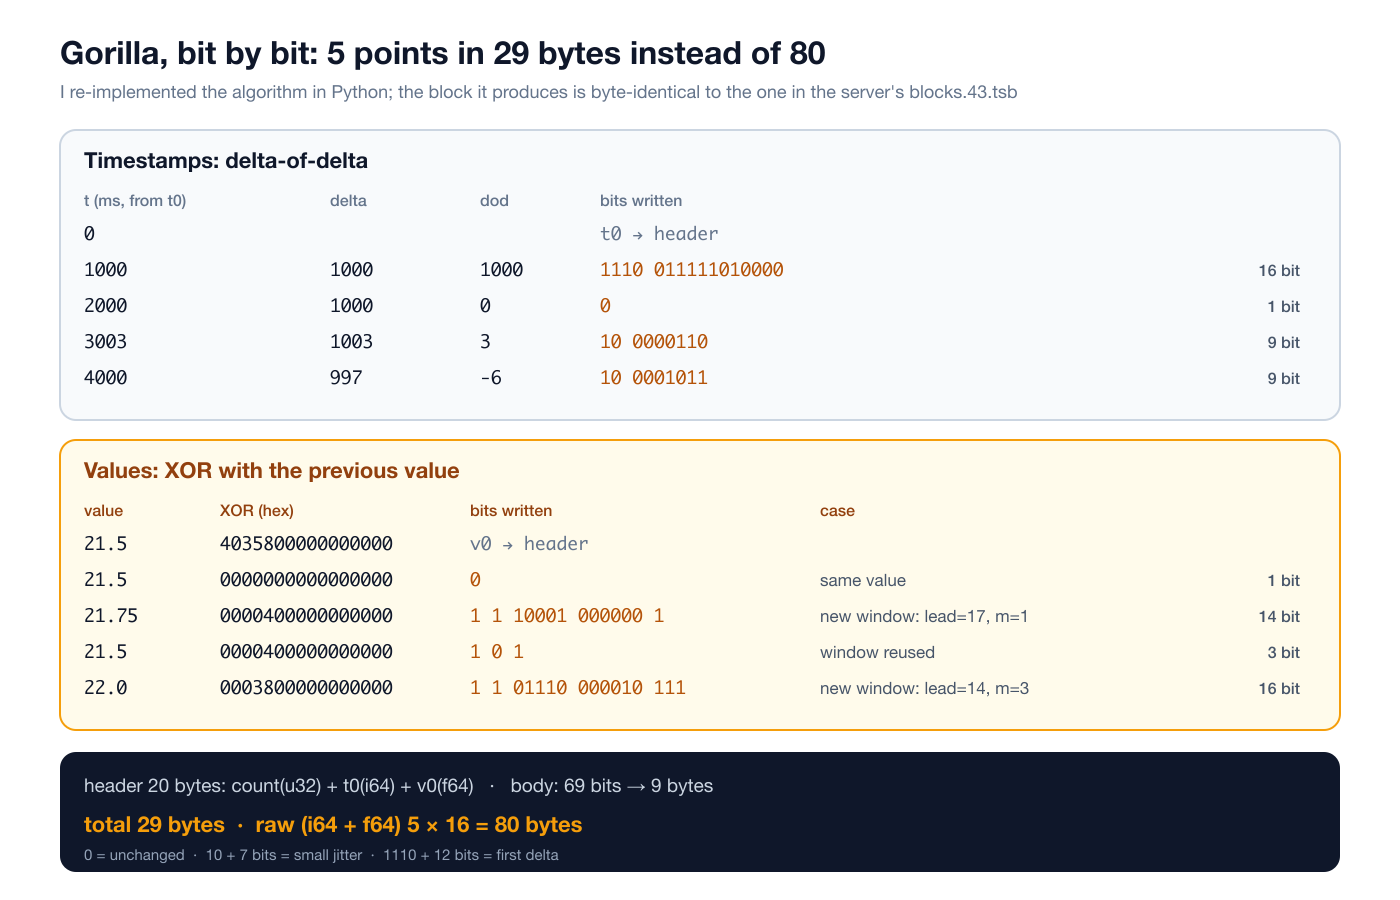
Leyéndolo línea a línea:
- El primer delta es 1000 y, como el delta anterior cuenta como 0, el dod también. Cae en el bucket -2048..2047: el prefijo
1110más el zigzag de 1000 (2000, en 12 bits:011111010000). 16 bits. - El segundo punto llega a tiempo: dod 0, un bit.
- El retraso de 3 ms se paga dos veces: primero el delta pasa a 1003, así que el dod es +3 (
10+ zigzag(3)=6); después el siguiente delta baja a 997, así que el dod es -6 (10+ zigzag(-6)=11). 9 bits cada uno. Las mediciones de más abajo muestran por qué el jitter sale caro. - El segundo valor no cambia: un único bit
0. - 21.75: su XOR con 21.5 es
0000400000000000. Hay un bit activo: 17 ceros iniciales, 46 finales, una ventana de 1 bit. No hay ventana anterior, así que se escribe la descripción:1 1 10001 000000 1, 14 bits. - De vuelta a 21.5: el mismo XOR; la ventana lo cubre y se reutiliza:
1 0 1, solo 3 bits. - 22.0: XOR
0003800000000000, los ceros iniciales bajan a 14, la ventana anterior ya no lo cubre, así que se escribe una nueva: 16 bits.
Son 35 bits de marcas de tiempo y 34 bits de valores, 69 bits, redondeados hacia arriba a 9 bytes. Con la cabecera son 29 bytes; en bruto (i64 + f64) serían 80. Con cinco puntos domina la cabecera; la ganancia real aparece en bloques de 1024 puntos, donde la cabecera se reduce a 0,16 bits por punto.
Elegí valores como 21.5, 21.75 y 22.0, que son exactos en binario. Un sensor de temperatura real envía 3.8 y 3.9, cuyo XOR es 0001555555555555: una ventana de 49 bits. Las fracciones decimales tienen expansiones binarias infinitas, y eso infla el XOR. Las mediciones de más abajo muestran cuánto importa esto en la práctica.
La tasa de compresión real, con mis propios datos de sensores
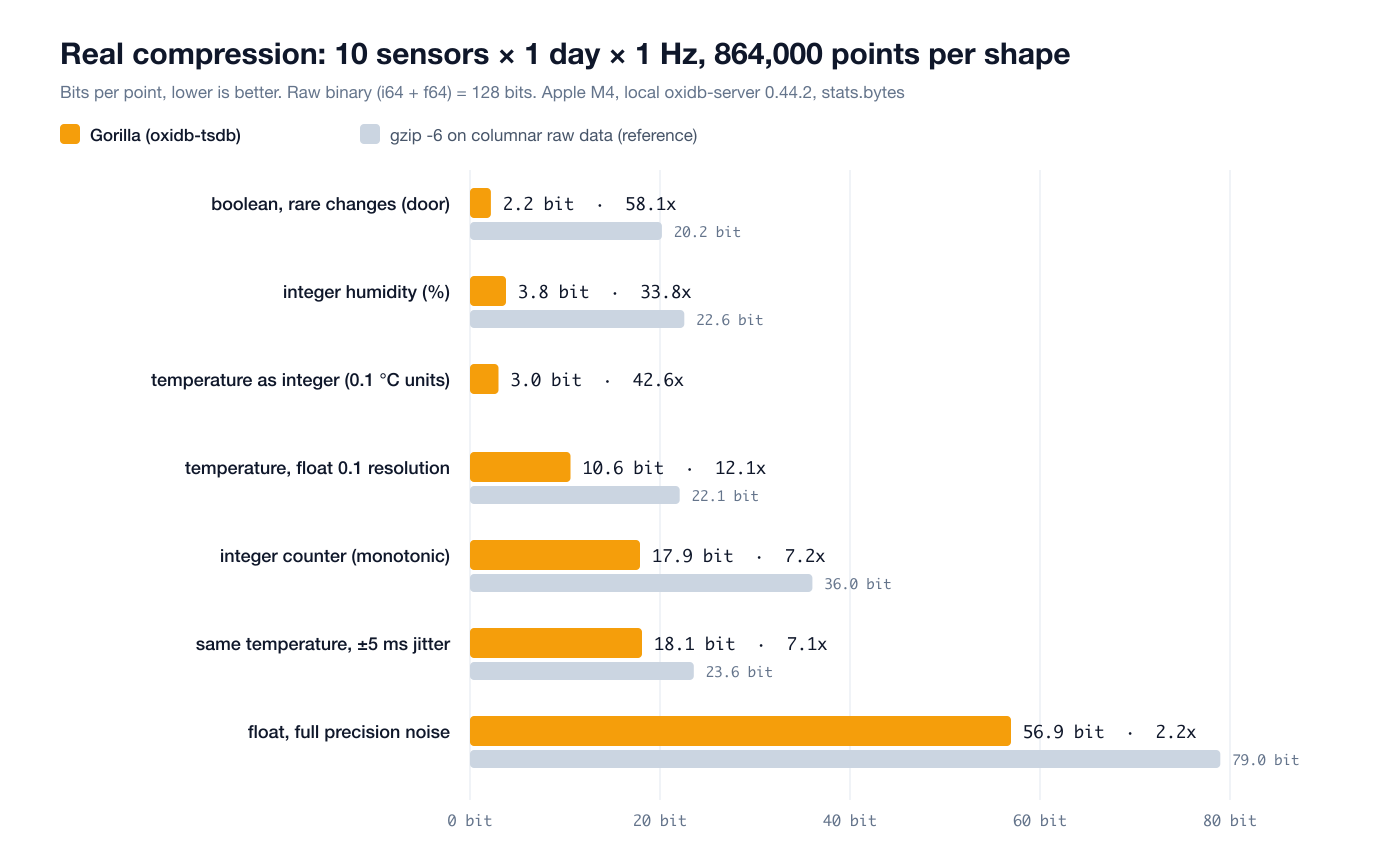
El libro del repositorio y examples/ratio.rs citan unos 0,28 bytes por punto (aproximadamente 56x frente al binario en bruto) para un indicador redondeado que mantiene su valor durante largos tramos. Esa es la medición del propio proyecto; yo quería ver distintas formas de datos en lugar del caso favorable. Generé diez sensores, un día, una muestra por segundo (864.000 puntos por forma), los escribí mediante line protocol en lotes de 10.000 líneas, ejecuté un checkpoint y medí el cambio en el número de bytes comprimidos que informa stats. Como referencia, comprimí también los mismos datos en formato binario columnar en bruto (todas las marcas de tiempo y luego todos los valores) con zlib nivel 6.
| Forma de los datos | Comprimido | Bits/punto | frente a binario en bruto | gzip -6 |
|---|---|---|---|---|
| puerta booleana, cambios poco frecuentes | 238.066 B | 2,2 | 58,1x | 6,3x |
| humedad entera (%) | 409.529 B | 3,8 | 33,8x | 5,7x |
| temperatura, float, resolución 0,1 | 1.142.690 B | 10,6 | 12,1x | 5,8x |
| misma temperatura, jitter de ±5 ms en las marcas de tiempo | 1.955.295 B | 18,1 | 7,1x | 5,4x |
| contador entero (monótono) | 1.933.080 B | 17,9 | 7,2x | 3,6x |
| float, ruido de precisión completa | 6.150.471 B | 56,9 | 2,2x | 1,6x |
De esta tabla se desprenden varias lecciones:
- Los datos que cambian poco son casi gratis. El sensor de la puerta cuesta 2,2 bits por punto: 1 bit de tiempo y, normalmente, 1 bit de valor. 58x frente al binario en bruto.
- Los floats decimales salen caros. La temperatura con resolución 0,1 cuesta 10,6 bits por punto. En el paseo aleatorio que generé, el valor cambia en aproximadamente el 16% de los puntos, y cada cambio escribe una ventana XOR de unos 49 bits.
- Guardar los mismos datos como enteros es 3,5 veces mejor. Lo probé por separado: la misma serie de temperatura, generada con la misma semilla, escrita una vez como floats del tipo
3.8y otra como enteros en unidades de 0,1 °C del tipo38i. La versión float ocupó 1.132.370 bytes (10,5 bits/punto, 12,2x) y la versión entera 324.259 bytes (3,0 bits/punto, 42,6x). Los enteros tienen ceros en los bits bajos de la mantisa de su patrónf64, así que la ventana XOR se mantiene estrecha. Si la resolución del sensor es fija, conviene escribirla en unidades enteras. - El jitter de las marcas de tiempo importa tanto como la compresión de los valores. Añadir únicamente ±5 ms de ruido a las marcas de tiempo de los mismos datos de temperatura sumó 7,5 bits por punto. Que el recolector redondee las marcas de tiempo a su propio tic (un segundo entero, por ejemplo) aporta mucho.
- Los contadores quedan en medio. Cada valor de un contador monótono es distinto y su magnitud no deja de cambiar, así que el XOR solo puede hacer hasta cierto punto. 17,9 bits.
- El ruido no obtiene milagros. Con floats aleatorios de precisión completa, Gorilla se queda en 2,2x, aunque incluso ahí supera a gzip.
En todos los casos Gorilla supera a gzip, que es de propósito general, porque conoce los datos. Para comparar, el mismo punto como documento JSON ocupaba de 107 a 122 bytes, y como texto de line protocol de 55 a 70 bytes. Las seis formas juntas sumaban 5.184.000 puntos y 11,8 MB de datos comprimidos; el archivo blocks.43.tsb en disco ocupaba 12,2 MB (la diferencia es la clave de serie repetida en cada registro de bloque).
Una nota sobre la velocidad de escritura: desde una sola conexión Python, en lotes de 10.000 líneas e incluyendo la propia generación de datos en Python, ingirió entre 150.000 y 220.000 puntos por segundo. No es un benchmark, solo la cifra que vi mientras hacía estos experimentos.
Por dentro: bloques, el búfer activo y el WAL
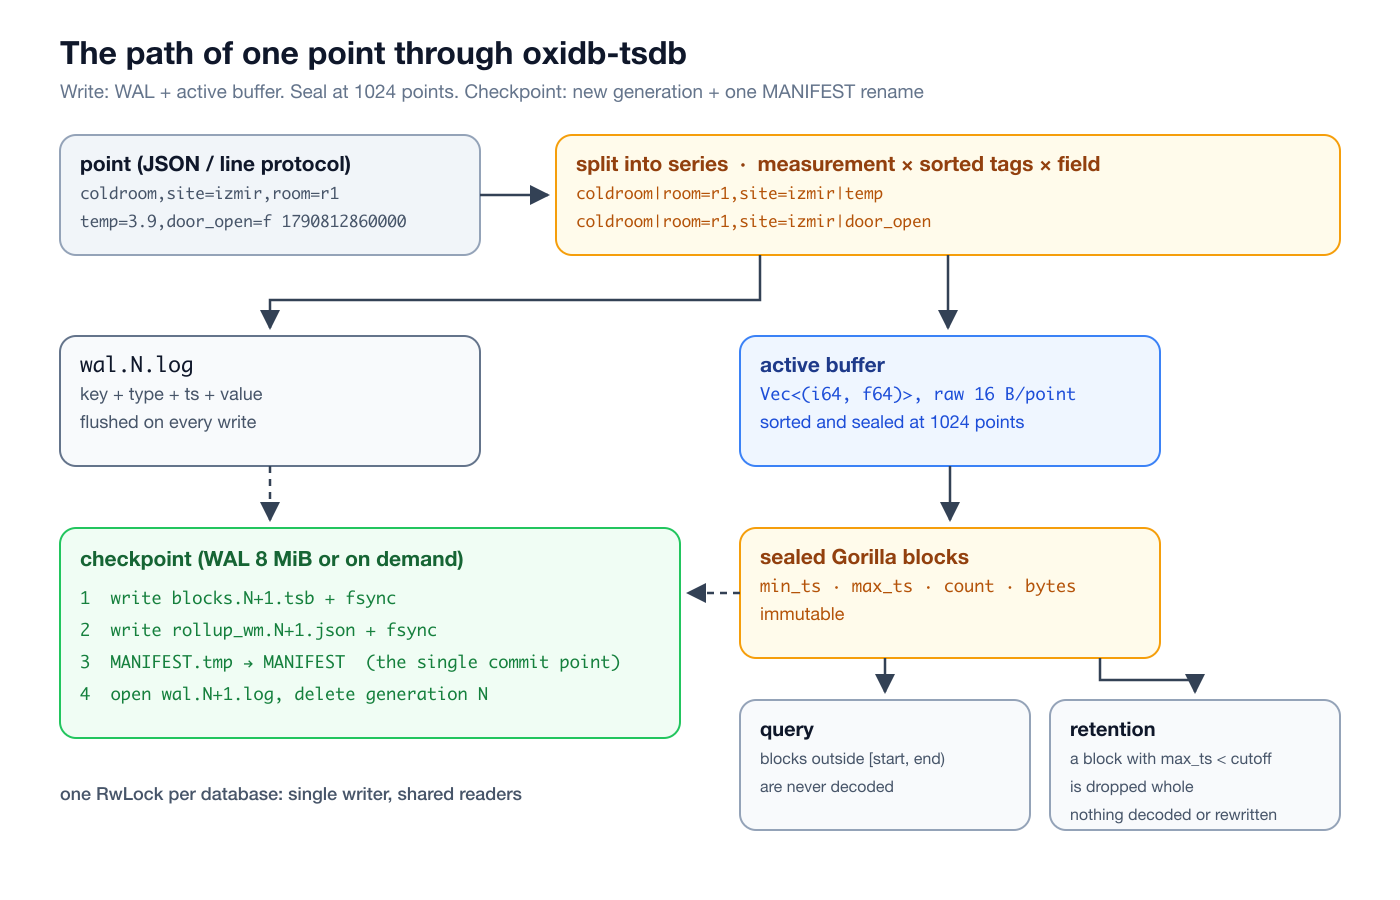
Una serie tiene dos partes: bloques sellados y un búfer activo. Un punto entrante se añade primero al WAL y después se introduce en el búfer de la serie (un Vec<(i64, f64)>). Cuando el búfer llega a 1024 puntos, se sella: se ordena por tiempo, se codifica con Gorilla y se convierte en un Block con min_ts, max_ts y count. A partir de ahí los bloques no cambian nunca.
De ello se derivan tres consecuencias:
- Poda de consultas. Una consulta de rango nunca decodifica bloques que no se solapan con
[start, end). Sobre los datos de temperatura de 864.000 puntos medí una mediana de 0,19 ms para una ventana de un minuto y 13,1 ms para el día completo (en el que se decodifican los 864.000 puntos). - La retención es gratis. Hacer expirar datos no es una reescritura punto a punto; consiste en quitar bloques enteros de una lista.
- Se aceptan escrituras fuera de orden. La ordenación ocurre dentro de un bloque en el momento de sellarlo; los bloques solapados no rompen la corrección de las consultas, solo debilitan la poda y la compresión.
El tamaño de bloque es un compromiso: los bloques más grandes comprimen mejor, pero hacen más gruesa la resolución de la retención y de la poda. El valor por defecto de 1024 es un término medio razonable; a nivel de crate se puede cambiar con with_block_points.
Durabilidad: el MANIFEST es el único punto de commit
La disposición en disco es así:
<dir>/MANIFEST              {"generation": N}, the authoritative generation
<dir>/blocks.<N>.tsb        full block snapshot at checkpoint N
<dir>/wal.<N>.log           points written after N
<dir>/rollup_wm.<N>.json    rollup watermark, same generation
<dir>/rollups.json          rollup rules
Un checkpoint se ejecuta en este orden: sellar los búferes activos, escribir blocks.<N+1>.tsb y hacerle fsync, escribir la marca de agua en rollup_wm.<N+1>.json y hacerle fsync, escribir MANIFEST.tmp y hacer un rename atómico sobre MANIFEST, abrir un wal.<N+1>.log nuevo y borrar los archivos de la generación N.
Todo el argumento de durabilidad se sitúa a uno u otro lado de ese único rename. Un fallo antes de él deja el MANIFEST en N; la recuperación lee el snapshot antiguo y su WAL, que todavía contiene todos los puntos escritos desde ese checkpoint. Un fallo después hace que la recuperación lea el snapshot nuevo e ignore el WAL antiguo; ningún punto se cuenta dos veces. El motor hace checkpoints por su cuenta cuando el WAL supera los 8 MiB (escribir un día de datos llevó mi número de generación a 43), y la operación checkpoint dispara uno bajo demanda. El motor SQL usa el mismo enfoque de "reescribir la generación y promoverla con un solo rename".
Hay algo sobre lo que tengo que ser honesto: al final de cada petición de escritura, el WAL se vuelca (flush) al sistema operativo, pero no se le hace fsync. Un fallo del proceso no pierde nada (lo probé con kill -9 más abajo), porque los datos escritos están en la caché de páginas del kernel. Un corte de corriente, en cambio, puede perder algunos de los puntos escritos desde el último checkpoint. Es un compromiso deliberado de velocidad para datos de métricas, pero conviene conocerlo.
Concurrencia y memoria
El motor de cada base de datos está detrás de un RwLock: las escrituras van de una en una y las consultas se ejecutan de forma concurrente bajo un lock compartido. Los bloques sellados viven en memoria; Tsdb::open carga el snapshot completo. Por tanto, el uso de memoria es aproximadamente el tamaño de los datos comprimidos. Los 5,2 millones de puntos de arriba ocupan 12 MB; un año de una serie de 1 Hz serían unos 40 MB como floats de resolución 0,1, o unos 12 MB en unidades enteras. No es la herramienta adecuada para un archivo de miles de millones de puntos; está hecha para datos calientes y rollups que caben en la RAM.
Consultas y agregaciones
Una consulta indica la medición, el campo, los filtros de etiquetas (tags, solo igualdad), un rango de tiempo semiabierto [start, end), una anchura de bucket opcional (interval, en ms), las etiquetas por las que agrupar (group_by) y una agregación (agg, por defecto mean). La respuesta es siempre una lista de grupos, cada uno con sus etiquetas, el tipo del campo y sus puntos.
| Agregación | Significado |
|---|---|
mean / avg | media |
sum | total |
min / max | menor / mayor |
count | número de puntos |
first / last | valor más antiguo / más reciente del bucket |
distinct | número de valores distintos |
rate | cambio por segundo: (last - first) / span_s, para contadores |
percentile + p | percentil p, con interpolación lineal (como el valor por defecto de numpy) |
p50, p95, p99, p99.9 | atajos de percentile |
Agrupar por tiempo
Con un interval, los buckets se alinean con la epoch (como en InfluxDB), de modo que los buckets horarios caen en horas en punto. La media horaria de un sensor durante sus cuatro primeras horas:
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "s_temp_01", "field": "temp",
 "tags": {"sensor": "s00"}, "start": 1790812800000, "end": 1790827200000,
 "interval": 3600000, "agg": "mean"}
{"ok": true, "data": [{"tags": {}, "type": "float", "points": [
{"ts": 1790812800000, "value": 2.734611111111113},
{"ts": 1790816400000, "value": 2.2817499999999957},
{"ts": 1790820000000, "value": 1.3479722222222226},
{"ts": 1790823600000, "value": 2.0618055555555315}]}]}Agrupar por etiqueta y por tiempo a la vez produce una línea por cada serie del gráfico en una sola consulta. Máximos de seis horas para diez sensores (comienzo de la salida):
{"tags": {"sensor": "s00"}, "type": "float", "points": [{"ts": 1790812800000, "value": 3.8}, {"ts": 1790834400000, "value": 6.0}]},
{"tags": {"sensor": "s01"}, "type": "float", "points": [{"ts": 1790812800000, "value": 5.5}, {"ts": 1790834400000, "value": 5.4}]},
{"tags": {"sensor": "s02"}, "type": "float", "points": [{"ts": 1790812800000, "value": 6.0}, {"ts": 1790834400000, "value": 5.3}]},
...
tags filtra series, group_by divide la salida; se pueden combinar.
Percentiles, rate y el resto
Percentiles sobre un día completo para los diez sensores (864.000 puntos). Necesitan ordenar los valores, así que cada uno tardó unos 16 ms:
agg=p50                 -> 3.2
agg=p95                 -> 5.7
agg=p99                 -> 5.9
agg=percentile, p=99.9  -> 6.0
rate es para contadores monótonos: divide la diferencia entre el primer y el último valor de un bucket por el tiempo transcurrido entre ellos. Paquetes por segundo a partir del contador de paquetes, en buckets de 15 minutos (generé de 40 a 60 paquetes por segundo, así que se espera en torno a 50):
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "s_counter", "field": "packets",
 "tags": {"sensor": "s03"}, "start": 1790812800000, "end": 1790816400000,
 "interval": 900000, "agg": "rate"}
{"ok": true, "data": [{"tags": {}, "type": "integer", "points": [
{"ts": 1790812800000, "value": 49.88320355951057},
{"ts": 1790813700000, "value": 49.809788654060064},
{"ts": 1790814600000, "value": 49.88987764182425},
{"ts": 1790815500000, "value": 49.77641824249166}]}]}Las agregaciones restantes sobre una hora de datos de humedad, cada una en torno a 0,1 ms:
count    -> 3600.0
first    -> 75.0
last     -> 76.0
min      -> 73.0
sum      -> 269640.0
distinct -> 5.0
rate no sabe nada de reinicios de contador; si un contador se reinicia dentro de un bucket, se verá un valor negativo o bajo. No hay corrección de reinicios como en el rate() de Prometheus.
Trayectorias geográficas
Si se guarda una posición como dos campos numéricos escritos con las mismas marcas de tiempo (lat, lon), el motor ofrece dos consultas adicionales: distance (longitud del recorrido en metros, con haversine) y track (una trayectoria simplificada con Douglas-Peucker). La trayectoria de cuatro puntos de un camión en Esmirna:
>>> {"op": "distance", "measurement": "truck", "tags": {"id": "t7"}}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790900060000, "value": 3423.2779930961387}]}]}

>>> {"op": "track", "measurement": "truck", "tags": {"id": "t7"}, "tolerance": 50}
<<< {"ok": true, "data": [{"tags": {"id": "t7"}, "points": [
     {"ts": 1790900000000, "lat": 38.4237, "lon": 27.1428},
     {"ts": 1790900120000, "lat": 38.4363, "lon": 27.1572},
     {"ts": 1790900180000, "lat": 38.45, "lon": 27.16}]}]}
Con una tolerancia de 50 metros se eliminó el segundo punto, que era colineal. Las consultas geográficas del lado de documentos están en el artículo sobre consultas geoespaciales y de grafos de la serie.
TCP en bruto y PostgREST
El protocolo es lo bastante simple como para no necesitar ninguna biblioteca. El mismo motor también habla la gramática de PostgREST sobre HTTP: una cabecera Accept-Profile: tsdb dirige la petición al motor TSDB, select indica el campo, tag=eq.value filtra y ts=gte. y ts=lt. fijan el rango. Máximo horario con curl:
curl -s 'http://127.0.0.1:15501/rest/v1/s_temp_01?select=temp&sensor=eq.s00&ts=gte.1790870400000&ts=lt.1790881200000&interval=3600000&agg=max' \
-H 'Accept-Profile: tsdb'[{"ts":1790870400000,"value":4.2},{"ts":1790874000000,"value":6.0},{"ts":1790877600000,"value":6.0}]Las escrituras reciben un objeto plano; los valores de tipo cadena se convierten en etiquetas y los números en campos:
curl -s -i -X POST 'http://127.0.0.1:15501/rest/v1/coldroom' \
  -H 'Content-Profile: tsdb' -H 'Content-Type: application/json' \
  -d '{"ts":1790899200000,"site":"izmir","room":"r3","temp":3.6}'
HTTP/1.1 201 CreatedPor eso el cliente @supabase/postgrest-js funciona sin modificaciones con .schema('tsdb'). PATCH y DELETE devuelven 405 a propósito: el almacén de series es de solo añadir, y los datos se eliminan con la retención.
Rollups continuos y la marca de agua
Guardar un año de datos por segundo es barato; recorrer millones de puntos cada vez que se dibuja un gráfico no lo es. La respuesta habitual es la agregación continua: calcular una vez los resúmenes de los buckets de tiempo cerrados y guardarlos. En oxidb-tsdb una regla de rollup dice "resume todas las series numéricas de esta medición en buckets de esta anchura con estas agregaciones"; el resultado es una medición derivada llamada <measurement>@<label> con campos <field>_<agg>, que conserva sin cambios las etiquetas de la serie de origen.
>>> {"op": "rollup_add", "measurement": "s_temp_01", "label": "1m", "interval": 60000, "aggs": ["mean", "min", "max", "count"]}
<<< {"ok": true, "data": {"ok": true}}

>>> {"op": "rollups"}
<<< {"ok": true, "data": [{"measurement": "s_temp_01", "label": "1m", "interval": 60000}]}

>>> {"op": "rollup_refresh", "now": 1790899200001}
<<< {"ok": true, "data": {"written": 14400}}
    (71.67 ms)

>>> {"op": "rollup_refresh", "now": 1790899200001}
<<< {"ok": true, "data": {"written": 0}}
Diez sensores × 1440 minutos = 14.400 puntos de rollup en 72 ms. El segundo refresco no escribe nada, porque el inicio del último bucket materializado se guarda en una marca de agua (watermark) para cada par (serie, intervalo). rollup_refresh solo procesa los buckets que se han cerrado por completo: puede que la mitad del minuto actual todavía no haya llegado. Sin now usa el reloj del servidor; mis datos de prueba están en el pasado, así que lo pasé explícitamente.
El resumen es una medición corriente y se lee con una consulta corriente:
s_temp_01@1m / temp_count, agg=sum   -> 864000.0
hourly mean raw    first 3: [2.7346, 2.2817, 1.348] 1.47 ms
hourly mean rollup first 3: [2.7346, 2.2818, 1.348] 0.17 ms
La media horaria tardó 1,47 ms a partir de los datos en bruto y 0,17 ms a partir del rollup por minuto, con los mismos resultados. Una advertencia: una media de medias por minuto solo es exacta cuando los buckets están igual de llenos. Con huecos se desvía ligeramente; si se necesita exactitud, conviene materializar sum y count y calcular uno mismo el cociente. El encadenamiento (1s → 1m → 1h) no ocurre por sí solo; definir y refrescar las reglas en orden corresponde a quien llama. Las reglas se escriben en rollups.json y sobreviven a los reinicios, pero disparar los refrescos es tarea de la aplicación (o de un planificador); el motor no los ejecuta periódicamente por su cuenta.
¿Cuándo es la marca de agua segura frente a fallos?
La marca de agua se escribe con la misma generación que el snapshot de bloques (rollup_wm.<N>.json) y se promueve de forma atómica con el rename del MANIFEST. Los tests fijan que "tras un checkpoint, al reabrir nunca se escribe dos veces el mismo bucket". Para este artículo probé dos escenarios con kill -9:
## scenario A: refresh, NO checkpoint, kill -9, restart
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 3}}
   [kill -9, restart]
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 14403}}
>>> {"op": "query", "measurement": "line_a@1m", "field": "v_mean", "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790899200000, "value": 6.0}]}]}

## scenario C: refresh + checkpoint, kill -9, restart
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 3}}
>>> {"op": "checkpoint"}
<<< {"ok": true, "data": {"ok": true}}
   [kill -9, restart]
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 0}}
>>> {"op": "query", "measurement": "line_c@1m", "field": "v_mean", "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790899200000, "value": 3.0}]}]}
El escenario C se comporta como se pretende: la marca de agua llegó a disco con el checkpoint, así que no se reescribió nada tras el reinicio. El escenario A me mostró un hueco: los puntos de rollup van al WAL y vuelven tras el fallo, pero la marca de agua solo se vuelve duradera en un checkpoint. Tras el reinicio la marca de agua estaba desfasada, así que los mismos buckets se escribieron de nuevo (6 puntos en lugar de 3; el rollup de 14.400 puntos de la sesión anterior, al que nunca se le había hecho checkpoint, también se duplicó). Así que la garantía se sostiene al nivel de "los refrescos con checkpoint nunca se cuentan dos veces". El patrón seguro hoy es sencillo: llamar a checkpoint justo después de rollup_refresh. La verdadera solución es registrar la actualización de la marca de agua en el WAL como un registro propio; está en mi lista.
Retención a nivel de bloque
La retención funciona con un único punto de corte: se eliminan los bloques cuyo punto más reciente es anterior al corte. Puse a propósito el corte en mitad de un bloque, a las 12:08:20:
>>> {"op": "query", "measurement": "s_temp_01", "field": "temp", "tags": {"sensor": "s00"}, "end": 1790856500000, "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790812800000, "value": 43700.0}]}]}

>>> {"op": "retention", "cutoff": 1790856500000}
<<< {"ok": true, "data": {"removed": 2584391}}
    (0.1 ms)

>>> {"op": "query", "measurement": "s_temp_01", "field": "temp", "tags": {"sensor": "s00"}, "end": 1790856500000, "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790855808000, "value": 692.0}]}]}
2,58 millones de puntos desaparecieron en 0,1 ms, porque no se decodificó ni se reescribió nada; se quitaron bloques de una lista. Quedaron 692 puntos anteriores al corte: pertenecen al bloque que empieza a las 11:56:48 y se extiende más allá del corte. La resolución de la retención es igual a la anchura del bloque, que para una serie de 1 Hz son 1024 puntos, unos 17 minutos. Los bloques eliminados no están en el siguiente snapshot, así que la retención se vuelve duradera sin trabajo adicional.
Dos límites que hay que decir claramente. El corte se aplica a toda la base de datos: la misma llamada borró también los puntos de medianoche de la medición coldroom (un count posterior volvió vacío). Si se quiere una retención distinta por medición, hay que poner las mediciones en bases de datos separadas; para el patrón clásico de "datos en bruto durante 7 días, rollups durante un año" esto es hoy una carencia. Y la retención tampoco se ejecuta sola; llamarla periódicamente corresponde a la aplicación.
Copia de seguridad y restauración con bloqueo mínimo
Una copia de seguridad es un .tar.gz consistente del directorio del motor. Lo importante es que el trabajo lento (la compresión) se ejecuta con el lock del motor liberado. Hay tres fases:
- backup_begin (bajo el lock de escritura, O(1)): se vuelca el WAL, la generación actual se "fija" con un contador de referencias y se registra la longitud actual del WAL.
- backup_write (sin lock): se escriben en el archivo un MANIFEST sintetizado, el archivo de bloques de esa generación, el prefijo estable de su WAL hasta la longitud registrada y los archivos de rollup. Un WAL por generación solo crece por el final o se rota, así que ese prefijo no puede cambiar.
- backup_end (bajo el lock de escritura, O(1)): se libera la fijación; si un checkpoint sustituyó a la generación durante la copia, sus archivos se borran ahora.
Mientras tanto, las escrituras y los checkpoints continúan; un checkpoint nunca borra los archivos de una generación fijada. Lo medí: una conexión siguió escribiendo puntos sueltos mientras otra hacía una copia de seguridad.
backup: {'ok': True, 'data': {'path': '.../backup/lowlock.tar.gz', 'size_bytes': 9531869}} took 860 ms
during backup   writes= 1482  p50=0.050 ms  p99=4.073 ms  max=10.486 ms
outside backup  writes= 3213  p50=0.060 ms  p99=4.082 ms  max=11.223 ms
La latencia de escritura no se ve afectada mientras se ejecuta la copia. La base de datos de 5,3 millones de puntos se archiva en 9,5 MB; los bloques Gorilla apenas se reducen con gzip porque ya están comprimidos. La restauración desempaqueta en un directorio vacío:
{"engine": "tsdb", "cmd": "backup", "path": "/backups/tsdb-2026-10-02.tar.gz"}
{"engine": "tsdb", "cmd": "restore", "archive": "/backups/tsdb-2026-10-02.tar.gz", "target": "/restore/tsdb"}
Arranqué un segundo servidor en el puerto 15510 con OXIDB_TSDB_DATA apuntando al directorio restaurado; stats coincidió exactamente con el valor previo a la copia:
{"ok": true, "data": {"series": 114, "points": 5299594, "bytes": 12382229}}La restauración no sobrescribe el motor en ejecución; se abre el motor sobre el nuevo directorio. Un directorio de destino que no esté vacío se rechaza.
Etapas temporales en el lado de documentos
El trabajo con series temporales en OxiDB no se limita a este motor. El pipeline de agregación del motor de documentos tiene tres etapas temporales, y cuando los datos de eventos ya viven como documentos suelen ser la herramienta adecuada. Sobre una colección trades de seis operaciones:
$ohlcv convierte ticks en velas; fill: "previous" rellena el minuto vacío con el cierre anterior:
{"$ohlcv": {"time": "ts", "interval": "1m", "price": "price", "volume": "qty", "symbol": "sym", "fill": "previous"}}
-> {"symbol": "ACME", "time": "2026-10-01T09:00:00Z", "open": 101.0, "high": 102.5, "low": 100.5, "close": 100.5, "volume": 6.0, "count": 3}
   {"symbol": "ACME", "time": "2026-10-01T09:01:00Z", "open": 100.0, "high": 100.0, "low": 99.5, "close": 99.5, "volume": 9.0, "count": 2}
   {"symbol": "ACME", "time": "2026-10-01T09:02:00Z", "open": 99.5, "high": 99.5, "low": 99.5, "close": 99.5, "volume": 0.0, "count": 0}
   {"symbol": "ACME", "time": "2026-10-01T09:03:00Z", "open": 101.5, "high": 101.5, "low": 101.5, "close": 101.5, "volume": 2.0, "count": 1}
$dateHistogram da buckets de tiempo conscientes del calendario; min_doc_count: 0 emite también los vacíos:
{"$dateHistogram": {"field": "ts", "interval": "1m", "min_doc_count": 0, "accumulators": {"volume": {"$sum": "$qty"}}}}
-> {"_id": "2026-10-01T09:00:00Z", "count": 3, "volume": 6}
   {"_id": "2026-10-01T09:01:00Z", "count": 2, "volume": 9}
   {"_id": "2026-10-01T09:02:00Z", "count": 0}
   {"_id": "2026-10-01T09:03:00Z", "count": 1, "volume": 2}
$setWindowFields admite ventanas por rango de tiempo: "los últimos 2 minutos", no "los últimos 5 documentos":
{"$setWindowFields": {"sortBy": {"ts": 1}, "output": {"avg_2m": {"$avg": "$price", "window": {"range": [-2, 0], "unit": "minute"}}}}}
-> {"ts": "2026-10-01T09:00:05Z", "price": 101.0, "avg_2m": 101}
   {"ts": "2026-10-01T09:00:40Z", "price": 102.5, "avg_2m": 101.75}
   {"ts": "2026-10-01T09:00:55Z", "price": 100.5, "avg_2m": 101.33333333333333}
   {"ts": "2026-10-01T09:01:10Z", "price": 100.0, "avg_2m": 101}
   {"ts": "2026-10-01T09:01:30Z", "price": 99.5, "avg_2m": 100.7}
   {"ts": "2026-10-01T09:03:20Z", "price": 101.5, "avg_2m": 100.5}
A grandes rasgos: si los eventos son ricos, varían de forma o son pocos, documentos y estas etapas; si hay millones de lecturas numéricas con la misma forma, la TSDB. Los dos funcionan bien juntos. En la demo examples/coldchain del repositorio, las lecturas de los sensores llegan por MQTT, los valores numéricos van a la TSDB y el evento en bruto, exactamente como lo envió el dispositivo, va al motor de documentos: la serie temporal muestra que la temperatura sube y el documento muestra por qué (door_open: true). El lado MQTT se cubre en el artículo sobre MQTT y AMQP de la serie.
Límites y compromisos honestos
Esto es lo que conviene saber antes de usar este motor, reunido en un solo lugar:
- Vive en memoria. Los bloques sellados están en la RAM; el uso de memoria es aproximadamente el tamaño de los datos comprimidos. Estupendo para datos calientes y rollups, inadecuado para un archivo en bruto de varios años.
- No hay índice de etiquetas. Una consulta recorre todas las claves de serie de la base de datos y filtra por medición y etiquetas. Con unos pocos miles de series no se nota; las etiquetas de alta cardinalidad (un ID de usuario, por ejemplo) hacen crecer tanto ese recorrido como la memoria. Las etiquetas deberían provenir de un conjunto acotado de valores.
- Los filtros de etiquetas son solo de igualdad. No hay regex,
!=niIN. - Un campo, una agregación. Una consulta devuelve un campo con una agregación;
meanymaxa la vez son dos consultas. - La retención abarca toda la base de datos, y ni el refresco de rollups ni la retención se ejecutan automáticamente.
- La marca de agua es duradera en los checkpoints; conviene hacer checkpoint tras un refresco.
- Al WAL no se le hace fsync; es seguro frente a fallos del proceso, pero ante un corte de corriente peligran los puntos escritos desde el último checkpoint.
- Los campos de tipo string no se comprimen; se guardan como pares
(timestamp, text)sin procesar. - No se replica en un clúster. En un clúster Raft, las escrituras TSDB se quedan en el nodo que las recibió; el ADR-0025 lo recoge explícitamente como una carencia compartida con el motor de recomendaciones y prevé cerrar ambas a la vez.
- Las marcas de tiempo están en milisegundos. Los clientes de InfluxDB que envían nanosegundos necesitan convertir sus marcas de tiempo.
Son los límites de un alcance deliberado, no los de un prototipo a medio terminar: datos de métricas en un solo proceso, que caben en memoria, comprimen bien y se consultan rápido. No pretende sustituir a un clúster de InfluxDB. Pero cuando se quieren las métricas de una aplicación en el mismo binario que sus documentos, sus tablas y su caché, ahorra tener que operar un segundo sistema.
Pruébalo
Las releases precompiladas de OxiDB están en la página de releases de GitHub: binarios para macOS (arm64/x86_64), Linux (x86_64/arm64) y Windows. Para ejecutarlo desde el repositorio con Docker basta con docker compose up -d. Activar el motor de series temporales no requiere más que OXIDB_TSDB=1. Si se quiere repetir la medición de este artículo con datos propios, lo más fácil es escribir un día de datos mediante line protocol y mirar stats después de un checkpoint: dividiendo bytes entre points se ve lo que se paga por punto. Y si la resolución del sensor es fija, vale la pena probar a escribir los valores en unidades enteras; con mis datos, la diferencia fue de 3,5 veces.
El siguiente artículo de la serie es OxiMem, el motor clave-valor que habla el protocolo de Redis (el artículo sobre OxiMem).