El motor Ledger de OxiDB: streams de ancho fijo para journals de órdenes y fills
El crate oxidb-ledger que escribí para los journals de un exchange: registros fijos de 40 bytes, secuencias asignadas por el motor, segmentos con mmap, retención borrando archivos y fsync por stream. Con mediciones reales y dos bugs que encontré.
Todos los motores de esta serie hasta ahora viven dentro de un servidor en ejecución, detrás de un número de puerto. El de este artículo no. oxidb-ledger es un crate joven que está en el repositorio de OxiDB con sus propios tests, pero todavía no se ha añadido al workspace y nada lo llama. El servidor 0.44.2 no tiene ninguna variable de entorno ni comando de protocolo que lo active. Aun así le dediqué un artículo, porque aquí están las decisiones de diseño más interesantes de poner OxiDB detrás de un exchange, y el motor en sí es pequeño: tres archivos, unas 1650 líneas de Rust. A continuación explico por qué quería un motor aparte, cómo se dispone un registro byte a byte y cómo funcionan los segmentos, la retención, el fsync y la ruta de lectura. Como el servidor no lo expone, ejecuté todos los ejemplos en mi propia máquina mediante un pequeño proyecto Rust que monta los archivos fuente del crate sin modificarlos. Toda la salida es real. Por el camino encontré dos bugs, y los trato hacia el final sin ocultar nada.
¿Por qué un motor aparte?
Cuando posicioné OxiDB como la capa de datos de un exchange de criptomonedas o de valores, docs/exchange-readiness.md trazó una línea desde el principio: el motor de matching no es trabajo de la base de datos. Los exchanges reales casan órdenes en un bucle de eventos de un solo hilo y en memoria (el modelo LMAX). OxiDB es la capa durable y consistente que hay detrás: la persistencia de órdenes, operaciones y journals, el libro de saldos, los datos de mercado y el tratamiento idempotente de las peticiones.
Hoy esa capa está construida sobre el motor de documentos y sus transacciones. El ejemplo tests/live-exchange del repositorio ejecuta un exchange real con diez procesos de traders y un matcher por símbolo. Cada fill (la parte de una orden que realmente se ejecutó contra otra orden) se liquida en una transacción atómica: mueve USD y el activo entre los dos usuarios, inserta la operación, escribe el journal de partida doble y fija el precio del símbolo en el de la última operación. Un paso de verificación comprueba después que no se ha creado dinero, que el journal cuadra y que cada saldo se puede reconstruir a partir del journal. Según su README, esta configuración procesa unas 150 operaciones por segundo en un portátil en modo de sincronización perezosa.
Esa es la herramienta adecuada para el libro de saldos. Una transferencia cambia varios documentos a la vez y necesita aislamiento. Pero un exchange guarda otros dos registros, y tienen una forma muy distinta:
- El journal de órdenes: un registro inmutable de cada orden aceptada. Una confirmación solo significa algo si este registro está en disco.
- El journal de fills: un registro de cada casamiento: quién operó con quién, a qué precio y con qué tamaño.
Lo que tienen en común: son solo de anexado, nunca se actualizan, su forma no ha cambiado desde la época de la negociación a viva voz, su orden es sagrado y sus partes antiguas se desechan en bloque pasado un tiempo. Si se pone esta carga de trabajo sobre una estructura de propósito general (un B-tree, un almacén de documentos, una tabla SQL), se pagan tres costes:
- El coste de anexar crece con el historial. Insertar en un B-tree implica mantener al día una estructura que abarca todo el historial.
- Cada registro se codifica. Codificación de documento o de fila, nombres de campo, prefijos de longitud, una asignación de memoria por registro.
- La retención es un escaneo y una reescritura. "Borrar un mes" significa encontrar cada fila de ese mes, borrarla y actualizar los índices.
oxidb-ledger se escribió para eliminar los tres por diseño. La descripción del crate lo dice en una línea: "append-only fixed-width streams with segment retention, for order and fill journals".
Estado: en el código, no en el servidor
Lo digo de entrada, porque esto difiere del resto de la serie:
- El crate llegó en un único commit fechado el 7 de septiembre de 2026. El mensaje del commit es explícito: "A new crate, not yet in the workspace and not referenced by anything."
oxidb-ledger/srctieneschema.rs,segment.rsylog.rs, pero nolib.rs. ElCargo.tomlraíz no lo incluye como miembro yoxidb-serverno depende de él.- La palabra "ledger" no aparece ni una vez en el binario del servidor 0.44.2 (
strings oxidb-server | grep -ci ledgerimprime 0). Nada en el protocolo nativo, en REST ni en el puerto compatible con PostgreSQL lo expone.
Sin embargo, los comentarios del código muestran hacia dónde va. Los discriminantes de los tipos de campo se definen como "the wire encoding", se dice que un esquema "cross the socket as these bytes" y verify se describe como "what a verify command runs". El objetivo es una superficie de protocolo en la que el cliente envía los registros por el socket exactamente en los bytes que se van a escribir. Esa superficie todavía no se ha escrito.
Así que monté el motor como módulos desde un proyecto Cargo aparte, sin tocar los archivos del repositorio:
// harness/src/lib.rs
// oxidb-ledger ships three modules and no lib.rs yet. This mounts the repo's
// files unchanged as modules of one library, so crate::schema and
// crate::segment resolve as they would in the real crate.
#[path = "../OxiDB/oxidb-ledger/src/schema.rs"]
pub mod schema;
#[path = "../OxiDB/oxidb-ledger/src/segment.rs"]
pub mod segment;
#[path = "../OxiDB/oxidb-ledger/src/log.rs"]
pub mod log;
Las dependencias coinciden con el propio Cargo.toml del crate: crc32fast, memmap2 y tempfile para los tests. Con esta configuración también se ejecutan los tests unitarios del propio crate, y vuelvo a su resultado más abajo.
Modelo de datos: stream, registro, secuencia
El motor tiene un único concepto: el stream. Un stream es una secuencia con nombre de registros, con su propio directorio bajo una raíz, y su esquema queda fijado en el momento en que se crea. Piénsese en dos streams de un exchange, orders y fills.
Ancho fijo, disposición fija
Cada registro de este motor tiene un ancho fijo y una disposición fija. Esa es la base de todo el diseño: un append es un copy_from_slice en un búfer que ya tiene espacio, y un escaneo es un recorrido por la memoria con un paso conocido. Sin codificación de filas, sin prefijo de longitud por campo, sin asignación por registro y sin nada que parsear ni en la ruta de escritura ni en la de lectura.
El precio es la flexibilidad que da un almacén de documentos: un registro no puede ganar un campo y un campo no puede faltar. Para un journal de órdenes y uno de fills eso no es ninguna pérdida. Me gusta el comentario del código: un mercado que cambia la forma de un fill tiene una migración entre manos haga lo que haga el motor de almacenamiento.
Hay ocho tipos de campo: I8, U8, I16, U16, I32, U32, I64, U64. Un stream puede declarar hasta 16 campos además de seq y ts. No es un límite de almacenamiento sino de consulta: los predicados se guardarán en un array fijo para que evaluarlos no asigne memoria. Un registro puede tener como máximo 4 KiB de ancho; ese techo impide que un esquema llegado por un socket pida un segmento de tamaño ilimitado.
Dos campos obligatorios
Cada registro empieza con una secuencia u64 (seq, offset 0) y un timestamp i64 (ts, offset 8). No se declaran; el motor los reserva. El reparto de tareas:
- El motor asigna las secuencias, nunca quien llama. Una secuencia es la declaración del propio mercado sobre el orden: "este fill ocurrió antes que aquel". Un cliente que pudiera elegir la suya no podría responder por ella. Las secuencias son densas y monótonas dentro de un stream, así que un hueco significa un registro perdido y merece reportarse en lugar de tolerarse.
- Quien llama aporta el timestamp, porque solo él lo conoce. Un mercado sella un fill en el microsegundo en que se casó, que es anterior al momento en que el lote llega al motor, y es el número que realmente quiere cualquiera que analice la cinta.
Todo se lee como i64
Un campo se almacena con su ancho declarado pero se lee extendido con signo o con ceros a un i64. Es una sola carga en cualquier caso, y significa que un predicado, un agregado y una proyección trabajan todos con un tipo en lugar de ocho. El coste es que un u64 por encima de i64::MAX se lee como negativo; ningún campo de un ledger lo es.
Al escribir, un valor que no cabe se rechaza, no se trunca. Es la misma elección que hace el motor SQL con los anchos enteros declarados, por la misma razón: un número de cuenta desbordado en silencio es una respuesta errónea que parece correcta.
Regla de empaquetado y dos formas incorporadas
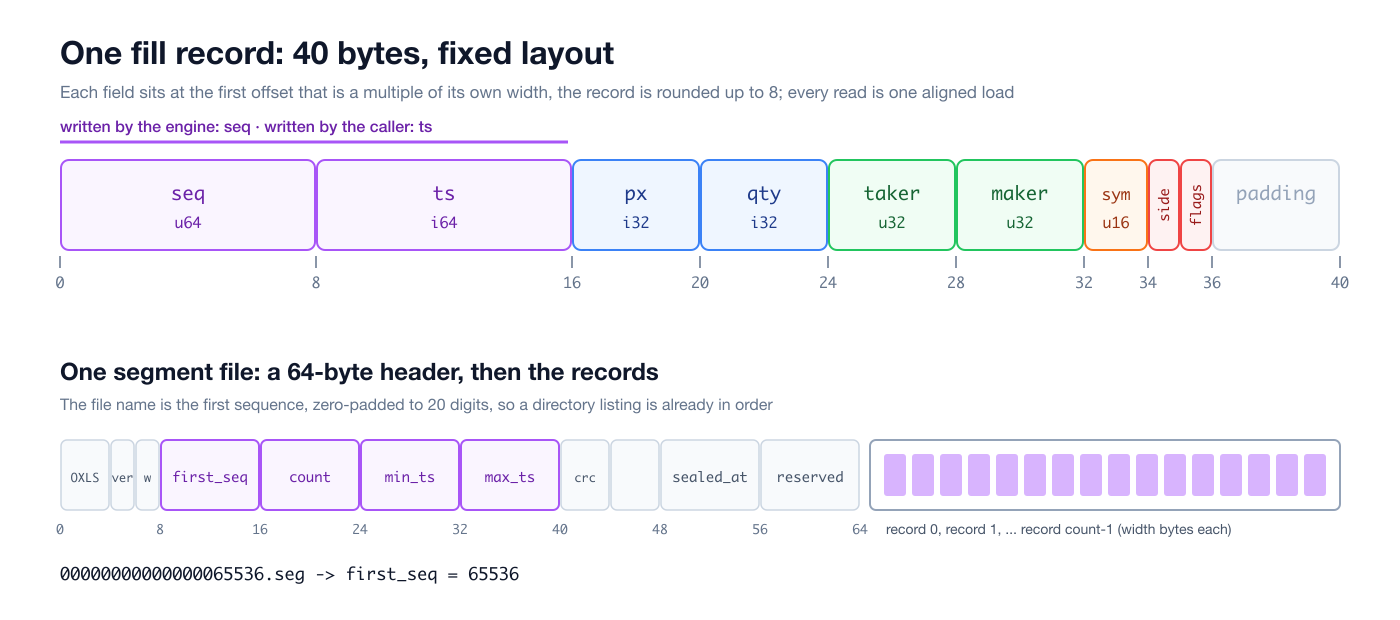
Después de seq y ts, cada campo va en el siguiente offset que sea múltiplo de su propio ancho, y el registro se redondea a un múltiplo de ocho. Cada lectura es una única carga alineada y un array de registros se mantiene alineado. Si se declaran los campos de mayor a menor ancho, no se desperdicia relleno.
El crate incluye dos formas, shapes::fill() y shapes::order(). Un fill es px (precio, i32), qty (i32), taker y maker (las dos partes, u32), sym (símbolo, u16), side (u8) y flags (u8).
La salida Debug de los esquemas en mi ejecución:
== layout
fill  Schema(40 B, px@16:I32, qty@20:I32, taker@24:U32, maker@28:U32, sym@32:U16, side@34:U8, flags@35:U8)
order Schema(40 B, px@16:I32, qty@20:I32, account@24:U32, client@28:U32, order@32:U32, sym@36:U16, kind@38:U8, side@39:U8)
Un fill ocupa 40 bytes, así que un millón de fills son 40 MB. El registro de orden también sale de 40 bytes; volveré sobre esto más adelante, porque el propio test del crate espera 48.
Que el precio sea un i32 es deliberado: los precios se guardan como ticks enteros (en mis ejemplos, unidades de 1/100, así que 6412350 es 64123.50). No guardar nunca dinero en coma flotante es la primera regla de cualquier cosa que lleve cuentas.
Uso: la API de Rust
Sin superficie de protocolo, la API de Rust es hoy la única forma de usar el motor. Crear un stream:
use ledger_harness::log::{Durability, Stream, DEFAULT_CAPACITY};
use ledger_harness::schema::{Schema, shapes};

let s = shapes::fill();
let mut st = Stream::create(root, "fills", s, DEFAULT_CAPACITY, Durability::Commit)?;
El append recibe un búfer de n * width bytes que quien llama ya ha dispuesto. El motor escribe la secuencia que asigna en los primeros ocho bytes de cada registro, deja todo lo demás intacto y devuelve la primera secuencia y el número de registros:
let w = s.width();
let mut buf = vec![0u8; 3 * w];
for (i, r) in buf.chunks_exact_mut(w).enumerate() {
    Schema::put_ts(r, t0 + i as i64 * 250);   // the caller's timestamp
    s.set(r, 0, 6_412_350)?;                  // px
    s.set(r, 1, 15)?;                         // qty
}
let (first_seq, count) = st.append(&mut buf)?;
Ejecuté mi demo con la capacidad de segmento reducida a 4 registros para que los límites aparezcan en un ejemplo pequeño:
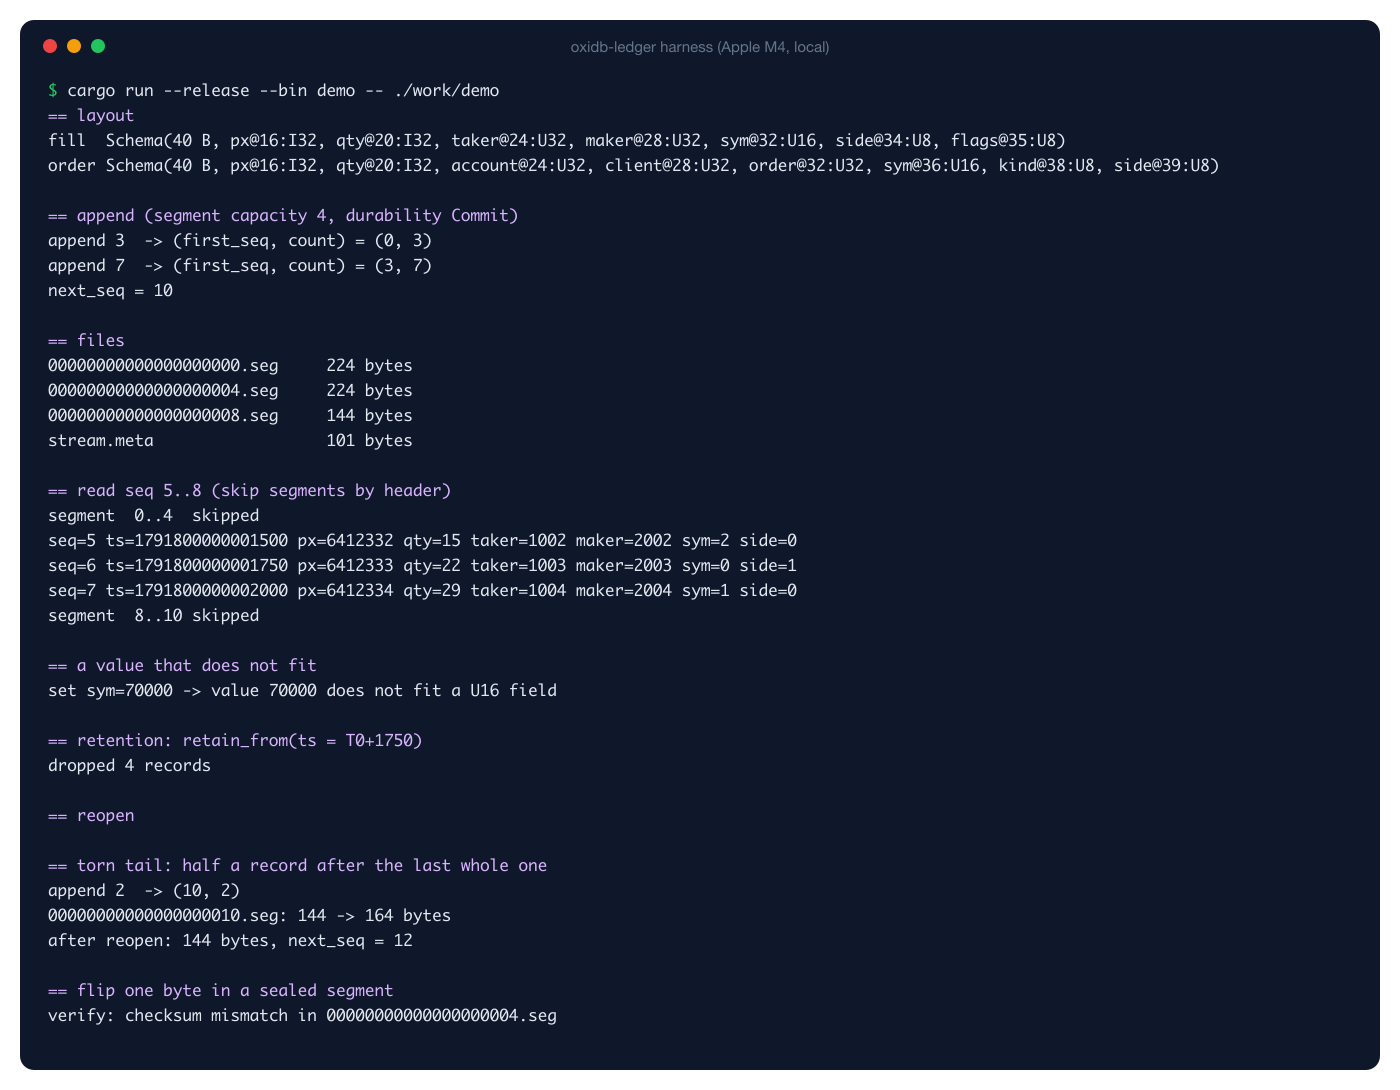
Los dos primeros appends devuelven (0, 3) y (3, 7): el motor reparte los números y continúa donde lo dejó. El segundo lote de 7 cruza dos veces el límite de 4 registros y se divide en lugar de rechazarse:
== append (segment capacity 4, durability Commit)
append 3  -> (first_seq, count) = (0, 3)
append 7  -> (first_seq, count) = (3, 7)
next_seq = 10
Stats { records: 10, segments: 3, bytes: 592, first_seq: 0, next_seq: 10, min_ts: 1791800000000000, max_ts: 1791800000002500, appended: 10, dropped: 0 }

== files
00000000000000000000.seg     224 bytes
00000000000000000004.seg     224 bytes
00000000000000000008.seg     144 bytes
stream.meta                  101 bytes
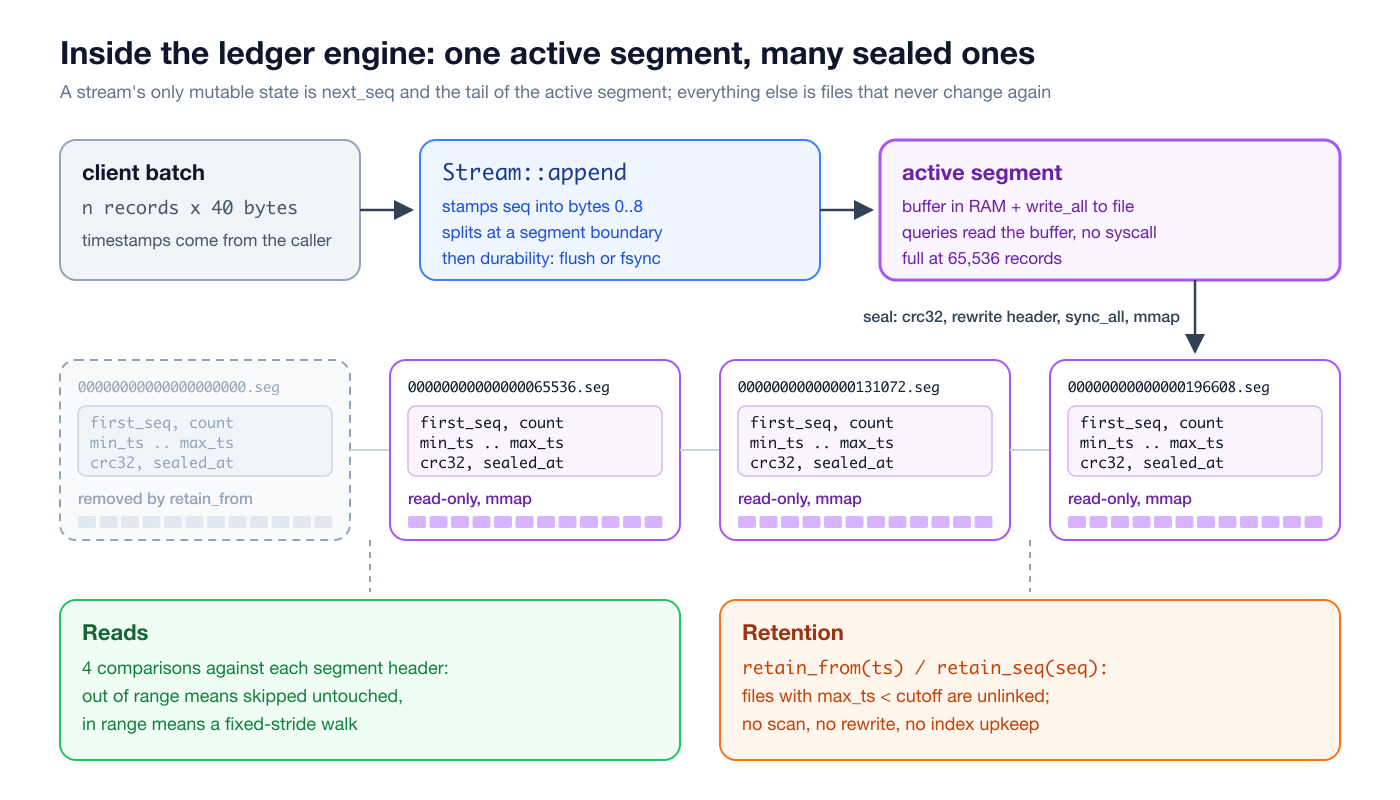
Un registro no puede quedar a caballo entre dos segmentos, así que append corta el lote en tantos trozos como segmentos haya donde colocarlo: un trozo para un lote más pequeño que un segmento, dos para un lote que cruza un límite.
Y el rechazo de un valor que no cabe es real:
== a value that does not fit
set sym=70000 -> value 70000 does not fit a U16 field
Segmentos: la unidad de todo lo barato
Un segmento es un archivo: una cabecera seguida de registros de ancho fijo. Se escribe una vez, de principio a fin, y nunca se modifica. Cuando alcanza su número de registros se sella: se completa la cabecera, se sincroniza el archivo y se mapea en memoria. A partir de ahí son bytes de solo lectura que el kernel puede cargar y descargar de memoria sin que el motor se entere.
Nombre de archivo y cabecera
El nombre de archivo de un segmento es la secuencia en la que empieza, rellenada con ceros hasta 20 dígitos, de modo que el directorio se lista en orden sin que nadie tenga que parsear nada. La cabecera ocupa 64 bytes:
| Offset | Campo | Significado |
|---|---|---|
| 0 | magic OXLS | segmento de ledger de OxiDB |
| 4 | version | actualmente 1 |
| 6 | width | ancho del registro |
| 8 | first_seq | secuencia del primer registro |
| 16 | count | número de registros (0 hasta el sellado) |
| 24 | min_ts | menor timestamp observado |
| 32 | max_ts | mayor timestamp observado |
| 40 | crc | CRC32 de los bytes de los registros |
| 48 | sealed_at | hora de reloj en el sellado (ms) |
Los primeros 104 bytes de un segmento del directorio de la demo, vistos con xxd:
00000000: 4f58 4c53 0100 2800 0800 0000 0000 0000  OXLS..(.........
00000010: 0200 0000 0000 0000 ca38 82f2 a15d 0600  .........8...]..
00000020: c439 82f2 a15d 0600 a64c ef3c 0000 0000  .9...]...L.<....
00000030: 8a27 eb2c a101 0000 0000 0000 0000 0000  .'.,............
00000040: 0800 0000 0000 0000 ca38 82f2 a15d 0600  .........8...]..
00000050: 2fd8 6100 2400 0000 ed03 0000 d507 0000  /.a.$...........
00000060: 0200 0100 0000 0000 ........OXLS, versión 1, ancho 0x28 = 40, first_seq 8, count 2, y luego min_ts, max_ts, CRC y sealed_at. A partir del byte 64 empieza el primer registro: seq 8, ts, precio 0x61d82f = 6412335, cantidad 0x24 = 36, taker 1005, maker 2005, sym 2, side 1. Sin parser, porque no hay nada que parsear.
sealed_at tiene su propia razón de ser: la retención por antigüedad del registro usa max_ts, mientras que sealed_at sirve para la retención por antigüedad de la escritura. Es una pregunta distinta, y una que se hace un operador cuando no se puede confiar en los timestamps de los propios registros.
El segmento activo
El segmento que se está escribiendo va al archivo y además se mantiene en memoria. Ambos responden a preguntas distintas: el archivo es lo que sobrevive y el búfer es lo que una consulta lee sin una llamada al sistema. Con la capacidad por defecto de 65.536 registros de cuarenta bytes, ese búfer ocupa 2,6 MB, y es la única memoria que el motor mantiene por stream que no es un archivo mapeado.
El código explica ese valor por defecto: un archivo de 2,6 MB es lo bastante pequeño para una retención de grano fino (un operador que pide conservar el último minuto obtiene el último minuto, no la última hora) y lo bastante grande para que el sellado, el único punto en el que un append hace trabajo real, ocurra dos veces por segundo a 35.000 registros por segundo en lugar de constantemente.
Por qué el coste del append se mantiene plano
Todo el estado mutable de un stream es next_seq y la cola del segmento activo. Todo lo demás son archivos que no van a volver a cambiar. No hay ninguna estructura que abarque el historial y haya que mantener al día. En código, un append hace esto: estampar las secuencias, un extend_from_slice, un write_all, una segunda pasada sobre bytes todavía calientes en L1 para seguir el timestamp mínimo y máximo, y luego flush o fsync según la durabilidad. Nada de eso mira cuántos segmentos hubo antes.
También intenté medirlo, y tengo que ser honesto con el resultado; los detalles están más abajo, en la sección de rendimiento.
Apertura
Reabrir un stream no lee ni un solo registro de un segmento sellado. Lee la cabecera de 64 bytes de cada uno, mapea el resto y reproduce solo el último segmento, el no sellado. Un stream de 10 millones de registros en 153 segmentos se abrió en unos 25 ms en mi máquina.
Durabilidad: tres ajustes por stream
La durabilidad se elige por stream, porque los dos journals quieren respuestas distintas:
| Ajuste | Significado |
|---|---|
Durability::Os | Entregar los bytes al sistema operativo y seguir. Una caída del proceso no pierde nada; una caída de la máquina pierde lo que la page cache no había escrito. |
Durability::Sealed | Llegar al disco cuando se sella un segmento, no más a menudo. La ventana es un segmento. |
Durability::Commit | Llegar al disco antes de que append regrese. Esto es lo que espera una confirmación. |
El razonamiento del código: un journal de fills puede permitirse perder los últimos milisegundos en un corte de luz, porque los fills también están en la red, en el navegador y en la serie temporal. Un journal de órdenes no: todo su sentido es que una confirmación signifique que la orden sobrevive, y eso solo es cierto si la escritura llegó al disco antes de que saliera la confirmación.
Es la misma postura que el resto de OxiDB, que por defecto hace fsync del WAL y del log de commits en cada commit (véase el artículo del motor de documentos). El sellado termina siempre con sync_all, así que un segmento sellado está en disco sea cual sea el ajuste.
Lo que medí (Mac con Apple M4, SSD interno, macOS, cada configuración durante 3 segundos o hasta un tope de registros):
Os      batch     1:    1443154 records in   3.00 s =      481051 rec/s,       2.1 us/append call
Os      batch    16:    4000000 records in   1.99 s =     2014745 rec/s,       7.9 us/append call
Os      batch   256:    4000000 records in   1.49 s =     2683801 rec/s,      95.4 us/append call
Os      batch  4096:    4001792 records in   0.62 s =     6440016 rec/s,     636.0 us/append call
Sealed  batch     1:    1481627 records in   3.00 s =      493876 rec/s,       2.0 us/append call
Sealed  batch    16:    4000000 records in   1.72 s =     2320832 rec/s,       6.9 us/append call
Sealed  batch   256:    4000000 records in   1.12 s =     3571360 rec/s,      71.7 us/append call
Sealed  batch  4096:    4001792 records in   0.69 s =     5761754 rec/s,     710.9 us/append call
Commit  batch     1:        733 records in   3.00 s =         244 rec/s,    4094.0 us/append call
Commit  batch    16:      11648 records in   3.00 s =        3881 rec/s,    4123.0 us/append call
Commit  batch   256:     161024 records in   3.00 s =       53622 rec/s,    4774.2 us/append call
Commit  batch  4096:     401408 records in   0.52 s =      770586 rec/s,    5315.4 us/append call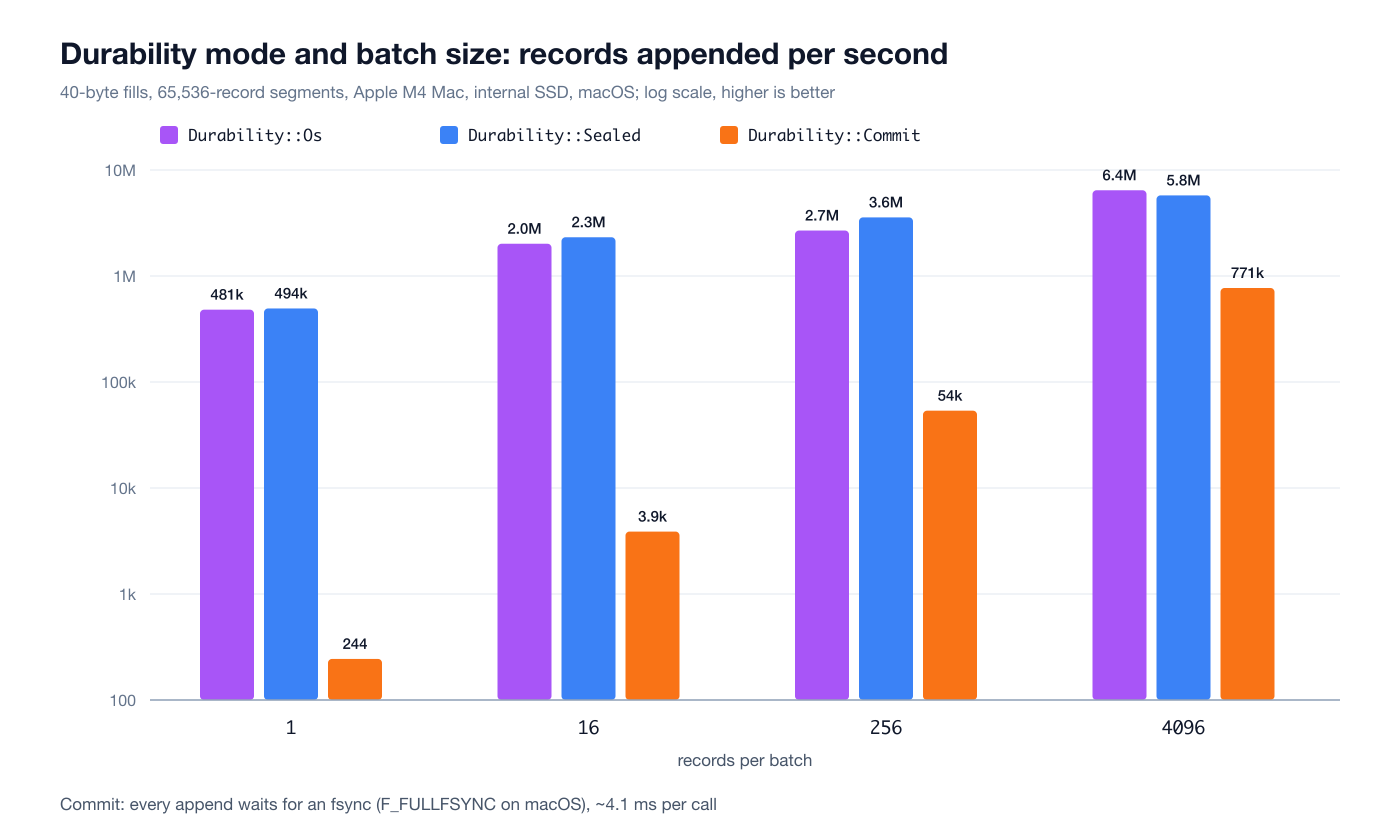
La historia es clara:
- En modo
Commitcada llamada cuesta unos 4,1 ms. Eso no es el motor; esF_FULLFSYNC, que elsync_datade Rust usa en macOS para obligar a la unidad a vaciar su propia caché de escritura. Con un registro por lote eso significa 244 registros por segundo. - Repartir el mismo fsync entre más registros lo cambia todo: con lotes de 4096 registros,
Commitalcanza 770.000 registros por segundo. Es el group commit en su forma más pura, y explica por qué la superficie de protocolo está diseñada en torno a que el cliente envíe bytes por lotes. OsySealedcuestan microsegundos por llamada. Por qué ambos salen casi idénticos es algo sobre lo que vuelvo en la sección "Lo que encontré".
Lecturas: por secuencia, por tiempo, escaneos completos
El crate todavía no tiene lenguaje de consultas ni evaluador de predicados; el límite de 16 campos del archivo de esquema está reservado para eso. Lo que existe hoy es la base de la lectura: segments() produce cada segmento, del más antiguo al más reciente, como una cabecera más los bytes que describe. No se copia nada y no se decodifica nada. Para los segmentos sellados, los bytes son el propio mmap; para el segmento activo, son el búfer en memoria.
Decidir si merece la pena leer un segmento son cuatro comparaciones contra su cabecera:
pub fn holds_seq(&self, from: u64, to: u64) -> bool {
    self.count > 0 && self.first_seq < to && self.end_seq() > from
}
pub fn holds_ts(&self, from: i64, to: i64) -> bool {
    self.count > 0 && self.min_ts < to && self.max_ts >= from
}
Los rangos son semiabiertos en todas partes. Como holds_ts trabaja con los timestamps mínimo y máximo observados y no con el primer y último registro, un segmento cuyos registros llegaron desordenados sigue respondiendo correctamente.
En la demo, leer las secuencias 5..8 descarta el primer y el último segmento solo con la cabecera:
== read seq 5..8 (skip segments by header)
segment  0..4  skipped
seq=5 ts=1791800000001500 px=6412332 qty=15 taker=1002 maker=2002 sym=2 side=0
seq=6 ts=1791800000001750 px=6412333 qty=22 taker=1003 maker=2003 sym=0 side=1
seq=7 ts=1791800000002000 px=6412334 qty=29 taker=1004 maker=2004 sym=1 side=0
segment  8..10 skipped
Como las secuencias son densas, encontrar un registro dentro de un segmento ni siquiera necesita una búsqueda: está en (seq - first_seq) * width. Leer un único registro por secuencia de un stream de 10 millones de registros tardó 2,1 microsegundos:
== one record by sequence
seq 7654321 ts 1791807654321000 px 6412331 qty 48 in 2.1 us
Los rangos de tiempo funcionan igual. Pedir un minuto de 10 millones de fills que abarcan unas 2,8 horas de tiempo de mercado descartó 151 de 153 segmentos por la cabecera:
== one minute out of ~2.8 hours, by timestamp
60000 records, volume 1530000; segments read 2, skipped 151; 0.166 ms
Y un escaneo completo: el precio medio ponderado por volumen de los 10 millones de registros. Los registros se recorren con un paso fijo y cada campo es una sola carga:
== full scan: VWAP and volume over every record
cold-ish 10000000 records, volume 255000000, vwap 64123.4959, 48.4 ms = 207 M rec/s, 8.26 GB/s
warm     10000000 records, volume 255000000, vwap 64123.4959, 33.1 ms = 302 M rec/s, 12.09 GB/s
300 millones de registros por segundo en un hilo con la page cache caliente. La salida dice "cold-ish" (casi en frío) porque los archivos se acababan de escribir y la mayoría seguía en caché; una lectura realmente en frío desde disco sería más lenta.
Retención: borrar archivos
La retención es mi parte favorita del motor porque casi no hace nada. retain_from(cutoff) elimina cada segmento sellado cuyo max_ts esté por debajo del corte. Sin escaneo, sin reescritura, sin mantenimiento de índices: un remove_file por segmento. retain_seq(cutoff) hace lo mismo por secuencia, para quienes conservan "los últimos N registros" en lugar de "los últimos N minutos".
Algunos detalles importan:
- El criterio es el propio
max_tsde cada segmento, no su posición. Un stream cuyo reloj retrocedió descarta exactamente lo que debe. - El segmento activo nunca se toca por antiguos que sean sus registros, porque todavía se está escribiendo. Un stream que se ha quedado en silencio conserva su último segmento parcial hasta que llegue algo que lo selle.
- La retención elimina historial, no lo renumera.
next_seqcontinúa yfirst_seqavanza.
La demo:
== retention: retain_from(ts = T0+1750)
dropped 4 records
Stats { records: 6, segments: 2, bytes: 368, first_seq: 4, next_seq: 10, min_ts: 1791800000001250, max_ts: 1791800000002500, appended: 10, dropped: 4 }

== reopen
Stats { records: 6, segments: 2, bytes: 368, first_seq: 4, next_seq: 10, min_ts: 1791800000001250, max_ts: 1791800000002500, appended: 10, dropped: 4 }
durability = Commit, verify failures = 0
Obsérvese que el corte es T0+1750 pero solo se fueron 4 registros. La retención trabaja con granularidad de segmento: el max_ts del segmento 4..8 está por encima del corte, así que su registro en 1250 también se queda. La garantía es "conservar al menos esto", no "borrar exactamente esto".
A escala: descartar la primera mitad del stream de 10 millones de registros tardó entre 54 y 127 ms en tres ejecuciones:
== retention: drop the first half by time
dropped 4980736 records in 54.25 ms
Stats { records: 5019264, segments: 77, bytes: 200775488, first_seq: 4980736, next_seq: 10000000, ...
Según un comentario del código, uno de los detonantes para escribir este motor fue un DELETE sobre tres millones de filas en el motor SQL que tardaba 8,7 segundos y bloqueaba. No es algo que pueda reproducir hoy: la ruta DML del motor SQL se ha reescrito desde entonces ("DML is one scan, ids only", justo antes de 0.44.2). A modo de comparación, cargué los mismos fills en los dos motores que sí expone el servidor 0.44.2 (en el puerto 16000, OXIDB_SQL=1, durabilidad completa por defecto) y planteé la misma pregunta de retención. Con el cliente Python y 1 millón de registros:
db.sql("CREATE TABLE fills (seq BIGINT PRIMARY KEY, ts BIGINT, px INTEGER, qty INTEGER, "
       "taker INTEGER, maker INTEGER, sym INTEGER, side INTEGER)")
# 1000-row INSERTs, each inside BEGIN/COMMIT ...
db.sql(f"DELETE FROM fills WHERE ts < {cut}")

# document engine: insert_many in thousands, with an index on ts
db.create_index("fills", "ts")
db.delete("fills", {"ts": {"$lt": cut}})
ping: pong
sql insert 1000000 rows (1000/stmt): 11.15 s = 89660 rows/s
sql count: [[1000000]]
sql DELETE WHERE ts < cutoff: {'affected': 500000} in 381 ms
doc insert_many 1000000 docs (1000/call): 10.15 s = 98511 docs/s
doc delete ts < cutoff: {'deleted': 500000} in 2011 ms
doc count: 500000| Método | Registros eliminados | Tiempo |
|---|---|---|
Motor SQL, DELETE WHERE ts < ... | 500,000 | 381 ms |
Motor de documentos, delete {ts: {$lt: ...}} | 500,000 | 2011 ms |
Ledger, retain_from (76 archivos) | 4,980,736 | 54 - 127 ms |
Esto no es una carrera y no debe leerse como tal: los motores SQL y de documentos encuentran cada fila y registran de forma durable su eliminación, actualizan los índices y dan a los lectores concurrentes una vista consistente, y las cifras del servidor incluyen la red y la ruta JSON. La diferencia real está en la forma del coste: en los motores SQL y de documentos la retención escala con el número de filas eliminadas; en el ledger escala con el número de archivos. Diez veces más registros no es un borrado diez veces más largo, solo diez veces más llamadas a unlink.
Recuperación tras caídas e integridad
La cola rota
Cuando se crea un segmento activo, su cabecera se escribe con un número de registros igual a cero y solo se reescribe en el sellado. Así que un archivo al que se estaba anexando cuando el proceso murió se reconoce por su contador a cero, y se reproduce en lugar de darlo por bueno. Un proceso que muere a mitad de una escritura deja un registro parcial al final. Esa cola no es ni un error ni una corrupción; es una escritura que nunca ocurrió. Se trunca y el segmento continúa desde el último registro completo, el mismo tratamiento que el WAL del motor de documentos da a una cola rota.
En la demo anexé 20 bytes de basura (medio registro) al segmento activo y lo reabrí:
== torn tail: half a record after the last whole one
append 2  -> (10, 2)
00000000000000000010.seg: 144 -> 164 bytes
after reopen: 144 bytes, next_seq = 12
El archivo se recortó a 144 bytes, los dos registros completos sobrevivieron y next_seq es 12.
CRC32
Cada segmento sellado lleva en su cabecera un CRC32 de los bytes de sus registros. No está en ninguna ruta crítica; verify() es lo que ejecuta un operador o un test de caídas. Invertir un solo bit de un segmento sellado se detecta:
== flip one byte in a sealed segment
verify: checksum mismatch in 00000000000000000004.seg
Rendimiento: lo que medí y lo que no pude medir
Todas las cifras son de un Mac con Apple M4 y 24 GB de RAM, SSD interno, macOS; un solo hilo, fills de 40 bytes, Durability::Os, lotes de 1024 registros.
| Medición | Resultado |
|---|---|
| Anexar 10 millones de fills (3 ejecuciones) | 2.29 / 2.60 / 4.03 s, es decir, de 2,5 a 4,4 millones de registros/s (99 a 175 MB/s) |
| Abrir un stream de 153 segmentos | 25 - 26 ms |
| Escaneo VWAP sobre 10 millones de registros | 33 ms en caliente (~300 millones de registros/s) |
| Un minuto de 2,8 horas, por tiempo | 0.17 ms, 151 de 153 segmentos descartados |
| Un registro por secuencia | 2.1 µs |
| Descartar la primera mitad por retención | 54 - 127 ms, 4,98 millones de registros |
Ahora la parte en la que tengo que ser honesto. Lo que afirma el código es que un stream con cien millones de registros detrás anexa exactamente al mismo ritmo que uno con diez mil. A nivel de código es cierto: ningún paso de un append mira el tamaño del historial. Pero no pude medirlo limpiamente en mi máquina. En las ejecuciones de 10 millones, el ritmo por millón osciló entre 1,4 y 10,4 millones de registros por segundo, y los últimos millones solían ser más lentos. Para aislarlo hice un experimento aparte: escribir 0, 3, 6 o 9 millones de registros de historial, sincronizar, hacer una pausa, reabrir el stream y anexar 1 millón más. Los resultados para la misma configuración oscilaron entre 166 mil y 10,6 millones de registros por segundo; el stream vacío fue más rápido de media, pero la dispersión era demasiado grande en todos los casos como para atribuir la diferencia al historial. Durante estas ejecuciones el disco solo tenía unos 2 GB libres, y el comportamiento de APFS y del SSD con ese nivel de ocupación ahoga el trabajo que hace el motor. Así que "el historial no afecta al coste del append" debe leerse como una propiedad del diseño, no como una medición mía. Repetir esto en Linux, con un disco vacío y con perf para separar la parte de CPU, está en mi lista.
Lo que encontré: dos bugs y una laguna
Preparar este artículo fue la primera vez que usé de verdad el crate, y salieron tres cosas. Todas confirman lo que ya dice su ausencia del workspace: este motor no está terminado.
1. Un test está mal. Pasan 18 de los 19 tests del crate. El que falta es an_order_is_forty_eight_bytes:
test schema::tests::an_order_is_forty_eight_bytes ... FAILED
assertion `left == right` failed
  left: 40
 right: 48
test result: FAILED. 18 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.05s
El código está bien y el test está mal. La forma de orden son 16 bytes reservados, cinco campos de 4 bytes (20), un u16 (2) y dos u8 (2): 40 en total, múltiplo de 8, sin relleno. El test espera 48. La regla de empaquetado funciona; la expectativa estaba mal calculada.
2. Os y Sealed hacen lo mismo. La diferencia documentada es que Sealed llega al disco solo cuando se sella un segmento. Pero el sellado llama a sync_all en todos los modos, y append solo llama a flush en todos los modos excepto Commit (y flush sobre un std::fs::File no hace nada de todos modos). El resultado: hoy Durability::Os también llega al disco en el sellado, y los dos modos son idénticos. Las diferencias del gráfico anterior son ruido de medición. No es un bug de pérdida de datos, ya que Os es más durable de lo que promete, pero si hay dos ajustes deberían comportarse de forma distinta. O bien Os debería omitir el fsync en el sellado, o bien ambos deberían fusionarse en uno.
3. Una ventana de caída en mitad del sellado. Este es el bug de verdad. roll() crea primero el archivo del siguiente segmento y sella el antiguo (escribe su número de registros en la cabecera) después. Si el proceso muere entre ambos pasos, el disco contiene un segmento antiguo cuyos registros están completos pero cuyo contador en la cabecera sigue a cero, más un segmento nuevo vacío. open() marca un archivo con contador a cero como "reproducido sea cual sea su posición", pero luego lo asigna a la variable active, y el siguiente archivo (el segmento nuevo vacío) sobrescribe esa misma variable. Los registros del segmento antiguo no acaban ni en la lista de sellados ni en el segmento activo. Lo simulé anexando 6 registros en modo Commit y devolviendo después el contador de la cabecera del segmento 0 a su valor previo al sellado, cero:
append 6 -> (0, 6)
before: Stats { records: 6, segments: 2, bytes: 368, first_seq: 0, next_seq: 6, min_ts: 1000, max_ts: 1005, appended: 6, dropped: 0 }
after:  Stats { records: 2, segments: 1, bytes: 144, first_seq: 4, next_seq: 6, min_ts: 1004, max_ts: 1005, appended: 6, dropped: 0 }
segment 0 still on disk: 224 bytes
Cuatro registros confirmados y con fsync se vuelven invisibles al reabrir. El archivo sigue en disco, así que los datos no han desaparecido físicamente, pero el motor ya no los lee. La ventana es estrecha (entre dos operaciones de archivo), pero es exactamente donde se supone que la promesa de durabilidad tiene que significar algo. La corrección es sencilla: un archivo con contador a cero que no sea el último debería tener sus registros contados a partir de la longitud del archivo y sellarse en su sitio. Pertenece a la misma familia que bugs que cerré recientemente en otras partes de OxiDB: el commit "five acknowledged-write losses in recovery", justo antes de 0.44.2, cerró cinco formas en que una escritura confirmada podía perderse en la recuperación del motor de documentos, una de las cuales era "a zero-record torn tail swallowed every later append".
Corrección monetaria: notas relacionadas del CHANGELOG
El motor ledger todavía no está en producción, pero la mayor parte de lo que hubo que corregir antes de que un exchange pudiera confiar sus datos a OxiDB está en el motor de documentos y registrado en el CHANGELOG. Estas eran las referencias que tenía en la cabeza mientras diseñaba este motor:
- v0.34.0, dos escrituras en el mismo documento: dos escrituras en un documento dentro de una transacción no se veían entre sí;
$inc -2seguido de$inc +1daba +1 en lugar de -1. En palabras del propio CHANGELOG, eso era "creating money in a ledger". Ahora las escrituras se componen, y se añadiófind_for_update(SELECT ... FOR UPDATE). - fsyncgate: en el group commit, una transacción aplicaba sus escrituras en memoria y después hacía fsync del WAL. Cuando el fsync fallaba, el commit devolvía correctamente un error, pero las escrituras rechazadas se filtraban al siguiente checkpoint: "money moved despite the API reporting failure". Ahora un fsync fallido del WAL envenena el estado en memoria y la recuperación solo reproduce las transacciones confirmadas.
- v0.40.0, una transacción multicolección aplicada a medias: una transacción que abarcaba dos colecciones podía recuperarse aplicada a medias tras una caída. El test bancario al estilo Jepsen, el simulacro de atomicidad multicolección y el test de exactamente-una-vez fallaban todos por ese único bug.
- La tabla de preparación para exchanges: monotonía de secuencias e IDs de operación a través del failover del líder Raft (
raft_sequence_monotonic), aplicación exactamente una vez ante reintentos (exactly_once), y que el fill de una orden sea todo o nada a través de cinco colecciones (multi_collection_crash).
Las reglas del ledger, "el motor asigna la secuencia" y "una confirmación significa en disco", se derivan directamente de esas lecciones. El tercer hallazgo de arriba muestra que esa misma disciplina todavía no se ha aplicado del todo a este nuevo crate.
Límites y compromisos
- No está en el servidor. Sin comando de protocolo, sin biblioteca cliente, sin endpoint REST. Hoy solo se puede usar embebido, desde Rust, e incluso así hay que escribirle un
lib.rs. - Sin capa de consultas. El evaluador de predicados, la proyección y la API de agregación no están escritos; hoy hay que recorrer
segments()a mano. - Esquema fijo. Añadir, quitar o ensanchar un campo implica un stream nuevo. Sin campos de texto ni de longitud variable (incluso los nombres de campo son de 12 bytes).
- Todo es
i64. Los valoresu64por encima dei64::MAXse leen como negativos. - La retención es por segmento. Algunos registros más antiguos que el corte pueden sobrevivir hasta un segmento; el segmento activo de un stream en silencio nunca se descarta.
- Un solo escritor.
appendrecibe&mut self; el modelo de concurrencia (un escritor por stream, muchos lectores) se diseñará junto con la capa de protocolo. - Sin replicación. No está conectado al clúster Raft; las garantías de replicación y de secuencia que tiene el motor de documentos todavía no existen aquí.
- La ventana de caída y la igualdad entre
OsySealeddescritas arriba siguen abiertas.
Cómo encaja con el resto de OxiDB
Así es como veo su lugar: el libro de saldos y el journal de partida doble se quedan en el motor de documentos con transacciones, porque necesitan aislamiento (motor de documentos). Los journals de órdenes y de fills van al ledger, porque necesitan orden, durabilidad y retención. Las velas y los datos de mercado viven en el motor de series temporales, los informes en el motor SQL, y los eventos de fill se distribuyen por MQTT y AMQP. El comentario del código dice lo mismo: los fills están "also on the wire, in the browser, and in the time series", y por eso un journal de fills puede no querer Commit.
El parecido con el motor de series temporales es evidente, pero los objetivos difieren: el motor de series temporales está construido en torno a etiquetas flexibles y compresión; el ledger, en torno a secuencias densas asignadas por el motor, cero codificación y un fsync que significa una confirmación.
Qué viene ahora y cómo probarlo
Primero, corregir las tres cosas que ha sacado a la luz este artículo: el test, el modo Os y la ventana del sellado. Después, incorporar el crate al workspace, darle un lib.rs y una capa de consultas y, sobre todo, la superficie de protocolo: un comando de append sin parseo, en el que el cliente envía los registros exactamente en los bytes que llegarán al disco. Después de eso, el ledger podrá activarse con una variable de entorno como los demás motores de esta serie.
Hasta entonces, para probar el OxiDB que funciona hoy, las versiones están en la página de releases de GitHub con binarios para macOS (arm64/x86_64), Linux (x86_64/arm64) y Windows, y docker compose up -d en el repositorio lo levanta en Docker. El crate del ledger vive en el código fuente bajo oxidb-ledger/; con el truco de #[path] de arriba se puede montar en un proyecto propio y ejecutar sus tests en cinco minutos. El último artículo de la serie trata del motor de recomendaciones.