Logs y alertas en OxiDB: GELF, MessagePack, retención y webhooks
El motor de logs de OxiDB: ingesta de GELF y MessagePack por UDP, reensamblado de fragmentos, indexación dinámica por campo, retención por colección, alertas por umbral con webhooks y oxidb-tail. Probado con paquetes reales, defectos incluidos.
Lo primero que se necesita cuando una aplicación entra en producción son sus logs. Lo segundo es algo que avise cuando esos logs dicen que algo ha ido mal. La respuesta habitual es una pila aparte: Graylog o Elasticsearch, un shipper delante y un servicio de alertas al lado. En OxiDB hice que la propia base de datos se encargara de ese trabajo. El servidor acepta registros de log GELF (Graylog Extended Log Format) y MessagePack por UDP, los escribe en colecciones de documentos normales, aplica un periodo de retención por colección y evalúa en segundo plano alertas por umbral que llaman a un webhook. En este artículo muestro cómo funciona ese motor enviando paquetes reales a un servidor real, y también dejo por escrito, sin ocultarlos, los defectos que encontré mientras lo hacía.
Este es el noveno artículo de la serie sobre OxiDB. Todo lo que aparece aquí se apoya en el motor de documentos: los logs son documentos, los índices son los índices del motor de documentos y la retención es su maquinaria de TTL.
¿Por qué poner los logs en la base de datos?
En un sistema pequeño o mediano, la infraestructura de logs a menudo requiere más cuidados que la propia aplicación. Un clúster de Elasticsearch, sus ajustes de heap, las plantillas de índices, las políticas de retención, una herramienta de alertas aparte... OxiDB ya almacena documentos, los indexa, los consulta y los hace expirar con TTL. Una línea de log no es más que un documento estructurado con marca de tiempo. Las piezas que faltaban eran:
- recibir logs por un protocolo de red barato (UDP, GELF, MessagePack),
- escribir por lotes un gran caudal de registros pequeños,
- retención por colección,
- alertas del tipo "llama a un webhook si hubo más de 100 errores en los últimos 5 minutos",
- una herramienta para verlo en directo en una terminal (oxidb-tail).
Todo en un solo proceso. Sin servicios adicionales.
Cómo activarlo
Cada entrada se activa con una variable de entorno. Este es el comando que usé para los experimentos (los puertos son los que elegí para este artículo, no los valores por defecto):
OXIDB_ADDR=127.0.0.1:15900 \
OXIDB_DATA=./data \
OXIDB_GELF_PORT=15908 \
OXIDB_MSGPACK_PORT=15909 \
OXIDB_UDP_PORT=15910 \
OXIDB_ALERT_INTERVAL=2 \
./oxidb-server
Al arrancar, el servidor dice exactamente lo que está haciendo:
TTL eviction: enabled (interval=1000ms)
alert evaluator: enabled (interval=2s)
oxidb-server listening on 127.0.0.1:15900 (pool_size=4, data_dir=.../data, idle_timeout=0s)
UDP log ingestion: listening on 0.0.0.0:15910 → collection '_udp_logs' (8 threads)
GELF ingestion: listening on 0.0.0.0:15908 → collection '_gelf_logs' (8 receivers, 4 writers, batch=2000, simd-json, crossbeam, auto-indexing)
MessagePack ingestion: listening on 0.0.0.0:15909 → collection '_msgpack_logs' (8 receivers, 4 writers, batch=2000, no auto-indexing)
El conjunto completo de variables:
| Variable | Valor por defecto | Qué hace |
|---|---|---|
OXIDB_GELF_PORT | desactivado | Listener UDP de GELF |
OXIDB_GELF_COLLECTION | _gelf_logs | Colección a la que van los registros GELF |
OXIDB_MSGPACK_PORT | desactivado | Listener UDP de MessagePack |
OXIDB_MSGPACK_COLLECTION | _msgpack_logs | Colección de MessagePack |
OXIDB_MSGPACK_TTL_SECS | 604800 (7 días) | TTL de la colección de MessagePack, 0 lo conserva todo |
OXIDB_UDP_PORT | desactivado | Listener UDP en bruto (JSON o texto plano) |
OXIDB_UDP_COLLECTION | _udp_logs | Colección de UDP en bruto |
OXIDB_ALERT_INTERVAL | 15 segundos | Intervalo de evaluación de alertas |
OXIDB_GELF_ADDR | desactivado | Destino GELF para los propios logs del servidor |
OXIDB_MSGPACK_ADDR | desactivado | Destino MessagePack para el propio log de peticiones REST del servidor |
Una observación: los tres listeners UDP se enlazan a 0.0.0.0 independientemente de OXIDB_ADDR, como muestra la salida anterior. UDP no tiene autenticación, así que conviene mantener estos puertos detrás de un firewall.
Una duda que quería aclarar era si OXIDB_UDP_PORT es una entrada independiente. Lo es: vive en udp_ingest.rs, es independiente de GELF y es la más sencilla de las tres. La trato más abajo.
Dentro del motor: la visión general
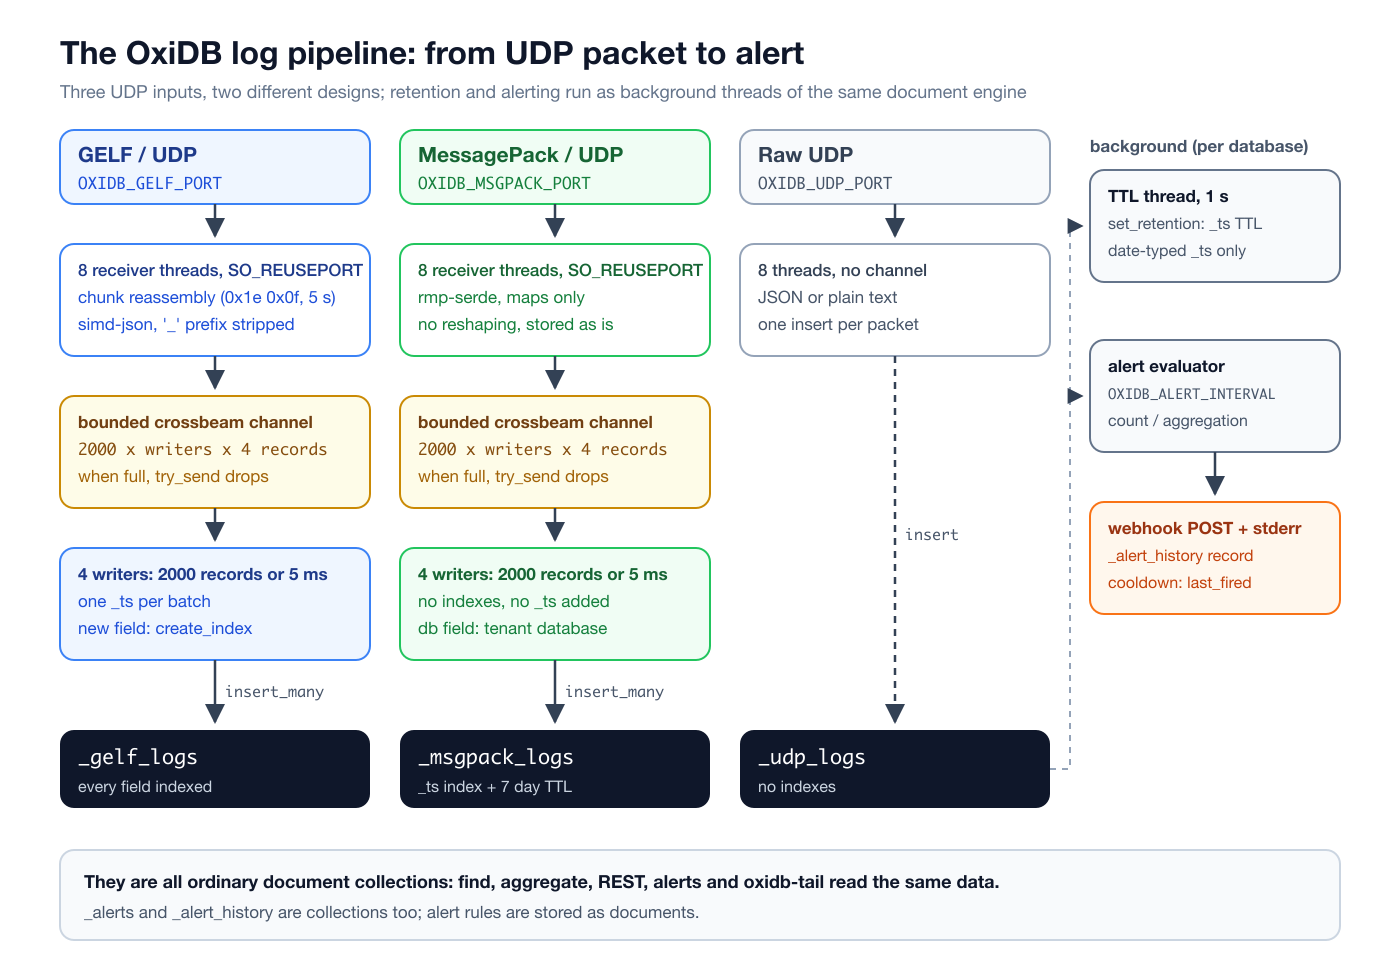
Las tres entradas son variaciones de un mismo esqueleto:
- Hilos receptores. Tantos hilos como núcleos, con un máximo de 8, se enlazan al mismo puerto UDP con
SO_REUSEPORT. El kernel reparte los paquetes entrantes entre estos sockets, de modo que un único buclerecvnunca es el cuello de botella. Cada socket pide un búfer de recepción de 64 MB (8 MB para UDP en bruto). - Un canal acotado. En GELF y MessagePack, los receptores empujan los documentos decodificados a un canal
crossbeamsin bloqueos. Su capacidad es2000 x writers x 4. Mi máquina de 10 núcleos tenía 4 escritores, es decir, 32.000 registros. - Hilos escritores. La mitad de escritores que de receptores (como mínimo 2) leen del canal. Un escritor cierra un lote cuando llega a 2000 registros o 5 ms después de su primer registro, lo que ocurra primero, y lo escribe con un único
insert_many. - La colección. El resultado es una colección de documentos normal. WAL, fsync, índices, consultas: todo eso es el motor de documentos.
La clave de este diseño es el lote. Un insert_many de 2000 registros en lugar de inserciones individuales reparte el coste del lock de la colección, la escritura en el WAL y el fsync entre cientos de registros. El límite de 5 ms impide que un registro espere indefinidamente cuando hay poco tráfico.
GELF: recibir logs en formato Graylog
GELF es el formato de logs JSON de Graylog. En la versión 1.1 los campos obligatorios son version, host y short_message. Hay campos opcionales, full_message, timestamp y level (niveles de syslog, de 0 emergency a 7 debug), y tantos campos adicionales que empiecen por _ como se quiera. Existen loggers GELF para la mayoría de los lenguajes, así que cambiar un endpoint de Graylog por OxiDB es solo un cambio de dirección en el lado de la aplicación.
OxiDB transforma cada mensaje así:
- Si no hay
short_message, el mensaje se descarta en silencio. - Los campos estándar (
host,short_message,full_message,timestamp,level,facility) se conservan tal cual. - Se elimina
version. - Se quita el guion bajo inicial de los campos adicionales:
_userse almacena comouser. - Antes de escribir un lote, el hilo escritor añade
_tsa cada documento. Hay que tener en cuenta que esta marca se toma una vez por lote, no por mensaje. Todos los registros que caen en la misma ventana de 5 ms llevan el mismo_ts. Es intencionado: hasta la llamada al reloj se hace una vez cada 2000 registros. Si se quiere la hora propia del mensaje, el campotimestampde GELF también se almacena.
El JSON se parsea in situ con simd-json.
Enviar mensajes reales
Sin ninguna biblioteca, con un simple socket de Python, envié tres mensajes normales y uno fragmentado:
import socket, json, os, time
sock = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
dst = ("127.0.0.1", 15908)
def send(msg):
    sock.sendto(json.dumps(msg).encode(), dst)

send({"version":"1.1","host":"api-01","short_message":"Login user: baris","level":6,
      "facility":"auth","timestamp":time.time(),"_user":"baris","_client_ip":"192.0.2.10","_latency_ms":42})
send({"version":"1.1","host":"api-02","short_message":"Payment declined","level":3,
      "facility":"billing","timestamp":time.time(),"_user":"ayse","_order_id":54321,"_amount":2500.0})
send({"version":"1.1","host":"worker-1","short_message":"Retrying job SendEmail","level":4,
      "facility":"jobs","timestamp":time.time(),"_job":"SendEmail","_attempt":3})

# a ~23 KB message split into 8 KB chunks and sent in REVERSE order
full = "Traceback (most recent call last):\n" + "".join(f"  at frame_{i} (service.rs:{i})\n" for i in range(700))
big = json.dumps({"version":"1.1","host":"api-01","short_message":"Unhandled panic in /checkout",
      "full_message":full,"level":2,"facility":"checkout","_request_id":"req-7f3a"}).encode()
CH = 8192
parts = [big[i:i+CH] for i in range(0, len(big), CH)]
mid = os.urandom(8)
order = list(range(len(parts)))[::-1]
for seq in order:
    sock.sendto(b"\x1e\x0f" + mid + bytes([seq, len(parts)]) + parts[seq], dst)
print(f"chunked payload: {len(big)} bytes -> {len(parts)} chunks, sent in order {order}")
chunked payload: 23084 bytes -> 3 chunks, sent in order [2, 1, 0]El stderr del servidor muestra cómo se crea un índice para cada campo que ve por primera vez:
GELF auto-index: created index on 'job' in '_gelf_logs'
GELF auto-index: created index on 'attempt' in '_gelf_logs'
GELF auto-index: created index on 'amount' in '_gelf_logs'
GELF auto-index: created index on 'order_id' in '_gelf_logs'
GELF auto-index: created index on 'client_ip' in '_gelf_logs'
GELF auto-index: created index on 'user' in '_gelf_logs'
GELF auto-index: created index on 'latency_ms' in '_gelf_logs'
GELF auto-index: created index on 'request_id' in '_gelf_logs'
GELF auto-index: created index on 'full_message' in '_gelf_logs'
Consultas
El protocolo de red de OxiDB es JSON con prefijo de longitud (una longitud de 4 bytes en little-endian seguida del JSON). Las peticiones y respuestas siguientes son mensajes reales sobre ese protocolo. Primero, un conteo:
{"cmd": "count", "collection": "_gelf_logs", "query": {}}{"ok": true, "data": {"count": 4}}Cuatro registros: tres mensajes normales y uno reensamblado a partir de tres fragmentos. Ahora una consulta por rango sobre un campo adicional. El índice latency_ms se creó automáticamente, así que esta consulta lo usa:
{"cmd": "find", "collection": "_gelf_logs", "query": {"latency_ms": {"$gt": 10}}}{
"ok": true,
"data": [
{
"host": "api-01",
"short_message": "Login user: baris",
"timestamp": 1791754331.033758,
"level": 6,
"facility": "auth",
"user": "baris",
"latency_ms": 42,
"client_ip": "192.0.2.10",
"_ts": "2026-10-11T21:32:11.039911+00:00",
"_id": 2,
"_version": 1
}
]
}_user pasó a ser user, no hay version y se añadió _ts. Una consulta level <= 3 devolvió el registro "Payment declined" y el mensaje fragmentado, y ambos tenían exactamente _ts: 2026-10-11T21:32:11.039911+00:00. Los cuatro mensajes cayeron en el mismo lote, así que recibieron la misma marca. También comprobé que el mensaje fragmentado volvía intacto:
chunked doc: short_message='Unhandled panic in /checkout', full_message 22215 chars, 701 lines, last line ' at frame_699 (service.rs:699)'La última línea del stack trace de 700 líneas está donde debe estar. La lista de índices de la colección:
indexes: ['_ts', 'amount', 'attempt', 'client_ip', 'facility', 'full_message', 'host', 'job', 'latency_ms', 'level', 'order_id', 'request_id', 'short_message', 'timestamp', 'user']Reensamblado de mensajes fragmentados
En la práctica, los datagramas UDP están limitados a unos pocos kilobytes, así que GELF divide los mensajes grandes en fragmentos (chunks). Cada fragmento empieza con una cabecera de 12 bytes: 2 bytes mágicos (0x1e 0x0f), un identificador de mensaje de 8 bytes, un número de secuencia de 1 byte y un recuento de fragmentos de 1 byte.
En OxiDB cada hilo receptor mantiene su propio HashMap<message_id, ChunkBuffer>. Los fragmentos van a la posición indicada por su número de secuencia; un número de secuencia repetido se ignora (gana el primero). Cuando llega el último fragmento que faltaba, se concatenan en orden y se parsean. En el ejemplo anterior envié los fragmentos al revés a propósito, y no hubo ninguna diferencia. Los mensajes incompletos se descartan a los 5 segundos. Esa limpieza se ejecuta cada 1000 paquetes, así que en un servidor inactivo un búfer a medio completar puede vivir algo más.
Un aspecto sutil: los búferes son por hilo. SO_REUSEPORT reparte según la dirección y el puerto de origen, así que los fragmentos enviados desde el mismo socket llegan al mismo hilo. Un cliente que enviara los fragmentos de un mismo mensaje desde distintos puertos de origen podría verlos repartidos entre hilos, y el mensaje nunca se reensamblaría. Las bibliotecas GELF que conozco envían cada mensaje desde un solo socket, pero vale la pena conocer el límite.
Indexación dinámica al estilo Elasticsearch
Esta es la característica que define la entrada GELF: cada campo se indexa en el momento en que se ve por primera vez. Los índices sobre host, short_message, level, facility, timestamp y _ts se crean al arrancar. A partir de ahí, cada escritor recoge los nombres de campo de su lote y los compara con el conjunto de campos conocidos; si hay alguno desconocido, llama a create_index. El conjunto de campos conocidos está detrás de un mutex compartido, y el camino rápido es solo una comprobación de pertenencia al conjunto.
La ventaja es evidente: si la aplicación empieza a enviar mañana un nuevo campo _tenant_id, una consulta {"tenant_id": "acme"} se ejecuta sobre un índice sin ninguna configuración de esquema ni de índices. El dynamic mapping de Elasticsearch hace lo mismo y, para logs, resulta realmente cómodo.
El coste es igual de evidente:
- Cada campo es un índice B-tree. Los cuatro mensajes anteriores produjeron 15 índices. Eso incluye el
full_messagede 22 KB: un stack trace entero se convierte en una clave de índice. Los campos de alta cardinalidad (duración de la petición, identificador de petición) son los que más hacen crecer la memoria de los índices y el coste de escritura. - Un campo nuevo implica construir un índice en el camino de escritura. Eso tiene un efecto secundario medible, que se trata más abajo en la sección "Medición".
Sin soporte de compresión
La especificación de GELF permite comprimir los mensajes UDP con zlib o gzip. El receptor de OxiDB no descomprime. Lo probé:
s.sendto(zlib.compress(m("zlib-compressed")), ("127.0.0.1",15908))
s.sendto(gzip.compress(m("gzip-compressed")), ("127.0.0.1",15908))
s.sendto(m("plain"), ("127.0.0.1",15908))
stored: ['plain']Los dos mensajes comprimidos desaparecieron sin dejar rastro. Algunos clientes GELF comprimen por UDP por defecto, así que conviene desactivarlo al enviar a OxiDB.
MessagePack: el hermano barato que no indexa a propósito
La entrada MessagePack usa el mismo esqueleto que GELF (8 receptores, canal acotado, 4 escritores, 2000 registros o 5 ms), con dos diferencias importantes:
- El formato es binario y compacto. El parseo usa
rmp-serdey solo se aceptan mapas. No hay reestructuración ni se quitan los prefijos_: el registro se almacena tal como llega. - No hay indexación por campo. A propósito.
El razonamiento del código fuente se resume en esto: el dynamic mapping de GELF construye un B-tree por campo, y los campos de alta cardinalidad, como la latencia de las peticiones, dominan la memoria. Un flujo de logs, en cambio, es de solo anexado y rara vez se consulta por un campo arbitrario. La mayoría de las veces se quiere "muéstrame los últimos N registros" o "muéstrame este rango de tiempo", y un único índice sobre _ts cubre eso. Cuando el servidor arranca el listener de MessagePack, pone un índice sobre _ts y un TTL por defecto de 7 días en la colección. Según el comentario del código, el objetivo es que la paginación del dashboard, de más reciente a más antiguo, no se convierta en un escaneo completo y que la colección no crezca sin límite.
Comparé el tamaño de los mismos registros:
GET /api/orders 200    msgpack 124 B vs JSON 169 B
POST /api/pay 502      msgpack 123 B vs JSON 167 B
GET /health 200        msgpack 116 B vs JSON 160 B
Paquetes alrededor de un 27 por ciento más pequeños. Las consultas siguen funcionando, solo que se ejecutan sin índice (un escaneo completo):
{"cmd": "find", "collection": "_msgpack_logs", "query": {"status": {"$gte": 500}}}{
"ok": true,
"data": [
{
"host": "edge-1",
"short_message": "POST /api/pay 502",
"level": 3,
"method": "POST",
"path": "/api/pay",
"status": 502,
"dur_ms": 3010,
"ts": 1791754356.749907,
"_ts": 1791754356749,
"_id": 2,
"_version": 1
}
]
}Estos son los únicos índices de la colección:
{"cmd": "list_indexes", "collection": "_msgpack_logs"}{
"ok": true,
"data": [
{"name": "_ts", "index_type": "field", "fields": ["_ts"], "unique": false},
{"name": "_ts_ttl", "index_type": "ttl", "fields": ["_ts"], "unique": false, "expire_after_seconds": 604800}
]
}(Compacté esta respuesta en menos líneas para que se lea mejor; el contenido no ha cambiado.)
Enrutamiento por tenant
La entrada MessagePack tiene un truco más: si un registro tiene un campo db y existe una base de datos con ese nombre, el registro va a la colección del mismo nombre en esa base de datos. El escritor agrupa cada lote por base de datos de destino y hace un insert_many por grupo. El razonamiento está escrito en el código: un único sumidero de logs compartido significaba que cada lectura de los logs de un proyecto recorría las filas de todos los demás proyectos, y la retención, el tamaño y el coste de las consultas se compartían. Las peticiones de un tenant son datos del tenant, y eliminar un proyecto se lleva consigo sus logs. Los registros sin db (las propias peticiones del plano de control) se quedan en la base de datos por defecto, y un registro que nombra una base de datos inexistente no se descarta, sino que también va a la base de datos por defecto. La primera escritura en la base de datos de un tenant también configura allí el índice _ts y el TTL.
UDP en bruto: la entrada más sencilla
OXIDB_UDP_PORT es la tercera entrada y la más simple. Si un paquete se puede parsear como JSON, se almacena como documento; si no, se convierte en {"message": "...", "_ts": ...}. El _ts propio de un paquete se conserva. Resulta práctico para recoger líneas de texto plano al estilo syslog sin ninguna transformación:
s.sendto(b'{"level":"error","msg":"disk 91% full","mount":"/var"}', ("127.0.0.1", 15910))
s.sendto(b'kernel: eth0 link down\n', ("127.0.0.1", 15910))
{
"ok": true,
"data": [
{
"level": "error",
"msg": "disk 91% full",
"mount": "/var",
"_ts": "2026-10-11T21:32:36.750067+00:00",
"_id": 1,
"_version": 1
},
{
"message": "kernel: eth0 link down",
"_ts": "2026-10-11T21:32:36.753946+00:00",
"_id": 2,
"_version": 1
}
]
}Aquí no hay canal ni lotes: cada uno de los 8 hilos recibe un paquete y hace directamente un único insert. El comentario al principio del archivo todavía dice "1 writer thread drains the channel in batches", pero el código ya no hace eso. La colección no tiene ningún índice; list_indexes devolvió un array vacío. Para volúmenes altos elegiría las entradas GELF o MessagePack; el UDP en bruto es más bien para "tengo nc, voy a lanzar esta línea a algún sitio".
Medición: una ráfaga de 50.000 paquetes
Para concretar la diferencia entre GELF y MessagePack, envié 50.000 paquetes tan rápido como podía un socket de Python y después conté cuántos registros se habían escrito. Entorno: Apple M4 (10 núcleos), loopback local, OxiDB 0.44.2, ajustes de disco por defecto (fsync en cada commit). El envío tardó entre 0,16 y 0,24 segundos cada vez, y todos los registros eran consultables en 1,2 segundos como máximo (mi bucle contaba cada 0,5 segundos, así que no tengo una resolución más fina).
GELF         sent 50000 in 0.16s, stored 50000 (100.0%), all visible after 1.17s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.18s, stored 50000 (100.0%), all visible after 1.19s (incl. 0.5s idle check)
Con nombres de campo que el servidor ya había visto, ambas entradas no perdieron nada. Cuando añadí nombres de campo nuevos a la ráfaga, el panorama cambió:
GELF         sent 50000 in 0.18s, stored 33439 (66.9%), all visible after 1.19s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.19s, stored 50000 (100.0%), all visible after 1.19s (incl. 0.5s idle check)
GELF         sent 50000 in 0.24s, stored 32751 (65.5%), all visible after 1.24s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.16s, stored 50000 (100.0%), all visible after 1.17s (incl. 0.5s idle check)
La primerísima ejecución ya había mostrado lo mismo (33.595 registros). En las tres, GELF perdió alrededor de un tercio.
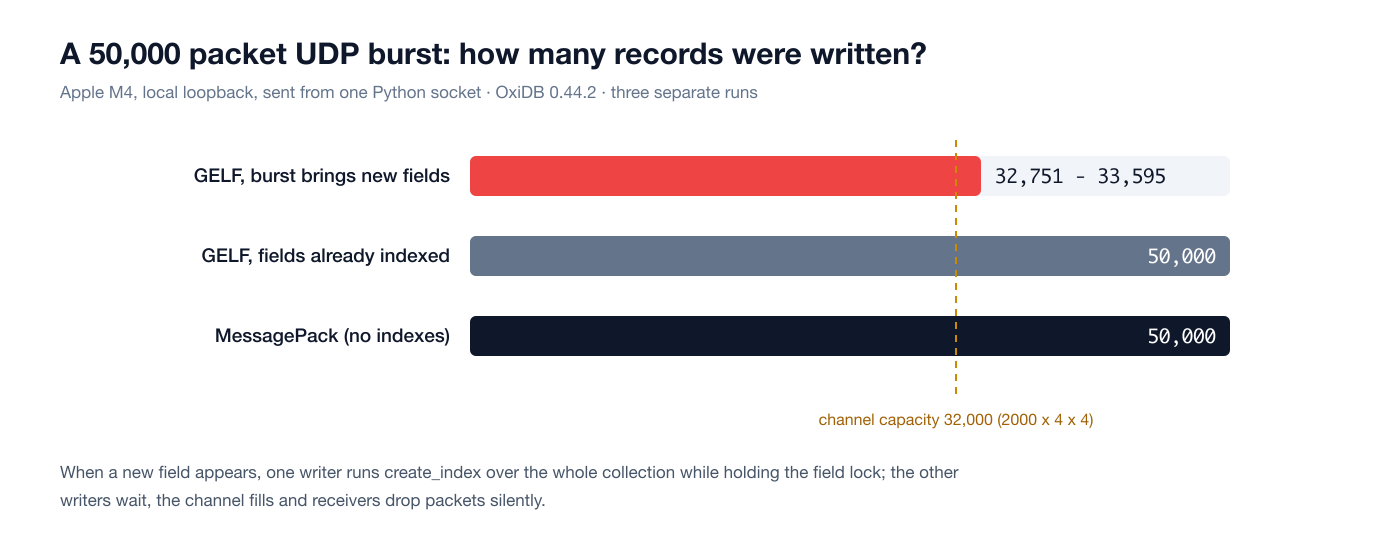
Leyendo el código, la explicación más probable es esta: un escritor que ve un campo nuevo llama a create_index mientras mantiene el mutex de campos conocidos. En ese momento la colección tenía bastante más de cien mil registros, así que el índice se construye sobre toda la colección. Los otros tres escritores comprueban el mismo mutex en cada lote, así que esperan. Mientras los escritores están parados, los receptores llenan el canal y, una vez lleno, try_send descarta el paquete en silencio. Que el número de registros escritos esté tan cerca de la capacidad del canal (32.000) más un lote aproximadamente encaja con esa explicación. MessagePack no construye índices, así que la misma ráfaga pasó sin pérdidas.
Es un compromiso deliberado del diseño: UDP no tiene contrapresión, no se le puede decir al emisor que vaya más despacio, así que descartar cuando la cola está llena es mejor que bloquear el servidor. Pero la consecuencia es que, en GELF, el momento en que aparece por primera vez un campo nuevo es el peor momento. En la práctica sugeriría dos cosas: para aplicaciones con un conjunto fijo de campos, calentar los índices enviando unos cuantos mensajes de ejemplo antes del primer despliegue, o dirigir los flujos de gran volumen y esquema cambiante a la entrada MessagePack. Tampoco hay un contador de estos descartes; quiero añadir uno como métrica.
Retención: set_retention y la maquinaria de TTL
La retención se define por colección:
{"cmd": "set_retention", "collection": "app_logs", "days": 7}Lo que ocurre por dentro es sencillo: set_retention pone un índice TTL de days x 86400 segundos sobre el campo _ts de la colección y escribe la política como documento en la colección _retention_policies. El borrado en sí lo hace el hilo de TTL ya existente del motor de documentos (una vez por segundo en modo archivo, cada 100 ms en modo memoria). La limpieza de TTL es un escaneo por rango sobre el índice _ts, "hasta expire_after_seconds antes de ahora". El borrado se hace en bloques de 4096, liberando los locks de escritura de los índices entre bloques, de modo que una gran acumulación de registros caducados no bloquea la colección durante mucho tiempo.
La prueba: escribí cuatro documentos con valores de _ts de 0, 3, 8 y 30 días de antigüedad en una colección app_logs y establecí una retención de 7 días. Los documentos caducados se borran en cuanto se crea el índice TTL:
{"cmd": "set_retention", "collection": "app_logs", "days": 7}{"ok": true, "data": "retention set: app_logs (7 days)"}{"cmd": "find", "collection": "app_logs", "query": {}}{
"ok": true,
"data": [
{"short_message": "0 days old", "_ts": "2026-10-11T21:33:01.272662+00:00", "_id": 1, "_version": 1},
{"short_message": "3 days old", "_ts": "2026-10-08T21:33:01.272662+00:00", "_id": 2, "_version": 1}
]
}(De nuevo compactado en menos líneas.) Los documentos de 8 y 30 días han desaparecido. El documento de la política:
{"cmd": "get_retention", "collection": "app_logs"}{
"ok": true,
"data": {
"collection": "app_logs",
"retain_days": 7,
"expire_after_seconds": 604800,
"_ts": "2026-10-11T21:33:01.348133+00:00",
"_id": 1,
"_version": 1
}
}days: 0 se rechaza (retain_days must be > 0). delete_retention elimina el ajuste de TTL pero conserva el índice de campo _ts, y list_retentions lista todas las políticas.
Lo que me gusta de este enfoque es que no escribí un mecanismo nuevo: la retención de logs es una forma de usar el índice TTL del motor de documentos. Ahí está también la diferencia con la retención del motor de series temporales: allí se descartan bloques sellados enteros; aquí los documentos se borran uno a uno a través del índice. Está bien para logs, pero en colecciones muy grandes no es tan barato como descartar bloques.
Dos defectos que encontré al probar
Cambiar el periodo de retención no cambia el TTL. create_ttl_index no hace nada si ya existe un TTL sobre ese campo (es idempotente). set_retention actualiza el documento de la política, pero no reconstruye el TTL:
policy record retain_days: 30
ttl index: [{'name': '_ts_ttl', 'index_type': 'ttl', 'fields': ['_ts'], 'unique': False, 'expire_after_seconds': 604800}]
La política dice 30 días, pero el TTL que realmente borra sigue siendo de 7 días (604800 segundos). La solución provisional es hacer primero delete_retention y luego set_retention de nuevo:
after delete: [('_ts', 'field')]
after re-set to 30: [{'name': '_ts_ttl', 'index_type': 'ttl', 'fields': ['_ts'], 'unique': False, 'expire_after_seconds': 2592000}]
Los valores numéricos de _ts nunca se borran. La limpieza de TTL solo mira los valores de índice de tipo fecha. El código explica por qué: si el límite inferior del rango no estuviera acotado, todos los documentos con un campo numérico created_at se borrarían independientemente de su caducidad. En OxiDB, una cadena en formato ISO 8601 / RFC 3339 se almacena en el índice como fecha, y un número como número. Pero el propio MsgpackLogger del servidor escribe _ts como milisegundos epoch, es decir, como número. Lo probé: envié a la entrada MessagePack tres registros con fecha de hace 10 días, uno con _ts en milisegundos epoch, otro con _ts como cadena ISO y otro sin _ts. Después esperé unos segundos a que se ejecutara el TTL por defecto de 7 días:
{"cmd": "find", "collection": "_msgpack_logs", "query": {"short_message": {"$in": ["old, epoch-ms _ts", "old, ISO-8601 _ts", "no _ts at all"]}}}{
"ok": true,
"data": [
{"short_message": "no _ts at all", "_id": 5, "_version": 1},
{"short_message": "old, epoch-ms _ts", "_ts": 1790890365335, "_id": 4, "_version": 1}
]
}Solo se borró el de la cadena ISO. Así que en la 0.44.2 el TTL por defecto de 7 días sobre _msgpack_logs nunca borra los registros con _ts numérico, como el propio log de peticiones REST de OxiDB, y la entrada MessagePack tampoco pone marca a los registros que no tienen _ts. Si se envía MessagePack desde una aplicación propia, conviene escribir _ts como cadena ISO 8601. El trabajo por mi parte también está claro: o ampliar la limpieza de TTL para que cubra valores numéricos en milisegundos epoch tras una opción explícita, o hacer que el logger y la entrada escriban _ts como fecha.
Alertas
Las reglas de alerta son documentos de la colección _alerts. En segundo plano, un hilo oxidb-alerts por base de datos se despierta cada OXIDB_ALERT_INTERVAL segundos, lee las reglas con enabled: true y evalúa cada una. Hay dos tipos de condición:
count_threshold: se añade una condición_ts >= now - windowal filtroqueryde la regla y se ejecuta uncount. El resultado se compara conthresholdusandooperator(gt,gte,lt,lte,eq,ne; por defectogte).aggregation_threshold: se antepone una etapa{"$match": {"_ts": {"$gte": ...}}}alpipelinede la regla, se ejecuta la agregación y elresult_field(por defectocount) del primer documento resultante se compara con el umbral.
window se escribe como "30s", "5m", "1h" y por defecto vale 5 minutos. Cuando se cumple la condición, se ejecutan las acciones: webhook (un HTTP POST con cuerpo JSON, fire-and-forget en su propio hilo para no bloquear al evaluador), stderr (una línea [ALERT] en el log del servidor) y log. Sean cuales sean las acciones configuradas, se escribe un registro en _alert_history y se actualizan los campos last_fired, last_fired_epoch y fire_count de la regla.
El cooldown se apoya en esos campos: si now < last_fired_epoch + cooldown_seconds, la regla ni siquiera se evalúa. El valor por defecto es de 300 segundos.
Una ejecución real: un receptor de webhooks local
Levanté un pequeño servidor HTTP en Python en 127.0.0.1:15906 que imprime cada POST con una marca de tiempo:
import http.server, datetime
class H(http.server.BaseHTTPRequestHandler):
    def do_POST(self):
        n = int(self.headers.get("Content-Length", 0)); body = self.rfile.read(n)
        t = datetime.datetime.now().strftime("%H:%M:%S")
        print(f"[{t}] POST {self.path}  {body.decode()}", flush=True)
        self.send_response(204); self.end_headers()
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 15906), H).serve_forever()
Después definí dos reglas, una de umbral de conteo y otra de umbral de agregación:
{"cmd": "create_alert", "name": "error-burst", "collection": "_gelf_logs",
 "condition": {"type": "count_threshold", "query": {"level": {"$lte": 3}}, "window": "1m", "threshold": 5, "operator": "gte"},
 "actions": [{"type": "webhook", "url": "http://127.0.0.1:15906/alerts"}, {"type": "stderr"}],
 "cooldown_seconds": 20}
{"ok": true, "data": "alert created: error-burst"}{"cmd": "create_alert", "name": "slow-requests", "collection": "_gelf_logs",
"condition": {"type": "aggregation_threshold", "window": "1m",
"pipeline": [{"$match": {"latency_ms": {"$gte": 500}}}, {"$group": {"_id": null, "n": {"$sum": 1}}}],
"result_field": "n", "threshold": 3, "operator": "gte"},
"actions": [{"type": "webhook", "url": "http://127.0.0.1:15906/alerts/slow"}],
"cooldown_seconds": 60}{"ok": true, "data": "alert created: slow-requests"}test_alert evalúa una regla de inmediato, sin ejecutar acciones e ignorando el cooldown:
{"cmd": "test_alert", "name": "error-burst"}{
"ok": true,
"data": {
"alert": "error-burst",
"type": "count_threshold",
"current_value": 0,
"threshold": 5,
"operator": "gte",
"would_fire": false
}
}Sin embargo, todavía no admite reglas de agregación:
{"cmd": "test_alert", "name": "slow-requests"}{"ok": true, "data": {"alert": "slow-requests", "error": "unsupported condition type: aggregation_threshold"}}Después reproduje un escenario de tráfico por GELF (hora local):
[00:33:40] send 6 errors + 4 slow requests (latency >= 500 ms)
[00:33:46] send 3 more errors (still inside the 20 s cooldown)
[00:34:10] cooldown over; window still holds >= 5 errors
[00:34:20] done
Lo que vio el receptor de webhooks:
[00:33:41] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:33:41Z","fired_at_epoch":1791754421,"condition_result":6,"threshold":5,"operator":"gte"}
[00:33:41] POST /alerts/slow  {"alert_name":"slow-requests","collection":"_gelf_logs","fired_at":"2026-10-11T21:33:41Z","fired_at_epoch":1791754421,"condition_result":4,"threshold":3,"operator":"gte"}
[00:34:01] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:34:01Z","fired_at_epoch":1791754441,"condition_result":9,"threshold":5,"operator":"gte"}
[00:34:21] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:34:21Z","fired_at_epoch":1791754461,"condition_result":9,"threshold":5,"operator":"gte"}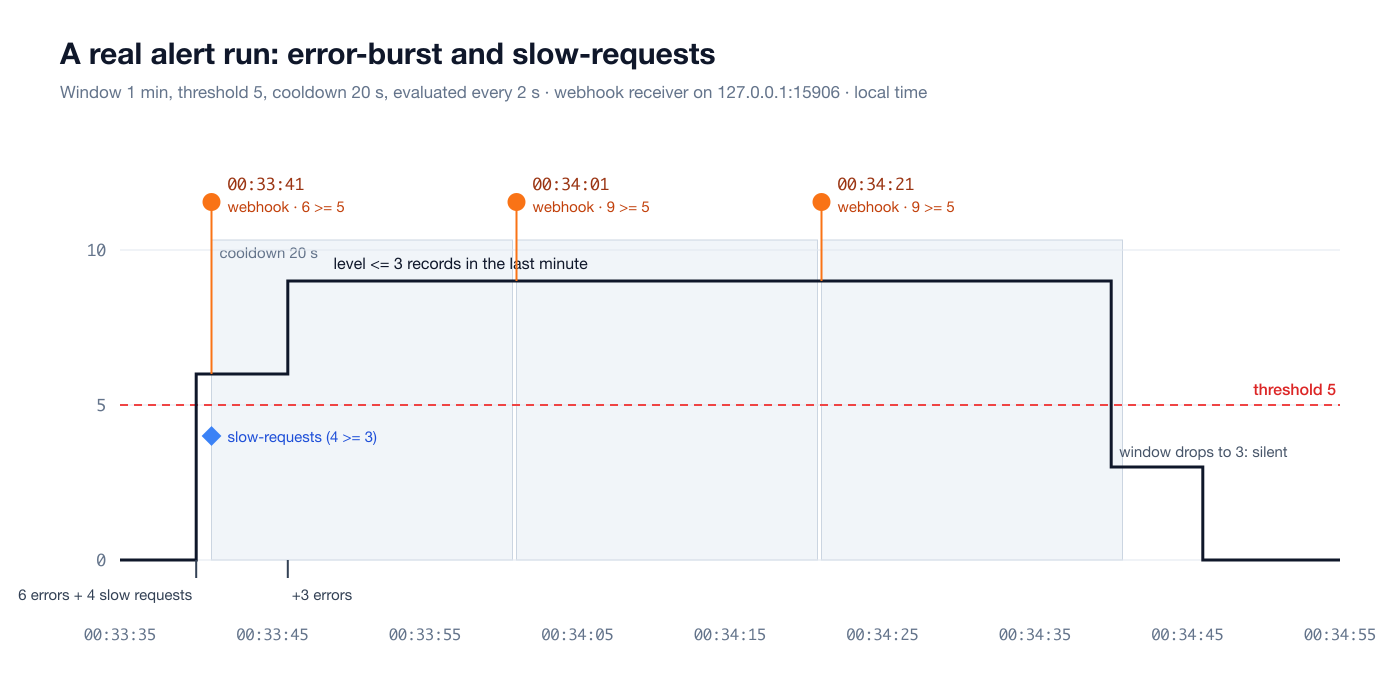
Aquí se ven varias cosas:
- El primer disparo llegó un segundo después de los paquetes, consecuencia del intervalo de evaluación de 2 segundos.
- Los tres errores adicionales de las 00:33:46 no produjeron una notificación nueva, porque la regla estaba en su cooldown.
- Mientras la condición siga siendo cierta, la regla vuelve a dispararse al final de cada cooldown: 00:34:01 y 00:34:21. Así que no es una alerta disparada por flanco; sigue recordándolo mientras dura la condición. Cuando los errores salieron de la ventana de 1 minuto a las 00:34:40, el conteo bajó a 3 y la regla se calló. No hay notificación de "resuelto".
- Cada disparo también dejó una línea
[ALERT] error-burst: _gelf_logs ...en el stderr del servidor.
El historial es una colección consultable:
{"cmd": "list_alert_history"}{
"ok": true,
"data": [
{
"alert_name": "error-burst",
"collection": "_gelf_logs",
"fired_at": "2026-10-11T21:33:41Z",
"fired_at_epoch": 1791754421,
"condition_result": 6,
"threshold": 5,
"operator": "gte",
"actions_executed": ["webhook", "stderr"],
"_ts": "2026-10-11T21:33:41Z",
"_id": 1,
"_version": 1
},
{
"alert_name": "slow-requests",
"collection": "_gelf_logs",
"fired_at": "2026-10-11T21:33:41Z",
"fired_at_epoch": 1791754421,
"condition_result": 4,
"threshold": 3,
"operator": "gte",
"actions_executed": ["webhook"],
"_ts": "2026-10-11T21:33:41Z",
"_id": 2,
"_version": 1
}
]
}(Los dos primeros de cuatro registros; los otros dos son los disparos de las 00:34:01 y las 00:34:21.) El estado propio de la regla también se actualizó:
{'name': 'error-burst', 'enabled': True, 'cooldown_seconds': 20, 'fire_count': 3, 'last_fired': '2026-10-11T21:34:21Z', 'last_fired_epoch': 1791754461}Como _alert_history y _alerts son colecciones normales, se les puede poner set_retention e incluso crear alertas sobre ellas. No hay un comando específico para activar o desactivar una regla; cambié enabled con un update normal sobre la colección _alerts:
{"cmd": "update", "collection": "_alerts", "query": {"name": {"$in": ["error-burst", "slow-requests"]}}, "update": {"$set": {"enabled": false}}}{"ok": true, "data": {"modified": 2}}Límites en el lado de las alertas
También los vi en pruebas reales:
- Los nombres de host no funcionan en las URL de webhook. El parser de URL acepta
http://localhost:15906/..., pero la conexión se hace parseando el textohost:portcomo dirección de socket, lo que no hace ninguna resolución DNS. Cuando se disparó una regla con una URLlocalhost, no llegó nada al receptor, y aun así el registro de_alert_historydecía"actions_executed": ["webhook"]. Los fallos de webhook son silenciosos; por ahora hay que usar una dirección IP en la URL. - Solo
http://. Sin TLS. Enviar un webhook a un servicio externo requiere un relay local entre medias. - No se lee la respuesta y no hay reintentos. Se escribe la petición y se cierra la conexión; si el receptor está caído en ese momento, la notificación se pierde (y el historial sigue diciendo "webhook").
- Los umbrales son enteros. El resultado de la agregación se lee con
as_i64. Con una latencia media de 300,5 ms, una reglaavg > 100nunca se disparó (fire_count: 0), mientras que los resultados que salen enteros de$sumfuncionaron bien. Para resultados fraccionarios, de momento hay que redondear en el pipeline. - La ventana se basa en
_ts. La ventana de la alerta compara_tscon un límite en cadena ISO. Los registros GELF y de UDP en bruto llevan una cadena de fecha en_ts, así que no hay problema, pero los registros MessagePack con_tsnumérico nunca entran en la ventana. Lo probé: para una regla que contabastatus: 503sobre_msgpack_logs,test_alertdevolvió"current_value": 0tras un registro con_tsen milisegundos epoch, y"current_value": 1cuando envié el mismo registro con_tscomo cadena ISO.
Todo esto tiene arreglo y está en mi lista. Pero, tal como está, el motor de alertas funciona bien para tareas del tipo "tantos errores en los últimos N minutos".
oxidb-tail: logs en directo en la terminal
oxidb-tail es una interfaz de terminal (ratatui + crossterm) que se conecta a OxiDB mediante el protocolo de red. Sus dependencias son ligeras, así que compila rápido; una compilación release limpia tardó 15,45 segundos en mi máquina:
cargo build --release -p oxidb-tail
./target/release/oxidb-tail --host 127.0.0.1 --port 15900
Mientras estaba en marcha envié un flujo de 60 mensajes por GELF; esta es la pantalla que capturé dentro de tmux:
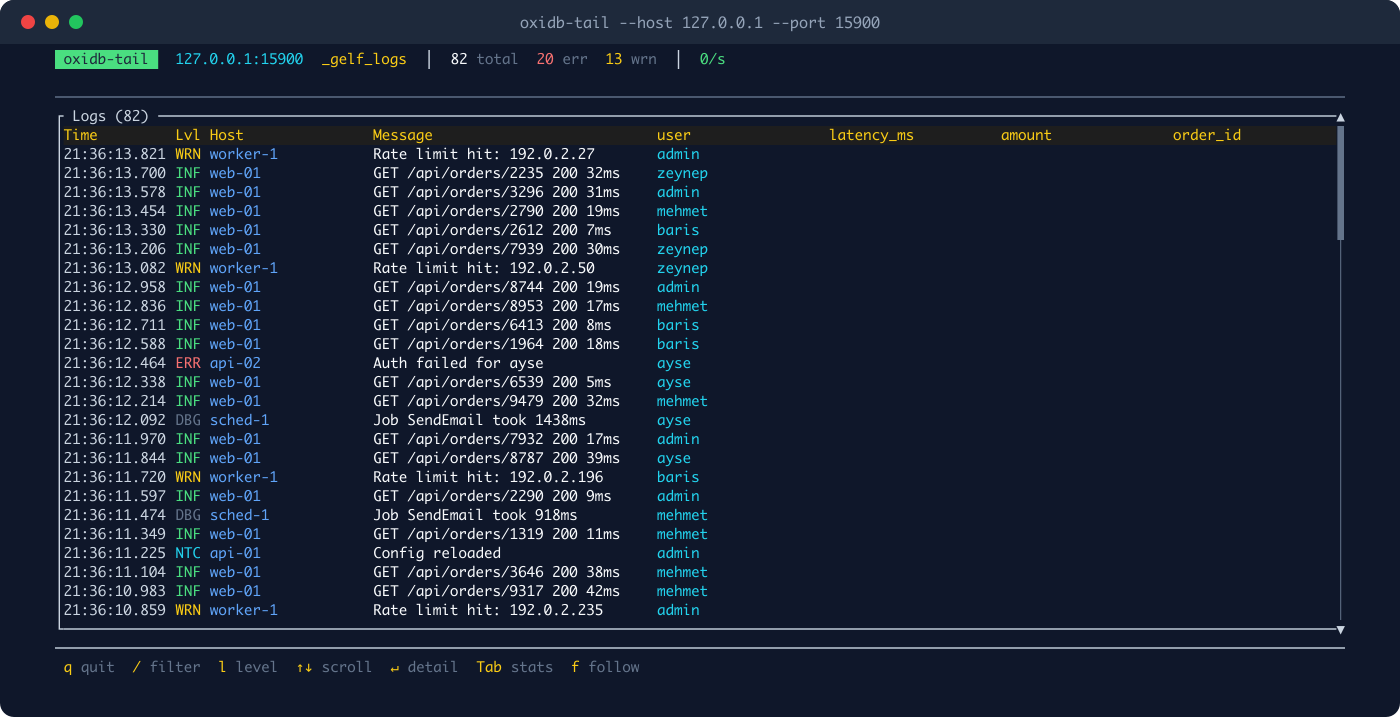
Su funcionamiento es sencillo: cada --interval milisegundos (500 por defecto) envía {"_id": {"$gt": last_id}} a la colección y obtiene hasta 200 registros ordenados por _id. Los niveles se colorean según el nivel de syslog: 0-3 rojo, 4 amarillo, 5 cian, 6 verde, 7 gris. Elige como columnas los campos adicionales más comunes del primer lote y los fija. Hay un filtro de texto con /, un filtro de nivel con l, todos los campos del registro seleccionado con Enter y un panel lateral con la distribución por host con Tab.
Para ser honesto también aquí, hay dos pequeñas rarezas. Como las columnas se fijan a partir del primer lote, la pantalla muestra columnas como latency_ms, amount y order_id que están vacías para este flujo, mientras que client_ip no aparece. En segundo lugar, la carga inicial toma los primeros 100 registros en orden ascendente de _id, así que con una colección muy grande empieza por los más antiguos y tarda un rato en ponerse al día. La columna de hora se lee de _ts, así que en colecciones MessagePack con _ts numérico muestra ??:??:??. Como su nombre indica, la herramienta se escribió para colecciones GELF.
El servidor escribiendo sus propios logs en sí mismo
La historia tiene un final simpático: OxiDB no solo recibe logs, también puede enviar sus propios logs a algún sitio como GELF o MessagePack. Con OXIDB_GELF_ADDR definido, los eventos de conexión del protocolo de red y los mensajes del servidor van allí; con OXIDB_MSGPACK_ADDR definido, va el log de peticiones de la capa REST. El destino puede ser el propio servidor. Reinicié el servidor apuntando a sus propios puertos (antes y después del reinicio, _gelf_logs tenía 199.868 registros y _msgpack_logs 250.005; no se perdió nada):
OXIDB_GELF_ADDR=127.0.0.1:15908 OXIDB_MSGPACK_ADDR=127.0.0.1:15909 HOSTNAME=oxidb-demo ...Tras abrir y cerrar una conexión del protocolo de red, _gelf_logs contenía:
{
 "host": "oxidb-demo",
 "short_message": "client connected: 127.0.0.1:50139",
 "timestamp": 1791754653.456128,
 "level": 6,
 "peer": "127.0.0.1:50139",
 "_ts": "2026-10-11T21:37:33.462529+00:00",
 "_id": 199869,
 "_version": 1
}
Con REST también activado (OXIDB_HTTP_PORT) y dos peticiones curl, _msgpack_logs contenía:
{
 "host": "oxidb-demo",
 "short_message": "GET /api/collections",
 "level": 6,
 "ts": 1791754676.108999,
 "_ts": 1791754676108,
 "app": "oxidb-server",
 "method": "GET",
 "path": "/api/collections",
 "status": "200",
 "ms": "0",
 "db": "",
 "user_agent": "curl/8.7.1",
 "_id": 250008,
 "_version": 1
}
La petición que devolvió 404 se escribió con level: 4 (warning). El campo db es el que alimenta el enrutamiento por tenant descrito más arriba. Y, como se ve, aquí _ts es numérico; aquí es exactamente donde el defecto de la retención muerde en la práctica.
Cómo encaja con el resto de OxiDB
El motor de logs no es un motor de almacenamiento aparte. Son entradas colocadas delante del motor de documentos y dos hilos en segundo plano detrás de él. Como resultado:
- Todas las funciones de consulta y agregación del motor de documentos funcionan sobre los logs. Si se quiere búsqueda de texto sobre los mensajes de error, basta con añadir un índice de texto completo a la colección.
- La durabilidad es la del motor de documentos: WAL, CRC32, fsync. No vi pérdida de registros entre reinicios. UDP en sí, sin embargo, no garantiza la entrega; un paquete que nunca llega al servidor, o que se descarta porque el canal está lleno, no deja rastro en ninguna parte.
- Para datos numéricos y espaciados regularmente, como las métricas, el motor de series temporales encaja mejor, con compresión y retención por bloques. El motor de logs es para registros irregulares, estructurados y con mucho texto.
- El ADR de estabilidad 1.0 del proyecto (ADR-0003) mantiene la entrada GELF y los índices TTL en el grupo que "funciona y se distribuye, pero una versión menor 1.x puede cambiar la forma de una petición o respuesta". Así que esta superficie todavía no está bajo una promesa de compatibilidad hacia atrás, lo que me deja margen para cambiar el comportamiento mientras corrijo los defectos anteriores.
Resumen y cómo probarlo
La entrada GELF ofrece "apunta la aplicación a OxiDB en lugar de a Graylog y obtén todos los campos indexados"; el precio es un índice por campo y posibles pérdidas de paquetes cuando llega por primera vez un campo nuevo. La entrada MessagePack hace menos a propósito: sin índices, paquetes más pequeños, más resistente a las ráfagas. La retención es una fina capa sobre la maquinaria de TTL del motor de documentos, y las alertas son documentos de la colección _alerts evaluados en segundo plano. Todo en un solo proceso, sin montar un servicio aparte.
Los defectos que encontré al preparar este artículo (el TTL que no sigue un cambio de retención, los registros con _ts numérico que nunca caducan, los webhooks a localhost que fallan en silencio, los resultados de agregación fraccionarios que nunca disparan alertas, test_alert sin soporte para reglas de agregación y la pérdida de paquetes GELF con campos nuevos) están en la lista de trabajo de las próximas versiones.
Si se quiere probar, hay binarios precompilados en la página de releases de GitHub, y se puede construir una imagen Docker a partir del Dockerfile del repositorio. El camino más corto:
OXIDB_GELF_PORT=12201 OXIDB_MSGPACK_PORT=12202 ./oxidb-serverDespués basta con apuntar el logger GELF de la aplicación a UDP 12201 (con la compresión desactivada) y observar con oxidb-tail --host 127.0.0.1 --port 4444. En el próximo artículo de la serie trato el motor de ledger.