OxiMem en OxiDB: un almacén clave-valor en memoria que habla el protocolo de Redis
Construí dentro de OxiDB una capa clave-valor que habla RESP: cinco tipos de datos, TTL, pub/sub, WATCH, Lua y snapshots. Sesiones reales con redis-cli y redis-py, mediciones frente a Redis 8.6 y los límites honestos.
Los datos de una aplicación no son todos del mismo tipo. Los pedidos, los registros de usuarios y las publicaciones no se pueden perder, así que van al motor de documentos o al motor SQL: al WAL, a esperar el fsync, de vuelta tras un fallo. Pero toda aplicación tiene también un borde caliente: tokens de sesión, contadores de visitas, ventanas de limitación de tasa, colas de trabajos de vida corta, HTML en caché. Estos datos cambian cientos de veces por segundo y, si desaparecen, nadie sale perjudicado. Hacerlos pasar por la maquinaria de durabilidad es un desperdicio. Normalmente aquí es donde se coloca un Redis junto a la base de datos. En OxiDB hice otra cosa: construí una capa clave-valor en memoria llamada OxiMem dentro del mismo proceso y le hice hablar RESP, el protocolo de red de Redis. El resultado es que clientes estándar como redis-cli, redis-py, go-redis y node-redis se conectan directamente a OxiDB.
Este artículo cubre OxiMem de principio a fin: cómo activarlo, qué tipos de datos y comandos admite, la expiración, pub/sub, MULTI/EXEC/WATCH, los scripts Lua, las opciones de persistencia, cómo funciona por dentro, el rendimiento y la memoria que medí frente a Redis y, igual de importante, en qué se diferencia de Redis. Todas las salidas que aparecen a continuación provienen de un servidor OxiDB 0.44.2 que ejecuté en mi propia máquina (Apple M4, macOS 26.3).
Una cosa más: el blog que estás leyendo también usa OxiMem. Está en www.baltavista.com, su servidor está escrito en Rill (mi propio lenguaje) y sus datos están en OxiDB: las publicaciones y las etiquetas en el lado SQL y de documentos, las imágenes en la capa S3, y el contador de visitas en vivo al pie de esta página es un INCR en OxiMem. Volveré a ello al final.
¿Por qué RESP?
La parte fácil de escribir un almacén en memoria es el almacén. La parte difícil es conectarlo con el mundo: bibliotecas cliente, pools de conexiones, herramientas de línea de comandos, integraciones con frameworks. Un protocolo propio habría significado reconstruir todo eso. Hablar RESP proporciona todo el ecosistema gratis.
RESP en sí es agradablemente pequeño. El primer byte de cada mensaje indica su tipo: + cadena simple, - error, : entero, $ cadena bulk con prefijo de longitud, * array. Un comando del cliente es siempre un array de cadenas bulk. En la red, GET session:42 tiene este aspecto:
*2\r\n$3\r\nGET\r\n$10\r\nsession:42\r\nLos prefijos de longitud resuelven el framing, pero también abren una superficie de ataque: la longitud la elige el cliente. Por eso el parser de OxiMem rechaza cualquier cabecera de cadena bulk o de array por encima de 16 MiB antes de reservar un solo byte (MAX_RESP_BULK_LEN en resp.rs).
Activarlo: una variable de entorno
OxiMem está desactivado por defecto. Basta con darle un puerto:
OXIDB_ADDR=127.0.0.1:15600 \
OXIDB_DATA=./data \
OXIDB_OXIMEM_PORT=15602 \
./oxidb-server
Al arrancar, el servidor imprime:
oxidb-server listening on 127.0.0.1:15600 (pool_size=4, data_dir=./data, idle_timeout=0s)
OxiMem RESP listening on 0.0.0.0:15602 (fast mode)
Hay dos cosas que destacar. Primero, la dirección es 0.0.0.0: el listener de OxiMem se enlaza a todas las interfaces independientemente de OXIDB_ADDR. La sección de seguridad más abajo explica por qué esto importa. Segundo, fast mode: por defecto OxiMem funciona puramente en memoria. Las otras opciones (snapshots y el espejo de documentos) están en la sección de persistencia. Si se pasa auto en lugar de un puerto, el kernel elige uno libre y una línea oximem=<port> aparece en el OXIDB_READY_FILE; así es como mis tests arrancan servidores.
OxiMem cuenta como un listener respaldado por documentos, de modo que un servidor arrancado con OXIDB_DOC=0 (motor de documentos desactivado) se niega a arrancar si OXIDB_OXIMEM_PORT está definido, y explica por qué.
No hace falta instalar nada para conectarse; el redis-cli de siempre funciona:
$ redis-cli -p 15602 PING
PONG
Tipos de datos
OxiMem admite los cinco tipos fundamentales de Redis: strings, hashes, listas, sets y sorted sets. Además están los comandos GEO (construidos sobre sorted sets, como en Redis) y las operaciones de bits sobre strings.
Strings y contadores
El caso más simple: una clave y un valor.
127.0.0.1:15602> SET user:42:name "Ayse"
OK
127.0.0.1:15602> GET user:42:name
"Ayse"
127.0.0.1:15602> APPEND user:42:name " Y."
(integer) 7
127.0.0.1:15602> SETNX user:42:name "Other"
(integer) 0
127.0.0.1:15602> GETRANGE user:42:name 0 3
"Ayse"
127.0.0.1:15602> MSET a 1 b 2 c 3
OK
127.0.0.1:15602> MGET a b c missing
1) "1"
2) "2"
3) "3"
4) (nil)
127.0.0.1:15602> GETDEL user:42:name
"Ayse Y."
127.0.0.1:15602> GET user:42:name
(nil)
Los contadores son la cara más útil de un almacén clave-valor, porque hacen lectura-modificación-escritura en un único comando atómico. Dos peticiones concurrentes no pueden tragarse el incremento de la otra:
127.0.0.1:15602> INCR page:views
(integer) 1
127.0.0.1:15602> INCRBY page:views 10
(integer) 11
127.0.0.1:15602> DECR page:views
(integer) 10
127.0.0.1:15602> INCRBYFLOAT price 2.5
"2.5"
127.0.0.1:15602> SET counter abc
OK
127.0.0.1:15602> INCR counter
(error) ERR value is not an integer or out of range
127.0.0.1:15602> SETBIT flags 7 1
(integer) 0
127.0.0.1:15602> BITCOUNT flags
(integer) 1
Los valores son bytes y STRLEN cuenta bytes, como en Redis. Escribir "Ayşe" desde redis-py dio un STRLEN de 5, porque "ş" ocupa dos bytes en UTF-8.
Hashes
Los campos de un objeto bajo una sola clave, con incrementos atómicos por campo:
127.0.0.1:15602> HSET user:42 name Ayse city Izmir visits 0
(integer) 3
127.0.0.1:15602> HINCRBY user:42 visits 1
(integer) 1
127.0.0.1:15602> HGETALL user:42
1) "city"
2) "Izmir"
3) "visits"
4) "1"
5) "name"
6) "Ayse"
127.0.0.1:15602> HEXISTS user:42 email
(integer) 0
127.0.0.1:15602> TYPE user:42
hash
El orden de los campos no es el orden de inserción: por dentro un hash es un HashMap y el orden no está garantizado (tampoco lo está en Redis).
Listas
Están respaldadas por un VecDeque, así que las inserciones y extracciones en ambos extremos son O(1). Se inserta por la derecha, se extrae por la izquierda y se obtiene una cola FIFO:
127.0.0.1:15602> RPUSH jobs job-1 job-2 job-3
(integer) 3
127.0.0.1:15602> LPUSH jobs job-0
(integer) 4
127.0.0.1:15602> LRANGE jobs 0 -1
1) "job-0"
2) "job-1"
3) "job-2"
4) "job-3"
127.0.0.1:15602> LPOP jobs
"job-0"
127.0.0.1:15602> LMOVE jobs done LEFT RIGHT
"job-1"
127.0.0.1:15602> LRANGE done 0 -1
1) "job-1"
También existen las variantes bloqueantes: BLPOP, BRPOP, BZPOPMIN, BLMOVE, BRPOPLPUSH. Con un cliente esperando en BLPOP queue 5 sobre una lista vacía y otro cliente haciendo RPUSH queue job-42 un segundo después, medí:
1) "queue"
2) "job-42"
waited 0.98s
En una lista que sigue vacía devuelve (nil) cuando se agota el timeout (una espera de 1 segundo tardó 1,02 s). Los que esperan duermen sobre un Condvar; cada escritura en una lista o un sorted set, como LPUSH, RPUSH o ZADD, lo señaliza.
Sets
Pertenencia, intersección, unión:
127.0.0.1:15602> SADD online 42 77 91
(integer) 3
127.0.0.1:15602> SISMEMBER online 77
(integer) 1
127.0.0.1:15602> SMISMEMBER online 42 13
1) (integer) 1
2) (integer) 0
127.0.0.1:15602> SADD admins 42 5
(integer) 2
127.0.0.1:15602> SINTER online admins
1) "42"
127.0.0.1:15602> SUNION online admins
1) "42"
2) "5"
3) "77"
4) "91"
Sorted sets
Tablas de clasificación, colas de prioridad, libros de órdenes. Por dentro hay dos estructuras: un HashMap de miembro a puntuación (ZSCORE en O(1)) y un BTreeSet de pares (score, member) (consultas de rango ordenadas). Las puntuaciones son f64, ordenadas con total_cmp, de modo que ni siquiera un NaN puede corromper el árbol.
127.0.0.1:15602> ZADD scores 1500 ayse 1800 mehmet 1200 zeynep
(integer) 3
127.0.0.1:15602> ZINCRBY scores 400 zeynep
"1600"
127.0.0.1:15602> ZREVRANGE scores 0 2 WITHSCORES
1) "mehmet"
2) "1800"
3) "zeynep"
4) "1600"
5) "ayse"
6) "1500"
127.0.0.1:15602> ZRANGEBYSCORE scores 1550 +inf
1) "zeynep"
2) "mehmet"
127.0.0.1:15602> ZPOPMAX scores
1) "mehmet"
2) "1800"
Los comandos GEO se construyen sobre sorted sets, igual que en Redis, y TYPE informa zset:
127.0.0.1:15602> GEOADD cities 27.1428 38.4237 izmir 28.9784 41.0082 istanbul 32.8597 39.9334 ankara
(integer) 3
127.0.0.1:15602> GEODIST cities izmir istanbul km
"327.4546"
127.0.0.1:15602> GEOSEARCH cities FROMMEMBER izmir BYRADIUS 400 km ASC
1) "izmir"
2) "istanbul"
127.0.0.1:15602> TYPE cities
zset
Para trabajo espacial serio (polígonos, índices) véase el artículo sobre las consultas geoespaciales y de grafos de OxiDB; los comandos GEO de aquí existen por compatibilidad con Redis.
Expiración
Lo más característico de una capa clave-valor es que los datos pueden morir por sí solos. No se escribe un trabajo de limpieza para los tokens de sesión; se les da un tiempo de vida:
127.0.0.1:15602> SETEX session:abc 900 "user=42"
OK
127.0.0.1:15602> TTL session:abc
(integer) 900
127.0.0.1:15602> SET session:xyz "user=7" PX 1500
OK
127.0.0.1:15602> PTTL session:xyz
(integer) 1995
127.0.0.1:15602> EXPIRE user:42 2
(integer) 1
127.0.0.1:15602> PERSIST session:abc
(integer) 1
127.0.0.1:15602> TTL session:abc
(integer) -1
127.0.0.1:15602> TTL no:such:key
(integer) -2
Dos segundos y medio después:
127.0.0.1:15602> GET session:xyz
(nil)
127.0.0.1:15602> EXISTS user:42
(integer) 0
Aquí hay dos detalles. Primero, user:42 es un hash, y también expiró. En versiones anteriores el plazo era un campo de la entrada de string, así que el TTL funcionaba silenciosamente solo con strings. Lo corregí en la 0.43.2: los plazos viven ahora en un mapa expires separado, indexado por nombre, y se aplican a los cinco tipos de la misma manera. Redis hace la misma separación (un dict expires aparte junto al keyspace).
Segundo, PTTL session:xyz devolvió 1995, no 1500. SET ... PX redondea los milisegundos hacia arriba a segundos enteros (ms.div_ceil(1000)), así que 1,5 s se convierten en 2 s. PEXPIRE tiene precisión de milisegundos en el código. Si se depende de tiempos de vida con precisión de milisegundos, hay que saberlo.
El mecanismo tiene dos capas:
- Expiración perezosa: antes de que se ejecute un comando, se comprueban las claves que va a tocar, y una que haya expirado se borra en el acto. Nunca se ve un valor expirado. Cuando nada en el almacén tiene plazo, esta comprobación cuesta un único read lock sin contención.
- Hilo barredor: para que las claves que nadie lee no se queden en memoria para siempre, un hilo se despierta cada segundo y borra en bloque las claves expiradas. Para cada una incrementa el contador de versión de WATCH y, si está activado, publica una notificación
expired.
Notificaciones de keyspace
Se activan con CONFIG SET notify-keyspace-events. Cuando están activas, cada escritura publica en __keyspace@0__:<key> y __keyevent@0__:<event> a través del pub/sub existente. Con un cliente escuchando en PSUBSCRIBE '__key*__:*', ejecuté SET k1 v EX 1 e INCR views:demo; un segundo después el barredor eliminó k1:
1) "pmessage"
2) "__key*__:*"
3) "__keyspace@0__:k1"
4) "set"
...
1) "pmessage"
2) "__key*__:*"
3) "__keyspace@0__:views:demo"
4) "incr"
...
1) "pmessage"
2) "__key*__:*"
3) "__keyevent@0__:expired"
4) "k1"
Una diferencia con Redis: OxiMem no distingue clases de eventos (K, E, g, x...). Cualquier valor no vacío activa las notificaciones por completo; un valor vacío las desactiva.
Pub/Sub
Se admiten SUBSCRIBE, PSUBSCRIBE (patrones glob) y PUBLISH. Con un suscriptor en SUBSCRIBE news y otro en PSUBSCRIBE 'price.*':
127.0.0.1:15602> PUBLISH price.BTC 68500
(integer) 1
127.0.0.1:15602> PUBLISH news "hello"
(integer) 1
127.0.0.1:15602> PUBLISH nobody x
(integer) 0
Lo que vio el suscriptor por patrón:
1) "pmessage"
2) "price.*"
3) "price.BTC"
4) "68500"
El número que devuelve PUBLISH es cuántos suscriptores recibieron el mensaje; 0 si nadie escucha. Es "disparar y olvidar": un suscriptor que no está conectado en ese momento se lo pierde. Para colas duraderas, OxiDB tiene su capa MQTT y AMQP.
Un efecto secundario agradable: el broker MQTT de OxiDB funciona sobre el mismo pub/sub de OxiMemStore. Así, un cliente Redis puede recibir un mensaje publicado por MQTT. Con redis-cli SUBSCRIBE sensors/temp abierto, ejecuté mosquitto_pub -p 15603 -t sensors/temp -m 21.5:
1) "subscribe"
2) "sensors/temp"
3) (integer) 1
1) "message"
2) "sensors/temp"
3) "21.5"
Un dispositivo IoT publica lecturas por MQTT, un servidor web escucha con redis-py y no hay ningún software puente entre ambos.
MULTI, EXEC y WATCH
MULTI abre una cola; los comandos siguientes no se ejecutan, sino que se acumulan con QUEUED. Con EXEC se ejecutan todos seguidos, sin ninguna otra transacción en medio:
127.0.0.1:15602> MULTI
OK
127.0.0.1:15602> SET counter 5
QUEUED
127.0.0.1:15602> INCRBY counter 10
QUEUED
127.0.0.1:15602> EXEC
1) OK
2) (integer) 15
Redis obtiene este aislamiento gratis por ser monohilo. OxiMem es multihilo, así que compra el aislamiento de forma explícita: EXEC toma el tx_lock del almacén y lo mantiene solo mientras vacía su propia cola. Dos bloques EXEC nunca pueden intercalarse.
Los comandos también se validan al encolarse. Un comando desconocido o un argumento que falta envenena la transacción, y EXEC se niega sin ejecutar nada:
127.0.0.1:15602> MULTI
OK
127.0.0.1:15602> SET z 1
QUEUED
127.0.0.1:15602> NOPE z
(error) ERR unknown command 'NOPE'
127.0.0.1:15602> GET z
QUEUED
127.0.0.1:15602> EXEC
(error) ERR EXECABORT Transaction discarded because of previous errors.
127.0.0.1:15602> GET z
(nil)
SET z 1 nunca se ejecutó. Una transacción con una errata no toca los datos.
WATCH: bloqueo optimista
MULTI/EXEC da atomicidad, pero no responde a "¿sigue siendo válido el valor que leí?". Una lógica como "leer el saldo y cargar si es suficiente" está expuesta a una actualización perdida cuando alguien escribe entre la lectura y la escritura. Para eso está WATCH: si una clave vigilada cambió antes de EXEC, la transacción no se ejecuta y EXEC devuelve un array nulo. Con dos clientes:
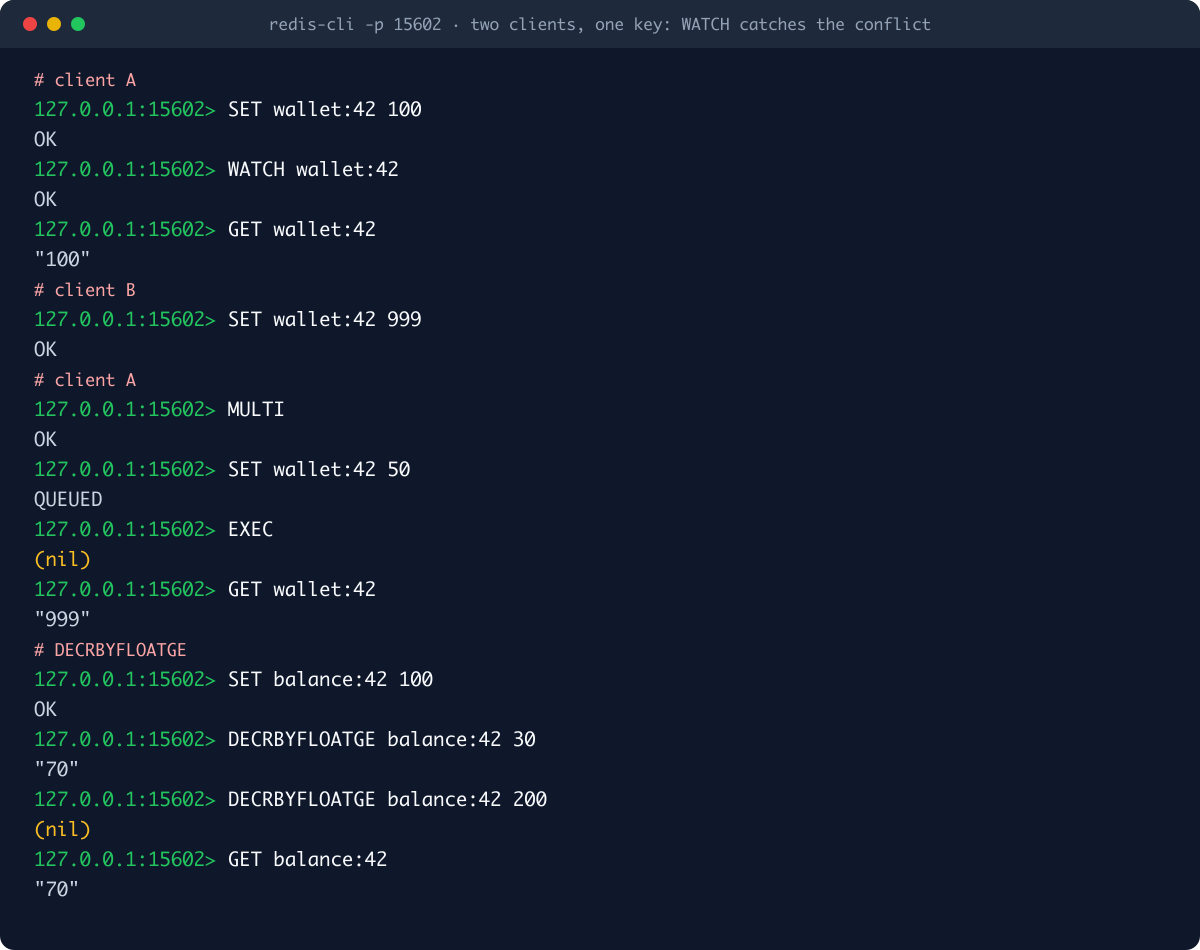
A vigiló wallet:42 y leyó 100. B intervino y escribió 999. El EXEC de A devolvió (nil), y la escritura de A nunca ocurrió.
Cómo se detecta el cambio es mi parte favorita del diseño. No se toma ninguna copia del valor; si vigilar un sorted set grande implicara copiarlo, el coste O(n) lo arruinaría todo. En su lugar, cada clave tiene un contador de mutaciones, y un snapshot de WATCH son tres números pequeños:
/// O(1) fingerprint of a key for WATCH change detection: the store epoch
/// (bumped by FLUSHALL), the key's mutation counter (bumped by every write
/// command touching it), and whether the key currently exists (so a lazy
/// TTL expiry between WATCH and EXEC still registers as a change).
type KeySnap = (u64, u64, bool);
Cada escritura con éxito incrementa los contadores de las claves que tocó. FLUSHALL incrementa un epoch global del almacén, lo que invalida todos los WATCH a la vez. El indicador de "existe" detecta una clave que expiró silenciosamente entre las dos lecturas. EXEC recalcula estas ternas bajo tx_lock y las compara.
Hay una asimetría deliberada: el contador se incrementa incluso cuando una escritura no cambia nada (al reescribir el mismo valor, por ejemplo). Así que las falsas alarmas son posibles y cuestan un reintento innecesario. Un cambio no detectado no es posible. Una falsa alarma cuesta un viaje de ida y vuelta; un cambio no detectado cuesta datos corruptos.
Para que el mapa de contadores no crezca indefinidamente, se le aplica recolección de basura: cuando supera las 100.000 entradas y ninguna sesión tiene un WATCH en ese momento, se vacía (el umbral es OXIMEM_VERSIONS_GC). Si nadie está vigilando, perder los contadores no rompe nada; el siguiente WATCH empieza de cero.
WATCH bajo contención con redis-py
También lo probé bajo carga. Dos cuentas, acct:a = 1000 y acct:b = 0. Ocho hilos, cada uno haciendo 250 operaciones de "mover 1 de a a b" con WATCH + MULTI, reintentando ante WatchError. Son 2000 intentos, pero a solo tiene 1000 unidades, así que exactamente 1000 deberían tener éxito:
def transfer(n):
    c = redis.Redis(host="127.0.0.1", port=15602, decode_responses=True, protocol=2)
    for _ in range(n):
        with c.pipeline() as p:
            while True:
                try:
                    p.watch("acct:a", "acct:b")
                    a = int(p.get("acct:a"))
                    if a < 1:
                        p.unwatch()
                        break
                    p.multi()
                    p.decrby("acct:a", 1)
                    p.incrby("acct:b", 1)
                    p.execute()
                    break
                except WatchError:
                    retries += 1   # (counter guarded by a lock)
Resultado:
after 2000 transfers: a=0 b=1000 sum=1000 watch_retries=3695La suma se conserva, nada quedó en negativo, no se perdió ninguna actualización. Los 3695 reintentos muestran lo duro que luchan ocho hilos por las mismas dos claves; ese es exactamente el precio del bloqueo optimista.
Scripts Lua: EVAL, EVALSHA, SCRIPT
Con mucha contención, el bucle de WATCH da vueltas. La alternativa es ejecutar toda la lógica de leer-decidir-escribir en el servidor en un solo paso. Integré Lua 5.4 mediante mlua; los scripts invocan comandos con redis.call y redis.pcall, y cjson está disponible.
127.0.0.1:15602> SET wallet:7 100
OK
127.0.0.1:15602> EVAL "local b = tonumber(redis.call('GET', KEYS[1]) or '0') if b >= tonumber(ARGV[1]) then return redis.call('DECRBY', KEYS[1], ARGV[1]) end return -1" 1 wallet:7 30
(integer) 70
127.0.0.1:15602> EVAL "...same script..." 1 wallet:7 500
(integer) -1
127.0.0.1:15602> SCRIPT LOAD "...same script..."
"777ac28203607bd0918ff085cb356478607980cb"
127.0.0.1:15602> EVALSHA 777ac28203607bd0918ff085cb356478607980cb 1 wallet:7 20
(integer) 50
127.0.0.1:15602> EVAL "return cjson.encode({n=redis.call('INCR', KEYS[1])})" 1 hits
"{\"n\":1}"
El modelo de concurrencia difiere del de Redis, porque aquí los scripts pueden ejecutarse en paralelo:
- Cada script toma el lado de lectura de un lock
eval_gate(muchos scripts a la vez);EXECtoma el lado de escritura y excluye a todos los scripts. - Un script bloquea las franjas (stripes), de un total de 128, a las que corresponden por hash sus claves declaradas (
KEYS), en orden. Adquirirlas en orden significa que no hay interbloqueos, y los scripts sobre claves disjuntas se ejecutan completamente en paralelo. - Tocar una clave no declarada desde dentro de un script es atómico por comando, no por script. Redis también pide a los scripts que declaren todas las claves en
KEYS; aquí esa regla decide directamente el bloqueo. - La VM de Lua se crea una vez por hilo de conexión y se reutiliza (
thread_local). Crear una VM nueva y volver a parsear el script en cadaEVALse comía la mayor parte de la latencia de liquidación que medí. - Cada 20.000 instrucciones Lua se ejecuta un hook: un script que pasa de 200 ms, o recibe un
SCRIPT KILL, se detiene.
Probé un bucle infinito: EVAL "while true do end" 0 se detuvo tras unos 200 ms y el servidor siguió sano. Pero encontré una arista áspera: el mensaje de error incluye el stack traceback multilínea de Lua, y las líneas de error simple de RESP no pueden contener saltos de línea. redis-cli no pudo parsear la respuesta e imprimió Error: Bad simple string value. La conexión sobrevive, pero es un bug y está en mi lista.
DECRBYFLOATGE: el único comando que Redis no tiene
"Cargar si el saldo es suficiente" es tan habitual que añadí un comando nativo que ni siquiera necesita Lua. DECRBYFLOATGE key amount: si el valor es mayor o igual que la cantidad, se decrementa de forma atómica y se devuelve el nuevo valor; si no, no se toca nada y vuelve nil. La mitad inferior de la imagen de terminal de arriba lo muestra: se cargan 30 de 100, se rechaza un cargo de 200 y el saldo se queda en 70. Un cargo que rompa un límite de crédito es imposible incluso con una condición de carrera. Es específico de OxiMem; desde clientes Redis estándar se invoca como comando en bruto, por ejemplo execute_command("DECRBYFLOATGE", ...).
Clientes sin modificar: redis-cli y redis-py
Todas las salidas de terminal de este artículo se obtuvieron con el redis-cli 8.6.1 estándar de Homebrew. Para Python instalé redis-py 8.1.0 con pip install redis en un venv aparte y ejecuté este script (abreviado):
import redis

r = redis.Redis(host="127.0.0.1", port=15602, decode_responses=True, protocol=2)

r.set("user:42:name", "Ayşe")
print("get:", r.get("user:42:name"), "strlen:", r.strlen("user:42:name"))
r.hset("user:42", mapping={"name": "Ayşe", "city": "İzmir"})
print("hgetall:", r.hgetall("user:42"))

pipe = r.pipeline(transaction=False)
for _ in range(1000):
    pipe.incr("views:hello")
print("pipeline last:", pipe.execute()[-1])

debit = r.register_script("""
local b = tonumber(redis.call('GET', KEYS[1]) or '0')
if b >= tonumber(ARGV[1]) then return redis.call('DECRBY', KEYS[1], ARGV[1]) end
return -1
""")
r.set("wallet:7", 100)
r.script_load(debit.script)
print("lua debit 30:", debit(keys=["wallet:7"], args=[30]),
      " debit 500:", debit(keys=["wallet:7"], args=[500]))

ps = r.pubsub()
ps.subscribe("news")
ps.get_message(timeout=1)
r.publish("news", "OxiMem says hi")
msg = ps.get_message(timeout=2)
print("pubsub:", msg["channel"], msg["data"])
Salida:
get: Ayşe strlen: 5
hgetall: {'name': 'Ayşe', 'city': 'İzmir'}
pipeline last: 1000
after 2000 transfers: a=0 b=1000 sum=1000 watch_retries=3695
lua debit 30: 70  debit 500: -1
pubsub: news OxiMem says hi
Tengo que ser honesto sobre dos cosas, porque me topé con ambas mientras escribía esto:
protocol=2es obligatorio. redis-py 8 envíaHELLO 3al conectarse por defecto, pidiendo RESP3. OxiMem solo habla RESP2 y responde con un error, y redis-py falla en lugar de recurrir a la versión anterior:redis.exceptions.ResponseError: NOPROTO unsupported protocol version. Un argumento (protocol=2) lo soluciona, pero decir "no hace falta ningún cambio" no sería cierto.register_scriptnecesita antes unscript_load. redis-py intentaEVALSHAy, ante unNoScriptError, carga el script y reintenta. El helper de errores de OxiMem anteponeERRa cada mensaje, así que la respuesta es-ERR NOSCRIPT ...y redis-py no la reconoce comoNoScriptError. El mismo prefijo aparece enERR EXECABORTyERR NOPROTO. La corrección es pequeña (sin prefijo para esos códigos) y está en mi lista.
Persistencia: tres modos
"En memoria" significa "se puede perder", y para la mayoría de los usos esa es la decisión correcta. Pero hay un término medio que dice "basta con sobrevivir a un reinicio".
1. Modo rápido (por defecto)
No va nada a disco. Cuando el proceso termina, el keyspace desaparece. Ideal para cachés y sesiones.
2. Snapshots: OXIDB_OXIMEM_SNAPSHOT_SECS
Con esta variable definida, OxiMem lee <OXIDB_DATA>/_oximem.snap al arrancar y después escribe en él el almacén completo cada N segundos. La escritura va a un archivo temporal, se le hace fsync y luego se renombra a su sitio, de modo que un fallo a mitad de escritura nunca puede corromper el snapshot anterior. El archivo es JSON plano:
{"s":[{"k":"session:s1","v":"x"},{"k":"views:hello","v":"42"}],"h":[{"k":"user:1","m":{"name":"Ayse"}}],"l":[{"k":"q","v":["a","b","c"]}],"t":[],"z":[{"k":"board","z":[["a",10.0],["b",20.0]]}],"x":[["session:s1",1791754990]]}La sección x guarda los plazos absolutos de las claves que expiran, así que el TTL restante es correcto tras un reinicio. Ejecuté el servidor con OXIDB_OXIMEM_SNAPSHOT_SECS=2, escribí unas cuantas claves, lo detuve y lo volví a arrancar:
OxiMem RESP listening on 0.0.0.0:15602 (fast mode)
OxiMem snapshot loaded
127.0.0.1:15602> GET views:hello
"42"
127.0.0.1:15602> TTL session:s1
(integer) 593
127.0.0.1:15602> LRANGE q 0 -1
1) "a"
2) "b"
3) "c"
Ahora el límite. Tras un snapshot ejecuté INCR views:hello (devolvió 43) y detuve el servidor antes de que pasaran dos segundos:
127.0.0.1:15602> INCR views:hello
(integer) 43
# server stopped and restarted
127.0.0.1:15602> GET views:hello
"42"
La ventana desde el último snapshot se pierde. No se toma un snapshot final al apagar; incluso un kill normal (SIGTERM) pierde esa ventana. Tampoco hay un log de comandos como el AOF de Redis. Así que este modo sirve para "sobrevivir casi siempre a un reinicio", no para "no perder nunca una escritura".
3. El espejo de documentos: OXIDB_OXIMEM_SQL
El nombre es histórico. Con este modo activado (OXIDB_OXIMEM_SQL=1), cada escritura se replica también en las colecciones _kv, _hash, _list, _set y _zset del motor de documentos, y al arrancar la memoria se reconstruye a partir de esas colecciones. El servidor anuncia el modo:
OxiMem RESP listening on 0.0.0.0:15602 (SQL mirroring)Tras escribir unas cuantas claves, miré las colecciones con el propio cliente Python de OxiDB (protocolo nativo, puerto 15600):
_kv {"_key": "session:abc", "_value": "{\"user\":42}", "_ttl": 900, "_exp": 1791755332, "_version": 1}
_kv {"_key": "session:def", "_value": "{\"user\":7}", "_version": 1}
_kv {"_key": "views:hello", "_value": "1", "_version": 1}
_hash {"_key": "user:42", "name": "Ayse", "city": "Izmir", "_version": 1}
_list {"_key": "jobs", "_items": ["a", "b"], "_version": 1}
_set {"_key": "tags", "_members": ["rust", "db"], "_version": 1}
_zset {"_key": "board", "_members": [{"member": "b", "score": 20.0}, {"member": "a", "score": 10.0}], "_version": 1}
prefix query: ['session:abc', 'session:def']
De repente los datos calientes se pueden consultar: find("_kv", {"_key": {"$regex": "^session:"}}) lista todas las sesiones, y se puede ejecutar un pipeline de agregación sobre ellas. Tras un reinicio, DBSIZE devolvió 7 y TTL session:abc dio el tiempo restante correcto (879).
Una nota honesta sobre el nombre: un comentario antiguo en el código fuente dice que esto se puede consultar con SELECT * FROM _kv desde SQL, pero el motor SQL actual es un crate separado y no ve estas colecciones. Lo probé: sql error: no such table: _kv. El espejo vive en el lado de documentos; no hay acceso SQL. El nombre de la variable data de cuando la superficie SQL vivía dentro del motor de documentos.
El coste es claro y grande: ahora cada escritura llega también al motor de documentos como un borrado más una inserción, cada uno con fsync en el modo estricto por defecto. Lo medí: en este modo, redis-benchmark -t set -n 2000 -c 50 dio 72 peticiones por segundo (p50 de 462 ms). Las lecturas no se ven afectadas: GET en el mismo modo hizo 200.803 por segundo. Así que este modo es para conjuntos de datos pequeños que se escriben poco, se leen mucho y deben volver tras un reinicio. No para un contador.
Por dentro: estructuras de datos, concurrencia, memoria
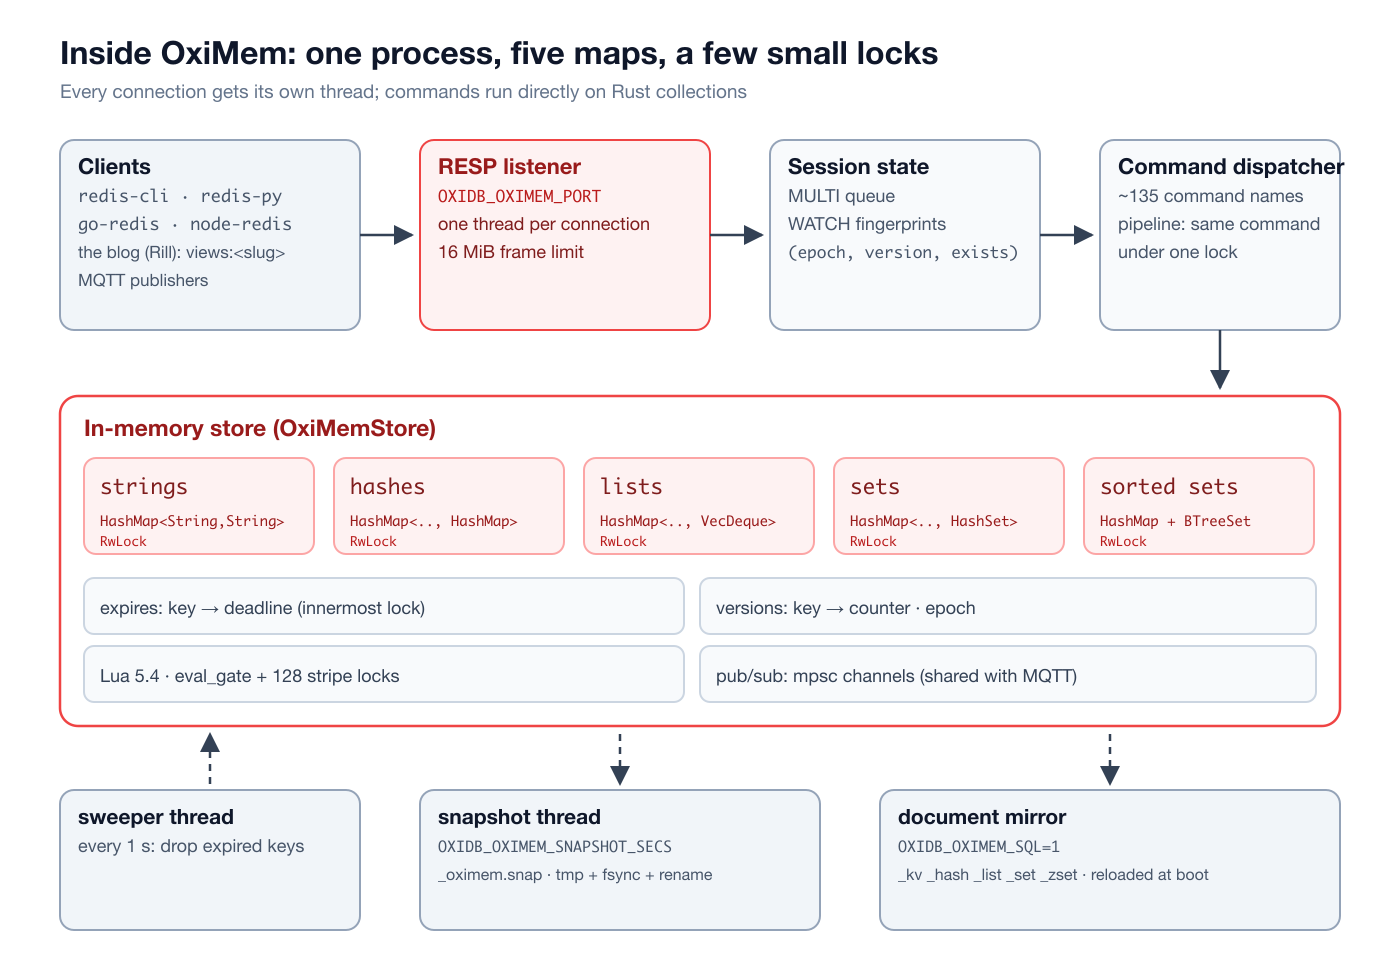
Todo está en oxidb-server/src/oximem.rs, unas 6.700 líneas. La estructura central es OxiMemStore:
pub struct OxiMemStore {
    strings: RwLock<HashMap<String, KvEntry>>,
    hashes: RwLock<HashMap<String, HashMap<String, String>>>,
    lists: RwLock<HashMap<String, VecDeque<String>>>,
    sets: RwLock<HashMap<String, HashSet<String>>>,
    sorted_sets: RwLock<HashMap<String, SortedSet>>,
    expires: RwLock<HashMap<String, Instant>>,
    // pubsub, psubs, tx_lock, eval_gate, eval_stripes, versions, epoch, ...
}
Sin JSON, sin WAL, sin índices: los comandos trabajan directamente sobre colecciones estándar de Rust.
Modelo de conexiones. Cada conexión TCP obtiene su propio hilo del sistema operativo (con TCP_NODELAY). El hilo lee valores RESP y los ejecuta a través de una Session por conexión (cola de MULTI, lista de WATCH). A diferencia del bucle de eventos monohilo de Redis, aquí las distintas conexiones se ejecutan realmente en paralelo, y los cinco mapas de tipos están detrás de RwLock separados: un GET y un HSET no se esperan entre sí.
Ruta rápida para pipelines. Cuando hay varios comandos en el búfer de lectura (el cliente está usando pipelining), se toman como un lote. Si todos los comandos del lote son iguales y se trata de GET, SET, INCR, LPUSH, RPUSH, HSET o PING, el lock correspondiente se toma una sola vez y todo el lote se ejecuta bajo él; las respuestas salen con un único flush. Los lotes mixtos o los que contienen comandos de transacción se ejecutan uno a uno por la ruta con estado. Por eso ZADD se queda atrás con pipelining en el benchmark de más abajo: no está en la lista de la ruta rápida.
Orden de los locks. El mapa expires es el lock más interno. Puede tomarse mientras se tiene un mapa de tipo, pero nunca se toma un mapa de tipo mientras se tiene expires. Todo comando que cambia un plazo primero establece la existencia en los mapas de tipos y después escribe en expires, así que el orden sale de forma natural. El código repite esta regla como comentario en cada punto crítico, porque el resultado de romperla una sola vez es un interbloqueo raro y muy difícil de atrapar.
Sorted sets. HashMap<String, f64> + BTreeSet<(Score, String)>. Insertar y eliminar son O(log n), buscar una puntuación O(1), los rangos un recorrido ordenado del árbol. El punto débil: ZRANK cuenta desde el principio del árbol, así que es O(n). La skip list de Redis guarda anchos de tramo en cada nodo y lo hace en O(log n). Si se llama mucho a ZRANK sobre un set con millones de miembros, se notará.
Memoria. También medí esto. Arranqué ambos servidores desde cero y cargué cada uno con un millón de SET key:NNNNNNN <32-byte value> mediante redis-cli --pipe:
| RSS al inicio | RSS tras 1M de claves | Crecimiento | Por clave | |
|---|---|---|---|---|
| Redis 8.6.1 | 6,8 MB | 107,9 MB | 101 MB | ~101 bytes |
| OxiDB 0.44.2 (OxiMem) | 14,6 MB | 169,6 MB | 155 MB | ~155 bytes |
OxiMem usa aproximadamente 1,5 veces más memoria que Redis para los mismos datos. La razón está clara: cada clave es un String separado (una cabecera de 24 bytes más su propia reserva en el heap), igual que cada valor, más la entrada del HashMap. Redis usa codificaciones embebidas (embstr) y estructuras compactas para strings pequeños. El RSS inicial de OxiMem también es mayor, porque este proceso es además una base de datos de documentos completa. Tampoco hay límite de maxmemory ni desalojo LRU: si la memoria se llena, el proceso sigue creciendo. Acotar el tamaño queda en manos del usuario (TTL, número de claves).
Un único keyspace. OxiDB es un motor multibase de datos, pero el keyspace de OxiMem es deliberadamente global (ADR-0012). SELECT 3 devuelve OK y no hace nada; sea cual sea la base de datos en la que se esté, se escribe en el mismo keyspace. A los tokens de sesión y a los contadores no les importan los límites lógicos entre bases de datos; si se quiere separación, se usan prefijos en las claves (customer:7:session:abc). En modo clúster OxiMem tampoco se replica mediante Raft; cada nodo tiene su propio keyspace.
La superficie de comandos
El README dice "más de 50 comandos"; eso ya se queda muy corto. El dispatcher conoce unos 135 nombres de comandos:
| Familia | Comandos |
|---|---|
| Conexión / servidor | PING ECHO QUIT SELECT AUTH HELLO CLIENT COMMAND INFO CONFIG DBSIZE FLUSHDB FLUSHALL |
| Strings | SET (EX/PX/NX/XX) GET GETSET SETNX SETEX PSETEX MSET MGET APPEND STRLEN GETRANGE SETRANGE GETDEL GETEX |
| Contadores | INCR DECR INCRBY DECRBY INCRBYFLOAT DECRBYFLOATGE |
| Bits | SETBIT GETBIT BITCOUNT |
| Claves / TTL | DEL EXISTS TYPE KEYS SCAN RANDOMKEY RENAME COPY EXPIRE PEXPIRE EXPIREAT PEXPIREAT PERSIST TTL PTTL |
| Hashes | HSET HMSET HSETNX HGET HMGET HGETALL HDEL HEXISTS HKEYS HVALS HLEN HINCRBY HRANDFIELD HSCAN |
| Listas | LPUSH RPUSH LPOP RPOP LLEN LRANGE LINDEX LSET LREM LTRIM LMOVE RPOPLPUSH LMPOP |
| Sets | SADD SREM SMEMBERS SISMEMBER SMISMEMBER SCARD SPOP SRANDMEMBER SINTER SUNION SDIFF SINTERSTORE SUNIONSTORE SDIFFSTORE SSCAN |
| Sorted sets | ZADD ZREM ZSCORE ZCARD ZCOUNT ZINCRBY ZRANK ZREVRANK ZRANGE ZREVRANGE ZRANGEBYSCORE ZREVRANGEBYSCORE ZRANGEBYLEX ZPOPMIN ZPOPMAX ZREMRANGEBYRANK ZREMRANGEBYSCORE ZUNIONSTORE ZINTERSTORE ZMPOP ZSCAN |
| GEO | GEOADD GEOPOS GEODIST GEOHASH GEOSEARCH |
| Bloqueantes | BLPOP BRPOP BZPOPMIN BLMOVE BRPOPLPUSH |
| Pub/Sub | PUBLISH SUBSCRIBE PSUBSCRIBE UNSUBSCRIBE PUNSUBSCRIBE |
| Transacciones | MULTI EXEC DISCARD WATCH UNWATCH |
| Scripting | EVAL EVALSHA SCRIPT (LOAD, EXISTS, FLUSH, KILL) |
Lo que falta también importa. Comandos que probé y que devolvieron unknown command: UNLINK, MSETNX, HINCRBYFLOAT, ZRANGESTORE, OBJECT, WAIT, SAVE, BGSAVE. No hay streams (la familia XADD), ni HyperLogLog (PFADD), ni ACL, SLOWLOG o MEMORY. CONFIG es en su mayor parte un cascarón: solo notify-keyspace-events hace algo de verdad; las demás llamadas a CONFIG GET devuelven un valor vacío y CONFIG SET devuelve OK. AUTH, SELECT, CLIENT y COMMAND responden OK para que los handshakes de los clientes no se rompan.
INFO también es breve:
# Server
oxidb_version:0.44.2
oximem_mode:raw
resp_compat:true

# Keyspace
db0:keys=19,expires=0
Rendimiento frente a Redis
La única vara de medir con sentido para una capa compatible con Redis es el propio Redis. En la misma máquina (Apple M4, 10 núcleos, 24 GB, macOS 26.3) ejecuté Redis 8.6.1 de Homebrew (--save "" --appendonly no, es decir, sin persistencia) junto a OxiMem en modo rápido. Ambos en localhost, medidos con redis-benchmark 8.6.1: 200.000 peticiones, 50 clientes, valores de 64 bytes, primero sin pipelining y luego con un pipeline de 16.
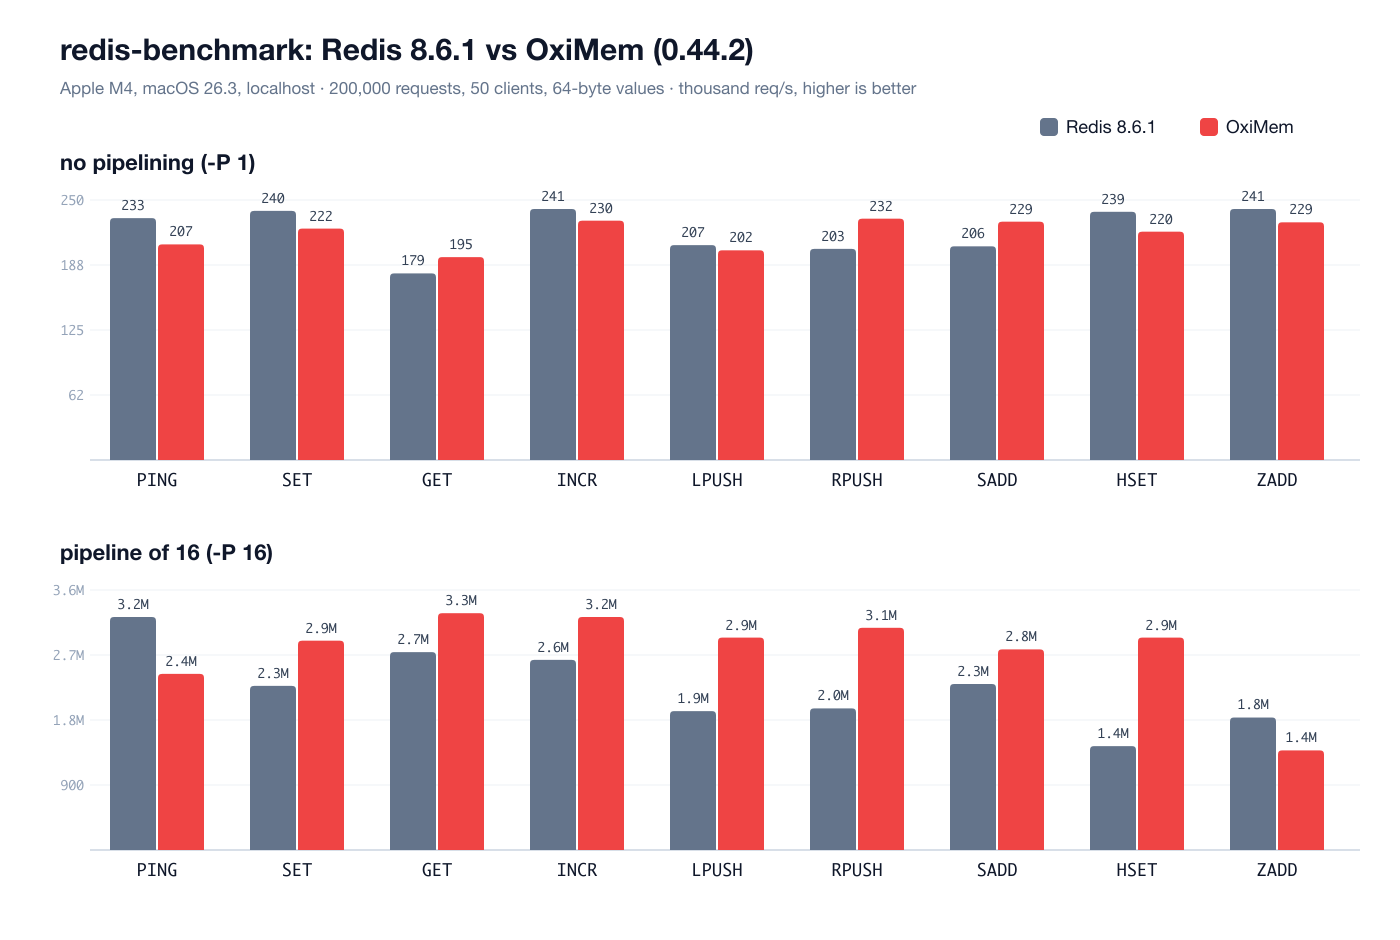
Cómo leerlo:
- Sin pipelining (-P 1) ambos servidores se sitúan en la franja de 180k a 245k peticiones por segundo y las diferencias son ruido. En una segunda ejecución el orden se invirtió en algunos comandos: el
GETde Redis pasó de 179k a 239k y elINCRde OxiMem bajó de 230k a 185k. En este modo el cuello de botella es el viaje de ida y vuelta en localhost, no el servidor. - Con pipelining (-P 16) OxiMem va por delante en la mayoría de los comandos (
SET2,9M frente a 2,3M,HSET2,9M frente a 1,4M). Las razones son las dos cosas descritas antes: 50 conexiones se ejecutan en paralelo en hilos separados, y los lotes del mismo comando se ejecutan bajo un único lock. Redis se queda en un solo hilo. La segunda ejecución mostró el mismo panorama. - Dónde se queda atrás:
PING(2,4M frente a 3,2M) y sobre todoZADD(1,4M frente a 1,8M; 1,35M frente a 2,0M en la segunda ejecución).ZADDno está en la ruta rápida de pipelines, así que cada comando pasa por el dispatcher por separado.MSET(10 claves) también se queda atrás con pipelining (393k frente a 473k). - Son una o dos ejecuciones por configuración en una sola máquina sobre localhost. Una red real, un número de núcleos diferente o una carga distinta cambiarán las cifras. En particular, no activé el I/O multihilo de Redis (
io-threads).
En resumen: en velocidad bruta OxiMem juega en la misma liga que Redis y aprovecha mejor varios núcleos; a cambio, gasta más memoria. Para mí, sin embargo, la verdadera ventaja no son las cifras, sino que esta velocidad vive en el mismo proceso, justo al lado de los motores de documentos y SQL: no hay un Redis aparte que instalar, monitorizar y actualizar.
Límites y compromisos honestos
No conocer los límites de una herramienta es la forma más rápida de usarla en el lugar equivocado. Los límites actuales de OxiMem:
No hay comprobación WRONGTYPE entre tipos. Como los cinco tipos viven en mapas separados, un mismo nombre puede ser a la vez un string y un set. En Redis, INCR sobre un set falla con WRONGTYPE; en OxiMem crea un string al lado:
127.0.0.1:15602> INCR online
(integer) 1
127.0.0.1:15602> TYPE online
string
127.0.0.1:15602> SCARD online
(integer) 3
127.0.0.1:15602> DEL online
(integer) 1
127.0.0.1:15602> EXISTS online
(integer) 1
DEL eliminó el string, pero el set sigue ahí. Prefijar los nombres de clave con su tipo (set:online, cnt:online) lo evita en la práctica, pero alguien que venga de Redis no lo esperará. Es una incompatibilidad que hay que corregir.
No hay autenticación, y el listener está en todas las interfaces. AUTH responde OK a cualquier cosa. La autenticación SCRAM y el control de acceso basado en roles de OxiDB no cubren el puerto de OxiMem. Como el puerto se enlaza a 0.0.0.0, solo hay una forma correcta de ejecutarlo: cerrar el puerto de OxiMem al exterior con un firewall y acceder a él solo desde la misma máquina o desde una red privada de confianza. Así es como lo ejecuta este blog. La autenticación es la carencia más importante de esta capa.
No hay RESP3. HELLO 3 recibe un error; algunos clientes (redis-py 8) necesitan protocol=2 por ello.
Prefijos de error. NOSCRIPT, EXECABORT y NOPROTO llegan con el prefijo ERR, así que la lógica de cliente basada en esos códigos (como el register_script de redis-py) no se activa.
No hay persistencia sin pérdidas. No hay un log al estilo AOF ni un snapshot final al apagar. El espejo de documentos es duradero, pero muy lento para escrituras.
No hay límite de memoria ni desalojo, y usa ~1,5 veces la memoria de Redis. No hay replicación: el keyspace es local a cada nodo.
Entonces, ¿cuándo OxiMem y cuándo otra cosa? Lo decide una sola pregunta: ¿qué pasa si pierdo estos datos? Si la respuesta es "nada, de todos modos se recalculan o son de vida corta" (sesiones, cachés, contadores, límites de tasa, colas cortas, precios en vivo), OxiMem es el sitio. Si la respuesta es "pierdo dinero, mi registro de auditoría tiene un hueco", su lugar es el motor de documentos, el motor SQL o el motor ledger. La configuración más sólida usa ambos: una ruta caliente rápida y una ruta fría duradera.
OxiMem en este blog
El servidor de este blog está escrito en Rill y habla con OxiDB a través de tres protocolos: el protocolo nativo para las publicaciones y las etiquetas (SQL y documentos), S3 para las imágenes y RESP para los datos calientes. Lo que vive en OxiMem:
- Contadores de visitas. Cuando se abre una publicación, el servidor ejecuta
INCR views:<slug>y coloca el número devuelto en lugar de un marcador en la página. Así que el número al pie de esta página salió de OxiMem en ese mismo instante. Los bots no lo incrementan; solo lo leen conGET. - Caché de páginas. El HTML renderizado se guarda bajo claves
page:<lang>:post:<slug>con un tiempo de vida de cinco minutos (SETEX ... 300). Si está en la caché, la página sale directamente de allí con una cabeceraX-Cache: hit; si no, se renderiza a partir de SQL y se escribe en OxiMem. Cuando se edita una publicación, todas las claves de página se eliminan conKEYS page:*; un blog se escribe poco y se lee mucho, así que esto es lo bastante barato. - Sesiones y limitación de tasa. La sesión de administración es una clave
sess:<token>con un tiempo de vida de siete días. Los comentarios y los intentos de inicio de sesión pasan por un límite de tasa de ventana fija: cuando el primerINCRdevuelve 1, la clave recibe la duración de la ventana conEXPIRE, un recuento por encima del límite se rechaza y la clave muere por sí sola cuando termina la ventana.
Las analíticas detalladas no están en OxiMem: cada visita se escribe también, en su propio strand (el hilo ligero de Rill), en la colección events del motor de documentos. Así la página no espera al fsync del motor de documentos, pero las analíticas son duraderas. El recuento total de visitas del panel de administración sale de contar esa colección, no de OxiMem. Aunque el contador de OxiMem se pierda en un reinicio, el registro real permanece en events. Es un ejemplo vivo de la pregunta de este artículo, "¿y si pierdo estos datos?": el número rápido en OxiMem, el registro de la verdad en el motor de documentos.
Pruébalo
OxiDB es un único binario. Se puede descargar oxidb-server para cada plataforma desde la página de releases de GitHub o construir una imagen Docker a partir del Dockerfile del repositorio, y después:
OXIDB_OXIMEM_PORT=6380 OXIDB_OXIMEM_SNAPSHOT_SECS=30 ./oxidb-server
redis-cli -p 6380 PING
Cualquier cliente Redis que ya se tenga debería funcionar (con protocol=2 para redis-py 8). Los siguientes puntos de mi lista están claros: una comprobación WRONGTYPE entre tipos, códigos de error sin el prefijo ERR, arreglar los errores multilínea de Lua, un snapshot final al apagar y la autenticación. El siguiente artículo de la serie trata el almacenamiento de objetos compatible con S3 de OxiDB.