Almacenamiento de objetos compatible con S3 en OxiDB: aws-cli y boto3 se conectan sin modificaciones
La capa S3 de OxiDB: multipart, lecturas de rango y condicionales, SSE-S3/SSE-C, SigV4 y URL prefirmadas, expiración por ciclo de vida, cómo se guardan los blobs en disco y búsqueda de texto completo dentro de los archivos subidos. Todo con sesiones reales.
A medida que una aplicación crece, junto a la base de datos aparece siempre el mismo invitado: los archivos. Avatares de usuarios, facturas en PDF, copias de seguridad, archivos de logs, imágenes del blog. La mayoría de los equipos monta un almacén de objetos aparte para ellos (AWS S3, MinIO, Ceph) y al poco tiempo se encuentra gestionando copias de seguridad, credenciales, monitorización y actualizaciones de dos sistemas en lugar de uno. En OxiDB decidí que ese invitado se quedara en la misma casa: si se le da al servidor un OXIDB_S3_PORT, abre un listener que habla la API HTTP de S3. aws-cli, boto3 y los SDK de MinIO se conectan sin modificaciones; solo hay que apuntarlos a otro endpoint_url. Este artículo explica qué hace esta capa, cómo funciona, cómo dispone los objetos en disco y en qué todavía se queda corta frente a S3, todo con sesiones reales.
Primero, una pequeña nota: las imágenes del blog que estás leyendo viven exactamente en esta capa. El servidor del blog escribe en un bucket llamado blog-media con claves como img/<uuid>.<ext> y firma sus peticiones con un pequeño firmador SigV4 que escribí en Rill. Todo lo que sigue es código que se ejecuta cada día en el servidor que entrega esta página.
¿Por qué un S3 dentro de una base de datos?
La API de S3 se ha convertido en el idioma de facto del almacenamiento de objetos. Herramientas de copia de seguridad, CDN, generadores de sitios estáticos, pipelines de ML: todos hablan S3. Por eso no bastaba con que "OxiDB tenga sus propios comandos de blobs". Las herramientas existentes tenían que conectarse sin ningún cambio.
Al mismo tiempo, mantener los objetos en un sistema separado tiene costes reales:
- Dos copias de seguridad, dos planes de restauración. La fila de
ordersen la base de datos y la factura en PDF en S3 se respaldan en momentos distintos y pueden no coincidir tras una restauración. - Dos sistemas de autenticación. Usuarios de la base de datos por un lado, claves de IAM por el otro.
- La búsqueda es otro mundo. Buscar dentro de un PDF suele implicar un tercer sistema (Elasticsearch, OpenSearch) y un pipeline de ETL.
En OxiDB la capa S3 es una fina envoltura HTTP sobre el BlobStore del núcleo. Un objeto escrito con el comando put_object del protocolo wire nativo puede leerse a través de S3, y un PDF subido por S3 aparece en la búsqueda de texto completo unos milisegundos después. El mismo directorio de datos, el mismo proceso, la misma copia de seguridad.
Activación y configuración
La capa S3 está desactivada por defecto; para activarla basta con un puerto. Para este artículo arranqué el servidor así (OxiDB 0.44.2 en un Mac con Apple serie M, todo en local):
OXIDB_ADDR=127.0.0.1:15700 \
OXIDB_DATA=./data \
OXIDB_S3_PORT=15703 \
OXIDB_S3_CREDENTIALS="oxiadmin:oxisecret123,reader:readersecret456" \
OXIDB_S3_ENCRYPTION_KEY=000102030405060708090a0b0c0d0e0f101112131415161718191a1b1c1d1e1f \
OXIDB_BLOB_COMPRESS=1 \
./oxidb-server
El log de arranque dice claramente qué está activo:
oxidb-server listening on 127.0.0.1:15700 (pool_size=4, data_dir=.../data, idle_timeout=0s)
[s3] authentication enabled (2 credential(s))
[s3] server-side encryption enabled (SSE-S3)
[s3] thread pool: 256 workers, queue depth 1024
S3-compatible API listening on 0.0.0.0:15703
Las variables de entorno relevantes:
| Variable | Qué hace |
|---|---|
OXIDB_S3_PORT | Puerto del listener HTTP de S3. Si no está definida, la capa está desactivada. |
OXIDB_S3_ACCESS_KEY / OXIDB_S3_SECRET_KEY | Un único par de claves. |
OXIDB_S3_CREDENTIALS | Varios pares: ak1:sk1,ak2:sk2. Puede combinarse con el par único. |
OXIDB_S3_ENCRYPTION_KEY | Clave del servidor para SSE-S3, 64 caracteres hexadecimales (32 bytes). |
OXIDB_S3_DEFAULT_ENCRYPTION | Si es true, todo PUT sin cabeceras de cifrado también se cifra con la clave del servidor. |
OXIDB_BLOB_COMPRESS | Si es 1, los objetos adecuados se guardan comprimidos con zstd. |
OXIDB_BLOB_SYNC | Si es 1, cada PUT/DELETE hace fsync antes de responder. |
Algunos detalles importantes:
- Sin credenciales, la API de S3 queda abierta a cualquiera, y el servidor lo anuncia a gritos:
[s3] WARNING: authentication DISABLED, S3 API is open to anyone!(la línea de log real). Preferí el ruido antes que dejar la puerta abierta en silencio. - El listener se enlaza a
0.0.0.0, así que restringir el puerto wire a localhost conOXIDB_ADDRno restringe S3. En producción, conviene ponerlo detrás de un firewall o de un proxy inverso. - S3 es un listener respaldado por el motor de documentos. Si se desactiva el motor de documentos con
OXIDB_DOC=0y además se defineOXIDB_S3_PORT, el servidor se niega a arrancar con "S3 buckets are stored as document-engine blobs". Parte del estado, como las reglas de ciclo de vida, vive en colecciones de documentos. - Cuando llegó el soporte para múltiples bases de datos, mantuve deliberadamente los buckets de S3 como globales (ADR-0012): la semántica de S3 tiene un único espacio de nombres de buckets, y la capa S3 siempre escribe en la base de datos por defecto (
data/oxidb/).
¿Cómo llega a existir un bucket?
No hay una configuración de buckets aparte. Un bucket se crea con PUT /bucket o simplemente escribiendo un objeto en él; BlobStore::put_object crea sobre la marcha los buckets que faltan. Los nombres de bucket se validan porque se convierten en directorios en disco: .., / e incluso un . solo se rechazan (. antes pasaba todas las comprobaciones y se resolvía a la raíz _blobs; la corrección está registrada en el CHANGELOG).
Una primera sesión con clientes sin modificar: aws-cli
aws-cli no estaba instalado en la máquina, así que lo instalé en un venv dentro de mi directorio de trabajo con pip install awscli boto3 (aws-cli 1.46.1, boto3 1.43). Sin plugins ni parches, solo --endpoint-url.
export AWS_ACCESS_KEY_ID=oxiadmin AWS_SECRET_ACCESS_KEY=oxisecret123 AWS_DEFAULT_REGION=us-east-1
export EP=http://127.0.0.1:15703
echo "Merhaba OxiDB S3, bu bir deneme dosyasıdır." > hello.txt
aws --endpoint-url $EP s3 mb s3://photos
aws --endpoint-url $EP s3 cp hello.txt s3://photos/notes/hello.txt
aws --endpoint-url $EP s3 ls s3://photos --recursive
aws --endpoint-url $EP s3api head-object --bucket photos --key notes/hello.txt
md5 -q hello.txt
make_bucket: photos
upload: ./hello.txt to s3://photos/notes/hello.txt
2026-10-12 00:32:25 46 notes/hello.txt
{
"AcceptRanges": "bytes",
"LastModified": "Sun, 11 Oct 2026 21:32:25 GMT",
"ContentLength": 46,
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"ContentType": "text/plain",
"Metadata": {}
}
87234ebddb79e0e7daed2faedcfc1f10Fíjate en que el ETag es exactamente el MD5 del archivo. Parece un detalle menor, pero detrás hay una historia a la que llegaré más adelante. Con una clave secreta incorrecta:
$ AWS_SECRET_ACCESS_KEY=wrong aws --endpoint-url $EP s3 ls s3://photos

An error occurred (AccessDenied) when calling the ListObjectsV2 operation: Access Denied
Operaciones sobre objetos: Put, Get, Head, Delete, Copy
La superficie soportada es la parte de S3 que las aplicaciones usan de verdad:
| Operación | HTTP | Notas |
|---|---|---|
| ListBuckets | GET / | |
| CreateBucket / DeleteBucket / HeadBucket | PUT, DELETE, HEAD /bucket | |
| ListObjectsV2 | GET /bucket?list-type=2 | prefix, delimiter, max-keys, continuation-token, start-after |
| PutObject | PUT /bucket/key | metadatos de usuario x-amz-meta-*, decodificación de cuerpos aws-chunked |
| GetObject | GET /bucket/key | Range, If-Match, If-None-Match, If-Modified-Since, If-Unmodified-Since |
| HeadObject | HEAD /bucket/key | |
| DeleteObject | DELETE /bucket/key | 204 aunque no exista (como S3) |
| DeleteObjects | POST /bucket?delete | borrado por lotes |
| CopyObject | PUT + x-amz-copy-source | directiva de metadatos COPY/REPLACE, copia condicional |
| Multipart | ?uploads, ?partNumber&uploadId, ?uploadId | iniciar, subir parte, completar, abortar |
| Tagging | GET/PUT/DELETE ?tagging | |
| Lifecycle | GET/PUT/DELETE /bucket?lifecycle | solo Expiration/Days |
Copia y etiquetado con aws-cli:
aws --endpoint-url $EP s3api copy-object --bucket photos --key archive/hello-copy.txt --copy-source photos/notes/hello.txt
aws --endpoint-url $EP s3api put-object-tagging --bucket photos --key notes/hello.txt \
    --tagging "TagSet=[{Key=project,Value=blog},{Key=lang,Value=tr}]"
aws --endpoint-url $EP s3api get-object-tagging --bucket photos --key notes/hello.txt
{
"CopyObjectResult": {
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"LastModified": "2026-10-11T21:32:36Z"
}
}
{
"TagSet": [
{ "Key": "project", "Value": "blog" },
{ "Key": "lang", "Value": "tr" }
]
}Las etiquetas no son una estructura aparte; viven en los metadatos del objeto con el prefijo tag-. Un efecto secundario: un GET sobre el mismo objeto también las devuelve como cabeceras de metadatos de usuario, del tipo x-amz-meta-tag-project (se verá en la salida del range más abajo). Escribir etiquetas también reescribe el objeto, así que LastModified cambia. Lo mantuve sencillo, pero conviene saberlo.
aws-chunked: la sorpresa de boto3
Las versiones modernas de aws-cli y boto3 envían por defecto los cuerpos de los PUT envueltos en el formato "aws-chunked": una línea con el tamaño en hexadecimal antes de cada fragmento y, opcionalmente, trailers con checksums al final. Las primeras versiones no decodificaban ese formato, así que líneas como 4000;chunk-signature=... acababan dentro del objeto almacenado. La subida tenía éxito, volvía un ETag y la descarga era basura. Ahora, siempre que la petición lleva content-encoding: aws-chunked o x-amz-content-sha256: STREAMING-*, el cuerpo se desenvuelve, tanto en los PUT simples como en las partes de multipart.
ListObjectsV2: prefijos, delimitadores y continuación
Los almacenes de objetos no tienen carpetas, solo claves que contienen /. La ilusión de carpetas sale de los parámetros prefix y delimiter. Subí con boto3 los archivos de log de tres días y los listé:
import boto3
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:15703",
                  aws_access_key_id="oxiadmin", aws_secret_access_key="oxisecret123",
                  region_name="us-east-1")

s3.create_bucket(Bucket="logs")
for day in ("2026-10-10", "2026-10-11", "2026-10-12"):
    for i in range(4):
        s3.put_object(Bucket="logs", Key=f"app/{day}/part-{i}.log", Body=f"{day} line {i}\n".encode())
s3.put_object(Bucket="logs", Key="README.txt", Body=b"logs bucket")

r = s3.list_objects_v2(Bucket="logs", Delimiter="/")
print("top level  :", [c["Prefix"] for c in r.get("CommonPrefixes", [])], [o["Key"] for o in r.get("Contents", [])])
r = s3.list_objects_v2(Bucket="logs", Prefix="app/", Delimiter="/")
print("under app/ :", [c["Prefix"] for c in r.get("CommonPrefixes", [])])

page, token = 1, None
while True:
    kw = dict(Bucket="logs", Prefix="app/", MaxKeys=5)
    if token: kw["ContinuationToken"] = token
    r = s3.list_objects_v2(**kw)
    print(f"page {page}: KeyCount={r['KeyCount']} IsTruncated={r['IsTruncated']} "
          f"first={r['Contents'][0]['Key'] if r.get('Contents') else None} next={r.get('NextContinuationToken')}")
    if not r["IsTruncated"]: break
    token, page = r["NextContinuationToken"], page + 1
top level : ['app/'] ['README.txt']
under app/ : ['app/2026-10-10/', 'app/2026-10-11/', 'app/2026-10-12/']
page 1: KeyCount=5 IsTruncated=True first=app/2026-10-10/part-0.log next=app/2026-10-11/part-0.log
page 2: KeyCount=5 IsTruncated=True first=app/2026-10-11/part-1.log next=app/2026-10-12/part-1.log
page 3: KeyCount=2 IsTruncated=False first=app/2026-10-12/part-2.log next=NoneComo se ve, NextContinuationToken no es opaco: es la última clave devuelta. Es intencionado. Las claves están ordenadas, así que paginar por "todo lo que sea mayor que la última clave que vi" es más estable que paginar por desplazamiento; una subida o un borrado entre dos páginas no puede hacer que una clave aparezca dos veces o desaparezca. Por eso también continuation-token y start-after se comportan igual.
El bug que encontré mientras escribía este artículo
Quise probar la continuación también en un bucket más grande. Subí 2500 objetos (1,66 segundos con 32 hilos) y los listé con el propio paginador de boto3:
pages = s3.get_paginator("list_objects_v2").paginate(Bucket="many")
counts = [p["KeyCount"] for p in pages]
print("pages:", counts, "total listed:", sum(counts))
put 2500 objects in 1.66s
pages: [1000, 1000, 0] total listed: 2000Solo se listaron 2000 de los 2500 objetos. La causa está en bucket.rs: la capa S3 primero obtiene del núcleo las primeras max_keys + 1000 claves y solo después aplica el filtro de continuation-token. Nada más allá de la clave número 2000 llega nunca, la tercera página vuelve vacía con IsTruncated=false y el cliente concluye que el listado está completo. La corrección es sencilla, porque el núcleo ya tiene list_objects_from(bucket, prefix, after, limit); la capa S3 solo tiene que llamarlo. Hasta la próxima versión, no hay que fiarse de un listado completo de un bucket con más de 2000 objetos. Prefiero decirlo en voz alta que esconderlo; para eso sirve, en parte, esta serie.
Lecturas condicionales y parciales
GetObject admite condiciones basadas en el ETag. Un cliente con caché envía el ETag que ya tiene en If-None-Match y recibe un 304 sin cuerpo cuando nada ha cambiado:
head = s3.head_object(Bucket="logs", Key="README.txt")
etag = head["ETag"]
print("etag:", etag, "md5:", hashlib.md5(b"logs bucket").hexdigest())
s3.get_object(Bucket="logs", Key="README.txt", IfNoneMatch=etag)      # ClientError
s3.get_object(Bucket="logs", Key="README.txt", IfMatch='"deadbeef"')  # ClientError
s3.get_object(Bucket="logs", Key="README.txt", IfMatch=etag)["Body"].read()
etag: "4a88ebb9d3237052e83f9445adba8d2c" md5: 4a88ebb9d3237052e83f9445adba8d2c
If-None-Match same etag -> 304
If-Match wrong etag -> 412 PreconditionFailed
If-Match right etag -> b'logs bucket'Las peticiones de rango funcionan con bytes=a-b, bytes=a- y la forma de sufijo bytes=-n; los rangos imposibles de satisfacer devuelven 416. Los primeros 7 bytes con aws-cli:
aws --endpoint-url $EP s3api get-object --bucket photos --key notes/hello.txt --range bytes=0-6 part.txt && cat part.txt{
"AcceptRanges": "bytes",
"ContentLength": 7,
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"ContentRange": "bytes 0-6/46",
"ContentType": "text/plain",
"Metadata": { "tag-project": "blog", "tag-lang": "tr" }
}
MerhabaDos advertencias honestas. Primera: una lectura de rango carga el objeto entero desde disco (descifrándolo y descomprimiéndolo si hace falta) y luego lo recorta; el último 1 MB de un vídeo de 5 GB sigue costando 5 GB de lectura. El cifrado y la compresión operan sobre el archivo completo y, sin un AEAD por fragmentos, no hay un seek real. Segunda: If-Modified-Since e If-Unmodified-Since no comparan fechas; comparan la cadena de fecha HTTP por igualdad exacta. Eso funciona con los clientes que devuelven Last-Modified tal cual, como hacen los navegadores, pero no puede expresar "modificado después de esta fecha". Las condiciones basadas en el ETag están completas.
Subidas multipart y la historia del ETag
aws-cli sube por defecto con multipart los archivos de más de 8 MB. Un archivo aleatorio de 20 MB:
head -c 20971520 /dev/urandom > big.bin
aws --endpoint-url $EP s3 cp big.bin s3://photos/videos/big.bin --only-show-errors
aws --endpoint-url $EP s3api head-object --bucket photos --key videos/big.bin --query "[ContentLength,ETag]" --output text
aws --endpoint-url $EP s3 cp s3://photos/videos/big.bin big.back --only-show-errors && cmp big.bin big.back && echo identical
20971520 "e90e5924e8af5f366537d93f2dfc780e-3"
identicalEl -3 al final del ETag indica que el objeto se subió en tres partes (8 + 8 + 4 MB). S3 no define el ETag de un objeto multipart como el MD5 del objeto: concatena los digests MD5 en bruto (16 bytes) de las partes, calcula el MD5 de eso y añade -<número de partes>. OxiDB hace exactamente eso y devuelve el MD5 en hexadecimal de cada parte como ETag de cada subida de parte.
Aprendí por las malas por qué esto importa. Antes, los ETag de una sola parte eran los primeros 16 bytes de un SHA-256. Eso son 32 caracteres hexadecimales, la misma forma que un MD5. El AWS SDK para .NET calcula el MD5 de lo que envió y lo compara con el ETag de la respuesta; si no coinciden, lanza una excepción suponiendo que la subida se corrompió. Una etiqueta que parece un MD5 pero no lo es resultó peor que una etiqueta que no parece nada: el cliente no podía saber que se trataba de una diferencia de esquema y concluía que los datos estaban dañados. Los ETag de las partes de multipart fueron CRC32 durante un tiempo (8 caracteres hexadecimales en lugar de 32). Ahora ambos siguen la definición de S3, y los tests de s3_etag.rs se encargan de que sigan así. MD5 está roto para firmas, pero un ETag no es una firma; identifica bytes.
Multipart tiene límites claros: como máximo 10.000 partes, 5 GiB en total por subida, y las subidas incompletas las limpia un hilo en segundo plano al cabo de 24 horas. Una nota de honestidad importante: las partes en curso se mantienen en memoria. Si el servidor se reinicia, las subidas multipart a medio terminar se pierden (el cliente vuelve a subir), y muchas subidas grandes concurrentes aumentan el uso de RAM en la suma de sus partes. Para imágenes de un blog y documentos no hay problema; para un archivo de vídeo de varios terabytes, OxiDB S3 no es la herramienta adecuada.
Ciclo de vida: expiración de objetos
En los buckets de logs y de archivos temporales, la función más solicitada es el borrado automático de objetos antiguos. OxiDB admite el subconjunto más usado de la configuración de ciclo de vida de S3: Expiration/Days.
s3.put_bucket_lifecycle_configuration(Bucket="secure", LifecycleConfiguration={
    "Rules": [{"ID": "expire-old", "Status": "Enabled", "Filter": {"Prefix": ""},
               "Expiration": {"Days": 30}}]})
print("lifecycle  :", s3.get_bucket_lifecycle_configuration(Bucket="secure")["Rules"])
lifecycle : [{'Expiration': {'Days': 30}, 'ID': 'secure-expiration', 'Status': 'Enabled'}]La regla se guarda en una colección de documentos llamada _s3_lifecycle, así que sobrevive a los reinicios y pasa por el mismo WAL que el resto de OxiDB. Un barrendero en segundo plano lee todas las reglas una vez cada cinco minutos y borra los objetos cuyo created_at tenga más de Days días.
Para verlo funcionar sin esperar 30 días, hice un poco de trampa: en mi propio directorio de datos cambié el created_at del archivo .meta del objeto invoice.txt a 2026-08-01T09:00:00Z (los archivos meta son JSON plano, más sobre eso abajo), reinicié el servidor y esperé cinco minutos:
$ aws --endpoint-url $EP s3 ls s3://secure
2026-10-12 00:33:04         48 diary.txt
2026-08-01 12:00:00         54 invoice.txt
Cinco minutos después apareció una sola línea en el log del servidor y el objeto había desaparecido:
[s3] lifecycle expired 1 objects

$ aws --endpoint-url $EP s3 ls s3://secure
2026-10-12 00:33:04         48 diary.txt
Límites: una regla por bucket, se usa el primer valor de <Days> del XML, Filter/Prefix y el ID de la regla se ignoran (GET devuelve el ID como <bucket>-expiration) y no hay transiciones ni reglas para objetos versionados.
Cifrado: SSE-S3 y SSE-C
Hay dos capas de cifrado independientes y no conviene confundirlas:
- Cifrado en reposo (
OXIDB_ENCRYPTION_KEY): cifra todo el directorio de datos de OxiDB con AES-256-GCM, incluidos los archivos.datay.metade los blobs. El cliente S3 nunca se entera. - Cifrado del lado del servidor de S3 (SSE): se elige en cada petición mediante cabeceras de S3.
Con SSE-S3 la clave pertenece al servidor (OXIDB_S3_ENCRYPTION_KEY) y el cliente solo envía x-amz-server-side-encryption: AES256. Con SSE-C el cliente envía la clave en cada petición; el servidor nunca la guarda y, sin ella, el objeto no se puede leer. En las subidas multipart la clave SSE-C permanece en memoria hasta completar la subida y después se pone a cero con write_volatile. Ambos modos usan AES-256-GCM con un nonce aleatorio de 12 bytes por objeto.
r = s3.put_object(Bucket="secure", Key="invoice.txt", Body=b"Invoice 2026-114: 1250 EUR",
                  ServerSideEncryption="AES256")
print("SSE-S3 put :", r.get("ServerSideEncryption"))
r = s3.get_object(Bucket="secure", Key="invoice.txt")
print("SSE-S3 get :", r.get("ServerSideEncryption"), r["Body"].read())

key = bytes(range(32))
s3.put_object(Bucket="secure", Key="diary.txt", Body=b"only I can read this",
              SSECustomerAlgorithm="AES256", SSECustomerKey=key)
r = s3.get_object(Bucket="secure", Key="diary.txt", SSECustomerAlgorithm="AES256", SSECustomerKey=key)
print("SSE-C get  :", r["Body"].read())
s3.get_object(Bucket="secure", Key="diary.txt")                       # no key
s3.get_object(Bucket="secure", Key="diary.txt",
              SSECustomerAlgorithm="AES256", SSECustomerKey=os.urandom(32))  # wrong key
SSE-S3 put : AES256
SSE-S3 get : AES256 b'Invoice 2026-114: 1250 EUR'
SSE-C get : b'only I can read this'
SSE-C no key: 400 InvalidRequest
SSE-C wrong key: 500 InternalErrorEn disco es realmente texto cifrado:
$ cat data/oxidb/_blobs/secure/0.meta
{"key":"invoice.txt","bucket":"secure","size":54,"content_type":"application/octet-stream",
 "etag":"5ffee1c8d3e340ce03033bb8146f03cf","created_at":"2026-10-11T21:33:04Z",
 "metadata":{"_sse":"AES256"},"stored_size":54,"format_version":1}
$ xxd data/oxidb/_blobs/secure/0.data | head -2
00000000: 8d3b e14e a81f d050 f0f7 ab1e 6cf9 4626  .;.N...P....l.F&
00000010: 7d8c b9e7 50a8 bb02 9de3 0124 f301 fd6f  }...P......$...o
Tres notas honestas aquí:
- El tamaño y el ETag reflejan el texto cifrado. La capa SSE está por encima del BlobStore, así que lo que llega al núcleo ya está cifrado. Para la factura de 26 bytes, HEAD informa un
ContentLengthde 54 (nonce de 12 bytes más la etiqueta GCM de 16 bytes), mientras que una descarga devuelve 26 bytes. El ETag es el MD5 del texto cifrado. En S3 los objetos SSE-C tampoco tienen como ETag el MD5 del contenido, pero la discrepancia de tamaño es una carencia por mi parte. - Una clave SSE-C incorrecta devuelve 500. AWS devuelve 403 en este caso; tengo que mapear un fallo de autenticación GCM a un error del cliente.
- Los objetos cifrados no se indexan para texto completo. El worker de FTS lee bytes cifrados del disco y no puede extraer el texto. Para SSE-C es exactamente lo correcto (el servidor no conoce la clave); para SSE-S3 es una decisión de diseño.
SigV4 y URL prefirmadas
La autenticación usa AWS Signature Version 4, en dos formas:
- Cabecera:
Authorization: AWS4-HMAC-SHA256 Credential=<ak>/<date>/<region>/s3/aws4_request, SignedHeaders=..., Signature=.... El servidor reconstruye la petición canónica (método, ruta, query ordenada, cabeceras firmadas, hash del payload), deriva la clave de firma a partir deAWS4<secret>a través de la cadena fecha, región, servicio yaws4_request, y verifica la firma con una comparación de tiempo constante. - Query string (prefirmada):
X-Amz-Algorithm,X-Amz-Credential,X-Amz-Date,X-Amz-Expires,X-Amz-SignedHeaders,X-Amz-Signature. El hash del payload esUNSIGNED-PAYLOADy las URL caducadas se rechazan.
El nombre de la región es libre: el servidor toma el scope de la propia petición, así que funcionan tanto us-east-1 como eu-central-1. Una URL prefirmada no es más que una dirección HTTP que lleva su propia firma, de modo que curl, un navegador o un <img src> pueden abrirla. Generé con boto3 una URL de cinco minutos y la obtuve con curl:
import boto3
from botocore.config import Config
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:15703",
                  aws_access_key_id="oxiadmin", aws_secret_access_key="oxisecret123",
                  region_name="us-east-1", config=Config(signature_version="s3v4"))
url = s3.generate_presigned_url("get_object",
        Params={"Bucket": "photos", "Key": "notes/hello.txt"}, ExpiresIn=300)
print(url)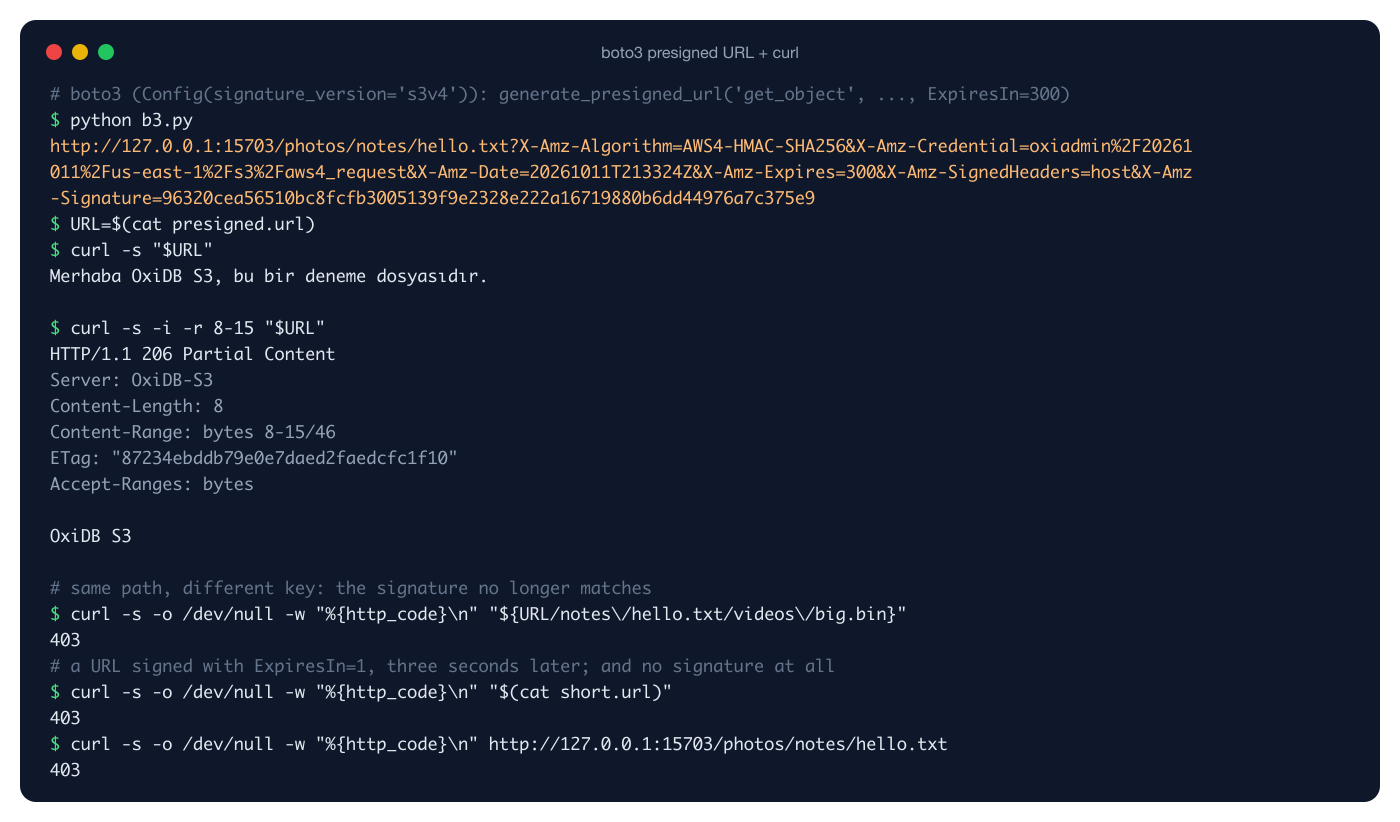
Cada línea de la imagen es salida real: una lectura completa con la URL firmada y un 206 Partial Content con -r 8-15; la misma firma sobre otra clave da 403; una URL firmada con ExpiresIn=1 y usada tres segundos después da 403; una petición sin firmar da 403.
Una trampa: en us-east-1, generate_presigned_url de boto3 todavía puede producir el formato heredado SigV2 (AWSAccessKeyId=...&Signature=...&Expires=...). Es exactamente lo que me pasó en el primer intento. OxiDB solo acepta SigV4, así que hay que darle al cliente Config(signature_version="s3v4").
Unas palabras sobre las credenciales
OXIDB_S3_CREDENTIALS permite definir varias claves, pero son identidades, no permisos. No hay políticas de bucket, ni ACL, ni claves de solo lectura; cualquier clave válida puede hacerlo todo. Lo comprobé borrando un objeto con la clave que se llama literalmente reader:
$ AWS_ACCESS_KEY_ID=reader AWS_SECRET_ACCESS_KEY=readersecret456 aws --endpoint-url $EP s3 rm s3://photos/archive/hello-copy.txt
delete: s3://photos/archive/hello-copy.txt
La ventaja de tener varias claves es dar a cada aplicación la suya y rotarlas de forma independiente. Si se necesita separación de permisos, por ahora hay que resolverla en un proxy inverso o con URL prefirmadas. El RBAC del protocolo wire nativo todavía no se extiende a la capa S3.
Por dentro: cómo se almacenan los objetos
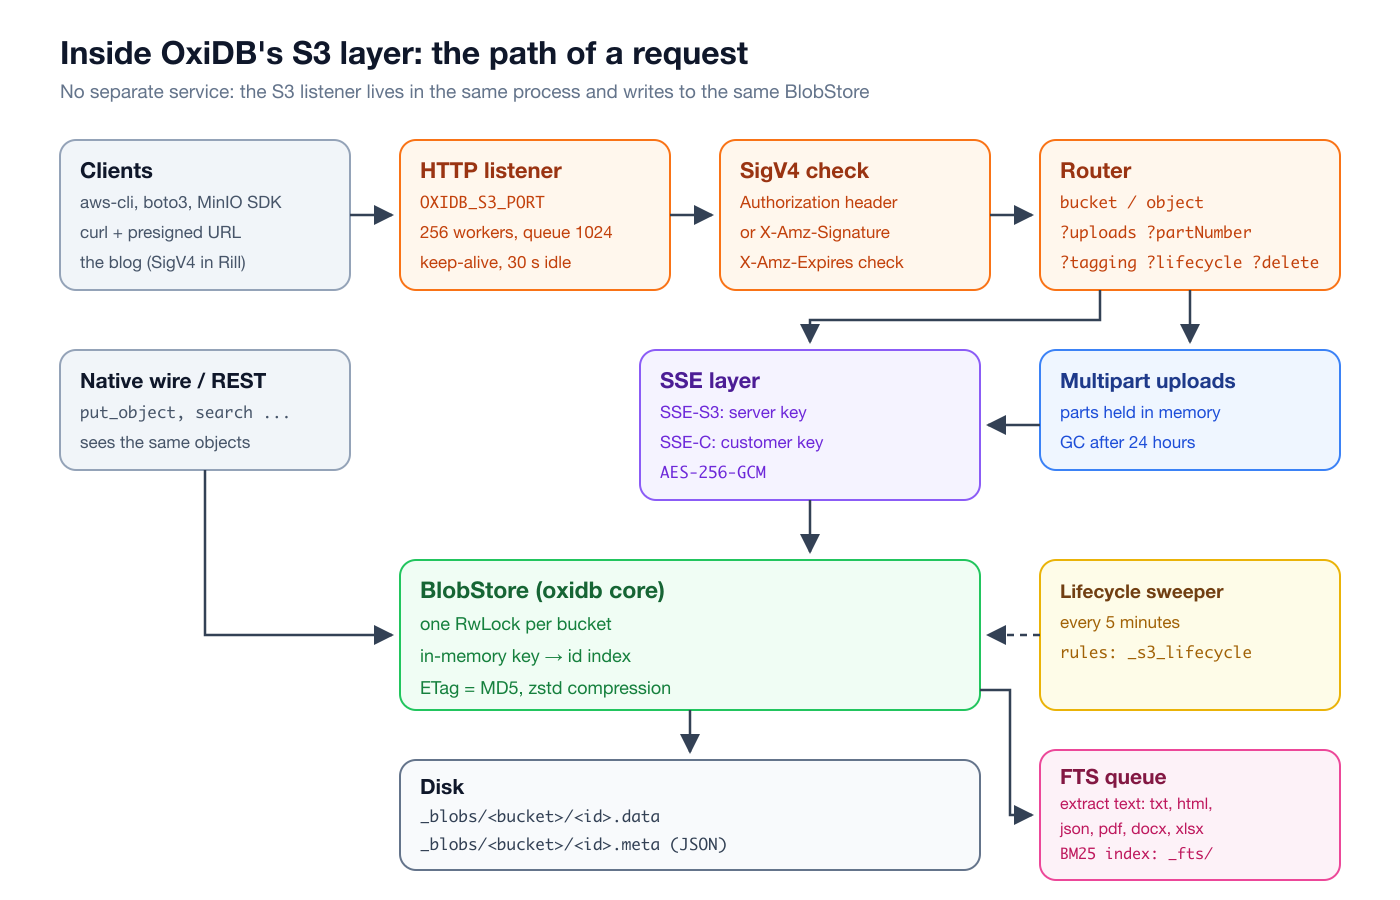
La capa S3 son unas 2.800 líneas de Rust bajo oxidb-server/src/s3/: auth (SigV4), bucket, object, multipart, tagging, lifecycle, encryption, batch y pequeños helpers. El parseo HTTP vive en un crate aparte, oxidb-http, porque el plano de control (oxibase) usa el mismo parser sin enlazar el motor (ADR-0021). El listener ejecuta un pool fijo de 256 hilos worker con una cola acotada de 1024; cuando la cola está llena, las conexiones nuevas se rechazan en lugar de dejar que la memoria crezca sin límite. Las conexiones son keep-alive y se cierran tras 30 segundos de inactividad. Cada worker se ejecuta dentro de catch_unwind, de modo que una sola petición defectuosa no puede tumbar el servidor.
El trabajo real ocurre en el BlobStore del núcleo (src/blob.rs). La disposición en disco es deliberadamente sencilla:
data/oxidb/_blobs/
  photos/
    0.data   0.meta
    1.data   1.meta
  secure/
    0.data   0.meta
Cada objeto son dos archivos hermanos: <id>.data contiene el payload en bruto (o comprimido/cifrado) y <id>.meta es un documento JSON que describe el objeto. <id> es un número interno; la clave del usuario (notes/hello.txt) vive dentro del archivo meta. Así, las barras, los espacios o los caracteres turcos en las claves nunca afectan al sistema de archivos. Al arrancar, el servidor recorre el directorio de cada bucket y construye en memoria los mapas key → id e id → meta; HEAD y LIST se responden desde esos mapas sin tocar el disco. El formato está documentado en docs/format/blob-object.md y forma parte del alcance de estabilidad de la 1.0 (ADR-0003). El archivo meta lleva un format_version, y un lector rechaza una versión más nueva que las que conoce: un cable trampa que impide que un motor antiguo corrompa en silencio datos escritos por uno más nuevo.
Con la compresión activada, los objetos de texto se reducen notablemente. Subí un log de acceso de 219.732 bytes:
{"key":"raw/access.log","bucket":"logs","size":219732,"content_type":"text/plain",
 "etag":"a4094dc3a7fe303056d409f26b951a05","created_at":"2026-10-11T21:34:34Z","metadata":{},
 "storage_compression":"zstd","stored_size":8344,"format_version":1}
Ocupa 8.344 bytes en disco. size es siempre el tamaño en claro, stored_size el espacio usado en disco. El compresor omite los archivos de menos de 256 bytes, el contenido que ahorra menos de un 5 % y los tipos que ya están comprimidos (image/, video/, audio/*, PDF, documentos de Office basados en ZIP, gzip...): recomprimir un JPEG cuesta CPU en cada PUT y GET y no aporta casi nada. Por eso las imágenes de este blog se guardan tal cual.
El viaje de un PUT
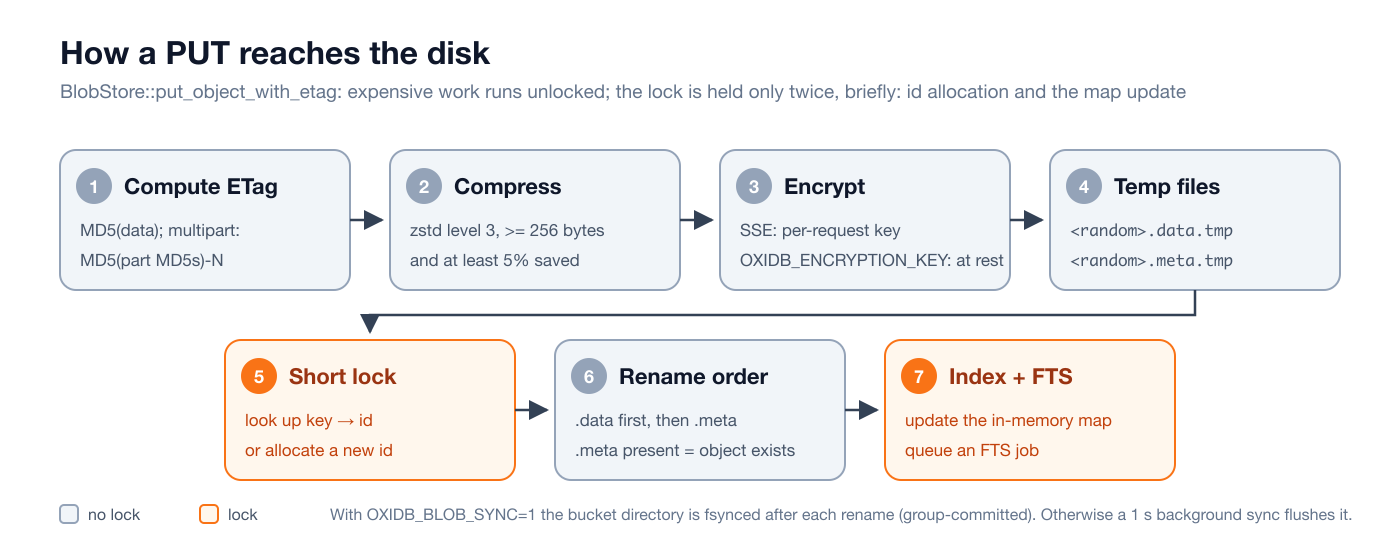
El diseño de put_object_with_etag nació de un problema de concurrencia. En la primera versión, el bloqueo de escritura del bucket se mantenía mientras se renombraban los archivos. En una prueba de carga con 32 escritores concurrentes, la latencia p50 subió a unos 900 ms (la cifra registrada en el CHANGELOG). Ahora el trabajo costoso (MD5, zstd, cifrado, escritura de archivos temporales) se ejecuta sin ningún bloqueo. El bloqueo se toma solo en dos momentos breves: para encontrar o asignar un id para la clave y, al final, para actualizar el mapa en memoria. Los buckets distintos nunca compiten, porque el RwLock exterior protege solo el mapa de buckets y cada bucket tiene su propio RwLock para su estado.
La regla de seguridad ante caídas es simple: si existe el .meta, el objeto existe. Por eso primero se renombra el .data a su sitio y después el .meta. Al arrancar, un .data sin .meta se trata como huérfano y se barre; un .meta sin .data sería una lectura fantasma, y el orden lo impide. Los archivos .meta truncados o imposibles de descifrar no se borran, se ponen en cuarentena.
Hay dos modos de durabilidad. Por defecto, rename solo es atómico a nivel de metadatos, y los bytes llegan al disco mediante una sincronización en segundo plano una vez por segundo o el writeback normal del kernel; un corte de corriente puede perder el último segundo de escrituras. Con OXIDB_BLOB_SYNC=1, los archivos temporales hacen fsync antes de que cada PUT responda, y el directorio del bucket hace fsync entre los dos renombrados y después de ellos. Los fsync de directorio se agrupan (group commit): un hilo dedicado es el dueño del fsync, y 100 PUT concurrentes comparten un único fsync de directorio. Añadí este modo para quienes tratan una escritura exitosa como un commit, como un servidor SMTP que no puede perder un correo al que ya respondió "250 OK". Un arnés de pruebas en Go (tests/blob-crash-recovery-go/) mata el proceso a mitad de una escritura para comprobar la consistencia ante caídas.
En este camino no hay WAL del motor de documentos. Las escrituras de objetos no participan en transacciones de documentos; "guardar el pedido y subir la factura" no es atómico. En la práctica se sube primero el objeto y después se escribe el documento (o al revés, limpiando si algo falla). La restauración a un punto en el tiempo también recupera los blobs solo hasta el punto de la copia base.
El mismo objeto, dos puertas
S3 es solo una puerta. El mismo BlobStore es accesible desde el protocolo wire nativo. Leí el archivo subido por S3 con el cliente Python de OxiDB:
from oxidb import OxiDbClient
db = OxiDbClient("127.0.0.1", 15700)
print(db.list_buckets())
print(json.dumps(db.head_object("photos", "notes/hello.txt"), ensure_ascii=False))
data, meta = db.get_object("photos", "notes/hello.txt")
print(data.decode())
['documents', 'logs', 'many', 'photos', 'secure']
{"key": "notes/hello.txt", "bucket": "photos", "size": 46, "content_type": "text/plain", "etag": "87234ebddb79e0e7daed2faedcfc1f10", "created_at": "2026-10-11T21:32:36Z", "metadata": {"tag-project": "blog", "tag-lang": "tr"}, "stored_size": 46, "format_version": 1}
Merhaba OxiDB S3, bu bir deneme dosyasıdır.En el protocolo nativo el contenido viaja en base64 (put_object, get_object, head_object, list_objects, delete_object, create_bucket ...). Para archivos grandes la puerta S3 es más eficiente, pero poder escribir archivos pequeños por la misma conexión que tus operaciones con documentos resulta práctico.
Buscar dentro de los archivos
Para mí, esta es la parte más valiosa de la capa. Cada PUT deja un trabajo en una cola de FTS después de escribir el objeto. Unos workers en segundo plano miran el Content-Type del objeto, extraen el texto y lo añaden a un índice invertido con ranking BM25; un DELETE lo elimina del índice. Formatos soportados: texto plano y CSV, HTML y XML (sin etiquetas), JSON (todos los valores de cadena, de forma recursiva), PDF, DOCX (word/document.xml), XLSX (xl/sharedStrings.xml) y, con la feature ocr, PNG/JPEG/TIFF/BMP a través de Tesseract.
Subí cuatro archivos con aws-cli: un informe de texto, una nota de versión en HTML, un registro de activo en JSON y un DOCX real generado con textutil de macOS:
aws --endpoint-url $EP s3 mb s3://documents
aws --endpoint-url $EP s3 cp docs/ s3://documents/ --recursive --only-show-errors
aws --endpoint-url $EP s3api list-objects-v2 --bucket documents --query "Contents[].[Key,Size]" --output text
aws --endpoint-url $EP s3api head-object --bucket documents --key minutes.docx --query ContentType --output text
asset.json 107
minutes.docx 3540
page.html 189
rapor.txt 174
application/vnd.openxmlformats-officedocument.wordprocessingml.documentaws-cli deduce el Content-Type a partir de la extensión del archivo y OxiDB elige el extractor en consecuencia. Después, una búsqueda por el protocolo wire:
for q in ("conveyor", "presigned", "november"):
    print(f"search {q!r}:")
    for hit in db.search(q, bucket="documents", limit=5):
        print("  ", json.dumps(hit))
search 'conveyor':
{"bucket": "documents", "key": "asset.json", "score": 0.7813213802071468}
{"bucket": "documents", "key": "minutes.docx", "score": 0.7132708083826534}
{"bucket": "documents", "key": "rapor.txt", "score": 0.4968852822440956}
search 'presigned':
{"bucket": "documents", "key": "page.html", "score": 1.3500054067641225}
search 'november':
{"bucket": "documents", "key": "asset.json", "score": 1.7364027140004965}Con "highlight": true, cada resultado devuelve además fragmentos marcados con <mark>. Para construirlos, el servidor vuelve a leer el archivo coincidente y extrae de nuevo su texto, así que esto solo ocurre cuando se pide:
{"cmd": "search", "query": "conveyor", "bucket": "documents", "limit": 3, "highlight": true}{"ok": true, "data": [
{"bucket": "documents", "key": "asset.json", "score": 0.7813213802071468, "highlights": ["<mark>conveyor</mark> belt installed in warehouse B inspectio"]},
{"bucket": "documents", "key": "minutes.docx", "score": 0.7132708083826534, "highlights": ["Meeting minutes: the board approved the <mark>conveyor</mark> upgrade budget for the Istanbul warehou"]},
{"bucket": "documents", "key": "rapor.txt", "score": 0.4968852822440956, "highlights": ["nventory turnover improved, and the new <mark>conveyor</mark>\nsystem reduced picking time. Next quart"]}
]}Es decir, se sube un documento de Word con un cliente S3 estándar y se encuentra por una palabra que contiene, sin Elasticsearch, trigger de Lambda ni pipeline de ETL de por medio. La estructura del índice, los parámetros de BM25 (OXIDB_FTS_K, OXIDB_FTS_B), el soporte de idiomas y cómo se combina con la búsqueda vectorial los cuento en el artículo sobre búsqueda de texto completo y vectorial. La indexación es asíncrona, así que una búsqueda lanzada justo después de que responda un PUT puede no encontrar el archivo nuevo por unos milisegundos.
Cómo usa este blog OxiDB S3
Cuando subo una imagen desde el panel de administración del blog, el servidor genera un UUID, hace PUT del archivo en el bucket blog-media bajo img/<uuid>.<ext>, y las páginas sirven la imagen a través de esa clave. El blog está escrito en Rill, mi propio lenguaje, y su cliente S3 también: src/s3.rill es un archivo de 140 líneas que contiene una implementación de SigV4 con SHA-256, la cadena HMAC y la petición canónica. Así, el verificador SigV4 de OxiDB se pone a prueba cada día no solo con boto3, sino con una tercera implementación escrita desde cero. El mismo proceso de OxiDB guarda los artículos del blog en el motor SQL, su índice de búsqueda en el motor de documentos, sus sesiones, contadores y caché de páginas en OxiMem, y sus imágenes en S3: un directorio de datos, una copia de seguridad.
Límites y una valoración honesta
Esta capa no compite con MinIO ni con Ceph. Responde a la necesidad de que "los archivos de mi aplicación estén junto a mi base de datos y las herramientas estándar puedan verlos". Lo que conviene saber:
| Tema | Estado |
|---|---|
| Direccionamiento | Solo path-style (/bucket/key). Sin virtual-hosted style (bucket.host). |
| Memoria | Los cuerpos de los PUT, las partes de multipart y las respuestas de GET se almacenan por completo en búfer. El límite del cuerpo HTTP es 5 GiB. |
| Range | Se lee el objeto entero y luego se recorta. |
| Multipart | Las partes están en memoria; las subidas a medio terminar se pierden al reiniciar. |
| Permisos | No hay diferencia entre claves; sin políticas ni ACL. |
| Versionado | Sin versionado de objetos, object lock ni replicación. |
| Ciclo de vida | Solo Expiration/Days, una regla por bucket. |
| SSE | El tamaño y el ETag reflejan el texto cifrado; una clave SSE-C incorrecta da 500. |
| Listado | Bug de continuación a partir de 2000 objetos (ver arriba); ListBuckets devuelve una fecha de creación fija. |
| Condiciones | If-Modified-Since es igualdad de cadenas, no una comparación de fechas. |
| Transacciones | Las escrituras de objetos no se unen a las transacciones de documentos. |
Lo que se obtiene a cambio: ningún servicio aparte, aws-cli/boto3/los SDK de MinIO funcionando sin modificaciones, ETag que coinciden exactamente con los de S3 (donde muchos servidores "compatibles con S3" tropiezan), SigV4 real y URL prefirmadas, cada documento subido buscable automáticamente, y los objetos respaldados en el mismo directorio de datos que tus documentos, tablas SQL y series temporales.
Pruébalo
OxiDB se puede descargar como binario precompilado para macOS y Linux (arm64 y x86_64) desde la página de releases de GitHub, o construir una imagen con el Dockerfile de la raíz del repositorio. Para activar la capa S3 bastan OXIDB_S3_PORT y un par de claves; después, basta con pasar --endpoint-url al cliente S3 que ya se use. El próximo artículo trata sobre la capa de mensajería MQTT y AMQP de OxiDB, donde volverá a aparecer la misma idea: los clientes estándar se conectan sin modificaciones y los datos se quedan en el mismo proceso.