OxiDB の S3 互換オブジェクトストレージ:aws-cli と boto3 が無改造で接続できる
OxiDB の S3 レイヤーを紹介します。マルチパート、range 読み取りと条件付き読み取り、SSE-S3/SSE-C、SigV4 と presigned URL、ライフサイクル、blob のディスク上の配置、アップロードしたファイル内の全文検索。すべて実際のセッションで示します。
アプリケーションが成長すると、データベースの隣には必ず同じ客がやってきます。ファイルです。ユーザーのアバター、PDF の請求書、バックアップ、ログのアーカイブ、ブログの画像。たいていのチームはそのために別のオブジェクトストレージ(AWS S3、MinIO、Ceph)を立ち上げ、気づけば1つではなく2つのシステムのバックアップ、認証情報、監視、アップグレードを管理することになります。OxiDB では、その客を同じ家に住まわせることにしました。サーバーに OXIDB_S3_PORT を与えると、S3 HTTP API を話すリスナーが開きます。aws-cli、boto3、MinIO SDK は変更なしで接続できます。別の endpoint_url を指定するだけです。この記事では、このレイヤーが何をするのか、どう動くのか、オブジェクトをディスク上にどう配置するのか、そしてまだ S3 に及ばない点はどこかを、すべて実際のセッションとともに紹介します。
まず小さな補足です。いまお読みのブログの画像は、まさにこのレイヤーに置かれています。ブログサーバーは blog-media というバケットに img/<uuid>.<ext> のようなキーで書き込み、私が Rill で書いた小さな SigV4 署名器でリクエストに署名しています。以下はすべて、このページを配信しているサーバーで毎日動いているコードです。
なぜデータベースの中に S3 なのか?
S3 API は、オブジェクトストレージの事実上の共通語になりました。バックアップツール、CDN、静的サイトジェネレーター、ML パイプライン、どれも S3 を話します。ですから「OxiDB には独自の blob コマンドがある」だけでは不十分でした。既存のツールが一切の変更なしに接続できる必要がありました。
同時に、オブジェクトを別のシステムに置くことには現実的なコストがあります。
- バックアップも復元計画も2つ。 データベースの
orders行と S3 にある請求書 PDF は別々のタイミングでバックアップされ、復元後に一致しないことがあります。 - 認証システムも2つ。 片方にはデータベースユーザー、もう片方には IAM キー。
- 検索は別世界。 PDF の中を検索するには、たいてい3つ目のシステム(Elasticsearch、OpenSearch)と ETL パイプラインが必要です。
OxiDB の S3 レイヤーは、コアの BlobStore の上にかぶせた薄い HTTP の殻です。ネイティブのワイヤープロトコルの put_object コマンドで書いたオブジェクトは S3 経由で読めますし、S3 経由でアップロードした PDF は数ミリ秒後には全文検索に現れます。同じデータディレクトリ、同じプロセス、同じバックアップです。
有効化と設定
S3 レイヤーはデフォルトでオフで、有効にするにはポートを指定するだけです。この記事のために、サーバーを次のように起動しました(Apple M シリーズの Mac 上の OxiDB 0.44.2、すべてローカル)。
OXIDB_ADDR=127.0.0.1:15700 \
OXIDB_DATA=./data \
OXIDB_S3_PORT=15703 \
OXIDB_S3_CREDENTIALS="oxiadmin:oxisecret123,reader:readersecret456" \
OXIDB_S3_ENCRYPTION_KEY=000102030405060708090a0b0c0d0e0f101112131415161718191a1b1c1d1e1f \
OXIDB_BLOB_COMPRESS=1 \
./oxidb-server
起動ログには、何が有効になっているかがはっきり出ます。
oxidb-server listening on 127.0.0.1:15700 (pool_size=4, data_dir=.../data, idle_timeout=0s)
[s3] authentication enabled (2 credential(s))
[s3] server-side encryption enabled (SSE-S3)
[s3] thread pool: 256 workers, queue depth 1024
S3-compatible API listening on 0.0.0.0:15703
関連する環境変数は次のとおりです。
| 変数 | 役割 |
|---|---|
OXIDB_S3_PORT | S3 HTTP リスナーのポート。未設定ならレイヤーはオフ。 |
OXIDB_S3_ACCESS_KEY / OXIDB_S3_SECRET_KEY | 1組のキーペア。 |
OXIDB_S3_CREDENTIALS | 複数のペア:ak1:sk1,ak2:sk2。1組のペアと併用可能。 |
OXIDB_S3_ENCRYPTION_KEY | SSE-S3 用のサーバーキー。16進数 64 文字(32 バイト)。 |
OXIDB_S3_DEFAULT_ENCRYPTION | true なら、暗号化ヘッダーのない PUT もすべてサーバーキーで暗号化。 |
OXIDB_BLOB_COMPRESS | 1 なら、適したオブジェクトを zstd 圧縮して保存。 |
OXIDB_BLOB_SYNC | 1 なら、PUT/DELETE のたびに戻る前に fsync。 |
重要な詳細がいくつかあります。
- 認証情報がないと S3 API は誰にでも開放されます。 サーバーはそれを大声で知らせます:
[s3] WARNING: authentication DISABLED, S3 API is open to anyone!(実際のログ行)。黙ってドアを開けっぱなしにするより、うるさいほうを選びました。 - リスナーは
0.0.0.0にバインドするので、OXIDB_ADDRでワイヤーポートを localhost に限定しても S3 は限定されません。本番環境ではファイアウォールかリバースプロキシの背後に置いてください。 - S3 はドキュメントエンジンに支えられたリスナーです。
OXIDB_DOC=0でドキュメントエンジンを無効にしたうえでOXIDB_S3_PORTも設定すると、サーバーは "S3 buckets are stored as document-engine blobs" と言って起動を拒否します。ライフサイクルルールなど一部の状態はドキュメントコレクションにあるからです。 - マルチデータベース対応が入ったとき、S3 バケットは意図的にグローバルのままにしました(ADR-0012)。S3 のセマンティクスではバケットの名前空間は1つで、S3 レイヤーは常にデフォルトデータベース(
data/oxidb/)に書き込みます。
バケットはどうやって生まれるのか?
バケット専用の設定はありません。バケットは PUT /bucket で作るか、単にそこへオブジェクトを書き込めば作られます。BlobStore::put_object は存在しないバケットをその場で作成します。バケット名はディスク上のディレクトリになるので検証されます。..、/、さらには単独の . も拒否されます(. はかつてすべてのチェックを通過し、_blobs のルートに解決されていました。修正は CHANGELOG に記録されています)。
無改造のクライアントで最初のセッション:aws-cli
マシンに aws-cli が入っていなかったので、作業ディレクトリ内の venv に pip install awscli boto3 でインストールしました(aws-cli 1.46.1、boto3 1.43)。プラグインもパッチもなく、--endpoint-url だけです。
export AWS_ACCESS_KEY_ID=oxiadmin AWS_SECRET_ACCESS_KEY=oxisecret123 AWS_DEFAULT_REGION=us-east-1
export EP=http://127.0.0.1:15703
echo "Merhaba OxiDB S3, bu bir deneme dosyasıdır." > hello.txt
aws --endpoint-url $EP s3 mb s3://photos
aws --endpoint-url $EP s3 cp hello.txt s3://photos/notes/hello.txt
aws --endpoint-url $EP s3 ls s3://photos --recursive
aws --endpoint-url $EP s3api head-object --bucket photos --key notes/hello.txt
md5 -q hello.txt
make_bucket: photos
upload: ./hello.txt to s3://photos/notes/hello.txt
2026-10-12 00:32:25 46 notes/hello.txt
{
"AcceptRanges": "bytes",
"LastModified": "Sun, 11 Oct 2026 21:32:25 GMT",
"ContentLength": 46,
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"ContentType": "text/plain",
"Metadata": {}
}
87234ebddb79e0e7daed2faedcfc1f10ETag がファイルの MD5 とまったく同じであることに注目してください。小さな詳細に見えますが、その裏には物語があり、あとで触れます。間違ったシークレットキーの場合は次のとおりです。
$ AWS_SECRET_ACCESS_KEY=wrong aws --endpoint-url $EP s3 ls s3://photos

An error occurred (AccessDenied) when calling the ListObjectsV2 operation: Access Denied
オブジェクト操作:Put、Get、Head、Delete、Copy
サポートしている範囲は、アプリケーションが実際に使う S3 の部分です。
| 操作 | HTTP | 備考 |
|---|---|---|
| ListBuckets | GET / | |
| CreateBucket / DeleteBucket / HeadBucket | PUT, DELETE, HEAD /bucket | |
| ListObjectsV2 | GET /bucket?list-type=2 | prefix、delimiter、max-keys、continuation-token、start-after |
| PutObject | PUT /bucket/key | x-amz-meta-* ユーザーメタデータ、aws-chunked ボディのデコード |
| GetObject | GET /bucket/key | Range、If-Match、If-None-Match、If-Modified-Since、If-Unmodified-Since |
| HeadObject | HEAD /bucket/key | |
| DeleteObject | DELETE /bucket/key | 存在しなくても 204(S3 と同様) |
| DeleteObjects | POST /bucket?delete | 一括削除 |
| CopyObject | PUT + x-amz-copy-source | COPY/REPLACE メタデータディレクティブ、条件付きコピー |
| Multipart | ?uploads, ?partNumber&uploadId, ?uploadId | 開始、パートのアップロード、完了、中止 |
| Tagging | GET/PUT/DELETE ?tagging | |
| Lifecycle | GET/PUT/DELETE /bucket?lifecycle | Expiration/Days のみ |
aws-cli でのコピーとタグ付け:
aws --endpoint-url $EP s3api copy-object --bucket photos --key archive/hello-copy.txt --copy-source photos/notes/hello.txt
aws --endpoint-url $EP s3api put-object-tagging --bucket photos --key notes/hello.txt \
    --tagging "TagSet=[{Key=project,Value=blog},{Key=lang,Value=tr}]"
aws --endpoint-url $EP s3api get-object-tagging --bucket photos --key notes/hello.txt
{
"CopyObjectResult": {
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"LastModified": "2026-10-11T21:32:36Z"
}
}
{
"TagSet": [
{ "Key": "project", "Value": "blog" },
{ "Key": "lang", "Value": "tr" }
]
}タグは独立した構造ではなく、tag- プレフィックス付きでオブジェクトのメタデータに入っています。副作用として、同じオブジェクトへの GET は、それらを x-amz-meta-tag-project のようなユーザーメタデータヘッダーとしても返します(下の range の出力で確認できます)。タグを書き込むとオブジェクトも書き直されるので、LastModified が変わります。単純さを優先しましたが、知っておく価値はあります。
aws-chunked:boto3 の不意打ち
最近の aws-cli と boto3 は、デフォルトで PUT のボディを「aws-chunked」フレーミングで包んで送ります。各チャンクの前に16進数のサイズ行があり、末尾にはオプションでチェックサムのトレーラーが付きます。初期のバージョンはこのフレーミングをデコードしていなかったので、4000;chunk-signature=... のような行が保存されたオブジェクトの中に入り込んでいました。アップロードは成功し、ETag も返ってくるのに、ダウンロードするとゴミになっていたのです。現在は、リクエストに content-encoding: aws-chunked か x-amz-content-sha256: STREAMING-* があれば、単一の PUT でもマルチパートのパートでもボディをほどいています。
ListObjectsV2:プレフィックス、デリミター、継続
オブジェクトストレージにフォルダはなく、/ を含むキーがあるだけです。フォルダの錯覚は prefix と delimiter パラメーターから生まれます。boto3 で3日分のログファイルをアップロードし、一覧を取ってみました。
import boto3
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:15703",
                  aws_access_key_id="oxiadmin", aws_secret_access_key="oxisecret123",
                  region_name="us-east-1")

s3.create_bucket(Bucket="logs")
for day in ("2026-10-10", "2026-10-11", "2026-10-12"):
    for i in range(4):
        s3.put_object(Bucket="logs", Key=f"app/{day}/part-{i}.log", Body=f"{day} line {i}\n".encode())
s3.put_object(Bucket="logs", Key="README.txt", Body=b"logs bucket")

r = s3.list_objects_v2(Bucket="logs", Delimiter="/")
print("top level  :", [c["Prefix"] for c in r.get("CommonPrefixes", [])], [o["Key"] for o in r.get("Contents", [])])
r = s3.list_objects_v2(Bucket="logs", Prefix="app/", Delimiter="/")
print("under app/ :", [c["Prefix"] for c in r.get("CommonPrefixes", [])])

page, token = 1, None
while True:
    kw = dict(Bucket="logs", Prefix="app/", MaxKeys=5)
    if token: kw["ContinuationToken"] = token
    r = s3.list_objects_v2(**kw)
    print(f"page {page}: KeyCount={r['KeyCount']} IsTruncated={r['IsTruncated']} "
          f"first={r['Contents'][0]['Key'] if r.get('Contents') else None} next={r.get('NextContinuationToken')}")
    if not r["IsTruncated"]: break
    token, page = r["NextContinuationToken"], page + 1
top level : ['app/'] ['README.txt']
under app/ : ['app/2026-10-10/', 'app/2026-10-11/', 'app/2026-10-12/']
page 1: KeyCount=5 IsTruncated=True first=app/2026-10-10/part-0.log next=app/2026-10-11/part-0.log
page 2: KeyCount=5 IsTruncated=True first=app/2026-10-11/part-1.log next=app/2026-10-12/part-1.log
page 3: KeyCount=2 IsTruncated=False first=app/2026-10-12/part-2.log next=Noneご覧のとおり、NextContinuationToken は不透明ではなく、最後に返されたキーそのものです。これは意図的です。キーはソートされているので、「最後に見たキーより大きいもの全部」でページングするほうが、オフセットでページングするより安定します。2つのページの間にアップロードや削除があっても、キーが2回現れたり消えたりすることはありません。continuation-token と start-after が同じ振る舞いをするのもそのためです。
この記事を書きながら見つけたバグ
もっと大きなバケットでも継続を試したくなりました。2500 個のオブジェクトをアップロードし(32 スレッドで 1.66 秒)、boto3 純正のページネーターで一覧を取りました。
pages = s3.get_paginator("list_objects_v2").paginate(Bucket="many")
counts = [p["KeyCount"] for p in pages]
print("pages:", counts, "total listed:", sum(counts))
put 2500 objects in 1.66s
pages: [1000, 1000, 0] total listed: 20002500 個のうち 2000 個しか一覧に出ませんでした。原因は bucket.rs にあります。S3 レイヤーはまずコアから先頭の max_keys + 1000 個のキーを取得し、そのあとで continuation-token のフィルターを適用しているのです。2000 番目より後ろのキーは一切届かず、3ページ目は IsTruncated=false で空のまま返り、クライアントは一覧が完了したと判断します。修正は簡単です。コアにはすでに list_objects_from(bucket, prefix, after, limit) があり、S3 レイヤーはそれを呼ぶだけでよいからです。次のリリースまでは、2000 個を超えるオブジェクトを持つバケットの完全な一覧は信用しないでください。隠すよりも、はっきり言うほうを選びます。それもこのシリーズの目的のひとつです。
条件付き読み取りと部分読み取り
GetObject は ETag ベースの条件をサポートしています。キャッシュを持つクライアントは手元の ETag を If-None-Match で送り、何も変わっていなければボディのない 304 を受け取ります。
head = s3.head_object(Bucket="logs", Key="README.txt")
etag = head["ETag"]
print("etag:", etag, "md5:", hashlib.md5(b"logs bucket").hexdigest())
s3.get_object(Bucket="logs", Key="README.txt", IfNoneMatch=etag)      # ClientError
s3.get_object(Bucket="logs", Key="README.txt", IfMatch='"deadbeef"')  # ClientError
s3.get_object(Bucket="logs", Key="README.txt", IfMatch=etag)["Body"].read()
etag: "4a88ebb9d3237052e83f9445adba8d2c" md5: 4a88ebb9d3237052e83f9445adba8d2c
If-None-Match same etag -> 304
If-Match wrong etag -> 412 PreconditionFailed
If-Match right etag -> b'logs bucket'Range リクエストは bytes=a-b、bytes=a-、そしてサフィックス形式の bytes=-n で動作し、満たせない範囲には 416 を返します。aws-cli で先頭 7 バイトを取得します。
aws --endpoint-url $EP s3api get-object --bucket photos --key notes/hello.txt --range bytes=0-6 part.txt && cat part.txt{
"AcceptRanges": "bytes",
"ContentLength": 7,
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"ContentRange": "bytes 0-6/46",
"ContentType": "text/plain",
"Metadata": { "tag-project": "blog", "tag-lang": "tr" }
}
Merhaba正直な注意点が2つあります。1つ目に、range 読み取りはオブジェクト全体をディスクから読み込み(必要なら復号・展開し)、そのあとで切り出します。5 GB の動画の最後の 1 MB でも、5 GB 分の読み込みコストがかかります。暗号化と圧縮はファイル全体に対して行われるので、チャンク化された AEAD なしでは本当のシークはできません。2つ目に、If-Modified-Since と If-Unmodified-Since は日付を比較せず、HTTP の日付文字列が完全に一致するかを比較します。ブラウザのように Last-Modified をそのまま送り返すクライアントには機能しますが、「この日付より後に変更された」を表現することはできません。ETag ベースの条件は完全です。
マルチパートアップロードと ETag の物語
aws-cli は、デフォルトで 8 MB を超えるファイルをマルチパートでアップロードします。20 MB のランダムなファイルの場合:
head -c 20971520 /dev/urandom > big.bin
aws --endpoint-url $EP s3 cp big.bin s3://photos/videos/big.bin --only-show-errors
aws --endpoint-url $EP s3api head-object --bucket photos --key videos/big.bin --query "[ContentLength,ETag]" --output text
aws --endpoint-url $EP s3 cp s3://photos/videos/big.bin big.back --only-show-errors && cmp big.bin big.back && echo identical
20971520 "e90e5924e8af5f366537d93f2dfc780e-3"
identicalETag の末尾の -3 は、オブジェクトが3つのパート(8 + 8 + 4 MB)でアップロードされたことを示しています。S3 はマルチパートオブジェクトの ETag をオブジェクトの MD5 としては定義していません。各パートの生の 16 バイト MD5 ダイジェストを連結し、その MD5 を取り、-<パート数> を付け加えます。OxiDB はまさにそのとおりに計算し、各パートのアップロードには、そのパートの16進数 MD5 を ETag として返します。
これがなぜ重要かは、痛い目にあって学びました。シングルパートの ETag は、かつて SHA-256 の先頭 16 バイトでした。16進数で 32 文字、MD5 とまったく同じ形です。AWS SDK for .NET は送信したものの MD5 を計算してレスポンスの ETag と比較し、一致しなければアップロードが壊れたとみなして例外を投げます。MD5 のように見えて MD5 ではないタグは、何にも見えないタグより悪い結果になりました。クライアントはそれが方式の違いだとは判断できず、データが壊れたと結論づけたのです。マルチパートのパートの ETag も、一時期は CRC32(32 文字ではなく 8 文字の16進数)でした。現在はどちらも S3 の定義に従っており、s3_etag.rs のテストがそれを守っています。MD5 は署名としては破られていますが、ETag は署名ではなく、バイト列を識別するものです。
マルチパートには明確な制限があります。パートは最大 10,000 個、1回のアップロードで合計 5 GiB まで、未完了のアップロードは 24 時間後にバックグラウンドスレッドが片付けます。重要な正直な注意点がひとつあります。送信途中のパートはメモリ上に保持されます。サーバーが再起動すると、途中までのマルチパートアップロードは失われ(クライアントが再アップロードします)、大きなアップロードが同時に多数走ると、そのパートの合計分だけ RAM 使用量が増えます。ブログの画像やドキュメントなら問題ありませんが、数テラバイトの動画アーカイブには OxiDB S3 は適したツールではありません。
ライフサイクル:オブジェクトの有効期限
ログや一時ファイルのバケットで最も要望が多い機能は、古いオブジェクトの自動削除です。OxiDB は S3 ライフサイクル設定のうち最もよく使われるサブセット、Expiration/Days をサポートしています。
s3.put_bucket_lifecycle_configuration(Bucket="secure", LifecycleConfiguration={
    "Rules": [{"ID": "expire-old", "Status": "Enabled", "Filter": {"Prefix": ""},
               "Expiration": {"Days": 30}}]})
print("lifecycle  :", s3.get_bucket_lifecycle_configuration(Bucket="secure")["Rules"])
lifecycle : [{'Expiration': {'Days': 30}, 'ID': 'secure-expiration', 'Status': 'Enabled'}]ルールは _s3_lifecycle というドキュメントコレクションに保存されるので、再起動しても残り、OxiDB の他の部分と同じ WAL を通ります。バックグラウンドのスイーパーが5分に1回すべてのルールを読み、created_at が Days 日より古いオブジェクトを削除します。
30 日待たずに動作を確かめるために、少しズルをしました。自分のデータディレクトリで invoice.txt オブジェクトの .meta ファイルの created_at を 2026-08-01T09:00:00Z に書き換え(meta ファイルはただの JSON です。詳しくは後述)、サーバーを再起動して5分待ちました。
$ aws --endpoint-url $EP s3 ls s3://secure
2026-10-12 00:33:04         48 diary.txt
2026-08-01 12:00:00         54 invoice.txt
5分後、サーバーログに1行だけ現れ、オブジェクトは消えていました。
[s3] lifecycle expired 1 objects

$ aws --endpoint-url $EP s3 ls s3://secure
2026-10-12 00:33:04         48 diary.txt
制限:ルールはバケットごとに1つ、XML 内の最初の <Days> の値が使われ、Filter/Prefix とルールの ID は無視され(GET は ID を <bucket>-expiration として返します)、トランジションやバージョン付きオブジェクトのルールはありません。
暗号化:SSE-S3 と SSE-C
互いに独立した2つの暗号化レイヤーがあり、混同しないように注意が必要です。
- 保存時の暗号化(
OXIDB_ENCRYPTION_KEY):blob の.dataと.metaファイルを含め、OxiDB のデータディレクトリ全体を AES-256-GCM で暗号化します。S3 クライアントがそれを知ることはありません。 - S3 サーバーサイド暗号化(SSE):S3 のヘッダーでリクエストごとに選びます。
SSE-S3 ではキーはサーバーのもの(OXIDB_S3_ENCRYPTION_KEY)で、クライアントは x-amz-server-side-encryption: AES256 を送るだけです。SSE-C ではクライアントがリクエストのたびにキーを送ります。サーバーはそれを決して保存せず、キーなしではオブジェクトを読めません。マルチパートアップロードでは、SSE-C キーは完了までメモリに保持され、そのあと write_volatile でゼロ埋めされます。どちらのモードも、オブジェクトごとにランダムな 12 バイトの nonce を使う AES-256-GCM です。
r = s3.put_object(Bucket="secure", Key="invoice.txt", Body=b"Invoice 2026-114: 1250 EUR",
                  ServerSideEncryption="AES256")
print("SSE-S3 put :", r.get("ServerSideEncryption"))
r = s3.get_object(Bucket="secure", Key="invoice.txt")
print("SSE-S3 get :", r.get("ServerSideEncryption"), r["Body"].read())

key = bytes(range(32))
s3.put_object(Bucket="secure", Key="diary.txt", Body=b"only I can read this",
              SSECustomerAlgorithm="AES256", SSECustomerKey=key)
r = s3.get_object(Bucket="secure", Key="diary.txt", SSECustomerAlgorithm="AES256", SSECustomerKey=key)
print("SSE-C get  :", r["Body"].read())
s3.get_object(Bucket="secure", Key="diary.txt")                       # no key
s3.get_object(Bucket="secure", Key="diary.txt",
              SSECustomerAlgorithm="AES256", SSECustomerKey=os.urandom(32))  # wrong key
SSE-S3 put : AES256
SSE-S3 get : AES256 b'Invoice 2026-114: 1250 EUR'
SSE-C get : b'only I can read this'
SSE-C no key: 400 InvalidRequest
SSE-C wrong key: 500 InternalErrorディスク上は本当に暗号文です。
$ cat data/oxidb/_blobs/secure/0.meta
{"key":"invoice.txt","bucket":"secure","size":54,"content_type":"application/octet-stream",
 "etag":"5ffee1c8d3e340ce03033bb8146f03cf","created_at":"2026-10-11T21:33:04Z",
 "metadata":{"_sse":"AES256"},"stored_size":54,"format_version":1}
$ xxd data/oxidb/_blobs/secure/0.data | head -2
00000000: 8d3b e14e a81f d050 f0f7 ab1e 6cf9 4626  .;.N...P....l.F&
00000010: 7d8c b9e7 50a8 bb02 9de3 0124 f301 fd6f  }...P......$...o
ここで正直な注意点を3つ挙げます。
- サイズと ETag は暗号文を反映します。 SSE レイヤーは BlobStore の上にあるので、コアに届くものはすでに暗号化されています。26 バイトの請求書の場合、HEAD は
ContentLengthを 54(12 バイトの nonce と 16 バイトの GCM タグを加算)と報告しますが、ダウンロードすると 26 バイトが返ります。ETag は暗号文の MD5 です。S3 でも SSE-C オブジェクトの ETag は内容の MD5 ではありませんが、サイズの不一致は私の側の不備です。 - 間違った SSE-C キーには 500 を返します。 AWS はここで 403 を返します。GCM 認証の失敗をクライアントエラーにマッピングする必要があります。
- 暗号化されたオブジェクトは全文インデックスされません。 FTS ワーカーはディスクから暗号化されたバイト列を読むので、テキストを抽出できません。SSE-C ならまさに正しい動作です(サーバーはキーを知りません)が、SSE-S3 では選択の問題です。
SigV4 と presigned URL
認証には AWS Signature Version 4 を使い、2つの形式があります。
- ヘッダー:
Authorization: AWS4-HMAC-SHA256 Credential=<ak>/<date>/<region>/s3/aws4_request, SignedHeaders=..., Signature=...。サーバーは正規リクエスト(メソッド、パス、ソート済みクエリ、署名対象ヘッダー、ペイロードハッシュ)を組み立て直し、AWS4<secret>から日付、リージョン、サービス、aws4_requestの連鎖で署名キーを導出し、定数時間の比較で署名を検証します。 - クエリ文字列(presigned):
X-Amz-Algorithm、X-Amz-Credential、X-Amz-Date、X-Amz-Expires、X-Amz-SignedHeaders、X-Amz-Signature。ペイロードハッシュはUNSIGNED-PAYLOADで、期限切れの URL は拒否されます。
リージョン名は自由です。サーバーはスコープをリクエストから取るので、us-east-1 でも eu-central-1 でも動きます。presigned URL は自分の署名を持ち歩くただの HTTP アドレスなので、curl でもブラウザでも <img src> でも開けます。boto3 で5分間有効な URL を生成し、curl で取得しました。
import boto3
from botocore.config import Config
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:15703",
                  aws_access_key_id="oxiadmin", aws_secret_access_key="oxisecret123",
                  region_name="us-east-1", config=Config(signature_version="s3v4"))
url = s3.generate_presigned_url("get_object",
        Params={"Bucket": "photos", "Key": "notes/hello.txt"}, ExpiresIn=300)
print(url)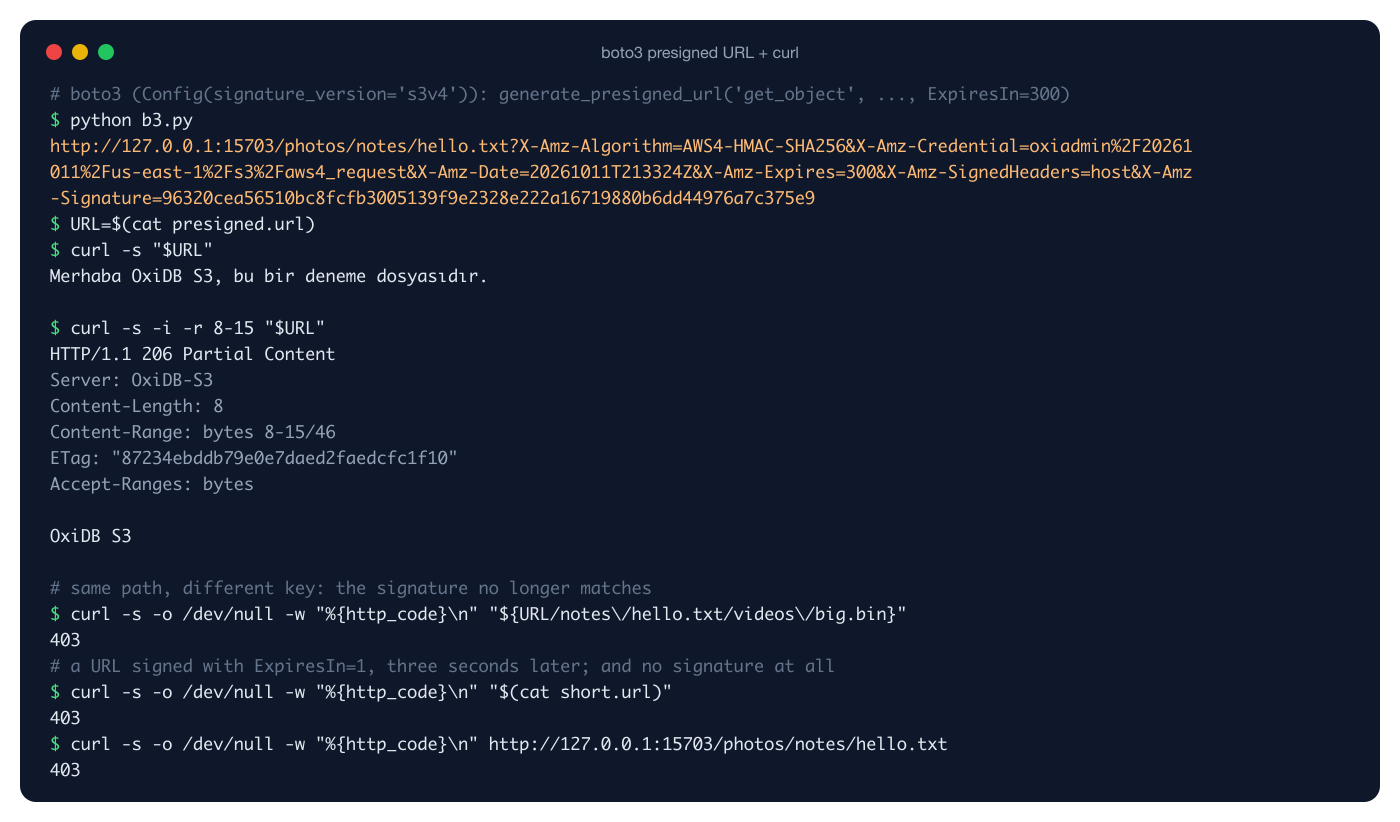
画像の各行はすべて実際の出力です。署名付き URL による完全な読み取りと、-r 8-15 による 206 Partial Content。同じ署名を別のキーに使うと 403。ExpiresIn=1 で署名して3秒後に使った URL も 403。署名のないリクエストも 403 です。
罠がひとつあります。us-east-1 では、boto3 の generate_presigned_url がいまだにレガシーな SigV2 形式(AWSAccessKeyId=...&Signature=...&Expires=...)を生成することがあります。私の最初の試行で起きたのがまさにそれでした。OxiDB は SigV4 しか受け付けないので、クライアントには Config(signature_version="s3v4") を渡してください。
認証情報についてひとこと
OXIDB_S3_CREDENTIALS で複数のキーを定義できますが、それらはアイデンティティであって権限ではありません。バケットポリシーも ACL も読み取り専用キーもなく、有効なキーなら何でもできます。文字どおり reader という名前のキーでオブジェクトを削除して確認しました。
$ AWS_ACCESS_KEY_ID=reader AWS_SECRET_ACCESS_KEY=readersecret456 aws --endpoint-url $EP s3 rm s3://photos/archive/hello-copy.txt
delete: s3://photos/archive/hello-copy.txt
複数キーの利点は、アプリケーションごとに専用のキーを渡し、それぞれ独立にローテーションできることです。権限の分離が必要なら、今のところリバースプロキシか presigned URL で解決してください。ネイティブのワイヤープロトコルにある RBAC は、まだ S3 レイヤーには及んでいません。
内部:オブジェクトはどう保存されるか
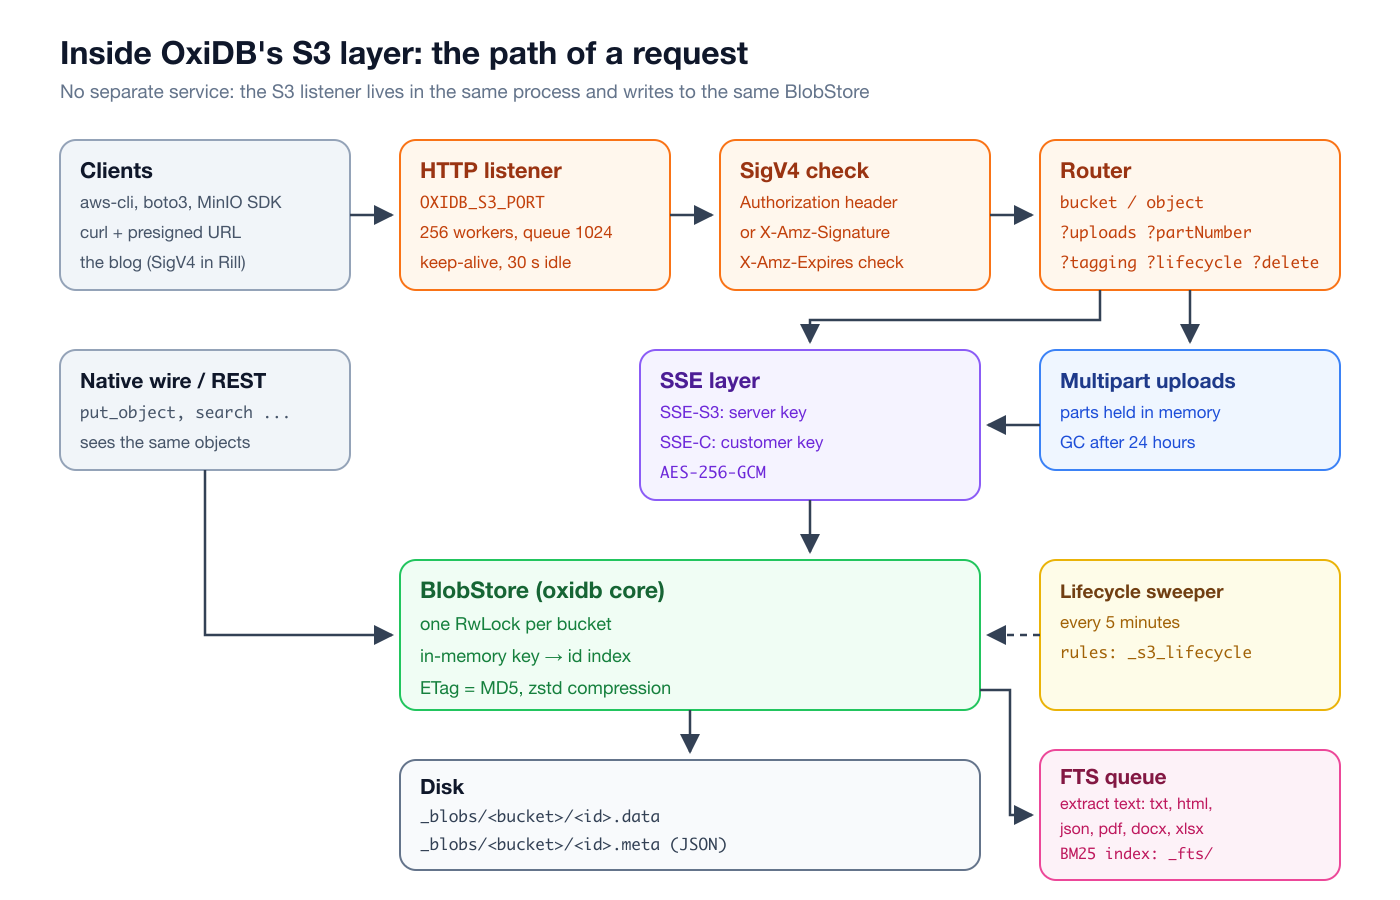
S3 レイヤーは oxidb-server/src/s3/ 以下の約 2,800 行の Rust で、auth(SigV4)、bucket、object、multipart、tagging、lifecycle、encryption、batch と小さなヘルパーからなります。HTTP のパースは別の oxidb-http crate にあります。コントロールプレーン(oxibase)がエンジンをリンクせずに同じパーサーを使うからです(ADR-0021)。リスナーは 256 個のワーカースレッドの固定プールと、上限 1024 の有界キューで動きます。キューが満杯になると、メモリを際限なく増やす代わりに新しい接続を拒否します。接続は keep-alive で、30 秒アイドルが続くと閉じます。各ワーカーは catch_unwind の中で動くので、1つの不正なリクエストでサーバーが落ちることはありません。
実際の仕事はコアの BlobStore(src/blob.rs)で行われます。ディスクレイアウトは意図的に素朴です。
data/oxidb/_blobs/
  photos/
    0.data   0.meta
    1.data   1.meta
  secure/
0.data 0.meta各オブジェクトは隣り合う2つのファイルです。<id>.data は生の(あるいは圧縮・暗号化された)ペイロードを持ち、<id>.meta はオブジェクトを記述する JSON ドキュメントです。<id> は内部の番号で、ユーザーのキー(notes/hello.txt)は meta ファイルの中にあります。そのため、キーに含まれるスラッシュや空白やトルコ語の文字がファイルシステムを煩わせることはありません。起動時にサーバーは各バケットのディレクトリをスキャンし、メモリ上に key → id と id → meta のマップを構築します。HEAD と LIST は、ディスクに触れずにこれらのマップから応答します。フォーマットは docs/format/blob-object.md に文書化されており、1.0 の安定性の範囲に含まれます(ADR-0003)。meta ファイルは format_version を持ち、読み手は自分が知っているより新しいバージョンを拒否します。古いエンジンが新しいエンジンの書いたデータを黙って壊さないようにするための仕掛け線です。
圧縮をオンにすると、テキストのオブジェクトは目に見えて小さくなります。219,732 バイトのアクセスログをアップロードしてみました。
{"key":"raw/access.log","bucket":"logs","size":219732,"content_type":"text/plain",
 "etag":"a4094dc3a7fe303056d409f26b951a05","created_at":"2026-10-11T21:34:34Z","metadata":{},
 "storage_compression":"zstd","stored_size":8344,"format_version":1}
ディスク上では 8,344 バイトです。size は常に平文のサイズ、stored_size はディスク上で使っている容量です。圧縮器は 256 バイト未満のファイル、削減が 5% 未満の内容、すでに圧縮されている形式(image/、video/、audio/*、PDF、ZIP ベースの Office ドキュメント、gzip など)をスキップします。JPEG を再圧縮すると PUT と GET のたびに CPU を食うのに、得るものはほとんどありません。このブログの画像がそのまま保存されているのはそのためです。
PUT の旅
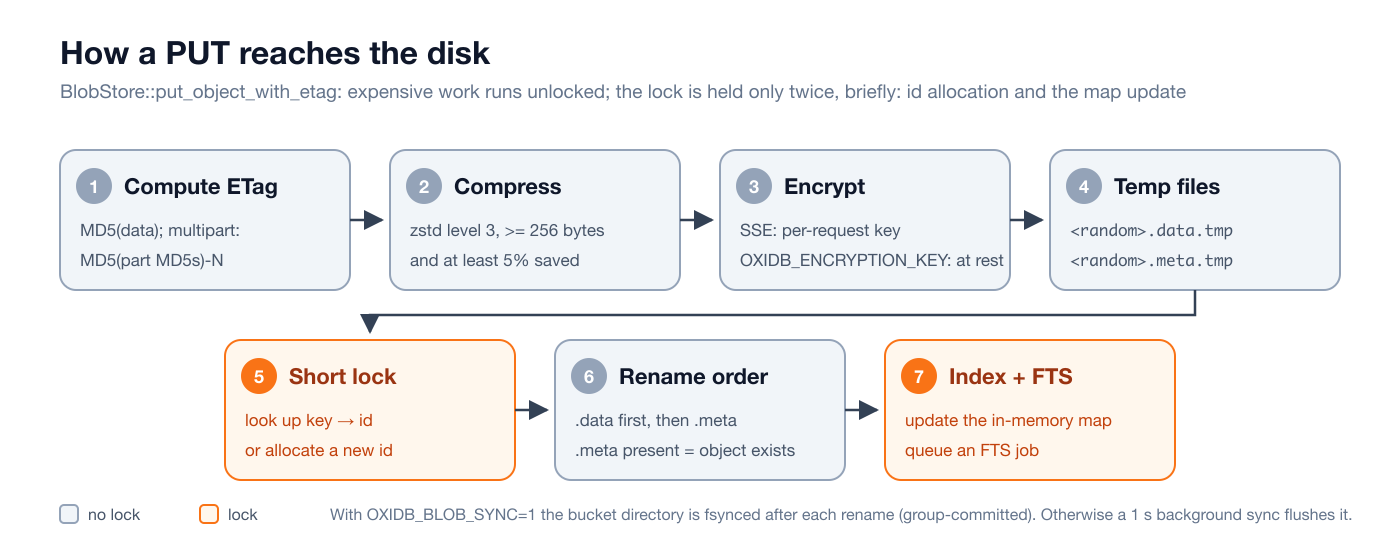
put_object_with_etag の設計は、ある並行性の問題から生まれました。最初のバージョンでは、ファイルを rename する間ずっとバケットの書き込みロックを保持していました。32 の同時書き込みによる負荷テストで、p50 レイテンシは約 900 ms まで上がりました(CHANGELOG に記録されている数値)。現在は、高コストな処理(MD5、zstd、暗号化、一時ファイルの書き込み)はまったくロックなしで実行されます。ロックを取るのは2つの短い瞬間だけです。キーの id を探すか割り当てるとき、そして最後にメモリ上のマップを更新するときです。異なるバケット同士が競合することはありません。外側の RwLock はバケットのマップだけを守り、各バケットは自分の状態のために専用の RwLock を持っているからです。
クラッシュ安全性の規則は単純です。.meta が存在すれば、オブジェクトは存在する。 そのため、まず .data を所定の位置に rename し、次に .meta を rename します。起動時に .meta のない .data は孤児として扱われ、掃除されます。.data のない .meta は幽霊読み取りになってしまいますが、この順序がそれを防ぎます。壊れた .meta や復号できない .meta は削除されず、隔離されます。
耐久性のモードは2つあります。デフォルトでは rename はメタデータとしてアトミックなだけで、バイト列は1秒に1回のバックグラウンド sync かカーネルの通常のライトバックでディスクに届きます。停電すると直近1秒分の書き込みが失われる可能性があります。OXIDB_BLOB_SYNC=1 にすると、各 PUT が戻る前に一時ファイルが fsync され、バケットディレクトリも2回の rename の間とその後に fsync されます。ディレクトリの fsync はグループコミットされます。専用のスレッドが fsync を担当し、100 の同時 PUT が1回のディレクトリ fsync を共有します。このモードは、書き込みの成功をコミットとみなす呼び出し側のために追加しました。たとえば、すでに「250 OK」と応答したメールを失ってはならない SMTP サーバーです。Go のテストハーネス(tests/blob-crash-recovery-go/)が書き込み途中でプロセスを kill し、クラッシュ時の一貫性をチェックしています。
この経路にドキュメントエンジンの WAL はありません。オブジェクトの書き込みはドキュメントのトランザクションに参加しないので、「注文を保存して請求書をアップロードする」はアトミックではありません。実際には、先にオブジェクトをアップロードしてからドキュメントを書きます(あるいは逆の順にして、失敗時に後片付けします)。ポイントインタイムリストアでも、blob はベースバックアップの時点までしか戻りません。
同じオブジェクト、2つの扉
S3 は扉のひとつにすぎません。同じ BlobStore にはネイティブのワイヤープロトコルからも到達できます。S3 経由でアップロードしたファイルを、OxiDB の Python クライアントで読んでみました。
from oxidb import OxiDbClient
db = OxiDbClient("127.0.0.1", 15700)
print(db.list_buckets())
print(json.dumps(db.head_object("photos", "notes/hello.txt"), ensure_ascii=False))
data, meta = db.get_object("photos", "notes/hello.txt")
print(data.decode())
['documents', 'logs', 'many', 'photos', 'secure']
{"key": "notes/hello.txt", "bucket": "photos", "size": 46, "content_type": "text/plain", "etag": "87234ebddb79e0e7daed2faedcfc1f10", "created_at": "2026-10-11T21:32:36Z", "metadata": {"tag-project": "blog", "tag-lang": "tr"}, "stored_size": 46, "format_version": 1}
Merhaba OxiDB S3, bu bir deneme dosyasıdır.ネイティブプロトコルでは内容は base64 で運ばれます(put_object、get_object、head_object、list_objects、delete_object、create_bucket など)。大きなファイルには S3 の扉のほうが効率的ですが、小さなファイルをドキュメント操作と同じ接続で書けるのは便利です。
ファイルの中を検索する
私にとって、これがこのレイヤーで最も価値のある部分です。PUT のたびに、オブジェクトが書き込まれたあと FTS キューにジョブが積まれます。バックグラウンドのワーカーがオブジェクトの Content-Type を見てテキストを抽出し、BM25 でランク付けされる転置インデックスに追加します。DELETE はそれをインデックスから削除します。対応フォーマット:プレーンテキストと CSV、HTML と XML(タグは除去)、JSON(すべての文字列値を再帰的に)、PDF、DOCX(word/document.xml)、XLSX(xl/sharedStrings.xml)、そして ocr フィーチャーを有効にすれば Tesseract による PNG/JPEG/TIFF/BMP です。
aws-cli で4つのファイルをアップロードしました。テキストのレポート、HTML のリリースノート、JSON の資産レコード、そして macOS の textutil で作った本物の DOCX です。
aws --endpoint-url $EP s3 mb s3://documents
aws --endpoint-url $EP s3 cp docs/ s3://documents/ --recursive --only-show-errors
aws --endpoint-url $EP s3api list-objects-v2 --bucket documents --query "Contents[].[Key,Size]" --output text
aws --endpoint-url $EP s3api head-object --bucket documents --key minutes.docx --query ContentType --output text
asset.json 107
minutes.docx 3540
page.html 189
rapor.txt 174
application/vnd.openxmlformats-officedocument.wordprocessingml.documentaws-cli はファイルの拡張子から Content-Type を推測し、OxiDB はそれに応じて抽出器を選びます。続いて、ワイヤープロトコル経由で検索します。
for q in ("conveyor", "presigned", "november"):
    print(f"search {q!r}:")
    for hit in db.search(q, bucket="documents", limit=5):
        print("  ", json.dumps(hit))
search 'conveyor':
{"bucket": "documents", "key": "asset.json", "score": 0.7813213802071468}
{"bucket": "documents", "key": "minutes.docx", "score": 0.7132708083826534}
{"bucket": "documents", "key": "rapor.txt", "score": 0.4968852822440956}
search 'presigned':
{"bucket": "documents", "key": "page.html", "score": 1.3500054067641225}
search 'november':
{"bucket": "documents", "key": "asset.json", "score": 1.7364027140004965}"highlight": true を付けると、各ヒットは <mark> タグ付きのスニペットも返します。それを作るためにサーバーは一致したファイルを読み直してテキストを再抽出するので、要求したときだけ行われます。
{"cmd": "search", "query": "conveyor", "bucket": "documents", "limit": 3, "highlight": true}{"ok": true, "data": [
{"bucket": "documents", "key": "asset.json", "score": 0.7813213802071468, "highlights": ["<mark>conveyor</mark> belt installed in warehouse B inspectio"]},
{"bucket": "documents", "key": "minutes.docx", "score": 0.7132708083826534, "highlights": ["Meeting minutes: the board approved the <mark>conveyor</mark> upgrade budget for the Istanbul warehou"]},
{"bucket": "documents", "key": "rapor.txt", "score": 0.4968852822440956, "highlights": ["nventory turnover improved, and the new <mark>conveyor</mark>\nsystem reduced picking time. Next quart"]}
]}つまり、標準の S3 クライアントで Word ドキュメントをアップロードし、その中の単語で見つけられるわけです。間に Elasticsearch も Lambda トリガーも ETL パイプラインもありません。インデックスの構造、BM25 のパラメーター(OXIDB_FTS_K、OXIDB_FTS_B)、言語サポート、ベクトル検索との組み合わせ方については、全文検索とベクトル検索の記事で扱っています。インデックス作成は非同期なので、PUT が戻った直後に発行した検索では、新しいファイルが数ミリ秒の差で見つからないことがあります。
このブログは OxiDB S3 をどう使っているか
ブログの管理パネルから画像をアップロードすると、サーバーは UUID を生成し、ファイルを blog-media バケットの img/<uuid>.<ext> に PUT し、ページはそのキーを通じて画像を配信します。ブログは私自身の言語である Rill で書かれており、その S3 クライアントも同様です。src/s3.rill は 140 行のファイルで、SHA-256、HMAC の連鎖、正規リクエストを含む SigV4 の実装が入っています。つまり OxiDB の SigV4 検証器は、boto3 だけでなく、ゼロから書かれた3つ目の実装によっても毎日試されているのです。同じ OxiDB プロセスが、ブログの記事を SQL エンジンに、検索インデックスをドキュメントエンジンに、セッション、カウンター、ページキャッシュを OxiMem に、そして画像を S3 に保持しています。データディレクトリは1つ、バックアップも1つです。
制限と正直な評価
このレイヤーは MinIO や Ceph の競合ではありません。「アプリケーションのファイルをデータベースの隣に置き、標準ツールからも見えるようにしたい」というニーズに応えるものです。知っておくべきこと:
| トピック | 状況 |
|---|---|
| アドレッシング | パススタイル(/bucket/key)のみ。仮想ホストスタイル(bucket.host)はなし。 |
| メモリ | PUT のボディ、マルチパートのパート、GET のレスポンスは完全にバッファリングされる。HTTP ボディの上限は 5 GiB。 |
| Range | オブジェクト全体を読んでから切り出す。 |
| マルチパート | パートはメモリ上。途中までのアップロードは再起動で失われる。 |
| 権限 | キーによる違いはなし。ポリシーも ACL もなし。 |
| バージョニング | オブジェクトのバージョニング、オブジェクトロック、レプリケーションはなし。 |
| ライフサイクル | Expiration/Days のみ、バケットごとにルール1つ。 |
| SSE | サイズ/ETag は暗号文を反映。間違った SSE-C キーで 500。 |
| 一覧 | 2000 オブジェクトを超えると継続のバグ(前述)。ListBuckets は固定の作成日を返す。 |
| 条件 | If-Modified-Since は日付比較ではなく文字列の一致。 |
| トランザクション | オブジェクトの書き込みはドキュメントのトランザクションに参加しない。 |
その代わりに得られるもの:別のサービスが不要、aws-cli/boto3/MinIO SDK が無改造で動く、S3 と完全に一致する ETag(多くの「S3 互換」サーバーがつまずくところ)、本物の SigV4 と presigned URL、アップロードしたすべてのドキュメントが自動で検索可能になること、そしてオブジェクトがドキュメント、SQL テーブル、時系列と同じデータディレクトリでバックアップされることです。
試してみる
OxiDB は、macOS と Linux(arm64 と x86_64)向けのビルド済みバイナリとして GitHub のリリースページからダウンロードできます。リポジトリのルートにある Dockerfile でイメージをビルドすることもできます。S3 レイヤーを有効にするには、OXIDB_S3_PORT とキーペア1組で十分です。あとは、すでに使っている S3 クライアントに --endpoint-url を渡すだけです。次の記事は OxiDB の MQTT と AMQP のメッセージングレイヤーについてです。そこでも同じ考え方に再び出会うことになります。標準のクライアントが無改造で接続し、データは同じプロセスの中に留まります。