OxiDB'de S3 uyumlu nesne depolama: aws-cli ve boto3 değişmeden bağlanıyor
OxiDB'nin S3 katmanı: multipart, range ve koşullu okumalar, SSE-S3/SSE-C, SigV4 ve presigned URL'ler, yaşam döngüsü, blob'ların diskte nasıl durduğu ve yüklenen dosyaların içinde tam metin arama. Hepsi gerçek oturumlarla.
Bir uygulama büyüdükçe veritabanının yanına hep aynı misafir gelir: dosyalar. Kullanıcı avatarları, PDF faturalar, yedekler, log arşivleri, blog görselleri. Çoğu ekip bunun için ayrı bir nesne deposu kurar (AWS S3, MinIO, Ceph) ve bir süre sonra iki ayrı sistemin yedeğini, kimlik bilgisini, izlenmesini ve sürüm yükseltmesini yönetmeye başlar. OxiDB'de bu misafiri ayrı bir eve göndermek yerine aynı sürece aldım: OXIDB_S3_PORT verdiğinizde OxiDB, S3 HTTP API'sini konuşan bir dinleyici açıyor. aws-cli, boto3 ve MinIO SDK'ları tek satır değişiklik yapmadan (sadece endpoint_url vererek) bağlanıyor. Bu yazıda bu katmanın ne yaptığını, nasıl çalıştığını, diske nasıl yazdığını ve nerede S3'ün gerisinde kaldığını gerçek oturumlarla anlatacağım.
Küçük bir not: okuduğunuz blogun görselleri de tam olarak bu katmanda duruyor. Blog sunucusu, blog-media adlı bucket'a img/<uuid>.<uzantı> anahtarlarıyla yazıyor ve istekleri Rill dilinde yazdığım küçük bir SigV4 imzalayıcıyla imzalıyor. Yani aşağıda anlattıklarımın hepsi, bu sayfayı size getiren sunucuda her gün çalışan kod.
Neden veritabanının içinde bir S3?
S3 API'si fiilen nesne depolamanın ortak dili oldu. Yedekleme araçları, CDN'ler, statik site üreticileri, makine öğrenmesi boru hatları, hepsi S3 konuşuyor. Bu yüzden "OxiDB'nin kendi blob komutları var" demek yetmiyordu; mevcut araçların hiçbir değişiklik yapmadan bağlanabilmesi gerekiyordu.
Öte yandan nesneleri ayrı bir sistemde tutmanın bedeli gerçek:
- İki yedek, iki geri yükleme planı. Veritabanındaki
orderssatırı ile S3'teki fatura PDF'i ayrı zamanlarda yedeklenir, geri yüklemede birbirini tutmayabilir. - İki kimlik doğrulama sistemi. Bir yanda veritabanı kullanıcıları, bir yanda IAM anahtarları.
- Arama ayrı bir dünya. PDF'in içinde arama yapmak için çoğu zaman üçüncü bir sistem (Elasticsearch, OpenSearch) ve bir ETL hattı gerekir.
OxiDB'de S3 katmanı, çekirdekteki BlobStore üzerine ince bir HTTP kabuğu. Native wire protokolündeki put_object komutuyla yazdığınız nesneyi S3'ten okuyabiliyorsunuz, S3 ile yüklediğiniz PDF'i birkaç milisaniye sonra tam metin aramada buluyorsunuz. Aynı veri dizini, aynı süreç, aynı yedek.
Etkinleştirme ve yapılandırma
S3 katmanı varsayılan olarak kapalı. Açmak için bir port vermek yeterli. Bu yazı için sunucuyu şöyle başlattım (OxiDB 0.44.2, Apple M serisi bir Mac, her şey yerel):
OXIDB_ADDR=127.0.0.1:15700 \
OXIDB_DATA=./data \
OXIDB_S3_PORT=15703 \
OXIDB_S3_CREDENTIALS="oxiadmin:oxisecret123,reader:readersecret456" \
OXIDB_S3_ENCRYPTION_KEY=000102030405060708090a0b0c0d0e0f101112131415161718191a1b1c1d1e1f \
OXIDB_BLOB_COMPRESS=1 \
./oxidb-server
Sunucunun açılış logu, neyin açık olduğunu açıkça söylüyor:
oxidb-server listening on 127.0.0.1:15700 (pool_size=4, data_dir=.../data, idle_timeout=0s)
[s3] authentication enabled (2 credential(s))
[s3] server-side encryption enabled (SSE-S3)
[s3] thread pool: 256 workers, queue depth 1024
S3-compatible API listening on 0.0.0.0:15703
İlgili ortam değişkenleri:
| Değişken | Ne yapar |
|---|---|
OXIDB_S3_PORT | S3 HTTP dinleyicisinin portu. Verilmezse katman kapalı. |
OXIDB_S3_ACCESS_KEY / OXIDB_S3_SECRET_KEY | Tek bir anahtar çifti. |
OXIDB_S3_CREDENTIALS | Birden çok çift: ak1:sk1,ak2:sk2. İkisi birlikte de kullanılabilir. |
OXIDB_S3_ENCRYPTION_KEY | SSE-S3 için sunucu anahtarı, 64 hex karakter (32 bayt). |
OXIDB_S3_DEFAULT_ENCRYPTION | true ise başlık gönderilmeyen her PUT da sunucu anahtarıyla şifrelenir. |
OXIDB_BLOB_COMPRESS | 1 ise uygun nesneler zstd ile sıkıştırılarak yazılır. |
OXIDB_BLOB_SYNC | 1 ise her PUT/DELETE, dönmeden önce diske fsync edilir. |
Birkaç önemli ayrıntı:
- Kimlik bilgisi vermezseniz S3 herkese açık olur ve sunucu bunu bağırarak söyler:
[s3] WARNING: authentication DISABLED, S3 API is open to anyone!(logdaki gerçek metin). Sessizce açık bırakmak yerine gürültü yapmayı tercih ettim. - Dinleyici
0.0.0.0üzerinde açılıyor, yaniOXIDB_ADDRile wire portunu localhost'a kilitlemeniz S3'ü kilitlemiyor. Üretimde bunu bir güvenlik duvarı veya ters vekil (reverse proxy) arkasına koymak gerekiyor. - S3, belge motoruna yaslanan bir dinleyici.
OXIDB_DOC=0ile belge motorunu kapatıpOXIDB_S3_PORTverirseniz sunucu "S3 buckets are stored as document-engine blobs" diyerek açılmayı reddediyor. Yaşam döngüsü kuralları gibi bazı durumlar belge koleksiyonlarında tutuluyor. - Çoklu veritabanı desteği geldiğinde S3 bucket'larını bilerek global bıraktım (ADR-0012): S3 semantiğinde tek bir bucket ad alanı var ve S3 katmanı her zaman varsayılan veritabanına (
data/oxidb/) yazıyor.
Bucket nasıl oluşur?
Ayrı bir "bucket yapılandırması" yok. PUT /bucket ile ya da doğrudan bir nesne yazarak oluşuyor; BlobStore::put_object var olmayan bucket'ı kendiliğinden yaratıyor. Bucket adları doğrulanıyor: dizin olarak diske yazıldıkları için .., / ve hatta tek başına . reddediliyor (. bütün kontrolleri geçip _blobs köküne çözümleniyordu; CHANGELOG'da bu düzeltmenin kaydı var).
Değiştirilmemiş istemcilerle ilk oturum: aws-cli
Makinede aws-cli kurulu değildi, bu yüzden çıktı dizinindeki bir venv içine pip install awscli boto3 ile kurdum (aws-cli 1.46.1, boto3 1.43). Hiçbir eklenti, hiçbir yama yok; sadece --endpoint-url.
export AWS_ACCESS_KEY_ID=oxiadmin AWS_SECRET_ACCESS_KEY=oxisecret123 AWS_DEFAULT_REGION=us-east-1
export EP=http://127.0.0.1:15703
echo "Merhaba OxiDB S3, bu bir deneme dosyasıdır." > hello.txt
aws --endpoint-url $EP s3 mb s3://photos
aws --endpoint-url $EP s3 cp hello.txt s3://photos/notes/hello.txt
aws --endpoint-url $EP s3 ls s3://photos --recursive
aws --endpoint-url $EP s3api head-object --bucket photos --key notes/hello.txt
md5 -q hello.txt
make_bucket: photos
upload: ./hello.txt to s3://photos/notes/hello.txt
2026-10-12 00:32:25 46 notes/hello.txt
{
"AcceptRanges": "bytes",
"LastModified": "Sun, 11 Oct 2026 21:32:25 GMT",
"ContentLength": 46,
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"ContentType": "text/plain",
"Metadata": {}
}
87234ebddb79e0e7daed2faedcfc1f10ETag'in dosyanın MD5'i ile birebir aynı olduğuna dikkat edin. Bu küçük bir ayrıntı gibi görünüyor ama bir hikayesi var; aşağıda anlatacağım. Yanlış gizli anahtarla deneyince:
$ AWS_SECRET_ACCESS_KEY=wrong aws --endpoint-url $EP s3 ls s3://photos

An error occurred (AccessDenied) when calling the ListObjectsV2 operation: Access Denied
Nesne işlemleri: Put, Get, Head, Delete, Copy
Desteklenen yüzey, S3 uygulamalarının gerçekten kullandığı kısım:
| İşlem | HTTP | Not |
|---|---|---|
| ListBuckets | GET / | |
| CreateBucket / DeleteBucket / HeadBucket | PUT, DELETE, HEAD /bucket | |
| ListObjectsV2 | GET /bucket?list-type=2 | prefix, delimiter, max-keys, continuation-token, start-after |
| PutObject | PUT /bucket/key | x-amz-meta-* kullanıcı metadatası, aws-chunked gövde çözme |
| GetObject | GET /bucket/key | Range, If-Match, If-None-Match, If-Modified-Since, If-Unmodified-Since |
| HeadObject | HEAD /bucket/key | |
| DeleteObject | DELETE /bucket/key | yoksa da 204 (S3 gibi) |
| DeleteObjects | POST /bucket?delete | toplu silme |
| CopyObject | PUT + x-amz-copy-source | COPY/REPLACE metadata yönergesi, koşullu kopya |
| Multipart | ?uploads, ?partNumber&uploadId, ?uploadId | başlat, parça yükle, tamamla, iptal |
| Tagging | GET/PUT/DELETE ?tagging | |
| Lifecycle | GET/PUT/DELETE /bucket?lifecycle | yalnızca Expiration/Days |
Kopyalama ve etiketleme, aws-cli ile:
aws --endpoint-url $EP s3api copy-object --bucket photos --key archive/hello-copy.txt --copy-source photos/notes/hello.txt
aws --endpoint-url $EP s3api put-object-tagging --bucket photos --key notes/hello.txt \
    --tagging "TagSet=[{Key=project,Value=blog},{Key=lang,Value=tr}]"
aws --endpoint-url $EP s3api get-object-tagging --bucket photos --key notes/hello.txt
{
"CopyObjectResult": {
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"LastModified": "2026-10-11T21:32:36Z"
}
}
{
"TagSet": [
{ "Key": "project", "Value": "blog" },
{ "Key": "lang", "Value": "tr" }
]
}Etiketler ayrı bir yapıda değil, nesnenin metadatasında tag- önekiyle duruyor. Bunun bir yan etkisi var: aynı nesneye bir GET yaptığınızda etiketler x-amz-meta-tag-project gibi kullanıcı metadatası başlıkları olarak da görünüyor (aşağıdaki range çıktısında göreceksiniz). Ayrıca etiket yazmak nesneyi yeniden yazıyor, bu yüzden LastModified değişiyor. Basit tuttum, ama bunu bilmek gerekiyor.
aws-chunked: boto3'ün sürprizi
Modern aws-cli ve boto3, PUT gövdelerini varsayılan olarak "aws-chunked" çerçevesiyle gönderiyor: her parçanın başında onaltılık bir boyut satırı, sonunda isteğe bağlı checksum trailer'ları. İlk sürümlerde bu çerçeveyi çözmüyordum ve nesnenin içine 4000;chunk-signature=... satırları da yazılıyordu. Dosya yükleniyor, ETag dönüyor, ama indirdiğinizde içerik bozuk geliyordu. Şimdi content-encoding: aws-chunked veya x-amz-content-sha256: STREAMING-* gördüğünde hem tek PUT'ta hem multipart parçalarında gövde çözülüyor.
ListObjectsV2: önekler, ayraç ve sayfalama
Nesne depolarında "klasör" yoktur, sadece / içeren anahtarlar vardır. Klasör yanılsamasını prefix ve delimiter parametreleri yaratır. boto3 ile üç günlük log dosyası yükleyip listeledim:
import boto3
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:15703",
                  aws_access_key_id="oxiadmin", aws_secret_access_key="oxisecret123",
                  region_name="us-east-1")

s3.create_bucket(Bucket="logs")
for day in ("2026-10-10", "2026-10-11", "2026-10-12"):
    for i in range(4):
        s3.put_object(Bucket="logs", Key=f"app/{day}/part-{i}.log", Body=f"{day} line {i}\n".encode())
s3.put_object(Bucket="logs", Key="README.txt", Body=b"logs bucket")

r = s3.list_objects_v2(Bucket="logs", Delimiter="/")
print("top level  :", [c["Prefix"] for c in r.get("CommonPrefixes", [])], [o["Key"] for o in r.get("Contents", [])])
r = s3.list_objects_v2(Bucket="logs", Prefix="app/", Delimiter="/")
print("under app/ :", [c["Prefix"] for c in r.get("CommonPrefixes", [])])

page, token = 1, None
while True:
    kw = dict(Bucket="logs", Prefix="app/", MaxKeys=5)
    if token: kw["ContinuationToken"] = token
    r = s3.list_objects_v2(**kw)
    print(f"page {page}: KeyCount={r['KeyCount']} IsTruncated={r['IsTruncated']} "
          f"first={r['Contents'][0]['Key'] if r.get('Contents') else None} next={r.get('NextContinuationToken')}")
    if not r["IsTruncated"]: break
    token, page = r["NextContinuationToken"], page + 1
top level : ['app/'] ['README.txt']
under app/ : ['app/2026-10-10/', 'app/2026-10-11/', 'app/2026-10-12/']
page 1: KeyCount=5 IsTruncated=True first=app/2026-10-10/part-0.log next=app/2026-10-11/part-0.log
page 2: KeyCount=5 IsTruncated=True first=app/2026-10-11/part-1.log next=app/2026-10-12/part-1.log
page 3: KeyCount=2 IsTruncated=False first=app/2026-10-12/part-2.log next=NoneGördüğünüz gibi NextContinuationToken opak bir şey değil, son döndürülen anahtarın kendisi. Bu bilinçli bir seçim: anahtarlar sıralı olduğu için "son gördüğüm anahtardan büyük olanlar" diye sayfalamak, offset ile sayfalamaktan daha kararlı. İki sayfa arasında bir yükleme veya silme olsa bile bir satır iki kez görünmüyor ya da atlanmıyor. Bu yüzden continuation-token ile start-after aynı şekilde davranıyor.
Bu yazıyı yazarken bulduğum hata
Sayfalamayı büyük bir bucket'ta da denemek istedim. 2500 nesne yükledim (32 iş parçacığıyla 1,66 saniye sürdü) ve boto3'ün kendi paginator'ı ile listeledim:
pages = s3.get_paginator("list_objects_v2").paginate(Bucket="many")
counts = [p["KeyCount"] for p in pages]
print("pages:", counts, "total listed:", sum(counts))
put 2500 objects in 1.66s
pages: [1000, 1000, 0] total listed: 20002500 nesnenin 2000'i listelendi. Sebebi bucket.rs içinde: S3 katmanı çekirdekten önce ilk max_keys + 1000 anahtarı alıyor, continuation-token filtresini ondan sonra uyguluyor. 2000. anahtardan sonrası hiç gelmiyor, üçüncü sayfa boş dönüyor ve IsTruncated=false olduğu için istemci listenin bittiğini sanıyor. Düzeltmesi kolay, çünkü çekirdekte zaten list_objects_from(bucket, prefix, after, limit) var; S3 katmanının onu çağırması yetiyor. Bir sonraki sürüme kadar 2000'den fazla nesnesi olan bucket'larda tam listeye güvenmeyin. Bu tür şeyleri yazıda saklamak yerine söylemeyi tercih ediyorum; bu seri biraz da bunun için var.
Koşullu ve kısmi okumalar
GetObject, ETag'e dayalı koşulları destekliyor. Önbellekleme yapan bir istemci, elindeki ETag ile If-None-Match gönderir ve nesne değişmediyse gövdesiz bir 304 alır:
head = s3.head_object(Bucket="logs", Key="README.txt")
etag = head["ETag"]
print("etag:", etag, "md5:", hashlib.md5(b"logs bucket").hexdigest())
s3.get_object(Bucket="logs", Key="README.txt", IfNoneMatch=etag)   # ClientError
s3.get_object(Bucket="logs", Key="README.txt", IfMatch='"deadbeef"')  # ClientError
s3.get_object(Bucket="logs", Key="README.txt", IfMatch=etag)["Body"].read()
etag: "4a88ebb9d3237052e83f9445adba8d2c" md5: 4a88ebb9d3237052e83f9445adba8d2c
If-None-Match same etag -> 304
If-Match wrong etag -> 412 PreconditionFailed
If-Match right etag -> b'logs bucket'Range istekleri bytes=a-b, bytes=a- ve son ek biçimi bytes=-n ile çalışıyor; aralık dışı istekler 416 dönüyor. aws-cli ile ilk 7 bayt:
aws --endpoint-url $EP s3api get-object --bucket photos --key notes/hello.txt --range bytes=0-6 part.txt && cat part.txt{
"AcceptRanges": "bytes",
"ContentLength": 7,
"ETag": "\"87234ebddb79e0e7daed2faedcfc1f10\"",
"ContentRange": "bytes 0-6/46",
"ContentType": "text/plain",
"Metadata": { "tag-project": "blog", "tag-lang": "tr" }
}
MerhabaDürüst olmam gereken iki nokta var. Birincisi, range okuması nesnenin tamamını diskten okuyup (gerekirse çözüp ve açıp) sonra dilimliyor; 5 GB'lık bir videonun son 1 MB'ı için de 5 GB okunuyor. Şifreleme ve sıkıştırma dosyanın tamamı üzerinde yapıldığı için şimdilik böyle; parça parça şifreleme (chunked AEAD) olmadan gerçek bir "seek" mümkün değil. İkincisi, If-Modified-Since ve If-Unmodified-Since tarihleri karşılaştırmıyor, HTTP tarih metnini birebir eşitlik için kıyaslıyor. Tarayıcıların gönderdiği gibi Last-Modified değerini aynen geri yollayan istemcilerde doğru çalışıyor, ama "şu tarihten sonra değiştiyse" anlamında kullanılamaz. ETag tabanlı koşullar ise tam.
Multipart yükleme ve ETag hikayesi
aws-cli, 8 MB'tan büyük dosyaları varsayılan olarak multipart ile yükler. 20 MB'lık rastgele bir dosya:
head -c 20971520 /dev/urandom > big.bin
aws --endpoint-url $EP s3 cp big.bin s3://photos/videos/big.bin --only-show-errors
aws --endpoint-url $EP s3api head-object --bucket photos --key videos/big.bin --query "[ContentLength,ETag]" --output text
aws --endpoint-url $EP s3 cp s3://photos/videos/big.bin big.back --only-show-errors && cmp big.bin big.back && echo identical
20971520 "e90e5924e8af5f366537d93f2dfc780e-3"
identicalETag'in sonundaki -3, nesnenin üç parçayla (8 + 8 + 4 MB) yüklendiğini söylüyor. S3, çok parçalı bir nesnenin ETag'ini nesnenin MD5'i olarak tanımlamaz: her parçanın MD5 özetleri (ham 16 bayt) art arda eklenir, bunun MD5'i alınır ve sonuna -<parça sayısı> eklenir. OxiDB de tam olarak bunu yapıyor ve her parça yüklemesinde parçanın hex MD5'ini ETag olarak dönüyor.
Bunun neden önemli olduğunu acı yoldan öğrendim. Eskiden tek parçalı nesnelerin ETag'i, SHA-256'nın ilk 16 baytıydı. Bu da 32 hex karakter, yani bir MD5 ile aynı şekilde. .NET için AWS SDK, gönderdiği verinin MD5'ini kendisi hesaplıyor ve sunucunun döndüğü ETag ile karşılaştırıyor; uyuşmazsa "yükleme bozuldu" diye hata fırlatıyor. MD5'e benzeyen ama MD5 olmayan bir etiket, hiçbirine benzemeyen bir etiketten daha kötüydü: istemci bunun bir şema farkı olduğunu anlayamıyor, verinin bozulduğuna karar veriyordu. Multipart parça ETag'leri de bir dönem CRC32 idi (32 yerine 8 hex karakter). Şimdi ikisi de S3'ün tanımına uygun ve s3_etag.rs testleri bunu koruyor. MD5 imza için kırık bir algoritma, ama ETag bir imza değil, baytları tanımlayan bir etiket.
Multipart'ın sınırları da net: en fazla 10.000 parça, yükleme başına toplam 5 GiB, tamamlanmamış yüklemeler 24 saat sonra bir arka plan iş parçacığı tarafından temizleniyor. Önemli bir dürüstlük notu: devam eden yüklemelerin parçaları bellekte tutuluyor. Sunucu yeniden başlarsa yarım kalan multipart yüklemeleri kaybolur (istemci baştan yükler) ve aynı anda birçok büyük yükleme yapılıyorsa RAM kullanımı parça toplamı kadar artar. Blog görselleri ve belgeler için sorun değil; terabaytlık video arşivi için OxiDB S3 doğru araç değil.
Yaşam döngüsü: süresi dolan nesneler
Log ve geçici dosya bucket'ları için en çok istenen özellik, eski nesnelerin kendiliğinden silinmesi. OxiDB, S3 yaşam döngüsü yapılandırmasının en çok kullanılan alt kümesini destekliyor: Expiration/Days.
s3.put_bucket_lifecycle_configuration(Bucket="secure", LifecycleConfiguration={
    "Rules": [{"ID": "expire-old", "Status": "Enabled", "Filter": {"Prefix": ""},
               "Expiration": {"Days": 30}}]})
print("lifecycle  :", s3.get_bucket_lifecycle_configuration(Bucket="secure")["Rules"])
lifecycle : [{'Expiration': {'Days': 30}, 'ID': 'secure-expiration', 'Status': 'Enabled'}]Kural _s3_lifecycle adlı bir belge koleksiyonunda saklanıyor; yani yeniden başlatmalarda kalıcı ve OxiDB'nin geri kalanıyla aynı WAL'den geçiyor. Bir arka plan süpürücüsü beş dakikada bir her kuralı okuyor ve created_at değeri Days günden eski olan nesneleri siliyor.
Bunu 30 gün beklemeden görmek için küçük bir hile yaptım: kendi veri dizinimdeki invoice.txt nesnesinin .meta dosyasında created_at değerini 2026-08-01T09:00:00Z yaptım (meta dosyaları düz JSON, aşağıda anlatıyorum), sunucuyu yeniden başlattım ve beş dakika bekledim:
$ aws --endpoint-url $EP s3 ls s3://secure
2026-10-12 00:33:04         48 diary.txt
2026-08-01 12:00:00         54 invoice.txt
Beş dakika sonra sunucu logunda tek bir satır belirdi ve nesne gitti:
[s3] lifecycle expired 1 objects

$ aws --endpoint-url $EP s3 ls s3://secure
2026-10-12 00:33:04         48 diary.txt
Sınırlar: bucket başına tek bir kural var, XML'deki ilk <Days> değeri okunuyor, Filter/Prefix ve kural ID'si dikkate alınmıyor (GET'te ID <bucket>-expiration olarak dönüyor), geçişler (Transition) ve sürümlü nesne kuralları yok.
Şifreleme: SSE-S3 ve SSE-C
İki ayrı şifreleme katmanı var ve karıştırılmamaları gerekiyor:
- Disk düzeyinde şifreleme (
OXIDB_ENCRYPTION_KEY): bütün OxiDB veri dizinini, blob.datave.metadosyaları dahil, AES-256-GCM ile şifreler. S3 istemcisi bundan habersizdir. - S3 sunucu tarafı şifreleme (SSE): istek başına, S3 başlıklarıyla seçilir.
SSE-S3'te anahtar sunucunundur (OXIDB_S3_ENCRYPTION_KEY), istemci sadece x-amz-server-side-encryption: AES256 gönderir. SSE-C'de anahtarı istemci her istekte gönderir; sunucu onu hiçbir yere yazmaz ve anahtar olmadan nesne okunamaz. Multipart yüklemelerde SSE-C anahtarı tamamlanana kadar bellekte duruyor ve iş bitince write_volatile ile sıfırlanıyor. Her iki modda da AES-256-GCM kullanılıyor, her nesne için rastgele 12 baytlık bir nonce üretiliyor.
r = s3.put_object(Bucket="secure", Key="invoice.txt", Body=b"Invoice 2026-114: 1250 EUR",
                  ServerSideEncryption="AES256")
print("SSE-S3 put :", r.get("ServerSideEncryption"))
r = s3.get_object(Bucket="secure", Key="invoice.txt")
print("SSE-S3 get :", r.get("ServerSideEncryption"), r["Body"].read())

key = bytes(range(32))
s3.put_object(Bucket="secure", Key="diary.txt", Body=b"only I can read this",
              SSECustomerAlgorithm="AES256", SSECustomerKey=key)
r = s3.get_object(Bucket="secure", Key="diary.txt", SSECustomerAlgorithm="AES256", SSECustomerKey=key)
print("SSE-C get  :", r["Body"].read())
s3.get_object(Bucket="secure", Key="diary.txt")                       # anahtarsız
s3.get_object(Bucket="secure", Key="diary.txt",
              SSECustomerAlgorithm="AES256", SSECustomerKey=os.urandom(32))  # yanlış anahtar
SSE-S3 put : AES256
SSE-S3 get : AES256 b'Invoice 2026-114: 1250 EUR'
SSE-C get : b'only I can read this'
SSE-C no key: 400 InvalidRequest
SSE-C wrong key: 500 InternalErrorDiskteki karşılığı gerçekten şifreli:
$ cat data/oxidb/_blobs/secure/0.meta
{"key":"invoice.txt","bucket":"secure","size":54,"content_type":"application/octet-stream",
 "etag":"5ffee1c8d3e340ce03033bb8146f03cf","created_at":"2026-10-11T21:33:04Z",
 "metadata":{"_sse":"AES256"},"stored_size":54,"format_version":1}
$ xxd data/oxidb/_blobs/secure/0.data | head -2
00000000: 8d3b e14e a81f d050 f0f7 ab1e 6cf9 4626  .;.N...P....l.F&
00000010: 7d8c b9e7 50a8 bb02 9de3 0124 f301 fd6f  }...P......$...o
Burada üç dürüst not:
- Boyut ve ETag şifreli veriye göre. SSE katmanı BlobStore'un üstünde çalıştığı için çekirdeğe giden şey zaten şifreli baytlar. 26 baytlık fatura için HEAD
ContentLengtholarak 54 dönüyor (12 bayt nonce + 16 bayt GCM etiketi), indirdiğinizde 26 bayt geliyor. ETag de şifreli verinin MD5'i. S3'te de SSE-C nesnelerinin ETag'i içeriğin MD5'i değildir, ama boyut farkı benim tarafımdaki bir eksik. - Yanlış SSE-C anahtarı 500 dönüyor. AWS bu durumda 403 döner; GCM doğrulaması başarısız olduğunda bunu bir istemci hatası olarak eşlemem gerekiyor.
- Şifreli nesneler tam metin aramaya girmiyor. FTS işçisi diskten şifreli baytları okuyor ve metin çıkaramıyor. Bu SSE-C için zaten olması gereken şey (sunucu anahtarı bilmiyor), SSE-S3 için ise bir tercih meselesi.
SigV4 ve presigned URL'ler
Kimlik doğrulama AWS Signature Version 4 ile yapılıyor, iki biçimde:
- Başlık ile:
Authorization: AWS4-HMAC-SHA256 Credential=<ak>/<tarih>/<bölge>/s3/aws4_request, SignedHeaders=..., Signature=.... Sunucu kanonik isteği (metot, yol, sıralı sorgu, imzalanan başlıklar, gövde hash'i) yeniden kurar,AWS4<secret>anahtarından tarih, bölge, servis veaws4_requestzinciriyle imzalama anahtarını türetir ve imzayı sabit zamanlı (constant-time) karşılaştırmayla doğrular. - Sorgu dizesi ile (presigned):
X-Amz-Algorithm,X-Amz-Credential,X-Amz-Date,X-Amz-Expires,X-Amz-SignedHeaders,X-Amz-Signature. Gövde hash'i yerineUNSIGNED-PAYLOADkullanılır ve süre dolmuşsa istek reddedilir.
Bölge adı serbest: sunucu kapsamı (scope) istekten aldığı için us-east-1 de eu-central-1 de çalışıyor. Presigned URL, imza bilgisini taşıyan sıradan bir HTTP adresi olduğu için curl ile, tarayıcıyla, <img src> ile açılabiliyor. boto3 ile beş dakikalık bir URL üretip curl ile çektim:
import boto3
from botocore.config import Config
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:15703",
                  aws_access_key_id="oxiadmin", aws_secret_access_key="oxisecret123",
                  region_name="us-east-1", config=Config(signature_version="s3v4"))
url = s3.generate_presigned_url("get_object",
        Params={"Bucket": "photos", "Key": "notes/hello.txt"}, ExpiresIn=300)
print(url)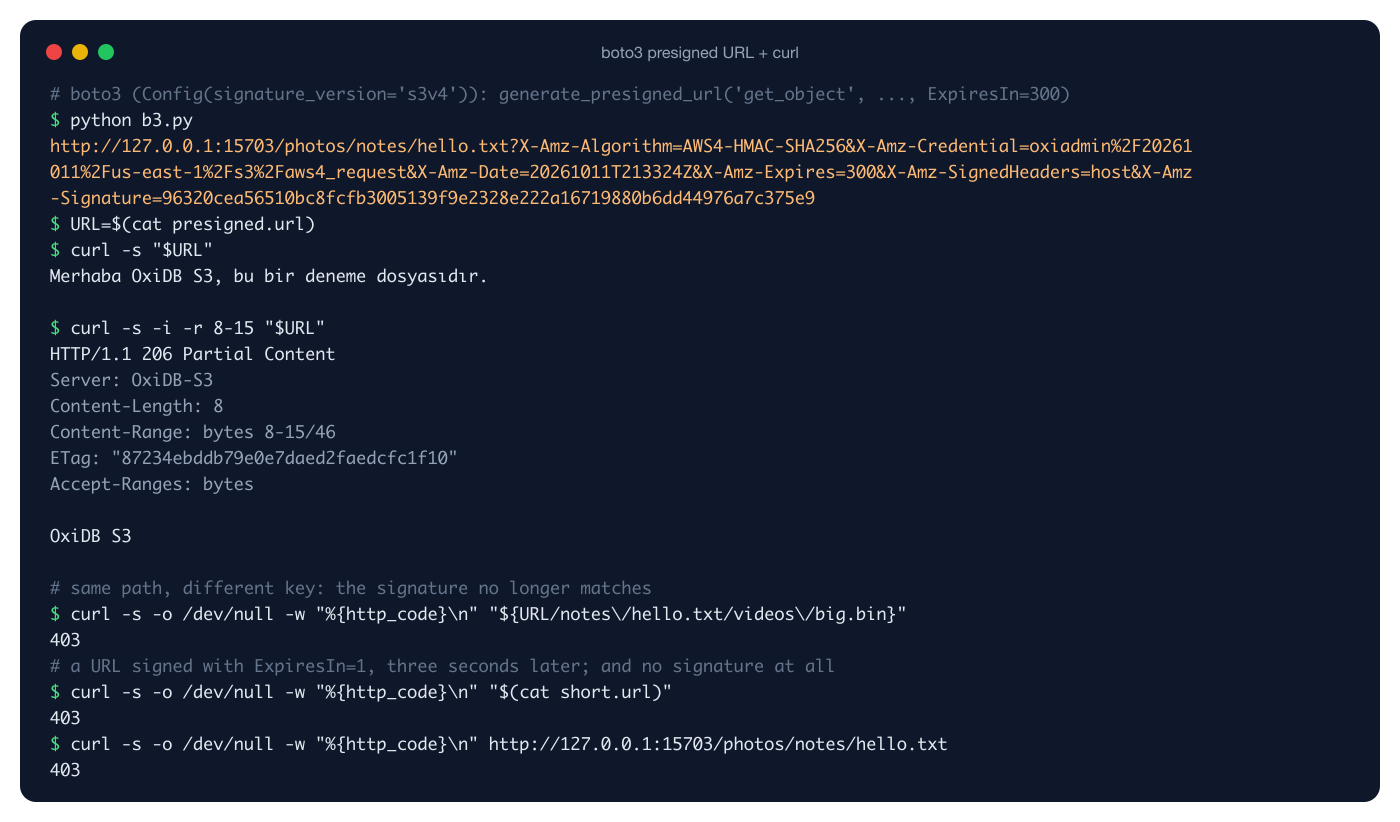
Görseldeki her satır gerçek çıktı. İmzalı URL ile tam okuma ve -r 8-15 ile 206 Partial Content, aynı imzayla başka bir anahtara gitmek 403, ExpiresIn=1 ile imzalanıp üç saniye sonra kullanılan URL 403, imzasız istek 403.
Bir tuzak: boto3, us-east-1 bölgesinde generate_presigned_url için hala eski SigV2 biçimini (AWSAccessKeyId=...&Signature=...&Expires=...) üretebiliyor. İlk denememde tam olarak bu oldu. OxiDB yalnızca SigV4 kabul ediyor, bu yüzden istemciye Config(signature_version="s3v4") vermek gerekiyor.
Kimlik bilgileri hakkında bir uyarı
OXIDB_S3_CREDENTIALS ile birden çok anahtar tanımlayabiliyorsunuz, ama bunlar kimlik, yetki değil. Bucket politikası, ACL veya salt okunur anahtar kavramı yok; her geçerli anahtar her şeyi yapabiliyor. Bunu ismi reader olan anahtarla bir nesne silerek doğruladım:
$ AWS_ACCESS_KEY_ID=reader AWS_SECRET_ACCESS_KEY=readersecret456 aws --endpoint-url $EP s3 rm s3://photos/archive/hello-copy.txt
delete: s3://photos/archive/hello-copy.txt
Birden çok anahtarın faydası, anahtarları uygulama başına ayırıp tek tek döndürebilmek (rotate). Yetki ayrımı gerekiyorsa şimdilik ters vekilde veya presigned URL'lerle çözmek gerekiyor. Native wire protokolündeki RBAC, S3 katmanına henüz uzanmıyor.
İçeride: nesneler nasıl saklanıyor?
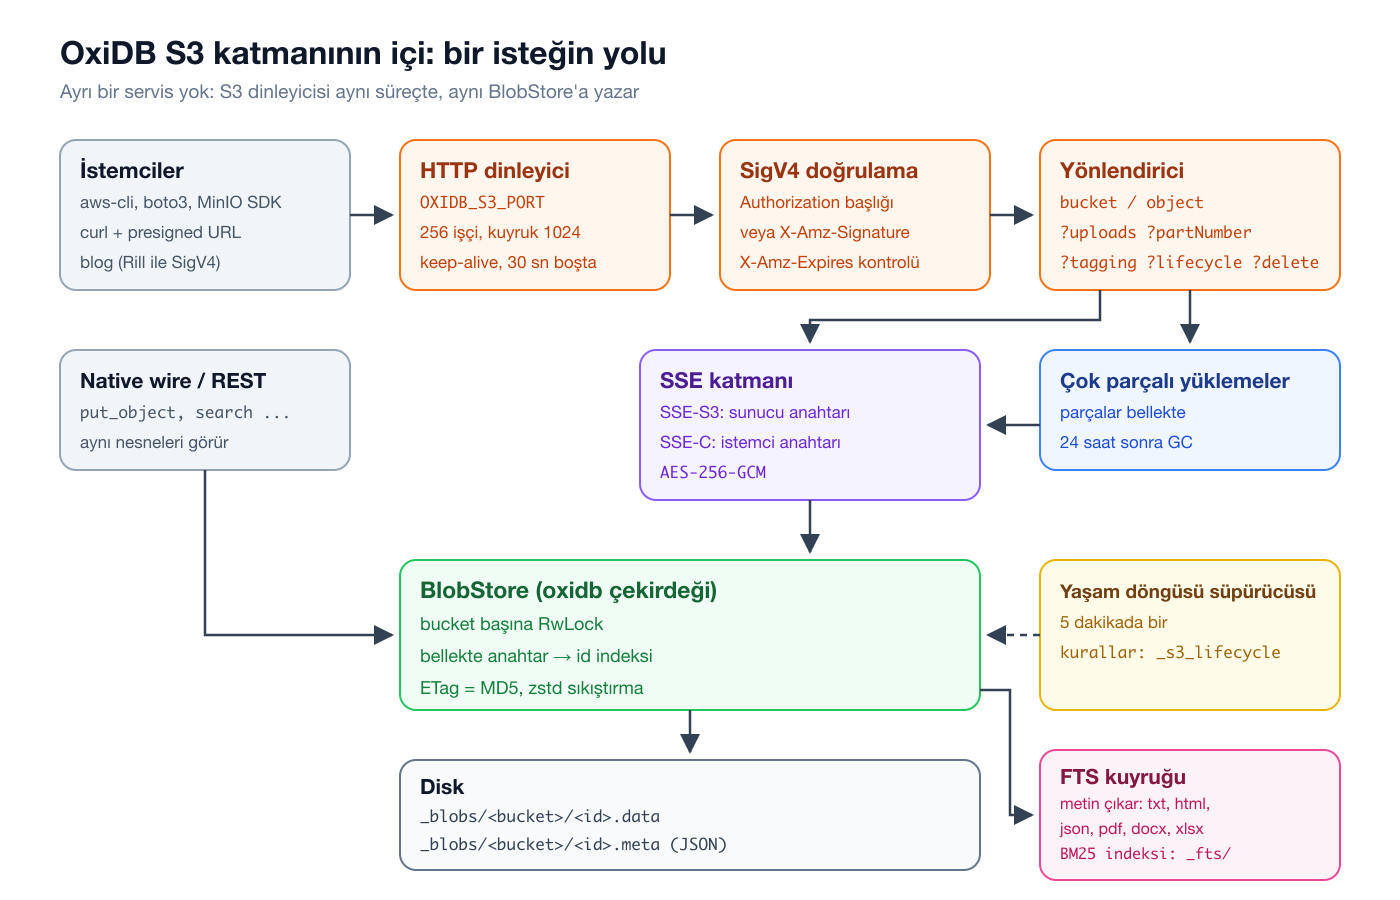
S3 katmanı oxidb-server/src/s3/ altında yaklaşık 2.800 satır Rust: auth (SigV4), bucket, object, multipart, tagging, lifecycle, encryption, batch ve küçük yardımcılar. HTTP ayrıştırma ayrı bir oxidb-http crate'inde, çünkü kontrol düzlemi (oxibase) de aynı ayrıştırıcıyı motoru bağlamadan kullanıyor (ADR-0021). Dinleyici, sabit 256 işçili bir iş parçacığı havuzu ve 1024 derinliğinde sınırlı bir kuyrukla çalışıyor; kuyruk dolarsa yeni bağlantılar reddediliyor, bellek sınırsız büyümüyor. Bağlantılar keep-alive, 30 saniye boşta kalırsa kapanıyor. Her işçi bir catch_unwind içinde koşuyor, tek bir hatalı istek sunucuyu düşüremiyor.
Asıl iş çekirdekteki BlobStore'da (src/blob.rs). Disk düzeni bilerek sade:
data/oxidb/_blobs/
  photos/
    0.data   0.meta
    1.data   1.meta
  secure/
    0.data   0.meta
Her nesne iki kardeş dosya: <id>.data ham (ya da sıkıştırılmış/şifrelenmiş) yük, <id>.meta ise nesneyi anlatan bir JSON. <id> dahili bir sayı; kullanıcının anahtarı (notes/hello.txt) meta dosyasının içinde. Bu sayede anahtarda /, boşluk veya Türkçe karakter olması dosya sistemini hiç ilgilendirmiyor. Sunucu açılırken her bucket dizinini tarıyor ve bellekte anahtar → id ve id → meta haritaları kuruyor; HEAD ve LIST diske dokunmadan bu haritalardan yanıtlanıyor. Biçim docs/format/blob-object.md içinde belgelenmiş ve 1.0 kararlılık kapsamında (ADR-0003). Meta dosyası bir format_version taşıyor ve okuyucu bilmediği yeni bir sürümü görünce okumayı reddediyor; yeni bir motorun yazdığı veriyi eski bir motorun sessizce bozmasını önleyen bir tuzak teli.
Sıkıştırma açıkken metin nesneleri belirgin şekilde küçülüyor. 219.732 baytlık bir erişim logu yükledim:
{"key":"raw/access.log","bucket":"logs","size":219732,"content_type":"text/plain",
 "etag":"a4094dc3a7fe303056d409f26b951a05","created_at":"2026-10-11T21:34:34Z","metadata":{},
 "storage_compression":"zstd","stored_size":8344,"format_version":1}
Diskte 8.344 bayt. size her zaman düz içeriğin boyutu, stored_size diskte kaplanan alan. Sıkıştırıcı 256 bayttan küçük dosyalara, %5'ten az kazandıran içeriğe ve zaten sıkıştırılmış türlere (image/, video/, audio/*, PDF, ZIP tabanlı Office belgeleri, gzip...) hiç dokunmuyor: bir JPEG'i yeniden sıkıştırmak her PUT ve GET'te CPU harcar, karşılığında neredeyse hiçbir şey kazandırmaz. Bu blogun görselleri bu yüzden diske olduğu gibi yazılıyor.
Bir PUT'un yolculuğu
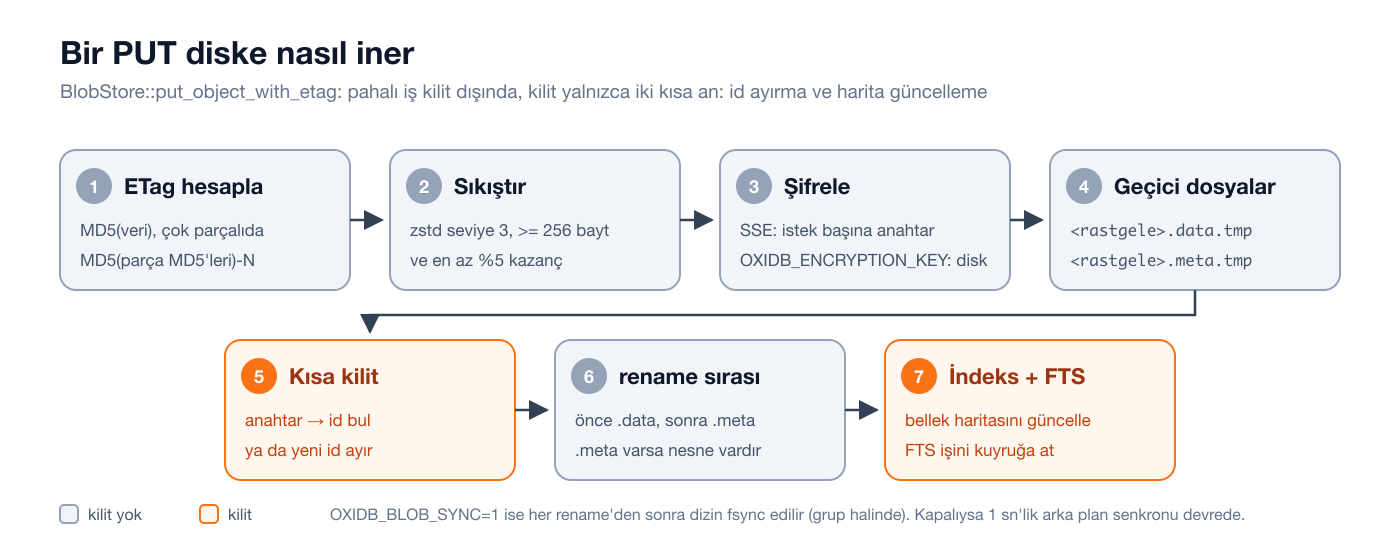
put_object_with_etag fonksiyonunun tasarımı, eşzamanlı yazmalarda yaşadığım bir sorundan çıktı. İlk sürümde bucket'ın yazma kilidi, dosyaların rename edilmesi boyunca tutuluyordu. 32 eşzamanlı yazıcıyla yapılan bir yük testinde p50 gecikme 900 ms civarına çıkmıştı (CHANGELOG'daki ölçüm). Şimdi pahalı işler (MD5, zstd, şifreleme, geçici dosyaları yazmak) hiçbir kilit altında değil. Kilit sadece iki kısa an için alınıyor: anahtara bir id bulmak/ayırmak ve sonunda bellek haritasını güncellemek. Bucket'lar arası hiç çekişme yok, çünkü dış RwLock sadece bucket haritasını, her bucket'ın kendi RwLock'u da o bucket'ın durumunu koruyor.
Çökme güvenliği için kural basit: .meta varsa nesne vardır. Bu yüzden önce .data, sonra .meta yerine taşınıyor. Açılışta .meta'sı olmayan bir .data öksüz sayılıp temizleniyor; .data'sı olmayan bir .meta ise hayalet okuma demek olurdu, sıralama bunu engelliyor. Bozuk veya çözülemeyen .meta dosyaları silinmiyor, karantinaya alınıyor.
Dayanıklılık konusunda iki mod var. Varsayılan modda rename sadece metadata düzeyinde atomik; baytlar diske saniyede bir çalışan arka plan senkronu veya çekirdeğin normal geri yazımıyla iniyor. Elektrik kesintisinde son bir saniyelik yazmalar kaybolabilir. OXIDB_BLOB_SYNC=1 ile her PUT dönmeden önce geçici dosyalar fsync ediliyor, iki rename'in arasında ve sonunda bucket dizini fsync ediliyor. Dizin fsync'leri grup halinde yapılıyor (group commit): adanmış bir iş parçacığı fsync'i sahipleniyor, aynı anda gelen 100 PUT tek bir dizin fsync'ini paylaşıyor. Bu modu, "250 OK" dediği bir e-postayı kaybetmemesi gereken bir SMTP sunucusu gibi, başarılı yazmayı commit sayan kullanıcılar için ekledim. Ayrıca bir Go test donanımı (tests/blob-crash-recovery-go/) süreci yazma ortasında öldürüp çökme tutarlılığını sınıyor.
Bu yapıda belge motorunun WAL'ı yok. Nesne yazmaları belgelerle aynı işleme (transaction) katılmıyor; "siparişi kaydet ve faturayı yükle" atomik değil. Uygulamada önce nesneyi yükleyip sonra belgeyi yazmak (ya da tersini yapıp başarısızlıkta temizlemek) gerekiyor. Nokta zamanlı geri yükleme (PITR) de blob'ları sadece temel yedek anına kadar geri getiriyor.
Aynı nesne, iki kapı
S3 yalnızca bir kapı. Aynı BlobStore'a native wire protokolünden de ulaşılıyor. S3 ile yüklediğim dosyayı OxiDB'nin Python istemcisiyle okudum:
from oxidb import OxiDbClient
db = OxiDbClient("127.0.0.1", 15700)
print(db.list_buckets())
print(json.dumps(db.head_object("photos", "notes/hello.txt"), ensure_ascii=False))
data, meta = db.get_object("photos", "notes/hello.txt")
print(data.decode())
['documents', 'logs', 'many', 'photos', 'secure']
{"key": "notes/hello.txt", "bucket": "photos", "size": 46, "content_type": "text/plain", "etag": "87234ebddb79e0e7daed2faedcfc1f10", "created_at": "2026-10-11T21:32:36Z", "metadata": {"tag-project": "blog", "tag-lang": "tr"}, "stored_size": 46, "format_version": 1}
Merhaba OxiDB S3, bu bir deneme dosyasıdır.Native protokolde içerik base64 olarak taşınıyor (put_object, get_object, head_object, list_objects, delete_object, create_bucket ...). Büyük dosyalar için S3 kapısı daha verimli, ama küçük dosyaları belge işlemleriyle aynı bağlantıdan yazabilmek pratik.
Dosyaların içinde arama
Bu katmanın bence en değerli yanı burada. Her PUT, nesne yazıldıktan sonra bir FTS kuyruğuna iş bırakıyor. Arka plandaki işçiler nesnenin Content-Type'ına bakıp metni çıkarıyor ve BM25 ile sıralanan bir ters indekse ekliyor; DELETE de indeksten siliyor. Desteklenen biçimler: düz metin ve CSV, HTML ve XML (etiketler atılıyor), JSON (bütün string değerler özyinelemeli), PDF, DOCX (word/document.xml), XLSX (xl/sharedStrings.xml) ve ocr özelliğiyle derlendiyse Tesseract üzerinden PNG/JPEG/TIFF/BMP.
Dört dosyayı aws-cli ile yükledim: bir metin raporu, bir HTML sürüm notu, bir JSON varlık kaydı ve macOS'un textutil aracıyla ürettiğim gerçek bir DOCX:
aws --endpoint-url $EP s3 mb s3://documents
aws --endpoint-url $EP s3 cp docs/ s3://documents/ --recursive --only-show-errors
aws --endpoint-url $EP s3api list-objects-v2 --bucket documents --query "Contents[].[Key,Size]" --output text
aws --endpoint-url $EP s3api head-object --bucket documents --key minutes.docx --query ContentType --output text
asset.json 107
minutes.docx 3540
page.html 189
rapor.txt 174
application/vnd.openxmlformats-officedocument.wordprocessingml.documentaws-cli Content-Type'ı dosya uzantısından tahmin ediyor, OxiDB de çıkarıcıyı ona göre seçiyor. Sonra wire protokolünden arama:
for q in ("conveyor", "presigned", "november"):
    print(f"search {q!r}:")
    for hit in db.search(q, bucket="documents", limit=5):
        print("  ", json.dumps(hit))
search 'conveyor':
{"bucket": "documents", "key": "asset.json", "score": 0.7813213802071468}
{"bucket": "documents", "key": "minutes.docx", "score": 0.7132708083826534}
{"bucket": "documents", "key": "rapor.txt", "score": 0.4968852822440956}
search 'presigned':
{"bucket": "documents", "key": "page.html", "score": 1.3500054067641225}
search 'november':
{"bucket": "documents", "key": "asset.json", "score": 1.7364027140004965}"highlight": true ile her isabet için <mark> işaretli parçalar da dönüyor. Bunun için sunucu isabet eden dosyayı yeniden okuyup metni tekrar çıkarıyor, bu yüzden sadece istendiğinde yapılıyor:
{"cmd": "search", "query": "conveyor", "bucket": "documents", "limit": 3, "highlight": true}{"ok": true, "data": [
{"bucket": "documents", "key": "asset.json", "score": 0.7813213802071468, "highlights": ["<mark>conveyor</mark> belt installed in warehouse B inspectio"]},
{"bucket": "documents", "key": "minutes.docx", "score": 0.7132708083826534, "highlights": ["Meeting minutes: the board approved the <mark>conveyor</mark> upgrade budget for the Istanbul warehou"]},
{"bucket": "documents", "key": "rapor.txt", "score": 0.4968852822440956, "highlights": ["nventory turnover improved, and the new <mark>conveyor</mark>\nsystem reduced picking time. Next quart"]}
]}Yani bir Word belgesini sıradan bir S3 istemcisiyle yüklüyorsunuz ve içindeki bir kelimeyle onu buluyorsunuz; arada Elasticsearch, Lambda tetikleyicisi veya ETL hattı yok. İndeksin yapısını, BM25 parametrelerini (OXIDB_FTS_K, OXIDB_FTS_B), dil desteğini ve vektör aramayla nasıl birleştiğini tam metin ve vektör arama yazısında ayrıntılı anlattım. İndeksleme asenkron olduğu için PUT döndükten hemen sonra yapılan bir arama, yeni dosyayı birkaç milisaniye kaçırabilir.
Bu blog OxiDB S3'ü nasıl kullanıyor?
Blogun yönetim panelinden bir görsel yüklediğimde akış şöyle: sunucu bir UUID üretiyor, blog-media bucket'ına img/<uuid>.<uzantı> anahtarıyla PUT yapıyor ve sayfalar görseli bu anahtar üzerinden servis ediyor. Blog, Rill adlı kendi dilimde yazılı ve S3 istemcisi de öyle: src/s3.rill içinde SHA-256, HMAC zinciri ve kanonik istek dahil 140 satırlık bir dosyada SigV4 uygulaması. Yani OxiDB'nin SigV4 doğrulayıcısı her gün sadece boto3'le değil, sıfırdan yazılmış üçüncü bir uygulamayla da sınanıyor. Aynı OxiDB süreci blogun yazılarını SQL motorunda, arama indeksini belge motorunda, oturum, sayaç ve sayfa önbelleğini OxiMem üzerinde, görsellerini S3'te tutuyor; tek bir veri dizini, tek bir yedek.
Sınırlar ve dürüst değerlendirme
Bu katman bir MinIO veya Ceph rakibi değil; "uygulamamın dosyaları veritabanımın yanında dursun ve standart araçlar onları görsün" ihtiyacına cevap veriyor. Bilmeniz gerekenler:
| Konu | Durum |
|---|---|
| Adresleme | Yalnızca path-style (/bucket/key). Virtual-hosted style (bucket.host) yok. |
| Bellek | PUT gövdesi, multipart parçaları ve GET yanıtı tamamen bellekte. HTTP gövde sınırı 5 GiB. |
| Range | Tam nesne okunup dilimleniyor. |
| Multipart | Parçalar bellekte, yeniden başlatmada yarım yüklemeler kaybolur. |
| Yetki | Anahtarlar arasında yetki farkı yok; politika, ACL yok. |
| Sürümleme | Object versioning, object lock, replikasyon yok. |
| Yaşam döngüsü | Yalnızca Expiration/Days, bucket başına tek kural. |
| SSE | Boyut/ETag şifreli veriye göre; yanlış SSE-C anahtarı 500. |
| Listeleme | 2000 nesneyi aşan sayfalamada hata (yukarıda); ListBuckets sabit bir oluşturma tarihi dönüyor. |
| Koşullar | If-Modified-Since tarih karşılaştırması değil, metin eşitliği. |
| İşlem | Nesne yazmaları belge işlemlerine katılmıyor. |
Buna karşılık kazandıklarınız: ayrı bir servis yok, aws-cli/boto3/MinIO SDK'ları değişmeden çalışıyor, ETag'ler S3 ile birebir uyumlu (ki birçok "S3 uyumlu" sunucunun takıldığı yer burası), SigV4 ve presigned URL'ler gerçek, yüklediğiniz her belge kendiliğinden aranabilir oluyor ve nesneler belgeler, SQL tabloları ve zaman serileriyle aynı veri dizininde yedekleniyor.
Denemek için
OxiDB'yi GitHub sürümler sayfasından macOS ve Linux (arm64 ve x86_64) için hazır ikili olarak indirebilir ya da depo kökündeki Dockerfile ile bir imaj oluşturabilirsiniz. S3 katmanını açmak için OXIDB_S3_PORT ve bir anahtar çifti yeter; sonra elinizdeki herhangi bir S3 istemcisine --endpoint-url verin. Sıradaki yazı OxiDB'nin MQTT ve AMQP mesajlaşma katmanı hakkında. Orada da aynı fikri göreceksiniz: standart istemciler değişmeden bağlanıyor, veriler aynı süreçte kalıyor.