OxiDB'de coğrafi ve graf sorguları: geohash index, $near, $graphLookup ve $shortestPath
OxiDB'nin doküman motoruna coğrafi sorguları ve graf aşamalarını nasıl koyduğumu, İstanbul'daki gerçek yerler ve küçük bir uçuş ağıyla anlatıyorum: cömert ama asla yanlış olmayan geohash index, BFS ve tembel Dijkstra.
OxiDB'nin doküman motoru sadece "şu alanı şuna eşit olanları getir" diye çalışmıyor. İki soru tipi var ki çoğu projede ayrı bir sisteme taşınır: "bana en yakın olanlar hangileri?" ve "buradan oraya nasıl giderim?". Birincisi için insanlar PostGIS ya da Redis GEO kurar, ikincisi için Neo4j gibi bir graf veritabanı. Ben ikisini de OxiDB'nin içine, aggregation pipeline ve sorgu dilinin doğal bir parçası olarak koydum. Bu yazıda coğrafi sorguları ($geoWithin, $near, $geoNear, geohash index) ve graf sorgularını ($graphLookup, $shortestPath) anlatıyorum. Örneklerin hepsini İstanbul'daki gerçek yerler ve Türkiye'deki havalimanlarıyla, yerel bir OxiDB 0.44.2 sunucusunda çalıştırdım; gösterdiğim her cevap o sunucudan geldi.
Serinin ilk yazısında doküman motorunu anlatmıştım. Burada anlatılanların hepsi o motorun üstünde çalışıyor: aynı koleksiyonlar, aynı index'ler, aynı wire protokolü. Ayrı bir servis, ayrı bir eklenti yok.
Neden veritabanının içinde?
Bir kurye uygulaması düşünün. Kuryelerin konumları bir koleksiyonda duruyor. "Müşteriye 2 km içindeki boş kuryeler" sorgusu hem konum filtresi hem de normal bir alan filtresi (durum: "bos") içeriyor. Konumu Redis'te, durumu ana veritabanında tutarsanız, iki sistemden gelen sonuçları uygulamada kesiştirmek zorunda kalırsınız; tutarlılık da sizin probleminiz olur. Aynı şey graf için de geçerli: "Bu kullanıcının arkadaşlarının arkadaşları" sorgusu için verinizi ikinci bir veritabanına kopyalamak, senkron tutulması gereken bir boru hattı demek.
OxiDB'de konum sadece bir doküman alanı. Graf da sadece belgeler arasındaki referanslar. Sorgu dili ikisini de anlıyor, index'ler ikisine de hizmet ediyor. Bunun bedeli, özel bir coğrafi veritabanının veya graf veritabanının tüm yeteneklerini sunmamak. Neyi yaptığını ve neyi bilerek yapmadığını aşağıda tek tek yazdım.
Etkinleştirme: hiçbir şey
Coğrafi ve graf sorguları doküman motorunun parçası ve doküman motoru varsayılan olarak açık. Ayrı bir ortam değişkeni yok. Ben testler için sunucuyu kendi portumda ve kendi veri dizinimle başlattım:
OXIDB_ADDR=127.0.0.1:15300 OXIDB_DATA=./data ./oxidb-serverWire protokolü uzunluk önekli JSON: 4 bayt little-endian uzunluk, ardından {"cmd": ...} biçiminde bir JSON belge. Aşağıdaki isteklerin hepsi bu biçimde gönderildi; cevaplar da sunucunun döndürdüğü haliyle (sadece okunabilirlik için bazı alanları kırptım ya da $project ile daralttım).
Coğrafi veri modeli: noktalar
OxiDB'nin coğrafi desteği bilerek nokta üzerine kurulu. Bir belgedeki konum alanı şu üç biçimden biri olabilir:
| Biçim | Örnek |
|---|---|
| GeoJSON Point | {"type": "Point", "coordinates": [28.9802, 41.0086]} |
[boylam, enlem] dizisi | [28.9741, 41.0256] |
{lat, lon} nesnesi | {"lat": 41.0370, "lon": 28.9850} (ya da lng) |
Sıra her zaman GeoJSON'daki gibi önce boylam, sonra enlem. Nesne biçiminde anahtar isimleri belli olduğu için sıra önemli değil. Boylam -180 ile 180, enlem -90 ile 90 arasında olmalı; bu aralığın dışındaki ya da sayı olmayan bir değer "nokta değil" sayılır. Konum alanı olmayan veya geçersiz konumlu bir belge hiçbir coğrafi sorguyla eşleşmez, ama hata da üretmez. Bu, şemasız bir koleksiyonda beklenen davranış: konumsuz bir kafe koleksiyonda durabilir, sadece "yakınımdakiler" listesine girmez.
Bunu göstermek için İstanbul'dan 14 yer ve bir de konumsuz kafe ekledim. Üç biçimi bilerek karıştırdım:
{"cmd": "insert_many", "collection": "yerler", "docs": [
  {"ad": "Ayasofya", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9802, 41.0086]}},
  {"ad": "Topkapı Sarayı", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9834, 41.0115]}},
  {"ad": "Kapalıçarşı", "tur": "carsi", "konum": [28.968, 41.0107]},
  {"ad": "Galata Kulesi", "tur": "kule", "konum": [28.9741, 41.0256]},
  {"ad": "Taksim Meydanı", "tur": "meydan", "konum": {"lat": 41.037, "lon": 28.985}},
  {"ad": "Dolmabahçe Sarayı", "tur": "muze", "konum": {"lat": 41.0392, "lon": 29.0005}},
  {"ad": "Kız Kulesi", "tur": "kule", "konum": [29.0041, 41.0211]},
  {"ad": "Kadıköy İskelesi", "tur": "iskele", "konum": {"lat": 40.9926, "lng": 29.0221}},
  {"ad": "Çamlıca Kulesi", "tur": "kule", "konum": [29.0697, 41.027]},
  {"ad": "Rumeli Hisarı", "tur": "muze", "konum": [29.0561, 41.0848]},
  {"ad": "Anadolu Hisarı", "tur": "muze", "konum": [29.0669, 41.0822]},
  {"ad": "Büyükada", "tur": "ada", "konum": [29.12, 40.858]},
  {"ad": "Sabiha Gökçen Havalimanı", "tur": "havalimani", "konum": [29.3092, 40.8986]},
  {"ad": "İstanbul Havalimanı", "tur": "havalimani", "konum": [28.7519, 41.2753]},
  {"ad": "Konumsuz Kafe", "tur": "kafe"}
]}
{"ok": true, "data": [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]}Coğrafi index'i tek bir komutla oluşturuyorum:
{"cmd": "create_geo_index", "collection": "yerler", "field": "konum"}
{"ok": true, "data": "geo index created"}

{"cmd": "list_indexes", "collection": "yerler"}
{"ok": true, "data": [{"name": "_geo_konum", "index_type": "geo", "fields": ["konum"], "unique": false}]}
Index olmadan da bütün coğrafi sorgular çalışıyor (tam tarama ile). Index sadece hızlandırıyor; sonuç asla değişmiyor. Bu cümle yazının merkezinde, birazdan nedenini anlatacağım.
$geoWithin: bölgenin içindekiler
$centerSphere: küresel daire
$centerSphere bir merkez ve radyan cinsinden bir yarıçap alıyor. Bu MongoDB'nin tanımı; yarıçapı metreye çevirmek için dünya yarıçapına bölmek gerekiyor. OxiDB, MongoDB'nin de kullandığı ortalama dünya yarıçapını kullanıyor: 6.371.008,8 metre. Ayasofya'nın 2 km çevresi için 2000 / 6371008.8 = 0.000313922... radyan:
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoWithin": {"$centerSphere": [[28.9802, 41.0086], 0.00031392202754452326]}}}}
{"ok": true, "data": [
{"ad": "Ayasofya", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9802, 41.0086]}, "_id": 1, "_version": 1},
{"ad": "Topkapı Sarayı", "tur": "muze", "konum": {"type": "Point", "coordinates": [28.9834, 41.0115]}, "_id": 2, "_version": 1},
{"ad": "Kapalıçarşı", "tur": "carsi", "konum": [28.968, 41.0107], "_id": 3, "_version": 1},
{"ad": "Galata Kulesi", "tur": "kule", "konum": [28.9741, 41.0256], "_id": 4, "_version": 1}
]}Galata Kulesi Ayasofya'ya 1.958 metre uzaklıkta (bunu birazdan $geoNear ile göreceğiz), yani 2 km'lik dairenin hemen içinde. Mesafeler her zaman büyük daire (haversine) mesafesi; düzlemde Pisagor hesabı yapılmıyor.
$box: boylam/enlem dikdörtgeni
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoWithin": {"$box": [[28.96, 41.0], [29.01, 41.03]]}}}}
Bu kutu Ayasofya, Topkapı, Kapalıçarşı, Galata Kulesi ve Kız Kulesi'ni döndürdü (5 belge). $box köşeleri [min, max] sırasında olmalı. Kutu antimeridyeni (180. boylamı) sarmıyor; sararsa ne demek istendiği belirsiz, o yüzden ters köşeler hata veriyor (aşağıda hatalar bölümünde).
$geometry Polygon ve $geoIntersects
İlk sürümden sonra GeoJSON Polygon desteği de geldi: bir dış halka ve isteğe bağlı delikler (holes). İçerde olma testi boylam/enlem düzleminde ışın atma (ray casting) ile yapılıyor. Tarihi yarımadayı kabaca çizen bir poligonla:
{"cmd": "find", "collection": "yerler", "query": {"konum": {"$geoWithin": {"$geometry":
  {"type": "Polygon", "coordinates": [[[28.92, 40.993], [28.985, 41.0], [28.99, 41.015],
     [28.97, 41.02], [28.94, 41.03], [28.923, 41.025], [28.92, 40.993]]]}}}}}
Cevapta Ayasofya, Topkapı Sarayı ve Kapalıçarşı var; Haliç'in karşı yakasındaki Galata Kulesi yok. Poligonun düzlemde değerlendirilmesi bilinçli bir tercih: geofence boyutundaki bölgeler (bir semt, bir şantiye, bir liman) için düzlem ile küre arasındaki fark ölçülemeyecek kadar küçük, hesap da çok daha basit ve hızlı.
$geoIntersects da var. Koleksiyonda sadece noktalar durduğu için "bir nokta bir bölgeyle kesişir" ile "nokta bölgenin içindedir" aynı şey; o yüzden ikisi tek bir değerlendiriciyi paylaşıyor. Point geometrisi verirseniz sıfır yarıçaplı bir daireye dönüşüyor:
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$geoIntersects": {"$geometry": {"type": "Point", "coordinates": [29.0041, 41.0211]}}}}}
{"ok": true, "data": [{"ad": "Kız Kulesi", "tur": "kule", "konum": [29.0041, 41.0211], "_id": 7, "_version": 1}]}$near ve $nearSphere: en yakından uzağa
$near iki şey birden yapıyor: isteğe bağlı mesafe sınırlarına göre filtreliyor ve sonucu en yakından en uzağa sıralıyor. Mesafeler metre cinsinden. Galata Kulesi'nin 3 km çevresi:
{"cmd": "find", "collection": "yerler", "query": {"konum": {"$near": {
  "$geometry": {"type": "Point", "coordinates": [28.9741, 41.0256]}, "$maxDistance": 3000}}}}
Dönen sıra: Galata Kulesi, Taksim Meydanı, Kapalıçarşı, Topkapı Sarayı, Ayasofya, Kız Kulesi, Dolmabahçe Sarayı. Yani 7 belge, yakından uzağa.
$nearSphere, $near ile birebir aynı (alias). Eski (legacy) biçim de destekleniyor: noktayı doğrudan verip $maxDistance ve $minDistance değerlerini kardeş anahtar olarak yazabilirsiniz. Kadıköy İskelesi'nden 1 ile 6 km arasındaki yerler:
{"cmd": "find", "collection": "yerler", "query":
  {"konum": {"$nearSphere": [29.0221, 40.9926], "$maxDistance": 6000, "$minDistance": 1000}}}
Sonuç: Kız Kulesi, Topkapı Sarayı, Ayasofya, Kapalıçarşı, Galata Kulesi, Dolmabahçe Sarayı, Çamlıca Kulesi, Taksim Meydanı. İskelenin kendisi (0 m) $minDistance yüzünden elendi.
Burada MongoDB'den bilinçli olarak ayrıldığım bir nokta var. MongoDB'de legacy $near biçimi düzlemsel çalışır ve $maxDistance değerini derece olarak yorumlar. Aynı sorgu iki farklı birimde iki farklı anlam taşır; bu, sessizce yanlış ölçüm demek. OxiDB'de her iki biçimde de mesafe metre ve hesap küresel. Kodu MongoDB'den taşıyan biri için bu bir fark, ama sessiz bir yanlışlık değil: derece sanıp 0.01 yazarsanız 1 cm'lik bir daire alırsınız ve bunu hemen fark edersiniz.
Mesafe sınırı olmadan da $near kullanılabiliyor; diğer filtrelerle birleşebiliyor. Ayasofya'ya en yakın kuleler:
{"cmd": "find", "collection": "yerler", "query": {"tur": "kule",
  "konum": {"$near": {"$geometry": {"type": "Point", "coordinates": [28.9802, 41.0086]}}}}}
Sonuç sırası: Galata Kulesi, Kız Kulesi, Çamlıca Kulesi.
Sıralama kuralı MongoDB ile aynı: $near sadece çağıran açık bir sort vermediyse sıralar. Açık bir sort verirseniz o kazanır. "sort": {"ad": 1}, "limit": 3 eklediğimde cevap Anadolu Hisarı, Ayasofya, Büyükada oldu: alfabetik.
$geoNear: mesafeyi de geri ver
$near sıralıyor ama mesafeyi döndürmüyor. Uygulamada "1,2 km uzakta" yazmak istiyorsanız ya mesafeyi istemcide kendi haversine kodunuzla tekrar hesaplarsınız ya da $geoNear aşamasını kullanırsınız:
{"cmd": "aggregate", "collection": "yerler", "pipeline": [
  {"$geoNear": {"near": {"type": "Point", "coordinates": [28.9802, 41.0086]},
                "key": "konum", "distanceField": "mesafe_m", "maxDistance": 5000}},
  {"$project": {"_id": 0, "ad": 1, "mesafe_m": 1}}
]}
{"ok": true, "data": [
{"ad": "Ayasofya", "mesafe_m": 0.0},
{"ad": "Topkapı Sarayı", "mesafe_m": 419.6165187010312},
{"ad": "Kapalıçarşı", "mesafe_m": 1049.969147589969},
{"ad": "Galata Kulesi", "mesafe_m": 1958.3701941280722},
{"ad": "Kız Kulesi", "mesafe_m": 2439.8565175620315},
{"ad": "Taksim Meydanı", "mesafe_m": 3183.509891312274},
{"ad": "Dolmabahçe Sarayı", "mesafe_m": 3804.936857196773},
{"ad": "Kadıköy İskelesi", "mesafe_m": 3940.690888137602}
]}key ve distanceField zorunlu; hangi alanın nokta olduğunu tahmin etmiyorum. query ile ek filtre, distanceMultiplier ile birim dönüşümü yapılabiliyor. Ayasofya'dan iki havalimanına kilometre olarak:
{"cmd": "aggregate", "collection": "yerler", "pipeline": [
  {"$geoNear": {"near": [28.9802, 41.0086], "key": "konum", "distanceField": "km",
                "distanceMultiplier": 0.001, "query": {"tur": "havalimani"}}},
  {"$project": {"_id": 0, "ad": 1, "km": 1}}
]}
{"ok": true, "data": [
{"ad": "Sabiha Gökçen Havalimanı", "km": 30.215465616237612},
{"ad": "İstanbul Havalimanı", "km": 35.28374942949766}
]}İçeride $geoNear iki aşamaya ayrılıyor: önde sentezlenmiş bir $match (eşdeğer $near yüklemi artı sizin query'niz) ve arkasında mesafeyi yazıp sıralayan bir aşama. Bu sayede geo index, aday kesişimi ve pushdown gibi şeyler $geoNear için ayrıca yazılmadan bedavaya geliyor. spherical parametresi kabul ediliyor ama yok sayılıyor: bu motor her zaman küresel çalışıyor.
Aynı sorguyu resmi Python istemcisiyle de çalıştırdım. İstemcide henüz create_geo_index için bir yardımcı metot yok, o yüzden ham komutu gönderdim:
from oxidb import OxiDbClient

with OxiDbClient("127.0.0.1", 15300) as db:
    # The Python client has no create_geo_index helper yet; send the raw command
    db._checked({"cmd": "create_geo_index", "collection": "yerler", "field": "konum"})
    yakin = db.aggregate("yerler", [
        {"$geoNear": {"near": [29.0221, 40.9926], "key": "konum",
                      "distanceField": "m", "maxDistance": 4000}},
        {"$project": {"_id": 0, "ad": 1, "m": 1}},
    ])
    for d in yakin:
        print(f'{d["ad"]:<20} {d["m"]:>7.0f} m')
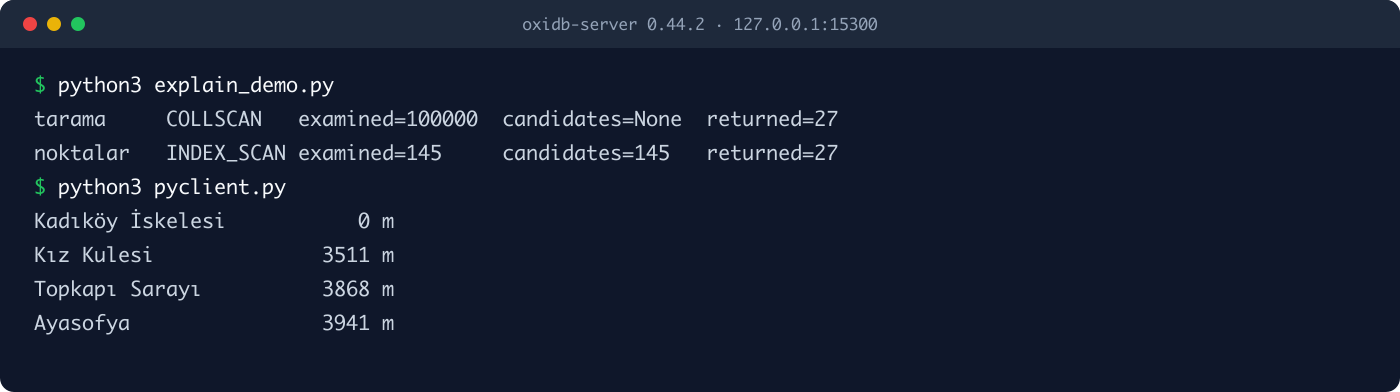
Kadıköy İskelesi 0 m
Kız Kulesi 3511 m
Topkapı Sarayı 3868 m
Ayasofya 3941 mDoğru cevaplanamayan şekli reddetmek
Coğrafi kodda en kolay hata, bir şekli "yaklaşık" cevaplamak ve bunu kimseye söylememek. OxiDB'de kural basit: doğru cevaplayamadığım bir sorguyu adıyla reddediyorum. Yanlış bir sonuç listesi, hata mesajından çok daha pahalı; çünkü fark edilmiyor.
{"konum": {"$geoWithin": {"$center": [[28.98, 41.0], 0.02]}}}invalid query: $geoWithin $center is not supported - use $centerSphere (spherical), $box, or $geometry PolygonMongoDB'nin $center operatörü düzlemsel bir dairedir ve yarıçapı derece olarak alır. 41. enlemde bir derece boylam yaklaşık 84 km, bir derece enlem yaklaşık 111 km; yani "daire" aslında bir elips. Bunu sessizce $centerSphere gibi yorumlamak da, düzlemsel hesaplamak da yanlış beklentilere yol açar. Aynı nedenle legacy $polygon da reddediliyor:
invalid query: $geoWithin $polygon is not supported - use $centerSphere (spherical), $box, or $geometry Polygon180 dereceden geniş boylam aralığına yayılan bir poligon da reddediliyor. Düzlemde bir halkanın hangi tarafının "iç" olduğu, halka dünyanın yarısını sardığında belirsizleşiyor:
{"konum": {"$geoWithin": {"$geometry": {"type": "Polygon",
  "coordinates": [[[-100, 0], [100, 0], [100, 10], [-100, 10], [-100, 0]]]}}}}
invalid query: Polygon spanning more than 180° of longitude is ambiguous - split it at the antimeridianDiğer reddedilen durumlardan bazıları, hepsi sunucudan gerçek cevaplar:
$box ters köşe:      invalid query: $box corners must be [min, max] (no antimeridian wrap)
3 elemanlı nokta:    invalid query: expected a point ([lon, lat], GeoJSON Point, or {lon, lat}), got [41.0,28.9,1]
negatif mesafe:      invalid query: $maxDistance must be a non-negative number of meters
LineString bölgesi:  invalid query: $geoWithin $geometry supports Polygon, got Some("LineString") - use $centerSphere for circles
(Sunucunun hata mesajlarındaki uzun tireyi burada kısa tire olarak yazdım; metnin geri kalanı aynen sunucunun döndürdüğü gibi.)
Burada bir asimetri olduğuna dikkat edin: belgede bozuk bir nokta "eşleşmeyen belge" sayılıyor, sorgudaki bozuk bir nokta ise hata. Belgeler şemasız ve heterojen olabilir; ama sorguyu yazan sizsiniz, sorgudaki bir hata büyük ihtimalle bir bug.
Geohash index: cömert ama asla yanlış değil
Şimdi işin içine bakalım. Geohash, dünyayı tekrar tekrar ikiye bölerek bir noktayı kısa bir metne çeviren klasik bir kodlama. Boylam ve enlem bitleri sırayla birbirine geçiriliyor (bit 0 boylam, bit 1 enlem, ...) ve her 5 bit bir base32 karakterine dönüşüyor. Önemli özelliği şu: aynı öneki paylaşan geohash'ler aynı dikdörtgen hücrenin içinde. sxk97 ile başlayan her nokta, sxk97 hücresinin içinde.
Yazma tarafı
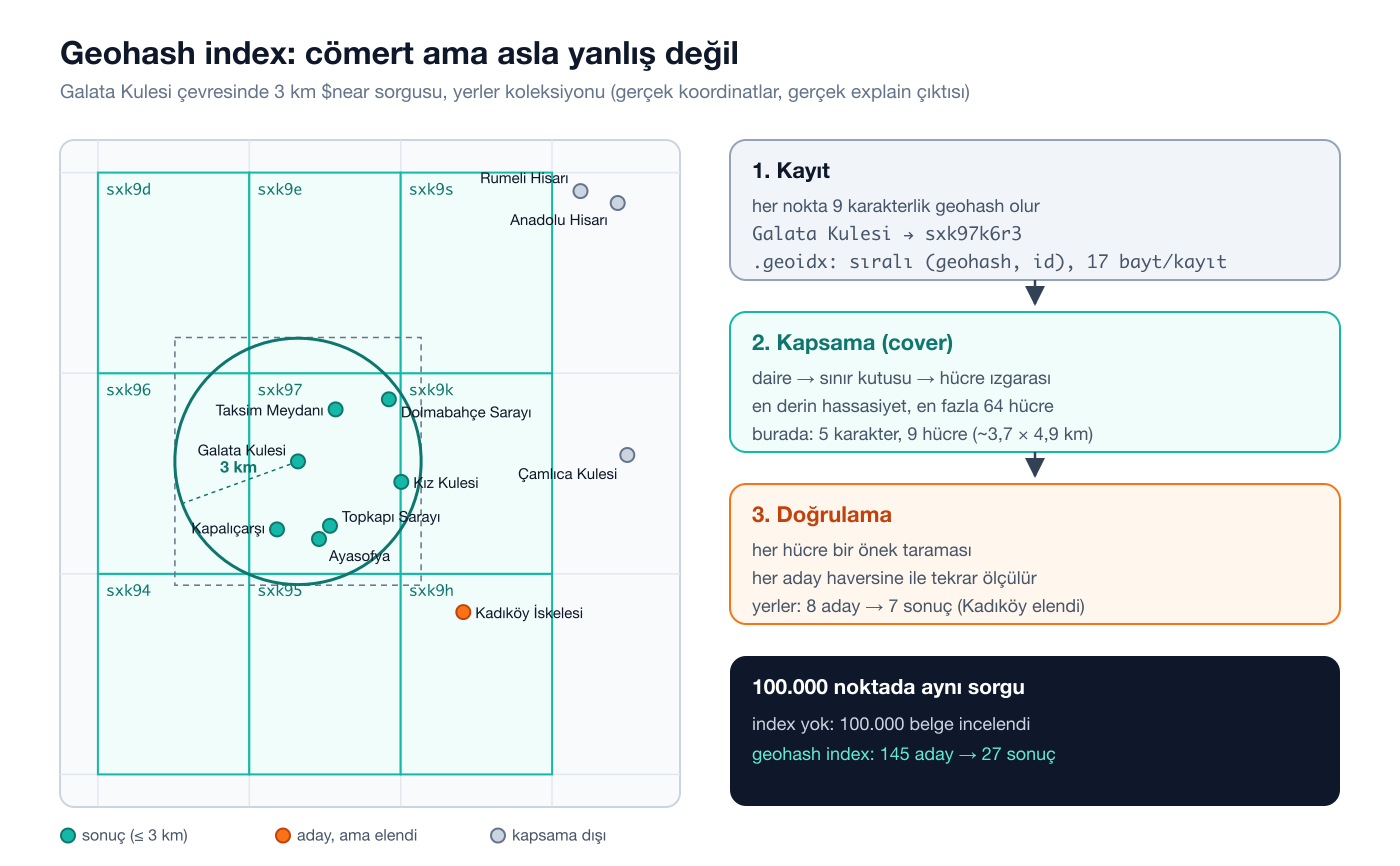
Index'teki her nokta 9 karakterlik sabit hassasiyetli bir geohash'e çevriliyor. 9 karakter yaklaşık 4,8 m × 4,8 m'lik hücre demek. Galata Kulesi sxk97k6r3, Ayasofya sxk973qsr. Index, (geohash, belge id) çiftlerinden oluşan sıralı bir tablo. Bellekte bir BTreeMap<String, BTreeSet<DocumentId>>, diskte .geoidx dosyası.
.geoidx biçimi bilerek çok basit: OXGE sihirli baytları, 4 baytlık sürüm, 8 baytlık kayıt sayısı, ardından sabit genişlikli kayıtlar. Her kayıt 9 bayt ASCII geohash ve 8 bayt little-endian belge id, yani 17 bayt. Sabit genişlik, tüm geohash'lerin tam 9 karakter olmasından geliyor ve bir önek taraması "ikili arama ile alt sınırı bul, önek uyduğu sürece yürü" kadar basit. Test sunucumda 100.000 noktalık koleksiyonun dosyası tam 1.700.016 bayttı: 16 bayt başlık artı 100.000 × 17. Yerler koleksiyonunun dosyasında 14 kayıt var, çünkü konumsuz kafe index'e girmiyor:
00000000: 4f58 4745 0100 0000 0e00 0000 0000 0000  OXGE............
00000010: 7378 6b36 7933 6271 700e 0000 0000 0000  sxk6y3bqp.......
00000020: 0073 786b 3871 7475 7831 0c00 0000 0000  .sxk8qtux1......
Sorgu tarafı: kapsama (cover)
Bir sorgu geldiğinde şekli (daire, kutu veya poligon) önce bir sınır kutusuna çeviriyorum. Daire için bu biraz dikkat istiyor: bir derece boylamın metre karşılığı enleme göre küçülüyor, o yüzden dairenin ulaştığı en geniş enlemi kullanıyorum ki kutu hiçbir zaman eksik kalmasın. Sonra hassasiyeti 9'dan geriye doğru deniyorum ve kutuyu en fazla 64 hücreyle örten en derin hassasiyeti seçiyorum. Hücreleri bulmak için komşu tablosu aritmetiği yapmıyorum; kutunun üzerine hücre boyutunda bir ızgara atıp her örnek noktanın geohash'ini hesaplıyorum. Bu, geohash'in bilinen komşu hesabı tuzaklarını tamamen atlıyor.
Galata Kulesi'nin 3 km çevresi için sonuç 5 karakter hassasiyetinde 9 hücre: sxk94, sxk95, sxk96, sxk97, sxk9d, sxk9e, sxk9h, sxk9k, sxk9s. 6 karakterde 88 hücre gerekecekti, o da 64 sınırını aşıyor. Her hücre index'te bir önek taraması.
Doğrulama: index sadece aday gösterir
Burası tasarımın en önemli kısmı. Index sadece aday gösteriyor. Hücrelerden gelen her aday, belgenin kendisi üzerinde gerçek yükleme karşı (haversine mesafesi, kutu ya da poligon testi) tekrar doğrulanıyor. Kapsama cömert olabilir, fazladan aday getirebilir; ama yanlış olamaz, çünkü son sözü index değil belge söylüyor.
Bunu explain ile görebilirsiniz:
{"cmd": "explain", "inner": {"cmd": "find", "collection": "yerler", "query": {"konum": {"$near": {
  "$geometry": {"type": "Point", "coordinates": [28.9741, 41.0256]}, "$maxDistance": 3000}}}}}
{"ok": true, "data": {"strategy": "INDEX_SCAN", "index_used": "(range/in conditions)", "collection_docs": 15,
"candidates": 8, "examined": 8, "returned": 7, "post_filter": true, "post_filter_ops": [], "sort": "none",
"duration_ms": 0.005}}8 aday, 7 sonuç. Elenen aday Kadıköy İskelesi: sxk9h hücresinde, yani kapsamanın içinde, ama Galata Kulesi'ne 3 km'den uzak. Index onu aday olarak gösterdi, doğrulama onu eledi.
Bu "index bir ipucudur, gerçek değil" sözleşmesi disk modunda daha da önemli hale geliyor. 0.38'den beri varsayılan olan disk öncelikli (disk-first) koleksiyonlarda index iki katmanlı: mmap ile açılan sıralı bir .geoidx tabanı ve son kalıcılaştırmadan beri yapılan yazmaları tutan küçük bir bellek katmanı (overlay). Taşınan ya da silinen bir belgenin eski kaydı dead kümesine giriyor; sorgu onu atlıyor, bir sonraki persist turunda taban ve overlay birleştirilip yeni bir dosyaya yazılıyor ve atomik olarak eskisinin yerine konuyor. Diyelim ki bir şekilde eski bir kayıt kaldı: belge doğrulamada eleneceği için sonuç yine doğru. Temiz bir kapanıştan sonra açılış anlık: belge taraması yok, dosya mmap ile açılıyor. Açılışta dosya kontrol de ediliyor: yanlış sihirli bayt, yanlış sürüm ya da kesik bir dosya reddediliyor ve index belgelerden yeniden kuruluyor. Çökme sonrası kurtarmada da yeniden inşa ediliyor. OXIDB_DISK_FIRST=0 ile açılan bellek modundaki koleksiyonlarda ise sadece index tanımı kalıcı; index açılışta belgeler bir kez taranarak kuruluyor.
Sunucuyu yeniden başlattıktan sonra index'in hâlâ orada olduğunu ve aynı planı ürettiğini kontrol ettim (aynı 145 aday, aynı 27 sonuç). Bir belgenin konumunu güncelleyince index'in onu takip ettiğini de denedim: Topkapı Sarayı'nı $set ile Ankara koordinatlarına taşıdığımda Ayasofya'nın 1,5 km çevresi sorgusundan düştü, geri taşıdığımda tekrar geldi.
Ne kadar fark ediyor?
Marmara bölgesine (boylam 26 ile 31, enlem 39,5 ile 42 arası) rastgele dağıtılmış 100.000 nokta ekledim ve aynı sorguyu index'li ve index'siz aynı veri üzerinde çalıştırdım. Ölçümler bir Apple M4 Mac'te, yerel sunucuda yapıldı:
| Sorgu (100.000 nokta) | Index yok | Geohash index |
|---|---|---|
Galata çevresi 3 km $near: incelenen belge | 100.000 | 145 aday |
| Sonuç | 27 | 27 |
| İstemciden ölçülen medyan süre (20 tekrar) | 40,9 ms | 0,084 ms |
Ayasofya çevresi 10 km $geoWithin: incelenen belge | 100.000 | 527 aday |
| Sonuç | 270 | 270 |
| İstemciden ölçülen medyan süre (20 tekrar) | 34,0 ms | 0,224 ms |
Süreler Python'dan TCP üzerinden ölçüldü; JSON çözme dahil. Asıl önemli satırlar "Sonuç" satırları: index'li ve index'siz cevap aynı. Projenin testleri de (tests/geo_queries.rs) tam olarak bunu kontrol ediyor: index'li sorgunun, ekleme, güncelleme, silme ve yeniden açma sonrasında index'siz taramayla birebir aynı sonucu döndürdüğünü.
Kapsamanın bir de alt sınırı var. Şekil o kadar büyük ki en kaba hassasiyette bile 64 hücreye sığmıyorsa (örneğin yarım gezegen), kapsama "kısıt yok" döndürüyor ve sorgu tam taramaya düşüyor. Mesafe sınırı olmayan $near için de aynısı geçerli: her belge aday, sonra hepsi sıralanıyor. Bu yavaş ama dürüst bir plan.
Graf sorguları
Coğrafi kısım "nerede?" sorusunu cevaplıyor, graf kısmı "neye bağlı?" sorusunu. OxiDB'de graf için ayrı bir veri modeli yok: düğümler normal belgeler, kenarlar ya bir belgedeki referans alanı (bir dizi id gibi) ya da ayrı bir kenar koleksiyonundaki belgeler. İki aşama var: $graphLookup (erişilebilirlik, BFS) ve $shortestPath (en kısa yol, Dijkstra).
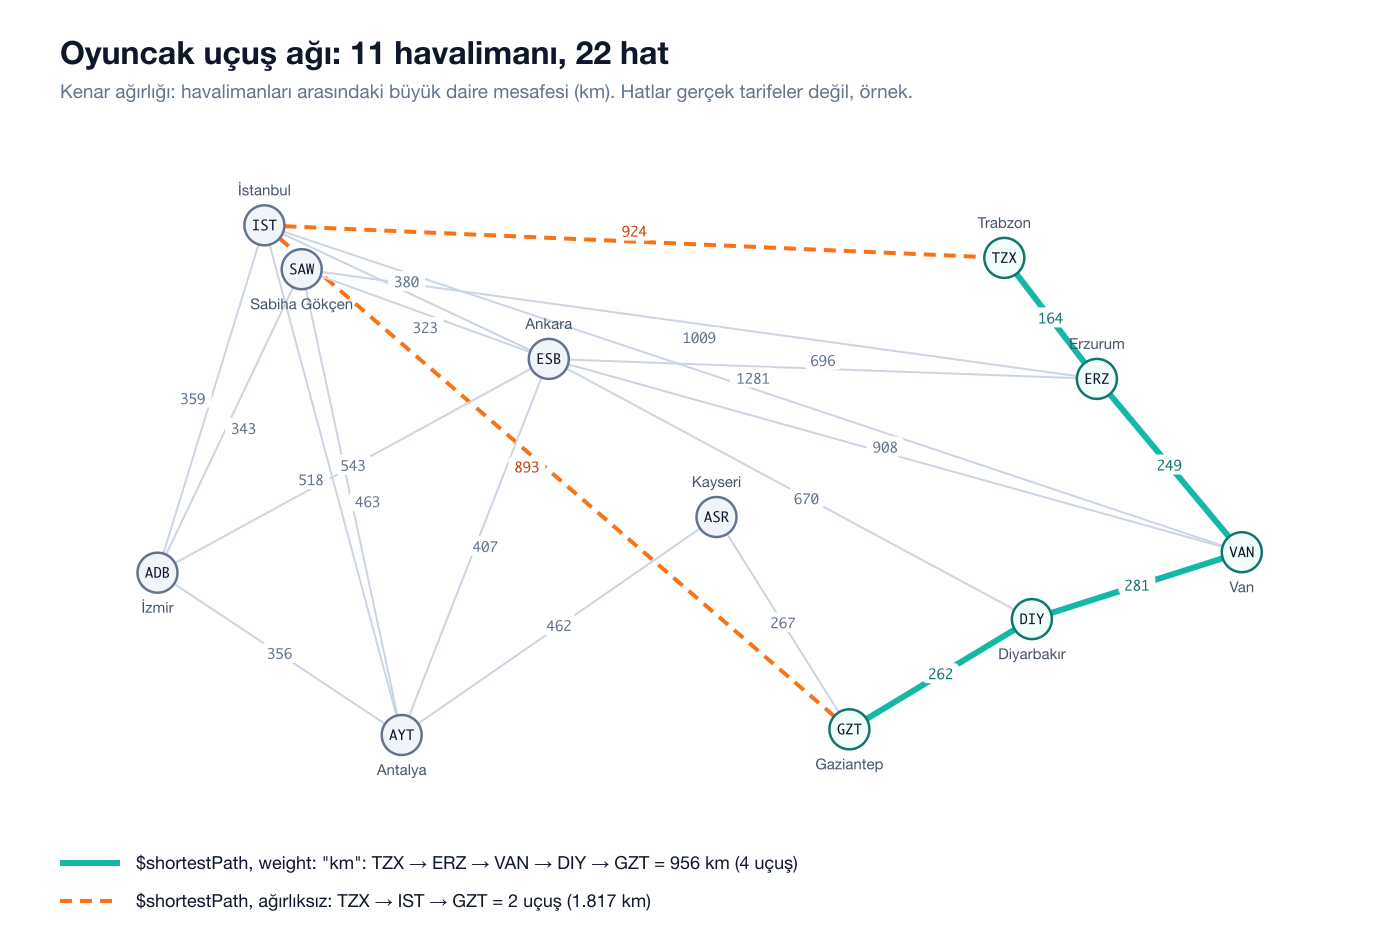
Örnek olarak küçük bir uçuş ağı kurdum: Türkiye'den 11 havalimanı ve 22 hat. Havalimanı koordinatları gerçek, kenar ağırlıkları bu koordinatlardan hesaplanmış büyük daire mesafeleri (km). Hatlar ise gerçek tarifeler değil, örnek olsun diye seçtiğim bir ağ.
İki koleksiyon var. havalimanlari düğümleri tutuyor ve her belgede komşuların kodları bir dizi olarak duruyor; ucuslar ise kenar koleksiyonu:
{"cmd": "find_one", "collection": "havalimanlari", "query": {"kod": "VAN"}}
{"ok": true, "data": {"kod": "VAN", "ad": "Van Ferit Melen", "konum": [43.3323, 38.4682],
  "baglanti": ["DIY", "ERZ", "ESB", "IST"], "_id": 8, "_version": 1}}
{"from": "TZX", "to": "ERZ", "km": 164}
{"from": "ERZ", "to": "VAN", "km": 249}
{"from": "IST", "to": "TZX", "km": 924}Bağlantı alanlarına normal index'ler koydum: havalimanlari.kod, ucuslar.from ve ucuslar.to. Neden önemli olduğu birazdan belli olacak.
$graphLookup: genişlik öncelikli arama
$graphLookup MongoDB'deki aşamanın aynısı: startWith değerlerinden başla, connectToField alanı bu değerlere eşit belgeleri bul, sonra onların connectFromField değerleriyle devam et. "Van'dan en fazla bir aktarmayla nereye gidebilirim?":
{"cmd": "aggregate", "collection": "havalimanlari", "pipeline": [
  {"$match": {"kod": "VAN"}},
  {"$graphLookup": {"from": "havalimanlari", "startWith": "$baglanti",
     "connectFromField": "baglanti", "connectToField": "kod",
     "as": "erisilen", "depthField": "aktarma", "maxDepth": 1}},
  {"$unwind": "$erisilen"},
  {"$project": {"_id": 0, "kod": "$erisilen.kod", "aktarma": "$erisilen.aktarma"}},
  {"$sort": {"aktarma": 1, "kod": 1}}
]}
{"ok": true, "data": [
{"kod": "DIY", "aktarma": 0}, {"kod": "ERZ", "aktarma": 0}, {"kod": "ESB", "aktarma": 0}, {"kod": "IST", "aktarma": 0},
{"kod": "ADB", "aktarma": 1}, {"kod": "AYT", "aktarma": 1}, {"kod": "GZT", "aktarma": 1},
{"kod": "SAW", "aktarma": 1}, {"kod": "TZX", "aktarma": 1}, {"kod": "VAN", "aktarma": 1}
]}maxDepth: 0 sadece direkt uçuşları (DIY, ERZ, ESB, IST) döndürüyor. maxDepth vermezsem arama yeni bir şey bulunmayana kadar sürüyor ve 11 belge dönüyor; Kayseri (ASR) 2. turda geliyor. Listede VAN'ın kendisinin de 1. turda göründüğüne dikkat edin: Van'dan Ankara'ya uçup geri dönebilirsiniz, yani VAN gerçekten de erişilebilir bir düğüm. MongoDB de aynı şekilde davranıyor; başlangıç belgesini istemiyorsanız sonradan bir filtreyle çıkarabilirsiniz.
İçeride: tur başına tek bir $in
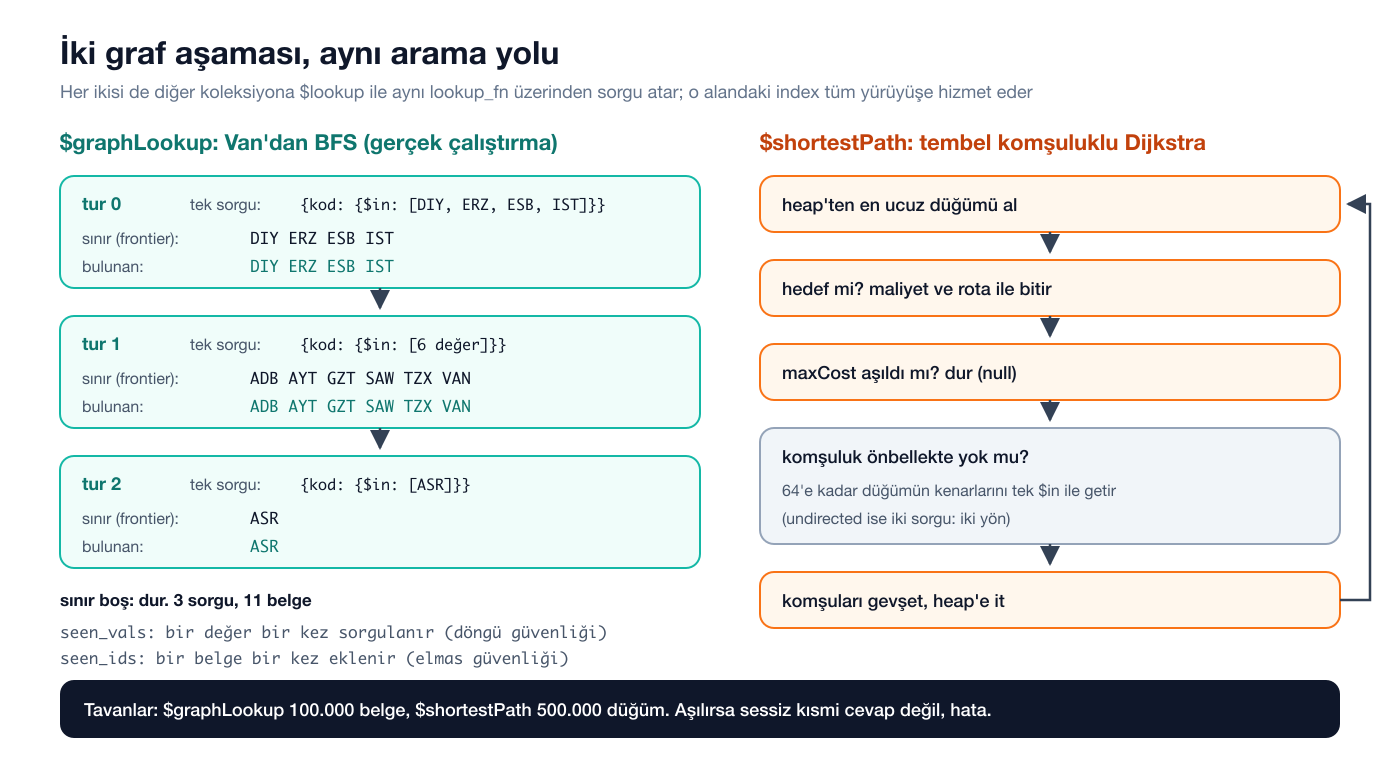
$graphLookup'ın en önemli özelliği her BFS turunun tek bir sorgu olması. O turun sınır (frontier) değerlerinin hepsi tek bir {connectToField: {$in: [...]}} sorgusunda toplanıyor (varsa restrictSearchWithMatch filtresiyle $and içinde). Bu sorgu, $lookup'ın da kullandığı aynı lookup_fn üzerinden gidiyor; yani connectToField üzerindeki normal bir index tüm yürüyüşe hizmet ediyor. Van örneğinde bütün arama 3 sorgu: 0. turda 4 değer, 1. turda 6 değer, 2. turda 1 değer. 3. turda sınır boş ve arama duruyor. Düğüm başına bir sorgu atan naif bir uygulama aynı iş için 11 sorgu atardı; büyük graflarda bu fark binlerle ölçülüyor.
Döngü güvenliği iki ayrı kümeden geliyor ve ikisinin de ayrı bir işi var:
seen_vals: daha önce sorgulanmış bağlantı değerleri. Bir değer en fazla bir kez sorgulanıyor. Bu küme olmasa bir döngü (A takip eder B, B takip eder C, C takip eder A) sonsuza kadar tekrar sorgulanırdı.seen_ids: daha önce toplanmış belge id'leri. Bir belge sonuçta en fazla bir kez görünüyor. Bu küme olmasa bir elmas (A→B→D ve A→C→D) D'yi iki kez döndürürdü.
Bunu küçük bir takip grafıyla denedim: ayşe mehmet'i, mehmet zeynep'i, zeynep hem ayşe'yi hem can'ı takip ediyor. Grafta bir döngü var:
{"cmd": "aggregate", "collection": "takip", "pipeline": [
  {"$match": {"kisi": "ayse"}},
  {"$graphLookup": {"from": "takip", "startWith": "$takip", "connectFromField": "takip",
     "connectToField": "kisi", "as": "ag", "depthField": "d"}},
  {"$unwind": "$ag"},
  {"$project": {"_id": 0, "kisi": "$ag.kisi", "d": "$ag.d"}}
]}
{"ok": true, "data": [{"kisi": "mehmet", "d": 0}, {"kisi": "zeynep", "d": 1}, {"kisi": "can", "d": 2}, {"kisi": "ayse", "d": 2}]}Arama bitiyor ve her kişi bir kez görünüyor.
Budama: restrictSearchWithMatch
restrictSearchWithMatch traversalın içinde uygulanıyor, sonunda değil. Filtreye uymayan bir belge hem sonuçtan çıkıyor hem de aramanın devam ettiği bir kapı olmaktan çıkıyor. "İstanbul ve Ankara aktarmalarını kullanmadan Trabzon'dan nereye gidebilirim?":
{"$graphLookup": {"from": "havalimanlari", "startWith": "$baglanti",
   "connectFromField": "baglanti", "connectToField": "kod", "as": "erisilen", "depthField": "aktarma",
   "restrictSearchWithMatch": {"kod": {"$nin": ["IST", "SAW", "ESB"]}}}}
{"ok": true, "data": [
{"kod": "ERZ", "aktarma": 0}, {"kod": "TZX", "aktarma": 1}, {"kod": "VAN", "aktarma": 1},
{"kod": "DIY", "aktarma": 2}, {"kod": "GZT", "aktarma": 3}, {"kod": "ASR", "aktarma": 4},
{"kod": "AYT", "aktarma": 5}, {"kod": "ADB", "aktarma": 6}
]}Sadece Erzurum üzerinden doğuya ve oradan güneye dolaşarak İzmir'e kadar 6 aktarmayla ulaşılabiliyor. Bu filtre aşama ayrıştırılırken de bir kez parse ediliyor; bozuk bir filtre ilk traversal turunda değil, pipeline kurulurken hata veriyor. maxDepth için de aynı: -1 verince cevap hemen invalid pipeline: $graphLookup maxDepth must be a non-negative integer.
Bir pratik not: startWith ve connectFromField dizi olabilir (dizinin her elemanı ayrı bir değer olarak sınıra giriyor), ama eşleşme connectToField üzerinde eşitlik ile yapılıyor. Hedef belgelerde connectToField skaler bir değer olmalı. Bu yüzden ben komşu listesini baglanti dizisinde, eşleşilen alanı da skaler kod alanında tuttum.
Hata veren tavanlar
Bir graf beklediğinizden çok daha büyük çıkabilir. Bir sosyal ağda "takipçilerin takipçileri" iki adımda milyonlara ulaşabilir. $graphLookup'ın tek bir girdi belgesi için 100.000 belgelik bir tavanı var. Tavan aşılırsa sessizce kısmi bir sonuç dönmüyor, hata dönüyor. Kısmi bir cevap, doğru görünen yanlış bir cevaptır.
Bunu denemek için 100.001 takipçisi olan tek bir hesap oluşturdum:
{"cmd": "aggregate", "collection": "yildiz", "pipeline": [
  {"$match": {"kullanici": "merkez"}},
  {"$graphLookup": {"from": "yildiz", "startWith": "$kullanici", "connectFromField": "kullanici",
     "connectToField": "takip", "as": "takipciler"}},
  {"$project": {"_id": 0, "n": {"$size": "$takipciler"}}}
]}
invalid pipeline: $graphLookup found more than 100000 documents for one input document - narrow the traversal with maxDepth or restrictSearchWithMatch(Gerçek mesajda kaynak koddaki satır devamından kalan fazladan boşluklar var; burada onları tek boşluğa indirdim. Küçük bir kozmetik kusur.) Hata yaklaşık 156 ms içinde geldi; tavan bir OOM'dan çok önce devreye giriyor. Aynı sorguya restrictSearchWithMatch: {"kullanici": {"$in": ["u1", "u2", "u3"]}} eklediğimde cevap {"n": 3} oldu.
$shortestPath: kenar koleksiyonu üzerinde Dijkstra
$shortestPath bir MongoDB aşaması değil; bilerek graf veritabanı bölgesine giren bir ek. Her girdi belgesi için source ve target ifadelerini değerlendiriyor ve from koleksiyonundaki kenarlar üzerinde Dijkstra çalıştırıyor. Her kenar {edgeFrom: düğüm, edgeTo: düğüm, weight: sayı} biçiminde bir belge.
Önce ağırlıksız, yani uçuş sayısını en aza indiren rota: Trabzon'dan Gaziantep'e.
{"$shortestPath": {"from": "ucuslar", "source": "$kod", "target": "GZT",
   "edgeFrom": "from", "edgeTo": "to", "undirected": true, "as": "rota", "costField": "maliyet"}}
{"ok": true, "data": [{"kod": "TZX", "maliyet": 2.0, "rota": [
{"from": "IST", "to": "TZX", "km": 924}, {"from": "IST", "to": "GZT", "km": 893}]}]}İki uçuş, ama İstanbul üzerinden 1.817 km. Şimdi weight: "km" ekleyelim:
{"$shortestPath": {"from": "ucuslar", "source": "$kod", "target": "GZT",
   "edgeFrom": "from", "edgeTo": "to", "undirected": true, "as": "rota", "costField": "maliyet",
   "weight": "km"}}
{"ok": true, "data": [{"kod": "TZX", "maliyet": 956.0, "rota": [
{"from": "TZX", "to": "ERZ", "km": 164}, {"from": "ERZ", "to": "VAN", "km": 249},
{"from": "DIY", "to": "VAN", "km": 281}, {"from": "GZT", "to": "DIY", "km": 262}]}]}Dört uçuş ama sadece 956 km: Trabzon, Erzurum, Van, Diyarbakır, Gaziantep. rota dizisi kaynak ile hedef arasındaki kenar belgelerini sırayla veriyor. undirected: true olduğunda kenarlar her iki yönde de kullanılabiliyor ama belgeler saklandığı haliyle dönüyor; o yüzden {"from": "DIY", "to": "VAN"} kenarı rotada VAN'dan DIY'ye doğru kullanılmış olsa da öyle görünüyor. Yönü siz okurken çıkarıyorsunuz.
Diğer parametreler:
restrictSearchWithMatch: kenarlara uygulanan filtre. İzmir'den Van'a en kısa rota Ankara üzerinden 1.451 km (ADB, ESB, VAN). Ankara'yı içeren kenarları{"from": {"$nin": ["ESB"]}, "to": {"$nin": ["ESB"]}}ile çıkarınca rota Sabiha Gökçen ve Erzurum üzerinden 1.601 km oluyor.maxCost: maliyet bu değeri aşınca arama duruyor. Aynı İzmir-Van sorgusundamaxCost: 1200verince cevap{"maliyet": null, "rota": []}oldu. Heap her zaman en ucuz düğümü verdiği için, heap'in tepesi sınırı aştığı anda geri kalan her şey de aşıyor; durmak güvenli.undirectedvermezsem (varsayılanfalse) kenarlar sadece saklandıkları yönde kullanılıyor. Benim ağımda Trabzon'dan Gaziantep'e yönlü bir yol yok; cevapmaliyet: null.- Kaynak ile hedef aynıysa bu "erişilemez" değil, sıfır uzunlukta bir yol:
IST'denIST'yemaliyet: 0.0,rota: [].
İçeride: tembel komşuluk
Dijkstra'nın kendisi ders kitabındaki gibi ve settle sırasından hiçbir şekilde taviz verilmiyor: heap her zaman en ucuz settle edilmemiş düğümü veriyor. Toplu yapılan şey veri çekme. En ucuz düğümün komşuluğu henüz önbellekte yoksa, o düğümle birlikte heap'teki komşuluğu henüz çekilmemiş 63 düğüme kadar daha toplanıyor ve hepsinin kenarları tek bir $in sorgusuyla getiriliyor (undirected ise iki sorgu, her yön için bir tane). Bu sorgu da $lookup ve $graphLookup ile aynı lookup_fn üzerinden gidiyor; edgeFrom ve edgeTo alanlarındaki index'ler aramaya hizmet ediyor. Komşuluk bir kez çekildikten sonra önbellekte kalıyor.
"Tembel" kelimesi önemli: kenar koleksiyonunun tamamı belleğe yüklenmiyor. Sadece aramanın gerçekten dokunduğu düğümlerin komşulukları çekiliyor. Hedef yakındaysa, milyonlarca kenarlık bir koleksiyonda bile sadece birkaç sorgu atılıyor.
Dijkstra'nın doğruluğu negatif olmayan ağırlıklara bağlı ve bunu sessizce varsaymak yerine kontrol ediyorum:
invalid pipeline: $shortestPath: negative or non-finite weight -2 - Dijkstra requires non-negative weightsAğırlık alanı olmayan ya da sayı olmayan bir kenar da hata:
invalid pipeline: $shortestPath: edge has no numeric 'ucret' weight: {"from":"TZX","to":"ERZ","km":164,"_id":21,"_version":1}Negatif maxCost da ($shortestPath maxCost must be a non-negative number). Ve $graphLookup gibi bir tavanı var: 500.000 settle edilmiş düğüm. Aşılırsa yine hata, mesaj da ne yapılacağını söylüyor: aramayı maxCost veya restrictSearchWithMatch ile sınırlayın. Bu tavanı 500.000 düğümlük bir graf kurup ayrıca denemedim; değer kaynak kodda (MAX_SETTLED) duruyor.
Sınırlar ve dürüst ödünler
- Sadece noktalar. Belgelerde çizgi (LineString) veya poligon saklayıp "bu yol bu bölgeden geçiyor mu?" diye soramazsınız. Sorgu tarafında poligon var, veri tarafında yok. Bu bilinçli bir v1 kapsamı: konum verisinin büyük çoğunluğu nokta (kullanıcı, araç, mağaza, sensör).
- Poligonlar düzlemde. Geofence boyutunda doğru, kıta boyutunda değil. 180 derece boylamdan geniş poligonlar reddediliyor;
$boxantimeridyeni sarmıyor. - Sorgu başına tek bir geo yüklem index'ten yararlanıyor. Bir sorguda birden fazla geo yüklem varsa ilki aday üretiyor, diğerleri doğrulamada kontrol ediliyor. Normal bir index ile birleşme ise iyi çalışıyor:
turalanına da index koyduğumda{"tur": "kule", "konum": {"$near": ... 3 km}}sorgusunun explain çıktısı 2 aday gösterdi; iki index'in aday kümeleri kesiştirildi. - Sınırsız
$neartam tarama demek.$maxDistancevermezseniz index bir kapsama hesaplayamaz; her belge aday olur ve sonra sıralanır. Büyük koleksiyonlarda her zaman bir mesafe sınırı verin ya dalimitile birlikte kullanın. $nearsıralaması bellekte. Sıralama, aday kümesi doğrulandıktan sonra bellekte yapılıyor. Kapsama küçük olduğunda bu ihmal edilebilir, sınırsız bir sorguda değil.- Graf aşamaları girdi belgesi başına çalışıyor. 1.000 belgelik bir
$matchsonrası$graphLookup1.000 ayrı BFS demek. Önce daraltın. $shortestPathsadece negatif olmayan ağırlıklarla. Negatif kenarlar için Bellman-Ford yok; hata alırsınız.- Tek bir en kısa yol. Eşit maliyetli birden fazla yol varsa biri dönüyor; k-en kısa yol veya tüm yollar yok.
OxiDB'nin geri kalanıyla nasıl birleşiyor?
Coğrafi ve graf sorguları ayrı bir motor değil, doküman motorunun sorgu dilinin parçası. Bu yüzden diğer her şeyle doğal olarak birleşiyorlar: aynı pipeline içinde $geoNear sonrası $group, $graphLookup sonrası $lookup kullanabilirsiniz. Konum alanı da sonuçta sıradan bir alan; güncellemeler, silmeler ve index bakımı doküman motorunun geri kalanıyla aynı yoldan geçiyor.
Aynı motor WebAssembly'ye de derleniyor. Geo globe demosu bunun canlı hali: GeoNames'ten yerleşim yerleri bir tarayıcı sekmesinde OxiDB'ye yükleniyor, küreye tıkladığınızda gerçek bir $near, kaydırıcıyı sürüklediğinizde $centerSphere ile bir $geoWithin çalışıyor, rota modunda ise iki tıklama yol ağına $near ile oturtuluyor ve $shortestPath (Dijkstra) tek bir aggregation olarak sekmenin içinde çalışıyor. Sunucu yok.
Redis protokolüyle konuşmak isteyenler için OxiMem tarafında GEOADD, GEOSEARCH, GEODIST gibi RESP GEO komutları da var; orada Redis'in kendi tasarımını izledim (bir GEO anahtarı, 52 bitlik geohash ile skorlanan bir sorted set). Zaman serisi verisini zaman serisi motorunda, sorgu tarafını SQL ile yazmayı seviyorsanız SQL motorunu anlattığım yazılara bakabilirsiniz. Benzerlik grafikleri gibi şeyler için de öneri motoru ayrı bir yazının konusu.
Denemek için
OxiDB tek bir binary. En kolay yol GitHub sürümler sayfasından kendi platformunuza uygun binary'yi indirmek ya da Docker imajını kullanmak. Sunucuyu başlatın, create_geo_index ile bir konum alanını index'leyin ve yukarıdaki sorguları deneyin. Graf için ayrı bir kurulum yok: belgeleriniz zaten düğüm, referanslarınız zaten kenar. Index'leri bağlantı alanlarına koymayı unutmayın; $graphLookup ve $shortestPath'in hızı neredeyse tamamen buna bağlı.
Bir sonraki adımda bu yazıdaki kuralı korumaya devam edeceğim: bir sorguyu doğru cevaplayamıyorsam, yaklaşık bir cevap yerine açık bir hata vereceğim.