OxiDB'de zaman serisi motoru: Gorilla sıkıştırması, rollup'lar ve blok düzeyinde saklama
OxiDB'nin zaman serisi motoru oxidb-tsdb: Gorilla sıkıştırmasını bit bit, tipli alanları, satır protokolünü, toplamaları, çökmeye dayanıklı rollup'ları ve kendi sensör verimde ölçtüğüm gerçek sıkıştırma oranlarını anlatıyorum.
Bir soğuk hava deposunda on sıcaklık sensörü olduğunu düşünün. Her biri saniyede bir değer gönderiyor. Bir günde bu 864.000 nokta eder, bir yılda 315 milyon. Bu verinin her noktasını bir JSON belgesi olarak saklamak mümkün, OxiDB'nin belge motoru bunu seve seve yapar; ama her belgede aynı ölçüm adı, aynı etiketler, aynı alan adları tekrar tekrar yazılır ve nokta başına yüz baytı geçen bir bedel ödenir. Oysa noktanın taşıdığı gerçek bilgi bir zaman damgası ile bir sayıdır. OxiDB'ye bu yüzden ayrı bir zaman serisi motoru yazdım: oxidb-tsdb. Bu yazıda motorun ne işe yaradığını, nasıl açıldığını, veri modelini, Gorilla sıkıştırmasını bit bit, sorgu ve toplama yüzeyini, sürekli rollup'ları, saklama (retention) ve yedeklemeyi anlatıyorum. Gösterdiğim her çıktı, bu yazı için kendi makinemde (Apple M4, yerel) çalıştırdığım gerçek bir oxidb-server 0.44.2'den geliyor; sıkıştırma oranlarını da ürettiğim sensör verisi üzerinde ölçtüm.
Neden ayrı bir motor?
Zaman serisi verisinin üç belirgin özelliği var. Şekli hiç değişmez: aynı ölçüm, aynı etiketler, aynı alanlar, sonsuza kadar. Zaman damgaları düzenlidir: saniyede bir yazan bir toplayıcı hep yaklaşık 1000 ms arayla yazar. Değerler yavaş değişir: bir sıcaklık ardışık iki ölçümde çoğu zaman ya aynıdır ya da son basamakta oynar. Üstüne veri neredeyse hep sona eklenir ve sorgular tek tek noktaları değil aralıkları ve özetleri sorar: "son bir saatin dakikalık ortalaması", "bugünün p95 değeri".
Belge modeli bu özelliklerin hiçbirinden yararlanamaz; çünkü esnekliği her belgeye kendi şemasını iliştirmesinden gelir. Sütunsal bir depolama ise tam bu tekrarı ortadan kaldırır: alan adı bir kez seri kimliğinde yazılır, değerler adsız ve tek tipte bir akış olur. Benzer değerlerin yan yana durması da sıkıştırmanın en sevdiği durumdur.
oxidb-tsdb, SQL motoru gibi aynı süreç içinde çalışan ama kendi dizini, kendi dosya biçimi ve kendi sorgu yüzeyi olan ayrı bir Rust crate'i. Varsayılan olarak kapalı; açmadığınız sürece tek bayt maliyeti yok.
Motoru açmak
Bir ortam değişkeni yeterli:
OXIDB_ADDR=127.0.0.1:15500 \
OXIDB_DATA=./data \
OXIDB_TSDB=1 \
OXIDB_HTTP_PORT=15501 \
./oxidb-server
Sunucu açılırken motoru tembel (lazy) kurar ve ilk TSDB isteğinde log'a şunu yazar:
[oxidb] TSDB engine enabled (default db at ./data/tsdb)OXIDB_TSDB_DATA ile varsayılan veritabanının TSDB dizinini başka bir yere alabilirsiniz. Motor, SQL motoru gibi veritabanı başınadır: varsayılan veritabanı $OXIDB_DATA/tsdb altında, adlandırılmış bir metrics veritabanı ise $OXIDB_DATA/metrics/tsdb altında yaşar. Belge motorunu tamamen kapatıp (OXIDB_DOC=0) süreci yalnızca SQL ve TSDB sunucusu olarak çalıştırmak da mümkün.
Tel protokolü OxiDB'nin her motor için kullandığı protokol: 4 baytlık küçük-endian uzunluk öneki ve ardından JSON. İsteğe "engine": "tsdb" eklenir, tüm istekler cmd: "tsdb" altında toplanır, op alanı eylemi seçer: write, write_lp, query, distance, track, stats, retention, checkpoint, rollup_add, rollup_refresh, rollups. Yetkilendirmede Read rolü yalnızca sorgu çalıştırabilir; yazma, retention ve rollup tanımlamak ReadWrite ister.
Örneklerde depodaki Python istemcisinin alt düzey _request çağrısını kullanıyorum; istemcide TSDB'ye özel bir yardımcı henüz yok, ama gerek de yok:
from oxidb import OxiDbClient

db = OxiDbClient(host="127.0.0.1", port=15500)

def tsdb(op, **kw):
    return db._request({"engine": "tsdb", "cmd": "tsdb", "op": op, **kw})
Veri modeli: ölçüm, etiketler, alanlar
Model InfluxDB'nin modeli. Bir nokta dört parçadan oluşur: bir ölçüm (measurement) adı, sıfır ya da daha çok etiket (tag, hepsi metin), bir ya da daha çok alan (field, ölçülen değerin kendisi) ve milisaniye cinsinden bir zaman damgası.
Etiketler kimliktir: hangi tesis, hangi oda, hangi sensör. Sorguda onlara göre filtreler ve gruplarsınız. Alanlar veridir. Motor bu ayrımı içeride sert biçimde uygular:
Bir seri = ölçüm × (sıralı) etiket kümesi × alan adı.
Yani coldroom,site=izmir,room=r1 temp=3.9,door_open=f noktası iki alan taşıdığı için iki ayrı seriye bölünür: coldroom|room=r1,site=izmir|temp ve coldroom|room=r1,site=izmir|door_open. Etiketler anahtara göre sıralanır, böylece hangi sırayla yazılırsa yazılsın aynı etiket kümesi aynı seriye düşer.
Tipli alanlar
Alanların tipi var: float, integer, boolean ve string. Sayısal üçlü aynı Gorilla yolundan geçer, hepsi içeride f64 olarak saklanır (tamsayılar 2^53'e kadar tam, boolean 0/1), ama tip seri başına hatırlanır ve sorgu yanıtında "type" olarak geri gelir. Metin alanları ayrı bir yolda (zaman, metin) çiftleri olarak tutulur.
JSON ile yazarken tipi JSON değerinin kendisi belirler: true/false boolean, tam sayı integer, metin string, geri kalanı float. İki noktayı tek istekte yazıyorum:
{"engine": "tsdb", "cmd": "tsdb", "op": "write", "points": [
  {"measurement": "coldroom", "tags": {"site": "izmir", "room": "r1"},
   "fields": {"temp": 3.8, "door_open": false, "compressor_rpm": 2950, "state": "cooling"},
   "ts": 1790812800000},
  {"measurement": "coldroom", "tags": {"site": "izmir", "room": "r2"},
   "fields": {"temp": 4.1, "door_open": true, "compressor_rpm": 3010, "state": "defrost"},
   "ts": 1790812800000}]}
{"ok": true, "data": {"written": 2}}InfluxDB satır protokolü
Metrik dünyasının ortak dili InfluxDB'nin satır protokolü (line protocol); Telegraf gibi toplayıcılar bu biçimde konuşur ve motor onu doğrudan yutar. Tip son ekle belirlenir: 3.9 float, 2940i integer, t/f/true/false boolean, "..." string. Zaman damgası milisaniye (InfluxDB'nin varsayılanı nanosaniyedir, buna dikkat); yoksa sunucunun o anki saati kullanılır. Boşluk ve virgül ters eğik çizgiyle kaçışlanabilir (us\ midwest).
{"engine": "tsdb", "cmd": "tsdb", "op": "write_lp",
 "lp": "coldroom,site=izmir,room=r1 temp=3.9,door_open=f,compressor_rpm=2940i,state=\"cooling\" 1790812860000\ncoldroom,site=izmir,room=r2 temp=4.4,door_open=t,compressor_rpm=3050i,state=\"defrost\" 1790812860000\ncoldroom,site=ankara,room=r1 temp=2.7,door_open=false,compressor_rpm=2800i,state=\"cooling\" 1790812860000"}
{"ok": true, "data": {"written": 3}}Tiplerin geri geldiğini görmek için birkaç sorgu. Son sıcaklık, tesis ve odaya göre gruplanmış:
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "coldroom", "field": "temp",
 "group_by": ["site", "room"], "agg": "last"}
{"ok": true, "data": [
{"tags": {"site": "ankara", "room": "r1"}, "type": "float", "points": [{"ts": 1790812860000, "value": 2.7}]},
{"tags": {"site": "izmir", "room": "r1"}, "type": "float", "points": [{"ts": 1790812800000, "value": 3.9}]},
{"tags": {"site": "izmir", "room": "r2"}, "type": "float", "points": [{"ts": 1790812800000, "value": 4.4}]}]}Kompresör devri integer, kapı boolean olarak raporlanıyor; boolean bir alanın ortalaması da "kapının açık kaldığı zaman oranı" anlamına geliyor:
compressor_rpm, tags={"site":"izmir"}, agg=max
{"tags": {}, "type": "integer", "points": [{"ts": 1790812800000, "value": 3050.0}]}

door_open, group_by=["room"], agg=mean
{"tags": {"room": "r1"}, "type": "boolean", "points": [{"ts": 1790812800000, "value": 0.0}]}
{"tags": {"room": "r2"}, "type": "boolean", "points": [{"ts": 1790812800000, "value": 1.0}]}

state, agg=distinct
{"tags": {}, "type": "string", "points": [{"ts": -4611686018427387904, "value": 2.0}]}
Bu çıktılarda iki pürüz var ve bunları saklamak istemiyorum. Birincisi: interval verilmeyen bir sorguda tek kovanın zaman damgası, kovadaki en eski noktanın zamanı oluyor. Yukarıda last 3.9 değerini doğru veriyor ama yanına ilk noktanın zamanını koyuyor. İkincisi: metin alanlarının sorgu yolu, sayısal yolda düzelttiğim "sınırsız aralık" işaretçisini hâlâ sızdırıyor; start vermezseniz zaman damgası i64::MIN/2 olarak dönüyor. Değer doğru, zaman damgası anlamsız; düzeltilmesi gereken küçük bir hata. Pratikte start verdiğinizde ortadan kalkıyor.
Gorilla sıkıştırması
Motorun kalbi gorilla.rs. Adını Facebook'un 2015'te VLDB'de yayımladığı bellek içi zaman serisi veritabanından alıyor ve fikri iki ayaklı: zaman damgalarını delta'nın delta'sıyla (delta-of-delta), değerleri XOR ile kodlamak. Bir blok kendi kendini tanımlar: [u32 nokta sayısı][i64 t0][f64 v0][bit akışı], yani 20 baytlık bir başlık ve bit düzeyinde paketlenmiş bir gövde. Gövdede önce tüm zaman damgaları, ardından tüm değerler gelir.
Zaman damgaları: delta-of-delta
Saniyede bir yazan bir sensörün ardışık farkları (delta) hep 1000'dir; farkların farkı (dod) ise sıfır. Sıfırı yazmak için tek bir 0 biti yeter. Sıfır değilse değer zigzag ile işaretsize çevrilip değişken genişlikte kovalara düşer:
| dod aralığı | Önek | Yük | Toplam |
|---|---|---|---|
| 0 | 0 | yok | 1 bit |
| -64 .. 63 | 10 | 7 bit | 9 bit |
| -256 .. 255 | 110 | 9 bit | 12 bit |
| -2048 .. 2047 | 1110 | 12 bit | 16 bit |
| diğer her şey | 1111 | 64 bit | 68 bit |
Bir incelik: ilk delta, sıfır olan "önceki delta"ya göre kodlanır. 1 saniyelik bir seride ilk dod 1000'dir ve 16 bit tutar; 10 saniyelik bir seride ilk dod 10.000 olur, 2047'yi aştığı için 68 bit öder. Blok başına bir kez ödendiği için önemsiz.
Değerler: XOR
Ardışık iki f64'ün bit desenleri XOR'lanır. Değer değişmediyse XOR sıfırdır ve tek bir 0 biti yazılır. Değiştiyse XOR'un anlamlı penceresi, yani baştaki sıfırlardan sonrası ile sondaki sıfırlardan öncesi saklanır. Önceki pencere yeni XOR'u kapsıyorsa (baştaki sıfır sayısı en az önceki kadar, sondaki de en az önceki kadar) pencere tanımı hiç yazılmaz: 1 (değişti), 0 (aynı pencere) ve anlamlı bitler. Kapsamıyorsa 1, 1, 5 bitlik baştaki sıfır sayısı, 6 bitlik pencere genişliği ve pencerenin kendisi yazılır.
Bit bit bir örnek
Bunu soyut bırakmak yerine beş noktalık bir seriyi elle izledim. Zaman damgaları 0, 1000, 2000, 3003, 4000 ms (dördüncü nokta 3 ms geç kalmış bir sensör), değerler 21.5, 21.5, 21.75, 21.5, 22.0. gorilla.rs'in kodlayıcısını satır satır Python'a çevirdim, aynı seriyi gerçek sunucuya yazdım, checkpoint aldım ve blocks.43.tsb dosyasını ayrıştırıp sunucunun ürettiği bloğu çıkardım:
values (hex bits):
    21.5 = 4035800000000000
    21.5 = 4035800000000000
   21.75 = 4035c00000000000
    21.5 = 4035800000000000
    22.0 = 4036000000000000
trace:
   ('ts', 1000, 1000, 1000, '1110 011111010000')
   ('ts', 2000, 1000, 0, '0')
   ('ts', 3003, 1003, 3, '10 0000110')
   ('ts', 4000, 997, -6, '10 0001011')
   ('val', 21.5, '0000000000000000', '-', '0')
   ('val', 21.75, '0000400000000000', 'new lead=17 trail=46 m=1', '1 1 10001 000000 1')
   ('val', 21.5, '0000400000000000', 'reuse lead=17 trail=46', '1 0 1')
   ('val', 22.0, '0003800000000000', 'new lead=14 trail=47 m=3', '1 1 01110 000010 111')
bitstream: 69 bits -> 9 bytes; block = 20 header + 9 = 29 bytes (raw 5x16 = 80)
python block: 0500000000c4c2f4a00100000000000000803540e7d041a16e206ee0b8
server block: 0500000000c4c2f4a00100000000000000803540e7d041a16e206ee0b8 min 1790812800000 max 1790812804000 count 5
IDENTICAL: True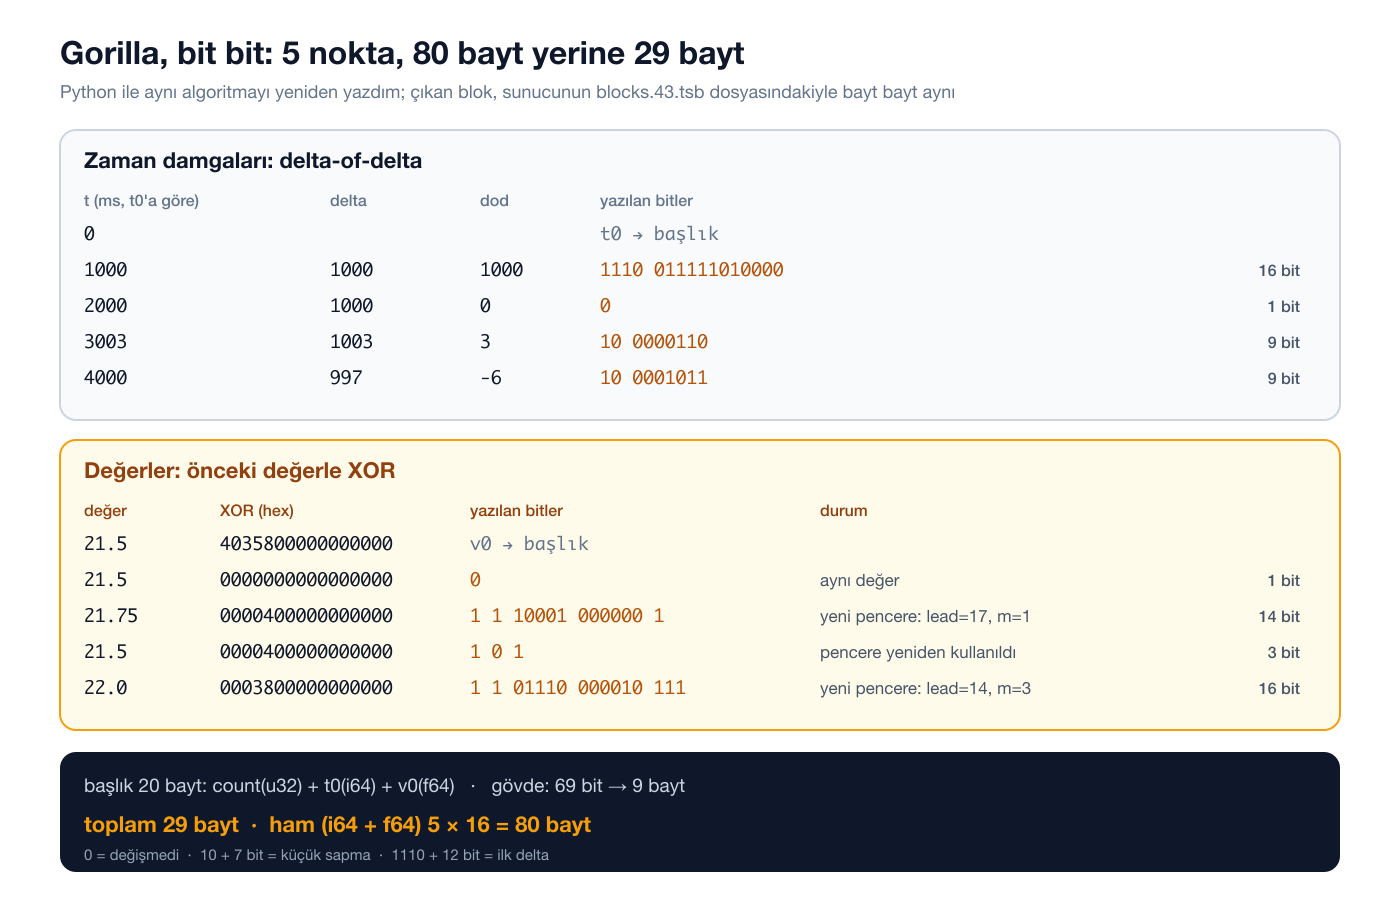
Satır satır okuyalım:
- İlk delta 1000, önceki delta 0 sayıldığı için dod de 1000. -2048..2047 kovasına düşüyor:
1110öneki ve 1000'in zigzag hâli (2000, 12 bit:011111010000). 16 bit. - İkinci nokta tam zamanında: dod 0, tek bit.
- 3 ms gecikme iki kez ödeniyor: önce delta 1003 olduğu için dod +3 (
10+ zigzag(3)=6), sonra bir sonraki delta 997'ye düştüğü için dod -6 (10+ zigzag(-6)=11). Her biri 9 bit. Jitter'ın neden pahalı olduğunu ileride ölçümde de göreceğiz. - İkinci değer aynı: tek
0biti. - 21.75: 21.5 ile XOR'u
0000400000000000. Tek bir bit yanıyor; baştaki sıfır sayısı 17, sondaki 46, pencere 1 bit. Önceki pencere olmadığı için tanım yazılıyor:1 1 10001 000000 1, 14 bit. - Tekrar 21.5: XOR aynı, pencere kapsanıyor, yeniden kullanılıyor:
1 0 1, yalnızca 3 bit. - 22.0: XOR
0003800000000000, baştaki sıfır 14'e düştü, önceki pencere artık kapsamıyor, yeni pencere: 16 bit.
Toplam 35 bit zaman, 34 bit değer, 69 bit; 9 bayta yuvarlanıyor. Başlıkla birlikte 29 bayt; ham hâli (i64 + f64) 80 bayt olurdu. Beş noktada başlık baskın; asıl kazanç 1024 noktalık bloklarda, başlığın nokta başına 0,16 bite indiği yerde ortaya çıkıyor.
Bu örnekte 21.5, 21.75, 22.0 gibi ikilik tabanda tam ifade edilebilen değerler seçtim. Gerçek bir sıcaklık sensörü 3.8 ve 3.9 gönderir; bu ikisinin XOR'u 0001555555555555, yani 49 bitlik bir pencere. Ondalık kesirlerin ikilik tabanda sonsuz açılımı XOR'u şişirir. Bunun pratikte ne kadar önemli olduğunu aşağıdaki ölçüm gösteriyor.
Gerçek sıkıştırma oranı: kendi sensör verimle
Repodaki kitap ve examples/ratio.rs, yuvarlanmış ve uzun süre sabit kalan bir gauge için nokta başına yaklaşık 0,28 bayt (ham ikiliye göre ~56 kat) diyor. Bu projenin kendi ölçümü; ben iyimser durumu değil, farklı veri şekillerini görmek istedim. On sensör, bir gün, saniyede bir örnek ürettim (şekil başına 864.000 nokta), satır protokolüyle 10.000 satırlık partiler hâlinde yazdım, checkpoint aldım ve sunucunun stats yanıtındaki sıkıştırılmış bayt sayısının farkını ölçtüm. Karşılaştırma için aynı veriyi sütunsal ham ikili olarak (önce tüm zamanlar, sonra tüm değerler) zlib seviye 6 ile de sıkıştırdım.
| Veri şekli | Sıkıştırılmış | Bit/nokta | Ham ikiliye göre | gzip -6 |
|---|---|---|---|---|
| boolean kapı, seyrek değişen | 238.066 B | 2,2 | 58,1 kat | 6,3 kat |
| tamsayı nem (%) | 409.529 B | 3,8 | 33,8 kat | 5,7 kat |
| sıcaklık, float, 0,1 çözünürlük | 1.142.690 B | 10,6 | 12,1 kat | 5,8 kat |
| aynı sıcaklık, ±5 ms zaman jitter'ı | 1.955.295 B | 18,1 | 7,1 kat | 5,4 kat |
| tamsayı sayaç (monoton artan) | 1.933.080 B | 17,9 | 7,2 kat | 3,6 kat |
| float, tam hassasiyetli gürültü | 6.150.471 B | 56,9 | 2,2 kat | 1,6 kat |
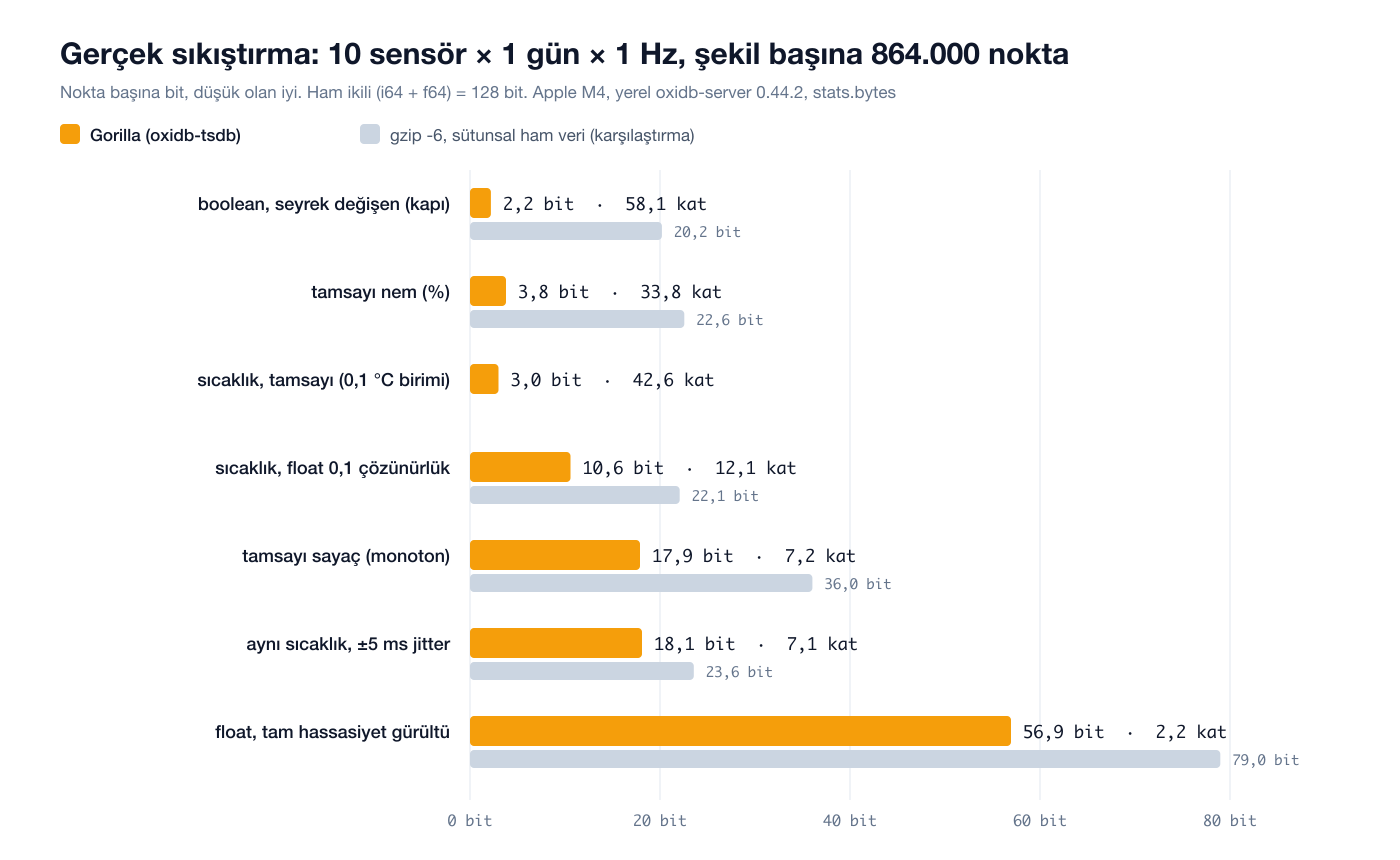
Bu tablodan birkaç ders çıkıyor:
- Seyrek değişen veri neredeyse bedava. Kapı sensörü nokta başına 2,2 bit: 1 bit zaman, çoğunlukla 1 bit değer. Ham ikiliye göre 58 kat.
- Ondalık float pahalı. 0,1 çözünürlüklü sıcaklık 10,6 bit/nokta. Ürettiğim rastgele yürüyüşte değer noktaların yaklaşık %16'sında değişiyor ve her değişim yaklaşık 49 bitlik bir XOR penceresi yazıyor.
- Aynı veriyi tamsayı olarak saklamak 3,5 kat daha iyi. Bunu ayrıca denedim: aynı tohumla üretilmiş aynı sıcaklık serisini bir kez
3.8gibi float, bir kez38igibi "0,1 °C birimi" tamsayı olarak yazdım. Float hâli 1.132.370 bayt (10,5 bit/nokta, 12,2 kat), tamsayı hâli 324.259 bayt (3,0 bit/nokta, 42,6 kat). Tamsayılarınf64bit desenlerinde mantisin son bitleri sıfır olduğu için XOR penceresi dar kalıyor. Sensör verinizin çözünürlüğü sabitse, onu tamsayı birimde yazın. - Zaman jitter'ı değer sıkıştırması kadar önemli. Aynı sıcaklık verisine yalnızca ±5 ms zaman sapması eklemek nokta başına 7,5 bit ekledi. Toplayıcının zaman damgasını kendi saatine yuvarlaması (örneğin tam saniyeye) bu yüzden çok şey kazandırır.
- Sayaçlar orta karar. Monoton artan bir sayacın her değeri farklı ve büyüklüğü sürekli değişiyor; XOR'un yapabileceği sınırlı. 17,9 bit.
- Gürültüye mucize yok. Tam hassasiyetli rastgele float'larda Gorilla da 2,2 katta kalıyor; ama orada bile gzip'in önünde.
Her durumda Gorilla genel amaçlı gzip'ten daha iyi, çünkü veriyi tanıyor. Karşılaştırma için aynı noktanın belge olarak JSON hâli 107 ile 122 bayt, satır protokolü metni 55 ile 70 bayt arasındaydı. Altı şeklin toplamı 5.184.000 nokta ve 11,8 MB sıkıştırılmış veri; diskteki blocks.43.tsb dosyası 12,2 MB (aradaki fark her blok kaydında tekrarlanan seri anahtarı).
Yazma hızını da not edeyim: tek bir Python bağlantısından, 10.000 satırlık partilerle, Python'un kendi veri üretimi dahil saniyede 150.000 ile 220.000 nokta arası yazdı. Bu bir kıyaslama değil, sadece bu yazının deneylerinde gördüğüm rakam.
İçeride: bloklar, aktif tampon ve WAL
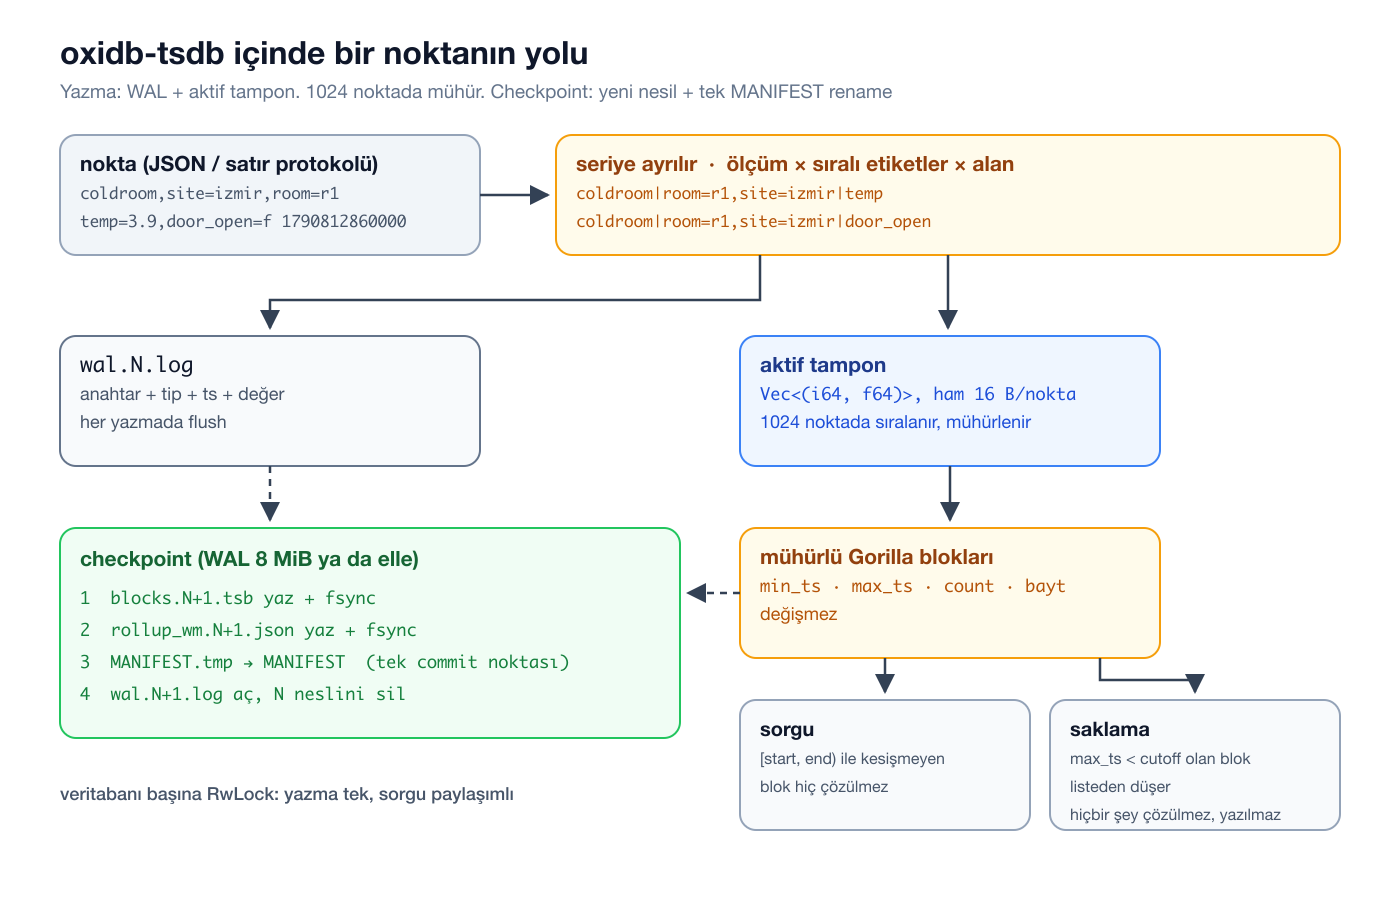
Bir seri iki parçadan oluşur: mühürlenmiş bloklar ve bir aktif tampon. Gelen nokta önce WAL'a eklenir, sonra seriye ait tampona (Vec<(i64, f64)>) düşer. Tampon 1024 noktaya ulaşınca mühürlenir: zamana göre sıralanır, Gorilla ile kodlanır ve min_ts, max_ts, count bilgileriyle bir Block olur. Bloklar bir daha değişmez.
Bu yapının üç sonucu var:
- Sorgu budaması. Bir aralık sorgusu
[start, end)ile kesişmeyen blokları hiç çözmez. 864.000 noktalık sıcaklık verisinde ölçtüm: 1 dakikalık pencere için sorgu medyanı 0,19 ms, bütün gün için (864.000 noktanın tamamı çözülüyor) 13,1 ms. - Retention bedava. Süresi dolan veriyi silmek nokta nokta yeniden yazmak değil, bütün bir bloğu listeden düşürmek.
- Sıra dışı yazma kabul edilir. Blok içinde sıralama mühürleme anında yapılır; bloklar arası örtüşme sorgu doğruluğunu bozmaz, yalnızca budamayı ve sıkıştırmayı zayıflatır.
Blok boyutu bir ödünleşim: büyük blok daha iyi sıkıştırır ama retention ve budamanın çözünürlüğünü kabalaştırır. Varsayılan 1024 makul bir orta nokta; crate düzeyinde with_block_points ile değiştirilebiliyor.
Kalıcılık: MANIFEST tek commit noktası
Disk düzeni üç dosya tipinden oluşuyor:
<dir>/MANIFEST              {"generation": N}, yetkili nesil
<dir>/blocks.<N>.tsb        N. checkpoint'teki tam blok anlık görüntüsü
<dir>/wal.<N>.log           N'den sonra yazılan noktalar
<dir>/rollup_wm.<N>.json    rollup watermark'ı, aynı nesille
<dir>/rollups.json          rollup kuralları
Checkpoint şu sırayla işler: aktif tamponlar mühürlenir, blocks.<N+1>.tsb yazılır ve fsync edilir, watermark rollup_wm.<N+1>.json'a yazılıp fsync edilir, MANIFEST.tmp yazılıp MANIFEST üzerine atomik olarak rename edilir, yeni wal.<N+1>.log açılır ve N nesline ait dosyalar silinir.
Bütün dayanıklılık argümanı tek bir rename'in iki yanında. Çökme rename'den önce olursa MANIFEST hâlâ N der; kurtarma eski anlık görüntüyü ve onun WAL'ını okur, o WAL checkpoint'ten sonraki her noktayı hâlâ içerir. Çökme rename'den sonra olursa kurtarma yeni anlık görüntüyü okur ve eski WAL'a bakmaz; hiçbir nokta iki kez sayılmaz. WAL 8 MiB'ı geçince motor kendiliğinden checkpoint alıyor; günlük veri yazarken benim deneyimde nesil numarası 43'e çıktı. checkpoint op'u ile elle de tetiklenebilir. Bu "tüm neslin yeniden yazılması ve tek rename ile terfi" yaklaşımı SQL motorunda da aynı.
Dürüst olmam gereken bir nokta: WAL her yazma isteğinin sonunda işletim sistemine flush ediliyor ama fsync edilmiyor. Süreç çökmesinde (aşağıda kill -9 ile denedim) veri kaybolmuyor, çünkü yazılanlar çekirdeğin sayfa önbelleğinde. Elektrik kesintisinde ise son checkpoint'ten sonraki noktaların bir kısmı gidebilir. Metrik verisi için bilinçli bir hız tercihi; ama bilmeniz gereken bir tercih.
Eşzamanlılık ve bellek
Her veritabanının motoru bir RwLock arkasında: yazmalar tek tek, sorgular paylaşımlı kilitle eşzamanlı çalışır. Mühürlü bloklar bellekte duruyor; Tsdb::open anlık görüntüyü tamamen yükler. Yani bellek kullanımı kabaca sıkıştırılmış veri boyutu kadar. Yukarıdaki 5,2 milyon nokta 12 MB tutuyor; bir yıllık saniyelik tek bir seri 0,1 çözünürlüklü float ile yaklaşık 40 MB, tamsayı birimle 12 MB civarında olurdu. Milyarlarca noktalık bir arşiv için doğru araç değil; belleğe sığan sıcak veri ve rollup'lar için tasarlandı.
Sorgular ve toplamalar
Bir sorgu şunları söyler: ölçüm, alan, etiket filtreleri (tags, yalnızca eşitlik), yarı açık zaman aralığı [start, end), isteğe bağlı kova genişliği (interval, ms) ve gruplanacak etiketler (group_by), bir de toplama (agg, varsayılan mean). Yanıt her zaman bir grup listesi: her grubun etiketleri, alanın tipi ve noktaları.
| Toplama | Anlamı |
|---|---|
mean / avg | ortalama |
sum | toplam |
min / max | en küçük / en büyük |
count | nokta sayısı |
first / last | kovanın en eski / en yeni değeri |
distinct | farklı değer sayısı |
rate | saniyedeki değişim: (last - first) / süre_sn, sayaçlar için |
percentile + p | p. yüzdelik, doğrusal aradeğerleme (numpy varsayılanı gibi) |
p50, p95, p99, p99.9 | percentile için kısayol |
Zamana göre gruplama
interval verildiğinde kovalar epoch'a hizalanır (InfluxDB'deki gibi), yani saatlik kovalar tam saat sınırlarına oturur. Bir sensörün ilk dört saatinin saatlik ortalaması:
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "s_temp_01", "field": "temp",
 "tags": {"sensor": "s00"}, "start": 1790812800000, "end": 1790827200000,
 "interval": 3600000, "agg": "mean"}
{"ok": true, "data": [{"tags": {}, "type": "float", "points": [
{"ts": 1790812800000, "value": 2.734611111111113},
{"ts": 1790816400000, "value": 2.2817499999999957},
{"ts": 1790820000000, "value": 1.3479722222222226},
{"ts": 1790823600000, "value": 2.0618055555555315}]}]}Etikete ve zamana birlikte gruplamak tek sorguda grafik başına bir çizgi üretir. On sensörün 6 saatlik maksimumları (çıktının başı):
{"tags": {"sensor": "s00"}, "type": "float", "points": [{"ts": 1790812800000, "value": 3.8}, {"ts": 1790834400000, "value": 6.0}]},
{"tags": {"sensor": "s01"}, "type": "float", "points": [{"ts": 1790812800000, "value": 5.5}, {"ts": 1790834400000, "value": 5.4}]},
{"tags": {"sensor": "s02"}, "type": "float", "points": [{"ts": 1790812800000, "value": 6.0}, {"ts": 1790834400000, "value": 5.3}]},
...
tags serileri eler, group_by çıktıyı böler; ikisi birlikte de kullanılabilir.
Yüzdelikler, rate ve diğerleri
On sensörün bir günlük verisi (864.000 nokta) üzerinde yüzdelikler; değerleri sıralamak gerektiği için her biri yaklaşık 16 ms sürdü:
agg=p50                 -> 3.2
agg=p95                 -> 5.7
agg=p99                 -> 5.9
agg=percentile, p=99.9 -> 6.0rate, monoton artan sayaçlar içindir: kovanın ilk ve son değerinin farkını aradaki süreye böler. Paket sayacından 15 dakikalık kovalarla saniyedeki paket sayısı (her saniye 40 ile 60 arası paket ürettiğim için 50 civarı bekleniyor):
{"engine": "tsdb", "cmd": "tsdb", "op": "query", "measurement": "s_counter", "field": "packets",
 "tags": {"sensor": "s03"}, "start": 1790812800000, "end": 1790816400000,
 "interval": 900000, "agg": "rate"}
{"ok": true, "data": [{"tags": {}, "type": "integer", "points": [
{"ts": 1790812800000, "value": 49.88320355951057},
{"ts": 1790813700000, "value": 49.809788654060064},
{"ts": 1790814600000, "value": 49.88987764182425},
{"ts": 1790815500000, "value": 49.77641824249166}]}]}Bir saatlik nem verisi üzerinde geri kalan toplamalar, hepsi 0,1 ms civarında:
count    -> 3600.0
first    -> 75.0
last     -> 76.0
min      -> 73.0
sum      -> 269640.0
distinct -> 5.0
rate sayaç sıfırlanmalarını (reset) bilmiyor; sayaç kova içinde sıfırlanırsa negatif ya da düşük bir değer görürsünüz. Prometheus'un rate()'i gibi reset düzeltmesi yok.
Coğrafi izler
Bir konumu aynı zaman damgalarıyla yazılmış iki sayısal alan (lat, lon) olarak saklarsanız motor iki ek sorgu sunuyor: distance (haversine ile metre cinsinden yol uzunluğu) ve track (Douglas-Peucker ile sadeleştirilmiş iz). İzmir'de dört noktalık bir kamyon izi:
>>> {"op": "distance", "measurement": "truck", "tags": {"id": "t7"}}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790900060000, "value": 3423.2779930961387}]}]}

>>> {"op": "track", "measurement": "truck", "tags": {"id": "t7"}, "tolerance": 50}
<<< {"ok": true, "data": [{"tags": {"id": "t7"}, "points": [
     {"ts": 1790900000000, "lat": 38.4237, "lon": 27.1428},
     {"ts": 1790900120000, "lat": 38.4363, "lon": 27.1572},
     {"ts": 1790900180000, "lat": 38.45, "lon": 27.16}]}]}
Aynı doğrultudaki ikinci nokta 50 metre toleransla atıldı. Belge tarafındaki coğrafi sorgular serinin coğrafi ve graf yazısında.
Ham TCP ve PostgREST
Protokol bu kadar basit olduğu için kütüphane de şart değil. Aynı motor HTTP üzerinden PostgREST dilbilgisiyle de konuşuyor: Accept-Profile: tsdb başlığı isteği TSDB motoruna yönlendiriyor, select alanı, tag=eq.value filtre, ts=gte. ve ts=lt. aralık. curl ile saatlik maksimum:
curl -s 'http://127.0.0.1:15501/rest/v1/s_temp_01?select=temp&sensor=eq.s00&ts=gte.1790870400000&ts=lt.1790881200000&interval=3600000&agg=max' \
-H 'Accept-Profile: tsdb'[{"ts":1790870400000,"value":4.2},{"ts":1790874000000,"value":6.0},{"ts":1790877600000,"value":6.0}]Yazma da düz bir nesneyle oluyor; metin değerler etiket, sayılar alan olur:
curl -s -i -X POST 'http://127.0.0.1:15501/rest/v1/coldroom' \
  -H 'Content-Profile: tsdb' -H 'Content-Type: application/json' \
  -d '{"ts":1790899200000,"site":"izmir","room":"r3","temp":3.6}'
HTTP/1.1 201 CreatedBu sayede @supabase/postgrest-js istemcisi .schema('tsdb') ile değiştirilmeden çalışıyor. PATCH ve DELETE bilerek 405 dönüyor: seri deposu sadece eklemeli, veri retention ile siliniyor.
Sürekli toplamalar (rollup) ve watermark
Bir yıllık saniyelik veriyi saklamak ucuz, ama her grafik çiziminde milyonlarca noktayı taramak değil. Standart çözüm sürekli toplama: kapanmış zaman kovalarının özetini bir kez hesaplayıp kalıcı olarak yazmak. oxidb-tsdb'de bir rollup kuralı "bu ölçümün her sayısal serisini şu genişlikteki kovalarda şu toplamalarla özetle" der; sonuç <ölçüm>@<etiket> adında türetilmiş bir ölçüm, alanları <alan>_<toplama>, kaynak serinin etiketleri aynen taşınır.
>>> {"op": "rollup_add", "measurement": "s_temp_01", "label": "1m", "interval": 60000, "aggs": ["mean", "min", "max", "count"]}
<<< {"ok": true, "data": {"ok": true}}

>>> {"op": "rollups"}
<<< {"ok": true, "data": [{"measurement": "s_temp_01", "label": "1m", "interval": 60000}]}

>>> {"op": "rollup_refresh", "now": 1790899200001}
<<< {"ok": true, "data": {"written": 14400}}
    (71.67 ms)

>>> {"op": "rollup_refresh", "now": 1790899200001}
<<< {"ok": true, "data": {"written": 0}}
On sensör × 1440 dakika = 14.400 rollup noktası, 72 ms'de. İkinci yenileme hiçbir şey yazmıyor, çünkü her (seri, aralık) çifti için son materyalize edilen kovanın başlangıcı bir watermark'ta tutuluyor. rollup_refresh yalnızca tamamen kapanmış kovaları işler: içinde bulunulan dakikanın yarısı henüz gelmemiş olabilir. now vermezseniz sunucu saati kullanılır; ben deney verim geçmişte olduğu için açıkça verdim.
Özet sıradan bir ölçüm, normal sorguyla okunuyor:
s_temp_01@1m / temp_count, agg=sum   -> 864000.0
hourly mean raw    first 3: [2.7346, 2.2817, 1.348] 1.47 ms
hourly mean rollup first 3: [2.7346, 2.2818, 1.348] 0.17 ms
Saatlik ortalamayı ham veriden 1,47 ms'de, dakikalık rollup'tan 0,17 ms'de aldım; sonuçlar aynı. Bir incelik: dakikalık ortalamaların ortalaması, kovalar eşit doluysa doğrudur. Eksik kovalar varsa hafif kayar; kesinlik gerekiyorsa sum ve count'u materyalize edip oranı kendiniz kurun. Zincirleme (1s → 1m → 1h) kendiliğinden olmuyor, kuralları sırayla tanımlayıp yenilemek çağıranın işi. Rollup kuralları rollups.json'a yazıldığı için yeniden başlatmayı atlatıyor; yenilemeyi tetiklemek ise uygulamanın (ya da bir zamanlayıcının) görevi, motor kendi başına periyodik çalıştırmıyor.
Watermark ne zaman çökmeye dayanıklı?
Watermark, blok anlık görüntüsüyle aynı nesle yazılıyor (rollup_wm.<N>.json) ve MANIFEST rename'i ile birlikte atomik olarak terfi ediyor. Testler "checkpoint sonrası yeniden açılışta aynı kova iki kez yazılmaz" durumunu sabitliyor. Bu yazı için iki senaryoyu kill -9 ile denedim:
## senaryo A: refresh, checkpoint YOK, kill -9, yeniden başlat
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 3}}
   [kill -9, yeniden başlatma]
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 14403}}
>>> {"op": "query", "measurement": "line_a@1m", "field": "v_mean", "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790899200000, "value": 6.0}]}]}

## senaryo C: refresh + checkpoint, kill -9, yeniden başlat
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 3}}
>>> {"op": "checkpoint"}
<<< {"ok": true, "data": {"ok": true}}
   [kill -9, yeniden başlatma]
>>> {"op": "rollup_refresh", "now": 1790899380001}
<<< {"ok": true, "data": {"written": 0}}
>>> {"op": "query", "measurement": "line_c@1m", "field": "v_mean", "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790899200000, "value": 3.0}]}]}
Senaryo C beklediğim gibi: watermark checkpoint ile diske indiği için yeniden açılışta hiçbir kova tekrar yazılmadı. Senaryo A ise bana bir boşluk gösterdi: rollup noktaları WAL'a yazılıyor ve çökmeden sonra geri geliyor, ama watermark yalnızca checkpoint'te kalıcı oluyor. Yeniden açılışta watermark eski kaldığı için aynı kovalar bir kez daha yazıldı (3 yerine 6 nokta; önceki oturumda checkpoint'siz kalan 14.400'lük rollup da tekrarlandı). Yani garanti "checkpoint'li yenilemeler iki kez sayılmaz" düzeyinde. Bugün için güvenli kalıp basit: rollup_refresh'ten hemen sonra checkpoint çağırmak. Kalıcı çözüm watermark güncellemesini de WAL'a bir kayıt olarak yazmak; listemde.
Retention: blok düzeyinde saklama
Retention tek bir kesim zamanıyla çalışır: en yeni noktası bu andan eski olan bloklar düşer. Kesimi bilerek bir bloğun ortasına, 12:08:20'ye koydum:
>>> {"op": "query", "measurement": "s_temp_01", "field": "temp", "tags": {"sensor": "s00"}, "end": 1790856500000, "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790812800000, "value": 43700.0}]}]}

>>> {"op": "retention", "cutoff": 1790856500000}
<<< {"ok": true, "data": {"removed": 2584391}}
    (0.1 ms)

>>> {"op": "query", "measurement": "s_temp_01", "field": "temp", "tags": {"sensor": "s00"}, "end": 1790856500000, "agg": "count"}
<<< {"ok": true, "data": [{"tags": {}, "type": "float", "points": [{"ts": 1790855808000, "value": 692.0}]}]}
2,58 milyon nokta 0,1 ms'de gitti, çünkü hiçbir şey çözülmedi ya da yeniden yazılmadı; bloklar listeden düştü. Kesimden eski 692 nokta ise kaldı: 11:56:48'de başlayıp kesimin ötesine uzanan bloğun içindeler. Retention'ın çözünürlüğü blok genişliği kadar, ki 1 Hz bir seride 1024 nokta yaklaşık 17 dakika. Düşürülen bloklar bir sonraki anlık görüntüye girmediği için retention ayrıca bir şey yapmadan kalıcı oluyor.
İki sınırı da söyleyeyim. Kesim veritabanının tamamına uygulanıyor: aynı çağrı coldroom ölçümündeki 1 Ekim gece yarısı noktalarını da sildi (sonraki count sorgusu boş döndü). Ölçüm başına farklı saklama süresi istiyorsanız ölçümleri ayrı veritabanlarına koymanız gerekiyor; ham veriyi 7 gün, rollup'ı 1 yıl tutmak gibi klasik bir kalıp için bu bugün eksik. İkincisi: retention de kendiliğinden çalışmıyor, periyodik çağırmak uygulamanın işi.
Düşük kilitli yedekleme ve geri yükleme
Yedek, motorun dizininin tutarlı bir .tar.gz'si. Önemli olan, yavaş kısmın (sıkıştırma) motor kilidi bırakılmışken çalışması. Üç faz var:
- backup_begin (yazma kilidi altında, O(1)): WAL flush edilir, mevcut nesil bir referans sayacıyla "iğnelenir" (pin) ve WAL'ın o anki uzunluğu kaydedilir.
- backup_write (kilitsiz): sentezlenmiş bir MANIFEST, o neslin blok dosyası, WAL'ın kaydedilen uzunluktaki sabit öneki ve rollup dosyaları arşive yazılır. Nesil başına WAL yalnızca sona eklendiği ya da döndürüldüğü için bu önek değişmez.
- backup_end (yazma kilidi altında, O(1)): iğne bırakılır; yedek sürerken bir checkpoint o nesli geçersiz kıldıysa dosyaları şimdi silinir.
Arada yazmalar ve checkpoint'ler normal şekilde devam ediyor; checkpoint iğnelenmiş bir neslin dosyalarını silmiyor. Bunu ölçtüm: bir bağlantı sürekli tek noktalık yazma yaparken diğeri yedek aldı.
backup: {'ok': True, 'data': {'path': '.../backup/lowlock.tar.gz', 'size_bytes': 9531869}} took 860 ms
during backup   writes= 1482  p50=0.050 ms  p99=4.073 ms  max=10.486 ms
outside backup  writes= 3213  p50=0.060 ms  p99=4.082 ms  max=11.223 ms
Yedek sürerken yazma gecikmesinde fark yok. 5,3 milyon noktalık veritabanının arşivi 9,5 MB; Gorilla blokları gzip ile pek küçülmüyor, zaten sıkışmış durumdalar. Geri yükleme boş bir dizine açıyor:
{"engine": "tsdb", "cmd": "backup", "path": "/yedek/tsdb-2026-10-02.tar.gz"}
{"engine": "tsdb", "cmd": "restore", "archive": "/yedek/tsdb-2026-10-02.tar.gz", "target": "/geri/tsdb"}
Arşivi açtığım dizinde, 15510 portunda OXIDB_TSDB_DATA ile ikinci bir sunucu başlattım; stats yedek alınmadan önceki değerle birebir aynıydı:
{"ok": true, "data": {"series": 114, "points": 5299594, "bytes": 12382229}}Restore çalışan motorun üstüne yazmıyor; yeni dizinde motoru açmanız gerekiyor. Hedef dizin boş değilse istek reddediliyor.
Belge tarafındaki zaman aşamaları
Zaman serisi işi OxiDB'de yalnızca bu motorda değil. Belge motorunun toplama hattında üç zaman aşaması var ve olay verisi zaten belge olarak duruyorsa genellikle doğru araç onlar. Altı işlemlik bir trades koleksiyonu üzerinde:
$ohlcv tick verisini mumlara çeviriyor; fill: "previous" boş dakikayı bir önceki kapanışla dolduruyor:
{"$ohlcv": {"time": "ts", "interval": "1m", "price": "price", "volume": "qty", "symbol": "sym", "fill": "previous"}}
-> {"symbol": "ACME", "time": "2026-10-01T09:00:00Z", "open": 101.0, "high": 102.5, "low": 100.5, "close": 100.5, "volume": 6.0, "count": 3}
   {"symbol": "ACME", "time": "2026-10-01T09:01:00Z", "open": 100.0, "high": 100.0, "low": 99.5, "close": 99.5, "volume": 9.0, "count": 2}
   {"symbol": "ACME", "time": "2026-10-01T09:02:00Z", "open": 99.5, "high": 99.5, "low": 99.5, "close": 99.5, "volume": 0.0, "count": 0}
   {"symbol": "ACME", "time": "2026-10-01T09:03:00Z", "open": 101.5, "high": 101.5, "low": 101.5, "close": 101.5, "volume": 2.0, "count": 1}
$dateHistogram takvim farkındalıklı zaman kovaları; min_doc_count: 0 boş kovaları da üretiyor:
{"$dateHistogram": {"field": "ts", "interval": "1m", "min_doc_count": 0, "accumulators": {"volume": {"$sum": "$qty"}}}}
-> {"_id": "2026-10-01T09:00:00Z", "count": 3, "volume": 6}
   {"_id": "2026-10-01T09:01:00Z", "count": 2, "volume": 9}
   {"_id": "2026-10-01T09:02:00Z", "count": 0}
   {"_id": "2026-10-01T09:03:00Z", "count": 1, "volume": 2}
$setWindowFields zaman aralığına dayalı pencereler; "son 5 belge" değil "son 2 dakika":
{"$setWindowFields": {"sortBy": {"ts": 1}, "output": {"avg_2m": {"$avg": "$price", "window": {"range": [-2, 0], "unit": "minute"}}}}}
-> {"ts": "2026-10-01T09:00:05Z", "price": 101.0, "avg_2m": 101}
   {"ts": "2026-10-01T09:00:40Z", "price": 102.5, "avg_2m": 101.75}
   {"ts": "2026-10-01T09:00:55Z", "price": 100.5, "avg_2m": 101.33333333333333}
   {"ts": "2026-10-01T09:01:10Z", "price": 100.0, "avg_2m": 101}
   {"ts": "2026-10-01T09:01:30Z", "price": 99.5, "avg_2m": 100.7}
   {"ts": "2026-10-01T09:03:20Z", "price": 101.5, "avg_2m": 100.5}
Kabaca ayrım şöyle: olay zengin ve şekli değişkense, ya da az sayıdaysa belge ve bu aşamalar; aynı şekilde milyonlarca sayısal ölçümse TSDB. İkisi birlikte de iyi çalışıyor. Repodaki examples/coldchain demosunda sensör okumaları MQTT ile geliyor, sayısal değerler TSDB'ye, cihazın gönderdiği ham olay olduğu gibi belge motoruna yazılıyor: sıcaklığın tırmandığını zaman serisi gösteriyor, nedenini (door_open: true) belge. MQTT tarafı serinin MQTT ve AMQP yazısında.
Sınırlar ve dürüst ödünleşimler
Bu motoru kullanmadan önce bilinmesi gerekenleri bir arada toplayayım:
- Bellekte yaşıyor. Mühürlü bloklar RAM'de; bellek kullanımı sıkıştırılmış veri boyutu kadar. Sıcak veri ve rollup'lar için iyi, çok yıllık ham arşiv için değil.
- Etiket indeksi yok. Sorgu, veritabanındaki tüm seri anahtarlarını dolaşıp ölçüm ve etiketlere göre eliyor. Birkaç bin seride fark edilmez; yüksek kardinaliteli etiketler (kullanıcı kimliği gibi) hem bu taramayı hem belleği büyütür. Etiketler sınırlı bir değer kümesinden gelmeli.
- Etiket filtreleri yalnızca eşitlik. Regex,
!=ya daINyok. - Tek alan, tek toplama. Bir sorgu bir alanı bir toplamayla döndürüyor;
meanvemax'ı birlikte istemek iki sorgu. - Retention veritabanı genelinde, rollup yenileme ve retention otomatik çalışmıyor.
- Watermark checkpoint'te kalıcı; yenilemeden sonra checkpoint alın.
- WAL fsync edilmiyor; süreç çökmesine dayanıklı, elektrik kesintisinde son checkpoint'ten sonrası risk altında.
- Metin alanları sıkıştırılmıyor; ham
(zaman, metin)çiftleri olarak saklanıyor. - Kümede replike edilmiyor. Raft kümesinde TSDB yazmaları onları alan düğümde kalıyor; ADR-0025 bu açığı öneri motoruyla ortak bir boşluk olarak açıkça kaydediyor ve ikisinin birlikte kapatılmasını öngörüyor.
- Zaman damgaları milisaniye. Nanosaniye gönderen InfluxDB istemcilerinde zaman damgasını dönüştürmek gerekiyor.
Bunlar bir MVP'nin değil, bilinçli bir kapsamın sınırları: tek süreçte, belleğe sığan, iyi sıkışan, hızlı sorgulanan metrik verisi. Bir InfluxDB kümesinin yerini almaya çalışmıyor; ama bir uygulamanın belgelerinin, tablolarının ve önbelleğinin yanında aynı binary içinde metriklerini de tutmak istediğinizde ikinci bir sistem kurmanızı gereksiz kılıyor.
Denemek için
OxiDB'nin derlenmiş sürümleri GitHub releases sayfasında: macOS (arm64/x86_64), Linux (x86_64/arm64) ve Windows binary'leri. Depodan Docker ile çalıştırmak için docker compose up -d yeterli. Zaman serisi motorunu açmak için tek gereken OXIDB_TSDB=1. Kendi verinizle bu yazıdaki ölçümü tekrarlamak isterseniz en kolay yol satır protokolüyle bir günlük veri yazıp checkpoint sonrası stats'a bakmak: bytes'ı points'e bölün, nokta başına kaç bayt ödediğinizi görün. Ve sensör verinizin çözünürlüğü sabitse, değerleri tamsayı birimle yazmayı deneyin; benim verimde fark 3,5 kattı.
Serinin bir sonraki yazısı OxiMem: Redis protokolünü konuşan anahtar-değer motoru (OxiMem yazısı).