OxiDB のログとアラート:GELF、MessagePack、保持期間、webhook
OxiDB のログエンジン:UDP 経由の GELF と MessagePack の受信、チャンク再構成、フィールドごとの動的インデックス、コレクション単位の保持期間、webhook 付きしきい値アラート、oxidb-tail。実際のパケットで検証し、見つかった欠陥も含めて紹介します。
アプリケーションを本番環境に出したとき、最初に必要になるのはログです。次に必要になるのは、そのログが「何かおかしい」と言っているときにそれを知らせてくれる仕組みです。よくある答えは別のスタックを用意することです。Graylog か Elasticsearch、その前段にシッパー、横にアラートサービス。OxiDB では、この仕事をデータベース自身にやらせることにしました。サーバーは UDP 経由で GELF(Graylog Extended Log Format)と MessagePack のログレコードを受け取り、通常のドキュメントコレクションに書き込み、コレクションごとに保持期間を適用し、バックグラウンドでしきい値アラートを評価して webhook を呼び出します。この記事では、本物のサーバーに本物のパケットを送りながらこのエンジンの仕組みを紹介します。また、その過程で見つけた欠陥も隠さずに書き残しておきます。
これは OxiDB シリーズの 9 本目の記事です。ここで紹介するものはすべてドキュメントエンジンの上に構築されています。ログはドキュメントであり、インデックスはドキュメントエンジンのインデックスであり、保持期間はその TTL の仕組みです。
なぜログをデータベースに入れるのか
小規模から中規模のシステムでは、ログ基盤のほうがアプリケーションより手間がかかることがよくあります。Elasticsearch クラスター、そのヒープ設定、インデックステンプレート、保持ポリシー、別のアラートツール……。OxiDB はすでにドキュメントを保存し、インデックスを張り、クエリを実行し、TTL で期限切れにできます。ログの 1 行は、タイムスタンプ付きの構造化されたドキュメントにすぎません。足りなかったのは次の部分です。
- 安価なネットワークプロトコル(UDP、GELF、MessagePack)でログを受け取ること
- 高頻度で届く小さなレコードをバッチで書き込むこと
- コレクションごとの保持期間
- 「直近 5 分間にエラーが 100 件を超えたら webhook を呼ぶ」といった種類のアラート
- ターミナルでライブに眺めるためのツール(oxidb-tail)
すべてが 1 つのプロセスに収まります。追加のサービスはありません。
有効化する
各入力は環境変数で有効にします。以下は実験に使ったコマンドです(ポートはこの記事のために選んだもので、デフォルト値ではありません)。
OXIDB_ADDR=127.0.0.1:15900 \
OXIDB_DATA=./data \
OXIDB_GELF_PORT=15908 \
OXIDB_MSGPACK_PORT=15909 \
OXIDB_UDP_PORT=15910 \
OXIDB_ALERT_INTERVAL=2 \
./oxidb-server
サーバーは起動時に、何をしているのかを正確に出力します。
TTL eviction: enabled (interval=1000ms)
alert evaluator: enabled (interval=2s)
oxidb-server listening on 127.0.0.1:15900 (pool_size=4, data_dir=.../data, idle_timeout=0s)
UDP log ingestion: listening on 0.0.0.0:15910 → collection '_udp_logs' (8 threads)
GELF ingestion: listening on 0.0.0.0:15908 → collection '_gelf_logs' (8 receivers, 4 writers, batch=2000, simd-json, crossbeam, auto-indexing)
MessagePack ingestion: listening on 0.0.0.0:15909 → collection '_msgpack_logs' (8 receivers, 4 writers, batch=2000, no auto-indexing)
変数の一覧は次のとおりです。
| 変数 | デフォルト | 役割 |
|---|---|---|
OXIDB_GELF_PORT | 無効 | GELF の UDP リスナー |
OXIDB_GELF_COLLECTION | _gelf_logs | GELF レコードの書き込み先コレクション |
OXIDB_MSGPACK_PORT | 無効 | MessagePack の UDP リスナー |
OXIDB_MSGPACK_COLLECTION | _msgpack_logs | MessagePack のコレクション |
OXIDB_MSGPACK_TTL_SECS | 604800(7 日) | MessagePack コレクションの TTL。0 ならすべて保持 |
OXIDB_UDP_PORT | 無効 | 生の UDP リスナー(JSON またはプレーンテキスト) |
OXIDB_UDP_COLLECTION | _udp_logs | 生 UDP のコレクション |
OXIDB_ALERT_INTERVAL | 15 秒 | アラートの評価間隔 |
OXIDB_GELF_ADDR | 無効 | サーバー自身のログの GELF 送信先 |
OXIDB_MSGPACK_ADDR | 無効 | サーバー自身の REST リクエストログの MessagePack 送信先 |
1 つ注意点があります。上の出力からわかるように、3 つの UDP リスナーはすべて OXIDB_ADDR に関係なく 0.0.0.0 にバインドされます。UDP には認証がないので、これらのポートはファイアウォールの内側に置いてください。
はっきりさせておきたかった疑問の 1 つは、OXIDB_UDP_PORT が独立した入力なのかどうかでした。答えはイエスです。udp_ingest.rs に GELF とは独立して実装されていて、3 つの中で最もシンプルなものです。後ほど取り上げます。
エンジンの内部:全体像
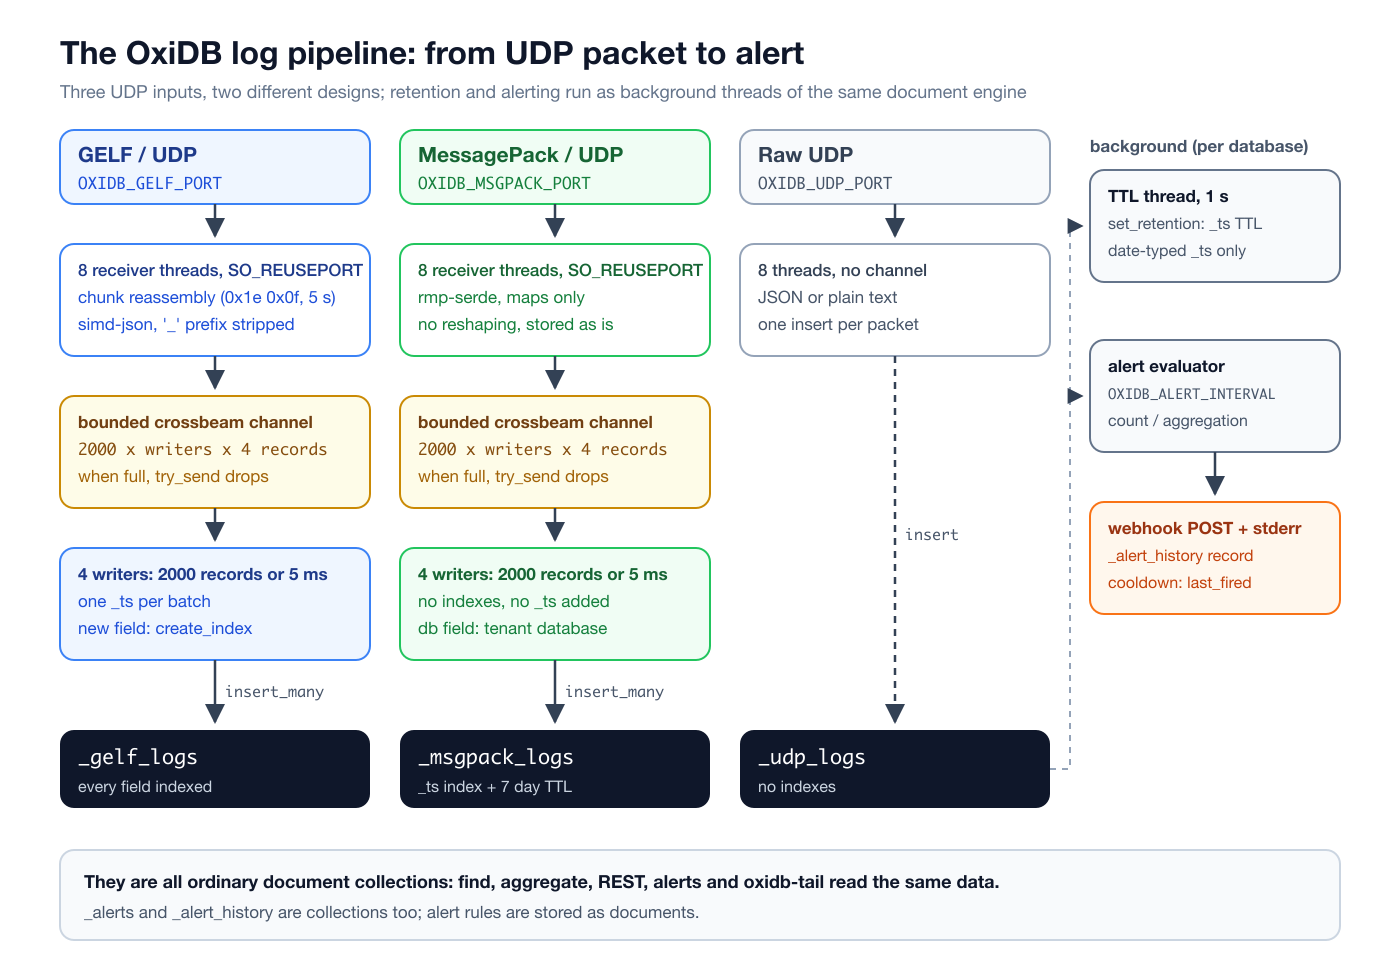
3 つの入力はいずれも、1 つの骨格のバリエーションです。
- 受信スレッド。 コア数と同じ数(上限 8)のスレッドが、
SO_REUSEPORTで同じ UDP ポートにバインドします。カーネルが届いたパケットをこれらのソケットに分散するので、単一のrecvループがボトルネックになることはありません。各ソケットは 64 MB の受信バッファを要求します(生 UDP では 8 MB)。 - 有界チャネル。 GELF と MessagePack では、受信スレッドがデコード済みのドキュメントをロックフリーの
crossbeamチャネルに送り込みます。容量は2000 x writers x 4です。私の 10 コアのマシンではライターが 4 つだったので、32,000 レコードになります。 - ライタースレッド。 受信スレッドの半分の数(最低 2)のライターがチャネルから取り出します。ライターは、2000 レコードに達するか、最初のレコードから 5 ms 経過するか、どちらか早いほうでバッチを閉じ、1 回の
insert_manyで書き込みます。 - コレクション。 結果は通常のドキュメントコレクションです。WAL、fsync、インデックス、クエリ、すべてがドキュメントエンジンのものです。
この設計の要はバッチです。個別の insert の代わりに 2000 レコードの insert_many を使うことで、コレクションロック、WAL 書き込み、fsync のコストを数百件のレコードに分散できます。5 ms の上限があるので、トラフィックが少ないときにレコードがいつまでも待たされることはありません。
GELF:Graylog 形式のログを受け取る
GELF は Graylog の JSON ログ形式です。バージョン 1.1 では、必須フィールドは version、host、short_message です。任意フィールドとして full_message、timestamp、level(syslog レベル。0 が emergency、7 が debug)があり、さらに _ で始まる追加フィールドを好きなだけ付けられます。GELF ロガーはほとんどの言語に存在するので、Graylog のエンドポイントを OxiDB に差し替えるのは、アプリケーション側でアドレスを変えるだけで済みます。
OxiDB は各メッセージを次のように変換します。
short_messageがなければ、そのメッセージは黙って破棄されます。- 標準フィールド(
host、short_message、full_message、timestamp、level、facility)はそのまま保持されます。 versionは削除されます。- 追加フィールドの先頭のアンダースコアは取り除かれます。
_userはuserとして保存されます。 - バッチを書き込む前に、ライタースレッドがすべてのドキュメントに
_tsを付与します。このスタンプはメッセージごとではなく バッチごとに 1 回だけ取得される点に注意してください。同じ 5 ms のウィンドウに入ったレコードはすべて同じ_tsを持ちます。これは意図的なもので、時計の呼び出しですら 2000 レコードに 1 回で済みます。メッセージ自身の時刻が必要なら、GELF のtimestampフィールドも保存されています。
JSON は simd-json でインプレースにパースされます。
本物のメッセージを送る
ライブラリは使わず、素の Python ソケットで通常のメッセージを 3 つと、チャンク分割したメッセージを 1 つ送りました。
import socket, json, os, time
sock = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
dst = ("127.0.0.1", 15908)
def send(msg):
    sock.sendto(json.dumps(msg).encode(), dst)

send({"version":"1.1","host":"api-01","short_message":"Login user: baris","level":6,
      "facility":"auth","timestamp":time.time(),"_user":"baris","_client_ip":"192.0.2.10","_latency_ms":42})
send({"version":"1.1","host":"api-02","short_message":"Payment declined","level":3,
      "facility":"billing","timestamp":time.time(),"_user":"ayse","_order_id":54321,"_amount":2500.0})
send({"version":"1.1","host":"worker-1","short_message":"Retrying job SendEmail","level":4,
      "facility":"jobs","timestamp":time.time(),"_job":"SendEmail","_attempt":3})

# a ~23 KB message split into 8 KB chunks and sent in REVERSE order
full = "Traceback (most recent call last):\n" + "".join(f"  at frame_{i} (service.rs:{i})\n" for i in range(700))
big = json.dumps({"version":"1.1","host":"api-01","short_message":"Unhandled panic in /checkout",
      "full_message":full,"level":2,"facility":"checkout","_request_id":"req-7f3a"}).encode()
CH = 8192
parts = [big[i:i+CH] for i in range(0, len(big), CH)]
mid = os.urandom(8)
order = list(range(len(parts)))[::-1]
for seq in order:
    sock.sendto(b"\x1e\x0f" + mid + bytes([seq, len(parts)]) + parts[seq], dst)
print(f"chunked payload: {len(big)} bytes -> {len(parts)} chunks, sent in order {order}")
chunked payload: 23084 bytes -> 3 chunks, sent in order [2, 1, 0]サーバーの stderr には、初めて見たフィールドごとにインデックスが作成されたことが表示されます。
GELF auto-index: created index on 'job' in '_gelf_logs'
GELF auto-index: created index on 'attempt' in '_gelf_logs'
GELF auto-index: created index on 'amount' in '_gelf_logs'
GELF auto-index: created index on 'order_id' in '_gelf_logs'
GELF auto-index: created index on 'client_ip' in '_gelf_logs'
GELF auto-index: created index on 'user' in '_gelf_logs'
GELF auto-index: created index on 'latency_ms' in '_gelf_logs'
GELF auto-index: created index on 'request_id' in '_gelf_logs'
GELF auto-index: created index on 'full_message' in '_gelf_logs'
クエリする
OxiDB のワイヤープロトコルは長さプレフィックス付きの JSON です(4 バイトのリトルエンディアンの長さに JSON が続く)。以下のリクエストとレスポンスは、このプロトコル上の実際のメッセージです。まずは件数です。
{"cmd": "count", "collection": "_gelf_logs", "query": {}}{"ok": true, "data": {"count": 4}}4 件のレコード、つまり通常のメッセージ 3 件と、3 つのチャンクから再構成された 1 件です。次に、追加フィールドに対する範囲クエリです。latency_ms のインデックスは自動的に作成されているので、このクエリはそれを使います。
{"cmd": "find", "collection": "_gelf_logs", "query": {"latency_ms": {"$gt": 10}}}{
"ok": true,
"data": [
{
"host": "api-01",
"short_message": "Login user: baris",
"timestamp": 1791754331.033758,
"level": 6,
"facility": "auth",
"user": "baris",
"latency_ms": 42,
"client_ip": "192.0.2.10",
"_ts": "2026-10-11T21:32:11.039911+00:00",
"_id": 2,
"_version": 1
}
]
}_user は user になり、version はなく、_ts が追加されています。level <= 3 のクエリでは "Payment declined" のレコードとチャンク分割されたメッセージが返り、どちらもぴったり _ts: 2026-10-11T21:32:11.039911+00:00 でした。4 つのメッセージはすべて同じバッチに入ったので、同じスタンプが付いたわけです。チャンク分割されたメッセージが完全な形で戻ってくることも確認しました。
chunked doc: short_message='Unhandled panic in /checkout', full_message 22215 chars, 701 lines, last line ' at frame_699 (service.rs:699)'700 行のスタックトレースの最後の行が、あるべき場所にあります。コレクションのインデックス一覧は次のとおりです。
indexes: ['_ts', 'amount', 'attempt', 'client_ip', 'facility', 'full_message', 'host', 'job', 'latency_ms', 'level', 'order_id', 'request_id', 'short_message', 'timestamp', 'user']チャンク分割メッセージの再構成
UDP のデータグラムは実際には数キロバイトに制限されるので、GELF は大きなメッセージをチャンクに分割します。各チャンクは 12 バイトのヘッダーで始まります。2 バイトのマジックバイト(0x1e 0x0f)、8 バイトのメッセージ ID、1 バイトのシーケンス番号、1 バイトのチャンク数です。
OxiDB では、各受信スレッドが自分専用の HashMap<message_id, ChunkBuffer> を持っています。チャンクはシーケンス番号が示すスロットに入り、重複したシーケンス番号は無視されます(最初のものが優先)。最後に欠けていたチャンクが届くと、チャンクを順番に連結してパースします。上の例ではわざとチャンクを逆順に送りましたが、何の違いもありませんでした。不完全なメッセージは 5 秒後に破棄されます。この掃除は 1000 パケットごとに実行されるので、アイドル状態のサーバーでは中途半端なバッファがもう少し長く残ることがあります。
微妙な点が 1 つあります。バッファはスレッドごとです。SO_REUSEPORT は送信元のアドレスとポートで振り分けるので、同じソケットから送られたチャンクは同じスレッドに届きます。1 つのメッセージのチャンクを異なる送信元ポートから送るクライアントだと、チャンクが複数のスレッドに散らばり、メッセージが再構成されることはありません。私が知っている GELF ライブラリは 1 つのメッセージを 1 つのソケットから送りますが、この制限は知っておく価値があります。
Elasticsearch 風の動的インデックス
これが GELF 入力を特徴づける機能です。すべてのフィールドは、最初に現れた瞬間にインデックスが張られます。host、short_message、level、facility、timestamp、_ts のインデックスは起動時に作成されます。その後、各ライターはバッチ内のフィールド名を集めて既知フィールドの集合と比較し、未知のものがあれば create_index を呼びます。既知フィールドの集合は共有ミューテックスの背後にあり、高速パスは単なる集合の所属チェックです。
利点は明らかです。明日アプリケーションが新しい _tenant_id フィールドを送り始めたとしても、{"tenant_id": "acme"} のクエリはスキーマやインデックスの設定を一切せずにインデックス上で実行されます。Elasticsearch の動的マッピングも同じことをしており、ログに関しては実に便利です。
コストも同じくらい明らかです。
- すべてのフィールドが B-tree インデックスになります。 上の 4 つのメッセージで 15 個のインデックスができました。その中には 22 KB の
full_messageも含まれます。スタックトレース全体が 1 つのインデックスキーになるのです。カーディナリティの高いフィールド(リクエストの所要時間、リクエスト ID)ほど、インデックスのメモリと書き込みコストを大きく増やします。 - 新しいフィールドは、書き込みパス上でのインデックス構築を意味します。 これには測定可能な副作用があり、後述の「計測」の節で取り上げます。
圧縮には非対応
GELF の仕様では、UDP メッセージを zlib または gzip で圧縮することが認められています。OxiDB の受信側は展開を行いません。試してみました。
s.sendto(zlib.compress(m("zlib-compressed")), ("127.0.0.1",15908))
s.sendto(gzip.compress(m("gzip-compressed")), ("127.0.0.1",15908))
s.sendto(m("plain"), ("127.0.0.1",15908))
stored: ['plain']圧縮した 2 つのメッセージは跡形もなく消えました。GELF クライアントの中には UDP でデフォルトで圧縮するものもあるので、OxiDB に送るときはそれを無効にしてください。
MessagePack:あえてインデックスを張らない安価な兄弟
MessagePack 入力は GELF と同じ骨格(8 つの受信スレッド、有界チャネル、4 つのライター、2000 レコードまたは 5 ms)を使いますが、重要な違いが 2 つあります。
- 形式がバイナリでコンパクトです。 パースには
rmp-serdeを使い、受け付けるのはマップだけです。形の変換も_プレフィックスの除去もありません。レコードは届いたとおりに保存されます。 - フィールドごとのインデックスはありません。 意図的にです。
ソースコード中の理由づけを要約するとこうなります。GELF の動的マッピングはフィールドごとに B-tree を構築し、リクエストのレイテンシのようなカーディナリティの高いフィールドがメモリを占有します。一方でログストリームは追記専用で、任意のフィールドでクエリされることはまれです。たいていは「最新 N 件を見せて」か「この時間範囲を見せて」であり、それは _ts のインデックス 1 つで足ります。サーバーは MessagePack リスナーを起動するときに、_ts にインデックスを張り、コレクションにデフォルトで 7 日間の TTL を設定します。コード中のコメントによれば、ダッシュボードの新しい順のページングがフルスキャンにならないこと、そしてコレクションが際限なく大きくならないことが目的です。
同じレコードのサイズを比較しました。
GET /api/orders 200    msgpack 124 B vs JSON 169 B
POST /api/pay 502      msgpack 123 B vs JSON 167 B
GET /health 200        msgpack 116 B vs JSON 160 B
パケットは約 27 パーセント小さくなります。クエリは引き続き動作しますが、インデックスなし(フルスキャン)で実行されます。
{"cmd": "find", "collection": "_msgpack_logs", "query": {"status": {"$gte": 500}}}{
"ok": true,
"data": [
{
"host": "edge-1",
"short_message": "POST /api/pay 502",
"level": 3,
"method": "POST",
"path": "/api/pay",
"status": 502,
"dur_ms": 3010,
"ts": 1791754356.749907,
"_ts": 1791754356749,
"_id": 2,
"_version": 1
}
]
}コレクションにあるインデックスはこれだけです。
{"cmd": "list_indexes", "collection": "_msgpack_logs"}{
"ok": true,
"data": [
{"name": "_ts", "index_type": "field", "fields": ["_ts"], "unique": false},
{"name": "_ts_ttl", "index_type": "ttl", "fields": ["_ts"], "unique": false, "expire_after_seconds": 604800}
]
}(読みやすさのためにこのレスポンスは行数を減らしてまとめていますが、内容は変えていません。)
テナントによるルーティング
MessagePack 入力にはもう 1 つ仕掛けがあります。レコードに db フィールドがあり、その名前のデータベースが存在すれば、レコードはそのデータベース内の同名のコレクションに入ります。ライターは各バッチを送り先のデータベースごとにグループ化し、グループごとに 1 回の insert_many を行います。その理由はコードに書かれています。共有のログシンクが 1 つしかないと、あるプロジェクトのログを読むたびに他のすべてのプロジェクトの行をなめることになり、保持期間もサイズもクエリコストもすべて共有されてしまいます。テナントのリクエストはテナントのデータであり、プロジェクトを削除すればそのログも一緒に消えるべきです。db のないレコード(コントロールプレーン自身のリクエスト)はデフォルトのデータベースに残り、存在しないデータベースを指定したレコードも破棄されずにデフォルトのデータベースに入ります。テナントのデータベースへの最初の書き込みでは、そこにも _ts のインデックスと TTL が設定されます。
生 UDP:最もシンプルな入力
OXIDB_UDP_PORT は 3 つ目で、最もシンプルな入力です。パケットが JSON としてパースできればドキュメントとして保存され、そうでなければ {"message": "...", "_ts": ...} になります。パケット自身が持つ _ts は保持されます。syslog のようなプレーンテキストの行を、一切変換せずに集めるのに便利です。
s.sendto(b'{"level":"error","msg":"disk 91% full","mount":"/var"}', ("127.0.0.1", 15910))
s.sendto(b'kernel: eth0 link down\n', ("127.0.0.1", 15910))
{
"ok": true,
"data": [
{
"level": "error",
"msg": "disk 91% full",
"mount": "/var",
"_ts": "2026-10-11T21:32:36.750067+00:00",
"_id": 1,
"_version": 1
},
{
"message": "kernel: eth0 link down",
"_ts": "2026-10-11T21:32:36.753946+00:00",
"_id": 2,
"_version": 1
}
]
}ここにはチャネルもバッチ処理もありません。8 つのスレッドのそれぞれがパケットを受け取り、直接 1 回の insert を行います。ファイル先頭のコメントにはまだ「1 writer thread drains the channel in batches」と書かれていますが、コードはもうそうなっていません。コレクションにはインデックスが一切なく、list_indexes は空の配列を返しました。大量のログには GELF か MessagePack の入力を選びます。生 UDP はどちらかというと「nc があるから、この行をどこかに投げておこう」という用途向けです。
計測:50,000 パケットのバースト
GELF と MessagePack の違いを具体的に示すために、1 つの Python ソケットで送れる限りの速さで 50,000 パケットを送り、書き込まれたレコード数を数えました。環境は Apple M4(10 コア)、ローカルのループバック、OxiDB 0.44.2、デフォルトのディスク設定(すべてのコミットを fsync)です。送信には毎回 0.16 から 0.24 秒かかり、すべてのレコードは長くても 1.2 秒以内にクエリ可能になりました(私のループは 0.5 秒ごとに数えていたので、それより細かい分解能はありません)。
GELF         sent 50000 in 0.16s, stored 50000 (100.0%), all visible after 1.17s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.18s, stored 50000 (100.0%), all visible after 1.19s (incl. 0.5s idle check)
サーバーがすでに見たことのあるフィールド名であれば、どちらの入力もロスはありませんでした。バーストに新しいフィールド名を加えると、様子が変わりました。
GELF         sent 50000 in 0.18s, stored 33439 (66.9%), all visible after 1.19s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.19s, stored 50000 (100.0%), all visible after 1.19s (incl. 0.5s idle check)
GELF         sent 50000 in 0.24s, stored 32751 (65.5%), all visible after 1.24s (incl. 0.5s idle check)
MessagePack  sent 50000 in 0.16s, stored 50000 (100.0%), all visible after 1.17s (incl. 0.5s idle check)
最初の実行でも同じことが起きていました(33,595 レコード)。3 回とも、GELF はおよそ 3 分の 1 を失いました。
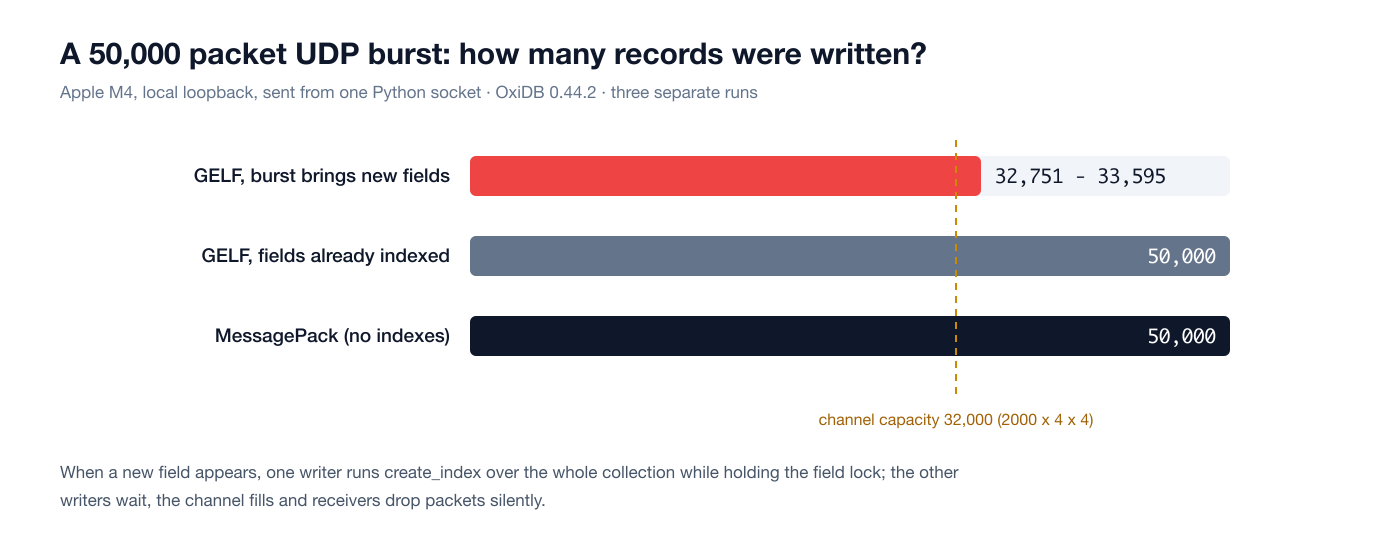
コードを読む限り、最も可能性の高い説明はこうです。新しいフィールドを見つけたライターは、既知フィールドのミューテックスを保持したまま create_index を呼びます。その時点でコレクションには 10 万件をゆうに超えるレコードがあったので、インデックスはコレクション全体に対して構築されます。他の 3 つのライターはバッチごとに同じミューテックスを確認するので、待たされます。ライターが止まっている間に受信スレッドがチャネルを埋め、満杯になると try_send は黙ってパケットを捨てます。書き込まれたレコード数がチャネル容量(32,000)にバッチ 1 つ分ほどを足した値にこれほど近いことも、この説明と整合します。MessagePack にはインデックス構築がないので、同じバーストがロスなしで通りました。
これは設計上の意図的なトレードオフです。UDP にはバックプレッシャーがなく、送信側に速度を落とせと伝えることはできません。だからキューが満杯のときは、サーバーを詰まらせるより捨てるほうがましなのです。しかしその結果として、GELF では新しいフィールドが初めて現れる瞬間が最悪のタイミングになります。実際の運用では 2 つのことをおすすめします。フィールドの集合が固定されたアプリケーションなら、最初のデプロイの前にサンプルメッセージをいくつか送ってインデックスを温めておくこと。あるいは、大量でスキーマが変わりやすいストリームは MessagePack 入力に回すことです。また、こうした破棄に対するカウンターもありません。メトリクスとして追加したいと考えています。
保持期間:set_retention と TTL の仕組み
保持期間はコレクションごとに定義します。
{"cmd": "set_retention", "collection": "app_logs", "days": 7}内部で起きていることはシンプルです。set_retention はコレクションの _ts フィールドに days x 86400 秒の TTL インデックスを張り、ポリシーをドキュメントとして _retention_policies コレクションに書き込みます。実際の削除は、ドキュメントエンジンの既存の TTL スレッドが行います(ファイルモードでは 1 秒に 1 回、メモリモードでは 100 ms ごと)。TTL の掃除は _ts インデックスに対する「現在から expire_after_seconds 前まで」の範囲スキャンです。削除は 4096 件ずつのチャンクで行われ、チャンクの合間にインデックスの書き込みロックを解放するので、期限切れのレコードが大量にたまっていてもコレクションが長時間ロックされることはありません。
テストとして、_ts が 0 日前、3 日前、8 日前、30 日前の 4 つのドキュメントを app_logs コレクションに書き込み、7 日間の保持期間を設定しました。期限切れのドキュメントは、TTL インデックスが作成されるとすぐに削除されます。
{"cmd": "set_retention", "collection": "app_logs", "days": 7}{"ok": true, "data": "retention set: app_logs (7 days)"}{"cmd": "find", "collection": "app_logs", "query": {}}{
"ok": true,
"data": [
{"short_message": "0 days old", "_ts": "2026-10-11T21:33:01.272662+00:00", "_id": 1, "_version": 1},
{"short_message": "3 days old", "_ts": "2026-10-08T21:33:01.272662+00:00", "_id": 2, "_version": 1}
]
}(これも行数を減らしてまとめています。)8 日前と 30 日前のドキュメントは消えています。ポリシーのドキュメントは次のとおりです。
{"cmd": "get_retention", "collection": "app_logs"}{
"ok": true,
"data": {
"collection": "app_logs",
"retain_days": 7,
"expire_after_seconds": 604800,
"_ts": "2026-10-11T21:33:01.348133+00:00",
"_id": 1,
"_version": 1
}
}days: 0 は拒否されます(retain_days must be > 0)。delete_retention は TTL 設定を削除しますが _ts のフィールドインデックスは残し、list_retentions はすべてのポリシーを一覧表示します。
このアプローチで気に入っているのは、新しい仕組みを書かずに済んだことです。ログの保持期間は、ドキュメントエンジンの TTL インデックスの使い方の 1 つにすぎません。そしてそこが、時系列エンジンの保持期間との違いでもあります。あちらでは封印済みのブロックを丸ごと捨てますが、こちらではドキュメントをインデックス経由で 1 件ずつ削除します。ログには十分ですが、非常に大きなコレクションではブロックを捨てるほど安くはありません。
テスト中に見つけた 2 つの欠陥
保持期間を変更しても TTL が変わりません。 create_ttl_index は、そのフィールドにすでに TTL が存在すれば何もしません(冪等です)。set_retention はポリシーのドキュメントを更新しますが、TTL を作り直しません。
policy record retain_days: 30
ttl index: [{'name': '_ts_ttl', 'index_type': 'ttl', 'fields': ['_ts'], 'unique': False, 'expire_after_seconds': 604800}]
ポリシーは 30 日と言っていますが、実際に削除を行う TTL は 7 日(604800 秒)のままです。回避策は、まず delete_retention を実行し、それから set_retention をやり直すことです。
after delete: [('_ts', 'field')]
after re-set to 30: [{'name': '_ts_ttl', 'index_type': 'ttl', 'fields': ['_ts'], 'unique': False, 'expire_after_seconds': 2592000}]
数値の _ts は決して削除されません。 TTL の掃除は、日付型のインデックス値しか見ません。コードにその理由が説明されています。範囲の下限を無制限にすると、数値の created_at フィールドを持つすべてのドキュメントが、期限に関係なく削除されてしまうからです。OxiDB では ISO 8601 / RFC 3339 形式の文字列はインデックスに日付として格納され、数値は数値として格納されます。ところが、サーバー自身の MsgpackLogger は _ts をエポックミリ秒、つまり数値として書き込みます。テストしてみました。10 日前の日付のレコードを 3 つ MessagePack 入力に送りました。1 つはエポックミリ秒の _ts、1 つは ISO 文字列の _ts、1 つは _ts なしです。それからデフォルトの 7 日間 TTL が動くまで数秒待ちました。
{"cmd": "find", "collection": "_msgpack_logs", "query": {"short_message": {"$in": ["old, epoch-ms _ts", "old, ISO-8601 _ts", "no _ts at all"]}}}{
"ok": true,
"data": [
{"short_message": "no _ts at all", "_id": 5, "_version": 1},
{"short_message": "old, epoch-ms _ts", "_ts": 1790890365335, "_id": 4, "_version": 1}
]
}削除されたのは ISO 文字列のものだけでした。つまり 0.44.2 では、_msgpack_logs のデフォルトの 7 日間 TTL は、OxiDB 自身の REST リクエストログのような数値の _ts を持つレコードを決して削除せず、しかも MessagePack 入力は _ts のないレコードにスタンプを付けることもしません。自分のアプリケーションから MessagePack を送るなら、_ts は ISO 8601 の文字列で書いてください。私の側でやるべきことも明確です。明示的なオプションのもとで TTL の掃除を数値のエポックミリ秒にも広げるか、ロガーと入力が _ts を日付として書くようにするかです。
アラート
アラートルールは _alerts コレクション内のドキュメントです。バックグラウンドでは、データベースごとの oxidb-alerts スレッドが OXIDB_ALERT_INTERVAL 秒ごとに起き、enabled: true のルールを読み込み、それぞれを評価します。条件の種類は 2 つあります。
count_threshold:ルールのqueryフィルターに_ts >= now - windowの条件を加えてcountを実行します。結果はoperator(gt、gte、lt、lte、eq、ne。デフォルトはgte)を使ってthresholdと比較されます。aggregation_threshold:ルールのpipelineの先頭に{"$match": {"_ts": {"$gte": ...}}}ステージを追加して集計を実行し、最初の結果ドキュメントのresult_field(デフォルトはcount)をしきい値と比較します。
window は "30s"、"5m"、"1h" のように書き、デフォルトは 5 分です。条件が成立すると、アクションが実行されます。webhook(JSON ボディを持つ HTTP POST。評価スレッドをブロックしないよう、専用のスレッドで撃ちっぱなしで送られます)、stderr(サーバーログに [ALERT] 行を出力)、そして log です。どのアクションが設定されていても _alert_history にレコードが書き込まれ、ルールの last_fired、last_fired_epoch、fire_count フィールドが更新されます。
クールダウン はこれらのフィールドに依存しています。now < last_fired_epoch + cooldown_seconds であれば、そのルールはそもそも評価されません。デフォルトは 300 秒です。
実際の実行:ローカルの webhook 受信サーバー
127.0.0.1:15906 で、すべての POST をタイムスタンプ付きで表示する小さな Python HTTP サーバーを動かしました。
import http.server, datetime
class H(http.server.BaseHTTPRequestHandler):
    def do_POST(self):
        n = int(self.headers.get("Content-Length", 0)); body = self.rfile.read(n)
        t = datetime.datetime.now().strftime("%H:%M:%S")
        print(f"[{t}] POST {self.path}  {body.decode()}", flush=True)
        self.send_response(204); self.end_headers()
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 15906), H).serve_forever()
次に、件数しきい値と集計しきい値のルールを 1 つずつ定義しました。
{"cmd": "create_alert", "name": "error-burst", "collection": "_gelf_logs",
 "condition": {"type": "count_threshold", "query": {"level": {"$lte": 3}}, "window": "1m", "threshold": 5, "operator": "gte"},
 "actions": [{"type": "webhook", "url": "http://127.0.0.1:15906/alerts"}, {"type": "stderr"}],
 "cooldown_seconds": 20}
{"ok": true, "data": "alert created: error-burst"}{"cmd": "create_alert", "name": "slow-requests", "collection": "_gelf_logs",
"condition": {"type": "aggregation_threshold", "window": "1m",
"pipeline": [{"$match": {"latency_ms": {"$gte": 500}}}, {"$group": {"_id": null, "n": {"$sum": 1}}}],
"result_field": "n", "threshold": 3, "operator": "gte"},
"actions": [{"type": "webhook", "url": "http://127.0.0.1:15906/alerts/slow"}],
"cooldown_seconds": 60}{"ok": true, "data": "alert created: slow-requests"}test_alert は、アクションを実行せず、クールダウンも無視して、ルールを即座に評価します。
{"cmd": "test_alert", "name": "error-burst"}{
"ok": true,
"data": {
"alert": "error-burst",
"type": "count_threshold",
"current_value": 0,
"threshold": 5,
"operator": "gte",
"would_fire": false
}
}ただし、集計ルールにはまだ対応していません。
{"cmd": "test_alert", "name": "slow-requests"}{"ok": true, "data": {"alert": "slow-requests", "error": "unsupported condition type: aggregation_threshold"}}それから GELF 経由でトラフィックのシナリオを流しました(時刻はローカル時間)。
[00:33:40] send 6 errors + 4 slow requests (latency >= 500 ms)
[00:33:46] send 3 more errors (still inside the 20 s cooldown)
[00:34:10] cooldown over; window still holds >= 5 errors
[00:34:20] done
webhook 受信サーバーが受け取ったものは次のとおりです。
[00:33:41] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:33:41Z","fired_at_epoch":1791754421,"condition_result":6,"threshold":5,"operator":"gte"}
[00:33:41] POST /alerts/slow  {"alert_name":"slow-requests","collection":"_gelf_logs","fired_at":"2026-10-11T21:33:41Z","fired_at_epoch":1791754421,"condition_result":4,"threshold":3,"operator":"gte"}
[00:34:01] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:34:01Z","fired_at_epoch":1791754441,"condition_result":9,"threshold":5,"operator":"gte"}
[00:34:21] POST /alerts  {"alert_name":"error-burst","collection":"_gelf_logs","fired_at":"2026-10-11T21:34:21Z","fired_at_epoch":1791754461,"condition_result":9,"threshold":5,"operator":"gte"}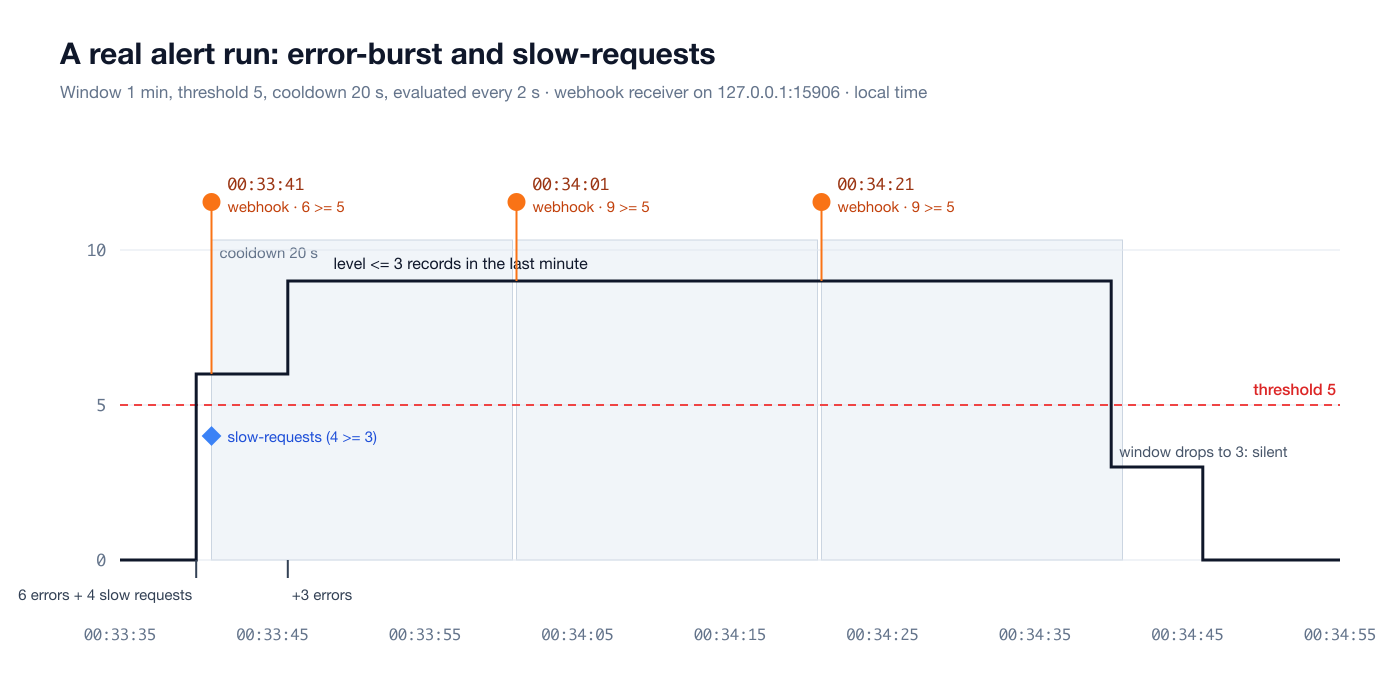
ここからいくつかのことがわかります。
- 最初の発火はパケット送信の 1 秒後に届きました。これは 2 秒の評価間隔によるものです。
- 00:33:46 の追加の 3 件のエラーでは新しい通知は出ませんでした。ルールがクールダウン中だったからです。
- 条件が真である限り、ルールは クールダウンが終わるたびに再び発火します。00:34:01 と 00:34:21 です。つまりこれはエッジトリガーのアラートではなく、条件が続く間は通知し続けます。00:34:40 にエラーが 1 分のウィンドウから外れると件数は 3 に下がり、ルールは静かになりました。「解消」の通知はありません。
- 発火のたびに、サーバーの stderr にも
[ALERT] error-burst: _gelf_logs ...行が出力されました。
履歴はクエリ可能なコレクションです。
{"cmd": "list_alert_history"}{
"ok": true,
"data": [
{
"alert_name": "error-burst",
"collection": "_gelf_logs",
"fired_at": "2026-10-11T21:33:41Z",
"fired_at_epoch": 1791754421,
"condition_result": 6,
"threshold": 5,
"operator": "gte",
"actions_executed": ["webhook", "stderr"],
"_ts": "2026-10-11T21:33:41Z",
"_id": 1,
"_version": 1
},
{
"alert_name": "slow-requests",
"collection": "_gelf_logs",
"fired_at": "2026-10-11T21:33:41Z",
"fired_at_epoch": 1791754421,
"condition_result": 4,
"threshold": 3,
"operator": "gte",
"actions_executed": ["webhook"],
"_ts": "2026-10-11T21:33:41Z",
"_id": 2,
"_version": 1
}
]
}(4 件のうち最初の 2 件です。残りの 2 件は 00:34:01 と 00:34:21 の発火です。)ルール自身の状態も更新されていました。
{'name': 'error-burst', 'enabled': True, 'cooldown_seconds': 20, 'fire_count': 3, 'last_fired': '2026-10-11T21:34:21Z', 'last_fired_epoch': 1791754461}_alert_history と _alerts は通常のコレクションなので、set_retention を設定することも、それらに対してアラートを張ることさえできます。ルールを有効化・無効化する専用のコマンドはないので、_alerts コレクションに対する通常の update で enabled を切り替えました。
{"cmd": "update", "collection": "_alerts", "query": {"name": {"$in": ["error-burst", "slow-requests"]}}, "update": {"$set": {"enabled": false}}}{"ok": true, "data": {"modified": 2}}アラート側の制限
これらも実際のテストで確認したものです。
- webhook の URL にホスト名が使えません。 URL パーサーは
http://localhost:15906/...を受け付けますが、接続はhost:portのテキストをソケットアドレスとしてパースして行われ、DNS 解決は行われません。localhostの URL を持つルールが発火したとき、受信サーバーには何も届かなかったのに、_alert_historyのレコードには"actions_executed": ["webhook"]と書かれていました。webhook の失敗は無言です。当面は URL に IP アドレスを使ってください。 http://のみです。 TLS はありません。外部サービスに webhook を送るには、間にローカルのリレーが必要です。- レスポンスは読まれず、リトライもありません。 リクエストを書き込んだら接続を閉じます。その瞬間に受信側が落ちていれば通知は失われます(それでも履歴には「webhook」と記録されます)。
- しきい値は整数です。 集計結果は
as_i64で読まれます。平均レイテンシが 300.5 ms のとき、avg > 100のルールは一度も発火しませんでした(fire_count: 0)。一方、$sumから整数として出てくる結果は問題なく動きました。小数の結果については、今のところパイプライン内で丸める必要があります。 - ウィンドウは
_tsに基づきます。 アラートのウィンドウは_tsを ISO 文字列の境界値と比較します。GELF と生 UDP のレコードは_tsに日付文字列を持つので問題ありませんが、数値の_tsを持つ MessagePack のレコードは決してウィンドウ内に入りません。テストしてみました。_msgpack_logsでstatus: 503を数えるルールに対し、エポックミリ秒の_tsを持つレコードを送った後のtest_alertは"current_value": 0を返し、同じレコードを ISO 文字列の_tsで送ると"current_value": 1になりました。
どれも修正可能で、私のリストに載っています。とはいえ現状でも、アラートエンジンは「直近 N 分間にこれだけのエラー」といった種類の仕事には十分に機能します。
oxidb-tail:ターミナルでライブにログを見る
oxidb-tail は、ワイヤープロトコルで OxiDB に接続するターミナル UI(ratatui + crossterm)です。依存関係が軽いのでビルドは速く、私のマシンではクリーンなリリースビルドに 15.45 秒かかりました。
cargo build --release -p oxidb-tail
./target/release/oxidb-tail --host 127.0.0.1 --port 15900
これを動かしている間に GELF で 60 メッセージのストリームを送りました。以下は tmux 内でキャプチャした画面です。
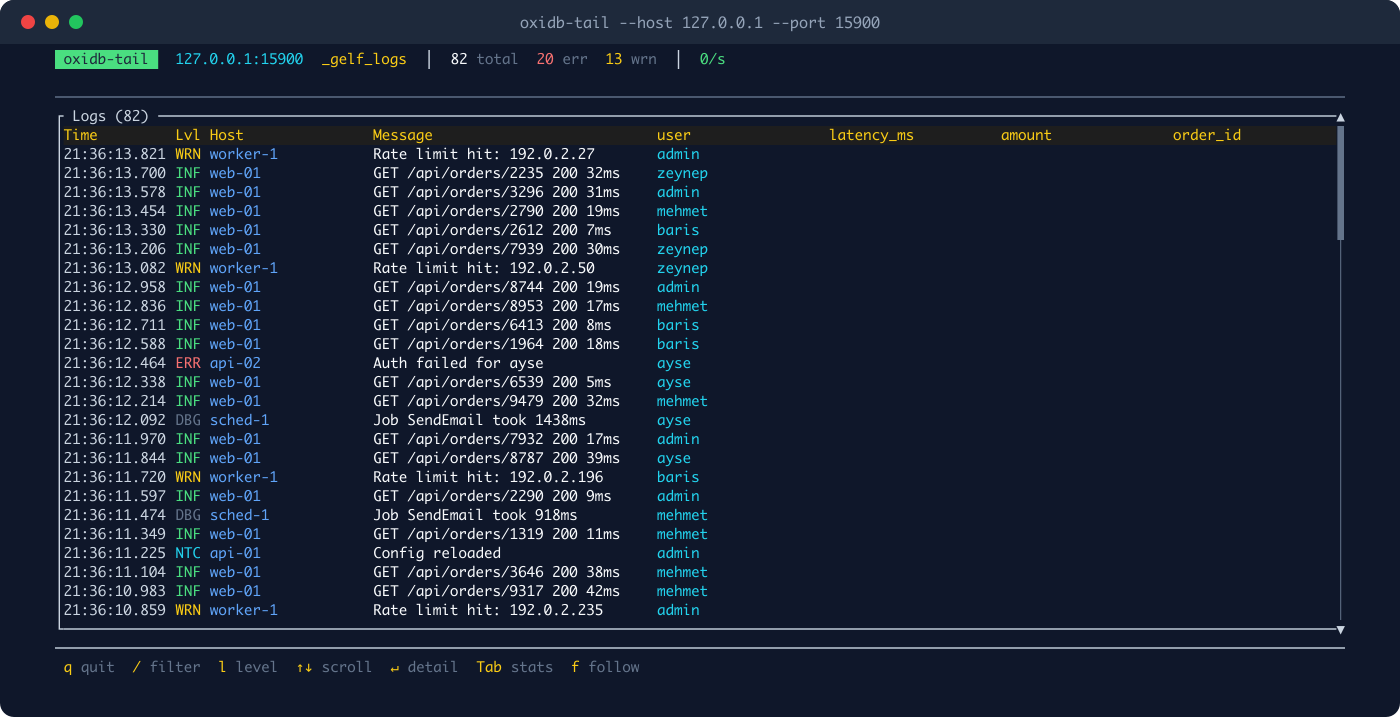
仕組みはシンプルです。--interval ミリ秒ごと(デフォルトは 500)にコレクションへ {"_id": {"$gt": last_id}} を送り、_id でソートされたレコードを最大 200 件取得します。レベルは syslog レベルで色分けされます。0-3 は赤、4 は黄、5 はシアン、6 は緑、7 はグレーです。最初のバッチから最もよく使われている追加フィールドを列として選び、固定します。/ でテキストフィルター、l でレベルフィルター、Enter で選択したレコードの全フィールド、Tab でホストの分布を示すサイドパネルが表示されます。
ここでも正直に書いておくと、小さなクセが 2 つあります。列が最初のバッチで固定されるため、このストリームでは空の latency_ms、amount、order_id のような列が画面に表示される一方で、client_ip は表示されません。次に、初回の読み込みでは _id の昇順で最初の 100 件を取るので、非常に大きなコレクションに対しては最も古いものから始まり、追いつくまでにしばらくかかります。時刻の列は _ts から読まれるので、数値の _ts を持つ MessagePack のコレクションでは ??:??:?? と表示されます。名前が示すとおり、このツールは GELF のコレクション向けに書かれています。
サーバーが自分のログを自分自身に書く
この話にはちょっといいオチがあります。OxiDB はログを受け取るだけでなく、自分自身のログを GELF や MessagePack としてどこかに送ることもできます。OXIDB_GELF_ADDR を設定するとワイヤー接続のイベントとサーバーメッセージがそこに送られ、OXIDB_MSGPACK_ADDR を設定すると REST レイヤーのリクエストログが送られます。送信先はサーバー自身でも構いません。自分のポートを指すようにしてサーバーを再起動しました(再起動の前後で _gelf_logs は 199,868 件、_msgpack_logs は 250,005 件で、何も失われていません)。
OXIDB_GELF_ADDR=127.0.0.1:15908 OXIDB_MSGPACK_ADDR=127.0.0.1:15909 HOSTNAME=oxidb-demo ...ワイヤー接続を 1 つ開いて閉じた後、_gelf_logs には次のものが入っていました。
{
 "host": "oxidb-demo",
 "short_message": "client connected: 127.0.0.1:50139",
 "timestamp": 1791754653.456128,
 "level": 6,
 "peer": "127.0.0.1:50139",
 "_ts": "2026-10-11T21:37:33.462529+00:00",
 "_id": 199869,
 "_version": 1
}
REST も有効にして(OXIDB_HTTP_PORT)curl リクエストを 2 回送ると、_msgpack_logs には次のものが入っていました。
{
 "host": "oxidb-demo",
 "short_message": "GET /api/collections",
 "level": 6,
 "ts": 1791754676.108999,
 "_ts": 1791754676108,
 "app": "oxidb-server",
 "method": "GET",
 "path": "/api/collections",
 "status": "200",
 "ms": "0",
 "db": "",
 "user_agent": "curl/8.7.1",
 "_id": 250008,
 "_version": 1
}
404 を返したリクエストは level: 4(warning)で書き込まれました。db フィールドは、前述のテナントルーティングに使われるものです。そしてご覧のとおり、ここでは _ts が数値です。保持期間の欠陥が実際に効いてくるのは、まさにこの部分です。
OxiDB の他の部分との関係
ログエンジンは独立したストレージエンジンではありません。ドキュメントエンジンの前に置かれた入力と、その後ろにある 2 つのバックグラウンドスレッドです。その結果、次のようになります。
- ドキュメントエンジンのクエリと集計の機能はすべてログに対して使えます。エラーメッセージをテキスト検索したければ、コレクションに全文インデックスを追加してください。
- 永続性はドキュメントエンジンのものです。WAL、CRC32、fsync。再起動をまたいでレコードが失われることはありませんでした。ただし UDP 自体は配送を何も保証しません。サーバーに届かなかったパケットや、チャネルが満杯で捨てられたパケットは、どこにも痕跡を残しません。
- メトリクスのような数値で等間隔のデータには、圧縮とブロック単位の保持期間を備えた時系列エンジンのほうが向いています。ログエンジンは、不規則で構造化された、テキスト中心のレコードのためのものです。
- プロジェクトの 1.0 安定性 ADR(ADR-0003)は、GELF 入力と TTL インデックスを「動作し出荷されるが、1.x のマイナーバージョンでリクエスト/レスポンスの形が変わりうる」グループに入れています。つまりこの部分はまだ後方互換性の約束の対象外であり、上記の欠陥を修正する際に挙動を変える余地があります。
まとめと試し方
GELF 入力は「アプリケーションの送り先を Graylog から OxiDB に変えるだけで、すべてのフィールドにインデックスが張られる」という体験を提供します。その代償は、フィールドごとのインデックスと、新しいフィールドが初めて届いたときのパケットロスの可能性です。MessagePack 入力は意図的に仕事を減らしています。インデックスなし、より小さなパケット、バーストへのより高い耐性。保持期間はドキュメントエンジンの TTL の仕組みを薄く包んだもので、アラートは _alerts コレクション内のドキュメントをバックグラウンドで評価するものです。すべてが 1 つのプロセスで、別のサービスを立てる必要はありません。
この記事を準備する中で見つけた欠陥(保持期間の変更に TTL が追従しない、数値の _ts のレコードが期限切れにならない、localhost の webhook が無言で失敗する、小数の集計結果でアラートが発火しない、test_alert が集計ルールに対応していない、新しいフィールドで GELF のパケットが失われる)は、次のリリースに向けた作業リストに載っています。
試してみたい方のために、ビルド済みのバイナリが GitHub のリリースページにあり、リポジトリの Dockerfile から Docker イメージをビルドすることもできます。最短の手順はこちらです。
OXIDB_GELF_PORT=12201 OXIDB_MSGPACK_PORT=12202 ./oxidb-serverあとはアプリケーションの GELF ロガーを UDP 12201 に向け(圧縮は無効に)、oxidb-tail --host 127.0.0.1 --port 4444 で眺めるだけです。シリーズの次の記事ではレジャーエンジンを取り上げます。