OxiDB の MQTT と AMQP:PUBACK は「ディスク上にある」という意味
OxiDB に内蔵された MQTT 3.1.1 と AMQP 0-9-1 ブローカー。誠実な QoS 1/2、kill -9 を生き延びるセッションと永続キュー、MQTT からコレクションへのインジェスト、センサーの MQTT パブリッシュを消費する AMQP ワーカーを紹介します。
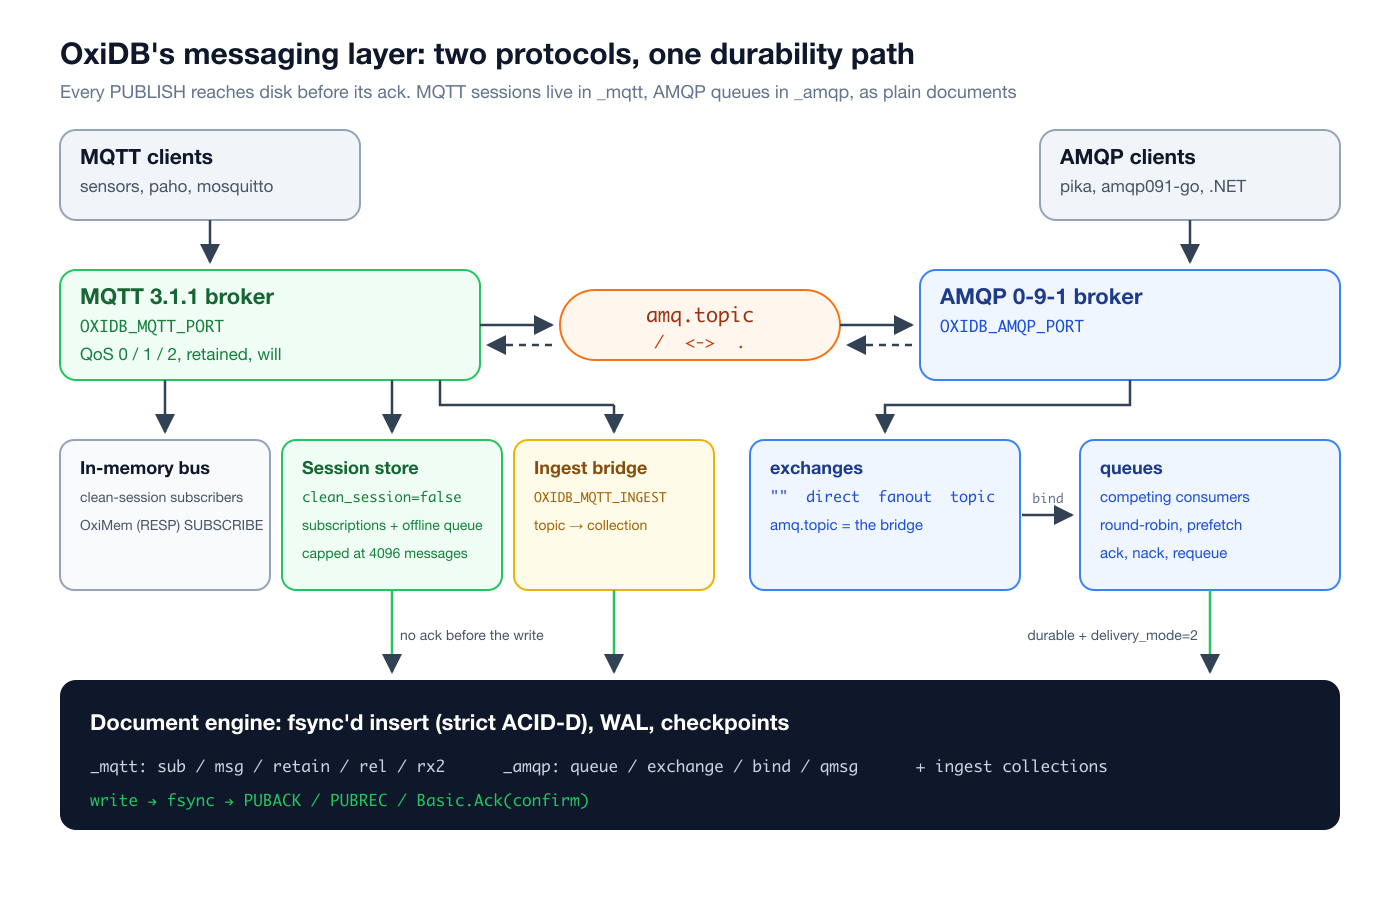
OxiDB には 2 つのメッセージブローカーが同梱されています。MQTT 3.1.1 ブローカーと、AMQP 0-9-1 ブローカー(RabbitMQ が話すプロトコル)です。どちらも同じバイナリ、同じプロセスの中で動き、耐久性も同じところから得ています。ドキュメントエンジンの fsync 済みの書き込みパスです。この記事ではこのレイヤー全体を順に見ていきます。なぜデータベースの中にブローカーを入れたのか、MQTT ブローカーに「QoS 1」の約束を実際に守らせるために何をしたのか、なぜその上に AMQP を追加したのか、MQTT センサーの値がどうやって AMQP ワーカーのキューに届くのか、そしてそのすべてを支えているのはどんなデータ構造なのか、です。ここに載せた例はすべて私自身のマシン(Apple M4、macOS、ローカル)で、実際の oxidb-server 0.44.2 プロセスに対して実行したものです。クライアント側には OxiDB 固有のものは一切ありません。mosquitto_pub/mosquitto_sub、paho-mqtt 2.1.0、pika 1.4.4 を、手を加えないそのままの状態で使っています。
なぜデータベースの中にブローカーがあるのか
MQTT ブローカーは IoT のシナリオのために生まれました。ColdChain デモでは温度プローブが MQTT で測定値を送り、その値を保存してクエリできる必要があります。古典的な構成では、そのために 3 つの可動部品が必要です。ブローカー(Mosquitto、EMQX)、ブリッジサービス、そしてデータベースです。私は代わりにブローカーをデータベースの入り口に置きました。測定値は届いた瞬間にドキュメントエンジンへ書き込め、時系列エンジンにも流し込め、OxiMem(Redis 互換レイヤー)のサブスクライバーからも見えます。
あるとき当然の疑問が浮かびました。どうせブローカーがあるのなら、OxiDB に Kafka や RabbitMQ のような独立したメッセージングエンジンを生やすべきではないか。その答えは ADR-0015(このプロジェクトのアーキテクチャ決定記録の 1 つ)に書いてあり、答えは「いいえ」です。Kafka の価値は、パーティションごとのリーダーシップと ISR レプリケーションにあります。それを OxiDB のシングルリーダー Raft クラスタの上に載せると、すべてのメッセージを 1 つの Raft リーダーに通す(それこそが要点であるパーティション並列性を捨てる)か、合意モデルと戦うかのどちらかになります。偽物の Kafka になるか、クラスタのお荷物になるかです。そこで私は、すでにあるブローカーを誠実なものにすることに決め、後からその上に AMQP を追加しました(ADR-0016)。
この記事の中心にある考え方はこうです。OxiDB では、メッセージが確認応答された瞬間(MQTT なら PUBACK、AMQP ならパブリッシャー確認)、そのメッセージはディスク上にあり、fsync 済みです。ブローカーには新しいファイルフォーマットがありません。セッション、キューに入ったメッセージ、retained 値は、_mqtt と _amqp コレクションにある普通のドキュメントです。
有効化:いくつかの環境変数だけ
プロトコルのリスナーはすべてデフォルトでオフで、オフの間はコストがかかりません。この記事の実験では、サーバーを次のように起動しました(ポートは私に割り当てられた範囲のものです)。
OXIDB_ADDR=127.0.0.1:15800 \
OXIDB_DATA=$PWD/data \
OXIDB_MQTT_PORT=15804 \
OXIDB_AMQP_PORT=15805 \
OXIDB_MQTT_PERSIST=1 \
OXIDB_MQTT_INGEST="sensors/#:sensor_readings,fleet/+/pos:pings" \
oxidb-server| 変数 | 役割 |
|---|---|
OXIDB_MQTT_PORT | MQTT 3.1.1 リスナー |
OXIDB_MQTT_PERSIST | 永続セッション、キューに入った QoS 1/2 メッセージ、retained 値をドキュメントエンジン経由で書き込み、クラッシュ後も残るようにします。デフォルトはオフ |
OXIDB_MQTT_INGEST | MQTT からコレクションへのブリッジ:topic-filter:collection 形式のルートのリスト。ワイルドカード可 |
OXIDB_MQTT_USER / OXIDB_MQTT_PASSWORD | 設定すると、CONNECT に一致するユーザー名とパスワードが必要になります |
OXIDB_AMQP_PORT | AMQP 0-9-1 リスナー。MQTT も有効な場合、amq.topic エクスチェンジが両者をつなぎます |
OXIDB_AMQP_USER / OXIDB_AMQP_PASSWORD | PLAIN 認証。未設定なら認証なし |
起動ログには、どの部分が有効になっているかが表示されます(サーバーはこれらの行で長いダッシュ記号を使っていますが、ここではハイフンに置き換えました。それ以外はそのままです)。
MQTT listening on 0.0.0.0:15804
MQTT persistence on - recovered 0 sessions, 0 pending messages
MQTT ingest bridge on - 2 route(s)
AMQP listening on 0.0.0.0:15805 - recovered 0 durable queues, 0 messages
注目すべき点が 1 つあります。MQTT と AMQP のリスナーは 0.0.0.0 にバインドするので、OXIDB_ADDR の 127.0.0.1 はこれらには適用されません。本番環境では認証を有効にするか、ポートをファイアウォールで守ってください。
MQTT 3.1.1:まずは普通の部分から
どのブローカーでもできるべき基本、つまりトピック、ワイルドカードサブスクリプション、retained メッセージです。2 つの部屋の温度を retained としてパブリッシュし、home/+/temp でサブスクライブしてから、さらに 2 つのメッセージをパブリッシュします。
mosquitto_pub -p 15804 -t 'home/livingroom/temp' -m '22.4' -r -q 1
mosquitto_pub -p 15804 -t 'home/kitchen/temp'    -m '24.1' -r -q 1
mosquitto_sub -p 15804 -t 'home/+/temp' -v -q 1 &
mosquitto_pub -p 15804 -t 'home/bedroom/temp'     -m '19.8' -q 1
mosquitto_pub -p 15804 -t 'home/bedroom/humidity' -m '55'   -q 1
home/livingroom/temp 22.4
home/kitchen/temp 24.1
home/bedroom/temp 19.8最初の 2 行は、サブスクライバーが接続した瞬間に届けられた retained 値で、3 行目がライブのメッセージです。home/bedroom/humidity はフィルタに一致しません。+ はちょうど 1 レベルに一致し、末尾の # は残り全部(何もない場合も含む)に一致します。
ここまではどのブローカーでもやっています。OxiDB を違うものにしているのは、QoS が何を意味するかです。
誠実な QoS:ADR-0015 の物語
MQTT には 3 つの配信レベルがあります。QoS 0 は「最大 1 回(at most once)」で、送りっぱなしです。QoS 1 は「最低 1 回(at least once)」です。ブローカーはサブスクライバーが PUBACK を返すまでメッセージを保持し、接続が切れたら DUP フラグ付きで再送しなければなりません。また clean_session=false で接続したクライアントについては、オフラインの間に届いたメッセージを保持し、戻ってきたときに再生する必要があります。QoS 2 は「ちょうど 1 回(exactly once)」で、PUBREC/PUBREL/PUBCOMP の 2 段階ハンドシェイクと、パケット ID による重複排除からなります。
OxiDB の最初の MQTT ブローカーはこの約束を守っていませんでしたが、守っているかのように振る舞っていました。ADR-0015 を書く際に自分のコードを監査したところ、次のことがわかりました。配信ループは QoS 1 フラグを立ててパケット ID を割り当てており、Web サイトには「パケット ID 付きの QoS 1 配信」と書いてありました。しかし、
- 配信された QoS 1 メッセージは、PUBACK を待つ間どこにも保存されていなかったので、再配信は決してできませんでした。
- サブスクライバーからの PUBACK は読み込まれた後に捨てられていました。確認応答すべきレコードが存在しなかったからです。
- パブリッシュは、その瞬間にライブなチャネルを持つサブスクライバーにしか届かなかったので、一瞬オフラインになったサブスクライバーはそのメッセージを完全に失っていました。
clean_session=falseは何もしておらず、CONNACK は常にsession_present=0を返していました。
ワイヤ上では at-least-once を名乗り、振る舞いは at-most-once でした。私はこれを正しさのバグとして分類しました。システムが守っていない保証を謳っていたからです。まずドキュメントを現実に合わせて修正し、それから振る舞いをドキュメントの以前の主張のレベルまで引き上げました。ルールは単純です。控えめに約束して多くを届けるブローカーは許容できますが、その逆はバグそのものです。
永続セッション:レシーバーはソケットではなくセッションのもの
修正は、設計上の小さな転換 1 つにかかっています。古いブローカーでは、SUBSCRIBE が接続に mpsc::Receiver を渡していました。ソケットが閉じるとレシーバーが drop され、チャネルに送られたものはすべて消えていました。新しい設計では、レシーバーは セッション が所有します。mpsc チャネルは、誰も読んでいなくてもレシーバーが生きている間はバッファリングを続けるので、オフラインのセッションへのパブリッシュはチャネルに溜まり続けます。接続がアタッチされている間は接続がそれを読み出し、デタッチされている間はブローカー全体で 1 つのリーパースレッド(500 ms ごと)がそれをセッションの上限付きキューへ移します。
セッションはクライアント ID をキーとする構造体です。サブスクリプションのリスト、PUBACK を待っている送信メッセージ(パケット ID をキーとする BTreeMap に入っているので、再配信は順序どおりになります)、オフライン中に届いたメッセージのキュー、QoS 2 用の 2 つのセット、そして世代カウンタを持っています。同じクライアント ID で 2 つ目の CONNECT が来ると(MQTT-3.1.4-2:新しく来た方が勝つ)、世代がインクリメントされます。乗っ取り競争に負けた古い接続は世代が変わったことに気づき、二重配信するのではなく終了します。
オフラインキューには上限があります。セッションごとに MAX_QUEUED = 4096 です。いっぱいになると 最も古い メッセージが捨てられ、カウンタ(dropped)が増えます。テレメトリでは、残す価値があるのは最新の測定値です。また QoS 1 が約束しているのは「最低 1 回」であって、「死んだコンシューマーに対して無制限にバックログが溜まっても決して失わない」ことではありません。遅いコンシューマーがブローカーのメモリを使い果たせてはいけないのです。
OXIDB_MQTT_PERSIST:SIGKILL でテストする
メモリ上のセッションはクライアントの切断からは守ってくれますが、サーバーを再起動すると消えてしまいます。OXIDB_MQTT_PERSIST=1 を指定すると、セッション、キューに入ったメッセージ、retained 値はドキュメントエンジンの WAL を通して書き込まれます。ここで私は ADR 自身のルールを真剣に受け止めました。「SIGKILL されたサブプロセスなしで通るテストは何も証明しない」。そこでこのテストは kill -9 で実行しました。
シナリオはこうです。冷蔵室のワーカーが永続セッションで plant/+/alarm に QoS 1 でサブスクライブし、切断します。プローブが 3 つのアラームをパブリッシュし、それぞれの PUBACK を待ちます。次にサーバーを kill して再起動し、ワーカーを再接続させます。Python 側では paho-mqtt を使っています。
import paho.mqtt.client as mqtt
from paho.mqtt.enums import CallbackAPIVersion

def client(cid, clean):
    return mqtt.Client(CallbackAPIVersion.VERSION2, client_id=cid, clean_session=clean)

# 1) subscribe, then drop
c = client("cold-room-worker", False)
def on_connect(c, u, flags, rc, props):
    print(f"CONNACK rc={rc} session_present={flags.session_present}")
    c.subscribe("plant/+/alarm", qos=1)
def on_subscribe(c, u, mid, rcs, props):
    print(f"SUBACK granted={[r.value for r in rcs]}")
    c.disconnect()

# 2) publisher: wait for the PUBACK of every message
p = client("probe-17", True)
info = p.publish("plant/room1/alarm", '{"seq": 1, "temp_c": -12.5}', qos=1)
info.wait_for_publish()
サブスクライブして切断し、その後 3 回パブリッシュします。
CONNACK rc=Success session_present=False
SUBACK granted=[1]
PUBACK mid=1 topic=plant/room1/alarm
PUBACK mid=2 topic=plant/room2/alarm
PUBACK mid=3 topic=plant/room1/alarm
PUBACK mid=4 topic=plant/status (retained)
この時点で、OxiDB 自身の Python クライアントを使い、ネイティブのワイヤプロトコル経由で _mqtt コレクションを覗いてみました。ブローカーの状態のすべてが、普通のドキュメントとしてそこにあります。
{"_kind": "retain", "topic": "home/livingroom/temp", "payload": "22.4", "_id": 1, "_version": 1}
{"_kind": "retain", "topic": "home/kitchen/temp", "payload": "24.1", "_id": 2, "_version": 1}
{"_kind": "sub", "client": "cold-room-worker", "filter": "plant/+/alarm", "qos": 1, "_id": 3, "_version": 1}
{"_kind": "msg", "client": "cold-room-worker", "seq": 1, "topic": "plant/room1/alarm", "payload": "{\"seq\": 1, \"temp_c\": -12.5}", "qos": 1, "_id": 4, "_version": 1}
{"_kind": "msg", "client": "cold-room-worker", "seq": 2, "topic": "plant/room2/alarm", "payload": "{\"seq\": 2, \"temp_c\": -3.1}", "qos": 1, "_id": 5, "_version": 1}
{"_kind": "msg", "client": "cold-room-worker", "seq": 3, "topic": "plant/room1/alarm", "payload": "{\"seq\": 3, \"temp_c\": 4.8}", "qos": 1, "_id": 6, "_version": 1}
{"_kind": "retain", "topic": "plant/status", "payload": "online", "_id": 7, "_version": 1}
ここで kill -9、再起動、そしてワーカーの復帰です。起動ログは次のとおりです。
MQTT persistence on - recovered 1 sessions, 3 pending messagesワーカーは同じクライアント ID と clean_session=false で再接続します。それとは別に、クリーンセッションの「ダッシュボード」クライアントが plant/status にサブスクライブします。
CONNACK rc=Success session_present=True
PUBLISH topic=plant/room1/alarm qos=1 dup=0 payload={"seq": 1, "temp_c": -12.5}
PUBLISH topic=plant/room2/alarm qos=1 dup=0 payload={"seq": 2, "temp_c": -3.1}
PUBLISH topic=plant/room1/alarm qos=1 dup=0 payload={"seq": 3, "temp_c": 4.8}
PUBLISH topic=plant/status retain=1 payload=online
session_present=True がようやく意味を持つようになりました。サブスクリプションが kill されたプロセスから戻ってきたのです。3 つのアラームは seq の順に配信され、retained の online 値も再起動を生き延びました。ワーカーが各メッセージに PUBACK を返すたびに、その _kind: "msg" レコードは削除されます。実行後に同じクエリを投げると、結果は空でした。
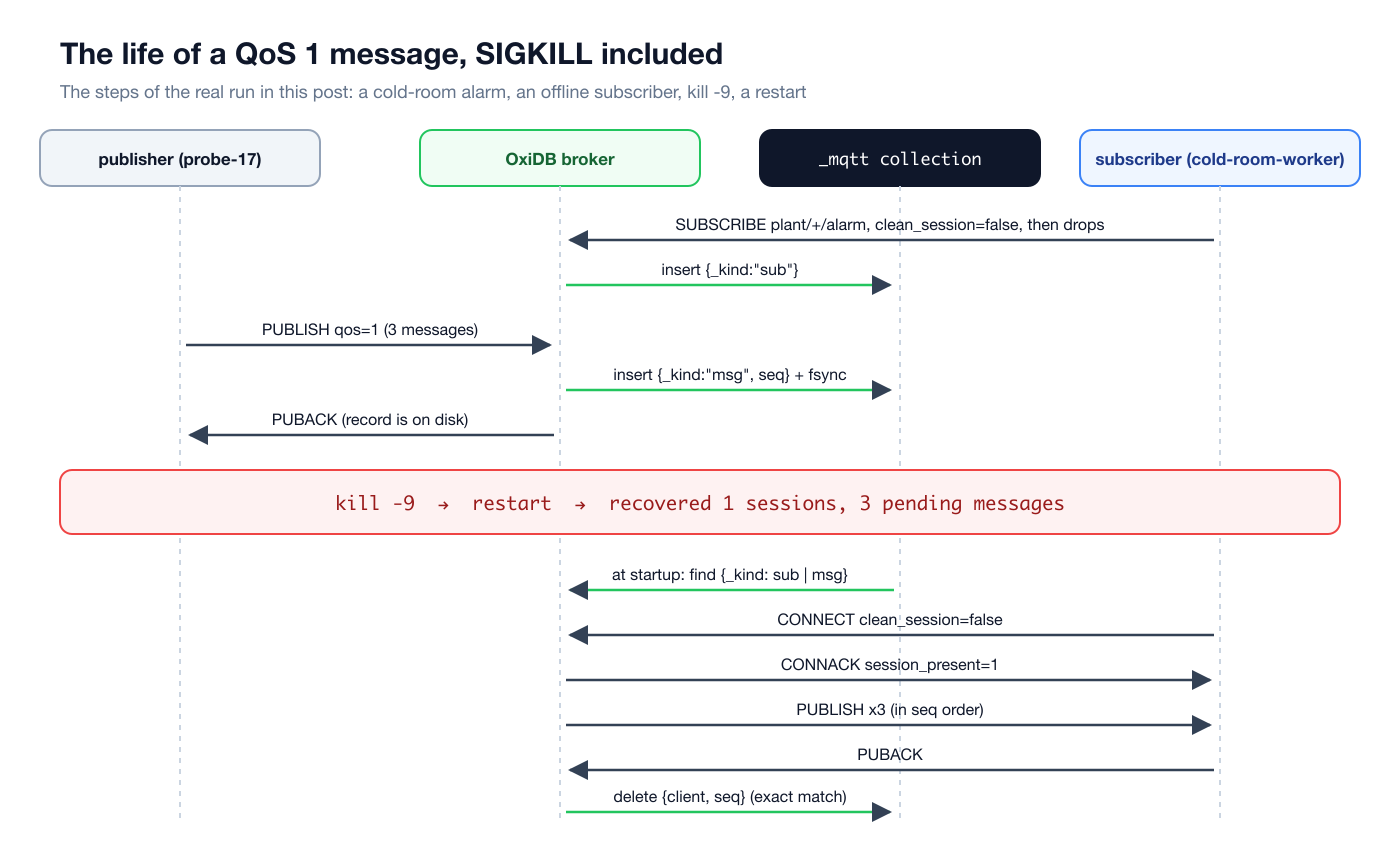
この削除には、小さいけれど重要な詳細があります。PUBACK のとき、レコードは内容ではなく (client, seq) で削除されます。内容で削除すると重複がつぶれてしまいます。同じペイロードを 2 回パブリッシュし、1 回だけ ack すると、内容一致による削除は両方のレコードを消してしまい、2 つ目のコピーについての at-least-once が静かに壊れます。だからこそ、メモリ上の inflight メッセージはすべて、ディスク上のレコードのシーケンス番号を持っているのです。
復元にも上限があります。クラッシュのタイミングによっては、ディスク上に MAX_QUEUED を超えるレコードが残ることがあります。起動時には最新のものだけが読み込まれ、超過分はディスクからも削除されます。そうしないと、再起動によって上限がすでに捨てたメッセージが復活してしまうからです。
QoS 2:ちょうど 1 回
QoS 2 は双方向で動作します。mosquitto クライアントの -d フラグでパケットの流れが見えます。メーターが meter/42/kwh に QoS 2 でパブリッシュし、課金クライアントが meter/+/kwh に QoS 2 でサブスクライブしています。
Client meter-42 sending CONNECT
Client meter-42 received CONNACK (0)
Client meter-42 sending PUBLISH (d0, q2, r0, m1, 'meter/42/kwh', ... (6 bytes))
Client meter-42 received PUBREC (Mid: 1)
Client meter-42 sending PUBREL (m1)
Client meter-42 received PUBCOMP (Mid: 1, RC:0)
Client meter-42 sending DISCONNECT
Client billing sending SUBSCRIBE (Mid: 1, Topic: meter/+/kwh, QoS: 2, Options: 0x00)
Client billing received SUBACK
Subscribed (mid: 1): 2
Client billing received PUBLISH (d0, q2, r0, m1, 'meter/42/kwh', ... (6 bytes))
Client billing sending PUBREC (m1, rc0)
Client billing received PUBREL (Mid: 1)
Client billing sending PUBCOMP (m1)
1532.7これを支えているのは 2 つのセットです。受信側には rx2 があります。すでにファンアウトしたものの、まだ PUBREL を見ていないパブリッシュのパケット ID です。パブリッシャーが同じ ID で再送(DUP)してきた場合、その ID はセットに入っているので、PUBREC を繰り返すだけでメッセージを再びファンアウトすることは しません。このセットこそが、「ちょうど 1 回」と「凝ったハンドシェイク付きの最低 1 回」の違いのすべてです。送信側には pubrel_pending があります。PUBREC を受け取り、PUBCOMP を返す義務を負っている ID です。メッセージレコードは PUBREC の時点で削除されます(そこから先はメッセージの所有者は受信側です)が、PUBREL の義務は生き残らなければなりません。そうしないと、サブスクライバーのステートマシンが永遠に保留中の ID で詰まってしまいます。永続化が有効な場合、両方のセットは _kind: "rx2" と _kind: "rel" のドキュメントとしてディスクに書かれます。ちょうど 1 回も、クラッシュを生き延びなければならないのです。
書き込み前には ack しない。そのコストは?
パブリッシュパスの順序は mqtt.rs に明記されています。まずメモリ上のバスへのファンアウト、次に永続セッション向けの fsync 付き insert、それから AMQP ブリッジとインジェストブリッジへの引き渡し、そして その後でようやく PUBACK(QoS 2 なら PUBREC)を送ります。つまり PUBACK は「受け取りました」という意味ではありません。「それを必要とするすべての永続サブスクライバーのために、ディスク上にあります」という意味です。
これには何らかのコストがかかるはずなので、測定しました。同じマシン(Apple M4、データディレクトリは内蔵 SSD)で、paho を使って 500 回の QoS 1 パブリッシュを逐次実行し、毎回 PUBACK を待ちました。1 回目の実行ではトピックに一致する永続サブスクライバーはおらず、2 回目では 1 つ(オフライン)が一致しました。
bench/nobody: 500 sequential QoS1 publishes, p50=0.059 ms p99=0.185 ms total=0.03 s
bench/durable: 500 sequential QoS1 publishes, p50=4.164 ms p99=9.006 ms total=2.25 s
およそ 70 倍で、そのすべてが fsync です。macOS では、OxiDB は安定ストレージへの完全なフラッシュ(F_FULLFSYNC)を使っており、これに数ミリ秒かかります。一致する永続サブスクライバーがいなければ fsync はまったく行われません。サーバーに永続セッションが 1 つもなければ、パス全体が 1 回のアトミックロード(has_durable フラグ)でスキップされます。必要な人だけがコストを払うのです。これらは 1 本の接続での逐次実行という最悪ケースの数字です。パブリッシャーが複数あれば状況は変わり、AMQP のセクションで説明するグループコミットはまさにそのためにあります。
OXIDB_MQTT_INGEST:トピックからクエリ可能なドキュメントへ
インジェストブリッジは、MQTT をデータの取り込み口として使う人のために私が書いたものの中で、最も実用的な部品です。OXIDB_MQTT_INGEST は topic-filter:collection 形式のルートをカンマ区切りで並べたリストです。一致したパブリッシュはすべて、そのコレクションのドキュメントになります。
- ペイロードが JSON オブジェクトなら、そのオブジェクト自体がドキュメントになります(なので
{"value": ..}はpayload.valueではなくvalueとしてクエリできます)。 - それ以外のものは
{"payload": ...}で包まれます。 - どちらの場合も、ドキュメントには
_topic(実際にパブリッシュされた具体的なトピック。ワイルドカードのルートでは、これで行を区別します)と_received_at(エポックミリ秒)が付きます。
パーサーは各エントリを最後の : で分割します。MQTT のトピックレベル自体に : が含まれることがあるからです。不正なルートがあるとサーバーは起動しません。途中に # があるフィルタ(a/#/b)は MQTT の仕様上何にも一致しないので、それはタイプミスです。それが、黙って一度も発火しないブリッジになるのは避けたかったのです。
5 回のパブリッシュで、そのうち 1 つはどこにもマッピングされていません。
mosquitto_pub -p 15804 -q 1 -t sensors/greenhouse/temp     -m '{"value": 27.3, "unit": "C"}'
mosquitto_pub -p 15804 -q 1 -t sensors/greenhouse/humidity -m '{"value": 71, "unit": "%"}'
mosquitto_pub -p 15804 -q 1 -t sensors/garage/temp         -m '18.9'
mosquitto_pub -p 15804 -q 1 -t fleet/u42/pos -m '{"lat": 41.0151, "lon": 28.9795, "speed": 34}'
mosquitto_pub -p 15804 -q 1 -t chat/general  -m '{"msg": "not mapped"}'
次に、ネイティブクライアントでコレクションを見てみます。
with OxiDbClient(port=15800) as db:
    print("collections:", sorted(...db.list_collections()))
    for d in db.find("sensor_readings", {}):
        print(json.dumps(d, ensure_ascii=False))
    for d in db.find("sensor_readings", {"value": {"$gte": 25}}):
        print(d["_topic"], d["value"], d["unit"])
    for d in db.find("pings", {}):
        print(json.dumps(d))
collections: ['_alerts', '_amqp', '_mqtt', '_schedules', 'pings', 'sensor_readings']
{"value": 27.3, "unit": "C", "_topic": "sensors/greenhouse/temp", "_received_at": 1791754335817, "_id": 1, "_version": 1}
{"value": 71, "unit": "%", "_topic": "sensors/greenhouse/humidity", "_received_at": 1791754335830, "_id": 2, "_version": 1}
{"payload": 18.9, "_topic": "sensors/garage/temp", "_received_at": 1791754335839, "_id": 3, "_version": 1}
--- find value >= 25
sensors/greenhouse/temp 27.3 C
sensors/greenhouse/humidity 71 %
--- pings
{"lat": 41.0151, "lon": 28.9795, "speed": 34, "_topic": "fleet/u42/pos", "_received_at": 1791754335848, "_id": 1, "_version": 1}chat/general はどこにも行きませんでした。18.9 のような裸の数値は payload の下に包まれました。それ以外はすべて普通のドキュメントになっています。インデックスを張ることも、集計することも、ドキュメントエンジン のクエリ言語をすべて使うこともできます。座標を持つ pings コレクションは、そのまま 地理空間クエリ に使えます。
insert はブローカーの QoS ack の 前に 行われるので、確認応答されたパブリッシュはコレクションにも永続的に入っています。ブリッジが設定されていないとき、パブリッシュごとのコストは 1 回のアトミックロード(OnceLock::get)です。
AMQP 0-9-1:MQTT では表現できないもの
ADR-0015 で私は、RabbitMQ スタイルの永続キューを却下したのではなく、先送りにしていました。「永続セッション、inflight ストア、WAL に裏打ちされた再配信がそろえば、永続キューの機能はその上に積む増分であって、独立したエンジンではない」。その後、この疑問がプロトコルの形で戻ってきました。既存の RabbitMQ クライアントは OxiDB と話せるのか?
AMQP は MQTT の拡張ではありません。2 つ目のワイヤプロトコルであり、本当に新しいセマンティクスを 1 つ持っています。競合コンシューマー です。MQTT のサブスクリプションは、すべてのメッセージを一致するすべてのサブスクライバーにコピーします。AMQP のキューは、各メッセージをそのコンシューマーのうちちょうど 1 つ に渡します。これは作業の分配であり、RabbitMQ がプロデューサーとワーカープールの間に置かれる理由です。OxiDB には pub/sub(MQTT、OxiMem)はありましたが、ワークキューはありませんでした。
スコープは意図的に狭く保ち、線引きは誠実に行いました。サポートしているもの:接続ハンドシェイク(PLAIN)、チャネル、ハートビート、デフォルトエクスチェンジ(""、キュー名でルーティング)、direct・fanout・topic エクスチェンジ、Queue.Declare(durable、exclusive、auto-delete、サーバー命名、passive)、Queue.Bind、複数フレームのボディ、Basic.Consume/Deliver/Get/Cancel、Basic.Ack(multiple を含む)、Basic.Nack/Reject、Basic.Qos の prefetch、Basic.Return を伴う mandatory フラグ、そしてパブリッシャー確認。スコープ外:tx クラス、headers エクスチェンジ、エクスチェンジ間バインディング、メッセージごとの TTL と優先度、デッドレター引数、代替エクスチェンジ、AMQP 1.0(まったく別のプロトコル)、ストリーム、そしてあらゆる管理 UI です。
エクスチェンジ:direct、fanout、topic
すべてを 1 つの pika スクリプトで試します。
import pika
conn = pika.BlockingConnection(pika.ConnectionParameters("127.0.0.1", 15805))
ch = conn.channel()

ch.exchange_declare("orders", exchange_type="direct")
for q, key in [("q.paid", "paid"), ("q.refund", "refunded")]:
    ch.queue_declare(q); ch.queue_bind(q, "orders", routing_key=key)
for key, body in [("paid", "order-1001"), ("refunded", "order-0999"),
                  ("paid", "order-1002"), ("cancelled", "order-1003")]:
    ch.basic_publish("orders", key, body)

ch.exchange_declare("cache-bust", exchange_type="fanout")
for q in ("node-a", "node-b", "node-c"):
    ch.queue_declare(q); ch.queue_bind(q, "cache-bust")
ch.basic_publish("cache-bust", "ignored", "invalidate:/products/42")

ch.exchange_declare("logs", exchange_type="topic")
binds = {"all-errors": "*.error", "eu-everything": "eu.#", "eu-west-db": "eu.west.db.*"}
for q, pat in binds.items():
    ch.queue_declare(q); ch.queue_bind(q, "logs", routing_key=pat)
for key in ["api.error", "eu.west.db.error", "eu.west.db.slow", "eu", "us.east.api.info"]:
    ch.basic_publish("logs", key, key)
basic_get でキューを空にしていきます。
server product: OxiDB

== direct exchange
q.paid   -> ['order-1001', 'order-1002']
q.refund -> ['order-0999']

== fanout exchange
node-a -> ['invalidate:/products/42']
node-b -> ['invalidate:/products/42']
node-c -> ['invalidate:/products/42']

== topic exchange
all-errors     *.error        -> ['api.error']
eu-everything  eu.#           -> ['eu.west.db.error', 'eu.west.db.slow', 'eu']
eu-west-db     eu.west.db.*   -> ['eu.west.db.error', 'eu.west.db.slow']
cancelled の注文はどのバインディングにも一致せず、破棄されました(mandatory なしでの通常の AMQP の振る舞いです)。topic エクスチェンジでは、* はちょうど 1 単語に、# は 0 個以上の単語に一致します。eu.# は裸の eu キーも捕まえ、一方 *.error は 4 単語の eu.west.db.error を取りませんでした。
確認、mandatory、nack、そして誠実な拒否
ch.confirm_delivery()
ch.queue_declare("jobs")
ch.basic_publish("", "jobs", "resize:img-1.png")
try:
    ch.basic_publish("", "no-such-queue", "lost?", mandatory=True)
except pika.exceptions.UnroutableError as e:
    ...
m, _, body = ch.basic_get("jobs");  ch.basic_nack(m.delivery_tag, requeue=True)
m, _, body = ch.basic_get("jobs");  ch.basic_ack(m.delivery_tag)
ch.exchange_declare("hdr", exchange_type="headers")
== publisher confirms + mandatory
confirmed: resize:img-1.png
UnroutableError: ['NO_ROUTE'] [312]
== nack with requeue
got resize:img-1.png redelivered = False -> basic_nack(requeue=True)
got resize:img-1.png redelivered = True -> basic_ack
== unsupported exchange type
ChannelClosedByBroker: 540 exchange type 'headers' is outside ADR-0016's scope; supported: direct, fanout, topic最後の行は、この設計で私が一番気に入っている部分です。私が実装していないものを使うクライアントは、黙って受け入れられるのではなく、ADR の名前を挙げたチャネルエラー(540 NOT_IMPLEMENTED)を受け取ります。黙って受け入れられ、何もルーティングしない headers エクスチェンジは、デバッグに何日もかかる類の問題です。
mandatory についての詳細を 1 つ。Basic.Return は確認の 前に 送られます。pika は return を集め、その後 ack を見て UnroutableError を送出します。RabbitMQ も同じことをします。.NET クライアントからは、後ろに ack が続かない Return が次のハートビートまでバッファに居座ってはいけないことを学びました。そのため、今ではすべてのバッチがちょうど 1 回のフラッシュで終わります。
競合コンシューマーと prefetch
これが AMQP を追加した理由となる機能です。2 つのワーカーが同じキューを消費します。速いもの(1 ジョブ 50 ms)と遅いもの(500 ms)です。キューに 12 個のジョブを入れ、まず prefetch なしで、次に basic_qos(prefetch_count=1) で試しました。
def worker(name, cost):
    conn = pika.BlockingConnection(P); ch = conn.channel()
    ch.queue_declare(Q, durable=True)
    if prefetch: ch.basic_qos(prefetch_count=prefetch)
    def on_msg(ch, m, props, body):
        time.sleep(cost)
        log.append((name, body.decode()))
        ch.basic_ack(m.delivery_tag)
    ch.basic_consume(Q, on_msg)
    ...
prefetch=unlimited fast: 6 jobs ['job-02', 'job-04', 'job-06', 'job-08', 'job-10', 'job-12']
prefetch=unlimited slow: 6 jobs ['job-01', 'job-03', 'job-05', 'job-07', 'job-09', 'job-11']
prefetch=1 fast: 10 jobs ['job-01', 'job-03', 'job-04', 'job-05', 'job-06', 'job-07', 'job-08', 'job-09', 'job-10', 'job-12']
prefetch=1 slow: 2 jobs ['job-02', 'job-11']prefetch なしでは純粋なラウンドロビンです。各ジョブは順番に次のコンシューマーへ渡され、遅いワーカーが 6 個のジョブに 3 秒を費やす間、速いワーカーは暇を持て余します。prefetch=1 では、各ワーカーは確認応答されていないメッセージを最大 1 つまでしか持てません。上限に達したコンシューマーは順番を飛ばされ、余裕のあるコンシューマーに回されます。速いワーカーは 10 個、遅いワーカーは 2 個のジョブを受け取りました。これが prefetch の要点です。忙しいワーカーが後ろのキューを止めてはいけないのです。
確認応答されていないメッセージは、チャネルや接続が死ぬと、redelivered=true のフラグ付きでキューの 先頭 に戻ります。ディスク上のレコードは一度も削除されていないので、その間にクラッシュしても何も変わりません。
耐久性はプロトコルに従う:永続キューと kill -9
MQTT に OXIDB_MQTT_PERSIST が必要だったのは、MQTT 3.1.1 にはストレージという概念がワイヤレベルで存在しないからです。AMQP にはあります。クライアントはキューを durable として宣言し、delivery_mode=2(persistent)でパブリッシュします。意図をプロトコルの中で表明するのです。だから OXIDB_AMQP_PERSIST はありません。永続メッセージを持つ永続キューは永続的、それだけです。一時キューはメモリ上に置かれます。クライアントが durable と言わないことで、それを求めたからです。
テスト:永続的な請求書 3 通を永続キュー invoices に、delivery_mode=1 の下書き 1 通も同じキューに、さらにメッセージ 1 通を一時キュー scratch に入れます。すべてパブリッシャー確認付きです。そして _amqp コレクションを見ます。
{"_kind": "queue", "name": "invoices", "_id": 31, "_version": 1}
{"_kind": "qmsg", "queue": "invoices", "seq": 25, "exchange": "", "rkey": "invoices", "props": "kAAKdGV4dC9wbGFpbgI=", "body": "aW52b2ljZS0x", "_id": 32, "_version": 1}
{"_kind": "qmsg", "queue": "invoices", "seq": 26, "exchange": "", "rkey": "invoices", "props": "kAAKdGV4dC9wbGFpbgI=", "body": "aW52b2ljZS0y", "_id": 33, "_version": 1}
{"_kind": "qmsg", "queue": "invoices", "seq": 27, "exchange": "", "rkey": "invoices", "props": "kAAKdGV4dC9wbGFpbgI=", "body": "aW52b2ljZS0z", "_id": 34, "_version": 1}
(コレクションには以前の実験のキューレコードも残っていたので、ここでは invoices の行だけを残しました。)下書きと scratch のメッセージはディスク上にありません。一方は永続メッセージではなく、もう一方はキューが永続ではないからです。ボディとプロパティは base64 エンコードで保存されます。props はコンテンツヘッダーのプロパティ部分をワイヤからそのまま取ったものなので、ブローカーは content_type、相関 ID、アプリケーションヘッダーをどれもモデル化することなく、配信時にそのまま返せます。
続いて kill -9 と再起動です。
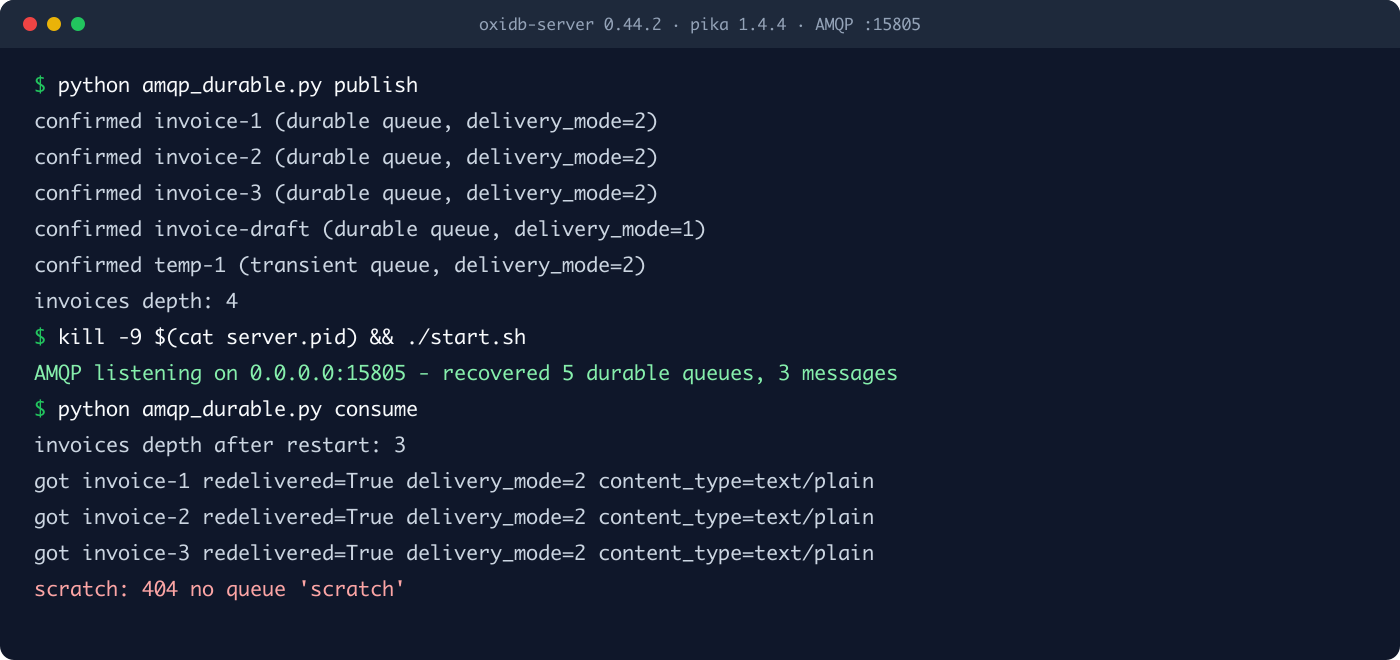
永続メッセージは content_type=text/plain を保ったまま戻ってきて、一時キューは消えています(404)。復元されたメッセージはすべて redelivered=True です。これは意図的に保守的にしています。「このメッセージはクラッシュ前に配信されていたかもしれない」というのがこのフラグが守るために存在する約束であり、正確な配信状態を追跡すると配信のたびにディスク書き込みが必要になるからです。
ここで小さなことにも気づきました。ログには「recovered 5 durable queues」とありますが、異なる永続キューは 3 つしかありませんでした。原因は、Queue.Declare がブローカーのロックを保持せずに「削除してから insert」という形でレコードを書くことです。そのため、3 つの接続が同じ瞬間に同じキューを宣言したとき(prefetch テストの 2 つのワーカーとセットアップ用の接続)、ディスクに 2 つのレコードができてしまいました。復元は entry().or_insert で重複を排除するので振る舞いには影響がなく、起動時のカウンタがレコード数を数えているだけです。次のリリースで直す予定の小さな欠陥です。
MQTT から AMQP へのブリッジ
ADR-0016 の最後のフェーズは、RabbitMQ 自身の MQTT プラグインと同じやり方で、1 つのバイナリの中で 2 つのプロトコルをつなぎます。MQTT のパブリッシュはすべて / を . に変えて amq.topic topic エクスチェンジにルーティングされ、amq.topic への AMQP のパブリッシュはすべて . を / に戻して MQTT 側に出てきます。amq.topic は起動時に事前宣言されているので、バインドするのに exchange_declare は不要です。
シナリオ:ボイラーのセンサーが MQTT で sensors/boiler/temp にパブリッシュします。AMQP ワーカーは、自分の永続キュー temp-alerts をパターン sensors.*.temp で amq.topic にバインドしています。
ch.queue_declare("temp-alerts", durable=True)
ch.queue_bind("temp-alerts", "amq.topic", routing_key="sensors.*.temp")   # amq.topic is pre-declared
ch.basic_qos(prefetch_count=10)
def on_msg(ch, m, props, body):
    print(f"[amqp worker] exchange={m.exchange} routing_key={m.routing_key} "
          f"delivery_mode={props.delivery_mode} body={body.decode()}")
    ch.basic_ack(m.delivery_tag)
ch.basic_consume("temp-alerts", on_msg)
mosquitto_pub -p 15804 -i boiler-probe -q 1 -t sensors/boiler/temp -m '{"value": 91.5, "unit": "C"}' -d
mosquitto_pub -p 15804 -q 1 -t sensors/boiler/pressure -m '{"value": 2.1, "unit": "bar"}'Client boiler-probe sending CONNECT
Client boiler-probe received CONNACK (0)
Client boiler-probe sending PUBLISH (d0, q1, r0, m1, 'sensors/boiler/temp', ... (28 bytes))
Client boiler-probe received PUBACK (Mid: 1, RC:0)[amqp worker] waiting on temp-alerts <- amq.topic 'sensors.*.temp'
[amqp worker] exchange=amq.topic routing_key=sensors.boiler.temp delivery_mode=2 body={"value": 91.5, "unit": "C"}圧力の測定値はパターンに一致しなかったので、ワーカーには届きませんでした。QoS 1 の MQTT パブリッシュは delivery_mode=2 として AMQP に渡ります。耐久性の約束とともに届いたメッセージは、ブリッジを越えてもその約束を保つのです。そして同じパブリッシュが sensors/# のインジェストルートにも一致したので、同時に sensor_readings にも書き込まれました。
{"value": 91.5, "unit": "C", "_topic": "sensors/boiler/temp", "_received_at": 1791754410602, "_id": 4, "_version": 1}1 つの MQTT PUBLISH が、ライブの MQTT サブスクライバーへ、AMQP のワークキューへ、そしてクエリ可能なコレクションへ。そのすべてが PUBACK の前に行われます。
逆方向も動きます。AMQP から amq.topic へキー devices.valve7.cmd でコマンドをパブリッシュすると、devices/+/cmd を購読している mosquitto_sub がそれを受け取りました。
[amqp publisher] confirmed amq.topic devices.valve7.cmd
devices/valve7/cmd {"open": false}
ブリッジにはループ防止があります。MQTT から amq.topic に入ったパブリッシュには bridge: false の印が付けられ、MQTT 側へ転送し返されることはありません。
最後に、ブリッジにとって最も厳しいケースを試しました。ワーカーが止まっている状態でセンサーが QoS 1 の測定値を 2 つパブリッシュし、サーバーが kill -9 で死に、復帰し、その後でようやくワーカーが接続します。
published 2 (worker offline)
AMQP listening on 0.0.0.0:15805 - recovered 6 durable queues, 2 messages
[amqp worker] waiting on temp-alerts <- amq.topic 'sensors.*.temp'
[amqp worker] exchange=amq.topic routing_key=sensors.boiler.temp delivery_mode=2 body={"value": 92.8, "unit": "C"}
[amqp worker] exchange=amq.topic routing_key=sensors.boiler.temp delivery_mode=2 body={"value": 95.1, "unit": "C"}
センサーが受け取った PUBACK は、AMQP キューの中のコピーもディスク上にあることを意味しており、実際にそうでした。amq.topic は永続扱いなので、永続キューからそれへのバインディング(_kind: "bind")もディスクに書かれます。バインディングはメッセージとともに再起動を生き延びました。
内部の仕組み
ストレージ:新しいフォーマットはなく、ただのドキュメント
どちらのブローカーも、状態を 2 つの別々のコレクションに、_kind フィールドで区別されるドキュメントとして保持しています。
| コレクション | _kind | 内容 |
|---|---|---|
_mqtt | sub | クライアント、フィルタ、許可された QoS |
_mqtt | msg | クライアント、seq、トピック、ペイロード、QoS:PUBACK 待ち、またはキューに入ったメッセージ |
_mqtt | retain | トピックごとの最後の retained 値(空のペイロードで消去) |
_mqtt | rel, rx2 | QoS 2 の 2 つの半分:PUBREL の義務と受信側の重複排除 ID |
_amqp | exchange, queue, bind | 永続トポロジー |
_amqp | qmsg | キュー、seq、エクスチェンジ、ルーティングキー、base64 の props と body |
ADR-0015 に書いたとおり、理由は、テストすべき 2 つ目の耐久性パスを作りたくなかったからです。ドキュメントエンジンのコレクションと WAL の仕組みは、クラッシュリカバリ、チェックポイント、PITR をすでに解決しており、ブローカーはそのすべてを無料で手に入れます。サーバーは「strict ACID-D」モードで起動し、すべてのコミットが fsync されます。コレクションを分けているのは、どちらのブローカーも相手の復元を壊せないようにするためです。
復元は起動時、リスナーが最初の接続を受け付ける前に実行されます。_kind ごとの find クエリを投げ、メッセージは seq でソートして再びキューに入れ、シーケンスカウンタは見つかった最大の seq の 1 つ先から再開します。
トピックのマッチング:2 つのプロトコル、2 つのルール
MQTT と AMQP のワイルドカードは似ていますが同じではなく、コードには 2 つの別々のマッチャーがあります。
- MQTT(
/区切りのレベル):+はちょうど 1 レベルです。#は最後のレベルとしてのみ有効で、「残り全部(何もない場合も含む)」を意味します。ブローカーは各サブスクリプションフィルタを一度だけ、アンカー付き(^...$)の正規表現にコンパイルします。+は[^/]+に、末尾の/#は(/.*)?になります(だからsensors/#は単なるsensorsにも一致します)。ワイルドカードのないフィルタはregex::escapeによる完全一致になります。インジェストブリッジは同じルールを正規表現なしで、レベルのスライスに対する小さな再帰関数で適用しています。 - AMQP(
.区切りの単語):*はちょうど 1 単語、#は 0 個以上の単語で、パターンのどこにでも現れることができます。topic_matchesは#を 2 分岐の再帰で扱います。#を消費するか、キーの単語を 1 つ飲み込んで#にとどまるかです。
ブリッジは区切り文字(/ と .)だけを入れ替えることで 2 つの世界をつなぎます。RabbitMQ の MQTT プラグインとまったく同じです。AMQP のバインディングは自分のルールでパターン(sensors.*.temp)を使い、MQTT のフィルタは自分のルールを使います。
1 つのエクスチェンジ上の複数のバインディングが同じキューに一致した場合でも、キューが受け取るコピーは 1 つ です。ターゲットのリストはソートされ、重複が排除されます(RabbitMQ のセマンティクス)。
AMQP のキュー:共有オブジェクト
MQTT では、永続的な状態はクライアント(セッション)のものです。AMQP では、キューはコンシューマーのリストとラウンドロビンのポインタを持つ共有オブジェクトです。各接続は自分のスレッドで動き、ブローカーに「私に渡すべき配信はどれか?」と尋ねます(poll)。準備のできた各メッセージは順番に次のコンシューマーへ行きます。その順番が別の接続のものであれば、メッセージはその接続自身の巡回を待ちます。これによって、一番速く poll するものが全部を持っていくのではなく、コンシューマーが本当に競合するようになります。prefetch の上限に達したコンシューマーは飛ばされます。
この設計の最初のバージョンでは、50 ms の poll 周期のせいでエンドツーエンドのレイテンシが 51 ms ありました。プロジェクトのメモによると、適応的な 1 ms 周期で 1.15 ms に下がり、その後スレッド間ウェイクアップで 0.02 ms になりました。消費を行う各接続はノンブロッキングのパイプを持っており、その読み出し側は TCP ソケットと並んで自分の poll(2) の集合に入っています。キューにメッセージが入ると、パブリッシャーはそのキューの各コンシューマーのパイプに 1 バイトを書き込み、コンシューマーのカーネル待ちは即座に終わります。(Unix のみ。他のプラットフォームでは適応的な周期のままです。)
グループコミット:メッセージごとに 1 回の fsync ではない
永続パブリッシュの最初のバージョンは、メッセージごとに 1 回 fsync していました。プロジェクトの測定では、1 本の接続で毎秒 264 メッセージでした。2 つの層がこれを変えました。
- 接続ごとのバッチ化。 接続は、パイプラインのバーストに含まれるパブリッシュを
prepare_publishでルーティングして集め(最大 256 個、またはソケットバッファが空になるまで)、それらすべてを 1 回のinsert_manyで書き込み、パブリッシュ順に確認を送ります。この順序が重要です。ディスク書き込みが 先 です。ack がエンキューと競合し、まだ書かれていないレコードを削除してしまうと、クラッシュ後に消費済みのメッセージが復活します。古いメッセージごとのパスは、まさにそのウィンドウを間違えていました。 - 接続をまたぐグループコミット。 ディスク上にコミットがなければ、到着した接続がリーダーになり、保留中のものをすべて、ラウンドを重ねて書き込みます。リーダーがディスクにいる間に到着した接続は次のラウンドを共有し、
Condvarで自分の世代を待ちます。バッチのウィンドウは fsync 自体の所要時間なので、単独のパブリッシャーは即座に自分のラウンドを率い、この仕組みのために何も払いません。
上限
どちらのブローカーも同じ規律に従っています。遅い、あるいは死んだコンシューマーがブローカーのメモリを使い果たしてはならず、損失は決して黙って起きてはなりません。MQTT のセッションキューの上限は 4096 メッセージ、AMQP の ready キューは 100,000 です。どちらでも最も古いものが捨てられ、カウンタが増え、捨てられたメッセージのディスク上のレコードも削除されます。最後の部分が重要です。上限がディスクに適用されなければ、死んだコンシューマーがコレクションを永遠に膨らませ、再起動すると上限がすでに捨てたメッセージが復活してしまいます。私はこれをまず MQTT 側で学び、AMQP では最初から正しく実装しました。
プロジェクトのベンチマーク:RabbitMQ との比較
リポジトリには、同じ Go クライアント(rabbitmq/amqp091-go)と同じシナリオで OxiDB と RabbitMQ を動かすベンチマークがあります。これらの数字はこの記事のために私が測ったものではなく、プロジェクト自身の 2026-07-17 時点の測定です。arm64 の MacBook で、OxiDB 0.36.12 対 RabbitMQ 4.x(brew)、ボディは 100 バイトです。
| シナリオ | OxiDB | RabbitMQ | 比率 |
|---|---|---|---|
| パブリッシュ確認、パイプライン | 246,295 msg/s | 164,224 msg/s | 1.50x |
| パブリッシュ確認、逐次(p50/p99) | 0.02/0.03 ms | 0.03/0.06 ms | 1.74x |
| 永続パブリッシュ、パイプライン | 53,724 msg/s | 159,614 msg/s | 0.34x |
| 永続パブリッシュ、8 接続 | 103,307 msg/s | 93,172 msg/s | 1.11x |
| エンドツーエンドのスループット | 318,330 msg/s | 246,076 msg/s | 1.29x |
| エンドツーエンドのレイテンシ(p50/p99) | 0.02/0.05 ms | 0.04/0.06 ms | 1.52x |
負けている 1 行は誠実な負けです。OxiDB の永続的な確認はすべて、それが属するバッチの本物の F_FULLFSYNC の後ろに控えています。プロジェクトのメモによると、RabbitMQ のクラシックキューは一定間隔で遅延フラッシュするので、その永続的な確認だけでは、メッセージが安定ストレージ上にあることの証明にはなりません。8 接続ではグループコミットが効き、結果は逆転します。
制限と誠実なトレードオフ
- ノードローカル。 MQTT セッションと AMQP キューは、接続が存在する 1 つのノード上にあります。フェイルオーバー後に別のノードへ再接続したクライアントは、セッションを再開しません。これは偶然ではありません。ノードをまたぐキューとは、両方の ADR が退けている共有ログ(Kafka)の設計そのものです。キューの背後にある永続データ(コレクション、時系列)は、すでに各エンジンによってレプリケートされています。
- MQTT 5 ではなく MQTT 3.1.1。 共有サブスクリプション、メッセージの有効期限、理由コードはありません。競合コンシューマーが欲しいなら、答えは AMQP のキューです。
- AMQP のサブセット。 上に挙げたスコープ外のリストは確定です。
tx、headers エクスチェンジ、TTL、優先度、デッドレター、AMQP 1.0、管理 UI はありません。それらを使うクライアントは明示的なエラーを受け取ります。 - 上限付きキューは最も古いものを捨てる。 テレメトリには正しく、決済のキューには議論の余地があります。上限に近づいているキューはアラートの対象にすべきです。
- 保守的な再配信。 クラッシュ後に復元された AMQP メッセージはすべて
redelivered=trueで届きます。コンシューマーはいずれにせよ冪等であるべきです。AMQP の at-least-once はそれを意味しています。 - fsync のコストは本物。 私の単一パブリッシャー、逐次、永続の実行では、差はおよそ 70 倍でした。耐久性を必要としないテレメトリには、QoS 0 やクリーンセッションが依然として最も安い道です。
- シンプルな認証。 MQTT のユーザー名/パスワードと AMQP の PLAIN です。未設定の場合、リスナーは認証なしで
0.0.0.0にバインドされます。
OxiDB の他の部分との関係
メッセージングレイヤーはそれ単体の製品ではなく、OxiDB の玄関口です。MQTT のパブリッシュは、メモリ上のバスを通して OxiMem の Redis 互換 SUBSCRIBE クライアントにも届きます(逆方向も同様です)。インジェストブリッジは測定値を ドキュメントエンジン に書き込み、そこでは SQL エンジン からクエリでき、長期間保持するメトリクスはそこから 時系列エンジン へ移せます。AMQP のワーカープールは、MQTT で届いた作業を消費し、結果を OxiDB に書き戻せます。ログとアラートについては、このシリーズの別の記事で扱います:ログとアラート。
私にとって、このレイヤーの本当の教訓は、ブローカーの最も重要な性質は速さではなく、ワイヤ上の約束と振る舞いが同じものであることだ、という点でした。OxiDB では今や PUBACK は「ディスク上にある」を意味し、私はそれを毎回 kill -9 で証明しています。
試してみる
ビルド済みのバイナリと Docker イメージは GitHub releases ページにあります。2 つの環境変数で MQTT と AMQP が有効になります。
OXIDB_MQTT_PORT=1883 OXIDB_AMQP_PORT=5672 OXIDB_MQTT_PERSIST=1 oxidb-serverあとは、すでに持っているツールを使ってください。mosquitto_pub、paho-mqtt、pika、amqp091-go、RabbitMQ.Client。どれも OxiDB のために変更されたものはありません。シリーズの次の記事は ログとアラートのエンジン です。