OxiMem の HyperLogLog: Redis と同じ推定値、和集合は 3 倍高速
OxiDB のインメモリエンジン OxiMem が PFADD、PFCOUNT、PFMERGE に対応しました。HyperLogLog の仕組みの詳しい解説、OxiMem の ASCII エンコーディングとそのコスト、高速化の内容、Redis 8.6.1 との比較計測: 推定値は完全に一致し、複数キーのカウントは 3 から 5 倍高速、単一キーの処理では Redis と同等かそれ以上です。
OxiDB のインメモリエンジンである OxiMem は Redis プロトコルを話します。今日からは Redis の HyperLogLog コマンド PFADD、PFCOUNT、PFMERGE にも対応しました。計算は Redis とまったく同じなので、同じ要素に対しては Redis と同じ数を返します。一方でエンコーディングは異なり、それには代償があります。この記事では、HyperLogLog の仕組み、OxiMem での実装、そして Redis 8.6 と並べて測定した結果を説明します。OxiDB はオープンソースで、コードは GitHub にあります:github.com/parisxmas/OxiDB。
問題:異なるものはいくつあるか
このブログのサイドにある「読者」の数は、サイトを読んだ異なる人の数を示しています。素直な方法はセットを使うことです。読者を一人ずつ追加し、セットのサイズを問い合わせます。このサイトも最初はこの方法で数えていました。各読者を 16 文字のダイジェストとして保存し、読者 10 万人で数メガバイトになります。
セットは正確に数えますが、見たものをすべて保持し、それに合わせて大きくなります。広告ネットワークの日次ユニークユーザー、API にアクセスする異なる IP、検索エンジンの異なるクエリは、数百万、数十億の規模に達します。そこですべての項目を保持するのは高コストです。そして多くの場合、正確な数は必要ありません。「約 320 万」で十分です。
HyperLogLog はまさにこのために存在します。見てきた異なる項目の数を、項目そのものを保持せずに、固定のメモリで、小さな誤差で推定します。Redis の実装は 12 KB を使い、標準誤差は 0.81% です。
HyperLogLog の仕組み
コイン投げの直感
友人がコインを投げ、ひとつのことだけを教えてくれるとします。裏が連続して出た最長の回数です。答えが「せいぜい 2 回」なら、おそらく数回しか投げていません。「20 回連続」なら、それは 1,000,000 回に 1 回の出来事なので、相当な回数を投げたはずです。
ハッシュ関数はコイン投げのように振る舞います。良いハッシュのビットはランダムに見え、ハッシュの末尾にちょうど k 個のゼロビットが現れるのは 2^(k+1) 回に 1 回です。したがって、見てきたハッシュの中でゼロの最長連続が長いほど、多くの異なる項目を見てきたことになります。同じ項目は常に同じハッシュを生むので、重複は数を変えません。「異なる」という性質はここから来ています。
1 回の測定では足りない:バケット
最長連続ひとつだけではノイズが非常に大きくなります。運の良いハッシュがひとつあるだけで推定値が倍になってしまいます。そこで HyperLogLog はハッシュをバケット(レジスタ)に振り分け、それぞれで別々に最長連続を保持します。
hash = MurmurHash64A(element)                      64 bits

  ┌──────────── 50 bits ───────────┬── 14 bits ─┐
  │  the rest                      │  register  │
  └────────────────────────────────┴────────────┘
                                         │
         trailing zero count + 1 ────────┼──► rank
                                         ▼
               register[r] = max(register[r], rank)
Redis と OxiMem は 2^14 = 16,384 個のレジスタを使います。ハッシュの下位 14 ビットでレジスタを選びます。残りの 50 ビットの末尾のゼロの数に 1 を足したものが、その要素の「ランク」です。位置 50 にある番兵ビットにより、ランクの上限は 51 になります。レジスタが保持しているランクのほうが小さければ、レジスタを更新します。
要素の追加はこれだけです。ハッシュが 1 回、マスクが 1 回、ゼロのカウントが 1 回、書き込みは最大 1 回です。
推定
各レジスタのランクは、そこに入った要素数のおおよその対数です。数に戻すには、これらの推測値を平均します。ただし算術平均ではなく調和平均を使い、運の良いレジスタひとつが結果全体を歪めるのを防ぎます。2007 年の元論文の式は次のとおりです。
E = α · m² / Σ 2^(−register[j])m はレジスタの数、α は補正定数です。この式は非常に小さい数と非常に大きい数でずれるため、元のアルゴリズムは小さい数では「空のレジスタを数える」方法に切り替え、その中間では経験的なバイアス表を使います。
Redis は 4.0 以降、Otmar Ertl による 2017 年の改良版推定量を使っており、OxiMem も同じです。これはレジスタそのものではなく、ランクのヒストグラム、つまり各ランクを保持するレジスタがいくつあるかを見ます。2 つの級数(コード中の sigma と tau)が両端を正しく扱います。結果はひとつの式になります。バイアス表も切り替えもなく、ゼロから数十億まで同じ計算です。
誤差はレジスタの数で決まります。標準誤差は 1.04 / √m で、16,384 個のレジスタでは 0.81% です。異なる項目が 10,000 個なら、答えはほとんどの場合 9,920 から 10,080 の間に収まります。
マージ
HyperLogLog の最も優れた性質は、マージできることです。2 つのカウンタの和集合は、レジスタごとに比較して大きいほうを残すだけで求められます:register[j] = max(a[j], b[j])。結果は、和集合を最初から数えた場合と同じです。この方法で、日次カウンタから週次ユニークユーザーが、サーバーごとのカウンタから合計が得られます。PFMERGE と複数キーの PFCOUNT はまさにこれを行います。
OxiMem での実装
コードは oxidb-server/src/hll.rs にあり、2 つのコミットで入りました。まずコマンド(c4502f2b)、次に高速化(0cd23297)です。
同じ計算、同じ数
目標は同じ要素に対して Redis と同じ数を返すことだったので、細部まですべて Redis に合わせています。
- Redis のシード(
0xadc83b19)を使った MurmurHash64A で、どのホストでもリトルエンディアンで読みます。その出力は C のリファレンス実装から生成したテストベクタで固定しています。 - 2^14 個のレジスタ。レジスタは下位 14 ビットで、ランクは残りの末尾のゼロの数に 1 を足したものです。
- Ertl の推定量を、Redis と同じ方法で丸めます。
両方に同じ user:0、user:1 ... という要素を追加して、自分で測定しました。
| 真の数 | Redis 8.6.1 | OxiMem 0.45.1 | 誤差 | 一致 |
|---|---|---|---|---|
| 10 | 10 | 10 | 0.00% | はい |
| 100 | 100 | 100 | 0.00% | はい |
| 1,000 | 1,007 | 1,007 | +0.70% | はい |
| 10,000 | 10,089 | 10,089 | +0.89% | はい |
| 100,000 | 99,471 | 99,471 | -0.53% | はい |
| 1,000,000 | 999,674 | 999,674 | -0.03% | はい |
| 3 キーの和集合(450,000) | 447,209 | 447,209 | -0.62% | はい |
どの行でも両サーバーは同じ数を返し、誤差は標準誤差 0.81% 前後に収まっています。
異なるエンコーディング:ASCII
Redis は HyperLogLog をバイナリの blob として保存します。dense 形式では 16,384 個のレジスタがそれぞれ 6 ビットを使い、合計 12 KB です。OxiMem ではこれができません。OxiMem の値は Rust の String なので有効な UTF-8 でなければならず、JSON スナップショットやオプションの SQL ミラーにテキストとして書き出されます。任意のバイト列からなる blob は、そのすべてを壊してしまいます。
そこで 2 つの ASCII エンコーディングを用意しました。
- Sparse(
HYLLs): ゼロでないレジスタだけを、インデックス順に並べます。各レジスタはindex << 6 | rankの 20 ビットで、base64url の 4 文字として書かれます。空の HyperLogLog は 5 バイトのヘッダーだけです。 - Dense(
HYLLd): レジスタごとに 1 文字、'0' + rankで、合計 16,389 バイトです。
Sparse は 750 個のレジスタ(3,000 バイト、Redis の hll-sparse-max-bytes のデフォルト値)を超えると dense に変わります。値は普通の文字列です。TYPE は「string」と答え、GET、SET、RENAME、COPY とスナップショットは他の文字列と同じようにこれを扱い、TTL は PFADD の後も残ります。HyperLogLog でない文字列に対する PFADD は、Redis と同様に WRONGTYPE を返し、値には手を触れません。壊れた値をマージするとカウントが壊れてしまうため、順序の乱れたインデックス、範囲外のランク、誤った長さは拒否します。
コストも測定しました。同じキーのサイズ(バイト)です。
| 要素数 | Redis | OxiMem |
|---|---|---|
| 10 | 46 | 45 |
| 100 | 283 | 405 |
| 200 | 506 | 797 |
| 1,000 | 1,910 | 16,389 |
| 10,000 以上 | 12,304 | 16,389 |
小さなキーではほとんど差がありません。1,000 要素あたりで OxiMem は Redis より先に dense になります。OxiMem の sparse 形式はレジスタごとに 4 バイトを使うのに対し、Redis の形式は空のレジスタの連続をひとつのオペコードで飛ばすからです。満杯のキーは Redis で 12 KB、OxiMem で 16 KB なので、dense の OxiMem は約 33% 多くメモリを使います。テキストではこれ以上詰められません。レジスタの 6 ビットはちょうど base64 の 1 文字なので、最良でもレジスタごとに 1 文字です。この差が縮まるのは、OxiMem がバイナリの値型を持った場合だけです。ただし、測定結果が示すように、大きなレイアウトには見返りもあります。
高速化
最初のバージョンは正しく動きましたが、Redis より遅いものでした。コミットメッセージによると、PFMERGE は Redis の約 4 分の 1 の速度でした。2 つ目のコミットでこれを改善しました。
- エンコーディングから直接数える: 推定量に必要なのはランクのヒストグラムだけなので、単一キーの
PFCOUNTは 16 KB のレジスタ配列を作らなくなり、エンコーディングから直接ヒストグラムを読み取ります。sparse のキーではエントリ分のコストしかかかりません。 - ひとつの配列に畳み込む:
PFMERGEと複数キーのPFCOUNTは、各ソースをそれぞれの配列にデコードしてから後でマージするのではなく、すべてのソースをひとつのレジスタ配列に畳み込みます(merge_into)。 - 分岐のないループ: バイトごとの早期終了チェックが dense ループのベクトル化を妨げており、ソースあたり約 6 µs かかっていました。現在はチェック結果をフラグに書き、パスの後でそのフラグを確認します。壊れたバイトが引き続き拒否されることはテストで固定しています。
- バイト列で組み立てる: dense エンコーディングを 1 文字ずつではなくバイトベクタとして組み立てることで、10 µs から 2.5 µs になりました。
- 4 つのサブヒストグラム: ほとんどのレジスタは 1 つか 2 つのランク値に集中しているため、ヒストグラムがひとつだと同じカウンタを増やし続けることになり、各インクリメントが直前のものを待ちます。4 つのヒストグラムに順番に書き込み、最後に合計することで、dense のカウントは 9.8 µs から 6.8 µs になりました。
Redis との比較測定
訂正(2026 年 11 月 3 日): このセクションの最初の版の数値は、Redis を
--daemonizeで起動した実行から得たものでした。macOS はデーモン化したプロセスを低い優先度で実行するため、Redis は実際より遅く、OxiMem は実際より良く見えていました。両サーバーを同じ方法で起動して測定をやり直しました。以下の数値は訂正後のものです。
環境:
- Apple M4(10 コア)、macOS 26.3。
- Redis 8.6.1 と oxidb-server 0.45.1(
master、0cd23297)を同じマシンで実行。どちらも同じシェルから同じ方法(フォアグラウンド、nohup下)で起動し、永続化はオフ。 redis-benchmarkで 5 つのシナリオを、それぞれ 5 ラウンド、Redis と OxiMem を交互に実行。表は中央値です。ラウンド間の差はほとんどが 5% 未満です。- dense のキーは 100 万個、sparse のキーは 200 個の要素を保持。和集合と
PFMERGEは重なりのある 3 つの dense キーを使います。
50 クライアント、パイプラインなし
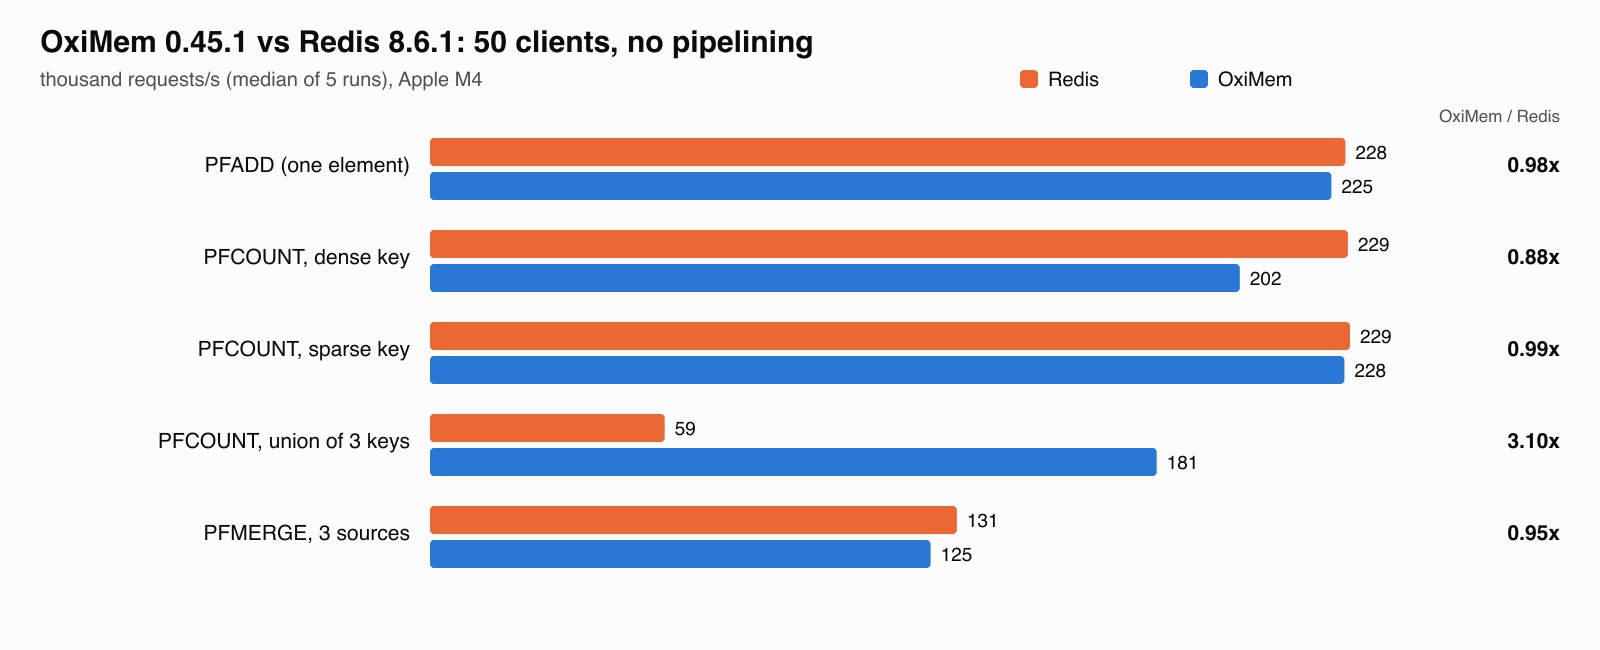
| シナリオ | Redis(req/s) | OxiMem(req/s) | OxiMem / Redis | p50 Redis / OxiMem(ms) | p99 Redis / OxiMem(ms) |
|---|---|---|---|---|---|
PFADD 1 要素 | 228,206 | 224,719 | 0.98 | 0.119 / 0.119 | 0.143 / 0.159 |
PFCOUNT dense キー | 228,833 | 201,884 | 0.88 | 0.119 / 0.143 | 0.143 / 0.191 |
PFCOUNT sparse キー | 229,358 | 227,964 | 0.99 | 0.119 / 0.119 | 0.135 / 0.159 |
PFCOUNT 3 キーの和集合 | 58,502 | 181,159 | 3.10 | 0.807 / 0.159 | 0.911 / 0.263 |
PFMERGE 3 ソース | 131,349 | 124,792 | 0.95 | 0.335 / 0.383 | 0.431 / 1.959 |
このラウンドでは、単一キーのコマンドは両者とも 230,000 リクエスト/秒付近に集まっています。これは主にこのマシンでのシングルスレッドの redis-benchmark の上限であり、サーバーの上限ではありません。PFADD と sparse キーの PFCOUNT は互角です。OxiMem は dense キーのカウントで 12%、PFMERGE で 5% 遅れています。
本当の差は和集合に現れ、OxiMem が 3.1 倍高速です。どちらもソースをひとつのレジスタ配列に畳み込みますが、Redis の dense エンコーディングはレジスタを 6 ビットに詰めているため、マージ時にはビットシフトでひとつずつ取り出す必要があります。OxiMem ではレジスタがそれぞれ 1 バイトなので、同じループが分岐なしでベクトル化されます。メモリで払った 33% が返ってくるのはここです。
50 クライアント、パイプライン 16、4 スレッド
パイプラインでは、各クライアントが応答を待たずに 16 個のコマンドを送るため、ボトルネックがクライアントからサーバーに移ります。本当の差が現れるのはここです。
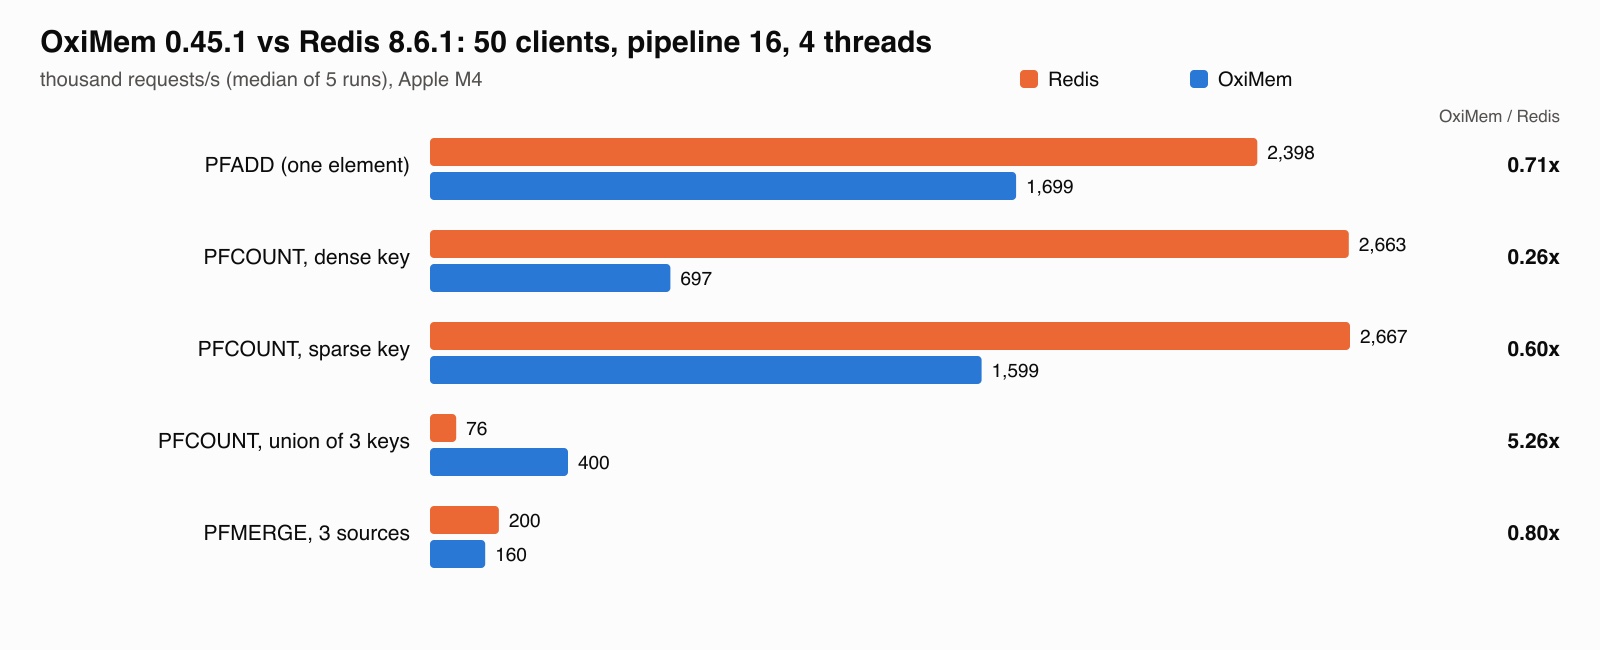
| シナリオ | Redis(req/s) | OxiMem(req/s) | OxiMem / Redis | p50 Redis / OxiMem(ms) | p99 Redis / OxiMem(ms) |
|---|---|---|---|---|---|
PFADD 1 要素 | 2,398,082 | 1,698,754 | 0.71 | 0.295 / 0.167 | 0.407 / 3.655 |
PFCOUNT dense キー | 2,663,116 | 696,864 | 0.26 | 0.263 / 0.271 | 0.383 / 3.983 |
PFCOUNT sparse キー | 2,666,667 | 1,598,721 | 0.60 | 0.263 / 0.167 | 0.375 / 1.727 |
PFCOUNT 3 キーの和集合 | 76,060 | 400,000 | 5.26 | 10.239 / 1.303 | 10.479 / 5.791 |
PFMERGE 3 ソース | 199,800 | 159,936 | 0.80 | 3.847 / 3.191 | 4.063 / 24.415 |
目立つ点が 4 つあります。
- OxiMem には上限があります。 軽いコマンド(
PFADD、sparse のPFCOUNT)では、Redis が毎秒 240 万から 270 万リクエストに達するのに対し、OxiMem は毎秒 160 万から 170 万リクエストで頭打ちになります。コマンドによらず同じところで止まることから、この差は HyperLogLog のコードではなく、OxiMem のリクエストごとのオーバーヘッド(プロトコルとコマンドのディスパッチ)から来ていると考えられます。これはまだ調べていません。 - 和集合の差は 5.3 倍に広がります。 サーバーが完全に負荷を受けている状態では、6 ビットのレジスタをひとつずつ展開するコストがより目に見えて効いてきます。
- 単一の dense キーのカウントは Redis が 3.8 倍高速です。 上に挙げた上限に加えて、2 つ目の理由があります。Redis は最後の推定値をキーのヘッダー内の 8 バイトのキャッシュに保持し、キーが変わるまで再計算しません。このテストではキーが一度も変わらないので、Redis は毎回キャッシュから答えますが、OxiMem は毎回 16,384 個のレジスタのヒストグラムを作り直します(約 6.8 µs)。sparse のキーではこの作業はごくわずかなので、そこに残るのは上限による差だけです。解決策は明らかで、値のヘッダーにキャッシュ用のフィールドを設けることです。これが次のステップです。
- OxiMem のテールレイテンシは高めです。 中央値のレイテンシはほとんどのシナリオで Redis と同等かそれより低いのですが、パイプライン下では p99 が 1.7 から 24 ms に上がり、Redis は 0.4 から 10.5 ms にとどまります。この原因もまだ調べていません。
まとめると、単一キーの処理では OxiMem は今のところ Redis と同等かやや遅く、負荷が高いと明らかに遅れます。複数キーのカウントでは 3 から 5 倍速くなります。
使い方
コマンドは Redis と同じで、redis-cli や任意の Redis クライアントで使えます。
$ redis-cli -p 6380 PFADD readers:2026-11-03 ip:203.0.113.7 ip:198.51.100.9
(integer) 1
$ redis-cli -p 6380 PFADD readers:2026-11-04 ip:203.0.113.7 ip:192.0.2.44
(integer) 1
$ redis-cli -p 6380 PFCOUNT readers:2026-11-03 readers:2026-11-04
(integer) 3
$ redis-cli -p 6380 PFMERGE readers:week readers:2026-11-03 readers:2026-11-04
OK
$ redis-cli -p 6380 TYPE readers:week
string
このブログの読者数も今はこの方法で数えています。各読者の IP アドレスをソルト付きでハッシュしたダイジェストをひとつの PFADD キーに追加し、数は PFCOUNT で読みます。読者ごとのデータは何も保存されず、キーは読者が何人でも最大 16 KB です。その代わり、数は正確な値ではなく誤差 0.81% の推定値になります。
コメント
最初のコメントを書いてみませんか。
コメントするには Google アカウントでログインしてください。お名前とコメントは公開されます。メールアドレスと IP アドレスは不正利用対策のため記録されますが、表示されません。