OxiMem'e HyperLogLog: Redis ile birebir aynı sayılar, birleşimlerde 3 kat hız
OxiDB'nin bellek içi motoru OxiMem artık PFADD, PFCOUNT ve PFMERGE biliyor. HyperLogLog'un nasıl çalıştığı ayrıntısıyla, OxiMem'deki ASCII kodlama ve bedeli, hızlandırmalar ve Redis 8.6.1 ile yan yana ölçümler: aynı tahminler, çok anahtarlı sayımda 3 ile 5 kat hız, tek anahtarlı işlerde ise Redis başa baş ya da önde.
OxiDB'nin bellek içi motoru OxiMem, Redis protokolünü konuşuyor. Bugünden itibaren Redis'in HyperLogLog komutlarını da biliyor: PFADD, PFCOUNT ve PFMERGE. Matematik Redis'inkiyle birebir aynı, bu yüzden aynı elemanlar için Redis'le aynı sayıyı veriyor. Kodlama ise farklı ve bunun bir bedeli var. Bu yazı HyperLogLog'un nasıl çalıştığını, OxiMem'de nasıl yazıldığını ve Redis 8.6 ile yan yana ölçümleri anlatıyor. OxiDB açık kaynak, kodu GitHub'da: github.com/parisxmas/OxiDB.
Sorun: kaç farklı?
Bu blogun kenarındaki "tekil okur" sayısı, kaç farklı kişinin siteyi okuduğunu gösteriyor. Bunu yapmanın açık yolu bir küme tutmak: her okuru ekle, kümenin boyunu sor. Site de ilk başta böyle sayıyordu: her okur için 16 karakterlik bir özet tutuluyordu, 100 bin okurda bu birkaç megabayt eder.
Küme doğru sayar, ama gördüğü her şeyi saklar ve büyüdükçe büyür. Bir reklam ağının günlük tekil kullanıcısı, bir API'nin farklı IP'leri ya da bir arama motorunun farklı sorguları milyonlar, milyarlar mertebesinde. Orada her öğeyi saklamak pahalı. Üstelik çoğu zaman tam sayı gerekmiyor: "yaklaşık 3,2 milyon" yeterli.
HyperLogLog tam bunun için var. Kaç farklı öğe gördüğünü, öğeleri saklamadan, sabit bir bellekle ve küçük bir hatayla tahmin ediyor. Redis'teki hâli 12 KB yer kaplıyor ve standart hatası %0,81.
HyperLogLog nasıl çalışıyor
Yazı tura sezgisi
Bir arkadaşın yazı tura atıyor ve sana yalnızca bir şey söylüyor: arka arkaya en fazla kaç kez yazı geldiğini. "En fazla 2 kez" dediyse muhtemelen birkaç kez atmıştır. "En fazla 20 kez" dediyse, bu yaklaşık milyonda bir olan bir şey, demek ki çok kez atmıştır.
Hash fonksiyonları da yazı tura gibi davranır. İyi bir hash'in bitleri rastgele görünür. Bir hash'in sonunda tam k tane sıfır bit görmek 2^(k+1)'de bir olur. Yani gördüğün hash'ler arasında en uzun sıfır dizisi ne kadar uzunsa, o kadar çok farklı öğe görmüşsündür. Aynı öğe aynı hash'i verdiği için tekrarlar sayıyı değiştirmez. "Farklı" kelimesi buradan geliyor.
Tek ölçüm yetmez: kovalar
Tek bir en uzun dizi çok gürültülü. Bir kez şanslı bir hash gelse tahmin iki katına çıkar. HyperLogLog bu yüzden hash'leri kovalara (register) bölüyor ve her kovada ayrı bir en uzun dizi tutuyor:
hash = MurmurHash64A(eleman)                       64 bit

  ┌──────────── 50 bit ────────────┬── 14 bit ──┐
  │  geri kalan                    │   kova no  │
  └────────────────────────────────┴────────────┘
                                         │
         sondaki sıfırların sayısı + 1 ──┼──► rank
                                         ▼
               register[kova] = max(register[kova], rank)
Redis ve OxiMem 2^14 = 16.384 kova kullanıyor. Hash'in alttaki 14 biti kovayı seçiyor. Geri kalan 50 bitin sonundaki sıfırların sayısının bir fazlası o elemanın "rank"ı oluyor. 50. bite bir koruyucu bit konduğu için rank en fazla 51. Kova o rank'tan küçükse güncelleniyor.
Bir elemanı eklemek bu kadar: bir hash, bir maskeleme, bir sıfır sayımı ve en fazla bir yazma.
Tahmin
Her kovanın rank'ı, o kovaya düşen eleman sayısının logaritmasının kabaca bir tahmini. Sayıya dönmek için bu tahminlerin ortalaması alınıyor. Aritmetik ortalama değil, harmonik ortalama alınıyor, çünkü harmonik ortalama tek bir şanslı kovanın tüm sonucu bozmasını engelliyor. Orijinal 2007 makalesindeki formül şöyle:
E = α · m² / Σ 2^(−register[j])Burada m kova sayısı, α da bir düzeltme sabiti. Bu formül çok küçük ve çok büyük sayılarda sapıyor, bu yüzden orijinal algoritma küçük sayılar için "boş kovaları say" yöntemine geçiyor, ara bölge için de deneysel düzeltme tabloları kullanıyor.
Redis 4.0'dan beri Otmar Ertl'in 2017'deki geliştirilmiş tahmincisini kullanıyor, OxiMem de onu kullanıyor. Bu tahminci kovaların kendisine değil, rank histogramına bakıyor, yani her rank değerinden kaç kova olduğuna. Uçlar için de sınırları doğru ele alan iki seri kullanıyor (kodda sigma ve tau). Sonuç tek bir formül: düzeltme tablosu yok, yöntem değiştirme yok, sıfırdan milyarlara kadar aynı hesap.
Hata, kova sayısından geliyor: standart hata 1,04 / √m. 16.384 kovada bu %0,81 ediyor. 10.000 farklı öğe için sonuç çoğunlukla 9.920 ile 10.080 arasında çıkar.
Birleştirme
HyperLogLog'un en güzel özelliği birleştirilebilmesi. İki sayacın birleşimi, kovaları tek tek karşılaştırıp büyüğünü almakla bulunuyor: register[j] = max(a[j], b[j]). Sonuç, iki kümenin birleşimini baştan saymışsın gibi aynı. Günlük sayaçlardan haftalık tekil kullanıcıyı ya da sunucu başına sayaçlardan toplamı bu yolla bulabilirsin. PFMERGE ve çok anahtarlı PFCOUNT bunu yapıyor.
OxiMem'deki gerçekleme
Kod oxidb-server/src/hll.rs dosyasında, iki commit'te geldi: önce komutlar (c4502f2b), sonra hızlandırmalar (0cd23297).
Aynı matematik, aynı sayılar
Hedef, Redis'le aynı elemanlara aynı sayıyı vermekti. Bunun için her ayrıntı Redis'inkiyle aynı:
- MurmurHash64A, Redis'in tohum değeriyle (
0xadc83b19). Her makinede little-endian okunuyor. Doğruluğu C referansından üretilmiş test vektörleriyle sabitlendi. - 2^14 kova. Kova numarası alttaki 14 bit, rank geri kalan bitlerin sonundaki sıfırlar artı bir.
- Ertl'in tahmincisi, Redis'teki gibi yuvarlanarak.
Bunu kendim de ölçtüm. Aynı user:0, user:1 ... elemanlarını iki tarafa da ekledim:
| Gerçek sayı | Redis 8.6.1 | OxiMem 0.45.1 | Hata | Aynı mı |
|---|---|---|---|---|
| 10 | 10 | 10 | %0,00 | evet |
| 100 | 100 | 100 | %0,00 | evet |
| 1.000 | 1.007 | 1.007 | +%0,70 | evet |
| 10.000 | 10.089 | 10.089 | +%0,89 | evet |
| 100.000 | 99.471 | 99.471 | -%0,53 | evet |
| 1.000.000 | 999.674 | 999.674 | -%0,03 | evet |
| 3 anahtarın birleşimi (450.000) | 447.209 | 447.209 | -%0,62 | evet |
Her satırda iki sunucu aynı sayıyı veriyor ve hata hep %0,81'lik standart hatanın etrafında.
Farklı kodlama: ASCII
Redis bir HyperLogLog'u ikili (binary) bir blob olarak saklıyor: yoğun hâlde 16.384 kovanın her biri 6 bit, toplam 12 KB. OxiMem bunu yapamıyor. OxiMem'de değerler Rust String'i, yani geçerli UTF-8 olmak zorunda. Ayrıca JSON anlık görüntüsüne ve isteğe bağlı SQL aynasına metin olarak yazılıyorlar. Rastgele baytlardan oluşan bir blob bunların hepsini bozardı.
Bu yüzden iki ASCII kodlama var:
- Seyrek (
HYLLs): yalnızca sıfır olmayan kovalar, kova numarasına göre sıralı. Her kovanumara << 6 | rankşeklinde 20 bit, 4 base64url karakteriyle yazılıyor. Boş bir HyperLogLog 5 baytlık başlıktan ibaret. - Yoğun (
HYLLd): her kova için bir karakter,'0' + rank. Toplam 16.389 bayt.
Seyrek hâl 750 kovayı (3.000 baytı, Redis'in hll-sparse-max-bytes varsayılanını) geçince yoğuna çevriliyor. Değer düz bir string: TYPE "string" diyor, GET, SET, RENAME, COPY ve anlık görüntü onu her string gibi taşıyor, PFADD sırasında TTL korunuyor. HyperLogLog olmayan bir string'e PFADD yapılırsa Redis gibi WRONGTYPE dönüyor ve değere dokunulmuyor. Bozuk bir değeri birleştirmek sayıları bozacağı için, sıralı olmayan kova numaraları, aralık dışı rank'lar ya da yanlış uzunluk reddediliyor.
Bedeli de ölçtüm. Aynı anahtarların bayt cinsinden boyları:
| Eleman | Redis | OxiMem |
|---|---|---|
| 10 | 46 | 45 |
| 100 | 283 | 405 |
| 200 | 506 | 797 |
| 1.000 | 1.910 | 16.389 |
| 10.000 ve üstü | 12.304 | 16.389 |
Küçük anahtarlarda fark yok gibi. 1.000 eleman civarında OxiMem yoğun hâle Redis'ten önce geçiyor, çünkü onun seyrek kodlaması kova başına 4 bayt harcıyor, Redis'inki ise ardışık boş kovaları tek bir işaretle atlıyor. Dolu bir anahtar Redis'te 12 KB, OxiMem'de 16 KB, yani yoğun hâlde OxiMem yaklaşık %33 daha fazla bellek kullanıyor. Metinle bundan sıkı paketlemek de mümkün değil: bir kovanın 6 biti tam bir base64 karakterine denk geliyor, yani en iyi ihtimalle yine kova başına bir karakter. Fark ancak OxiMem'e ikili bir değer türü gelirse kapanır. Bu büyüklüğün bir getirisi de var, onu ölçümlerde göreceğiz.
Hızlandırmalar
İlk sürüm doğru ama Redis'ten yavaştı. Commit mesajına göre PFMERGE Redis'in hızının dörtte biri civarındaydı. İkinci commit şunları değiştirdi:
- Doğrudan sayım: Tahminci yalnızca rank histogramına ihtiyaç duyduğu için tek anahtarlı
PFCOUNTartık 16 KB'lık bir kova dizisi kurmuyor, histogramı doğrudan kodlamanın üstünden çıkarıyor. Seyrek bir anahtar yalnızca dolu kovaları kadar iş yapıyor. - Tek diziye katlama:
PFMERGEve çok anahtarlıPFCOUNT, her kaynağı ayrı bir diziye açıp sonra birleştirmek yerine hepsini tek bir dizinin üstüne katlıyor (merge_into). - Dallanmasız döngüler: Yoğun döngüde her bayt için yapılan bir erken çıkış kontrolü, derleyicinin döngüyü vektörleştirmesini engelliyordu, kaynak başına yaklaşık 6 µs sürüyordu. Kontrol artık bir bayrağa yazılıyor ve geçişten sonra bakılıyor. Bozuk baytın yine de reddedildiğini bir test sabitliyor.
- Baytla kurma: Yoğun kodlamayı karakter karakter değil bayt dizisi olarak kurmak 10 µs'yi 2,5 µs'ye indirdi.
- Dört alt histogram: Kovaların çoğu bir iki rank değerinde toplandığı için tek histogramda hep aynı sayaç artıyor, her artış bir öncekini bekliyor. Dört ayrı histograma dönüşümlü yazıp sonda toplamak yoğun sayımı 9,8 µs'den 6,8 µs'ye indirdi.
Redis ile ölçümler
Düzeltme (3 Kasım 2026): Bu bölümün ilk hâlindeki sayılar, Redis'in
--daemonizeile başlatıldığı bir ölçümden geliyordu. macOS arka plana alınmış süreçleri daha düşük öncelikle çalıştırıyor, bu da Redis'i olduğundan yavaş, OxiMem'i olduğundan iyi gösterdi. Ölçümler iki sunucu aynı şekilde başlatılarak yenilendi, aşağıdaki sayılar düzeltilmiş hâli.
Ortam:
- Apple M4 (10 çekirdek), macOS 26.3.
- Redis 8.6.1 ve oxidb-server 0.45.1 (
master,0cd23297), ikisi de aynı makinede, aynı kabuktan aynı şekilde (ön planda,nohupile) başlatıldı, diske yazma kapalı. redis-benchmarkile beş senaryo, her biri 5 tur, sırayla bir Redis bir OxiMem. Tablolardaki sayılar ortanca. Turlar arasındaki fark çoğunlukla %5'in altında.- Yoğun anahtarda 1 milyon eleman, seyrek anahtarda 200 eleman var. Birleşim ve
PFMERGEiçin örtüşen üç yoğun anahtar kullanıldı.
50 istemci, pipelining yok
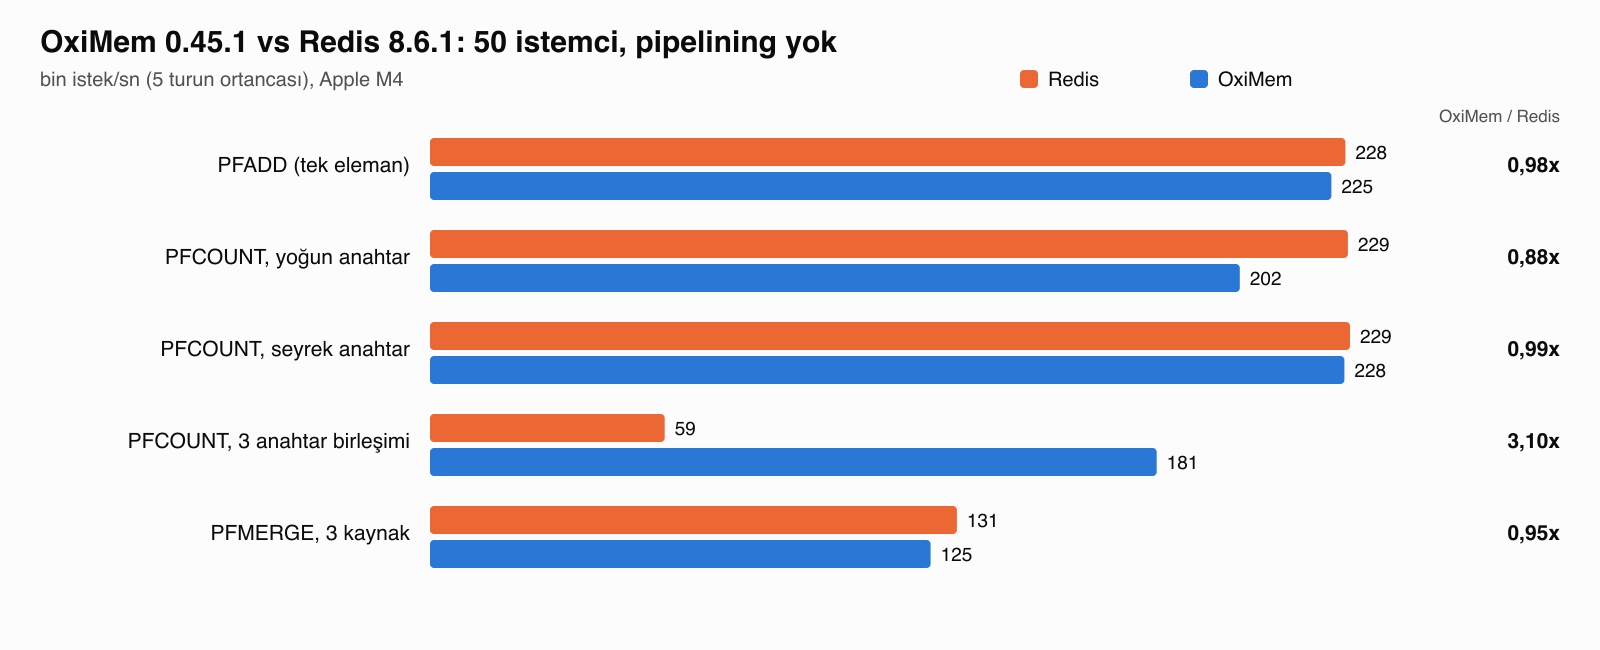
| Senaryo | Redis (istek/sn) | OxiMem (istek/sn) | OxiMem / Redis | p50 Redis / OxiMem (ms) | p99 Redis / OxiMem (ms) |
|---|---|---|---|---|---|
PFADD tek eleman | 228.206 | 224.719 | 0,98 | 0,119 / 0,119 | 0,143 / 0,159 |
PFCOUNT yoğun anahtar | 228.833 | 201.884 | 0,88 | 0,119 / 0,143 | 0,143 / 0,191 |
PFCOUNT seyrek anahtar | 229.358 | 227.964 | 0,99 | 0,119 / 0,119 | 0,135 / 0,159 |
PFCOUNT 3 anahtar birleşimi | 58.502 | 181.159 | 3,10 | 0,807 / 0,159 | 0,911 / 0,263 |
PFMERGE 3 kaynak | 131.349 | 124.792 | 0,95 | 0,335 / 0,383 | 0,431 / 1,959 |
Bu turda tek anahtarlı komutlar iki tarafta da 230 bin istek/sn civarında toplanıyor. Bu büyük ölçüde tek iş parçacıklı redis-benchmark'ın bu makinedeki tavanı, sunucuların değil. PFADD ve seyrek anahtarda PFCOUNT iki tarafta aynı. Yoğun anahtarı saymakta OxiMem %12 geride, PFMERGE'te %5 geride.
Asıl fark birleşimde: OxiMem 3,1 kat hızlı. İki taraf da kaynakları tek bir kova dizisine katlıyor, ama Redis'in yoğun kodlamasında kovalar 6 bitlik paketler hâlinde duruyor ve birleştirirken her kova bit kaydırmalarla tek tek çıkarılıyor. OxiMem'de her kova bir bayt olduğu için aynı döngü dallanmasız ve vektörleşebiliyor. Bellekte ödenen %33'ün karşılığı burada alınıyor.
50 istemci, pipeline 16, 4 iş parçacığı
Pipelining'le her istemci cevap beklemeden 16 komut gönderiyor, böylece darboğaz istemciden sunucuya geçiyor. Gerçek fark burada çıkıyor.
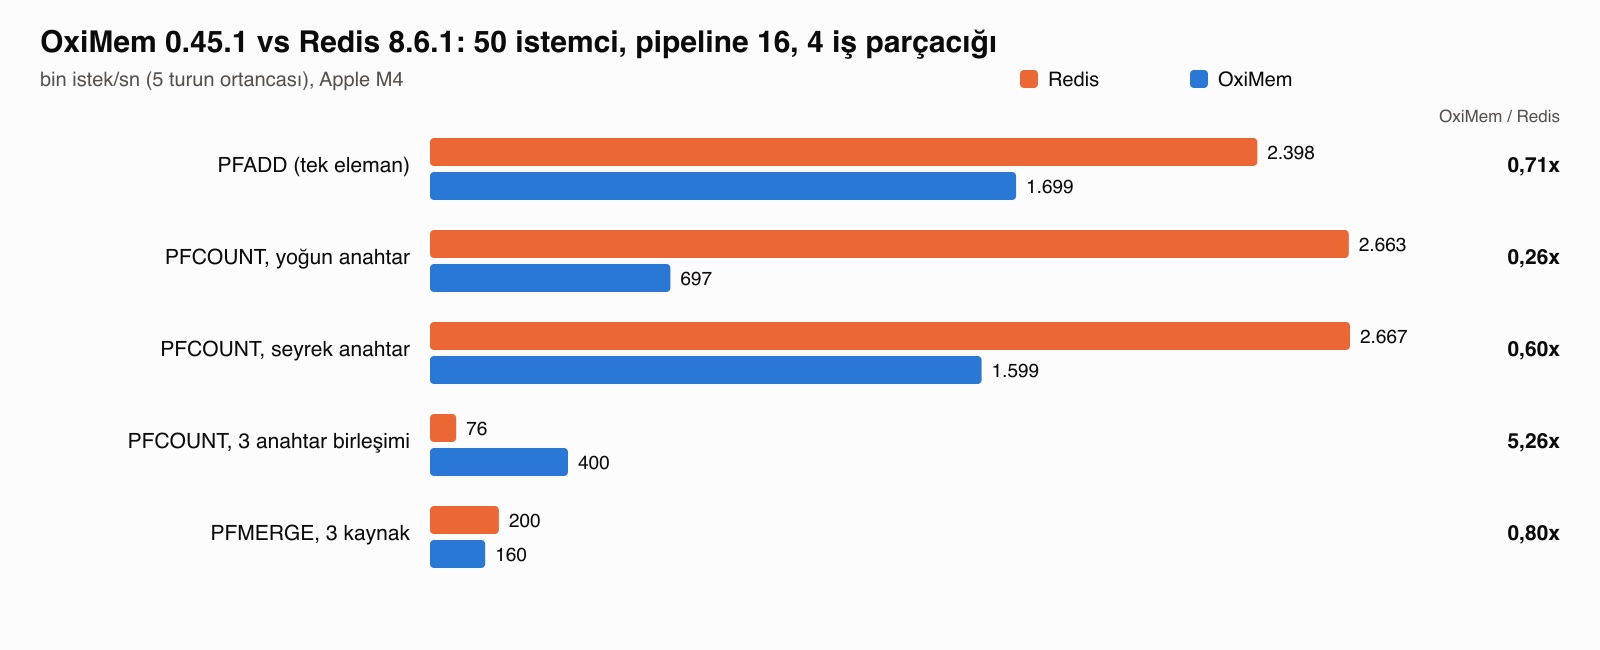
| Senaryo | Redis (istek/sn) | OxiMem (istek/sn) | OxiMem / Redis | p50 Redis / OxiMem (ms) | p99 Redis / OxiMem (ms) |
|---|---|---|---|---|---|
PFADD tek eleman | 2.398.082 | 1.698.754 | 0,71 | 0,295 / 0,167 | 0,407 / 3,655 |
PFCOUNT yoğun anahtar | 2.663.116 | 696.864 | 0,26 | 0,263 / 0,271 | 0,383 / 3,983 |
PFCOUNT seyrek anahtar | 2.666.667 | 1.598.721 | 0,60 | 0,263 / 0,167 | 0,375 / 1,727 |
PFCOUNT 3 anahtar birleşimi | 76.060 | 400.000 | 5,26 | 10,239 / 1,303 | 10,479 / 5,791 |
PFMERGE 3 kaynak | 199.800 | 159.936 | 0,80 | 3,847 / 3,191 | 4,063 / 24,415 |
Burada dört şey dikkat çekiyor:
- OxiMem'in bir tavanı var. Ucuz komutlarda (
PFADD, seyrekPFCOUNT) OxiMem saniyede 1,6–1,7 milyon istekte duruyor, Redis 2,4–2,7 milyona çıkıyor. Komut ne olursa olsun aynı yerde durması, farkın HyperLogLog kodundan değil, OxiMem'in istek başına ek yükünden (protokol ve komut dağıtımı) geldiğini düşündürüyor. Bunu henüz incelemedim. - Birleşimde fark açılıyor: 5,3 kat. Sunucu tam yük altındayken 6 bitlik kovaları tek tek açmanın maliyeti daha açık görünüyor.
- Yoğun bir anahtarı tek başına saymakta Redis 3,8 kat önde. Yukarıdaki tavanın üstüne bir sebep daha ekleniyor: Redis bir anahtarın son tahminini başlığında 8 baytlık bir önbellekte tutuyor ve anahtar değişmedikçe yeniden hesaplamıyor. Bu testte anahtar hiç değişmediği için Redis her seferinde önbellekten cevap veriyor, OxiMem ise her seferinde 16.384 kovanın histogramını yeniden çıkarıyor (yaklaşık 6,8 µs). Seyrek anahtarda bu iş çok küçük olduğu için orada yalnızca tavan farkı kalıyor. Çözüm belli: değerin başlığına bir önbellek alanı eklemek. Bir sonraki adım o.
- OxiMem'in kuyruk gecikmesi daha yüksek. Ortanca gecikmesi çoğu senaryoda Redis'inkine eşit ya da daha düşük, ama p99'u pipelining altında 1,7–24 ms'ye çıkıyor, Redis'inki 0,4–10,5 ms'de kalıyor. Bunun da nedenini henüz incelemedim.
Özetle: tek anahtarlı işlerde OxiMem şimdilik Redis'in biraz gerisinde, yük altında belirgin şekilde gerisinde. Çok anahtarlı sayımda ise 3 ile 5 kat önde.
Kullanmak
Komutlar Redis'tekiyle aynı, redis-cli ya da herhangi bir Redis istemcisiyle çalışıyor:
$ redis-cli -p 6380 PFADD okurlar:2026-11-03 ip:203.0.113.7 ip:198.51.100.9
(integer) 1
$ redis-cli -p 6380 PFADD okurlar:2026-11-04 ip:203.0.113.7 ip:192.0.2.44
(integer) 1
$ redis-cli -p 6380 PFCOUNT okurlar:2026-11-03 okurlar:2026-11-04
(integer) 3
$ redis-cli -p 6380 PFMERGE okurlar:hafta okurlar:2026-11-03 okurlar:2026-11-04
OK
$ redis-cli -p 6380 TYPE okurlar:hafta
string
Bu blogun tekil okur sayısı da artık böyle sayılıyor: her okurun IP adresinin tuzlanmış özeti tek bir PFADD anahtarına ekleniyor ve sayı PFCOUNT ile okunuyor. Okur başına hiçbir şey saklanmıyor, anahtar okur sayısı ne olursa olsun en fazla 16 KB, karşılığında sayı tam değil, %0,81 hatayla bir tahmin.
Yorumlar
İlk yorumu sen yaz.
Yorum yazmak için Google hesabınla giriş yap. Adın ve yorumun herkese açık görünür. E-posta ve IP adresin kötüye kullanıma karşı kaydedilir, ama gösterilmez.